一个不会聊天、不会写文章,只负责“做选择”的模型,为什么突然火了?顺着 Jev 往下追,会发现真正的问题很简单:AI 已经会干活了,但它每走一步,真的都值得调用一次大模型吗?
一、一个只会“做选择”的模型,凭什么突然火了?
这几天,Jev 突然火了。第一次看到它,很容易有一种感觉:就这?它不会陪你聊天,也不负责写文章。它主要干一件事:做选择。
比如一条客服工单:“同一份订阅被扣了两次钱。”系统已经知道只有三个去向:账单、技术支持、账户访问。普通大模型会理解后继续生成答案。Jev 则直接给几个候选打分,再选一个。
一句话解释:
大模型擅长继续写,Jev 专门负责从几个答案里选一个。
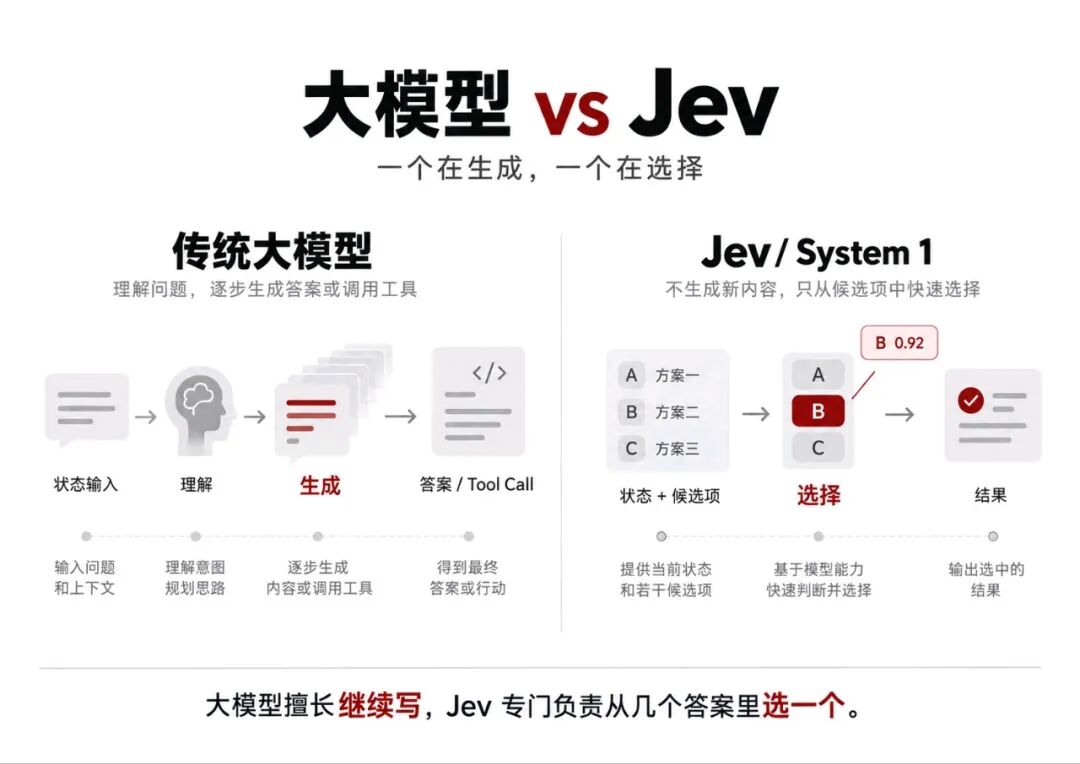
问题马上来了:**大模型不能选吗?**当然能。GPT、Claude、Gemini 都能干。Jev 关心的重点,是这么小的判断,有没有必要每次都动用完整大模型。
其实以前早就有类似的小模型。黄图识别、垃圾邮件、欺诈检测,本质都是分类和打分。它们小、快、便宜。只是任务通常提前就定死了。
Jev 往前走了一步。今天判断“账单还是技术支持”,明天可以判断“点击还是提交”。任务可以临时定义。它想把小分类模型的速度和大模型的理解力拼起来。
可如果只是做选择,为什么不用代码?
二、为什么不用代码?为什么不提前把自动化写好?
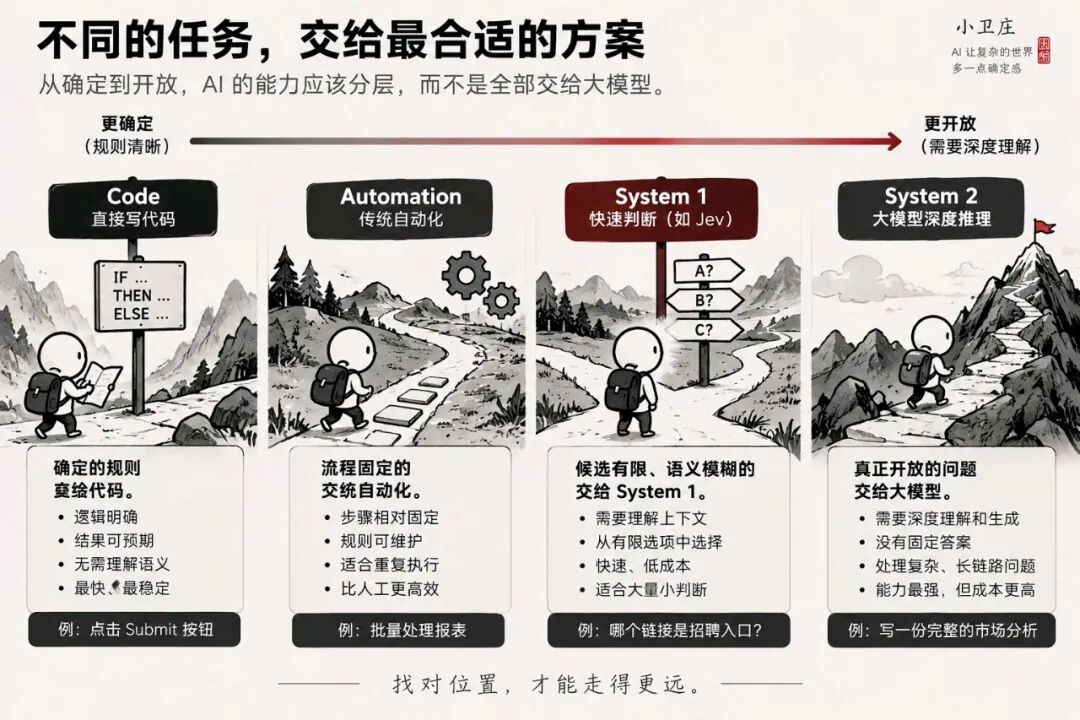
如果一件事可以百分之百确定,代码当然最好。网页上明确有一个 Submit,就直接点。流程固定,就提前写好自动化。Jev 没必要出现。
真正的问题出现在环境变化以后。今天招聘入口叫 Careers,明天叫 Jobs,另一家叫 Join Us。人扫一眼就知道大概都指招聘。传统自动化却要不断加规则。
传统自动化的逻辑,是提前把路径写出来。System 1 换了一个思路:目标先确定,再根据现场状态逐步判断。页面有 37 个链接,就问哪个最像招聘入口。选完以后再由代码点击。
所以 Jev 的位置其实很具体:
能写死的,交给代码。流程固定的,交给自动化。候选有限、语义模糊的,交给 System 1。真正开放的问题,再交给大模型。
它填的是中间那块空白。代码嫌它太模糊,大模型又显得太重。可这块空白真有那么大吗?得去真实案例里看。
三、真正让 Jev 火起来的,是这些“慢到不能忍”的场景
最直观的是 Browser Use。有开发者只给系统一个完全陌生的网址,让它自动填写 TypeSafe AI 问卷。结果是 16 道题,38 秒完成。作者称全程零人工干预。
它的分工很简单。Jev 负责判断“点哪个、勾哪个、什么时候提交”。碰到真正需要写文字的地方,再调用 DeepSeek V4.1 Flash。能选的就选,需要写的才写。
来源是开发者在 X 上的单次实测。38 秒和零人工干预都是作者自述。它不能证明所有网站都能稳定复现。但这个案例把问题暴露得很清楚。
很多 Browser Agent 每点一次,都让大模型重新看、重新想、再决定。于是整个流程变成:看一下,等几秒,点一下,再等几秒。很聪明。也很像幻灯片。
另一个案例是 Third Hand。很多 Computer Use 会截图,再让视觉模型理解,最后生成坐标点击。Third Hand 直接读取 macOS 的按钮、输入框和菜单。Jev 只需要回答:下一步选哪个?
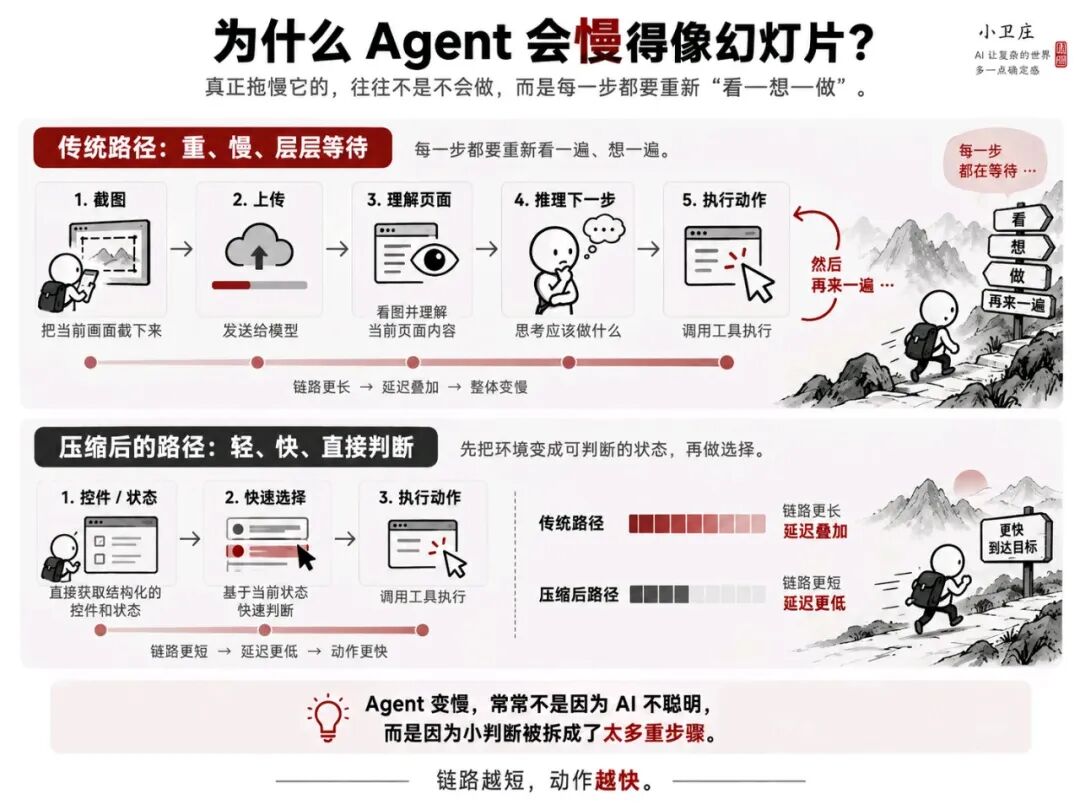
这里真正重要的,不只是 Jev 快。环境先被整理成了机器容易判断的样子。“看复杂屏幕猜坐标”,变成“12 个按钮里选一个”。问题本身已经被大幅压缩。
LangChain 又给了另一个案例。他们让 Jev 做 Agent Judge,也就是判断 Agent 刚才做得对不对。实验里一次判断大约 0.44 秒。重复判断也比较稳定。
这个场景和 Browser Use 完全不同,却有同一个痛点:系统每天要做大量小判断。路由、审核、重试、升级人工,单次调用大模型当然不贵。一天十万次就完全是另一回事。
再看一个反例。有人在 M2 Pro 上跑 Laya,单次判断约 13.7ms,QPS 约 58。可拿自己的 100 道题一测,准确率只有约 50%。
这两个数字放在一起,比“13.7ms”更重要:
快没有用,得先判断对。
四、Jev 真有那么神吗?大模型以后快起来怎么办?
答案没那么简单。Computer Use 慢,还包括截图、上传、视觉理解和网络延迟。如果系统本来就有结构化 API,很多问题直接消失。GUI 特别痛,是因为 GUI 本来就是给人看的。
所以 Third Hand 真正聪明的一步,是先绕开一部分视觉界面。操作系统直接把按钮列表交出来。这部分收益不能都算到 Jev 头上。一个很快的小模型,同样可能大幅提速。
更有意思的是,社区很快发现:**甚至不一定需要重新训练一个 Jev。**Avi Chawla 直接用普通 Qwen 加 SGLang 打分接口。几个候选答案摆出来,不让模型继续写。直接读取它更偏向哪个。
这件事很关键。大家突然发现,大模型还有另一种用法。以前是看懂以后继续写。现在也可以看懂以后,直接给几个候选打分。
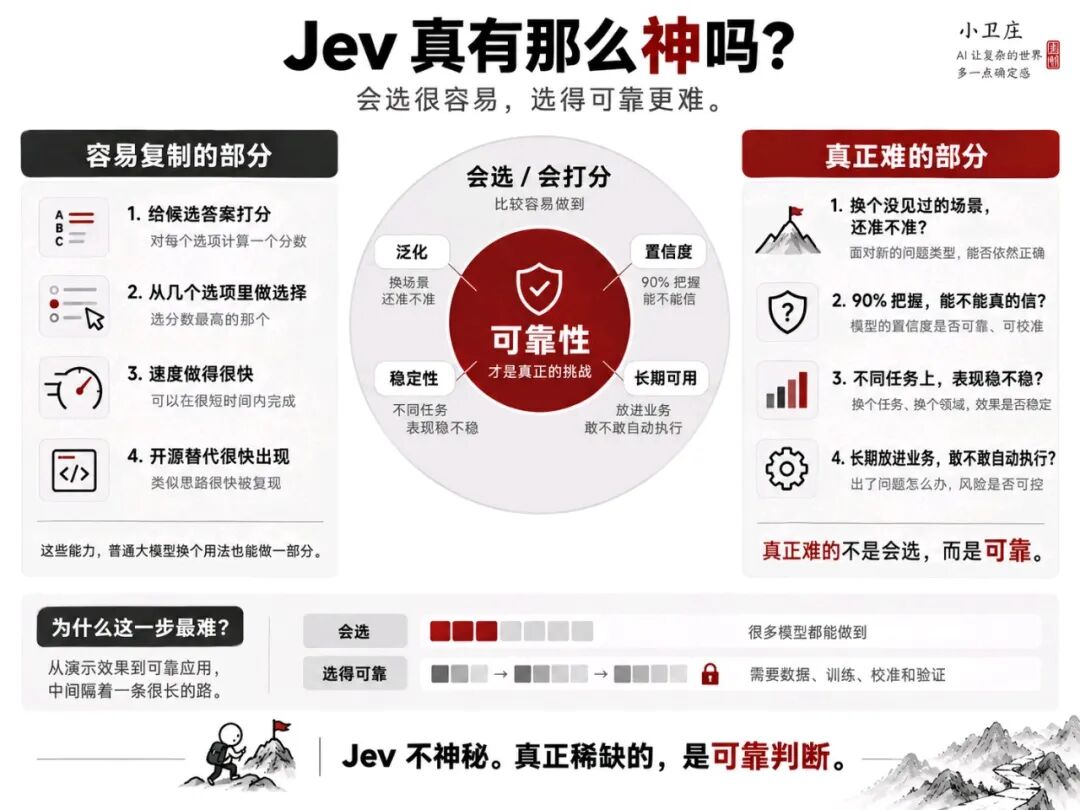
开源替代也迅速出现。Laya、Kev、SemIf、classifier.dev,各走各的路线。你之前发来的 JevBench v1.2 里,classifier.dev test tier 得分 84.8,Jev 1.13 是 75.3。
这不能证明 classifier.dev 在真实业务里全面更强。Benchmark 可能被针对性优化,测试条件也未必完全一样。但至少说明:“做一个 System 1”本身,很难形成绝对壁垒。
真正难的可能是另一层。换个没见过的场景还能不能准?模型说自己有 90% 把握时,这个 90% 能不能信?
会选很容易,选得可靠难很多。
那为什么偏偏是现在爆发?因为 Chatbot 一次请求可能只调用一次模型。Agent 完成一个任务,却可能连续做几十、几百次局部判断。原来不起眼的一秒,终于被放大成了系统瓶颈。
五、Jev 可能会被吃掉,但这个能力大概会留下
今天想用这类能力,已经有很多办法。可以直接用 Jev,也可以用 Laya、Kev、SemIf。还可以继续使用原来的大模型,只改变打分方式。Agent 框架也已经开始接进去。
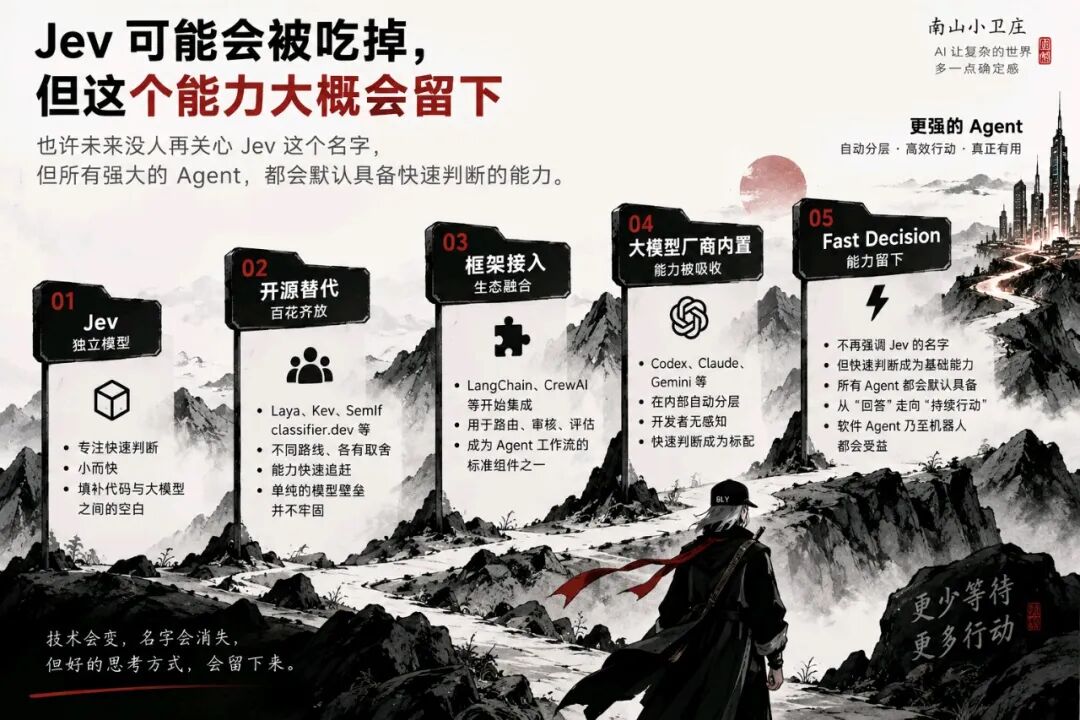
所以这个能力的实现成本,看起来并不算高。模型不用特别大,接口也不复杂。开源社区几天就能做出一批替代方案。最有条件把它吃掉的,反而可能是大模型厂商。
比如 Codex、Claude Code、Gemini 这类 Agent。它们本来就有大模型、执行环境和工具系统。以后完全可以在内部自动分层。开发者甚至感知不到 System 1 的存在。
未来可能就是:
能确定的,代码直接做。小判断,快速模型做。真正复杂的,强模型再出场。
这让我想起 OpenClaw。它爆火以后,很快出现大量模仿、改进和轻量版。后来真正留下来的,不只是某一个项目。更重要的是那套思路被整个生态学走了。
Jev 现在也很像。只是演化更快:发布、开源替代、Benchmark 竞争、框架接入。下一步,大模型厂商直接把它内化,也很自然。
开发者最后不会关心:“我的 Agent 有没有用 Jev?”他真正关心的是:“我的 Agent 有没有这种能力?”简单判断能不能快速完成,复杂问题是不是才调用最强模型。
如果把视角再拉远一点,这个问题甚至不只属于软件 Agent。现在很多机器人,也有一种熟悉的“慢动作感”:先看、再理解、再推理、再决定,最后才动。
如果每个细小动作都要经过大模型,这种迟滞很难消失。机器人领域早就在做分层,高层负责理解和规划,下面负责快速执行。软件 Agent 今天也开始走到类似的位置。
当 AI 从“回答”走向“持续行动”,智能自然会分层。
所以研究到最后,Jev 本身反而没那么神秘。接口容易复制,推理方式也不神秘,开源模型已经追得很快。
但它提出的问题很值得留下:
AI 每走一步,真的都值得调用一次最强的大模型吗?
也许几年以后,Jev 这个名字已经没人再提。但如果那时候所有 Agent 都默认有一层快速判断能力,Jev 今天带火的这个问题,就已经留下来了。
如果对自己🈶用,点👍收藏吧,
如果对朋友🈶用,点❤️转发下!
感谢支持❤️!!!