昨天,我在 Hugging Face 上看到一个挺有意思的模型:GLM-5.3-CYBERSECURITY-FP8。
从名字就能看出来,它不是一个普通的通用模型,而是一个面向网络安全场景做过专门处理的 GLM-5.3 模型。
对于做安全的人来说,这种模型天然就有吸引力——到底在漏洞分析、代码审计、攻防这些事情上能做到什么程度,很值得拿回来试试。
756GB。
倒不是马上要用,只是这个模型放在 Hugging Face 上,我有点担心哪天作者把库删了。既然碰到了,觉得还有点价值,那就留一份。
第一反应当然是:下载。
然后看了一眼硬盘。
放不下。
没关系,我还有 Google Drive。
于是一个原本只有一句话的事情——
“怕作者删库,留一份。”
变成了:
“怎么把 756GB 的 Hugging Face 模型搬到 Google Drive?”
当时我完全没觉得这两个问题有什么区别。
一、事情开始变得有技术含量
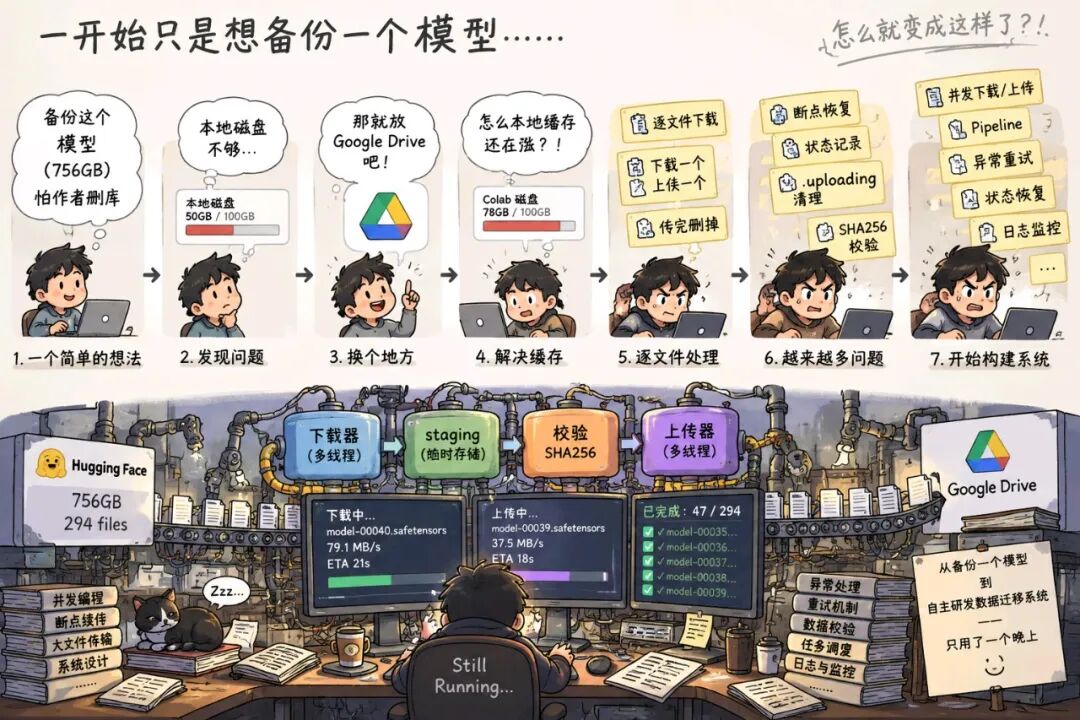
Google Drive 空间够,那就直接下载进去。
跑起来以后发现不对。
文件虽然往 Google Drive 里写,本地缓存也在涨。模型还没下载多少,Colab 的本地磁盘先顶不住了。
这很好办。
解决缓存。
既然不能整个模型放到本地,那就一次处理一个文件:下载一个,上传一个,传完删掉,再下载下一个。
问题解决。
然后又发现,大文件上传到一半断了怎么办?
那就加恢复。
程序重新启动以后,怎么知道哪些已经传完了?
那就记录状态。
上传了一半留下来的临时文件怎么办?
清理 .uploading。
已经上传的文件到底对不对?
SHA256。
下载的时候上传线程闲着,上传的时候下载又在等,效率是不是还能再高一点?
当然可以。
Pipeline。
于是昨天晚上,我的屏幕逐渐变成了这样:
归档:47 / 294↓ 下载:model-00040-of-00282.safetensorsstaging SHA256 33.8%79.1 MB/sETA 21s
↑ 上传:model-00039-of-00282.safetensors上传 73.8%37.5 MB/sETA 18s
看到这里的时候,我甚至还有一点满意。
这套东西已经越来越像一个正经的数据迁移系统了。
二、然后我开始研究怎么爬楼梯
现在回头看,最好笑的是整个过程中,每一步都很合理。
磁盘不够,换 Google Drive。
缓存不够,逐文件。
逐文件慢,流水线。
传输会断,断点恢复。
状态不确定,做校验。
没有哪一步明显是错的。
所以人会很自然地继续往下走。
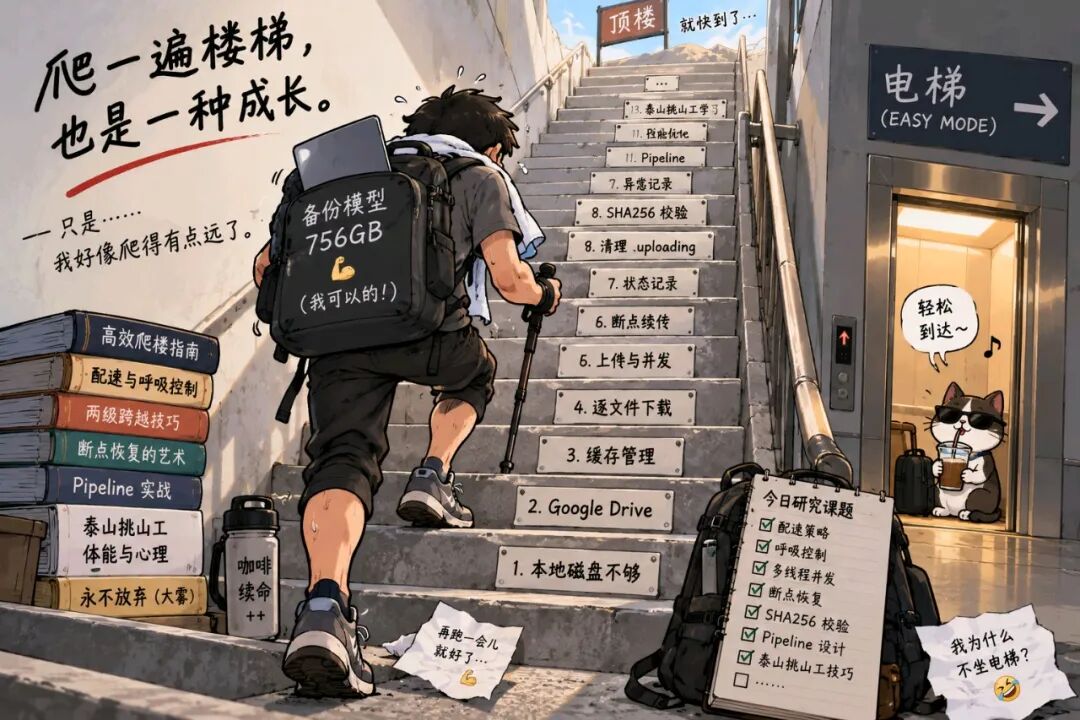
就像要去顶楼,进门以后发现旁边有个楼梯。
爬吧。
爬到十楼有点累,于是开始研究配速。
爬到二十楼,发现两级两级跨可能更快。
三十楼开始研究呼吸。
四十楼研究怎么在中途休息以后快速恢复状态。
五十楼开始研究负重情况下怎么保持效率。
再往后,泰山挑山工的技术资料都快翻出来了。
而且最麻烦的是:
这些研究真的有用。
你真的越爬越专业了。
三、昨天晚上,我真的爬了半夜
这个模型其实什么时候备份完都无所谓。
没有截止时间。
晚一天没关系,晚一个星期也没关系。机器多跑几个小时,我更不在乎。
但昨天晚上,我电脑一直开着。
我也一直在折腾它。
看进度,发现问题,改代码,再跑;又发现一个边界情况,再改。
不知不觉就到了半夜。
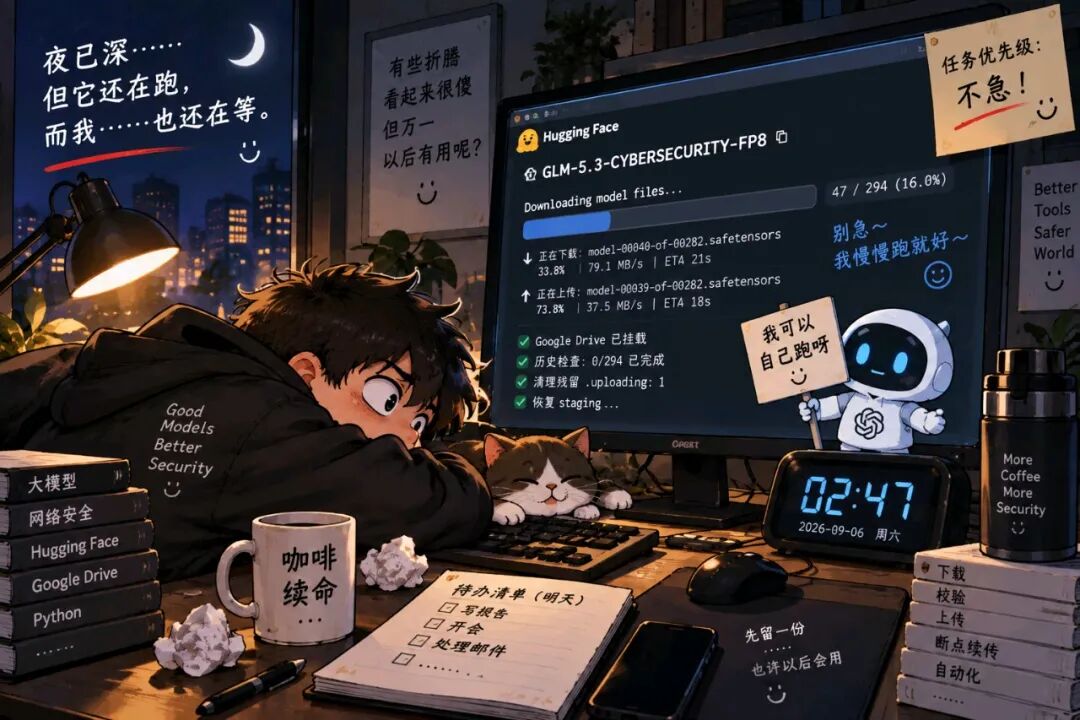
这时候其实已经出现了一个挺荒唐的画面:
一个完全不着急的后台备份任务,正在占用一个活人的睡觉时间。
但人在里面的时候并不会觉得荒唐。
因为你刚刚又解决了一个问题。
再把眼前这个解决掉,应该就好了。
四、后来我突然问了一句
折腾到后面,我不知道怎么突然重新想了一下:
等等。
我为什么要把这个模型下载到 Google Drive?
因为我要备份。
为什么要备份?
因为怕作者删库。
我怕的是硬盘坏吗?
不是。
我怕 Google Drive 没有吗?
也不是。
我甚至不太担心 Hugging Face 哪天突然整个没了。
我就怕一件事:
作者把仓库删了。
那……
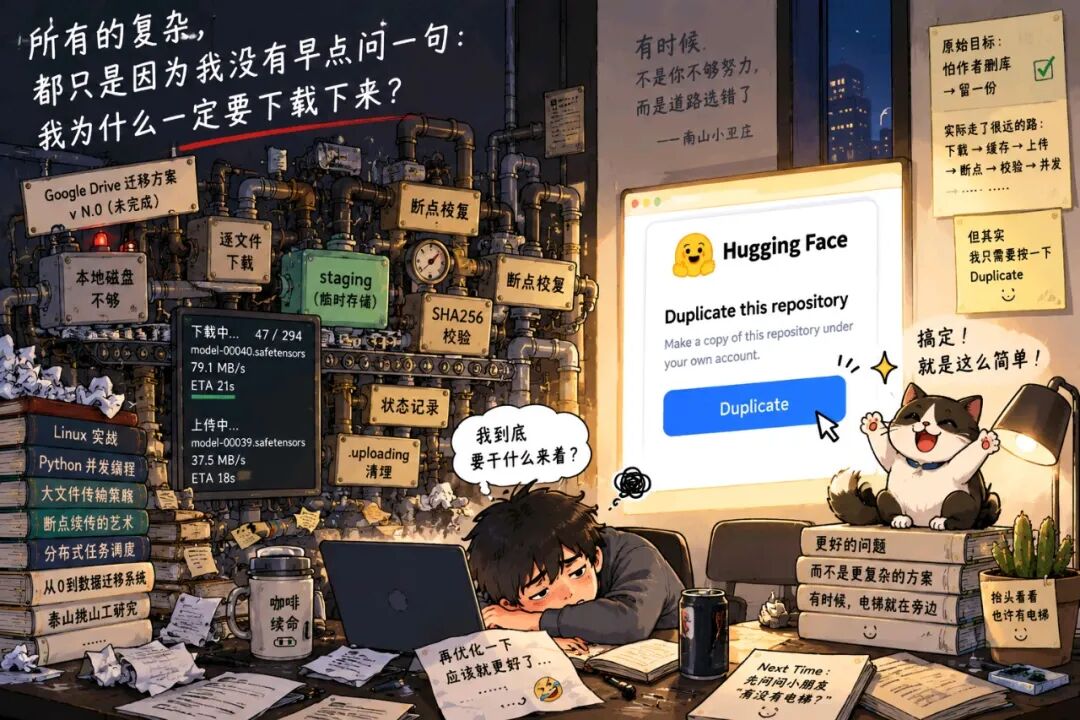
我为什么一定要把它搬出 Hugging Face?
到这里,前面研究的东西突然都停了。
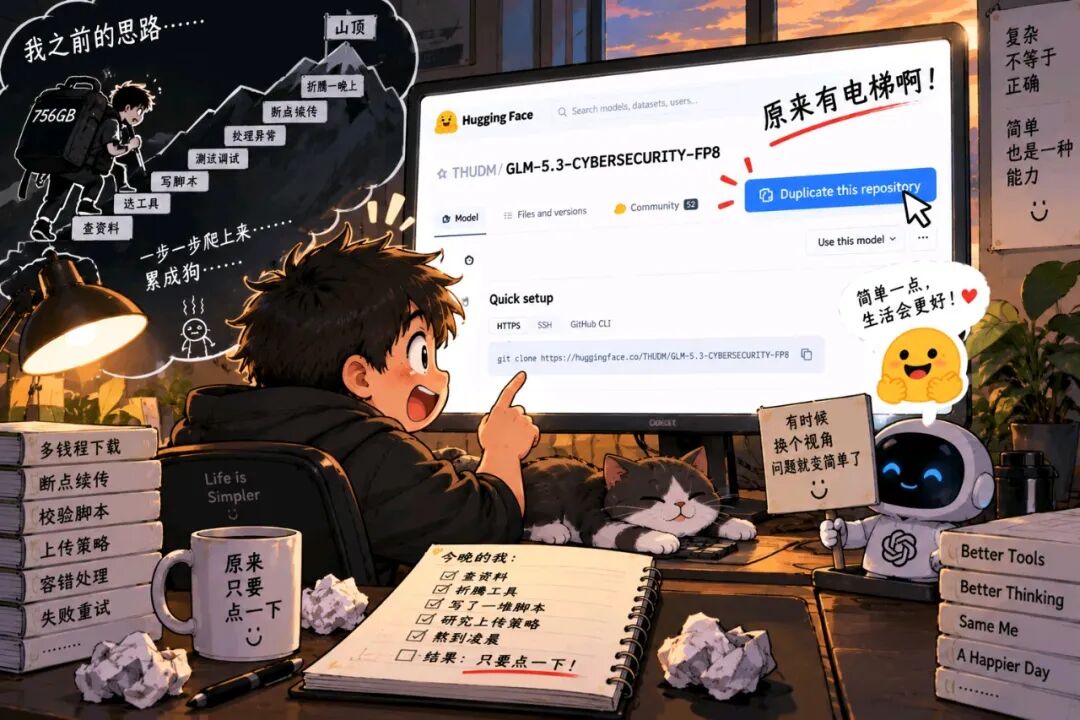
我去找了一下。
然后看到了一个东西:
Duplicate。
把作者的 Repo,直接 Duplicate 一份到自己的 Hugging Face 账号。
我试了一下。
756GB。
过去了。
……
五、叮
那一刻我脑子里出现了一个特别清楚的画面。
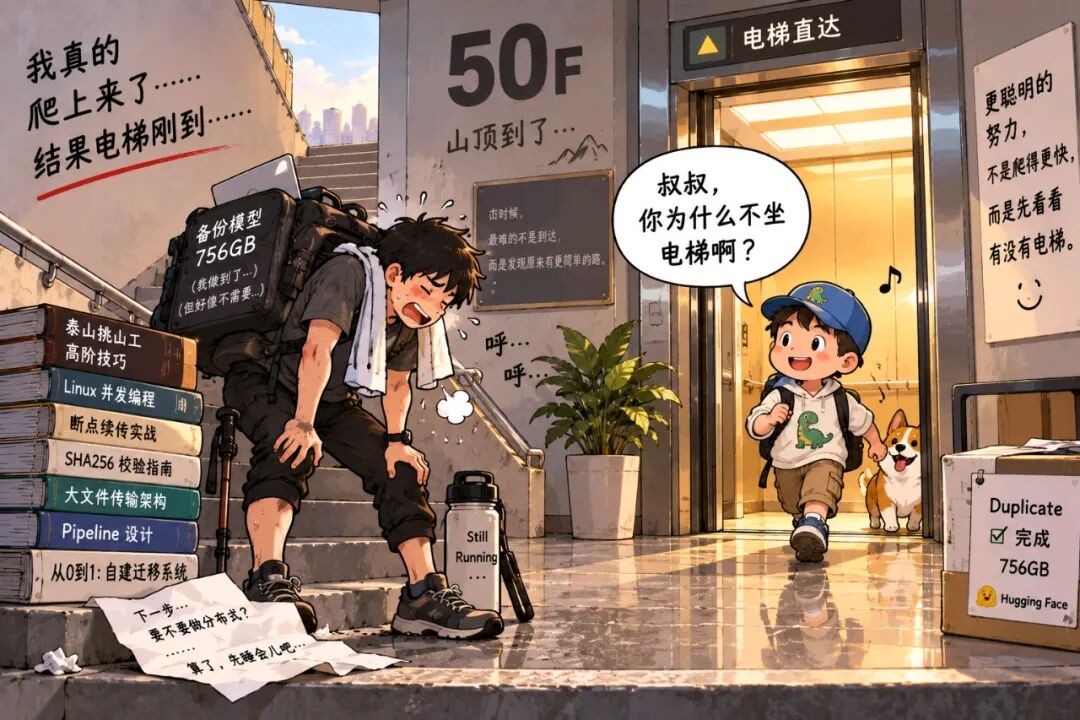
昨天一楼有个小朋友跟我一起进楼。
我要去顶楼。
我看见楼梯,开始往上跑。
一路研究配速、呼吸、跨步、恢复,最后连泰山挑山工的方法都用上了。
拼尽全力,终于到了顶楼。
这时候:
叮。
旁边的电梯门开了。
一楼那个小朋友从里面蹦蹦跳跳地走出来。
他看看我。
又看看楼梯。
然后很认真地问:
叔叔,你为什么不坐电梯啊?
六、楼梯没有错
今天再回头看,最有意思的地方不是 Duplicate。
下次碰到的事情,也不会恰好有一个 Duplicate 按钮。
真正让我有点警觉的是:
昨天楼梯上的每一步,其实都走对了。
那些缓存问题是真的,断点恢复是真的,SHA256 有意义,Pipeline 也确实提高了效率。
如果继续做下去,我大概真的可以把那套程序做得很好。
可问题恰恰在这里。
当一条路上的问题不断被解决,人很容易把“不断取得进展”,误认为“正在接近目标”。
也许以后碰到复杂任务,PoC、MVP、逐步放大当然还是要做。
但在这些之前,以及事情开始越来越复杂的时候,可能还值得偶尔问一句特别幼稚的问题。
幼稚到有点像那个刚从电梯里出来的小朋友:
“叔叔,你为什么一定要走这里啊?”
有时候,真正需要优化的不是步法。
是先抬头看看,旁边有没有电梯。