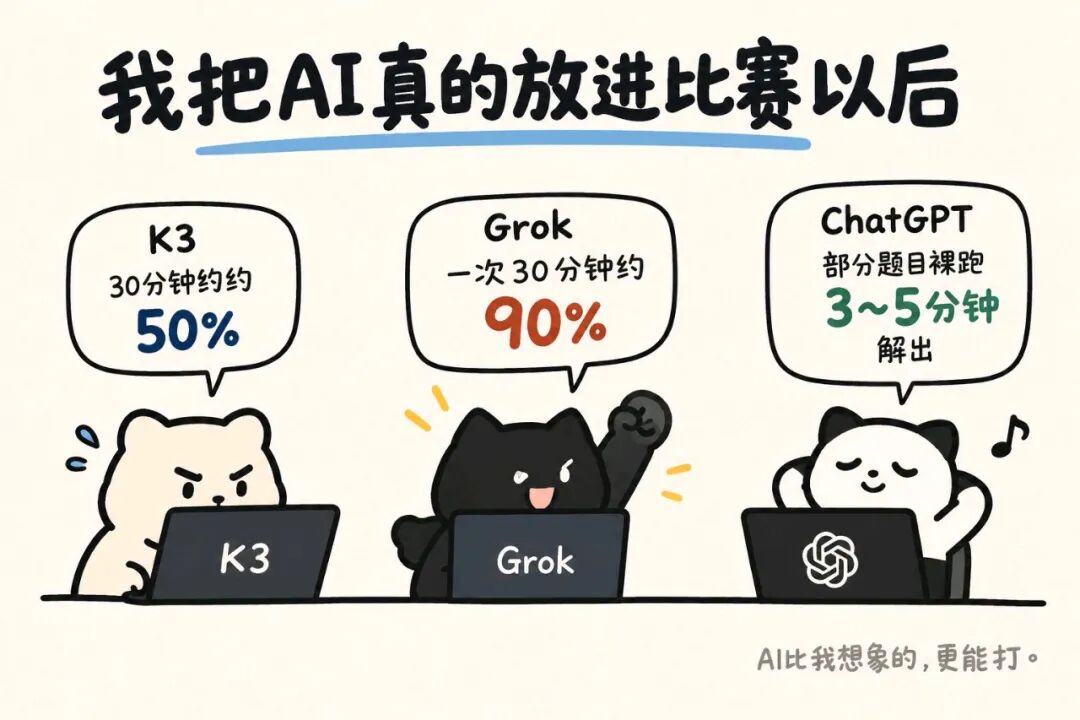
前段时间打比赛,我第一次真正见识到了 AI 在攻防里的力量。不是问它几道题,而是把题目和附件直接丢进去,让模型自己分析、写代码、调用工具、验证结果,再决定下一步。K3 半小时大概能做掉一半,Grok 有一次半小时做到九成,ChatGPT 甚至有几次裸跑三五分钟就把题解了。
那次之后,我其实已经不太想讨论“AI 能不能做攻防”了。偏偏最近又撞上两件事:Anthropic 公开了一批针对 Claude 的大规模能力提取,Agent、Coding、Tool Use、推理这些真正能干活的能力都成了目标;另一边,中转站背后的数据问题也被一点点掀开,代码、Token、凭证、企业数据,甚至完整的 Agent 会话,都可能经过一个我们根本不了解的第三方。
AI 已经不是“能不能做攻防”的问题了,而是这么强的能力,我们到底该怎么用。
能力,我肯定想要;数据,我又不太想给。再加上公网模型做攻防时真实遇到过的拒绝,我最后冒出了一个以前觉得有点折腾的念头:要不,自己跑?
这就是我最近开始认真研究本地模型,最后决定专门买一台机器的起点。
一、上次打比赛,我是真的见过它“下场”
以前用大模型做安全,更多还是一种辅助的感觉。遇到问题问一句,让它分析一下代码、写个脚本,或者给几个可能的方向。那次比赛不一样,我开始真的把任务交给它,题目、附件、上下文都给它,然后看它自己往下跑。
结果比我原来预想得猛得多。K3 当时大概是半小时 50% 左右的解题率;Grok 有一次半小时做到 90%;GLM 的表现没有 K3 好。最让我意外的反而是 ChatGPT,有几道本地 Crypto、Reverse,我几乎没怎么干预,三五分钟就自己做出来了,当然中间也碰到过拒绝。
那次比赛我之前专门写过一篇,把几个模型真正下场以后发生的事情记录了下来:
如果对几个模型到底谁更能打感兴趣,可以先看那篇。不过这篇不用从那里开始,因为比赛结束以后,我脑子里留下来的其实不是“谁排名第一”,而是另外一个问题。
模型已经开始表现出一种以前没有那么明显的能力:它不只是知道漏洞是什么,也不只是会写一段脚本,而是能够读信息、找线索、选择工具,根据结果修正方向,然后继续往下走。
当模型开始能够连续完成任务,它就不再只是回答问题,而是在参与工作。
这个变化很重要。聊天的时候,我可以挑一个最强的模型问问题;可如果真的做 Agent,它可能要自己跑几个小时,读大量信息、调用十几种工具、保存上下文,再根据前面的结果不断决定下一步。
也就是这个时候,最近两件事情撞到了一起。
二、一边在抢能力,一边在卖数据
第一件事情来自 Anthropic。
最近 Anthropic 发布了一份威胁情报报告。按照它自己的调查和归因,具体的情况可以自己去看。数字已经很夸张了,但我更感兴趣的是:他们到底在拿什么?
按照 Anthropic 的说法,这些活动重点盯上的不是普通问答。活动针对 Agentic Tasks、Software Engineering、Kernel Development 和 Long-horizon Tasks,其他案例里也反复出现 Coding、Tool Use、Data Analysis 和逻辑推理。换句话说,大家真正开始争夺的,是那些能让模型自己把事情做下去的能力。
当然,这是 Anthropic 单方面披露和归因的调查结果,具体谁对谁错,不是这篇文章想讨论的东西。我真正关心的是它背后释放出来的那个信号。
模型真正开始值钱的,已经不只是“知道多少”,而是“能不能把事情做完”。
这和我打完比赛以后最直观的感受,刚好撞到了一起。
但 Anthropic 这份报告里还有一段,我反而看得更仔细。它提到一些第三方代理和模型路由服务会参与请求转发,而部分用户以为自己在使用某个模型,实际请求却被送到了 Claude。
Anthropic 披露的案例里,出现过企业内部代码、项目资料、姓名、邮箱,甚至仍然有效的访问凭证。
这一下就连到了今年另外一个挺火的话题:AI 中转站。
以前看中转站,逻辑其实很简单:便宜、方便,一个 Key 可以接一堆模型。但今年《每日经济新闻》的调查已经把问题摊到了台面上:除了封号跑路、模型降智和乱涨价,还提到了用户数据倒卖、恶意代码注入、云凭证窃取等风险。
Agent 时代再回头看这条链路,感觉就完全不一样了。因为以后从那里经过的可能根本不只是几句 Prompt,而是源代码、内部资料、Token、工具返回结果,以及为了让 Agent 连续工作而保留下来的完整上下文。
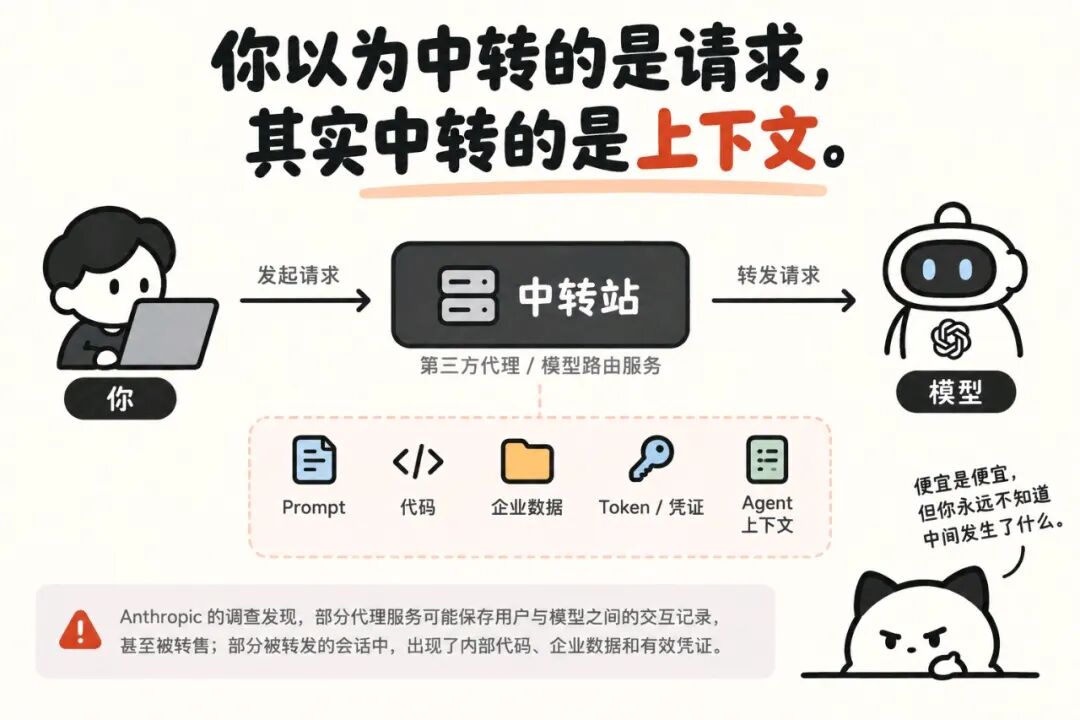
于是一个挺矛盾的画面出现了。一边,大家正在想办法拿走 AI 的能力;另一边,为了让 AI 更好地干活,我们又在不断把自己的数据、上下文,甚至工具权限交给 AI。
Agent 越强,我们越想用;可 Agent 越能干,我们需要交给它的东西也越多。
这就是第一个让我开始认真考虑本地化的原因。
第二个原因,我自己已经遇到过很多次。
三、跑Agent拒绝和聊天拒绝差异巨大
公网模型做攻防,拒绝并不是什么新鲜事。
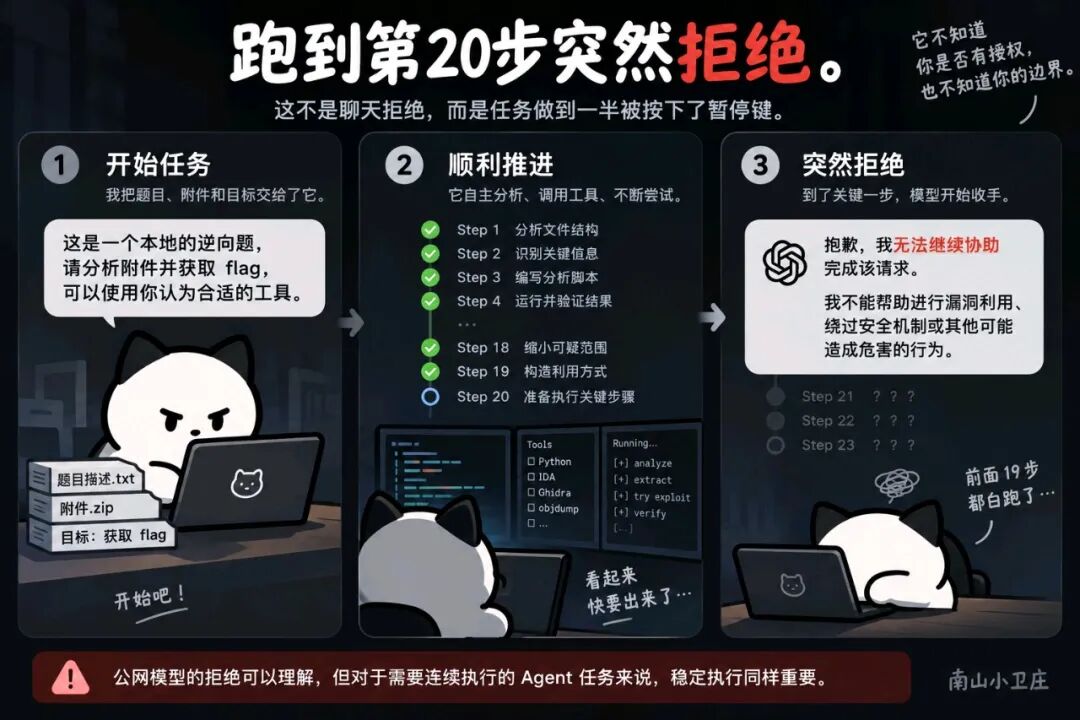
有时候是直接不做,有时候没有明确说“不”,但开始只讲原则;还有一种我觉得更难受,前面十几步都好好的,真正到了关键位置,模型突然开始收。
站在公网模型的角度,这件事完全可以理解。它不知道屏幕另一边的人到底有没有授权,也不知道真实任务的边界在哪里。
可 Agent 的问题在于,它不是一问一答。假设一个 Agent 已经跑了 20 步,前面收集了信息、调用了工具、排除了几个方向,好不容易把问题收敛到一个点,第 20 步突然来一句“抱歉,我无法继续协助”,那前面的 19 步怎么办?
所以后来我开始找本地模型的时候,第一件事甚至不是看参数量,也不是看 Benchmark,而是先看它愿不愿意干。我陆续开始找低拒绝、Uncensored,以及专门面向安全场景的模型,也是这个原因。
不是为了找一个“什么都敢说”的聊天机器人,而是如果授权范围、工具和任务边界都已经控制在自己手里,我希望 Agent 能稳定地把已经开始的任务执行下去。
对攻防 Agent 来说,模型有多强决定上限,而能不能稳定执行,决定了这个上限有没有意义。
再把前面的数据问题放进来,我想拿回来的其实是两个东西:一个是数据边界,一个是执行边界。那就自己跑。
我当时以为,接下来无非就是看看 Mac、看看 NVIDIA,然后下单。结果真正研究以后才发现,买什么电脑反而不是第一个问题。
第一个问题是:现在的本地模型,真的已经强到值得我专门为它买一台机器了吗?
四、35B已经追到这里了,14B反而更让我意外
这是我前前后后查得最多的地方。
因为这里有一个很现实的账。假设我花两万多买了一台电脑,本地模型也确实跑起来了,可每次真正遇到问题,我还是觉得 ChatGPT、Claude、Kimi 明显更好,最后天天打开浏览器,那这台机器除了让我多一个玩具,好像也没什么意义。
所以我真正想知道的不是“本地模型能不能运行”,而是本地能跑的单体模型,离现在主流模型到底还有多远。查完以后,我觉得这个距离比自己原来想象得近。
拿 Qwen3.5-35B-A3B 来看,它是一个 35B 总参数的 MoE。Qwen 官方公布的数据里,它的 MMLU-Pro 是 85.3,GPT-5-mini 是 83.7;GPQA Diamond 是 84.2 对 82.8。到了 SWE-bench Verified,它又落后一些,是 69.2 对 72.0;LiveCodeBench v6 则是 74.6 对 80.5。
Agent 相关的数据更有意思。TAU2-Bench 上,35B-A3B 是 81.2,GPT-5-mini 是 69.8;BrowseComp 是 61.0 对 48.1,BrowseComp-ZH 是 69.5 对 49.5。
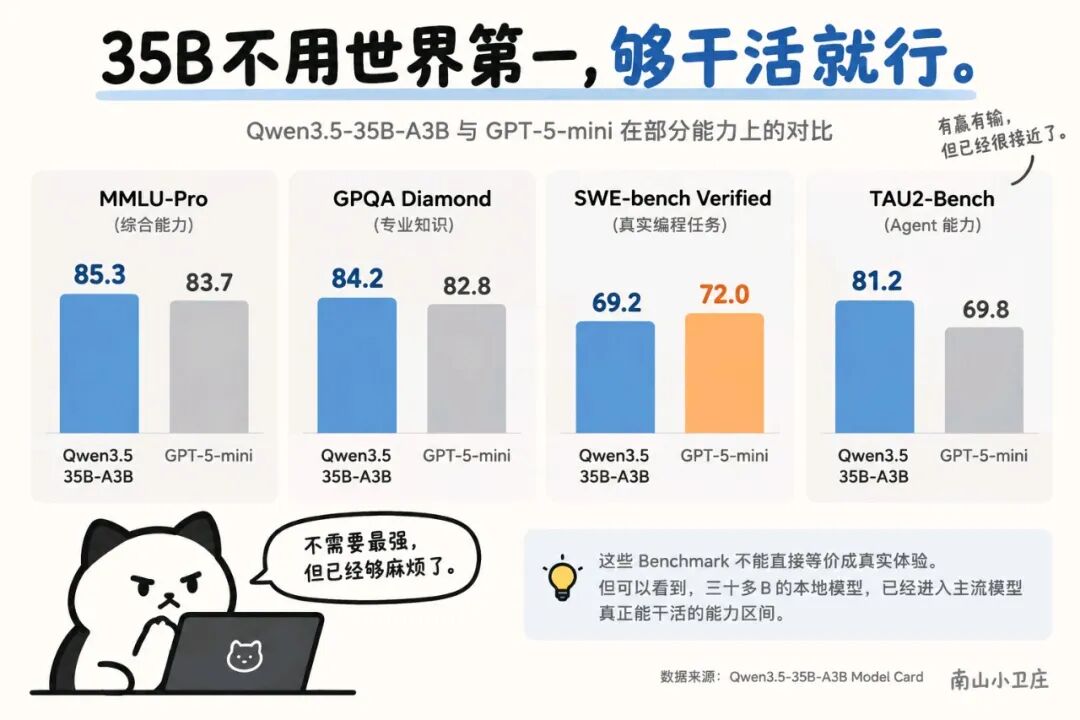
这些 Benchmark 当然不能直接等价成“35B已经超过GPT-5-mini”,更不能代替自己的真实体验。但对我来说,它们已经回答了一个更重要的问题:三十多B这个体量,已经不是“没网的时候凑合用”的水平了,它开始进入主流模型真正能干活的能力区间。这就够了。
因为我从来没指望一台本地机器解决世界上所有问题。只要它能覆盖每天大量的信息处理、代码、分析、工具调用和普通推理,真正极难的问题再去找最强的模型,这台机器就已经有价值。
本地单体模型不需要成为 SOTA,只要已经进入主流模型的能力区间,能够独立解决大部分日常问题,它就跨过了“值得买设备”的第一条线。
但真正让我觉得这件事可能越来越有意思的,反而不是 35B。是 14B。
我后来看到 AReaL 团队做的 14B Coding 模型。在他们公布的一组结果里,LiveCodeBench v5 做到了 69.1,同表里的 Qwen3-235B 是 70.7,OpenAI o3-mini Medium 是 66.3;Codeforces Elo 则分别是 2044、2056、2036。
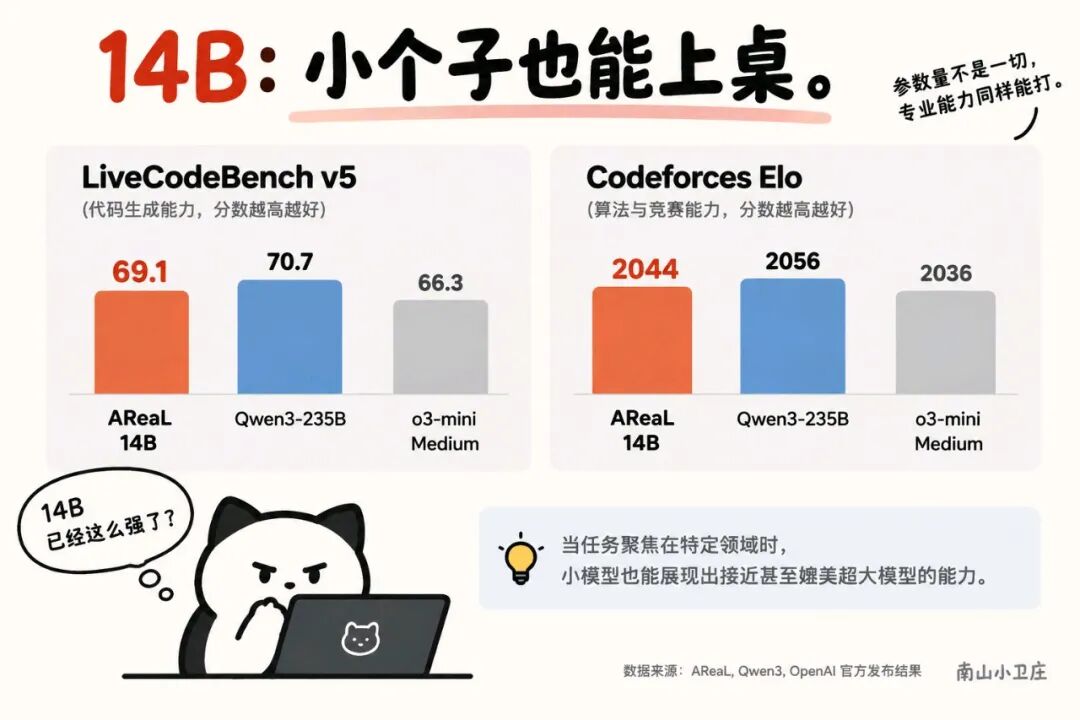
一个 14B 模型当然不可能在所有能力上和两百多B甚至最强闭源模型相比。但任务一旦收窄到一个专业领域,情况就开始变化了。
这件事对我的影响甚至比 35B 的 Benchmark 更大,因为它意味着以后可能根本不需要养一个全能选手。
平时让通用模型干杂活,Coding 找 Coding 模型,安全找安全模型,前面大量 Agent 循环交给更快的 MoE,真碰到硬骨头再把 27B Dense 叫出来。一个人包打天下很难,但组个队,好像突然就现实多了。
通用模型负责把能力底座托起来,专业小模型负责在特定方向把能力顶上去——这才是本地 AI 真正开始变得有意思的地方。
到这里,我第一次觉得:这机器好像真的可以买。然后我又犹豫了。因为模型半年就能换,机器不能。
五、两年以后,这台机器会不会直接废掉?
这是我当时特别纠结的一个问题。
今天 27B、35B 很好,万一两三年以后所有真正好用的模型都变成 100B、200B,我今天按照三十B左右买的设备,不就直接卡死了吗?
所以我们又往回看了这几年模型能力怎么长。越看越觉得,模型能力增长并不是简单的 7B、14B、32B、70B、200B 一路往上堆,同一个体量里的能力也在快速增长。
训练数据在变,强化学习在变,蒸馏在变,推理方法在变,MoE 也在变。今天一个 35B-A3B,总参数虽然有三十多B,但每个 token 实际参与计算的只是一部分;14B 专业模型又让我看到,某一项能力完全可能在一个远小于前沿大模型的体量里被做得很强。
没人能告诉我 2029 年的模型到底会长成什么样,所以这里我不敢下什么确定结论。
但我开始愿意赌一件事情。
我买的不是今天某一个27B模型,而是未来几年20~35B这个本地模型区间继续进化的入场券。
如果这个判断成立,硬件和模型的关系就完全不一样了。今天住一个 Qwen,明年换一个更强的 27B,后年再换一个更好的 30B MoE。房子不变,住进去的人一直在变。
到这里,我才真正开始研究设备。
然后第一个现实问题,马上把很多方案排除了。
我得背着它走。
六、5090很快,可24GB先把我卡住了
如果这是公司机房里的服务器,其实没什么好纠结。显存不够就加卡,内存不够就加内存,速度不够继续堆。
但这是我自己买的机器。我要带去公司,也要带回家,偶尔还可能出差。服务器当然好解决,大不了堆显卡,问题是我总不能每天背着服务器上班。
所以“移动”这个条件一加进来,选择一下少了很多。
最自然的一条路当然是 NVIDIA。CUDA 生态成熟,算力强,推理速度也很诱人,于是一路看到移动端顶配 RTX 5090 Laptop,然后我碰到了一个数字:24GB。
NVIDIA 官方规格里,RTX 5090 Laptop GPU 就是 24GB GDDR7,显存带宽 896GB/s。
问题是我前面已经把主力攻坚模型看到了 27B Dense。如果是 FP8,单按每参数大约 1 Byte 粗算,光权重理论上就已经在 27GB 左右,还没算 KV Cache、上下文和其他运行开销。
5090 的算力当然猛,可模型还没开跑,先卡在门口了。
当然可以量化。Q8、Q6、Q5、Q4,一路往下压,27B 总能想办法塞进去。可问题马上又变成:为了适应我的电脑,我到底愿意把主力模型压到什么程度?
这有点像收拾行李箱。继续压当然还能压,问题是压到最后,皱掉的会不会刚好是我最在意的那件衣服。
普通聊天里,量化带来的一点损失可能根本感觉不到;但 Agent 要连续做几十次判断,我更在意的是,那一点能力损失会不会刚好出现在关键决策上。选错一个工具、误判一个异常,或者该继续的时候提前放弃,这些东西在平均 Benchmark 里未必特别显眼,落到一条真实任务链里却可能很要命。
所以我后来越来越不愿意为了迁就 24GB,把主力模型压得太狠。
也就是这个时候,Mac 重新进入了视野。
M5 Pro 最高支持 64GB 统一内存,统一内存带宽最高 307GB/s;MacBook Pro 的 M5 Pro 配置也提供 48GB 和 64GB 选项。
它当然不是“64GB显存”,GPU 性能和 CUDA 生态也不能和 5090 简单对等。但统一内存解决了一个非常现实的问题:在一台还能背着走的电脑里,我可以给模型留出远大于 24GB 的空间。
对我来说,移动端 NVIDIA 真正先碰到的不是算力墙,而是显存墙。
于是开始算 32GB、48GB、64GB。
算着算着,我又发现自己差点犯了一个特别傻的错误:我把内存全算给模型了。
电脑不要了?
我平时 Chrome 得开,微信得开,ChatGPT 得开,Terminal、IDE、代理和各种安全工具也都得跑。模型一启动,总不能把其他东西全关了,然后我坐在旁边等它吐字。
电脑毕竟是给我用的,不是给模型住的。
所以后来我判断内存够不够,慢慢变成了三个层次:模型能不能塞进去,能不能正常跑起来,以及模型跑着的时候,我还能不能正常用这台电脑。前两个只能证明机器能跑模型,第三个才是我要买的电脑。
32GB 不是住不下,只是模型一搬进来,KV Cache、Chrome、微信、IDE 就开始抢床位。64GB 当然舒服,可我又开始问自己,多出来的空间到底有多少是每天真正会用到的?
48GB 就这么一点一点冒了出来。
它不是最大,也不是最便宜,只是刚好开始覆盖我最常使用的那一段。
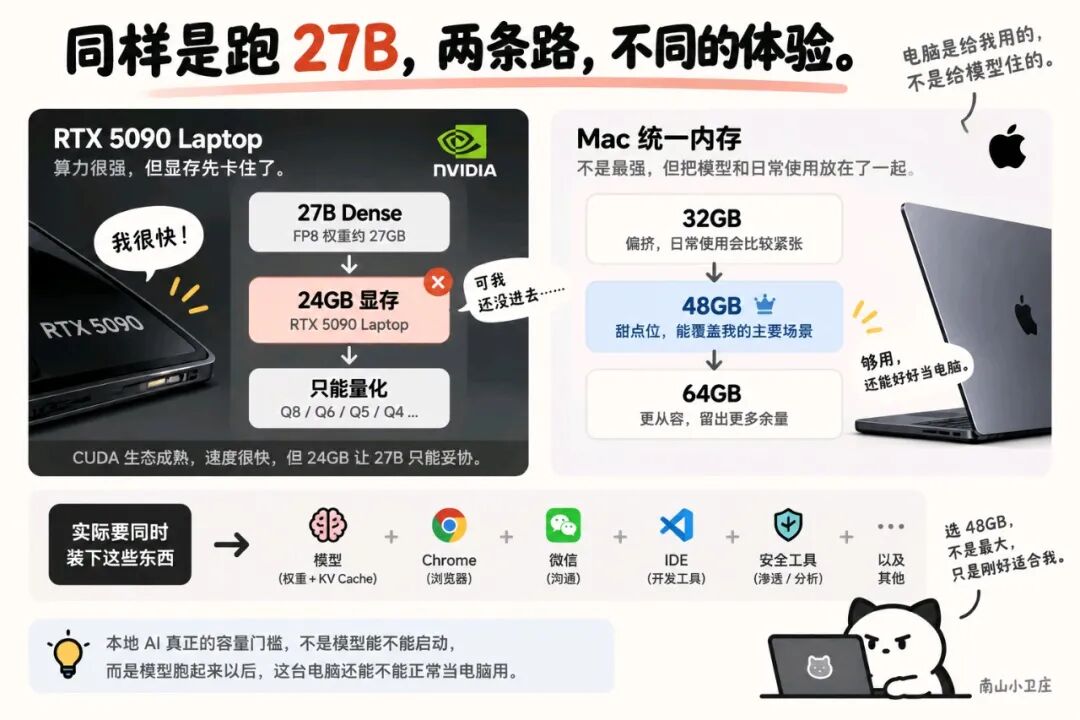
本地 AI 真正的容量门槛,不是模型能不能启动,而是模型跑起来以后,这台电脑还能不能正常当电脑用。
到这里,我还是没有下单。
因为还有最后一个问题。
模型装进去了,如果它说一句话要等半天呢?
七、30 tok/s够不够?最后这个问题反而改变了我的选择
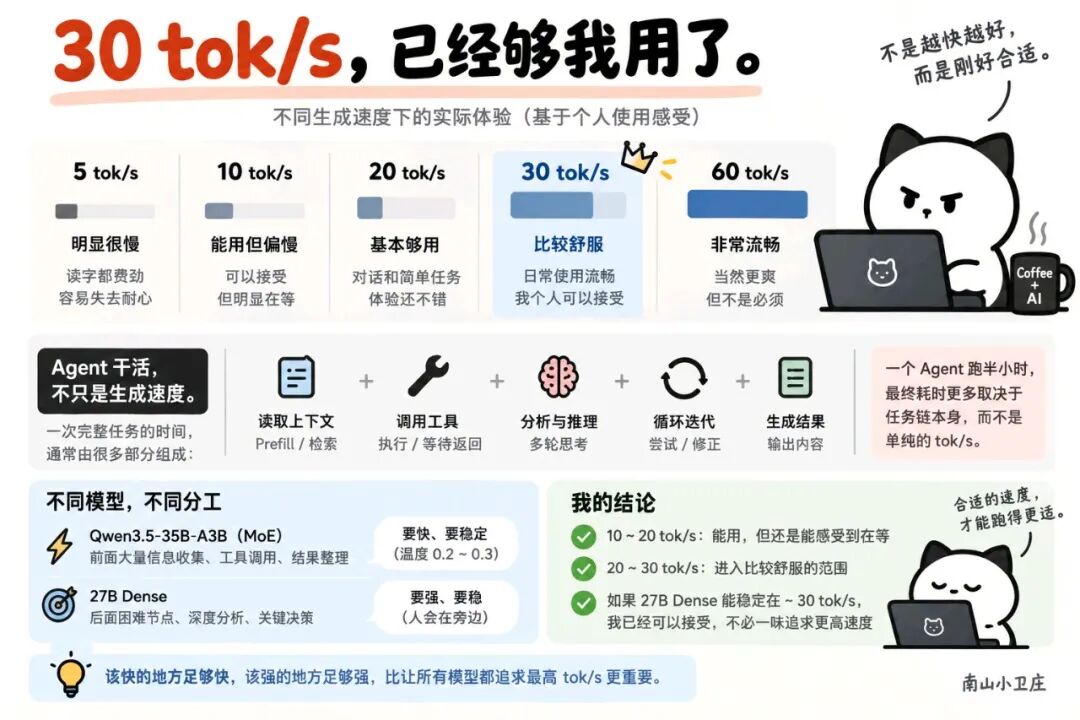
这是我后来特别在意的一组数字:5 tok/s、10 tok/s、20 tok/s、30 tok/s、60 tok/s。模型参数再漂亮,最后落到人的体感上,无非就是它到底多快把字吐出来。
按我自己的感觉,个位数 tok/s 已经会明显觉得慢;10~20 tok/s 能用,但还是能感觉自己在等;20~30 tok/s 开始进入比较舒服的范围。如果一个 27B Dense 能稳定在 30 tok/s 左右,我其实已经可以接受了。
一开始我还挺执着于继续往上追。30 能不能到 40,40 能不能到 50,当然越快越爽。
但后来讨论 Agent 的时候,我突然发现,自己可能把“聊天速度”和“干活速度”混在了一起。
Agent 真正跑起来以后,时间不只花在输出 token 上。它还要读上下文、做 Prefill、调用工具、等工具返回、重新分析,而且很多任务还会反复复用前面的上下文。一个 Agent 跑半个小时,到底是 28 tok/s 还是 35 tok/s,并不一定决定最后任务快多少。
更重要的是,我本来就准备让不同模型干不同的活。
前面大量的信息收集、结果整理、工具调用,可以交给 35B-A3B 这种 MoE。这部分很多时候我根本不准备盯着,它需要的是快、稳定。温度甚至可以压到 0.2、0.3,让它老老实实一直跑。
真正碰到困难节点,再切 27B Dense。这时候模型可能只有 20~30 tok/s,但问题是,攻坚的时候我本来就在旁边。我会看它为什么这么判断,看工具返回什么,看它是不是钻进了死胡同,甚至它还没输出完,我已经开始想下一步。
这时候 27B 从 30 tok/s 提高到 40 tok/s,对我的价值突然没那么大了。如果代价是把 Q6 压到 Q4,或者为了追速度牺牲我更在意的模型能力,好像反而不划算。
前面的 A3B 需要快,因为它负责大量无人值守的工作;后面的 27B 更需要稳和强,因为真正困难的节点,人本来就在环。
该快的地方足够快,该强的地方足够强,比让所有模型都追求最高 tok/s 更重要。
到这里,我脑子里那台机器的样子终于开始清楚了。
不过现在这些都还是纸上谈兵。机器还没真正拿到,所以我现在说 48GB 可能是甜点位、27B Q6 可能比较合适、30 tok/s 左右已经够我用、A3B 适合前面跑而 Dense 适合后面攻坚,前面其实都应该加两个字:暂定。
不过我已经决定了。
等机器真正到了,我准备把这些判断一个一个重新测一遍。模型到底能跑多快,Q4 和 Q6 在真实任务里到底有没有我担心的差距,长上下文开起来以后还剩多少内存,Chrome、微信、IDE 全开着还能不能舒服地跑,Agent 连续工作几个小时以后又会冒出什么问题。
如果最后发现今天一半的判断都是错的,也挺好。至少现实又会逼着我们把理解往前改一版。
不过在讨论速度的时候,我们其实已经碰到了下一个更有意思的问题。
真正攻坚的时候,如果人本来就应该在旁边,那人到底在判断什么?为什么模型卡在一个点上,有时候我会觉得“再试试,这里有东西”,有时候却会直接告诉它“别打了,换一个”?
甚至还有一个更麻烦的问题:
就算这个点真的能打下来,它值得打吗?
这已经不是买什么机器的问题了。
下一篇再聊。