上一篇写完以后,机器终于到了。AI强到离谱,Anthropic开盒、中转站出卖,我们怎么办?
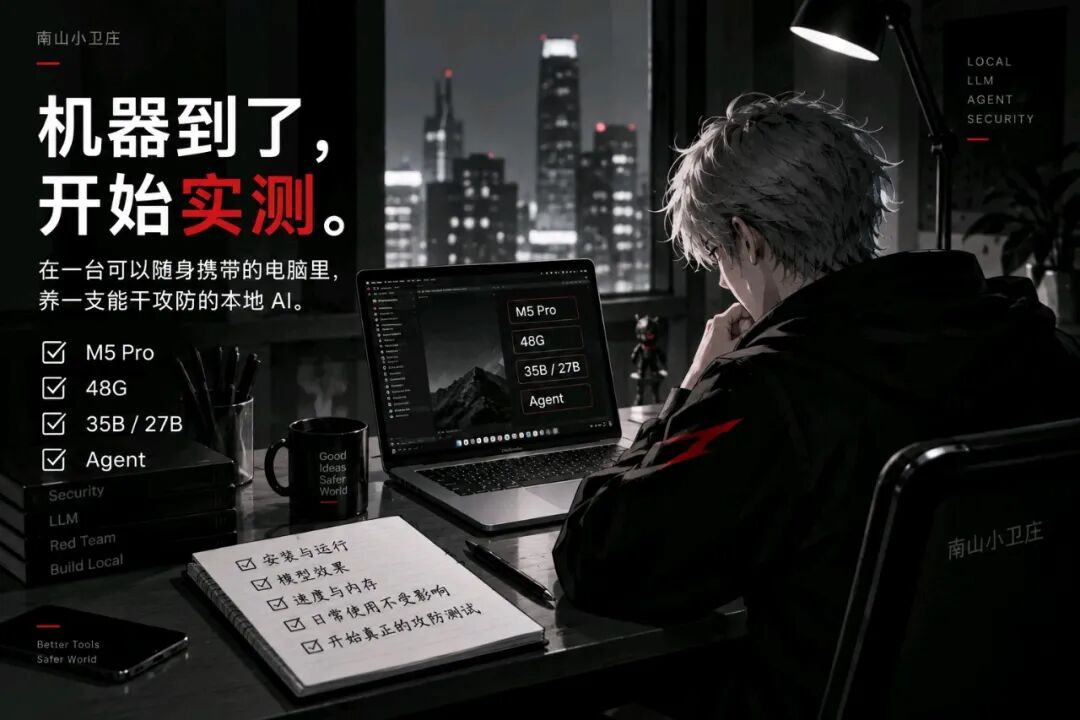
M5 Pro,48G。当时买它的目标其实很明确,不是专门买台电脑跑 Benchmark,而是想看看:能不能在一台每天背着上下班的电脑里,养一套真正能干攻防的本地 AI。
30B 左右,能力不能太差;尽量无审查,Agent 跑到关键位置别突然收手;Token 管够,不用跑几轮就开始心疼钱。代码、日志、工具返回和完整上下文,也尽量留在自己的机器里。
上一篇这些都还是纸上谈兵。现在机器到了,模型也下好了。从安装、跑起来,到换量化、换推理框架、加速、缓存、自动切模型,前前后后折腾了一遍。
这里面真正有意思的,反而不是最后跑出了多少 tok/s。而是很多事情真的跑起来以后,和买机器之前想得并不完全一样。有些判断赌对了,有些被现实打了回来,还有些问题,根本是一开始问错了。
先说目前的结果。35B-A3B,真实长会话大概 43~51 tok/s。27B Dense,主模型保持 6-bit,从最开始的 10.4 tok/s,一路折腾到了 20.6 tok/s。
48G 没把 Chrome、微信、Codex 这些日常应用赶出去,32K 上下文也真的跑起来了。所以这篇不猜了。我们直接去看结果。
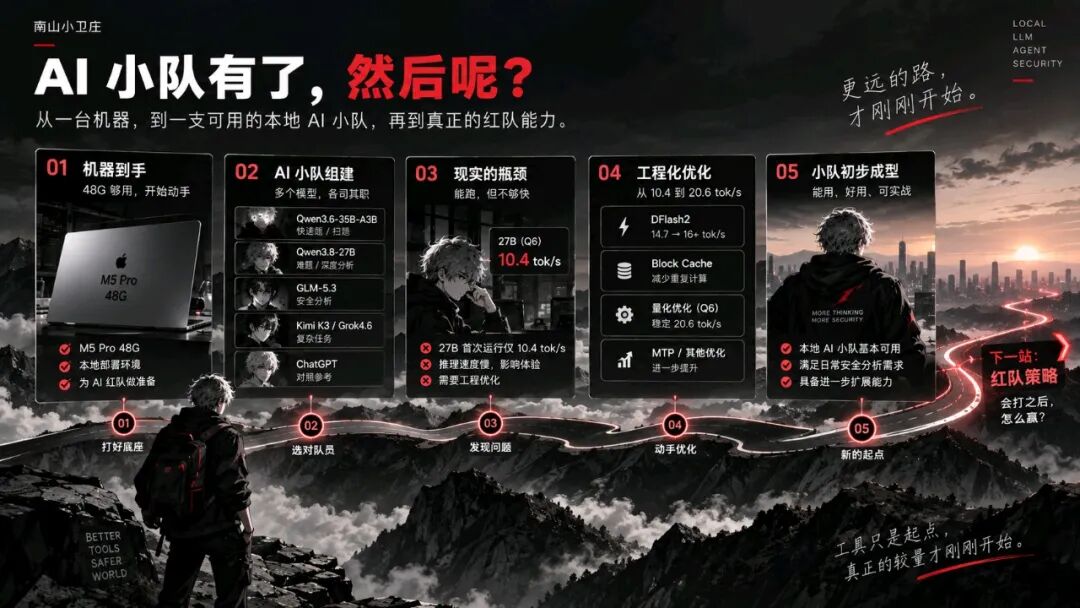
一、机器到了,先把 AI 小队装进去
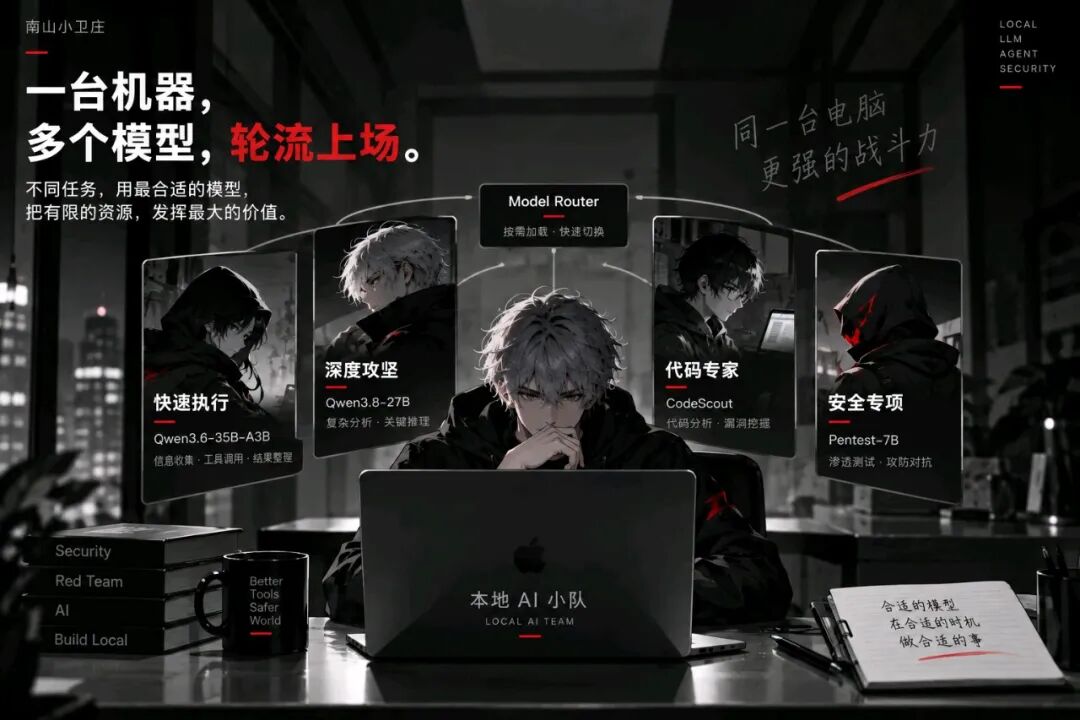
机器真的到手以后,第一个问题就来了。48G 的资源是有限的,到底应该塞进去一个尽可能大的全能模型,还是几个各有所长的模型? 最后还是决定试第二条路。
上一篇其实已经想好了一个大概的分工。前面大量信息收集、工具调用、结果整理,不一定需要一个特别大的 Dense 模型一直顶着,这里更需要的是快、稳定。真正碰到难点,再换一个能力更强的模型慢慢想。
所以机器到手以后,先后装了几类模型。主力快模型是 Qwen3.6-35B-A3B 的无审查版本,虽然有 35B 总参数,但每个 Token 实际激活大约 3B,比较适合前面大量跑。
真正准备拿来攻坚的,是 Qwen3.8-27B-Uncensored。Dense,27B,最后留在了 6-bit。另外还准备了 CodeScout、Pentest 这类更专业的小模型,以后代码分析、安全专项任务到底有没有优势,再慢慢测。
找这些模型时,有一个条件一直没变:尽量低拒绝,甚至直接找 Uncensored。 这不是为了养一个“什么都敢说”的聊天机器人,而是公网模型做攻防时的拒绝,之前已经真实遇到过很多次。
聊天拒绝一次最多重新问,Agent 跑了几十步以后在关键位置突然收手,损失的是前面整条任务链。授权范围、工具权限和任务边界既然已经控制在自己的环境里,更希望模型把已经开始的事情稳定做完。
还有一个变化,是以前用 API 时很难彻底忽略的:Token。 Agent 真跑起来以后特别能吃 Token,读代码、看日志、调工具、失败、回退、重新规划,一跑就是几小时。现在至少不用再盯着“这一轮又烧了多少”。
只要机器还开着,它就继续跑。
可真正把几个模型装进去以后,最开始那个矛盾马上出现了。48G 确实能装 30B,但不代表两个 30B 级模型可以同时舒服地常驻。 如果思路是“组一支队伍”,结果一次只能住一个,那这条路是不是从一开始就走不通?
后来才发现,这里其实把“组队”和“同时运行”混在了一起。
为什么一定要同时跑?
一次真正攻坚的任务,本来就只需要一个主模型。于是后来干脆做了一个 Model Router,客户端永远连接同一个地址。需要 35B 就自动加载 35B,需要 27B 就卸掉前一个再加载 27B,整个切换几秒钟。
测试下来,这件事反而比想象中简单。原来脑子里想象的那支队伍,终于真的住进了一台电脑,只是他们不同时上班。
本地资源有限,不一定意味着能力也只能选一个。
二、48G赌对了,速度却没完全赌对
队伍能装进去,接下来就是上一篇最纠结的问题:48G到底够不够? 不过真拿到机器以后,对“够”的标准已经变了。模型能启动,不叫够。
模型跑着的时候,Chrome、微信、Codex、Terminal 还能不能照常用,这台电脑才算真的够。
因为这是每天要背着上下班的电脑,不是模型服务器。如果为了跑一个 27B,每次都得先把其他应用全关掉,然后坐在旁边等它吐字,那前面所有参数算得再漂亮,也没什么意义。
所以干脆不清场。Chrome、微信、Codex、Terminal 这些平时该开的东西继续开,模型照样跑。后来甚至把 27B 推到了 32K 上下文。
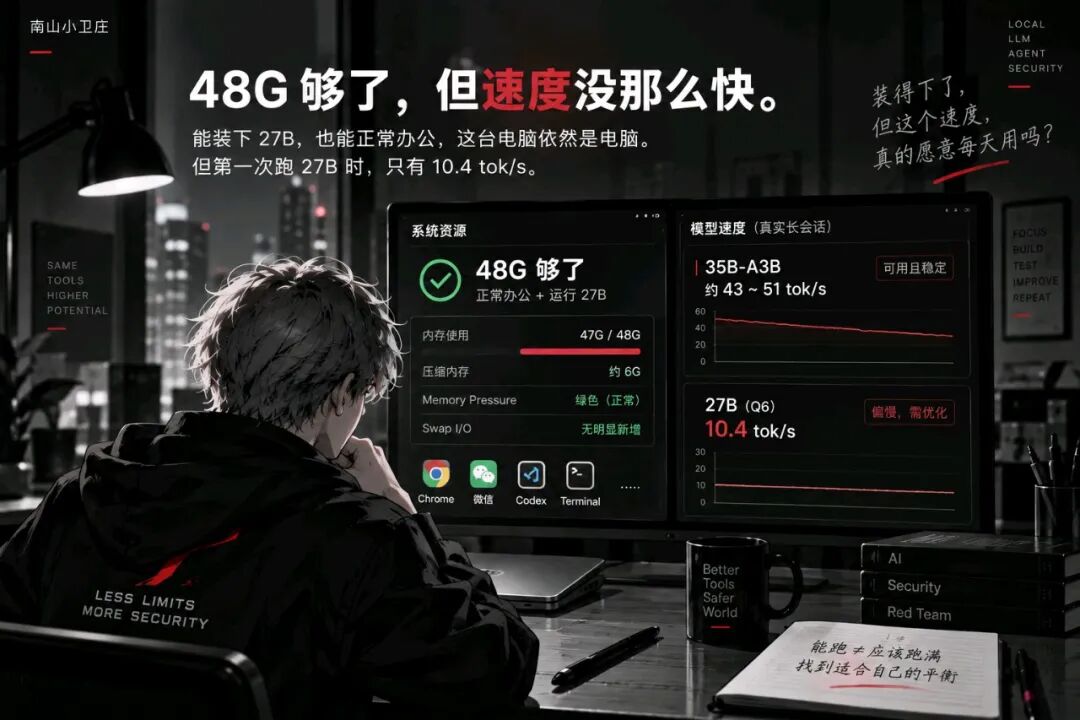
冷启动 Prefill 最极端的时候,整机内存使用一度接近 47G,还有大约 6G 压缩内存。但 Memory Pressure 仍然是绿色,也没有产生新的 Swap I/O。所以容量这一轮,基本赌对了。
至少它验证的不是:48G能不能塞进去一个27B? 而是:塞进去以后,这台电脑还能不能继续当电脑用? 目前答案是可以。
但 32K 跑起来以后,又发现另外一个问题。能跑,不代表应该天天这么跑。32K 更像一个保险,平时让 Agent 在 8K、16K 里保持一个相对干净的上下文,真有大量原始材料需要的时候再上 32K。
容量够,不代表资源就应该用满。
容量这边基本赌对了,速度却马上给了第二个问题。35B-A3B 刚开始看短输出时很漂亮,一度会看到 55~56 tok/s。但真正连续跑长会话以后,随着上下文不断增长,速度会逐渐往下掉。
大概从 51 tok/s,慢慢掉到 45.7,接近 29K 的时候平均大概 42.6。所以以前脑子里的“60+ tok/s”,现在已经不这么看了。真实长任务,大概 43~51 tok/s。
不过这个速度拿来跑前面大量无人值守的 Agent,已经挺满意了。真正让人皱眉的是 27B。第一次认真跑:
10.43 tok/s。
上一篇还在想,20~30 tok/s 应该就能接受。结果机器买回来以后,第一棒只有 10。48G 到底够不够,这个问题基本回答了,新的冲突马上变成:
装得下了,可这个速度,真的愿意每天用吗?
三、然后开始折腾,很多“优化”反而没用
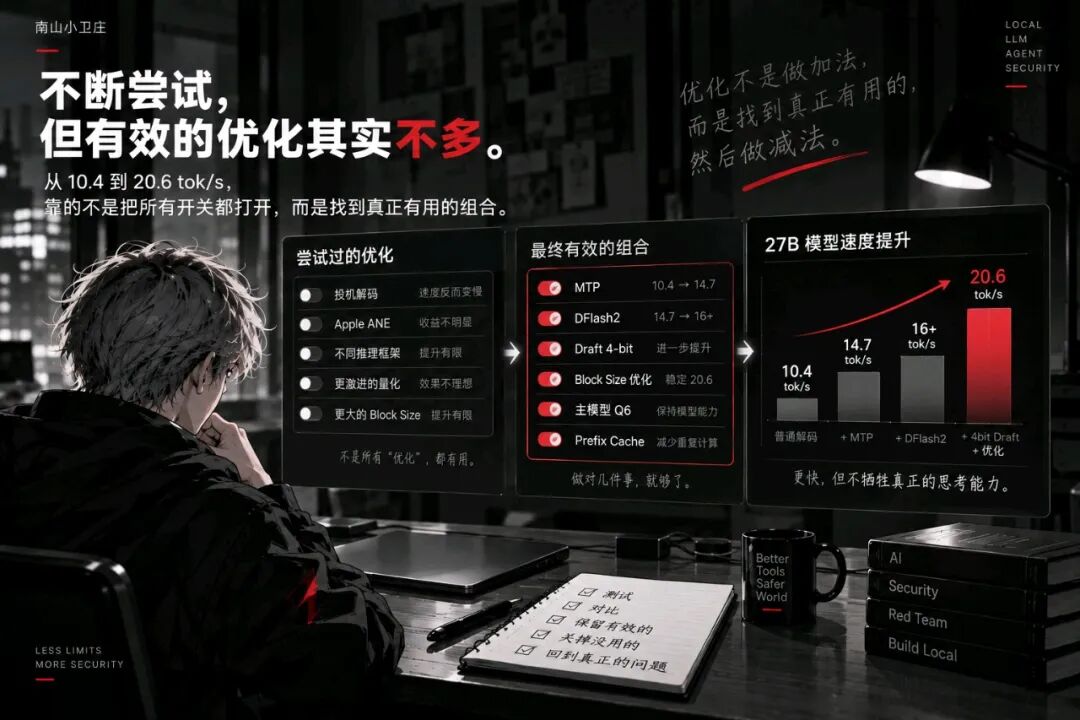
27B 只有 10.43 tok/s,最开始的想法其实特别简单:还有什么加速没开? MTP、投机解码、ANE、不同推理框架、Block Size……能开的都试试,不就快了吗?
然后真的开始一个一个试。最先觉得不太对的是投机解码。理论上挺美:一个更小的 Draft Model 在前面猜,主模型负责验证,猜对了一次就可以往前走好几个 Token。
听起来就是白捡的速度。结果给 35B-A3B 配上以后,原来挺快的模型反而掉到了二三十 tok/s。
优化完,更慢了。关掉。
后来又试 ANE,希望把一部分计算扔给 Apple Neural Engine。模型确实能放进去,但在 48G 这套配置下,额外的内存占用和调度并没有换来想要的收益。再关掉。
测到这里,一开始那个问题似乎问反了。
优化真的是“还有什么没开”吗?
真正有效的东西,后来出现在 27B 上。普通解码 10.43 tok/s,先上 MTP 到了 14.71 tok/s,然后换 DFlash2,到了 16~17 tok/s。
最后把 DFlash2 的 Draft 侧压到 4-bit,再一点一点测 Block Size。8K、512 Token 的完整测试最后稳定到了:
20.57 tok/s。
差不多翻倍。但这里真正重要的,其实不是 20.57 这个数字,而是:负责最后决策的 27B 主模型,还是 6-bit。
这正好回答了上一篇最纠结的一个问题。当时一直在想,为了把 27B 塞进机器、跑得更快,到底愿不愿意把 Q6 压成 Q4?最后现实给出的答案是:
先别动真正负责思考的那个模型。
可以让辅助它猜 Token 的小模型更粗一点,可以牺牲一些辅助计算的精度换速度。甚至某些所谓“优化”没有收益就直接关掉。但最终做判断的模型,能不牺牲就先别牺牲。
折腾到这里,对“优化”这两个字的理解已经和刚开始有点不一样了。不是把能开的东西全部打开,而是先找到真正卡住自己的那一个东西。 有时候,优化甚至是在做减法。
四、真正让人惊讶的,反而不是20 tok/s
27B 从 10 跑到 20,其实已经准备收工了。主模型没有降到 Q4,速度又差不多翻倍。上一篇给自己定的“20~30 tok/s 能接受”,至少已经摸到门槛。
可真正把它接进 Agent,又开始觉得哪里不对。如果 Agent 每走一步,都要重新读前面十几K、几十K的东西,那把 Decode 从20优化到25,真的有那么重要吗?
Agent 和聊天最大的区别之一,就是它会不停重复读东西。System Prompt 差不多,Skill 差不多,前面的工具结果也大量重复。Agent 每走一步,都把一大坨已经读过的历史重新送进去。
如果每一次都重新计算,Decode 再快,也可能一直在等。于是后来开始认真测 Prefix Cache。
16K 上下文第一次进去,要几十秒。第二次,相同的前缀已经在缓存里:
0.28秒。
后来又把缓存从 2G 加到 4G,32K 的前缀也终于装下了。第一次 121.96秒,第二次 0.50秒。
那一下带来的变化,其实比 10 tok/s 变 20 tok/s 还明显。因为前面的那个问题突然有答案了:
Agent 的速度,好像根本不能只看 tok/s。
真正干活的时候,时间还花在 Prefill、上下文、工具调用、模型切换、重复计算,甚至失败以后重新走一遍。于是现在这套配置反而越来越简单。
35B-A3B 负责快,27B Q6 负责难。DFlash2 负责把 27B 加速到一个能接受的范围,Cache 负责不要反复读已经读过的东西,Router 负责几秒钟把该上场的人叫出来。上下文能不开 32K,就别开 32K。
这时候一个判断开始越来越清晰:
少做一次没必要的事情,有时候比把模型再提速20%更值钱。
开始还只是把这句话理解成计算优化。后来准备真正拿它做红队的时候,才发现这句话可能还有另外一层意思。
五、AI小队有了,然后呢?
折腾到现在,上一篇留下来的几个问题,至少已经有了一个当前版本的答案。48G够不够?对现在20~35B、本地Agent、每天还得背着上下班的需求,够。
无审查模型能不能真正跑?能。30B级模型是不是只能“勉强启动”?也不是。
35B-A3B 真实长会话大约 43~51 tok/s,已经可以承担前面大量自动执行。27B Dense 主模型保持 6-bit,8K 下目前做到 20.6 tok/s 左右,也已经到了愿意坐在旁边拿它攻坚的程度。
Token 不用再按调用次数算钱,数据、代码、日志、完整上下文可以尽量留在自己的机器。Router 让不同模型轮流上场,Cache 又让它们不用每一轮重新读一遍过去。
所以如果把上一篇最开始的目标拿回来:能力够强、Token管够、数据留在本地、授权攻防里尽量不拒绝。 现在至少已经从“可能行”,变成了:
真的可以开始干活了。
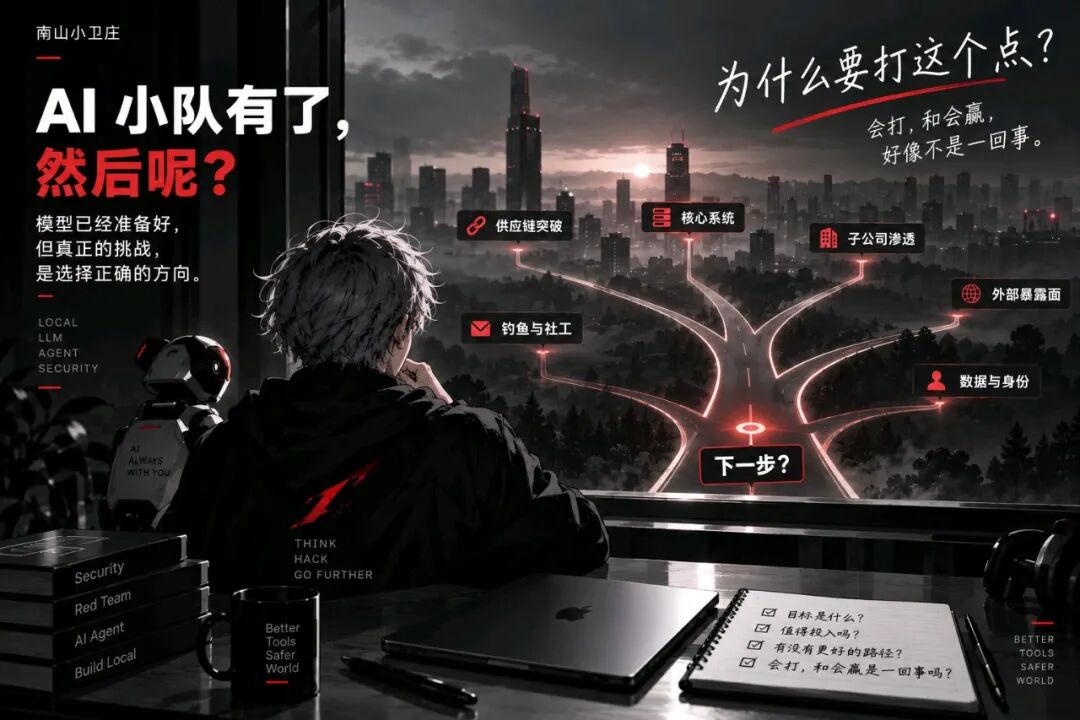
按理说,折腾到这里应该挺开心。可真正准备把这套东西放进红队流程的时候,一个之前一直被硬件、模型和速度挡在后面的问题终于冒了出来:
模型跑起来以后,到底希望它学会什么?
假设 A3B 扫到一个异常,试了一次,失败;换一个方法,又失败。什么时候应该继续?什么时候应该把 27B 叫出来?什么时候其实应该马上放弃,去看另一个地方?
如果只是规定“失败三次就换路”,好像也不对。因为方法失败,不代表那个地方真的没有问题。
更麻烦的是:
就算这个点真的能打下来,然后呢?
如果花一个小时拿下来的东西,对后面的攻击路径一点帮助都没有;而另外一个看起来不起眼的点,一旦进去就能拿到身份、权限,甚至打开一整片新的攻击面——AI应该把时间花在哪里?
想到这里,突然想起以前见过的一支红队。他们留下最深印象的,不是某一个特别炫的漏洞,也不是某一个人技术有多猛。
而是他们特别会找地方。
供应链、子公司、钓鱼……正面很硬的时候,他们似乎从来不执着于证明自己能把最硬的地方啃下来。他们更在意另一件事情:
哪里最薄弱,突破以后又最有价值。
前面一直在优化一个问题:怎么让AI更快地把一个点打下来。 可想到那支队伍以后,才发现真正重要的问题,也许应该再往前一步。
为什么要打这个点?
如果方向错了,模型跑得越快,可能只是在更快地浪费时间。
会打,和会赢,好像不是一回事。
下一篇聊这个。
完整配置参数和 Benchmark,另外整理成一份:
《M5 Pro 48G|30B级本地无审查模型实测与优化记录》留给真的准备自己跑的人。
如果对自己🈶用,点👍收藏吧,
如果对朋友🈶用,点❤️转发下!
感谢支持❤️!!!