那几天一直在做 CTF晚上停下来的时候,头有一点疼。倒没有什么大影响,只是脑子明显已经跑得太久了。回头看这一个下午,真正让我停不下来的,后来已经不是题本身,而是一个越来越奇怪的现象。
我们为了比赛,请教了专门打 CTF 的师傅,装了专业的 Skills,选了专业的模型,换了不同的 Agent 客户端,本地执行环境也准备好了。几乎能装的装备,都装上了。
然后,一个什么 CTF Skills 都没装、只带着通用沙箱的 GPT 上场了。
我们这边有些题跑了三四十分钟,Token 还在不停地滚,甚至最后没有结果。它三五分钟,flag 已经拿到了。
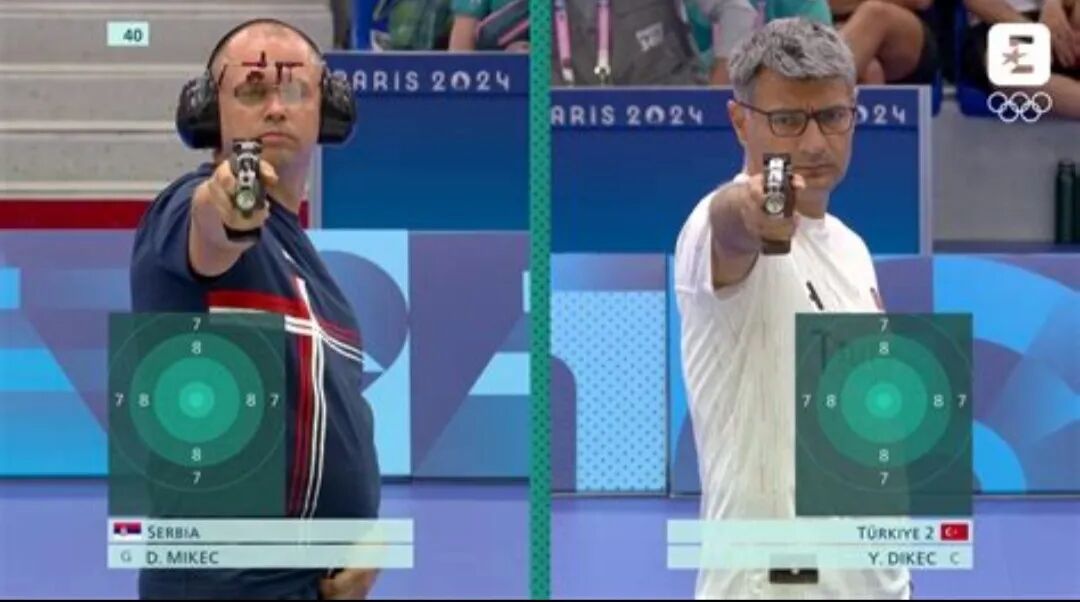
那一刻让我想起 2024 年巴黎奥运会上那个土耳其射击运动员优素福·迪凯奇。别人各种专业装备戴得整整齐齐,他戴着一副普通眼镜,一只手插在兜里,举枪,射击。
但现在想想,这个比喻甚至还不够准确。
这一次不是全副武装输给了穿休闲装的人,是你还在全副武装地战斗,人家已经结束比赛,连背影都看不到了。
一、一开始,我们就是全副武装的
因为要打比赛,我们没有自己瞎摸索。一开始就请教了专门打 CTF 的师傅:现在用 AI 打 CTF,应该怎么打?
师傅的建议很明确:要装专门做 CTF 的 Skills,要使用适合这类任务的模型,还要配能够读文件、写代码、调用工具的 Agent 客户端。当时他比较推荐的是:
K3 + Kimi Code + CTF Skills。
所以后来的测试,并不是几个模型打开聊天窗口随便问问。它们有专业 Skills,有 Agent 客户端,也能够直接在我的 Mac 上执行代码,模型可以分析文件、写脚本、运行、读取结果,再继续往下走。
但最开始使用 GLM-5.2、Kimi 2.7 等模型时,体验并不好。有些题一跑就是三四十分钟,甚至四五十分钟。
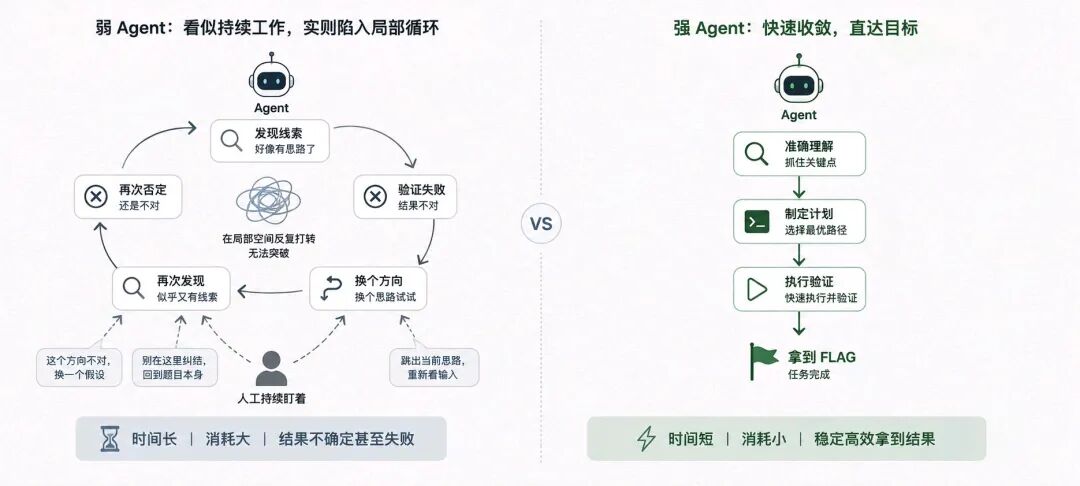
更折磨人的,其实还不是等,而是你会一直看着它“思考”。Token 一行一行往下滚,一会儿它说“有重大发现”,心里也跟着一提;过一会儿又变成“这个方向不对,需要重新分析”。
继续跑一会儿,它突然又找到一个线索,你又觉得这次可能真的快出来了。那半个小时里,模型的判断一直在跳,人的心情也跟着它一起跳。
看起来它一直在工作,每一步似乎也都有理由。但最后回头一看,它有时候只是不断在几个方向之间来回打转。
当时甚至一度让我怀疑:是不是题有问题?
现在想想,这个怀疑很有意思。当你已经按照专业经验,把模型、客户端、Skills、执行环境都配齐以后,跑了四五十分钟还是做不出来,人很自然会开始怀疑外部。
也许附件不完整,也许题本身有坑。后来才发现,题可能一点问题都没有。
二、模型一直在动,但却停在原地
后来看到一些关于 GLM-5.3 网络安全能力的宣传,我们又赶快想办法换上了 GLM-5.3。相比 5.2,确实能够感觉到提升,但没有特别大。
真正第一次让我明显感觉到台阶变化的,是师傅推荐的 K3。以前有些模型跑半个小时,最后还不知道有没有结果;K3 在不少题上,半个小时左右已经能够真正解出来。
按照那天下午非常粗略的体感,成功率可能到了四五成。后来又用了 gk 4.6,差距再次出现。
时间其实仍然大致在半小时以内,但当时测试的那批题里,大部分已经能够真正走到最后,体感成功率接近九成。这些数字当然不是 Benchmark,只是一次真实使用中的观察。
真正让我在意的是:
同样是“跑了半小时”,原来可以是完全不同的半小时。
一个模型可能消耗大量 Token,不断尝试,最后什么都没有。另一个模型时间差不多,却已经把事情做完了。
CTF 恰好把这种差异放得特别大,因为它不是一次问答,而是一个不断循环的过程:判断、执行、反馈、修正,再判断。
模型每一步只差一点,几十轮以后就可能完全不同。一个模型很早踩中关键路径,另一个模型则像一只热锅上的蚂蚁,一直在走、一直在转,但就是走不出去。
当时师傅还提醒过我们,如果模型卡住了,人要进去介入一下,帮它调整思路。当时觉得这只是一个使用技巧,现在再想,这句话其实暴露了一个很重要的问题。
当模型能力还不够的时候,人并没有真正退出执行。
模型负责跑,人负责看方向。一旦它陷入循环,人要告诉它这个方向不要继续了,换一个假设,重新看题,甚至直接把它从错误的问题空间里拎出来。
所以所谓“AI 自己跑了半小时”,其实不只是半小时的 Token。旁边还站着一个人,一直盯着它。
这让我第一次觉得:
Token 一直在滚,只能说明模型还在工作,不能说明问题正在向前。
三、后来发现,模型也不是全部
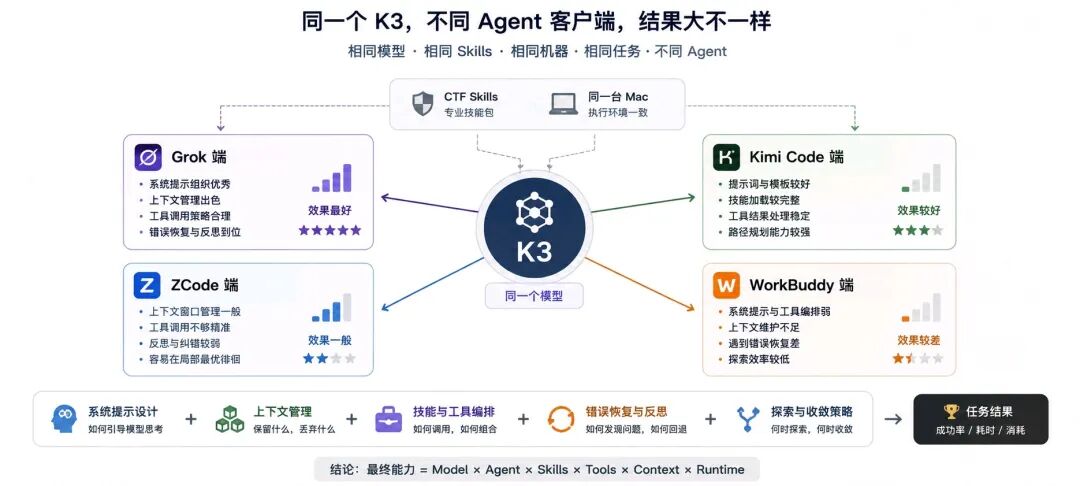
测试 K3 的时候,我又做了一件很随意的事情:把同一个 K3 放进不同 Agent 客户端里跑。
Gk、Kimi Code、ZCode、WorkBuddy。这些环境都装了 CTF Skills,代码也都在同一台 Mac 上执行。
至少表面看起来,模型相同,机器相同,任务相同,也都有专业 Skills。主要变化的只是 Agent。结果却不一样。
按照那天下午的实际体感,大致是:
Gk 端 > Kimi Code > ZCode > WorkBuddy。
甚至还出现了一个交叉:
K3 + Kimi Code,优于 GLM-5.3 + ZCode。
这一下,“哪个模型最强”这个问题突然变得没那么简单了。如果客户端只是模型外面套的一层壳,同一个 K3 放在哪里,表现应该差不多,但实际不是。
System Prompt 怎么组织,Context 怎么维护,Skills 怎么加载,工具结果怎么反馈,走错以后怎么恢复,什么时候继续探索,什么时候收敛,这些藏在 Agent 后面的东西,都在改变模型最终能够发挥出来多少能力。
这也带来了第一个让我有点后怕的发现:
如果你最强的模型,放在别人家的客户端里,比放在自己的客户端里表现还好,会怎么样?
模型是你的,但别人可能比你更会使用它。拥有最强模型,和拥有最强的 AI 产品,原来可能是两件事。
四、然后,穿休闲装的人已经走了
真正让我意外的还是 GPT。
前面的模型,我们已经按照专业师傅的建议,把该准备的基本都准备了。到了 GPT 这里,反而没有准备什么。
没有专门安装 CTF Skills,就是普通的会话,加一个通用沙箱。而且因为安全边界,中间还拒绝了我不少次。但有些题,三五分钟就做完了。
这时候再回头看前面那些跑了半个小时的 Agent,感觉突然不一样了。因为这已经不只是:
30 分钟 vs 3~5 分钟。
30 分钟背后,还有巨量 Token,还有不断的工具调用,还有失败以后重新探索,也还有旁边那个一直盯着它、随时准备纠偏的人。
而三五分钟那边,分析、执行、结果,然后结束。
所以我前段时间看到一句话:
Token 和 Token 是不一样的。
刚看到的时候,只觉得有道理。那天下午重新想起这句话,却突然有点后怕。
因为一个 Agent 可以烧掉几十倍 Token,最后产出是 0;另一个只消耗很少的 Token,产出是 1 个完成的任务。这两个 Token,应该怎么比较?
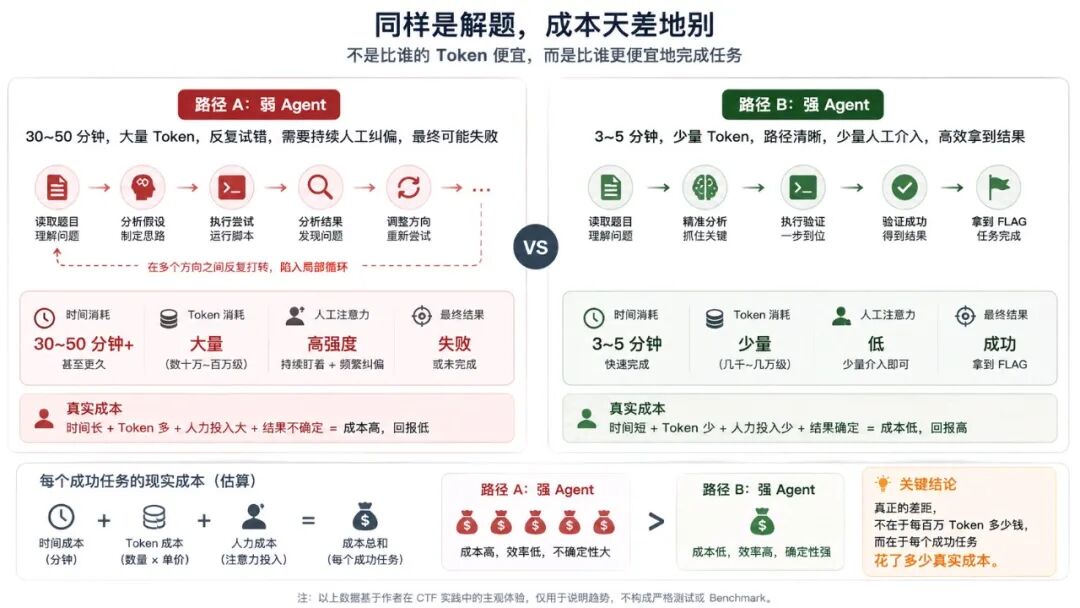
这时候再看“每百万 Token 多少钱”,突然觉得这个指标有些单薄。
一个模型的 Token 单价便宜十倍,如果它需要几十倍 Token,跑更长时间,还需要一个专家在旁边不断纠偏,最后甚至可能失败,它真的便宜吗?
反过来,一个模型单价很贵,但几分钟就把事情做完,也许它才是便宜的那个。
便宜地消耗 Token,和便宜地完成任务,是两件完全不同的事情。
五、也许真正昂贵的是人的注意力
这个下午还让我重新想起我们以前讨论过的一个判断。
我们曾经设想,未来一个团队可能不再需要那么多执行人员。留下一个负责人,一个领域专家,再有一个负责维护 Agent 平台的人,大量具体工作交给数字团队执行。
以前这更多是一种对未来组织的想象。这次 CTF,却让我第一次看到了一点它可能发生的过程。
当模型还比较弱的时候,专家其实走不了。Agent 在前面跑,专家在后面盯,发现它陷入循环,赶快进去调整方向。
这时候 AI 替代的只是手,方向仍然在人这里。而当模型强到能够自己发现错误、退出错误路径、重新规划,最后直接把结果交回来时,专家才第一次真正有机会退出执行循环。
也许真正的分界线从来不是:AI 会不会干活。而是:人能不能离开。
真正的自主,也许不是 Agent 可以自己运行半小时,而是你把任务交给它,然后去做别的事情。回来以后,只需要验收结果。
这时候被节省下来的,就不只是 Token,还有组织里可能更加昂贵的东西:专家的注意力。
六、AI重新定义专家的边界
顺着这个问题继续想,又出现了一个新的矛盾。如果模型越来越强,专家是不是也会越来越少?
也许会。
但留下来的那个专家,可能必须非常强。以前一个七十分的专家,也许已经可以指导一个五十分的 Agent;当模型自己到了八十分以后,这个专家就很难再给它提供方向。
真正还能站在它旁边的人,可能必须是九十分、九十五分,甚至能够发现当前最强模型都发现不了的问题。
而这样的专家,又会产生另一个变化。
过去一个很强的专家只能是一个人。他一天只有二十四小时,只能带有限的人、处理有限的问题。
但如果他的经验、判断、方法,甚至解决问题的轨迹能够被训练、蒸馏、沉淀进模型呢?一个专家的能力,就可能被复制到很多地方。
于是未来真正稀缺的,也许不再只是“有多少专家”,而是:谁还能产生模型里没有的新能力。
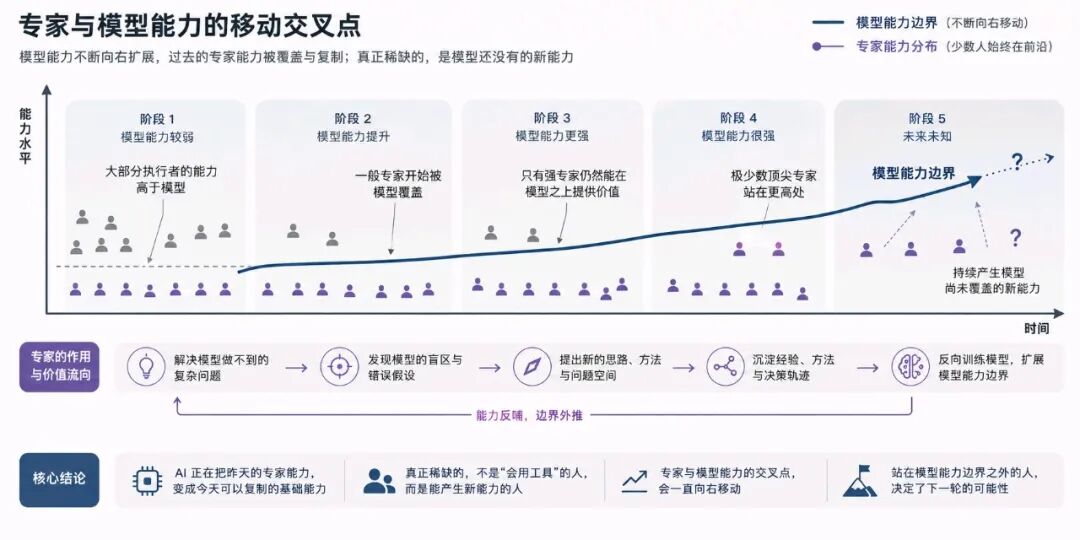
这条线最后会移动到哪里,我不知道。而且 CTF 是一个结果特别明确的场景,flag 要么拿到了,要么没有。
换成管理、战略、审美、关系这些没有明确 flag 的事情,这条线可能完全不一样。所以现在还不急着给答案。
但至少那天下午让我看见了一件以前只是模糊感觉到的事情:
AI 正在不断把昨天的专家能力,变成今天可以复制的基础能力。
而人的专家角色,也许只能不断往模型还没有覆盖的地方走。
七、最后留下来的,不是模型排名
晚上头有一点疼的时候,我才发现自己下午其实换了很多把尺子。
最开始比较的是哪个模型更强,后来变成哪个 Model + Agent 组合更强。再后来发现,真正应该看的也许不是模型、Token,甚至不是运行时间。是到底花了多少现实成本,把事情从 A 推到了 B。
Token 一直滚,不代表问题一直向前。Agent 一直运行,不代表人已经退出。
模型很便宜,也不代表完成任务很便宜。拥有最强模型,也不代表拥有最强的 AI 产品。
至于未来一个团队究竟需要多少人,需要什么样的专家,模型和专家能力的交叉点最后会走到哪里,现在都还不知道。
但有一件事情,那天下午已经变得很难再忽略。
我们全副武装,模型、Agent、Skills、工具全部装好。屏幕上的 Token 还在不断往下滚:“有重大发现”“方向不对”“重新分析”。
我们还盯着屏幕,等着下一次转机。而那个穿休闲装的人,三五分钟前已经拿到了 flag。
等我们终于抬起头。连背影都看不到了。