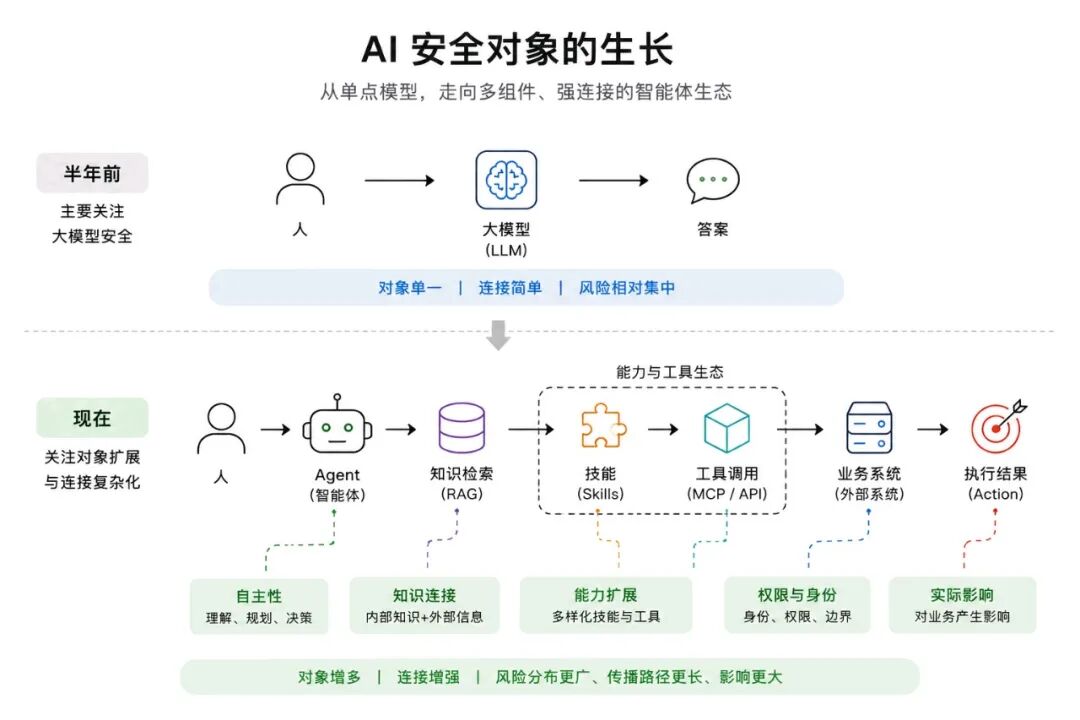
大概半年前,我们做过一次AI安全的行业调研。那时候聊AI安全,大家的注意力还比较集中在大模型上。内容安全、Prompt Injection、越狱、敏感信息泄露、模型幻觉、安全评测、安全网关……这些是当时经常聊到的东西。当时我们脑子里的AI,大体还是:人 → Prompt → 大模型 → Answer。
半年以后,又做了一轮行业调研。中间陆陆续续聊了10多家AI安全厂商,看了不少方案,也和同行交流了很多。第二次再回头看,变化已经挺明显了。RAG已经很常见,Agent开始真正进入企业,MCP和Skills又很快冒了出来。模型开始连接知识、工具、权限和业务系统,AI也从一个“回答问题的东西”,逐渐变成一个“可以做事情的东西”。
但这半年对我影响最大的,可能还不是多认识了几个新的技术名词。而是看得越多,我越觉得:每个人嘴里说的“AI安全”,好像都不是同一个东西。
一、看10多家方案以后看到的“不同”
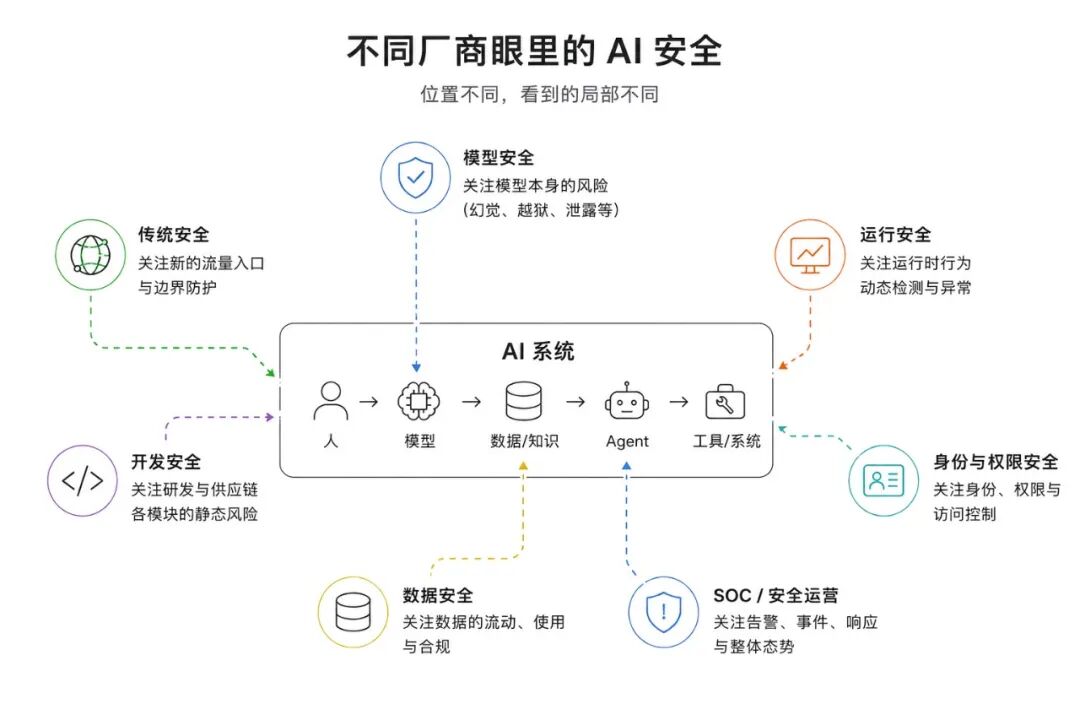
不同厂商的方案差异非常大。最开始我会下意识地比较:谁做得完整,谁做得不完整。看多了以后,慢慢发现,可能还不完全是完整不完整的问题。他们站的位置本来就不一样。
传统安全厂商进入AI安全,通常会从自己原来已经有的能力开始。原来做网关的,会寻找AI新的流量入口;做数据安全的,会把Prompt和Response当成新的数据流;做WAF、SOC或者其他安全产品的,也很自然地尝试把原来的检测、防护、告警能力往AI上迁移。这些能力当然有很多可以复用,但有些方案看久了,总觉得哪里有点别扭。
后来我才慢慢意识到,也许是顺序的问题。如果先拿自己已有的能力去找AI的问题,很容易最后把AI安全做成传统安全能力的重新包装。
开发安全背景的厂商又不太一样。他们熟悉的是研发安全生命周期,所以看到AI以后,很自然会往研发阶段走。模型、代码、RAG、MCP、Skills、Agent,一个一个拆开,对各个模块做检测,整体偏静态扫描、组件检测、供应链检测。这种思路对上线前、入库前发现问题很有价值,但它更擅长回答:“这个东西本身有没有问题?”
等AI真正跑起来以后,问题又变了。一个Skill本身可能没问题,一个MCP Server也可能没问题,Agent也没有明显漏洞。但它们组合起来以后,Agent为什么调用这个Skill?为什么在这个场景里获得这个权限?几个正常能力组合以后,会不会完成一个不应该完成的动作?这些已经很难只靠静态扫描回答。
运行环境安全背景的厂商,看到的又是另一张图。他们更习惯让AI真正跑起来,然后观察Prompt经过了什么链路、模型返回了什么、Agent调用了什么工具、参数是什么、有没有越权、有没有异常行为。所以方案自然会偏向:运行 → 观测 → 动态检测 → 异常识别 → 告警 → 阻断/响应。
开发安全在看“它带着什么问题进来”,运行安全在看“它跑起来以后发生了什么”。再加上模型安全、数据安全、身份安全、SOC、安全运营……聊得越多,我越有一种感觉:大家讲的都是AI安全,但脑子里其实不是同一张图。
二、厂商的问题也可能发生在自己身上
一开始看这些差异,很容易觉得这是厂商的路径依赖。做什么出身,就容易把AI安全理解成什么。后来自己开始整合方案,我突然意识到:甲方其实也一样。
安全人员看AI,很容易先看到攻击和漏洞。开发安全负责人,会看到研发阶段和供应链;安全运营负责人,会看到告警、事件、响应和复盘;安全负责人再往上一层,会开始看到制度、责任、流程和管理。如果再从整个信息技术的角度往下看,看到的可能已经是业务、办公、研发、运维,以及合规、业务、安全共同组成的一套AI安全治理。
大家看到的都是真的,但每个人都很容易把“我看到的AI安全”,慢慢理解成“AI安全本来就是这样”。而厂商还会再叠加一层:我有什么。 于是,我站在哪里 × 我手里有什么,很容易影响我认为AI安全是什么。
这件事情后来对我影响挺大。因为当我自己开始整合方案的时候,我也不可能天然客观。我同样有自己的专业背景、职责、经验和已有的安全能力。
所以后来我越来越觉得,做这种复杂方案的时候,可能需要先做一个有点反直觉的动作:我与我无关。
先暂时忘掉我是做什么的,也暂时忘掉手里已经有什么产品。先看看AI自己到底长成了什么样:有哪些对象?这些对象怎么连接?它们进入了哪些场景?风险从哪里产生?怎么传播?最后影响什么?
等这张图慢慢清楚以后,再把“我”放回来。我负责什么?哪些应该由别人负责?现有能力能接住什么?还有什么需要补?
先让“我”退出问题,再让“我”回来解决问题。
现在回头看,我觉得这可能是这次做方案过程中一个挺重要的变化。因为只要“我”一直站在问题中央,我看到的就很容易是这个对象与我的关系,而不是这个对象自己是什么。
三、把自己拿掉以后,我先重新看了资产
以前做安全方案,很容易从风险清单或者安全产品开始。这一次后来慢慢变成了先看:AI到底已经形成了什么。
业务里的AI、办公里的AI、研发里的AI、运维里的AI。再继续往里面走,会看到模型、数据、RAG、Agent、Workflow、MCP、Skills、API,以及后面的业务系统。Agent还有自己的身份、权限、知识和工具。
这些东西不是孤立存在的,它们开始连接起来:人 → Agent → RAG / Workflow → MCP / Skills → API → 业务系统 → Action。
这个时候我才越来越明显地感觉到,半年前我们主要讨论的“大模型安全”,已经很难装下现在看到的全部东西了。大模型依然很重要,只是它慢慢变成了整个AI系统中的一个节点,而安全对象也开始从一个模型向外生长。
四、资产展开以后,真正麻烦的是风险
对象逐渐看清以后,下一步自然是风险。结果风险一展开,反而更乱了。模型有模型的风险,RAG有RAG的风险,Agent有Agent的风险,MCP、Skills又各自有一批风险。再从业务场景看,办公、研发、运维、业务又完全不一样。那段时间最直接的感受就是:哪里都是风险。
整理了很多轮以后,我才慢慢发现,可能还有一个原因:我们把很多不同维度的东西放在一起了。
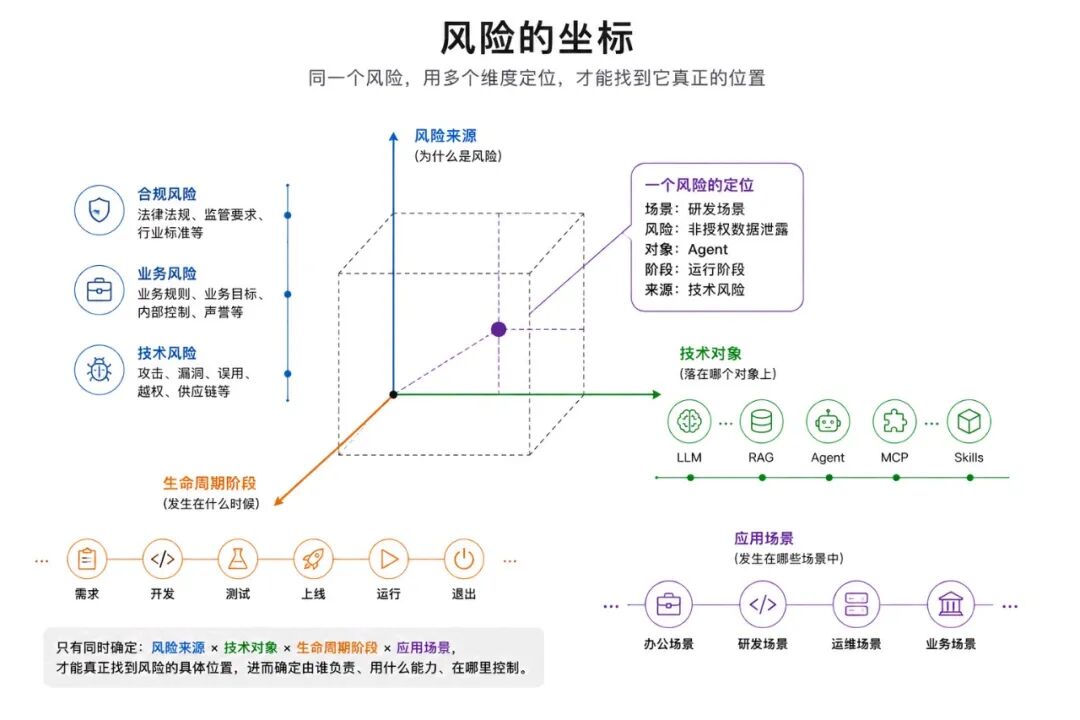
有些风险来自法律法规和监管要求,即使没有攻击者、没有漏洞,它依然存在。有些来自业务本身,一段内容技术上可能没有任何问题,但放到具体的客户、具体的业务场景里,可能涉及适当性、业务规则、内部控制或者其他业务风险。还有一些,才是安全人员最熟悉的攻击、漏洞、恶意输入、供应链、越权调用。
于是我后来慢慢把它们分成了三个方向:合规风险、业务风险、技术风险。
但这只是“为什么它是风险”。业务、办公、研发、运维,说的是它发生在哪里;LLM、RAG、Agent、MCP、Skills,说的是它落在哪个技术对象上;需求、开发、测试、上线、运行、退出,说的又是它发生在什么时候。
这些原来被我们习惯性地全部叫作“风险分类”。后来拆开以后才发现,它们其实是不同的坐标轴。于是一个风险开始可以被放到一个更具体的位置:某个场景 × 某个资产 × 某类风险 × 某个生命周期阶段
原来散落的风险,也开始慢慢有了结构。
五、风险找到位置以后,还要继续看它怎么发生
后来我又发现,给风险找到一个格子,好像还是不够。因为每一种风险还有自己的生成过程。
比如一次间接Prompt Injection。恶意内容可能最开始只藏在一份文档或者网页里,RAG把它读进来,进入Agent上下文,影响Agent判断。Agent选择Skill,通过MCP调用工具,再带着自己的身份和权限操作后面的系统。最后真正产生影响的时候,已经离最开始那份恶意内容很远了。
幻觉又是另一条路径。它不需要攻击者,模型生成错误内容,人或者后面的系统相信了它,才逐渐形成业务影响。业务风险又可能完全不同:模型没被攻击,系统也没漏洞,回答甚至没有事实错误,但放在错误的人、错误的业务场景里,风险依然可能出现。
所以后来再看风险,我开始习惯多往前后走几步:它从哪里来?为什么会产生?什么条件下被触发?经过什么继续传播或者执行?最后影响什么?
然后才是:在哪个地方把它接住比较合适?
我现在越来越愿意把风险分析理解成:看看一个风险是怎么长出来的。 而治理的时候,再去找这条链上适合干预的位置。
这时候原来那些静态扫描、动态检测、安全网关、权限控制、DLP、SOC,也开始重新找到自己的位置。
六、拆开的东西,后来又慢慢合了回来
研究AI安全的过程中,还有一个挺有意思的变化。开始的时候,我们不断拆:LLM安全、RAG安全、MCP安全、Skills安全、Agent安全。每出现一个新对象,先把它单独研究一遍。
但等真正把Agent执行一次任务的过程连起来以后,又发现它们原本就是一起工作的。Agent理解目标、规划任务,需要知识的时候找RAG,需要能力的时候选择Skill,需要操作外部系统的时候通过MCP或者API调用工具,再带着身份和权限执行动作。
这时候会出现一种挺有意思的情况:一个Skill可能是安全的,MCP可能也是安全的,RAG没有问题,API鉴权也完全正常,但这些正常的东西组合起来,最后仍然可能做出一个不应该做的动作。
所以我开始觉得:组件安全,好像不能自然推出智能体安全。
拆开,是为了看看风险从哪里产生;重新合起来,才看得到它最后怎么发生。到这里以后,我开始把Agent本身当成一个新的安全对象,因为这里出现了一个以前没有那么明显的变量:自主性。
理解目标、规划、选择能力、调用工具、根据结果继续行动。执行路径不再完全提前写死。安全开始从“这个程序能不能做什么”,慢慢走向“这个智能体为什么决定这样做”。
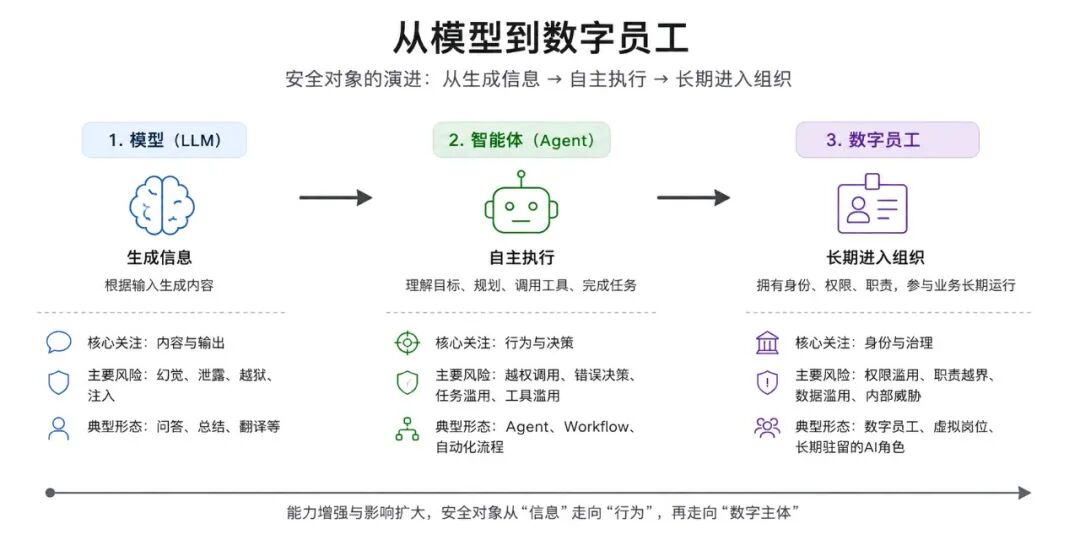
七、Agent再往前走,可能又会长出数字员工安全
如果一个Agent只是临时执行一次任务,它还是比较容易被理解成一个技术系统。但如果它开始长期存在,有岗位、有职责、有身份、有权限、有自己的知识和工具,参与工作流程,和人以及其他Agent协作,还有长期记忆和行为记录,这时候它已经越来越像组织里的一个员工,只是这个员工是数字的。
以前Agent安全会问:它能不能调用这个工具? 到了数字员工这里,问题可能会继续变成:它为什么拥有这个工具?这个权限和岗位匹配吗?哪些事情可以自主完成?什么时候必须重新找人授权?岗位变化以后权限怎么调整?数字员工退出以后,身份、凭证、知识和能力怎么回收?
这些问题开始和IAM、内部控制、职责分离、人员生命周期管理碰到一起。
所以最近我开始有一种感觉:从模型到智能体,安全对象好像从信息慢慢走向了行为;从智能体到数字员工,又开始从行为走向一个长期存在的数字主体。
这件事情未来会走多远,我现在也不知道,但它已经开始改变我看AI安全的方式。
八、做到这里以后,最后会走向治理
最开始我以为,是因为AI涉及的技术越来越多。开发安全只能接住一部分,运行安全接住一部分,数据安全、身份安全、模型安全、SOC又各自接住一部分,没有一个单独的专业板块能够完整接住。
后来再看,好像还不止这个原因。AI风险本来就是从不同地方长出来的。
法律法规和监管有自己的要求,业务有自己的规则、目标和不能接受的结果,安全又面对真实的攻击、漏洞和技术风险。三种风险可能最后同时落在一个AI应用里。再加上AI开始进入业务、办公、研发、运维的各个地方,这时候我越来越难把AI安全只理解成一个技术安全问题。
而且站的位置继续往上走以后,看到的东西也在变。各个安全板块负责人看到的是自己的专业能力;安全运营负责人看到的是监测、发现、分析、处置、复盘;安全负责人看到的是制度、职责、流程、控制和管理;再从整个信息技术的角度往下看,看到的才逐渐变成:整个组织怎么安全地使用AI。
我现在会把这几个层次暂时理解成:
治理 → 管理 → 运营 → 专业板块 → 具体安全能力
每一层研究的对象不同,最后应该交付的东西也不同。
所以回头再看一些厂商方案,我开始有了另外一种理解。有些方案本身的能力其实没有问题,问题可能发生在:一个板块级的能力,被拿来回答治理级的问题。
静态扫描当然有价值,动态检测也很重要,安全网关、DLP、IAM、SOC都需要,只是它们各自应该待在自己的位置上。如果拿其中任何一个去解释完整的AI安全,总会差一点什么。
九、最后整合出来的是一套分层的方案
做到后面,我越来越不想从“需要建设哪些AI安全能力”开始方案了。我现在更愿意从分析开始。
第一步是看资产。我到底有哪些AI?它们在哪些场景?由哪些对象组成?彼此怎么连接?拥有什么数据、身份、权限和工具?
第二步是看风险。监管要求是什么?业务不能接受什么?攻击者可能利用什么?这些风险落在哪个资产、哪个场景、哪个生命周期阶段?
第三步才慢慢形成框架。不同风险应该在哪个层次被接住?哪些进入治理?哪些进入管理?哪些需要运营持续处理?哪些最终落到开发安全、数据安全、身份安全、运行安全、攻防等专业板块?
第四步,才开始补能力。已有能力能够接住,就继续复用;接不住,再补新的。
这时候再回头看那10多家厂商,很多东西反而清楚了。开发安全厂商的静态扫描有自己的位置,运行安全厂商的动态检测有自己的位置,安全网关有自己的位置,Agent权限控制、MCP和Skills检测也都有自己的位置。
新的问题不一定都需要新的工具,但可能要先把新的问题看清楚,才知道原来的工具还能不能接得住。
所以现在如果让我把这套方案压缩成一条线,大概会是:资产 → 风险 → 框架 → 能力
但到这里,其实还只是搭起来了,还没有真正活起来。
十、一套系统最后应该能够自己转起来
前面做了很多事情。资产梳理了,风险分析了,框架有了,安全能力也补进去了。但做到最后,我又开始觉得:闭环可能还不够。
如果一套体系每走一步都需要有人记着、有人拉表、有人发邮件、有人催、有人盯着下一步,它虽然在流程图上闭环了,但好像还没有真正成为一个系统。
我现在更愿意把一套好的系统理解成:它应该有一点自己的生命力。
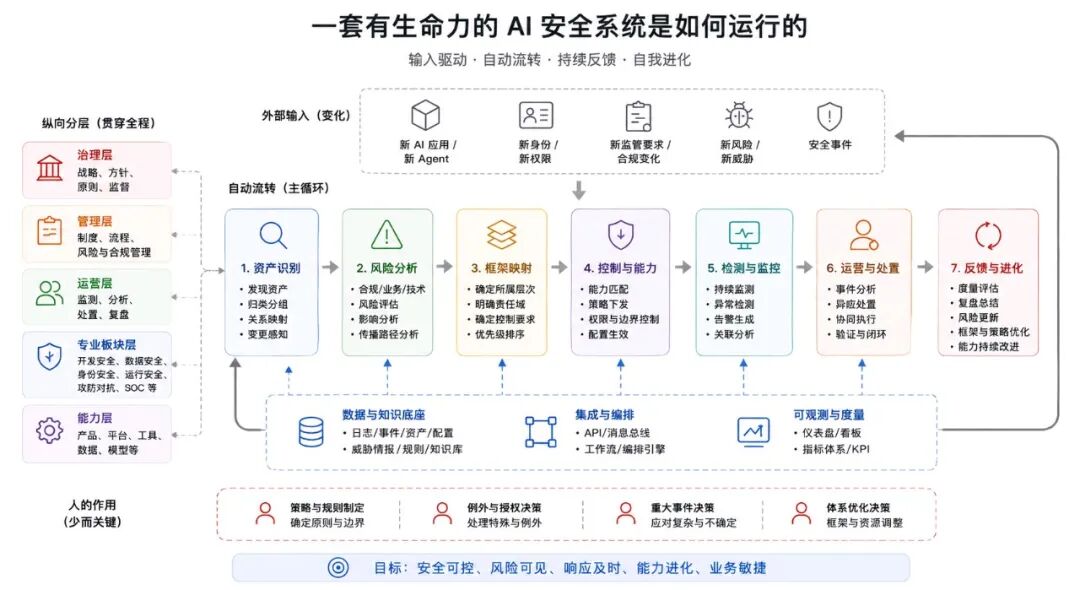
上游给它一个输入。可能是一个新的AI应用、一个新的Agent、一个刚刚上线的Skill、一项新的监管要求、一种刚出现的攻击方式,或者一次真实发生的安全事件。输入进入以后,应该能够沿着已经建立好的关系往下走:
资产识别 → 风险分析 → 框架映射 → 控制要求 → 能力匹配 → 检测监控 → 运营处置 → 验证 → 反馈
人当然还在,只是人越来越多地出现在真正需要判断、授权、例外和决策的地方。而那些规则已经明确、能够自动完成的事情,应该尽可能让系统自己流转。
运行过程中产生的结果,还应该继续回来改变系统。某一类Agent越权持续出现,是不是原来的风险判断有问题?一个控制点长期误报,是不是放错了位置?新出现的风险,框架是不是需要调整?某项制度一直无法执行,是不是管理机制本身还有缺口?
于是前面的链条开始真正转起来:
资产 → 风险 → 框架 → 能力 → 运营 → 运维 → 反馈 → 再进入下一轮
运营负责让风险持续被发现、分析、处置和复盘;运维保证承载这些控制点的技术能力持续稳定、有效;系统运行产生的数据,又继续反馈到风险、能力甚至更上层的框架。
做到这里,我觉得“闭环”和“生命力”可能还是有一点区别。闭环解决的是,事情最后能不能回来;生命力解决的可能是,没有人一直推着,它还能不能继续转。
十一、半年以后,我是这么看AI安全
现在回头看这半年,最开始其实一直在看别人有什么。这家厂商有什么能力,那家厂商怎么做,同行怎么建,框架怎么写。信息越来越多以后,反而开始乱。
后来才慢慢把注意力从产品移到资产,从资产移到风险。风险多起来以后,又不得不去找它为什么产生、发生在哪里、落在哪个对象、处在哪个阶段。
再往后,治理、管理、运营、各个安全专业板块开始慢慢分出自己的位置。那些原来看到的静态扫描、动态检测、安全网关、数据安全、身份权限、SOC,也终于一个一个重新放了回来。
所以现在再让我看一套AI安全方案,我可能已经不会先问“这里面有多少AI安全产品”。我可能会先看看:它保护的对象到底是什么?风险是怎么分析出来的?这些风险为什么被放在这里?谁应该接住它?每一种能力为什么出现在这个位置?上游发生变化以后,这套东西还能不能继续自己跑?
从看产品,到看资产;从看资产,到看风险;从风险,再到结构、机制和运行。
现在我越来越觉得,一套方案真正形成的时候,可能并不是把所有东西都装进去的时候,而是每一样东西都慢慢知道:自己为什么在这里,应该待在哪一层,上游来了一个输入以后,下一步应该往哪里走。
然后,整个系统开始自己转起来。
从信息到结构,从结构到机制,从机制到运行。
也许到这里,一套AI安全方案才慢慢开始有了自己的生命。
需要资料可以后台找我。