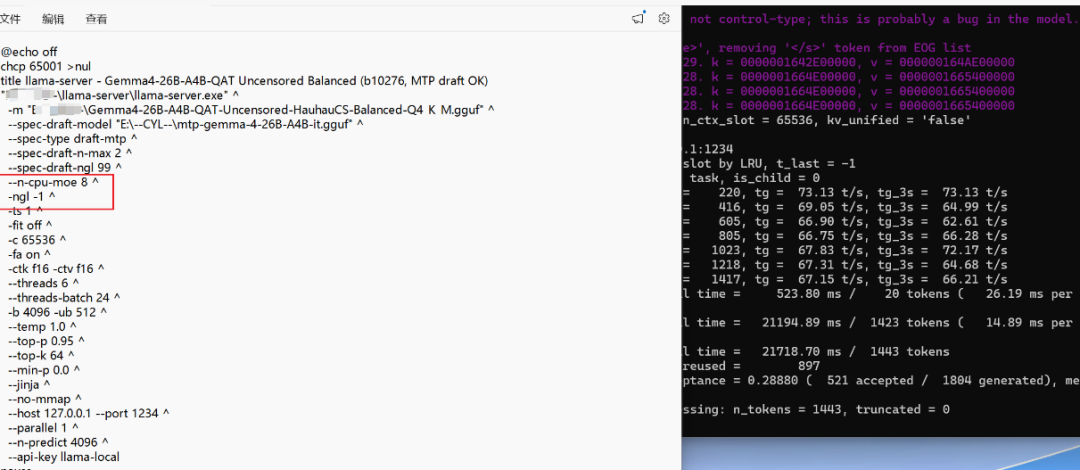
本地AI使用体验报告·一(设备与模型篇) 作者:AI丽丝的人偶工坊 发布:2026-08-11 12:10 收录:2026-09-07 18:16 2 次阅读 约 1319 字 摘要:针对竞赛/比武/工作的本地AI使用报告 推荐理由:本文涵盖「Qwen」、「RTX5090」、「本地AI」等多个主题,重点关注 Qwen。 结合最近几次比赛和平时干活的体验,外加上和一些大佬的交流经验,总结一下本地可部署的模型以及具体的使用体验。这次主要分享一下不同的设备和本地模型,如有谬误,还烦请各位大佬指出(鞠躬)设备选择与模型速度参考我自己的设备如下:U9-275H96G RAMRTX 5090 Laptop(24G显存)日常使用(针对跑本地AI)算是甜品级别?目前测试过的AI模型及对应上下文主要如下(可大致参考,实际使用中包含一部分误差)Qwen3.6 35b-a3b q6;上下文160000;显存占用22.4G;参考速度60t/sQwen3.6 27b q5;上下文64000;显存占用22.4G;参考速度50t/sGemma4 31b q5;上下文8192;显存占用23.2G;参考速度50t/sGemma4 26b-a4b q5;上下文160000;显存占用22G;参考速度70t/s另外还包含了Gemma4的QAT改版,比原版显存占用小一点,这里就不再赘述(26b-a4b q4参考速度:150t/s,降速后50t/s)。除了上面的模型,另外有一些模型也是能用的,比如Qwen3.5 122b-a10b;上下文8192;显存拉满配CPU卸载,勉强能用,大概20t/s,可以跑一些稍微困难的问题,相比27b知识面更广,有一段时间我是搭配着27b使用的,但在比赛中这个实在是太慢了(跑跑密码题也许可以?)后面就不怎么用了。5090笔记本版还是有点太拉垮了,又贵,算力上也就台式5070到5070ti之间,唯一的闪光点就是24G显存(显存比金子贵哇)能直接跑27b,所以也能给到“人上人”吧。相比5090,笔记本端更多的还是5080,由于我手头上没有这个卡的笔记本,就求助大佬帮我测了一下(由于参数原因,图片展示速度并非最高速度,极限可以拉到100t/s左右)24G显存相比16G显存还是太权威了,5080完全跑不了27b q4以上的(直接炸显存了),q4往下还不如直接跑MOE的qwen和gemma结合价格考虑,5080的笔记本最便宜的时候1.5w能拿下,够很多单位的采购标准,所以给到“夯”再往下的话就是5070(12G的太新了,没借到)、5060,之前我用的是4060,显存都是8G,只能跑MOE,剩下的就是算力之间的区别了。4060跑35b参考速度是30t/s,在比赛中做一些理论题还是轻轻松松的。除了常规的高性能笔记本(就是游戏本啦),最近统一内存的设备也是异军突起,打折移动AI办公的广告,狠狠买流量。但这类设备有一个通病,只能跑MOE的模型,比如qwen3.5 122b,狠一点我看有大佬跑deepseekv4 flash q1的。跑稠密模型(比如qwen27b)速度还是太慢了,AI Max+395+128G内存,跑qwen3.6 q4参考速度约为70t/s(极致速度),qwen3.5 122b q6参考速度约为27t/s(最佳性能)。不考虑游戏的话,内存融合真的是目前跑AI的最佳选择了,目前的大一点的模型都是MOE,显存内存都比金子还贵,买带独显的相当于买了两遍金子,所以这里给到“夯”。除此之外,还有老黄的Spark,这里我用过两个不同的版本,一个是BW现场体验的DGX Spark,128G版本的,现场跑fp16的qwen3.6 35b,速度高达惊人的40t/s(感觉大概率是没调参数),另外一个是美**科公司的移动AI取证终端,没有意外的话就是特调版的DGX Spark,内置FP8的qwen3.6 35b,速度也是70t/s。如果能单位采购的话,比赛的时候,这些可以带着当个小AI服务器用。给到一个“未来可期”吧。模型选择模型选择上,那可太多微调版本了。以最常用的qwen3.6 35b-a3b为例,针对网络安全(破限)的话,目前用的较多的是HauhauCS 的一系列破限模型,破限效果都相对较好,但他的模型争议也比较多,Reddit上也有用户称其模型破限关键方法是抄袭Heretic的(参考:https://www.reddit.com/r/LocalLLaMA/comments/1sw77p0/hauhaucs_of_uncensored_aggressive_fame_published/),这里就不妄加评论了。另外,llmfan46 的一系列模型也挺好的,主要就是基于原版加Heretic,破限效果也不错。当然,破限版本也是有缺点的,就是性能相比原本会下降,有陷入无限循环思考的可能,还请注意。最后,仅个人观点,不推荐使用任何带Fable、Opus等模型蒸馏(含思维链)的微调模型。有一段时间我非常痴迷这类型的模型,但实际效果比下来,比原版差很多很多,经常会陷入无限循环思考,比破限版的还要容易(难绷),所以后面凡是带有这种标签的,我都会直接跳过 转载声明:本文转载自原发布平台 (作者:AI丽丝的人偶工坊), 原文标题《本地AI使用体验报告·一(设备与模型篇)》, 查看原文。 版权归原作者及原发布平台所有,本站仅作收录与展示,未对正文内容作实质性修改; 若涉及侵权请联系本站处理。 ← 【bitlocker是什么?】 第四届黄河流域公安院校电子物证个人赛计算机取证 →