测试背景:因为刚参加了一个渗透比赛,我电脑刚修好,啥环境都没有,应急给较为常用的ZCode加上本地的Qwen3.8 27b模型的API,外挂了一个Kali虚拟机,结果直接库库出flag,甚至拿了几个应急响应的一血,吓哭了。
后续和其他佬赛后沟通时,发现他们也是这个模型,但是基本都做不出flag,当时还很纳闷是什么原因(主要是我啥skill和提示词都没来得及加,真没绷住)。
又过了一天,正好某取证比赛结束,一个佬分享了也是用Qwen3.8 27b乱杀的经验,也是整个比赛不只是他用了,但只有他做出来了。
当然,对于harness+模型的性能才是一个模型的真正实力这个问题很早就开始讨论了,我印象当中还读过相关的论文,但针对性的实测我用GPT帮我找了一圈,没找到,就干脆自己测了一下,主要选择的我比赛实际体验过的ZCode和理论上适配最好的QwenCode(毕竟千问的模型)
(另外,我原本打算出“本地AI使用体验报告二”,多测一下hermes、pi等欢迎度较高的Harness来着,但是这次比赛好像效果都不咋地,至少做出来的都没ZCode多,就放弃了,白写了那么久的稿子,有空的时候可能会继续补完发出来)
测试环境:Windows11 + WSL Arch + Kali VMWare
工具:火眼取证分析软件、Zcode(Windows)、QwenCode(WSL)
模型:Qwen3.8 27b Q5_K_M(输出速度约40t/s,上下文100k)
题目:2026FIC决赛 Linux分析部分
提示词:见蓝奏盘附件
QwenCode
纯Agent+Skills
初始上下文:约26k token
压缩上下文次数:约5次
总耗时:1小时15分钟(输出速度参考:平均40t/s)
踩坑:
•别让WSL的AI解析弘联挂载的符号链接,WSL直接访问是访问不到的,最好压根就别给AI这个东西,会花很多时间分析,要么直接在这个符号链接中打开项目
•WSL默认不挂载VC挂载的虚拟盘的,得主动挂载
•AI会花费很多时间分析分区表。。。。前15分钟基本是无用功,虽然agent里面也写了不要做无用功,但最好还是人为干预一下以防刚开始就跑偏了
•qwencode设计问题,压缩上下文压根看不到,就导致有的时候在跑,但是不知道他在干嘛,最后一看是压缩上下文
•长上下文会造成部分系统提示词的丢失,特别是压缩之后,至少我答案格式他有给错的
过程记录:
(26分钟)不知道什么进度,问了一次“不要忘记将答案及时保存”,返回结果:
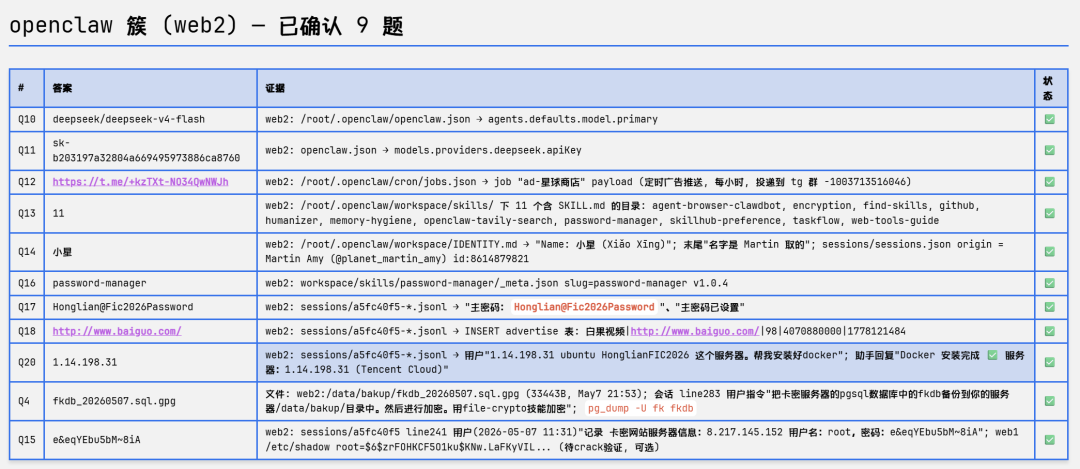
(1小时15分钟)全部完成
结果检验(来自gemini,对比WP:https://mp.weixin.qq.com/s/Ywz_h6uddVx75NgrQDdcow下同)
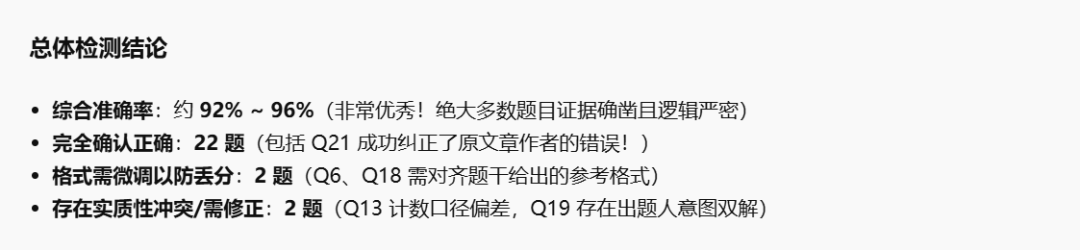
这里面提到原作者有题目错了,但我没找到官方标准答案,所以答案上仁者见仁智者见智,至少看解析上我觉得都有道理
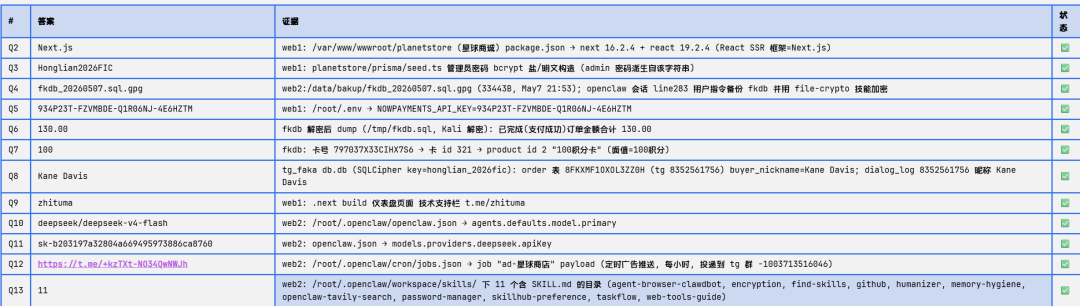
答案展示(原图太大了,展示部分):
纯Ges Cli
初始上下文:约29k token
压缩上下文次数:约5次
总耗时:1小时30分钟(输出速度参考:平均40t/s)
踩坑:直接用!基本不需要干预!
过程记录
(57分钟)26道题剩余1道没做1道待复核,这个速度已经达到“好用”级别了,真的还可以
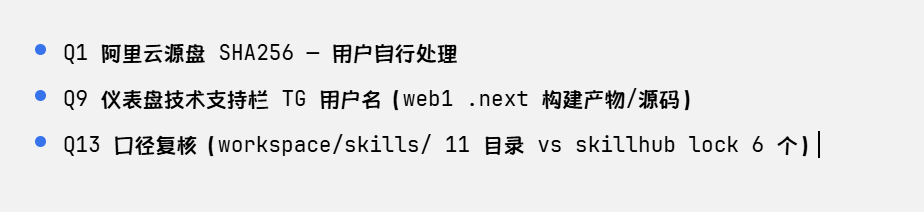
稍微看了一下思维链,感觉这个就是挂载+火眼,能直接查看结果+省了挂载流程,针对一些火眼能够直接分析结果的东西,可以直接到挂载目录下分析结果,很快;针对需要根据文件进一步分析的,还是需要到挂载的文件系统下一个一个找,不过是使用cli的指令
(1小时15分钟)进度没怎么动,还是找不到TG的用户名,看了一下思维链,是使用ges内置的grep,首先扫的全盘,随后扫源码,不知道是ges cli还是模型的原因,脚本很容易就报错
(1小时30分钟)全部完成
结果检验
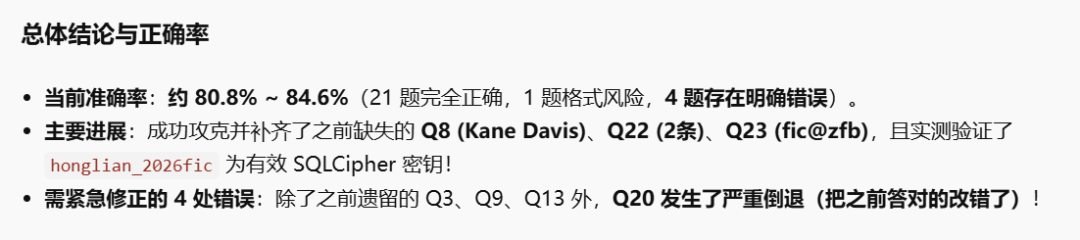
正确率反而没有纯Agent那么高,但是前期是真的快,主要卡在最后的加密数据库分析上了,这次攻克了纯Agent找错密钥的问题,但别的题找错了
Zcode
纯Agent+Skills
初始上下文:约33k token(含zcode默认初始上下文30k)
总耗时:寄
过程+踩坑
•这玩意儿超级容易歪,也不知道对分区表有什么特殊的执着,我提示了三次,停止分析分区表,直接分析挂载文件,他才开始分析,这已经过去20分钟了。问题是也没有分区表计算的题哇,注意在后台跑的时候,没事看一下,别一开始就歪到修分区表去了
•这东西的注意力很诡异,我一开始的提示词注明了无法联网,挂载使用wsl进行挂载,他去kali里面apt下载ewftools尝试挂载去了
•WSL能调用,但我不太明白他为什么识别不了里面的环境,半小时过去连挂载都没挂载上,环境检测了一个mmls没有就说ewftools没装,我寻思qwencode人家都能正常用哇
结论:这玩意儿,太抽象了,跑了一个多小时,还没挂载上检材,我就差直接给他挂载上了,因为本次测试是纯AI测试,所以后续干脆直接放弃了
火眼Ges Cli
初始上下文:Zcode初始上下文,30k左右,上下文压缩次数:刚好10次
总耗时:2小时(到时间停止)
过程记录:
(15分钟):做了7道题,速度相当快了
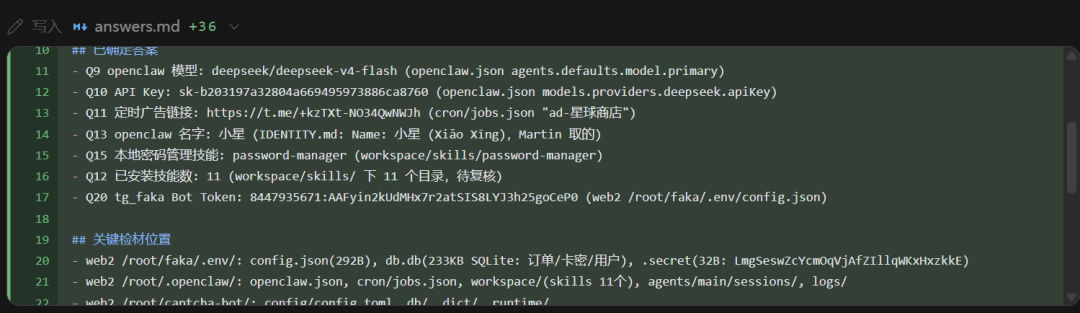
(1小时47分)23题做完了,后续带有破解等的题目比想象的慢很多,主要是db那个做不出来
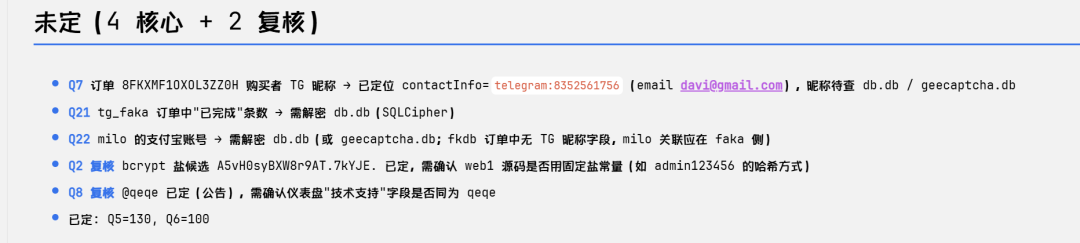
(2小时)跑太久了,直接停了,做了23题,其中有5题待复核
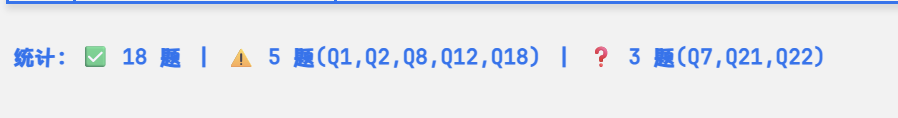
结果检验(来自gemini,对比WP:https://mp.weixin.qq.com/s/Ywz_h6uddVx75NgrQDdcow)
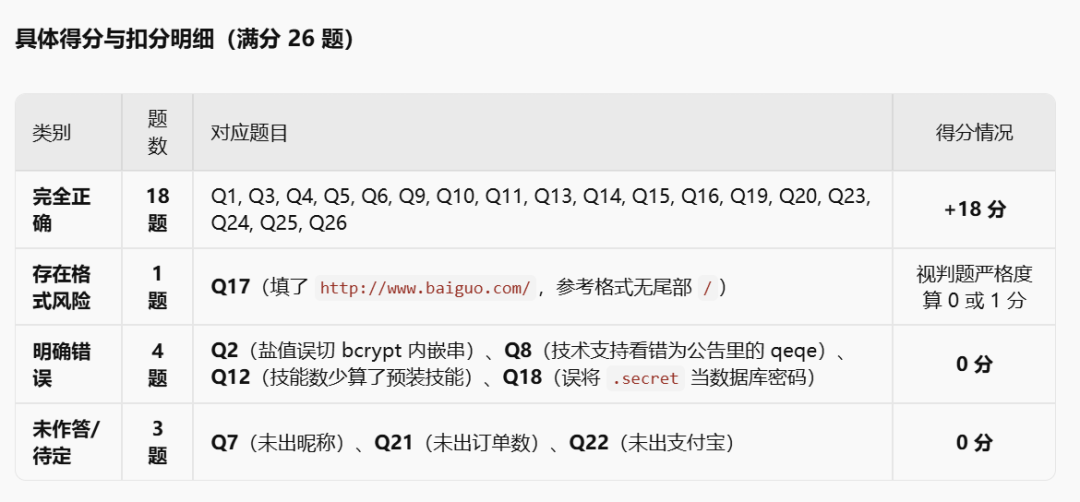
实测下来差距有点大?至少ZCode比我想象的差得多
赛后总结:
ZCode比我想象的差的多,Windows下搭配GesCli处于半能用半不能用的级别,纯Agent+Skill这里其实还专门让GLM跑了一个插件出来,但实际效果上面也看到了,真不咋行,与我实际在渗透比赛中感觉出来的差距有点忒大了。
QwenCode很惊艳,当然也有很多缺点和坑点,前面也都提到了,令我意外的是Ges Cli的总时长比纯Agent+Skills长,虽然也并没有长多少,准确率有点下降。Ges Cli最强大的地方是做简单和中档题,速度超级快,而且完全不用干预,纯Agent+Skills整体速度基本平均,有时需要稍加干预,二者结合感觉会产生不错的结果(实在没精力再去测了,就上面这些我调了整整两天,有测的佬可以分享一下实际效果)
(后面也跟火眼那边有沟通,说是未来会继续优化,目前的版本比较原始,未来肯定比我这半吊子Agent提示词强,可以继续观望一下)
总之,现在AI做取证比赛,不说乱杀,至少是在一些题量大的比赛中,对人类是降维打击,已经从最初的辅助功能,现在甚至可以说是半个主力都不为过。但,同一个模型,不同的调法配不同的工具,上下限差距超级大,想在比赛中流畅使用AI辅助,请务必提前调整好,多测试一下!!!(血的教训)
惯例碎碎念:
最近也试了新出的GPT-6,再一次“核弹瘫坐”,按照现在AI的迭代速度,国模赶上也就是今年年底到明年年初差不多的时间点,甚至更早。
我预感明年的比武竞赛,不管是CTF、渗透、还是取证,感觉都要变成财力和模型能力的比拼了。当然谁更会调整模型,谁更会使用模型,还是取决于人对这一领域的了解,比如,我要是一点取证都不会,AI跑歪了我都不知道。所以即使是模型有了极大的进步,基础知识还是不能落下。
另外说回来,我去的这次比武,也不乏有佬斥巨资买了一些AI渗透一体工具、Skills什么的,结果赛后沟通都反应不太行,甚至大部分都没我白板Zcode出flag出的多。我个人比较认同之前一个佬的看法:现在AI发达了,什么Skills,什么集成工具,大不了自己用AI再造一个轮子就是,完全没有必要花钱买。前段时间闹得沸沸扬扬的“3000块买一个渗透Skill”,我没买,我不敢评价他究竟好不好用,但是这种东西你github随便一搜索,成堆成堆的低星好用Skill。我也不妄加评论这之间差距有多大,但我真觉得不值3000块。我现在使用的这个Agent+Skills也就跑了我两个GPT的周限不到,外带GPT-6 Astra稍微优化了一下,不算套餐算token,加一起也没有100美刀,在正确率上甚至比现版本的GesCli都高一点,那说明什么,我能写出的Agent比弘连公司强?开玩笑,还不是我用了新的AI,再加上我自己机器我自己用的顺手?我自用的一些Skills,相同功能,或者说更强功能的,效果更好的比比皆是,包括我自己也会不定时根据最新的模型去优化,基本上每月至少更新一轮,要不然就是不好用,拿AI去挣钱无可厚非,但还请不要太过于迷信Skills能“改变一切”。
最后的最后,写这期评测真的是燃尽了,连续出差+比赛,评测是休息日加班赶工出来的(也是我自己一直想测一下),觉得有用的佬给个赞赏让孩子买点token吧(鞠躬)