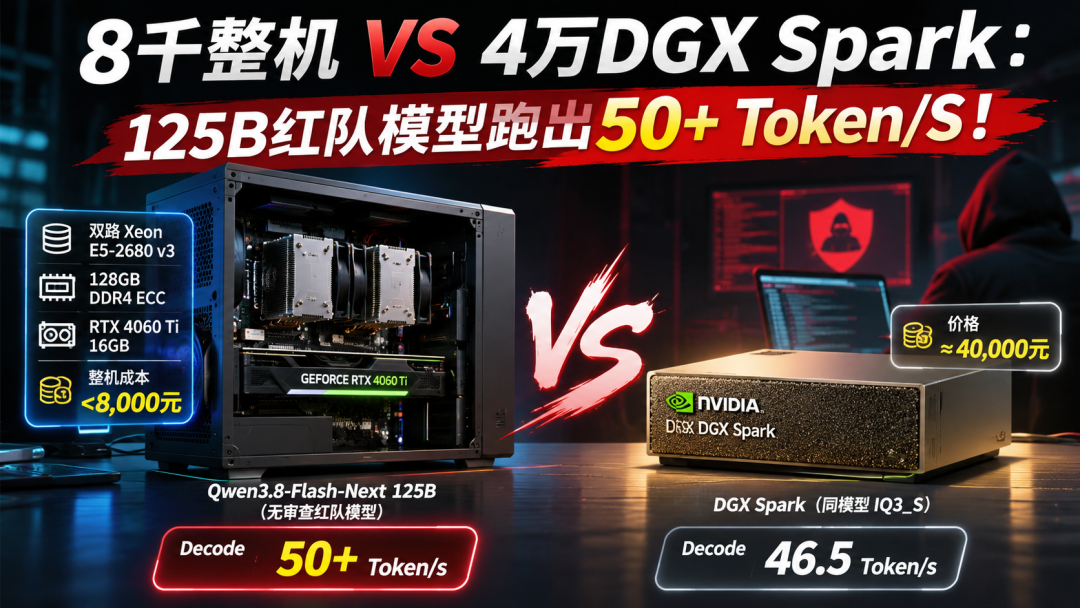
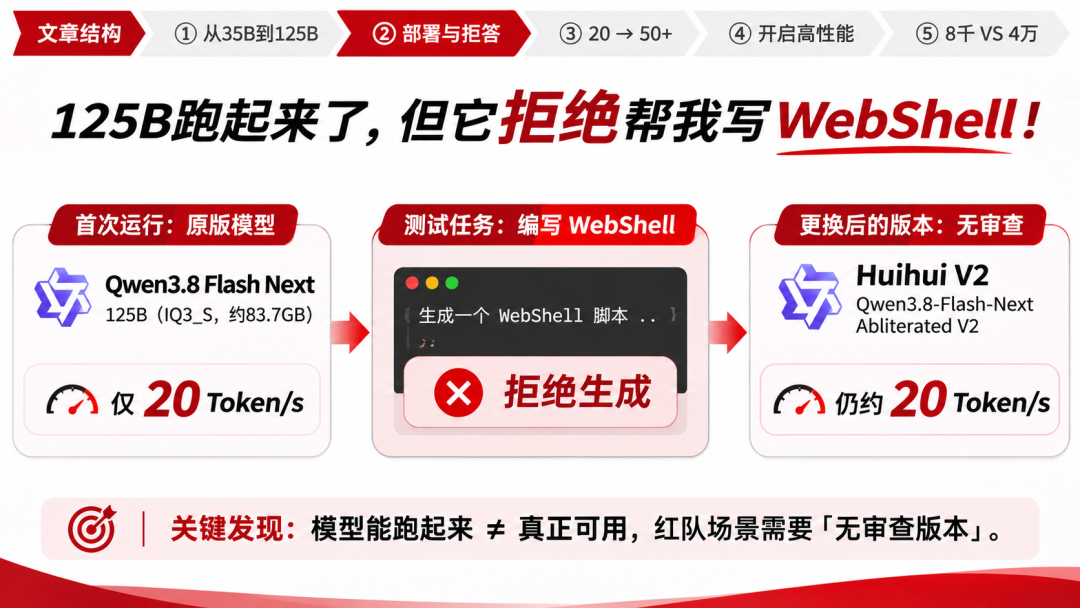
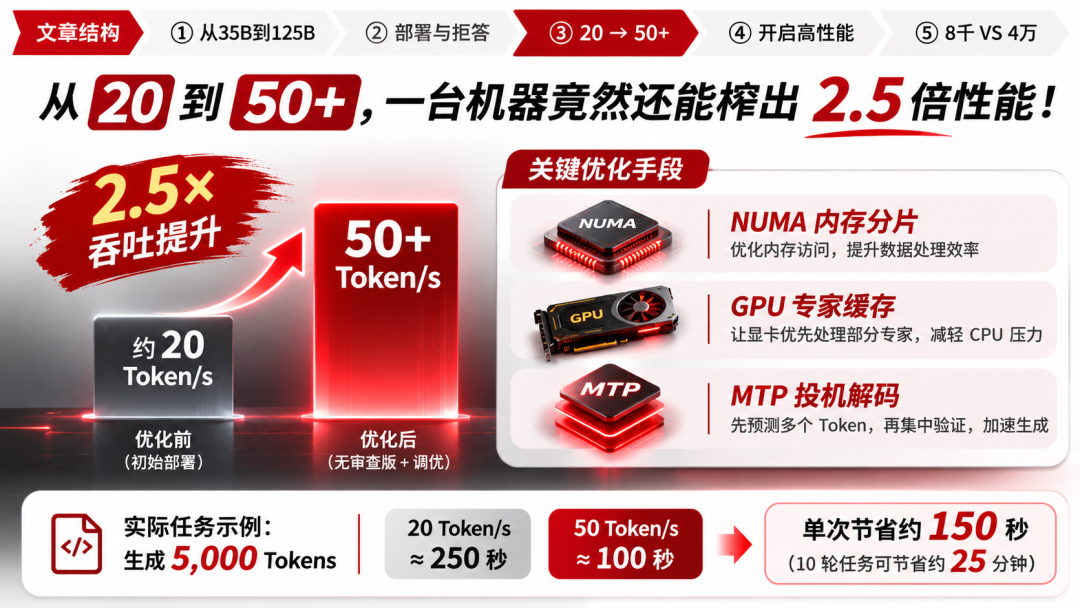
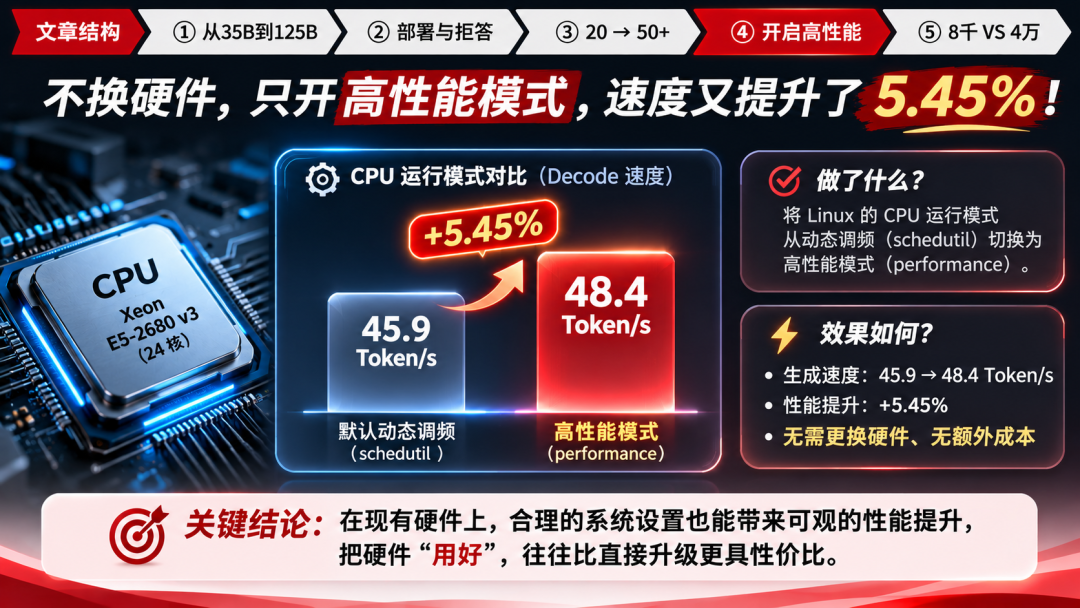
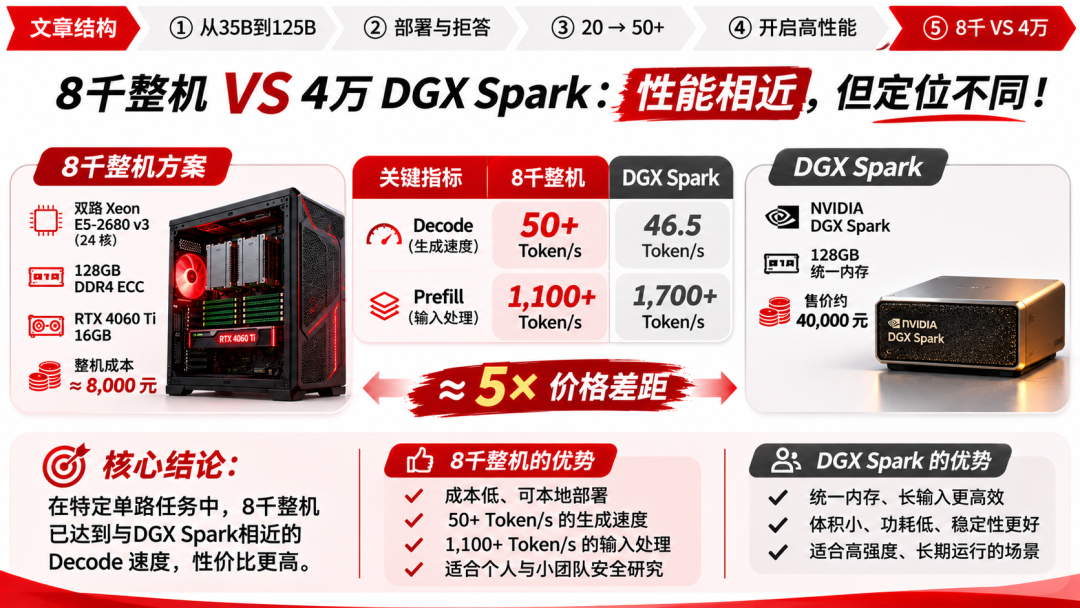
8千整机 VS 4万DGX Spark:125B红队模型跑出50+ Token/s! 作者:南山小卫庄 发布:2026-11-15 14:03 收录:2026-11-17 18:56 1 次阅读 约 3415 字 摘要:一台不到8000元的台式机,竟然把125B无审查红队模型跑到了50+ Token/s,生成速度进入4万元级DGX Spark的同一量级!更离谱的是,刚装好时只有20 Token/s,原版还拒绝生成WebShell。究竟做了什么,让性能暴涨2.5倍? 推荐理由:本文涵盖「Token」、「Next」、「Agent」等多个主题,重点关注 Token。 摘要: 一台不到8000元的台式机,把Qwen 3.8 Flash Next 125B无审查红队模型跑到了50+ Token/s,进入4万元级DGX Spark部分方案的解码速度区间。但刚安装时,模型只有20 Token/s左右,原版还拒绝了一个WebShell脚本请求。从更换模型到优化推理架构,这次实测经历了多次反转。一、从35B到125B,这次想挑战更低的成本过去几个月,一直在折腾本地无审查红队模型。从27B到35B,从模型量化到推理引擎,从普通对话到自动化Agent,前后测试了很多轮。此前还专门写过一篇35B红队模型的性能优化文章。在特定测试场景中,经过推理架构调整,生成速度从最初约11 Token/s一路突破200 Token/s。后来又把AI深度审计和自动化攻击平台带进了2026年证券期货业网络安全技能大赛,最终获得季军,进攻平台累计取得180+ Flag。这些经历让我逐渐意识到,本地红队模型有三个特别重要的指标:能力、拒答限制、速度。速度太慢,Agent执行多个步骤就需要长时间等待;能力不够,复杂代码分析容易遇到瓶颈;频繁拒答,则可能直接中断授权安全研究的工作流程。35B已经能够完成不少事情,但更大规模的模型究竟能带来多少提升?有没有可能用很低的成本把它运行起来?最近看到有人用DDR3内存、老Xeon和RTX 3050 8GB运行Qwen3.8-Flash-Next,甚至测出了20+ Token/s的成绩。一开始确实有点难以相信。不过仔细研究Strata的推理架构之后,发现这条路线值得一试。于是决定把目标直接提高到125B。更重要的是,这次还要控制硬件成本:整机8K以内。二、125B跑起来了,结果它拒绝帮我写WebShell这次使用的机器其实很普通。两颗Intel Xeon E5-2680 v3,24个物理核心;128GB DDR4 ECC内存;一张RTX 4060 Ti 16GB显卡,以及华南X99双路主板。按此前的硬件估值,包含显示器在内约7170~7560元。这个数字属于当时的整套设备估值,包含二手硬件,不能直接视为今天重新采购的固定价格。模型选择Qwen3.8-Flash-Next。它的主体规模为125B,另外还有51B的N-gram Embedding,每Token激活约6B参数。下载的IQ3_S量化版本,文件约83.7GB。83.7GB的模型,一张16GB显卡显然装不下。Strata提供了一条很有意思的技术路线:利用GPU缓存和计算部分专家,其余专家交给CPU与主机内存处理。这意味着,128GB内存也可以成为大型MoE推理的关键资源。安装、配置、加载,模型终于成功启动。第一次测试,只有20 Token/s左右。速度不算理想,但至少125B真的跑起来了。接下来准备测试它能否解决实际问题,于是让它帮忙编写一个WebShell脚本。没想到,原版模型直接拒绝了。这个结果让人有点扫兴。对于红队研究来说,本地模型最重要的价值之一,就是能够在授权环境中自主进行代码分析、脚本编写和安全测试,减少拒答对工作流程的影响。模型参数再大,如果实际需要的任务无法顺利执行,价值就会明显打折。于是决定更换无审查版本。最终选择Huihui发布的Qwen3.8-Flash-Next Abliterated V2,利用去拒答处理降低模型的拒答倾向。模型重新下载、重新部署。结果第二次测试又出现了熟悉的数字:20 Token/s左右。原版和无审查版都能启动,但这个速度距离理想状态还有很大差距。接下来只能继续往下挖。三、从20到50+,一台机器竟然还能榨出2.5倍性能先从推理架构入手。Flash-Next属于大型MoE模型,真正影响生成速度的环节很多:专家怎样分配、GPU能够缓存多少专家、CPU访问哪一侧内存、PCIe要传输多少数据,以及投机解码一次能够接受多少Token。这些环节只要有一个安排得不好,就可能让整个推理流程长时间等待。最初考虑过硬件瓶颈。毕竟这台机器使用的是十多年前的Xeon,PCIe也只有3.0 x8。按照传统经验,很容易怀疑CPU性能或显卡带宽已经不足。但之前的研究提醒了我们:不要急着下结论。在另一款35B-A3B模型的测试中,仅仅调整双路NUMA内存放置策略,Decode就曾从41.3提升到58.8 Token/s。同样的硬件,吞吐提升了约42%。当然,这组数据属于35B的独立实验,不能算作本次125B的直接优化收益,但它说明了双路服务器内存布局的重要性。这次继续围绕NUMA专家分片、内存驻留、GPU专家缓存和PCIe自动分流等环节进行调整。另一个重要变量是投机解码。原版Flash-Next可以采用DFlash2加速,经过优化后,IQ3_S实测达到52~55 Token/s。但切换到Huihui V2无审查版本后,DFlash2配置无法直接加载。原版跑通的加速路径,换一个模型版本竟然失效了。只能继续寻找替代方案。最终使用MTP投机解码,通过先预测多个Token,再集中验证,减少平均生成一个Token所需的完整推理次数。经过多轮测试,无审查版本终于在代码生成任务中突破50 Token/s。从最初约20到50+,吞吐达到了原来的2.5倍以上。这个数字放进真实任务会发生什么?假设一个Agent需要连续生成5000个Token:20 Token/s:约250秒。50 Token/s:约100秒。单次减少约150秒。如果连续执行10轮类似的代码生成任务,仅纯解码时间就能节约约25分钟。实际任务还包含输入处理、工具调用和环境执行,但生成速度的收益会在多轮Agent流程中不断累积。原本只是“勉强可用”的125B,开始真正具备持续运行的价值。不过,性能突破之后又发现了一个问题。同一个无审查模型,代码生成能超过50 Token/s,换成复杂中文分析,却可能只有30多Token/s。为什么同样的硬件、同样的模型,速度差距会这么大?四、不换硬件,只开高性能模式,速度又提升了5.45%跑到50+ Token/s之后,还想看看有没有进一步优化的空间。开始尝试一些系统层面的设置,其中最简单的一项,就是Linux的CPU高性能模式。默认情况下,系统会根据负载动态调整CPU频率,以平衡性能与功耗。这样的策略对日常应用很合适,但大型MoE模型需要CPU持续参与专家计算,频繁的频率调整可能影响整体效率。于是进行了一组对照测试。CPU运行模式实测生成速度默认动态调频(schedutil)45.9 Token/s高性能模式(performance)48.4 Token/s性能提升+5.45%没有更换CPU,没有增加内存,也没有购买新显卡,仅仅改变CPU运行策略,生成速度就提升了5.45%。如果一个任务累计需要生成5万个Token,按照这组测试的速度计算,纯解码时间大约从18.2分钟下降到17.2分钟,节省约1分钟。单看一次任务,差距不算惊人。但对于长期运行、需要反复调用模型的Agent来说,这种无需新增硬件投入的性能收益很值得争取。不过,其他优化并没有这么顺利。例如,最初以为增加CPU工作线程就能继续提高速度,实际测试却发现,线程数量增加后性能不一定同步提升;有些设置虽然降低了CPU占用,却反而拖慢了生成。甚至连CPU显示100%满载,也不代表它一直在进行有效计算,其中可能有不少时间花在等待任务上。最后,我们选择了20个CPU Workers和10ms自旋等待作为现阶段的平衡配置,同时保留高性能模式及NUMA优化,让模型推理与其他程序能够共存。其中10ms自旋与20 Workers的组合仍需要统一基准复测;上面的5.45%则来自单独的CPU模式对照实验。这次折腾最大的感受是:花钱升级硬件固然可以提升性能,但很多时候,先把现有硬件用好,性价比可能更高。既然这套不到8K的机器已经跑出了50+ Token/s,那么它与价格高得多的专业AI设备相比,究竟处于什么水平?五、8千整机VS4万DGX Spark,性价比究竟差在哪里?做到这里,还有一个很有意思的问题:如果用同样的Qwen3.8-Flash-Next,在NVIDIA的DGX Spark上运行,究竟能跑多快?我们找到了Strata项目2026年10月27日公布的单台DGX Spark实测数据。硬件是128GB统一内存的DGX Spark,推理引擎为Strata 0.2.7.1,模型采用Flash-Next IQ3_S。在64K上下文配置下,输入长度分别为4K、16K、32K时,Decode成绩为:45.5、46.5、46.5 Token/s。再看我们的机器。原版IQ3_S曾达到52~55 Token/s,无审查版在代码生成任务中也超过了50 Token/s。仅看这些数据,两套硬件已经进入相近的解码速度区间。而价格差距相当明显。这套双路Xeon机器,当时的整机硬件估值不到8000元。DGX Spark在国内市场的零售报价则处于约4万元档位,部分渠道更高。价格相差约5倍,部分场景下的单路生成速度却在同一量级。这是这次研究中最让我意外的结果之一。不过,这里必须说明比较边界。DGX Spark公开测试使用的是同系列原版IQ3_S,我们的50+无审查成绩来自Huihui V2和不同的代码任务。两者尚未进行完全相同模型、Prompt、量化配置和输出长度的对照测试。另外,Spark的其他优化方案已经测得更高的生成速度。它还拥有统一内存架构、紧凑体积、较低功耗,以及更值得关注的长输入处理能力。所以,这里的对比主要说明低成本硬件在特定单路Decode任务中能够取得怎样的性能,还不能扩展成两套设备整体性能的结论。但对个人安全研究来说,这已经非常有价值。如果目标是运行一套本地125B无审查模型,让它辅助代码分析、脚本开发和授权红队研究,那么有限预算下,旧CPU、大容量内存和消费级GPU的组合,确实值得认真考虑。当然,这套方案也有代价:体积更大、功耗更高、Prefill性能需要单独评估,二手平台的稳定性和维护成本也必须计算进去。回顾整个过程,从最初约20 Token/s,到超过50 Token/s;从原版拒答,到无审查版本成功运行;从怀疑CPU算力不足,到发现系统设置仍有优化空间;最后又发现8K内的机器已经能达到4万元级设备部分测试的解码速度量级。这些结果背后,有一个越来越清晰的认识:本地大模型的性价比,正在从单纯比较硬件规格,转向比较整套推理系统的效率。模型结构、量化、推理引擎、CPU/GPU协同、内存布局和投机解码,每一项都可能重新改变硬件的能力边界。不过,这次研究解决的主要还是部署成本和推理速度。真正决定红队模型价值的,还有另外一个问题:125B无审查模型,相比已经优化成熟的27B、35B,究竟能够多解决多少真实安全问题?下一步,准备把这几款模型放进同一套代码审计与授权红队任务中,用实际成功率、执行时间和任务完成质量,再做一次完整对比。 如果对自己🈶用,点👍收藏吧,如果对朋友🈶用,点❤️转发下!感谢支持❤️!!!前期高阅读文章从 11 到 200 +Token/s:35B红队本地 Agent 是如何炼成的?聊完10+AI安全厂商并调研后的思考总结聊完 10+ AI SOC 厂商后的思考总结M5 Pro 48G + 无审查模型+实测效果拿各大模型打比赛后的狂喜和后怕 转载声明:本文转载自原发布平台 (作者:南山小卫庄), 原文标题《8千整机 VS 4万DGX Spark:125B红队模型跑出50+ Token/s!》, 查看原文。 版权归原作者及原发布平台所有,本站仅作收录与展示,未对正文内容作实质性修改; 若涉及侵权请联系本站处理。 ← 微信聊天记录被改过?取证鉴定怎么看出破绽 微信聊天记录被改过?取证鉴定怎么看出破绽 →