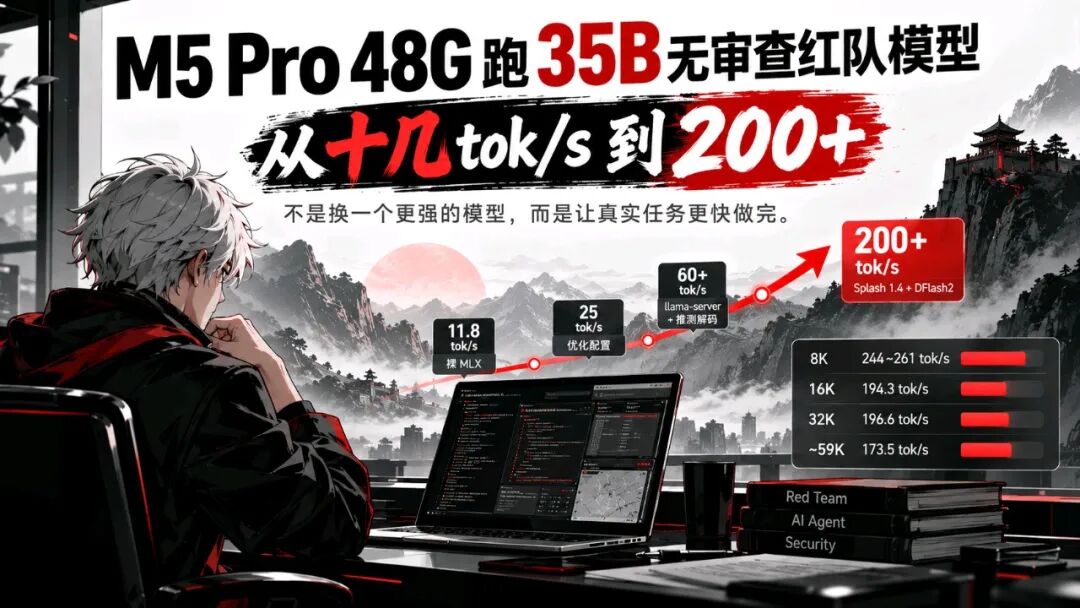
M5 Pro 48G 跑35B无审查红队模型:从十几 tok/s 到200+
上次参加行业决赛之前,我其实一直不太看好 Qwen 35B A3b。
当时更看好的是3.8 27B。Coder390强化Coding、Agent和Tool Call,EfficientThink减少过度思考,再通过Huihui解决审查。无论从模型能力还是Agent适配来看,27B都更接近我想要的红队模型。
35B留下来的理由很简单:它快。
后来比赛拿了季军。AI深度审计成为攻击端真正持续产生得分的能力,最终成功提交173次攻击,发现并形成PoC的有效漏洞大约7~8个。
比赛至少验证了一件事:本地模型真的可以进入红队实战。
于是赛后我重新捡起这个原本并不看好的35B。
既然能力已经够用,它到底还能跑多快?
最后,在一台M5 Pro 48G上,它从最早的十几 tok/s,一路跑到了 200+ tok/s。
更意外的是,接近60K上下文以后,它依然还有 173.5 tok/s。
而原本更看好的27B,在同样32K上下文测试中,完成一次任务需要 72.6秒。
35B只用了 16.7秒。
差了4倍多。
这个结果没有证明35B更聪明,却让我重新思考了一件事:
到了Agent时代,我们到底应该怎么选一个本地模型?
一、先别急着下载模型,先把“为什么难用”拆开
赛前不看好35B,并不是因为35B这个数字小。
真正的问题是,我需要的并不是一个聊天模型。
红队Agent要读代码、分析漏洞、调用工具、执行命令、读取结果、修改判断,然后继续下一轮。一个模型Benchmark很高,只要中间某一环经常掉链子,整个Agent都会停下来。
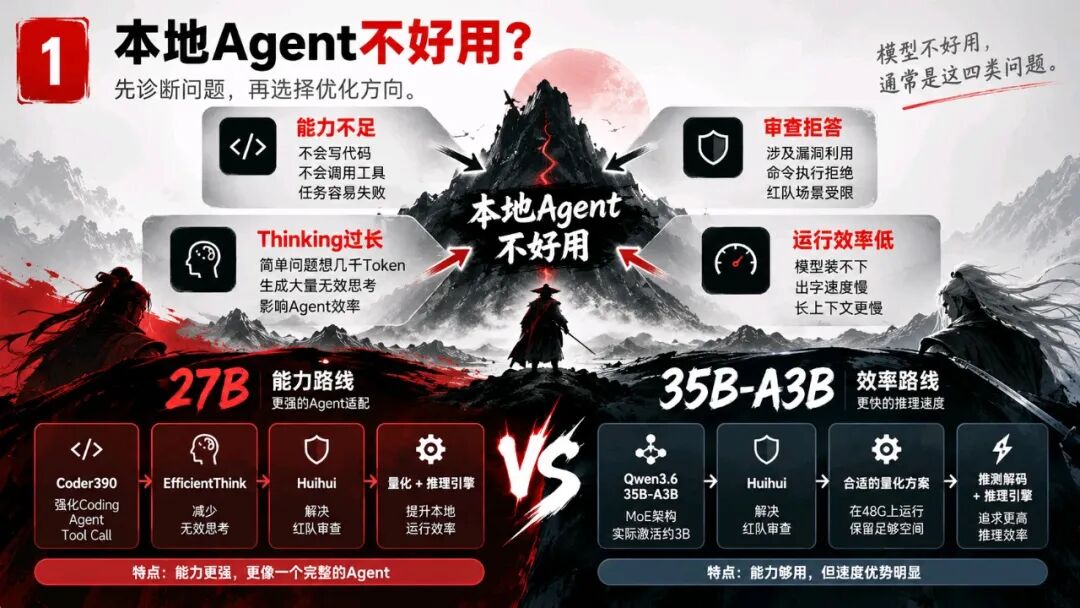
折腾27B的时候,这个问题逐渐被拆成了四层:
能力、审查、思考效率、运行效率。
27B的优化路线其实非常典型:
Coder390 → 提升Coding、Agent和Tool Call
EfficientThink → 减少无效思考
Huihui → 解决红队场景审查
量化 + 推理引擎 → 解决本地运行效率
这个拆分后来非常有用。
因为模型不好用的时候,首先要判断到底哪里出了问题。
先定位问题在哪一层,再动手。
这也是这轮折腾里最容易复用的方法。
今天如果你遇到一个模型“不好用”,甚至不需要自己研究怎么改。
把模型名称、硬件、使用场景和具体症状告诉AI,然后让它按照上面这几层逐项判断:
到底应该换模型、换微调版本、控制Thinking、重新量化,还是换推理引擎。
这比一上来就问“48GB最强能跑什么模型”有效得多。35B就是这样留下来的。
Qwen3.6-35B-A3B采用MoE架构。可以把它理解成一个拥有很多专家的团队,总规模虽然有35B,但每次只叫其中相关的一部分专家干活,实际激活规模大约3B。
所以它留下了一个非常有意思的可能:
能力上暂时没有27B那么让我满意,但它可能快得多。
于是目标变得很清楚。
先别想着让35B什么都赢。
先把它最有可能赢的地方榨干。
二、70GB塞进48GB:别只想着“能装下”
确定35B路线以后,第一个硬问题马上来了。
我选的是Huihui处理过的Qwen3.6-35B-A3B无审查版本。
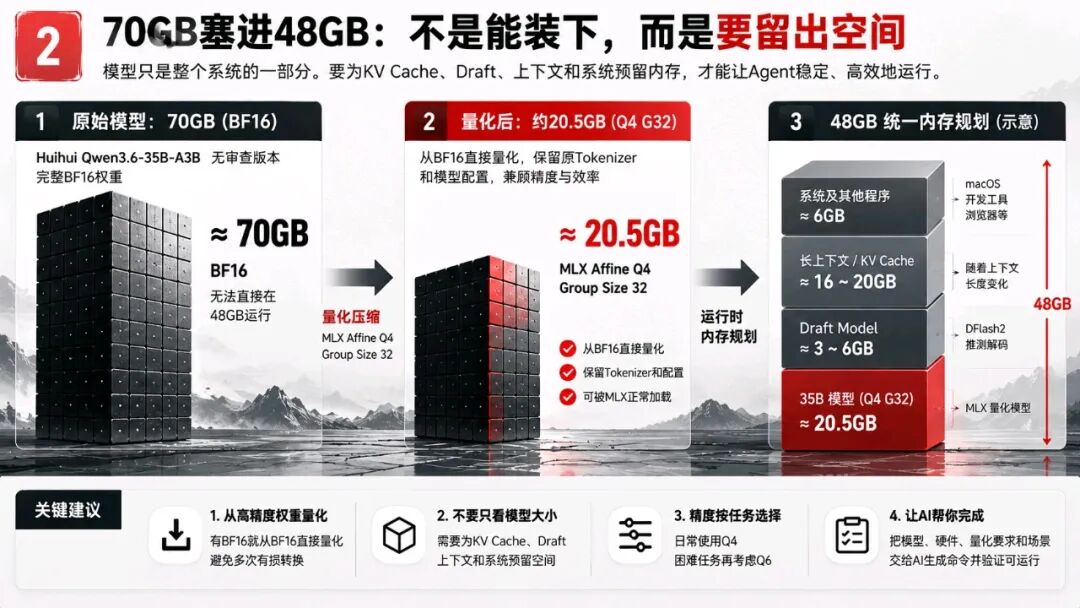
完整BF16权重接近 70GB。机器只有 48GB统一内存。看起来第一步应该是:想办法把70GB压进48GB。
后来发现这个目标本身就有问题。
因为模型即使占掉45GB,成功启动了,也没有太大意义。
Agent还要吃KV Cache,长上下文需要内存,DFlash2还要放Draft Model,操作系统和其他程序也要活着。
所以真正的问题应该改成:
35B模型最多应该占多少,才能让整个Agent舒服地跑?
最后我选择:
BF16 → MLX Affine Q4 → Group Size 32。
模型最终从约70GB降到了 20.5GB。
Q4可以简单理解成给模型参数做高质量压缩。
Group 32则决定量化尺度的分组粒度。我的选择没有追求把模型压到极限,而是在质量、内存和运行效率之间取一个平衡。
这里有三个经验可以直接拿走。
第一,有BF16原始权重,尽量从BF16直接量化。
我不希望拿一个已经量化过的模型再做一次有损转换。
第二,不要按照“模型能不能塞进内存”选量化。
要给KV Cache、Draft Model、长上下文和系统留下空间。
第三,精度要根据真实任务选。
我现在把Q4作为日常版本,Q6留给真正困难、对能力损失更敏感的任务。
如果你也有一台Apple Silicon机器,其实做到这里已经不需要自己研究具体命令。
直接把这些要求交给AI:
“这是我的模型和Mac配置。我要从BF16直接量化成MLX Affine Q4、Group Size 32,保留正确的Tokenizer和模型配置,量化后验证MLX能够正常加载,同时帮我估算模型、KV Cache和长上下文的内存预算。”
剩下的命令,让AI写。
人真正需要做的,是把几个关键选择告诉它。
最后我得到的结果是:
70GB → 20.5GB。
模型终于装得很舒服了。
然后第二个问题来了。
它还是慢。
三、从11.8到60+ tok/s,我却发现自己看错了指标
最早折腾本地推理的时候,速度真的很痛苦。
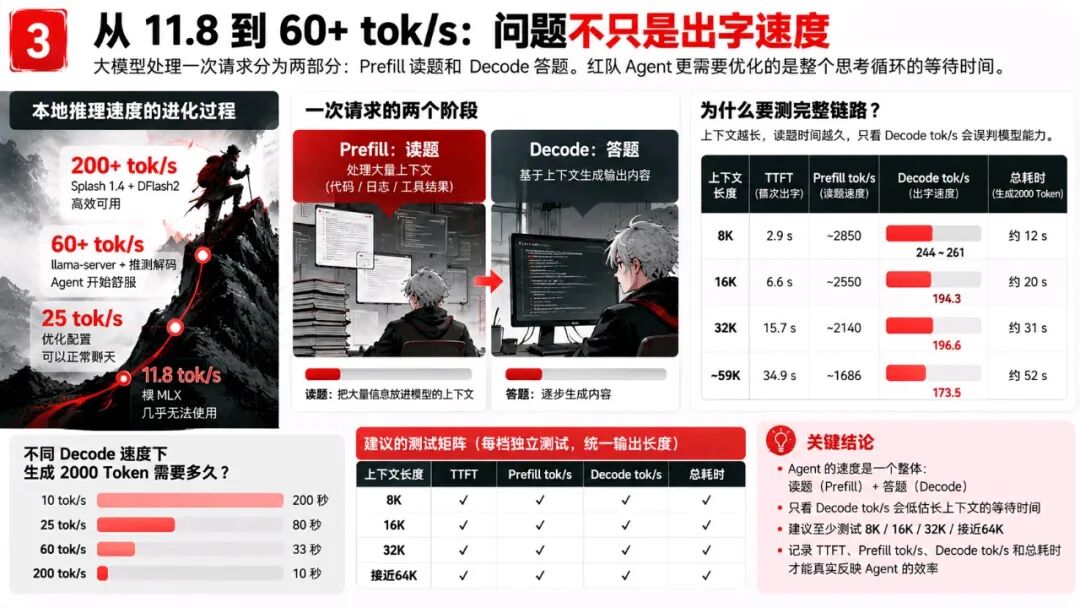
裸MLX大约只有 11.8 tok/s。后来折腾到 25 tok/s。再换到llama-server和推测解码,终于到了 60+ tok/s。每一次提升都很明显。
我自己的体感大概是:
这个表只是我的个人经验,不是什么行业标准。
但它能说明一个很现实的问题。
假设模型一次需要输出2000 Token:
10 tok/s,要200秒。
25 tok/s,要80秒。
60 tok/s,大约33秒。
200 tok/s,只需要10秒。
Agent如果一天调用几十、几百次模型,这个差距会被不断放大。
所以第一次跑到60+ tok/s的时候,我很高兴。
以为问题基本解决了。
结果真正跑长任务,还是经常等。
后来才发现,我一直盯错了一个指标。
大模型处理一次请求,大致可以拆成两部分:
Prefill:读题。
Decode:写答案。
我们平时最喜欢晒的tok/s,很多时候只是在说后半段。
但红队Agent会不断往上下文里塞代码、扫描结果、Shell输出、工具返回和历史判断。
上下文从8K涨到32K、64K以后,很可能出现一个很奇怪的情况:
答案写得飞快,读题读了几十秒。
这也是为什么我后来不再只测一个tok/s。
现在测试本地Agent模型,我至少看四个数字:
TTFT、Prefill、Decode、端到端总时间。
上下文也不会只测8K。
至少:
8K → 16K → 32K → 接近64K。
而且尽量保持同样的输出长度,避免Prefix Cache干扰。
这套Benchmark也完全可以让AI帮你生成。
只需要告诉它:
“帮我写一个本地LLM Benchmark,分别构造8K、16K、32K、接近64K的Prompt;统一输出长度;每档独立测试;记录TTFT、Prefill tok/s、Decode tok/s和总耗时;结果最后输出成表格。”
AI会把剩下的脚本补完。
到这里,我才真正意识到:
Agent需要优化的不是出字速度,是整个思考循环的等待时间。也正是这个问题,把我继续推向了Splash。
四、60+到200+:真正的变化来自Splash + DFlash2
到了60+ tok/s以后,再继续提升已经没那么容易。最后真正把速度推到另一个级别的,是:
Splash + DFlash2。
但这里又碰到了一个坑。
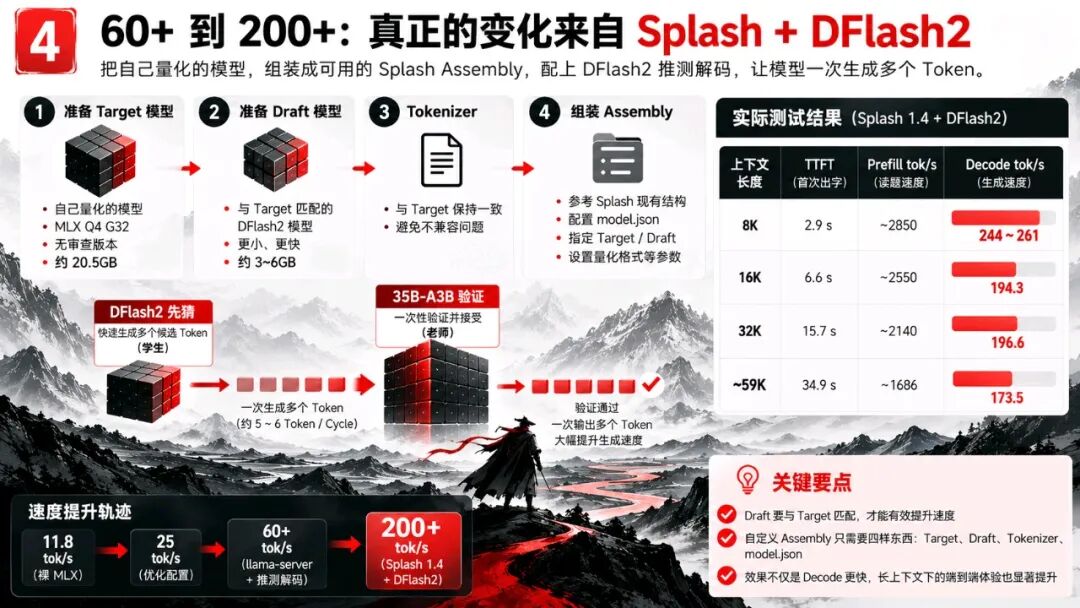
Splash可以跑模型,不代表它天然就认识我自己做出来的这个模型。
我的Target是自己从BF16量化出来的Huihui无审查Q4 G32版本,还要配对应的DFlash2 Draft。
最后我给它组了一套自己的Assembly。
核心只有四样东西:
Target:自己的35B Q4 G32模型
Draft:与它匹配的DFlash2模型
Tokenizer:与Target保持一致
model.json:告诉Splash这些东西应该怎么组合
如果你也遇到这种情况,其实没有必要手工研究整个Splash工程。
直接让AI做。
给它Splash现有Assembly作为参考,再告诉它:
“我要把自己的MLX Q4 G32模型作为Target,匹配的DFlash2作为Draft。请参考Splash现有模型的Assembly结构,为它生成对应目录和model.json,并逐项检查Target、Draft、Tokenizer和量化格式是否匹配。”
真正需要人判断的只有一个问题:
Draft到底和Target匹不匹配。
因为DFlash2的原理,本质上就是让一个更快的“学生”先往后猜,再让35B这个“老师”一次验证。
如果学生猜得准,一次计算就可以接受多个Token。我的实际测试里,大约可以做到 5~6 Token/Cycle。效果非常明显。
Splash 1.4下重新统一测试:
| 244~261 tok/s | |||
| 194.3 tok/s | |||
| 196.6 tok/s | |||
| 173.5 tok/s |
从最早的 11.8,到现在最高 250左右。
已经超过20倍。
但这张表里,我最喜欢的其实不是250。
是最后一个:
59K,173.5 tok/s。
8K跑得飞快,只能证明它聊天很爽。
接近60K以后还能维持这个速度,才意味着代码、日志、工具结果和历史对话堆起来以后,它依然有机会保持很高的Agent效率。
所以如果让我重新走一遍,这条路线其实很清楚:
先选对模型 → 解决审查和Thinking → 从高精度权重做合适量化 → 给系统留内存 → 优化Prefill → 接推测解码 → 最后测长上下文衰减。
这条路线,比“找一个最高tok/s模型”重要得多。
五、35B快了4倍以后,我反而不知道该选谁了
跑到这里,故事重新回到了文章开头。
我原来一直更看好27B。现在依然没有证据证明35B能力超过它。27B的优势很清楚:
Coder390强化Coding、Agent和Tool Call。
EfficientThink控制无效思考。
Huihui解决审查。
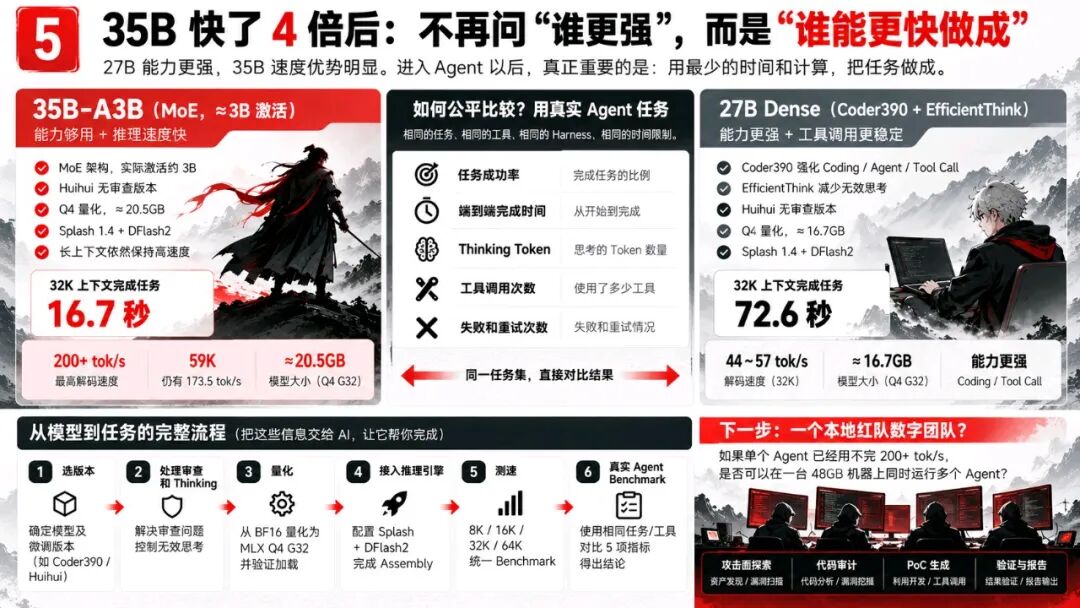
但同样放进Splash 1.4以后,一个巨大的差距摆在面前。
32K上下文:
35B-A3B:16.7秒。
27B Dense:72.6秒。
超过4倍。
这时候再问“哪个模型更强”,我已经觉得这个问题不够好了。
真正应该问的是:
谁能更快把事情做成?
一个模型200 tok/s,却想了4000 Token,需要20秒。另一个模型100 tok/s,只想500 Token,5秒就形成正确判断。
再加入Agent以后,还要继续计算工具调用、失败重试和错误路径。
所以我现在准备把最终测试改成真正的Agent Benchmark。
给两个模型相同的任务、相同的工具、相同的Harness、相同的时间限制,然后只看五件事:
任务成功率。
端到端完成时间。
Thinking Token。
工具调用次数。
失败和重试次数。
这套测试也不需要自己从零写。
把这五个指标、两个模型API和你的Agent Harness告诉AI,让它生成测试集、日志格式和统计程序。
最后真正比较的,是:
完成一个有效任务,需要付出多少时间和计算。
这可能也是这轮折腾以后,我最大的认知变化。
赛前我更看好27B,因为它在模型层面更像一个优秀的Agent。
比赛以后,我开始认真对待35B,因为它已经证明能力够用。
跑到200+以后,我又发现:
模型进入Agent以后,推理速度、思考长度、工具效率和任务成功率,其实已经变成了同一道题。
而200+ tok/s又留下了下一个问题。
如果一个Agent已经吃不完这些性能,那能不能同时跑四个?
一个负责攻击面,一个负责代码审计,一个负责PoC,一个负责验证。
一台48G Mac,到底能够支撑一个什么规模的本地红队数字团队?
刚好,下一轮又有一个很值得等的变量:
Qwen4-27B。
等它真正出来,我准备把今天这套流程直接交给AI:
选版本 → 处理审查和Thinking → 量化 → 接Splash和推测解码 → 跑8K到64K → 最后扔进真实Agent Benchmark。然后看看这一次,27B还能不能把答案重新改回去。