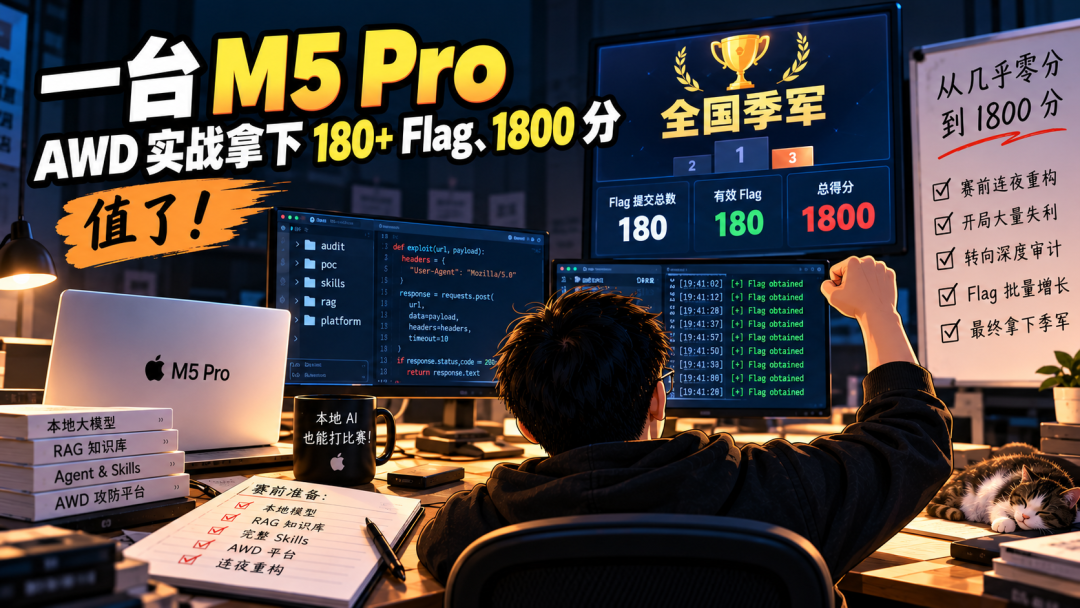
摘要: 为了参加一场行业决赛,专门买了台 M5 Pro,准备了本地模型、RAG、Skills 和自动化平台。赛前一晚连夜重构,开局却依然失利。直到改变 AI 的工作方向,才从几乎拿不到分走向批量获取 Flag。最后拿到季军,这台设备终于证明了自己的价值。
一、为比赛买的M5 Pro,开局却几乎拿不到分
为了参加一场网络安全行业决赛,前段时间专门买了一台 48GB 内存的 M5 Pro Mac。
目的很明确:在本地部署大模型,让 AI 真正参与网络安全攻防。
此前已经做过多轮本地模型和 Agent 测试,研究过 27B、35B 等模型,也比较过 Pi、Codex 以及不同推理方案的表现。相关内容在之前几篇文章中写过,这次就不重复展开了。
有了明确的比赛目标,准备工作也变得更加深入。
除了本地模型,还准备了 RAG 知识库,编写了一整套 Skills,又开发了一套功能完整的 AWD 攻防平台。从源码备份、漏洞扫描、代码审计,到漏洞利用和防御处理,基本把能想到的功能都做进去了。
可以说,为了这场比赛,能准备的东西几乎都准备了。
然而,真正开始对抗后,情况却远远没有预想的顺利。
比赛中的 AWD 环节只有两个半小时,每十分钟左右一轮。时间非常紧张,一个漏洞晚几分钟利用,可能就少拿一轮分,甚至等到对手已经修复。
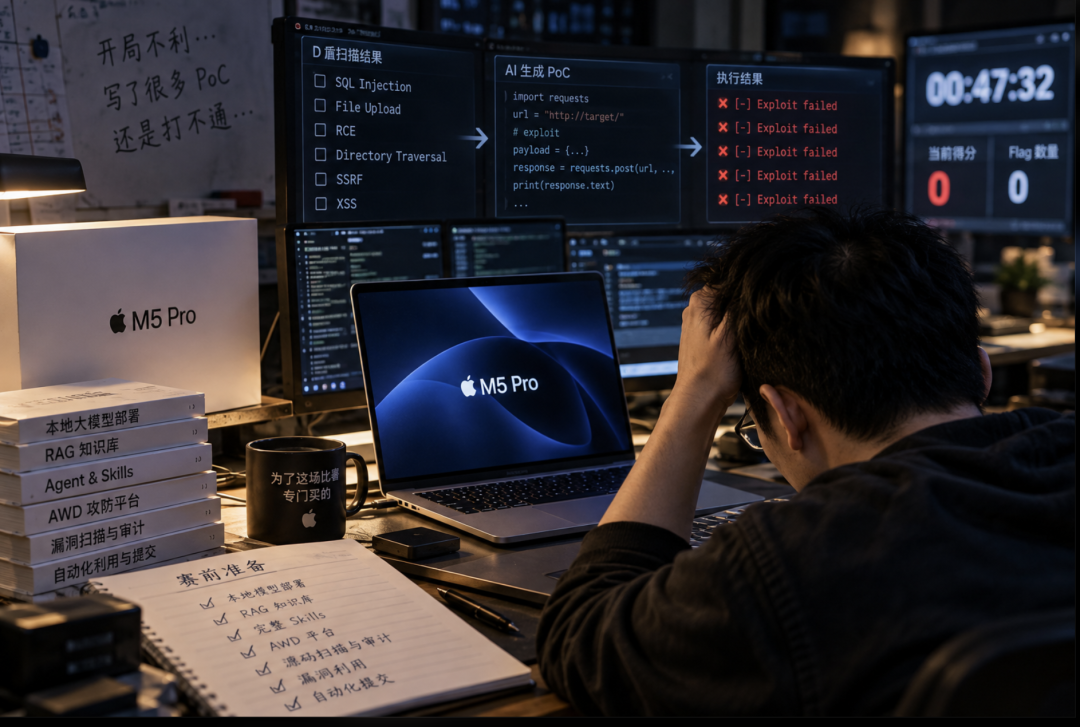
开局采用了比较熟悉的打法:先用 D 盾快速扫描源码,发现基础漏洞,再让 AI 编写 PoC,交给自动化平台执行。
AI 写代码确实很快,接连产出了不少 PoC。
可真正去打,几乎全部失败。写一个,打不通。换一个,还是打不通。
时间不断流逝,PoC 写了不少,Flag 却迟迟拿不到。
比赛前面大约三分之一的时间,进攻几乎没有像样的成果。
当时真的有点绝望。
为了这场比赛专门买了设备,花了大量时间研究模型、准备工具,连自动化平台都写好了。结果真正上场,AI 忙了半天,却似乎没有帮上多大忙。
最难受的,是一直在忙,却没有结果。
更讽刺的是,就在比赛前一天夜里,为了让这套系统真正好用,我还推翻了之前准备的方案,连夜重构了一次。
二、比赛前夕,我删掉了一半的平台和 Skills
最初设计 AWD 平台时,想法其实很简单。既然比赛有那么多工作要做,就按照实际流程拆成不同模块,再把它们集中到一个平台里。
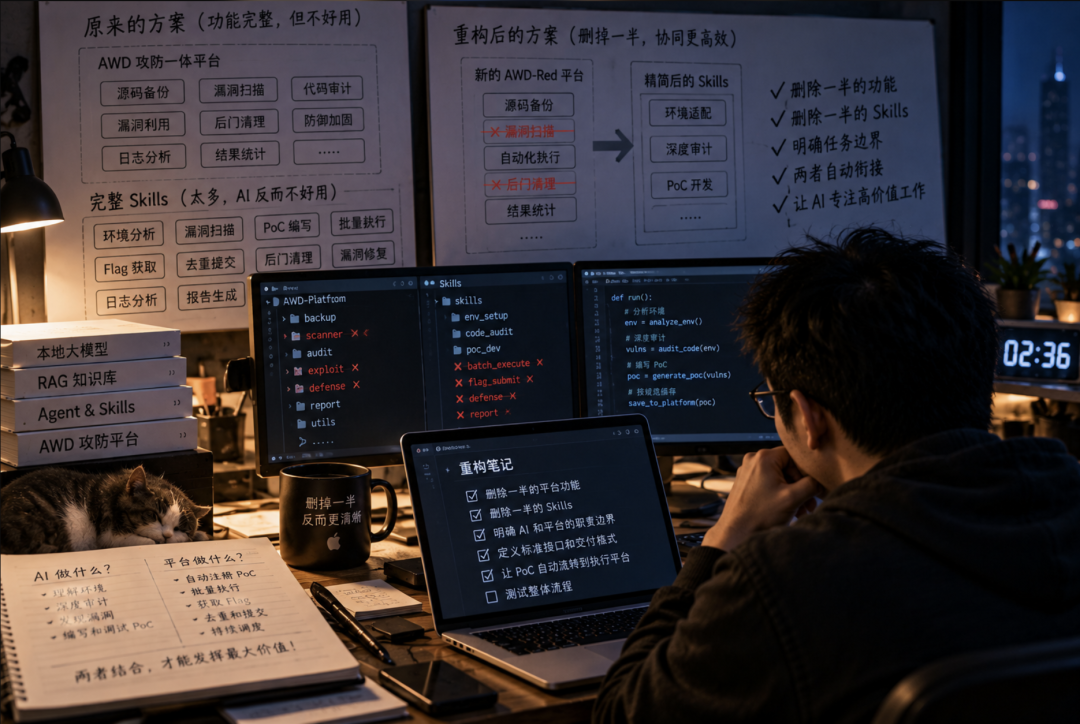
于是,源码获取、备份、扫描、审计、漏洞利用、后门清理等功能逐渐被做了进去。
从功能清单看,已经相当完整。但实际测试之后发现,它并不好用。
一个模块执行完,还要人工查看结果、判断下一步、切换模块,再触发另一个模块。每个功能都存在,却没有形成真正连续的自动化流程。
后来又尝试通过 Skills 让 AI 自动调用这些能力。
结果又遇到了另一种问题。
AI 可以理解环境、分析源码、寻找漏洞,也能编写和调试脚本。但如果让它反复执行 PoC、收集 Flag、去重、提交,再等待下一轮重新执行,就会消耗大量时间和推理资源。
AI 一直在操作工具,就没有足够的时间研究新的漏洞。
到了比赛前一天夜里,终于想明白了一件事:
想让 AI 包办所有工作,很难;让平台包办所有工作,同样很难。关键是让它们各自承担最适合的任务。
于是,当晚重新设计平台和 Skills,删掉了约一半的功能,把剩下的能力重新组合起来。
需要根据环境变化进行判断的工作,交给 AI。
例如理解代码、深入审计、分析漏洞、编写和调试 PoC。
需要高频、批量、重复执行的工作,交给自动化平台。
例如批量利用、轮次调度、获取 Flag、去重和提交。
而 Skills 负责明确 AI 的工作范围和交付标准:要做什么、怎么做、接口是什么、怎样验收、最终把文件放在哪里。
AI 写好 PoC 后,只需要把文件放进平台约定的目录。
重新设计的 AWD-Red 平台会自动发现新 PoC、热注册、批量执行,并接管后续所有重复工作。
AI 可以立即开始研究下一个漏洞,平台则持续运行已经交付的 PoC。
这样,两个系统终于能够并行工作。
AI 负责生产高价值成果,平台负责持续执行,Skills 负责让两者自动衔接。
比赛前夜折腾到这一步,原本觉得问题应该解决得差不多了。
没想到,第二天开局依然打得十分艰难。
三、架构跑通了,为什么还是打不进去?
这也是本次实战最让我意外的地方。赛前重构已经解决了执行效率的问题。
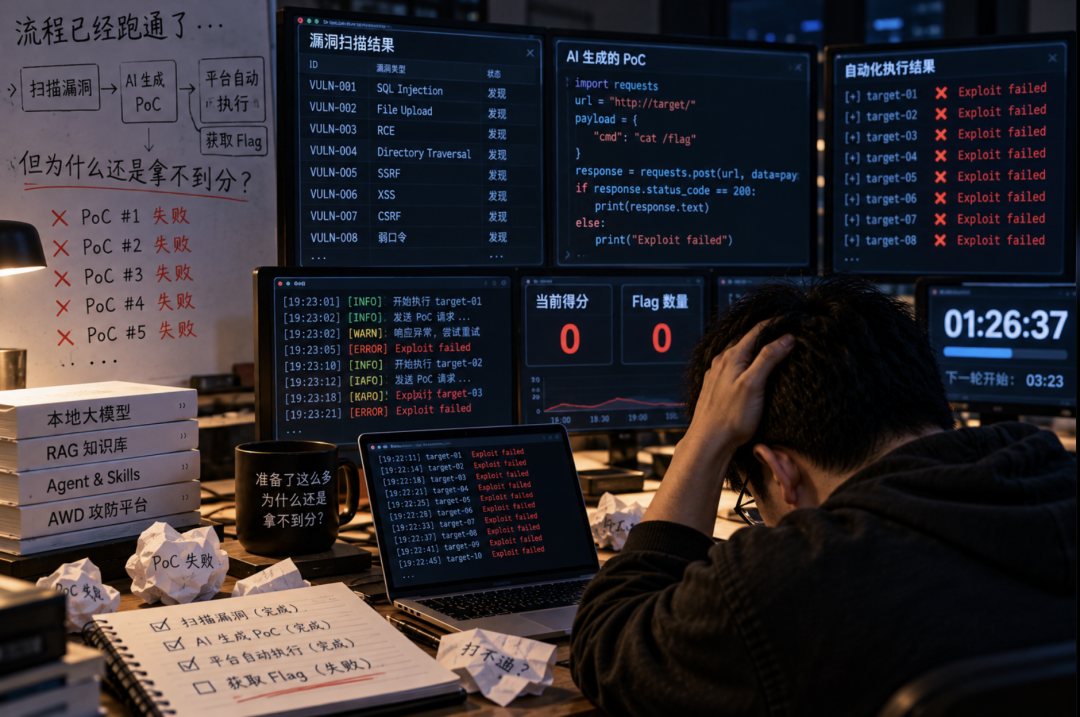
35B-A3B 模型能够快速编写 PoC,Skills 能够约束交付格式,AWD-Red 也能够自动注册、调用、执行和提交。
从技术上看,整套流程已经跑通。但有一个更根本的问题被忽略了:
如果漏洞本身已经被修复,再快的模型、再完善的自动化平台,也拿不到分。
开局通过 D 盾发现的基础漏洞,恰好遇到了这个问题。
这次对抗中,现场很多队伍都在使用 AI。
过去需要人工花时间排查的问题,现在通过扫描工具和 AI,很快就能被发现。对手也可以利用 AI 辅助分析与修复。
基础漏洞的竞争变得非常激烈。有时候相差几十秒,原本能够利用的漏洞就可能失效。
于是出现了一个非常尴尬的局面:模型在快速写 PoC,平台在自动执行,但整套系统一直围绕着已经无法利用的漏洞忙碌。
工具都在正常工作,得分却没有增长。前期投入的大量时间,就这样被消耗掉了。
这时开始重新判断问题所在。
继续让 AI 围绕扫描结果写更多 PoC,可能只会得到更多失效的脚本。
真正需要改变的,是漏洞研究方向。
当大家都开始使用 AI,容易发现的基础漏洞很难再形成持续优势。能够深入挖掘别人尚未发现的漏洞,才可能打开局面。
于是,决定调整策略。
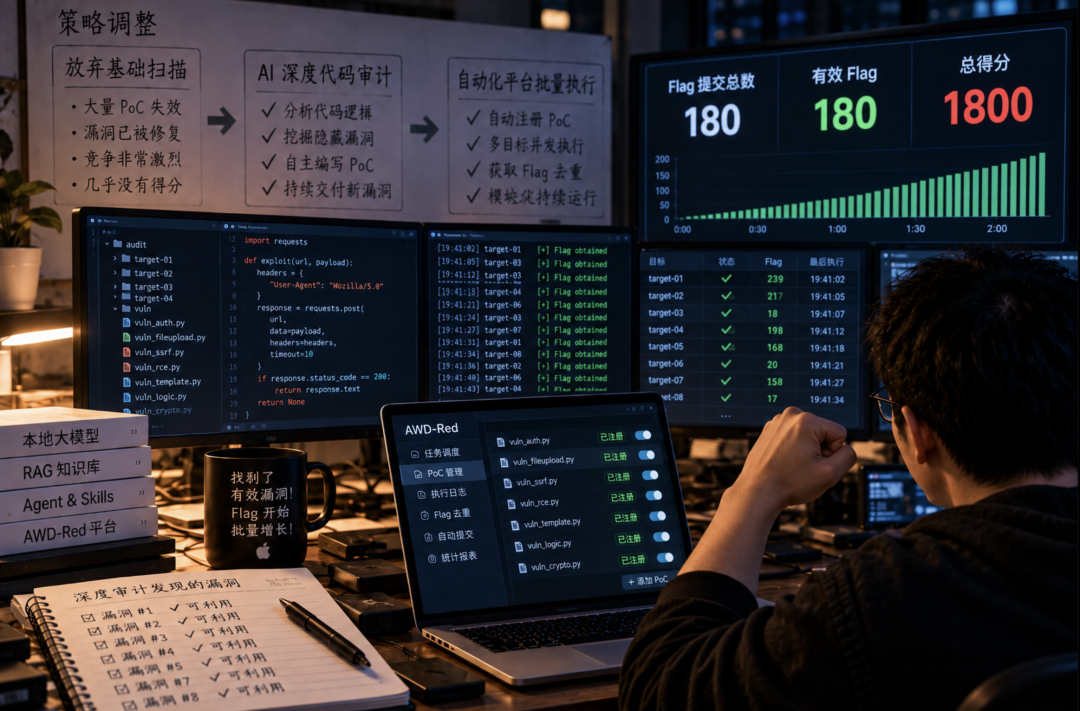
让 AI 放弃继续围绕基础扫描结果反复尝试,直接深入源码,独立开展深度代码审计。
当时其实也没有把握。
毕竟,前面已经浪费了不少时间。如果这条路依然走不通,后面能够追回来的机会就更少了。
但至少有一点很清楚:继续重复已经失败的方法,很难改变比赛结果。
四、换了策略之后,Flag 开始批量增长
改变方向后,开始让本地 35B-A3B 模型深入研究源码,分析代码逻辑,寻找那些常规扫描不容易发现的隐蔽漏洞。
选择这个模型,有一个很现实的考虑:速度。
AWD 是限时对抗。模型需要具备足够的代码理解和分析能力,同时必须能够快速完成 PoC 开发和调试。
更大、更聪明的模型,在某些复杂任务上可能有优势。但如果响应速度明显变慢,研究结果和 PoC 就可能错过利用窗口。
这台 M5 Pro 在赛前经过了多轮推理优化,包括引擎、量化和其他运行环节的调整。
比赛中还有同学问,为什么我的模型跑得这么快。
其实没有什么神秘之处,就是此前反复测试和优化的结果。具体怎么优化的、速度最终达到了什么水平,可以留到下一篇文章再聊。
这次最关心的是:它能不能在有限时间里,持续产出有效的 PoC。
没想到,改变策略之后,局面真的发生了变化。
AI 陆续发现了约 7~8 个比较隐蔽、能够实际利用的漏洞,并完成对应的 PoC 开发。
有些漏洞直到对抗结束时,仍然可以在部分目标上利用。
这与开局那些很快失效的基础漏洞形成了鲜明对比。
每当 AI 写好一个有效 PoC,就按照 Skills 的规范放入指定目录。
AWD-Red 自动热注册,开始对多个目标、多个轮次持续执行。
与此同时,AI 继续审计源码,寻找下一个漏洞。
终于,Flag 开始批量增长。
整个过程中,平台产生了四五千条量级的 Flag 相关结果,包括重复获取、跨轮次结果和无效记录。
如果让 AI 逐条执行、整理和提交,时间根本不够用;如果全部依靠人工,同样无法处理这样的工作量。
最终,平台完成约 180 次 Flag 提交,获得约 1800 分的进攻成绩。
其中有效提交约 170 多次,全部来自 AI 深度审计发现的漏洞。
从前面三分之一时间几乎拿不到分,到后面连续获得大量 Flag,这个反差非常明显。
尤其是回头想想,如果没有这台 M5 Pro,会怎么样?
如果完全依靠自己现场使用传统工具进行深度代码审计、寻找漏洞、编写和调试 PoC,两个半小时可能只能深入研究出一个漏洞。
能不能最终调试成功,都没有把握。
即使运气不错,找到一个能够利用的漏洞,再依靠人工反复执行、收集和提交,估计连 10 个有效 Flag、100 分都未必拿得到。
这只是根据个人经验作出的估计,没有进行严格的对照实验。
但正因为以前亲自做过这些工作,才知道每一步需要消耗多少时间。
从人工可能连 100 分都拿不到,到 AI 与平台协作获得约 1800 分。
这个差距,才让我真正感受到本地 AI 在实际工作中能够创造多大的价值。
同时也明白了,为什么赛前那次连夜重构如此重要。
架构解决了怎样高效协作的问题,策略转向解决了什么工作真正值得投入的问题。
两者结合,才有了最后的结果。
五、最后拿到季军,这台 M5 Pro 值了
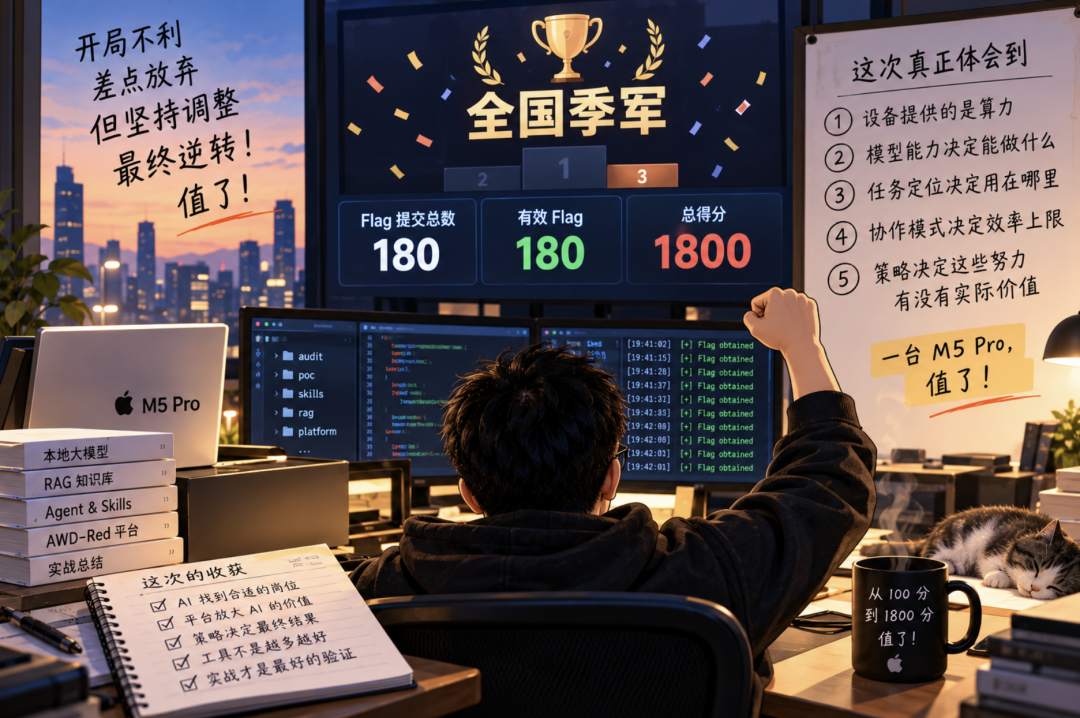
最终,这场行业决赛,我们拿到了季军。这个成绩基本符合最初的预期。
但比结果更让我印象深刻的,是同一场比赛里,大家对 AI 的评价并不相同。
有些小伙伴认为,AI 在比赛中没有帮上太多忙。
而在我看来,如果没有这台 M5 Pro 上的本地 AI,自己可能连 100 分都拿不到。
为什么同样是使用 AI,感受会有这么大的差异?
回头看,答案可能就在整个准备和比赛过程中。
最初,专门买了设备,准备了本地模型、RAG、完整 Skills 和一套功能齐全的攻防平台,希望 AI 能够承担尽可能多的工作。
后来发现,功能堆得越多,实际使用未必越高效。于是比赛前夜删掉一半的平台和 Skills,重新划分 AI 与自动化程序的工作边界。
真正开始对抗,又发现即使系统已经跑通,如果让 AI 持续研究那些已经失效的基础漏洞,依然没有价值。
直到调整策略,让它专注深度代码审计,再通过平台持续执行有效 PoC,才真正把能力转化成了得分。
这几次转折,让我重新认识了本地 AI 的价值。
模型能力决定它能够完成什么任务,任务定位决定它把能力用在哪里,协作模式决定成果能否被持续放大,策略则决定这些努力有没有实际价值。
过去研究本地模型,经常关注参数量、Token 输出速度、量化精度和Agent能力。
这些当然重要。但真正面对高强度、时间有限的实际任务时,仅仅拥有模型和工具还远远不够。
需要把适合 AI 的任务交给 AI,把确定性的重复工作交给程序,让 Skills明确执行边界和交付接口,再由人根据现场情况调整方向。
这次,M5 Pro终于找到了适合自己的位置:一名专职进行深度代码审计和 PoC 开发的本地 AI 攻击手。
如果现在再问,为了这场比赛专门购买它,值不值?
我觉得值了。而且非常值如果我按照这个套路防御,我觉得问题也不大。
特别是在开局非常不利、准备工作一度看不到效果的情况下,最后还能拿到约 1800 分的进攻成绩,并获得季军。
当然,成绩来自人工判断、AI模型、Skills和自动化平台共同协作。任何一个环节单独拿出来,都无法保证同样的结果。
但在这套体系中,M5 Pro上的本地 AI 承担了最重要的漏洞研究和 PoC 开发工作,发挥了实实在在的作用。
买设备获得的是算力,找到正确的定位和协作方式,才能让算力真正创造价值。
细思极恐的是,如今一台普通电脑上的本地AI,已经能够分析代码、发现漏洞、编写程序、调用工具,完成大量过去需要专业人员才能完成的工作。然而,面对同样的技术,有些人依然觉得AI没有太大帮助,有些人却已经能够让它独立承担复杂任务,并创造实际价值。
当AI的执行能力越来越强,人与人之间真正拉开差距的,可能就是认知、判断、策略,以及组织和驾驭AI的能力。更可怕的是,有些人已经开始改变工作方式,有些人却还没有意识到变化正在发生。
至于这台设备的推理速度如何优化到 100+token/s 的,以及那套连夜重构的 AWD-Red 平台到底是怎样设计的,后面再分别展开。如果你也在研究本地 AI 与自动化平台协作,欢迎交流。
如果需要配置详情和平台代码,欢迎后台找我。
如果对自己🈶用,点👍收藏吧,
如果对朋友🈶用,点❤️转发下!
感谢支持❤️!!!
前期高阅读文章
一寸光阴一寸金。愿这几十小时实践沉淀下来的东西,能替你省下一些时间,少走一些弯路,也带来一点启发。