摘要: 为了用 AI 打 AWD,花了大量时间开发和优化全量 Skills,原以为准备得越来越充分,心里却越来越慌。比赛前夜,索性重构整套工具,将重复、并发的工作交给自动化平台,让 Agent 专注漏洞研究。最终,这套系统在实战中完成了大量目标的持续攻击,取得 180+ Flag 量级的成果。这次经历,让我重新理解了 Agent、Skills 和自动化的边界。
一、花了大量时间写 Skills,为什么最后却越来越慌?
比赛之前,一直在研究怎样利用 AI Agent 打 AWD。
当时非常喜欢 Agent + Skills 这种模式。
在我看来,Skills 是一个很有价值的东西。它能够把安全人员的工作经验、执行步骤和工具使用方法交给大模型,让 Agent 按照既定流程完成任务。
尤其是 AWD,整个比赛流程中有大量相对成熟的安全工作。
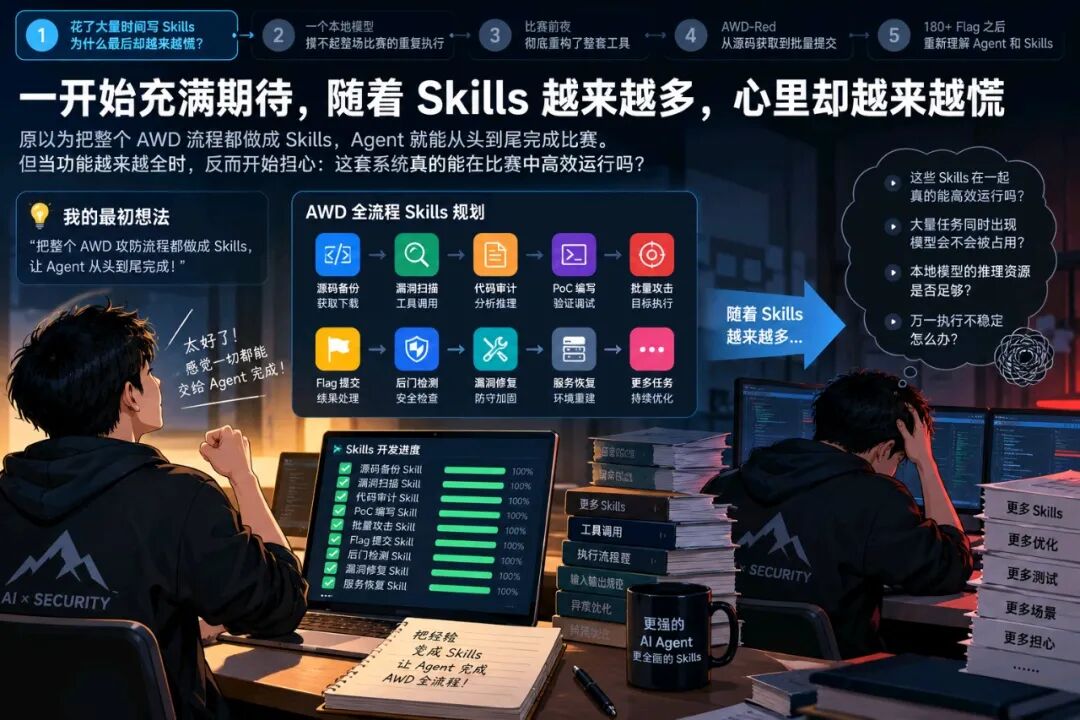
源码备份、漏洞扫描、代码审计、PoC 编写、批量攻击、Flag 提交,以及后门检测、漏洞修复、服务恢复……
这些工作看起来都可以通过 Skills 组织起来。
所以最初的想法很直接:
能不能把整个 AWD 攻防流程都做成 Skills,让 Agent 从头到尾完成?
接下来,花了大量时间做这件事。
先梳理完整流程,再让大模型编写 Skills,然后不断优化。
有些 Skills 的执行步骤不够清晰,就补充提示词;有些工具调用不稳定,就调整流程;有些任务之间衔接不好,就修改输入输出和交付标准。
为了让模型更好地完成任务,还反复调整过 Skills 的指导方式和执行细节。
整个过程投入了不少时间和精力。
而且最初确实很有成就感。
每完成一个 Skill,就意味着 Agent 又多了一项能力。原来需要人工操作的事情,现在似乎都可以交给模型。
随着 Skills 越来越完善,整个系统也逐渐覆盖了 AWD 的大部分工作。
当时觉得,准备得越全面,比赛时就越有把握。
但等到全量 Skills 基本完成,开始真正考虑比赛当天怎么运行时,情况却发生了变化。
功能越来越全,心里反而越来越慌。
这些 Skills 单独执行或许没有问题,但如果大量任务同时出现,整套系统真的能够高效运行吗?
尤其是当所有工作都需要依赖同一个本地模型时。
这个问题,最终成为整套架构重构的起点。
二、一个本地模型,撑不起整场比赛的重复执行
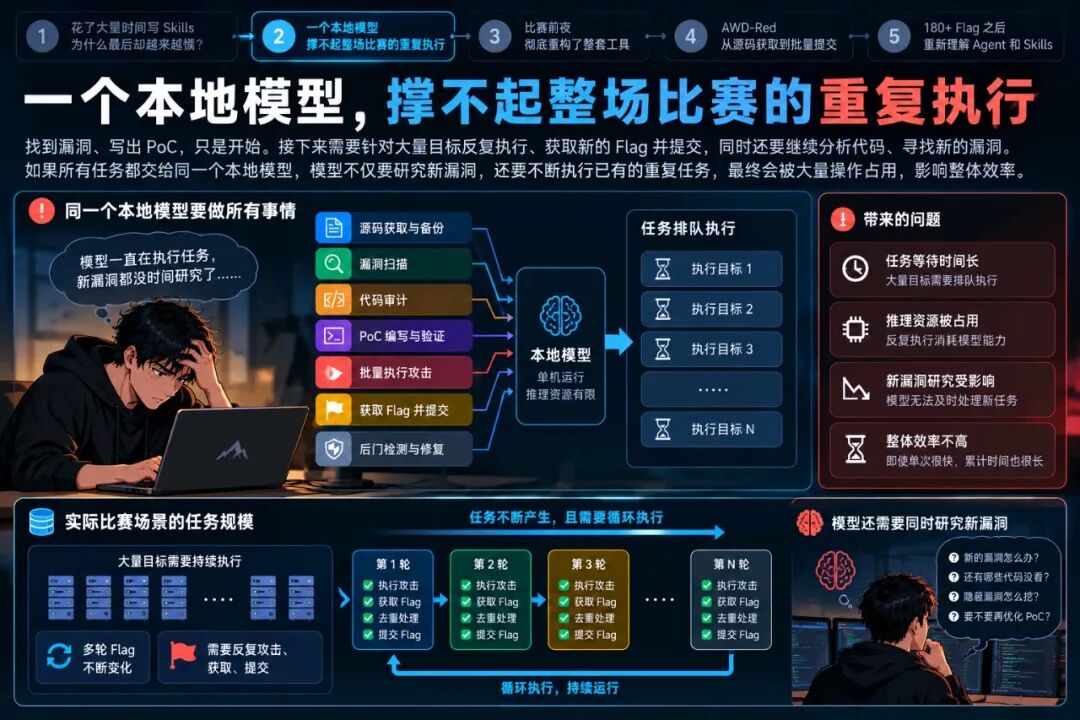
真正让我焦虑的,是并发。当时只有一个本地模型。虽然前期已经做过不少性能优化,但生成速度和推理资源终究有限。
而 AWD 比赛有一个很特殊的地方。
找到漏洞、写出 PoC,只是开始。
接下来,需要针对大量目标批量执行。
比赛中的 Flag 还会随着轮次不断变化,需要反复攻击、获取新的 Flag,再完成提交。
与此同时,模型还需要继续分析代码、寻找新的漏洞。
这就带来了一个矛盾。
如果所有任务都通过 Agent + Skills 完成,那么模型不仅要负责漏洞研究,还要反复参与批量执行、结果处理和任务调度。
哪怕每次操作只消耗几秒,放到大量目标、多轮比赛中,累计时间也可能变得难以接受。
更麻烦的是,模型一旦被已有任务占用,就会影响新漏洞的研究。
想象一下:
模型已经发现一个漏洞,并成功写出 PoC。
但接下来,为了利用这个漏洞,还需要让模型不断选择目标、调用工具、判断结果、提交 Flag。
同样的工作,可能要执行几十次、几百次,甚至更多。
模型明明已经解决了最困难的问题,为什么还要让它反复参与后面的固定操作?
这里其实涉及两个不同的问题。
一个是任务的可重复性,另一个是任务的并发性。成熟 PoC 可以反复执行,但不代表需要模型每次重新参与。
而大量任务同时运行,更需要考虑执行吞吐量、调度效率和资源竞争。尤其是本地模型,并发 Agent 越多,不一定意味着整体速度越快。
此时再回头看那套全量 Skills,就发现一个问题:
很多工作虽然能够通过 Skills 完成,但它们已经没有必要继续消耗模型的推理资源。
Agent 能做一件事,不代表这件事就应该一直交给 Agent 做。
距离比赛只剩一个晚上,必须重新做选择。
三、比赛前夜,彻底重构了整套工具
比赛前一天晚上,开始重新审视整套系统。
首先考虑的是比赛策略。
按照当时的规则,进攻成功可以直接得分,防守成功主要是避免失分。
结合团队分工,最后决定彻底放弃自己原来规划的防守工作,把精力集中到进攻。
但这只解决了任务范围的问题。
更关键的是,原来的全量 Skills 架构也需要重新设计。
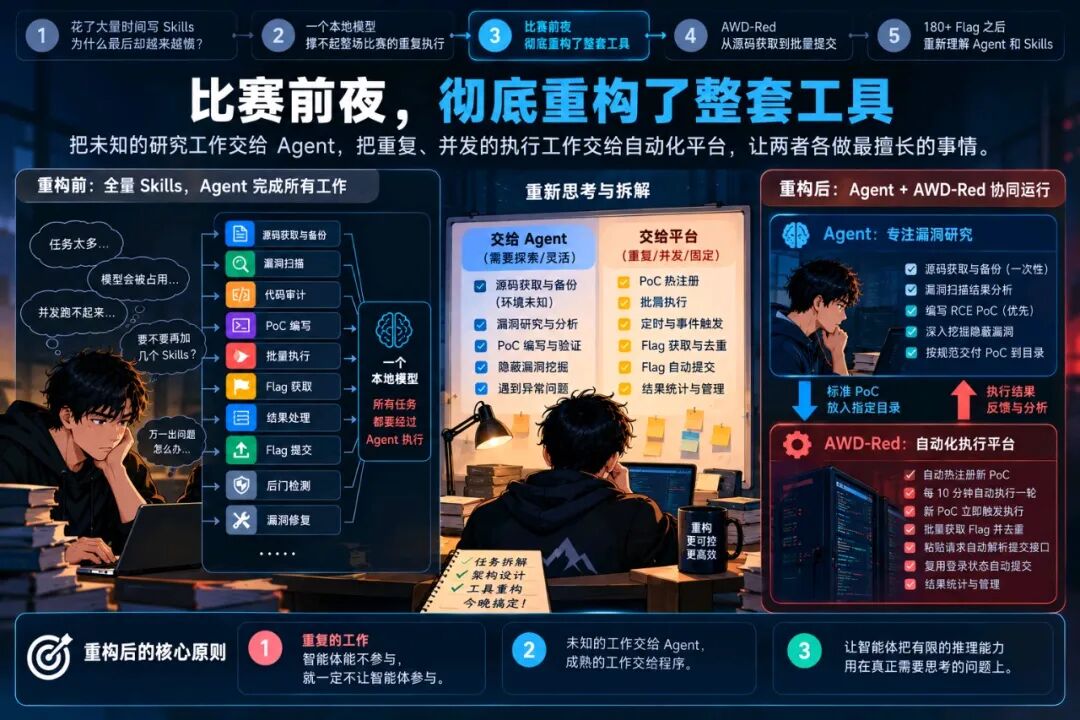
于是,把整个攻击流程重新拆解了一遍。
第一类:未知、需要探索的工作。
例如,比赛前根本不知道靶机源码放在哪里,也不清楚具体的目录结构和部署环境。
源码下载与备份虽然只需要执行一次,但需要根据现场环境进行判断。
这种工作交给 Agent + Skills 更稳妥。
同样,代码审计、漏洞研究、PoC 编写,也需要模型进行分析、推理和调整。
第二类:成熟、重复、需要并发的工作。
例如,批量运行 PoC、获取 Flag、去重、自动提交、周期性执行。
这些工作的执行逻辑相对明确,而且需要大量重复。
于是决定将原来通过 Skills 完成的重复性工作,直接提炼成工具的原生自动化能力。
由此,AWD-Red 作为独立的红队自动化执行平台形成了。
这次重构有一条非常明确的原则:
重复的工作、批量并发的工作,智能体能不参与,就一定不让智能体参与。
但 Agent 和平台也不能各干各的。
还需要让两者形成一套顺畅的协作机制。
Agent 负责发现漏洞、编写符合标准的 PoC;平台自动接收研究成果,持续执行后续工作。
整个架构从原来由 Agent 主导全流程,变成了 Agent 与自动化平台协同运行。
最有意思的是,这次重构完成之后,心态反而平静了。
前面花了大量时间,让 Skills 尽可能覆盖所有工作。
可功能越来越全,反而越来越担心整个系统跑不起来。
到了比赛前夜,重新设计了工具,把大量重复执行工作从模型中剥离出去,心里却踏实了。
因为现在知道,每一项工作应该由谁完成,系统的运行边界在哪里。
最初的安心来自功能越来越全面,最后的踏实来自整个系统真正变得可控。
四、AWD-Red:从源码获取到批量提交,形成自动化闭环
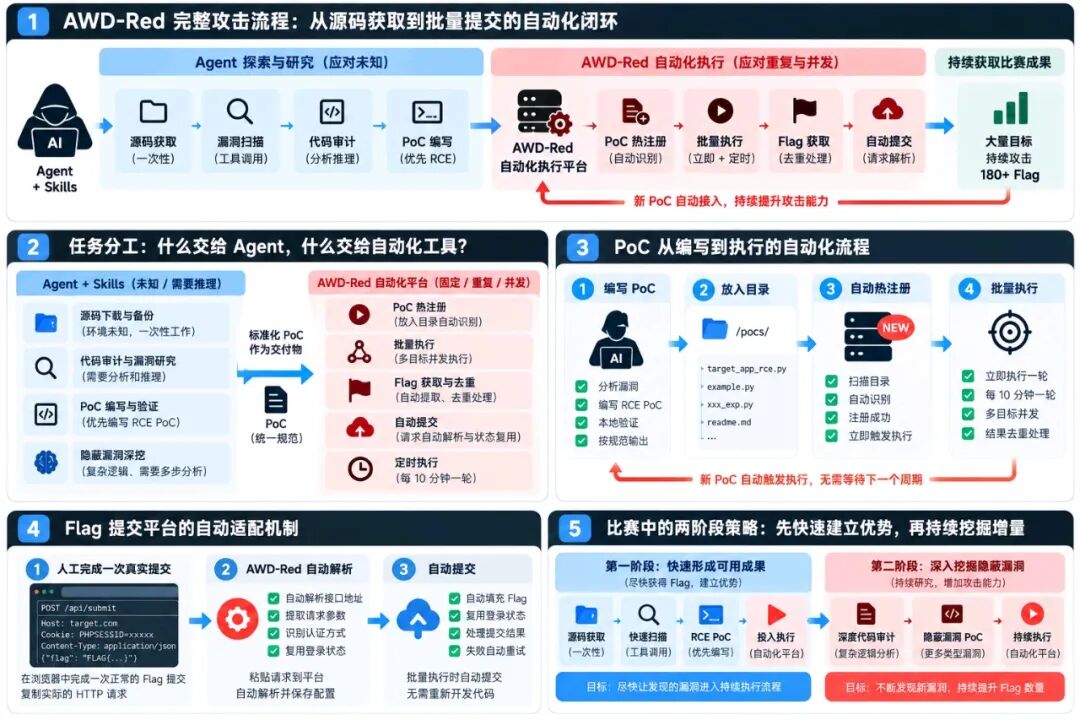
重构之后,整个攻击流程分成了两个阶段。
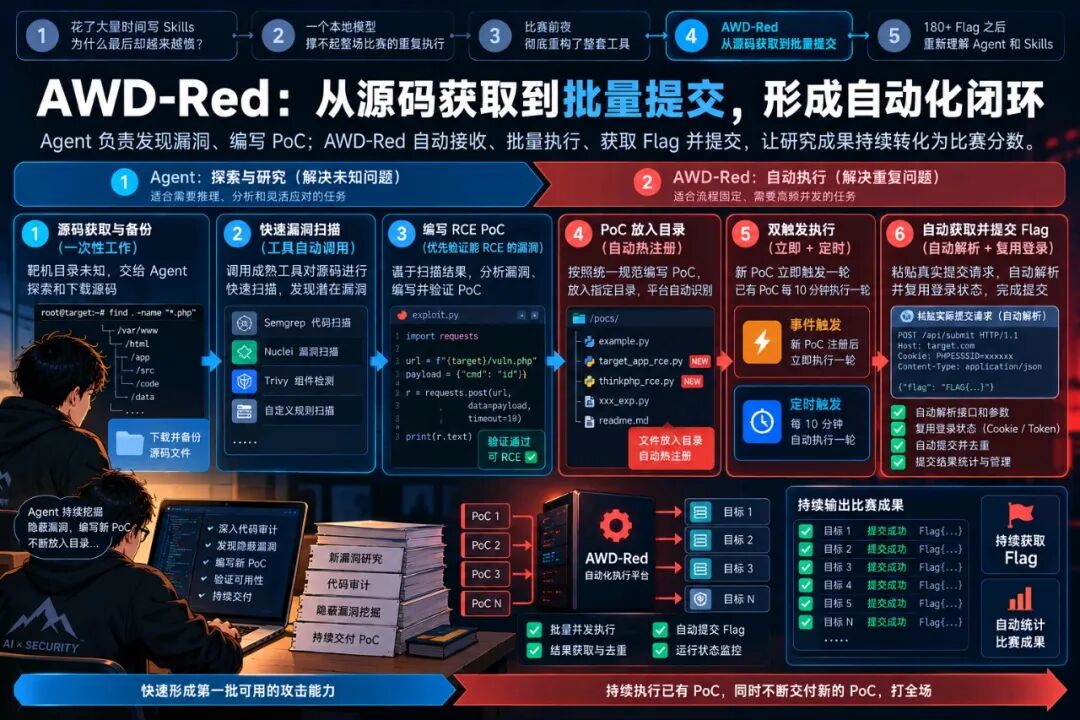
第一阶段:快速发现漏洞,尽快形成攻击能力。
比赛开始后,首先通过 Agent + Skills 完成源码定位、下载和备份。
为什么这一步没有直接固化成脚本?
因为比赛之前不知道源码目录、部署结构和具体环境,而且正常情况下只需要执行一次。
让 Agent 探索环境并完成准备,既能够适应未知情况,也不会产生大量重复推理开销。
源码获取完成后,自动调用成熟的安全工具进行快速漏洞扫描。
这里还有一个明确的策略:
快速扫描阶段优先编写能够实现 RCE 的 PoC。
目的很简单,尽快形成可以投入比赛的有效攻击能力,避免在初期把时间分散到大量低优先级问题上。
Agent 根据扫描结果分析漏洞、编写并验证 PoC。
接下来,就是 AWD-Red 发挥作用的时候。
PoC 只需要按照统一规范编写,放进指定目录,平台就会自动热注册。
不需要手动导入,也不需要再让 Agent 调用一堆工具来启动执行。
而且平台设计了双触发机制。
一是定时触发。
每 10 分钟自动执行一轮,对大量目标批量运行已有 PoC,获取 Flag 并提交。
二是事件触发。
只要有新的 PoC 注册成功,就立即触发一轮执行,无需等待下一个 10 分钟周期。
这样,新发现的漏洞可以尽快投入使用,已经发现的漏洞也能持续发挥价值。
Flag 提交同样做了自动化适配。
比赛开始前,根本不知道具体的 Flag 提交平台是什么样的。不同比赛的接口、参数和认证方式可能完全不同。
如果提前写死提交逻辑,到现场很可能需要临时修改代码。
所以 AWD-Red 采用了一个更直接的办法:
把实际的 Flag 提交 HTTP 请求复制到平台里,平台自动解析,并复用登录状态。
完成一次适配后,后续的 Flag 提交就可以自动进行。
整个过程不需要模型反复分析提交接口,也不需要为每场比赛重新开发一套提交程序。
第二阶段:Agent 深入挖掘隐蔽漏洞。
完成快速扫描和第一批 PoC 交付后,Agent 开始对源码进行更深入的审计。
这一阶段主要寻找常规工具不容易发现的隐蔽漏洞,例如复杂逻辑、特殊调用链和需要多步分析才能确认的问题。
发现新的有效漏洞后,继续编写 PoC,按照统一规范放进目录。
AWD-Red 自动热注册,立即执行一轮。
与此同时,平台仍然每 10 分钟持续运行已有 PoC。
于是形成了一条完整的流水线:
Agent 负责不断发现新的漏洞,AWD-Red 负责将这些漏洞持续转化为比赛成果。
研究和执行可以同时推进,彼此之间通过标准化 PoC 完成交付。
这就是整个工具设计中最关键的部分。
五、180+ Flag 之后,重新理解 Agent 和 Skills
正式比赛开始后,这套比赛前夜重构的系统接受了实战检验。Agent 持续开展代码审计、漏洞研究和 PoC 开发。
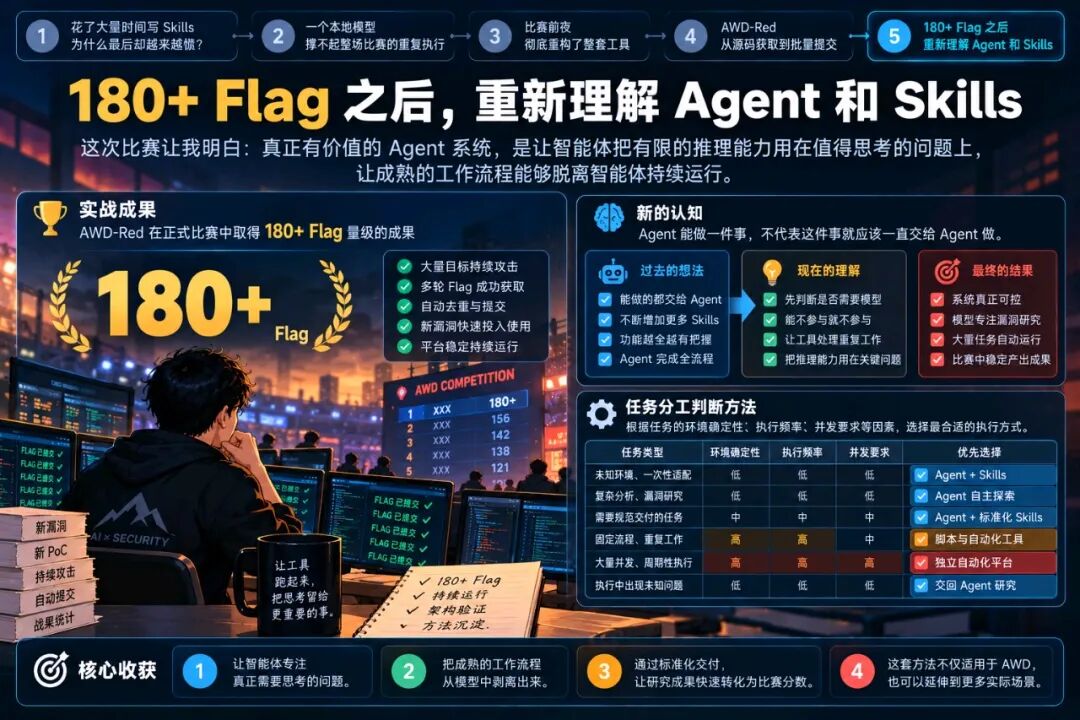
AWD-Red 则自动接收新的 PoC,负责大量目标的批量执行、Flag 获取、去重和提交。
比赛过程中,AI 深度审计还发现了一些较为隐蔽的漏洞,为后续攻击提供了新的机会。
最终,整套系统取得了 180+ Flag 量级的实战成果。
这次比赛没有对原来的全量 Skills 方案进行完整的同环境对照,因此无法准确计算架构重构带来了多少倍的性能提升。
但实战证明,这套分工架构能够在模型资源有限的情况下,完成大量目标上的持续自动化执行,同时保留 Agent 研究新漏洞的能力。
回过头看,这次经历让我对 Agent 和 Skills 有了新的认识。
过去设计 Agent 时,很容易考虑它还能做什么、还需要增加哪些 Skills。但现在,我会先考虑另一组问题:
这项任务真的需要模型吗?
需要模型参与几次?
有没有可能把成熟流程提炼成工具?
如果需要重复一千次,还应该让 Agent 参与一千次吗?
进一步看,Agent 的架构设计其实涉及几个不同维度。
首先是模型能力、指导粒度和任务灵活性。
能力不同的模型,需要的指导程度可能不同。
高度灵活的任务,需要模型理解、探索和自主决策。
相对固定的任务,可以通过更明确的 Skills 规范执行。
但如果流程已经成熟,而且需要高频重复或批量并发,就应该考虑将其固化成自动化工具。
这里还有一个重要区别:可重复性和并发性,需要分别评估。
一次性的未知任务,即使比较复杂,也适合交给 Agent。高频执行的固定任务,即使模型能够完成,也未必值得持续占用推理资源。
因此,这次实践最终沉淀出一套简单的判断方法:
这套方法可以用于 AWD,也可以延伸到 AI SOC、渗透测试、软件开发和其他 Agent 工作流。
从最初的全量 Skills,到比赛前夜重构 AWD-Red,再到正式比赛中的持续执行,这次经历最重要的收获,是重新理解了智能体与工具之间的关系。
真正有价值的 Agent 系统,需要让智能体把有限的推理能力用在值得思考的问题上,同时让成熟的工作流程能够脱离智能体持续运行。
AWD-Red 解决了这次比赛中重复执行和批量并发的问题,但也留下了另一个值得研究的方向。
同样一个任务,模型能力不同、Skills 指导粒度不同,最终的完成率、稳定性和执行效率究竟会相差多少?
接下来,准备围绕模型能力、指导粒度与任务灵活性继续开展实测。
或许,真正决定 Agent 系统效果的,除了模型有多聪明,还有我们究竟让它做了哪些事情。
如果对自己🈶用,点👍收藏吧,
如果对朋友🈶用,点❤️转发下!
感谢支持❤️!!!
如需 Skills 和 工具 可后台联系我!
前期高阅读文章