摘要:
这次选 Agent 的背景,是准备拿本地模型去打 AWD。AWD 里有些场景要求快速响应,有些长程任务更看重稳定推进。于是我把 Pi 和 Codex 都真正跑了一遍:一个轻、快、灵活,一个重、稳、长程更强。结果也让我开始重新理解,Agent 会直接影响同一个模型最后表现出来的“聪明程度”。
一、模型选完后,Agent 决定实际体验
上一篇主要折腾的是模型。
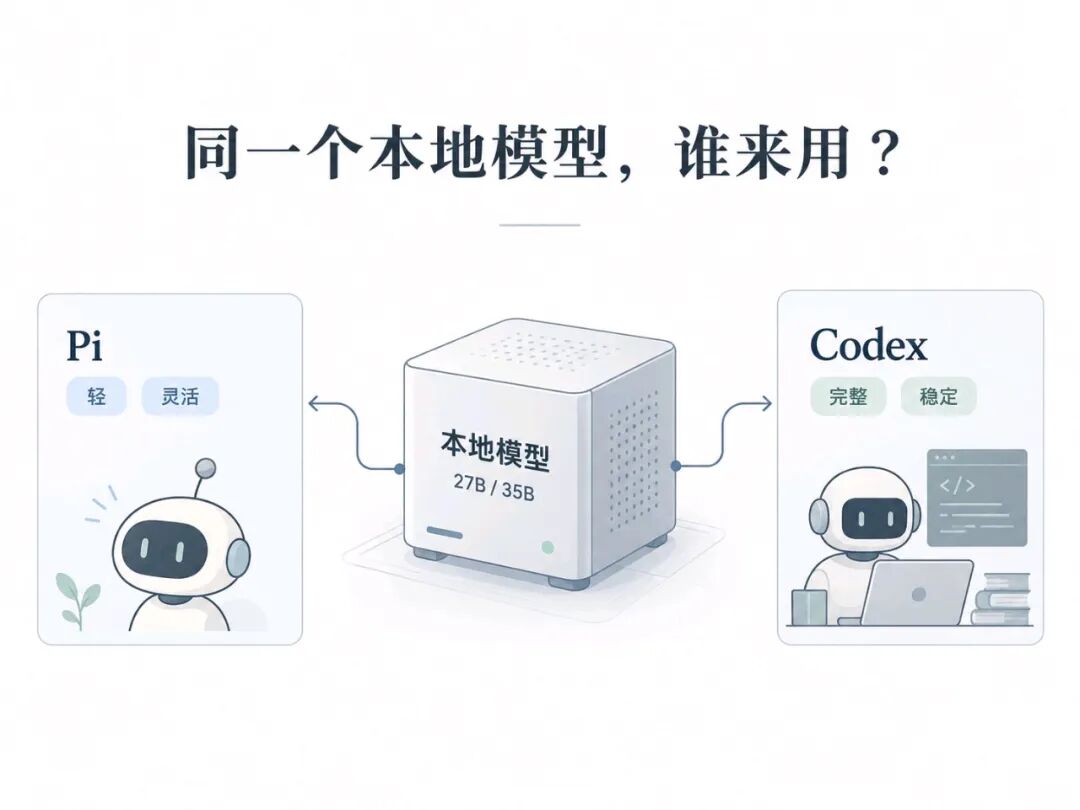
48GB 统一内存下,27B、35B 这一档已经能比较舒服地跑起来。前期实际使用里,27B 大约 20~25 token/s,35B-A3B 大约 40~50 token/s。
模型这件事,暂时没以前那么焦虑了。
新的问题很自然:
模型选好了,谁来把它用好?
本地模型资源终究有限。如果只有 32K 上下文,Agent 开工前塞进大量系统提示、Memory、Skills 和工具说明,真正留给任务的空间会迅速减少。
一开始其实想过自己写 Agent。
模型接口已经有了,再接 Bash、文件和编辑工具,看起来没那么复杂。真正往下拆,事情很快就多了。
上下文要裁,工具输出要管。状态要记,失败要恢复。命令还要处理超时、权限和不同模型的兼容。
继续做下去,已经是在重新实现一套 Agent 框架。
所以最后决定,不自己造,先选两个有代表性的成熟 Agent 来测。
最后选了 Pi 和 Codex。
Pi 比较轻,接本地模型方便。它代表的是轻量路线:框架少做一点,模型自己承担更多事情。
Codex 则更完整。Agent loop、工具体系和上下文管理都更成熟,代表的是另一种路线:框架替模型承担更多工作。
所以这两个放在一起,刚好可以回答一个问题:
轻量 Agent 和完整 Agent,哪一种更适合本地模型?
【图1:同一个本地模型,左侧 Pi,右侧 Codex;一个轻,一个完整】
二、Pi 更轻更灵活,长程任务容易跑偏
开始先跑 Pi。
没有专门挑漂亮 Demo,直接放进本地靶场和连续终端任务。简单任务能做,工具也会调,刚开始其实没觉得有多大问题。
但任务一长,感觉开始变了。
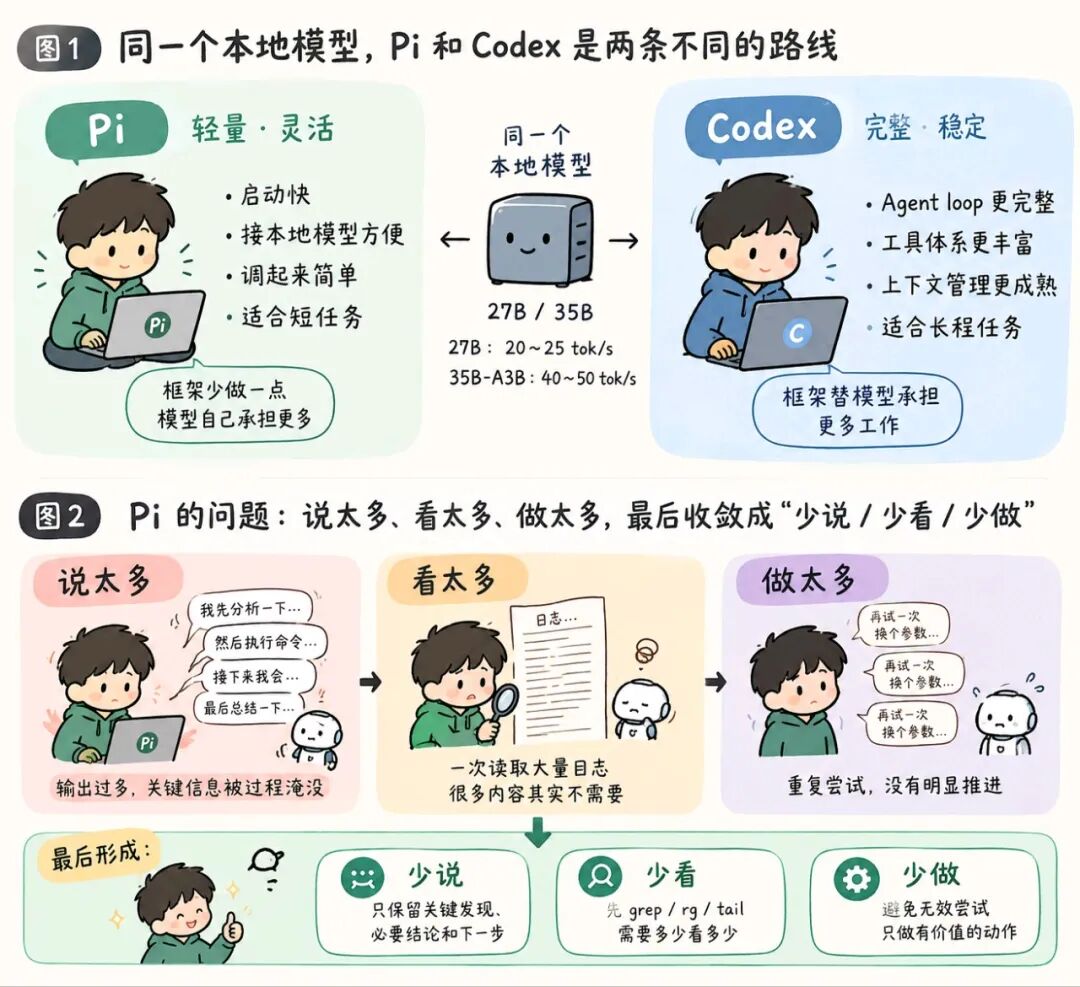
用 Pi 的时候,经常会觉得模型有点“笨”。它会重复已经做过的动作,也会卡在一个方向里反复尝试。
一开始怀疑是模型能力不够。
后来翻 session,才发现问题不只在模型。
有一次单个工具返回超过 1.6 万字符。这些日志、命令和中间结果,还会继续进入后面的上下文。
当时模型只有 32K。
跑几轮以后,大量过程信息不断堆积。真正有价值的事实开始和日志、中间判断、重复动作混在一起。
于是第一个问题出现了:
能不能先让它少说一点?
先把输出压短,只保留关键发现、必要结论和下一步。再跑一段时间,很快发现还不够。
模型自己少说了,工具照样可能一次吐几十行、上百行。
于是第二个问题来了:
为什么模型要把这些东西全部看一遍?
人排查日志也不会从第一行看到最后一行。通常先 grep、rg、tail,发现异常后再向前后扩。
所以又加了一条:
少看。
继续跑,又发现第三种浪费。
有些尝试已经没有提供新信息,模型还是会换个参数继续做。动作很多,但任务并没有明显往前走。
于是第三条也出来了:
少做。
到这里,“少说、少看、少做”才真正形成。
它们不是提前想出来的方法。是输出太多、读取太多、重复动作这三个问题,一个一个逼出来的。
Pi 的特点也开始清楚了。
它轻、灵活,简单任务启动快。但长程任务里,模型承担得更多,也更容易出现状态漂移、重复动作和在错误方向上卡住。
【图2:说太多 → 看太多 → 做太多,最后收敛成“少说 / 少看 / 少做”】
三、Codex 更重,长程任务跑得更稳
Pi 跑到这里以后,开始换 Codex。
原本只是想看看,更完整的 Agent 会不会让本地模型稳定一点。真正跑起来以后,第一感受非常明显:
同一个模型,好像突然聪明了。
Pi 里那些重复动作明显少了。
长任务里也更少出现卡在一个方向反复试的情况。任务状态更连续,整体推进感也更强。
但 Codex 很快暴露出另一个问题。
它太重了。
看本地推理日志时,抓到过一次:
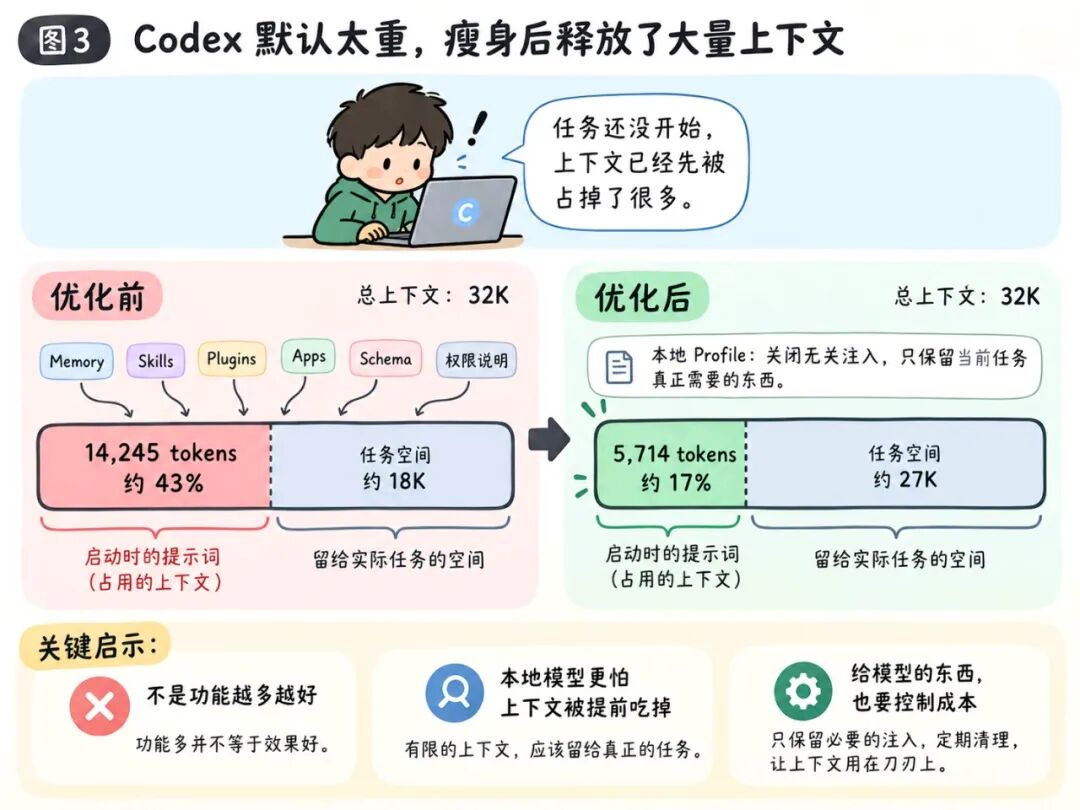
Prompt Eval:14,245 tokens。
当时模型开的上下文只有 32K。任务还没真正开始,已经消耗了大约 43%。
这个数字一出来,很多现象都解释通了。
首字为什么慢,长任务为什么很快觉得空间不够,本地模型为什么一上来就背着很大的上下文负担。
于是继续往里面拆。
Memory、Skills instructions、Plugins、Apps、工具 Schema,还有一部分权限说明,都已经在开工前进入上下文。
这些能力单独看都有价值。
真正的问题是:
当前任务真的需要全部带进去吗?
于是开始给 Codex 做本地 Profile。
暂时不用的插件关闭,Memory 不注入,Skills instructions 拿掉,无关 Schema 尽量减少。
重新测试后:
14,245 tokens → 5,714 tokens
还是同一个模型,同一台机器。
32K 上下文里,开工前占用从约 43% 降到了约 17%。真正留给任务的空间,一下多了八九千 token。
到这里,Codex 的特点也开始清楚了。
它重,但稳定。默认成本更高,可一旦把无关部分裁掉,长程任务的优势会明显出来。
【图3:32K 上下文前后对比,14.2K → 5.7K】
四、Pi 适合短任务,Codex 适合长任务
两个 Agent 都跑过以后,一个很有意思的差异开始稳定出现。
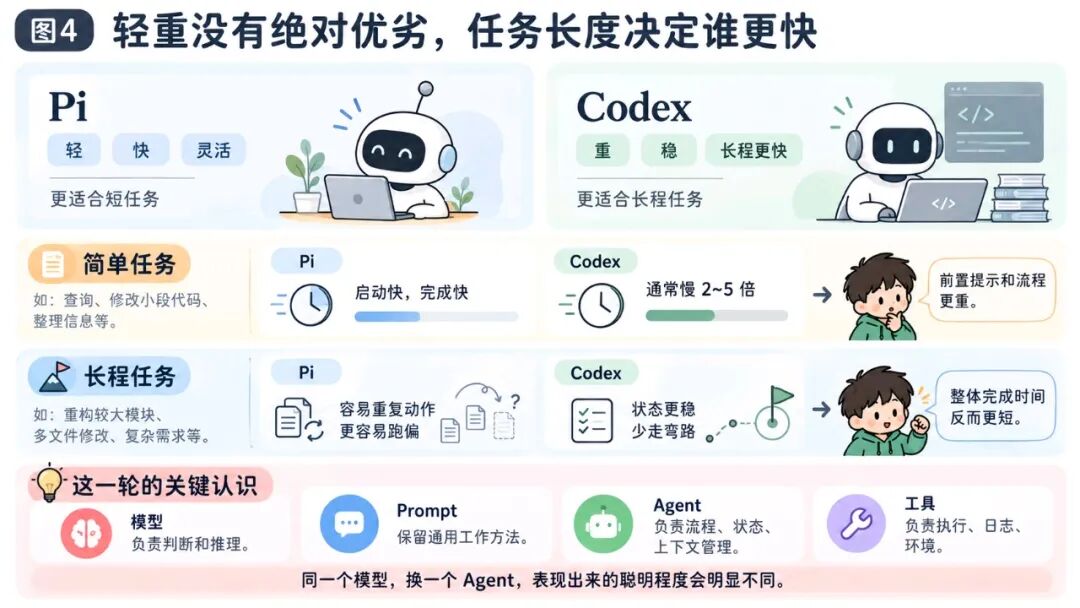
简单任务里,Pi 明显更快。
Codex 前置提示、工具管理和流程控制都更重。实际简单任务里,Codex 完成时间通常会是 Pi 的 2~5 倍。
但任务一长,情况开始反过来。
Pi 单步很轻,但更容易重复动作、状态漂移,或者在一个错误方向上持续消耗时间。
Codex 单步更重,但整体更稳定。
它少做无效重复,任务状态也保持得更好。所以长程任务的总完成时间,反而明显比 Pi 更短。
这时候才真正能回答前面那个问题:
为什么同一个模型,换到 Codex 后感觉更聪明?
模型本身没有变。
变的是 Agent 帮它管理了多少状态、工具和执行过程。很多看起来像“模型笨”的问题,其实有一部分来自 Harness。
这轮测试里,还暴露出另一个问题。
为了让 Pi 表现更稳定,AGENTS.md 里的规则开始越来越多:少说、少看、少做、先找工具、维护状态、失败回溯……
每一条都合理。
但如果每犯一次错就补一条 Prompt,最后很容易变成一本“错误百科”。
于是分工开始清楚了。
模型负责判断和推理。Prompt 保留通用工作方法。输出截断、日志落盘、上下文压缩、状态维护这些,更适合交给 Agent 和工具层。
到这里,Pi 和 Codex 都已经进入了基本可用的状态。
后面要做的,已经不是证明它们能不能跑,而是继续优化:怎么跑得更稳、更省、更有效。
【图4:Pi=轻、快、灵活;Codex=重、稳、长程更快。下方标出模型 / Prompt / Agent / 工具分工】
五、下一步要测每一层能力值多少
走到这里,新的问题已经不是继续换 Agent。
真正值得测的是:
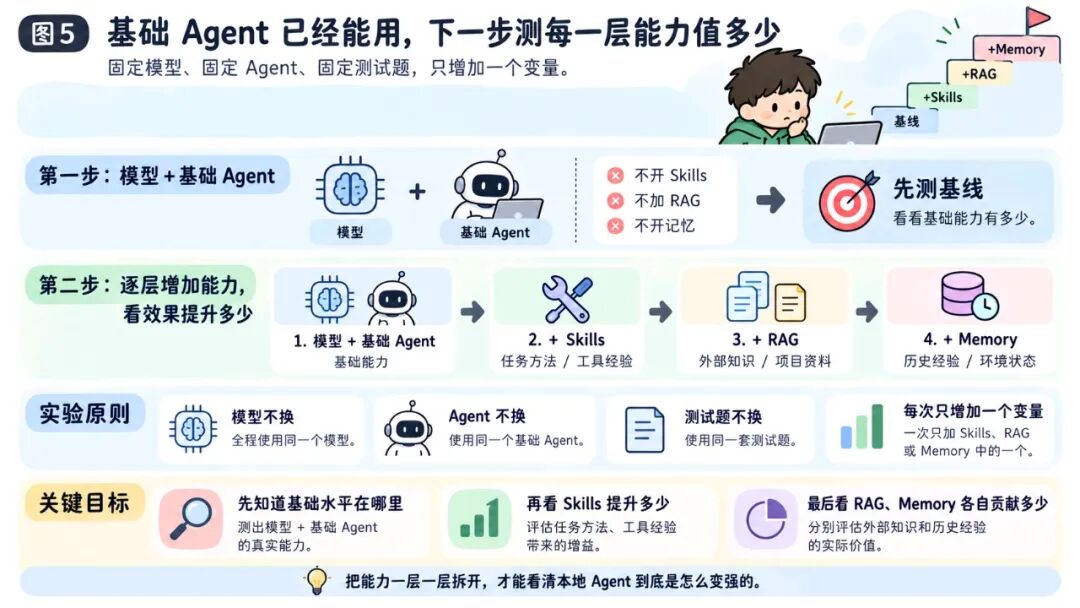
一个 Agent 最后表现出来的能力,到底是怎么一层一层加上去的?
如果模型、Agent、Skills、RAG、记忆全部一起打开,最后任务做成了,其实很难知道提升到底来自哪里。
所以接下来先建立基线。
第一步只测:
模型 + 基础 Agent
不开 Skills,也不加额外 RAG 和记忆。固定模型、固定 Agent、固定测试题,先看看最基础的组合到底是什么水平。
这组结果会成为后面所有实验的参照。
下一步再加 Skills。
模型不换,Agent 不换,测试题也不换。只增加 Skills,看成功率、时间和执行过程到底改善多少。
再往后加 RAG。
看看补充工具知识、项目资料和外部信息以后,哪些原本做不出来的任务开始发生变化。
最后再加 Memory。
看已经验证过的工具、环境、错误路径和经验,能不能在后续任务里真正积累下来。
这样整条路线会很清楚:
模型 + 基础 Agent
→ + Skills
→ + RAG
→ + Memory
每次只增加一个变量。
这样最后才能真正回答:
一个本地 Agent 变强,到底是哪一层起了作用,又分别提升了多少?
【图5:能力阶梯——基础 Agent → Skills → RAG → Memory,每层只增加一个变量】
上一篇,我们先把模型选到了能用。
这一篇,把 Pi 和 Codex 调到了基本能用。
下一步,就开始测每增加一层能力,到底能带来多少提升。
如果对自己🈶用,点👍收藏吧,
如果对朋友🈶用,点❤️转发下!
感谢支持❤️!!!