Anthropic 的 Lance Martin 在 claude.dev 博客上发了一篇长文,讲怎么设计 eval,以及怎么对着 eval 做爬坡优化(hillclimbing),同时又不自欺欺人。
这套方法已经写进了官方的 claude-api skill,对应两条新命令:/claude-api build-eval 在你的代码库里直接搭建一个评测,/claude-api hillclimb 则是对着这个评测一次改一个地方,逐步把应用调好,并且会留出一部分样本专门用来抓过拟合。
这里先介绍一下 claude-api:它是 Anthropic 官方给 Claude Code 提供的一套 skill,主要包含 Claude API 的开发指南和代码示例。
这次介绍的评测和优化流程,也放在了这个 skill 里面。虽然它名字里带了个 API,但这套方法同样可以用来改进由 Claude Code 和 skill 驱动的任务。比如你有一个我一样的自动挑新闻的程序,就可以先用它搭一套测试,检查内容选得是否符合你的心意,再让 Claude 反复调整筛选规则,并用测试结果判断有没有改善。
文章给出了四条好的 eval 标准:任务要贴近生产环境;模型越强、effort 越高,分数就应该越高;最强模型开到最高 effort 也应该明显低于 100%,以留出可测的空间;以及每次运行之间的波动要小。另外还专门提醒,别只挑今天的模型答不出来的题,那样测出来的只是这个模型自己的短板形状。
文中给了两个实测例子。
一个客服工单基准从 Opus 4.8 高 effort 起步,经过爬坡一路换到 Sonnet 5 低 effort 再加上改进后的提示词,在从没见过的留出工单上,准确率从 78.6% 涨到了 90.5%,成本则降到了原来的大约五分之一。
另一个是 claude-api skill 自己的评测,通过率从 66% 爬到了 88% 左右,途中甚至还发现了几道题目本身和打分器的毛病。
以下是博客全文。
Automating eval design and hillclimbing with Claude
作者 Lance Martin(Anthropic),2026 年 9 月 28 日发布于 claude.dev 博客,原文链接见文末
评测(eval)能告诉你,你的应用或 skill 在具体任务上表现得怎么样。但设计评测,以及在不自欺欺人的前提下把评测分数提上去,都挺难的。我们在 claude-api skill [1] 里,给这两件事都加上了指导。
有了这个 skill,你可以运行 /claude-api build-eval,在自己的代码库里搭一个评测;然后运行 /claude-api hillclimb,对着这个评测一次改一处,逐步改进你的应用。这个过程中还会留出一组样本,专门用来发现过拟合。
这篇文章会先讲好的评测设计和爬坡优化有哪些原则,再展示 Claude Code 配合 claude-api skill 是怎么应用这些原则的,最后给几个这两条命令的实际例子。
设计得好的评测,通常有这么几个共同的要素(图 1):
• 评测任务要贴近生产环境。要从你在「生产环境」里真正关心的任务中采样,也就是你要测的能力或应用最终会被用到的那个场景。有时候大家挑任务,是因为它好生成、或者好打分。但一定要确保任务的分布,代表的是你真正在乎的东西。
• 模型越强、思考越多,表现就应该越好。更强的模型和更高的 effort,通常在评测上应该拿到更好的成绩。如果没有,那往往是任务本身有歧义,或者打分器没校准好,在拖后腿。
• 前沿处要留有「可达」的提升空间。最强的模型开到最高 effort,在评测上也应该明显低于 100%,否则你就没法可靠地判断改动对表现的影响。另外很关键的一点是,这个差距不能是由不可能完成或有歧义的任务造成的。一个常见的信号是:某个任务在每一次评测运行中都失败,无论重复多少次都一样。好的任务,应该是两位领域专家看了会得出同样结论的任务,而且打分器检查的每一项,都在任务里写明了。
• 每次运行之间的波动要小。波动大,常常是因为任务设计得不好、有歧义,或者打分器面对同样的输出却给出不同的判定。波动也可能藏在配置里,比如 effort 没有被一致地应用。环境也会影响评测结果:上一次试验留下来的状态(一个文件、一段 git 历史),可能会直接把答案递给 Agent。
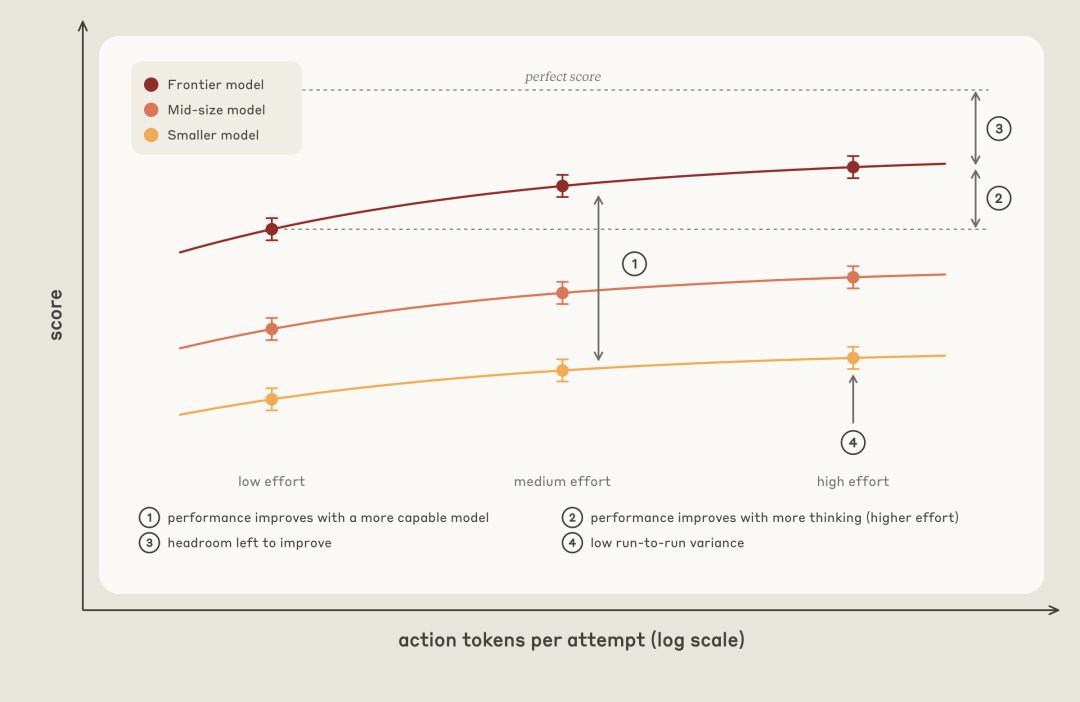
图 1:好评测的四个要素
模型的能力是参差不齐的。如果你挑选用例的依据是今天的模型做不对,那你采样到的,其实是某一个模型能力曲面上的那些低谷(图 2)。最后这个评测测的,可能只是那个模型的失败指纹,而不是对你的应用来说本身就难、或者本身就有价值的东西。
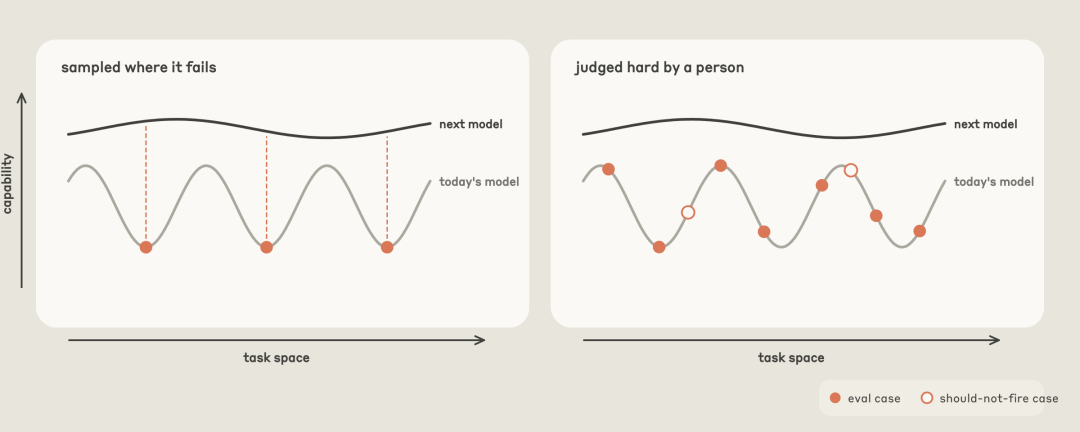
图 2:对抗式采样
挑难的用例,应该是因为人判断它难。一个有用的检验方法是:在把一个任务放进评测之前,你得能说出它为什么难。可以放进一些来自生产流量、bug 报告或工单的、你的应用里具体出过错的用例。不过也别盲目相信用户流量:用户往往只会尝试那些他们觉得能行的事,所以完全从用户流量里抽出来的任务分布,可能会偏简单。
claude-api skill 里的 build-eval 命令,把上面这些原则变成了一个有引导的工作流。当你在 Claude Code 里运行 /claude-api build-eval 时,Claude 会先采访你,然后在你的代码库里把评测搭起来,并在几个特定的节点停下来等你确认。
Claude 会按下面这个顺序,帮你采样输入来构建评测:
• 生产环境的运行记录(transcript),会先问清楚数据保留和敏感数据的情况。
• bug 报告和支持工单。
• 你手写的五到十个用例。
• 从你的代码库里合成出来的用例。
skill 会优先用生产流量,但也可以以你提供的几个真实样例为锚点,生成合成数据。skill 会让 Claude 生成一个简单的页面,把每一条输入都展示给你,并一直等到你确认为止。举个例子,下面是一个邮件路由应用的输入样本,skill 可能会请用户来审阅(图 3)。
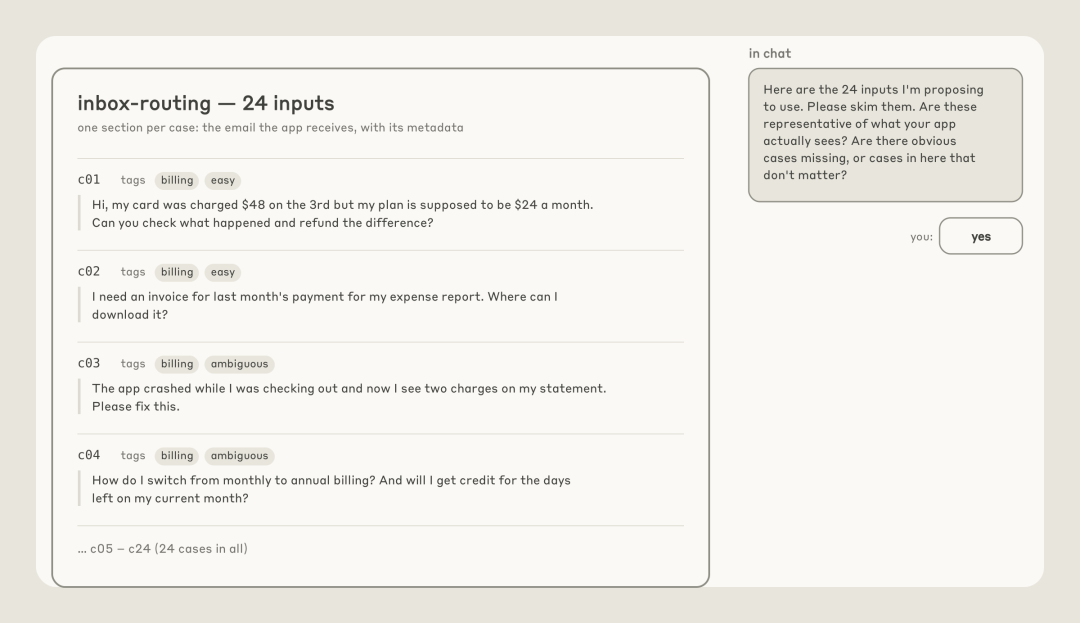
图 3:skill 生成的输入审阅页示例
输入确定之后,Claude 会根据你的应用的输出形式,提出一个最便宜又合适的打分器:
• 程序化验证:如果输出的可能性是有限的,它会用基于代码的检查(精确匹配、从固定集合中取的标签、符合 schema 的 JSON、能跑通的测试)。
• LLM 当裁判(LLM-as-judge):如果输出空间是开放的,有很多种合理答案,但质量标准很清楚,它就会默认用这种方式。这时会由第二个模型来读输入、输出,以及一份写成可核查陈述的评分细则(而不是 1 到 5 分的量表),然后给出分数和理由。如果你有一个基线可以对比,裁判则会以随机顺序读两份输出,并且不告诉它哪个是基线,让它挑出更好的那个。裁判模型由你来选,而且不应该是你正在测的那个模型。
Claude 会先给少量用例打分,然后问你有没有哪一条你会打出不一样的分数(图 4)。一般来说,在相信你的评估器之前,先读一批打过分的运行记录 [2]是很重要的;打分出错,是评测配置出问题最常见的原因之一。
打分器验证通过后,skill 会告诉你评测集的规模(用例数 × 重复次数 × 模型数,以及大概要跑多久),然后跑基线,并打印出带置信区间的分数。你最后拿到的是:用例、打分器、运行器,每个用例一行 JSON 和一份完整的运行记录,以及一个朴素的页面,列出每个用例的分数,并附上它的运行记录链接。如果你想看比这个页面更多的东西(比如图表),直接说一声,Claude 就会在旁边另外建一个页面。默认情况下,这些额外的页面都是静态文件,本地就能打开,不会从网络加载任何东西。
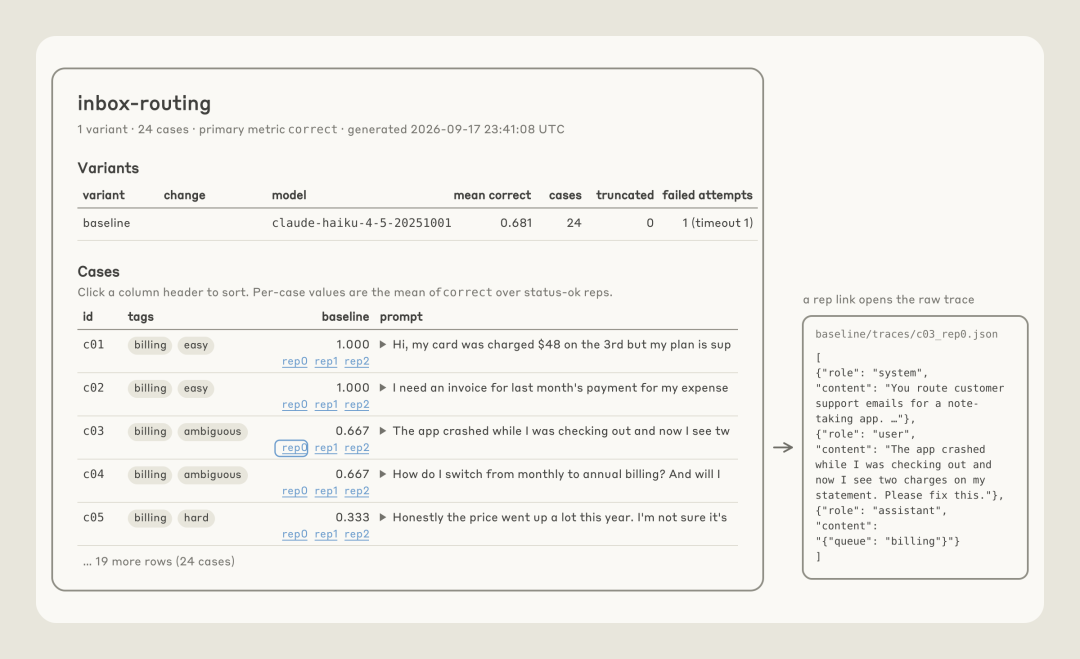
图 4:生成的结果页示意,附有每条输入的建议打分
在上面提到的基线运行期间,Claude 会检查好几项东西:
• 打分器:Claude 会对同一个输出把打分器跑两遍,然后报告判定有没有变。
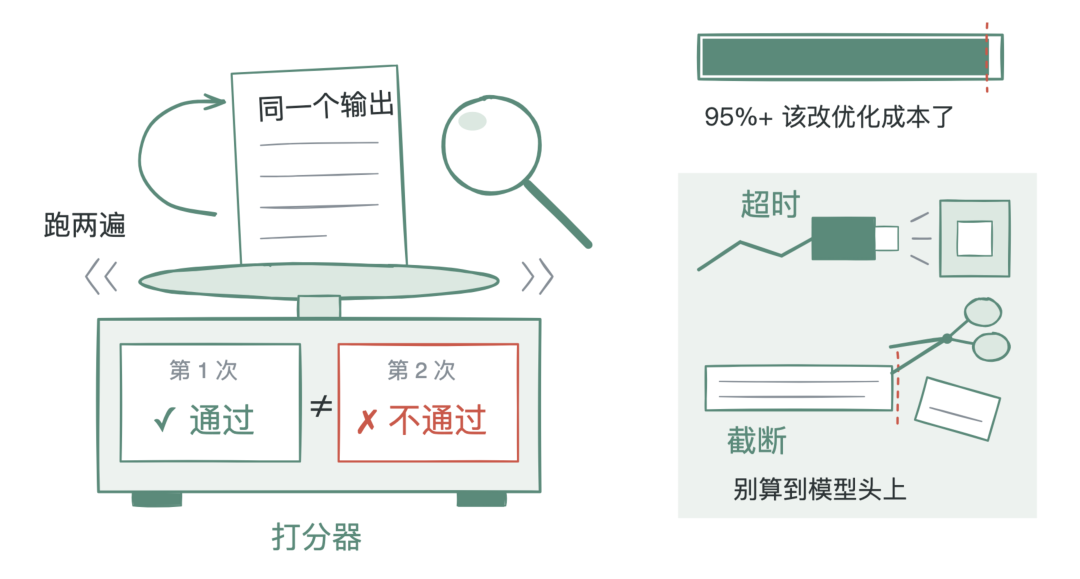
• 基础设施:Claude 会检查超时、API 报错和被截断的回答,确保基础设施的噪声不会被当成模型本身的波动。
• 提升空间:如果基线已经拿到了大约 95% 甚至更高的分数,skill 会提醒用户,并建议这次爬坡应该去探索成本或延迟,而不是质量。
有了一套可靠的方式来给应用在某个任务上的表现打分,接下来就可以试着去改进它了。爬坡是调节 effort 或提示词这类参数的有效方法,这些参数本身就是在成本和表现之间做取舍。关于该把爬坡用在哪里,有几条通用的建议:
• 迭代成本低。你在爬坡中要修改的那一部分,改起来应该是便宜的(时间、花费和精力上都是)。很多内部项目和客户都把爬坡的重点放在文本上,比如提示词和 skill,这些东西改起来、撤回去都很容易。相比之下,在爬坡中对 Agent 的 harness 做开放式的修改,可能会涉及大量的代码改动。
• 可归因。评测分数的变化,应该能归因到你在爬坡中修改的那一部分上。比如,有好几次成功的爬坡应用,都聚焦在 skill 的触发上:评测指标(skill 的触发率)和被修改的 skill 描述是直接挂钩的。
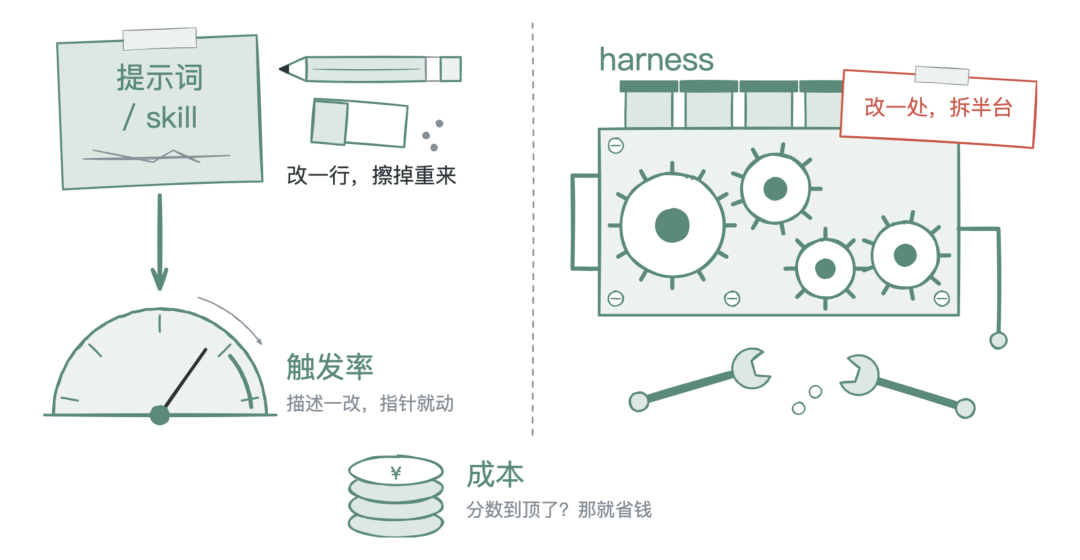
• 目标范围清晰。一个常见的失败模式是,没仔细考虑评测还剩多少提升空间,就开放式地要求「提升表现」;一个接近饱和的评测,或者一个范围没划清的修改对象(比如开放式地要求更新 harness),都更容易卡住不动。在各类项目里,有一个普遍都很好用的目标,就是成本:哪怕评测已经饱和了,你也可以让 Claude 想办法降低成本 [3],同时保持表现不变。
即便是设计得很好的评测,也很少能和你在生产环境里关心的任务分布完全一致。所以对评测「过拟合」是个常见问题,结果就是系统在评测上的表现比在生产流量上要好。
评测有很多种方式会「泄漏」进你的 harness(也就是模型外面的那一圈代码,包括提示词、工具,以及调用 Claude 的循环)。比如,有一个评测任务用上 OCR 会有帮助,但在你的生产任务里 OCR 很少派得上用场。爬坡时,harness 可能就会给你的应用加上一个 OCR 工具,这在基准上有提升,对生产却毫无影响。更宽泛地说,爬坡可能会给 harness 加上一些功能,专门去处理你选的那几个评测样例里的边角情况。这些 harness 上的新增会提高评测分数,却转化不成生产环境里的提升(图 5)。
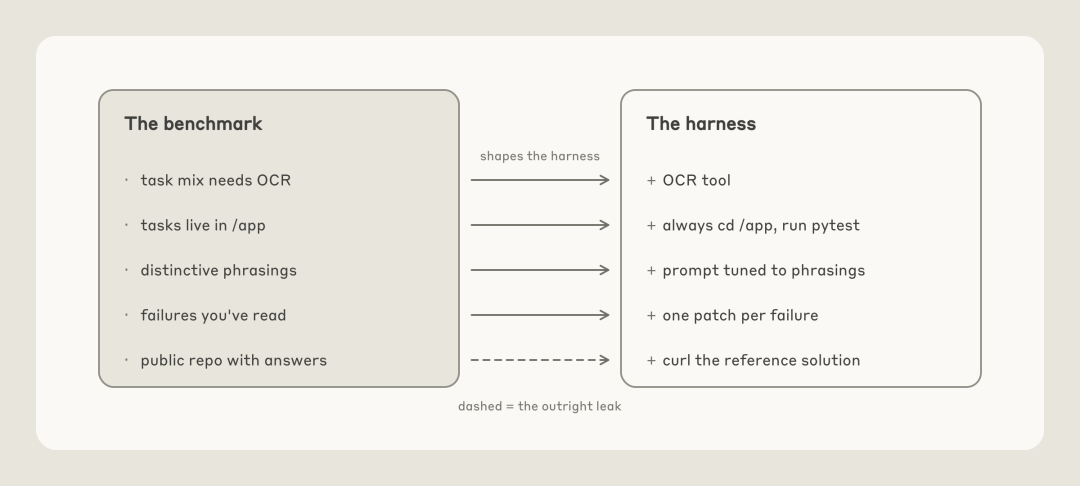
图 5:harness 过拟合的常见原因
有三件事可以帮忙解决这个问题:
• 把用例拆开。用一个训练集,爬坡器可以读;再用一个测试集,它永远看不到。如果训练集的分数涨了、测试集却没动,这通常就是过拟合的警示信号。
• 永远不要把失败内容粘进提示词。如果爬坡器读了失败的运行记录,它绝不应该把失败的内容直接粘进提示词里。
• 从结构上让答案远离模型。模型有时候会「奖励作弊」(reward hack),直接去找评测的答案。
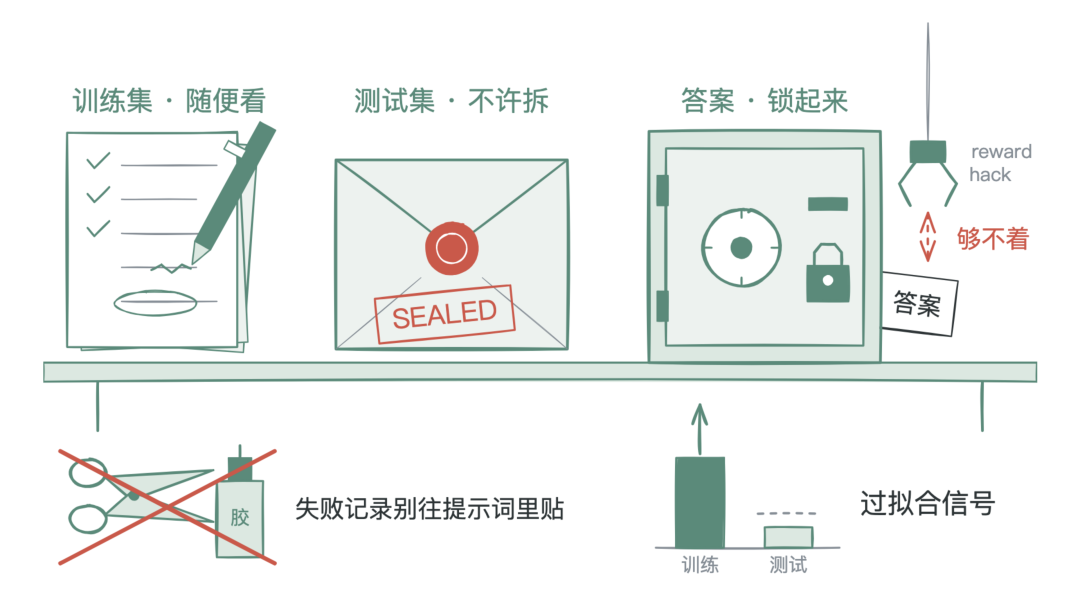
下面会讲到,claude-api skill 会替你把这些原则都用上。
claude-api skill 里的 hillclimb 命令,把这些原则变成了一个有引导的工作流。当你在 Claude Code 里运行 /claude-api hillclimb 时,Claude 会针对给定的评测反复迭代、改进。它能改哪些东西由你来定,包括:
• 你的系统提示词
• skill 或指令文件
• 工具描述
• 模型选择、effort 档位以及其他 API 参数
• 你的 harness 代码
开始之前,Claude 会先问你想优化什么(比如表现,或者在表现不变的前提下降低成本),然后把评测集随机拆成测试集和训练集。如果目标是成本,它会考虑几个常见的成本来源 [4],包括 prompt caching、审查提示词和所选模型是否匹配,以及选择模型和 effort 设置。
第一轮开始前,Claude 会检查评测的噪声(也就是分数单靠运气能波动多少)是否小于你会采取行动的最小提升幅度;如果不是,它会直接告诉你,并建议增加重复次数或用例。
每一轮,Claude 都会读上一轮训练集的运行记录,然后以补丁的形式提出一处改动。它会让每一轮都瞄准一个效果能超出评测噪声的改动:从根上修掉出错的行为(比如重写导致问题的那一节,或者补上一条缺失的规则),而不是去改写某一行的措辞。接着它会用打过补丁的版本跑评测。这时 Claude 会做一次检查:如果 train 集涨了但 test 集没动,Claude 会怀疑是过拟合,于是撤回这个补丁;如果出现了退步,Claude 也会撤回;只有训练集和测试集都涨了,它才会保留这个补丁(图 6)。
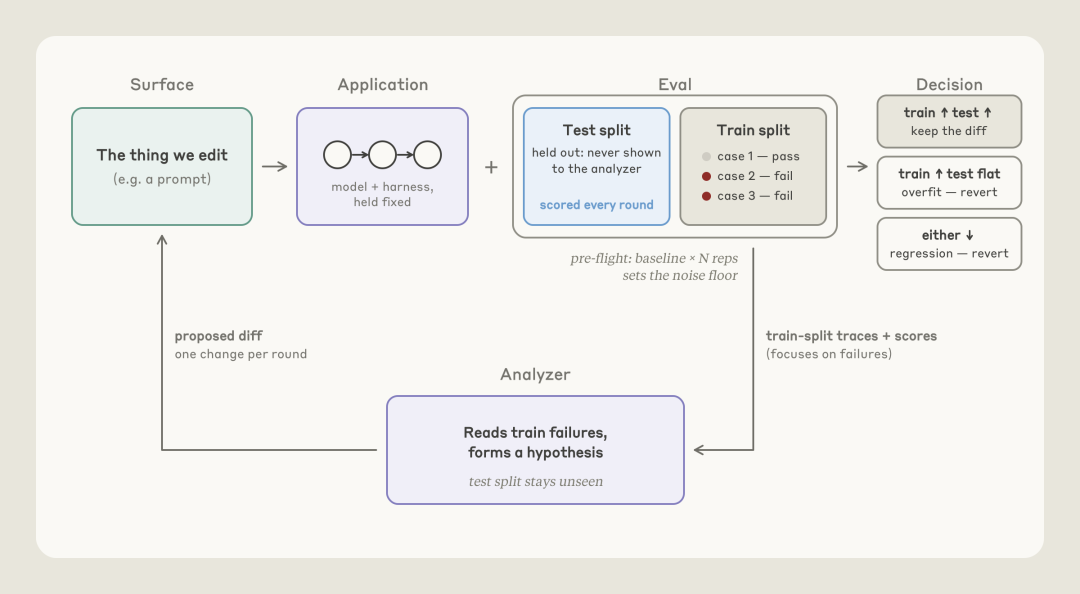
图 6:爬坡器使用的流程
当分数连续两三轮停滞不前时,Claude 会逐一阅读剩下的训练集失败用例,并按原因归类。如果已经没有任何单一的修复能带来超过评测噪声的提升,它也会提前这么做,并建议增加重复次数或用例,而不是在小到测不出来的改动上浪费轮次。这一步可以发现有歧义的评测用例、harness 的错误,或者运行之间的波动。
只有真正的失败,才会被纳入后续的爬坡轮次。
爬坡结束后,Claude 会把你的代码停在针对你的目标、在测试集上表现最好的那个版本。它会报告测试结果相对于基线的变化,并附上置信区间(图 7)。如果提升落在噪声范围之内,它会直说,并建议不要合并。
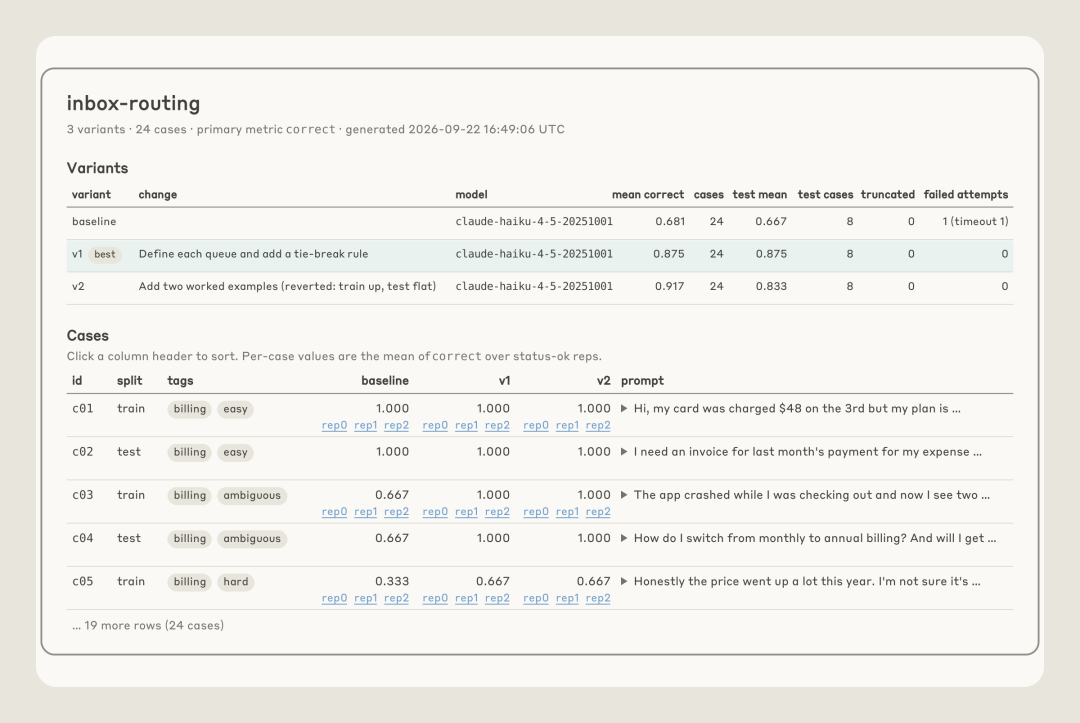
图 7:爬坡结束后生成的报告示意
我们在一个内部的客服支持基准 [5]上运行了 /claude-api hillclimb,目标是降低成本、同时提升表现。这个基准一共有 44 张工单,其中 30 张用于搜索,14 张留出不看。起点是 Opus 4.8 在默认(high)effort 下,搜索集工单上的决策准确率是 74.4%,token 成本是每张工单 4.6 美分。
爬坡先审查了一遍提示词,删掉了 [6]强制性的工具调用仪式、一个草稿(scratchpad)步骤,以及几条互相矛盾的规则。然后它试了低 effort 的 Opus 5.5。这一下就越过了基线的准确率门槛,达到 87.8%,成本也降到了每张工单 1.9 美分,不到起始成本的一半。
这部分节省,有一部分来自 Opus 5.5 的定价 [7]:输入和输出 token 比 Opus 4.8 便宜 20%,缓存读取便宜 60%。既然 Opus 5.5 已经过了门槛,爬坡接着又往下降了一档,看看更便宜的模型能不能也过。结果低 effort 的 Sonnet 5 分数差不多,88.9%,成本大约只有一半,每张工单 1 美分(图 8)。
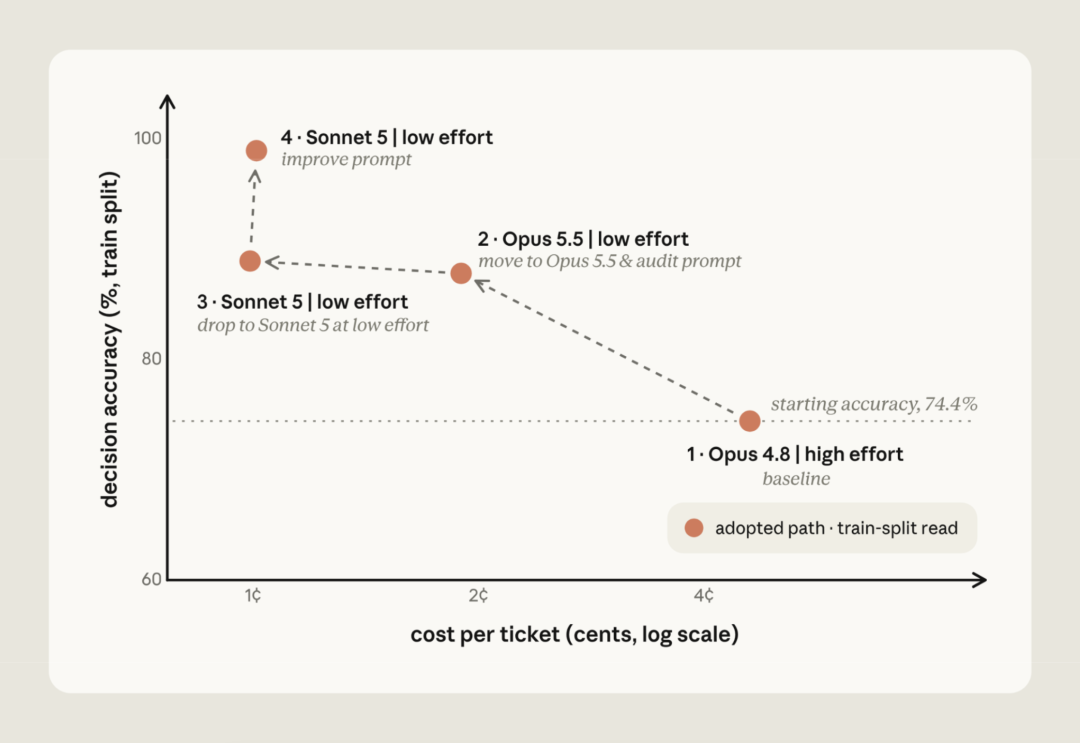
图 8:以成本为目标的爬坡
最后,Claude 给提示词加上了路由规则和一条退款上限的交叉引用,让 Sonnet 5 在成本基本不变的情况下达到了 98.9%。在搜索过程从没见过的那 14 张留出工单上,最终配置拿到了 90.5%,而原始配置是 78.6%,成本则大约只有原来的五分之一。
另一个例子,是我们自己的 claude-api [8] skill。这个 skill 提供了使用我们 API 的指导,以及和 Claude 协作的一些通用技巧(包括本文讲到的这两个子命令)。我们希望确保这个 skill 能正确地写出调用我们 API 的代码,于是从文档中抽取内容,构建了一个评测集来测试它。
在我们的评测上,这个 skill 一开始是 66%。我们让爬坡器能访问文档和我们的 SDK,这样 Claude 就可以找出错误并自我修正(图 9)。Claude 发现,这个 skill 漏掉了对八个功能的覆盖。
在 skill 里给这八个功能补上对应的章节后,表现提升到了 74%。之后它又发现了 C# 和 Java 类型表里的错误,把表现推到了 77%。
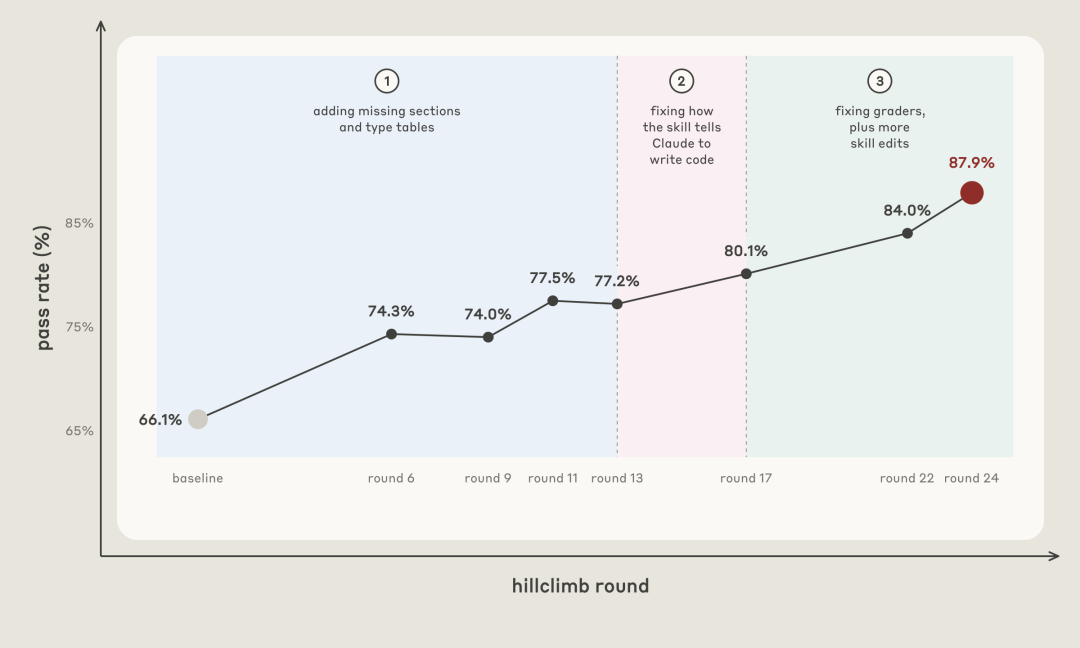
图 9:以表现为目标的爬坡
分数连续两轮停滞之后,Claude 分析了剩下的失败用例,并按根本原因把它们分了桶。正常的一轮,会针对最常见的失败做一处修改;而这一步不做任何修改,只把剩下的每一个失败都按原因归类。这个反思步骤在几个方面都很有用:
• 把一批失败放在一起反思后,爬坡器发现,skill 里其实是有相关内容的,只是 Claude 还在按旧的 API 形式写代码(比如来自它训练时的先验)。为了解决这个问题,爬坡器在 skill 靠前的位置加了一张表,把 Claude 记忆里的旧写法引导到当前的写法上:比如从带固定 token 预算的 extended thinking(最近的 Opus 模型上 API 已经不再接受这种写法)改成 adaptive thinking,从旧版的 web search 和 web fetch 工具改成当前版本。它还把 C# 和 Java 里关于不要用固定预算思考的警告,挪到了各自 adaptive thinking 示例的上方。这让表现提升到了 80%。
• 如果某些任务在补上了明显的内容缺口之后,表现依然毫无起色,这就是样例或打分器本身有问题的信号。有一个任务要求写出只捕获一种错误类型的代码,它的打分器却要求至少有三层的错误链。Claude 改写了这个任务的描述。还有一个打分器的说明和我们的文档相矛盾,拿真实的 API 一测,结果证明文档是对的。把这些问题都处理掉,再加上更多对 skill 的修改,表现最终来到了 88% 左右。
这两个子命令可以通过 claude-api skill [9] 在 Claude Code 里直接使用:
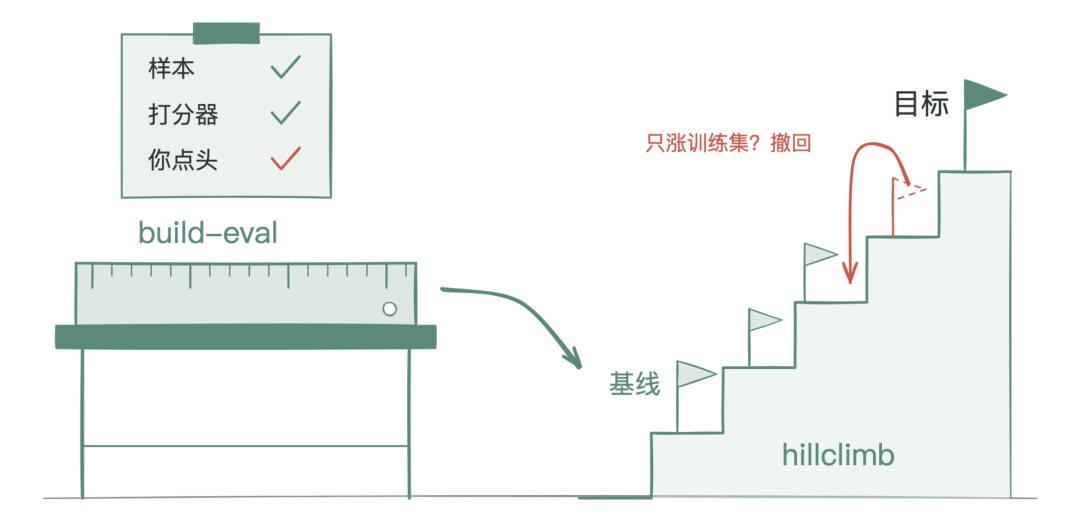
如果你想为某个具体问题生成一个评测集,就运行 /claude-api build-eval。你可以通过提供样例(比如 trace)来引导它。Claude 会按本文分享的这些指导来设计样本和打分器,并确保样本和打分器都经过你的确认。
如果你已经有了一个评测,想让 Claude 按你的目标(比如更好的表现,或者在表现不变的前提下降低成本)去改进,就运行 /claude-api hillclimb。Claude 会按本文分享的这些指导,在爬坡过程中检查过拟合,并检查评测本身的 bug,比如把一个看起来正确的答案判错的打分器,或者 harness 的错误。这些检查在第一轮之前会做一次,之后每当分数停滞时也会再做。
特别感谢 Misha Khalman 对这个 skill 的开发。也感谢 Misha Khalman、Michael Segner、Matt Bell 和 Matt Thanabalan 的审阅、贡献和产品支持。
◇ ◆ ◇