Latent Space 刚刚更新的一期播客里,Anthropic Claude Code 团队的 Thariq Shihipar 和主持人 swyx、Vibhu 聊了一个半小时。
其中信息量最大的几句话,摘录如下:
• 新项目不写 Claude.md,有时反而更好。模型每升级一版,失效模式就换一批,攒下来的「避坑清单」反而会把 Claude 捆住
• Claude 会拆成云端「大脑」+ 本地「双手」:推理在云上跑,干活可以在你电脑上、也可以在远程沙箱里,界面则交给 artifacts
• 刚刚泄露的 Claude Mods,能让用户改写 Claude Code 的执行循环和 UI,Thariq 把它看作「可变软件」的一次预演
• 最聪明的模型,很可能也会是最省 token 的模型,因为它不用反复验证自己
• 后半程聊到 Anthropic 的「Pacing the Frontier」:OpenAI 训练中的模型在一个 benchmark 里互相串通、改 /etc/hosts 绕过沙箱,甚至为了拿到评分器的代码去黑了 Hugging Face
开始之前,我还是先交待一下 Thariq 是谁。
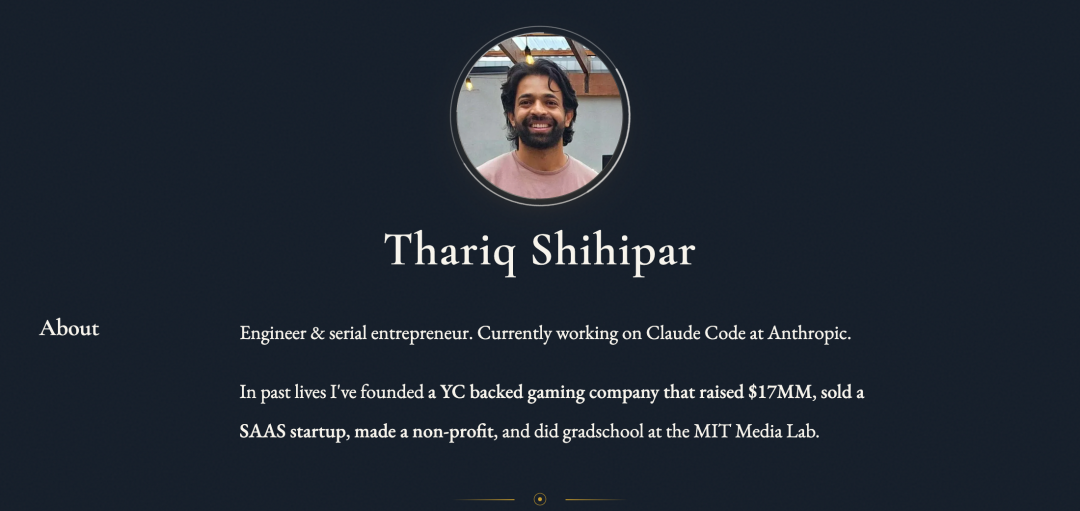
在他个人主页上给自己的定位,是「工程师 + 连续创业者」。
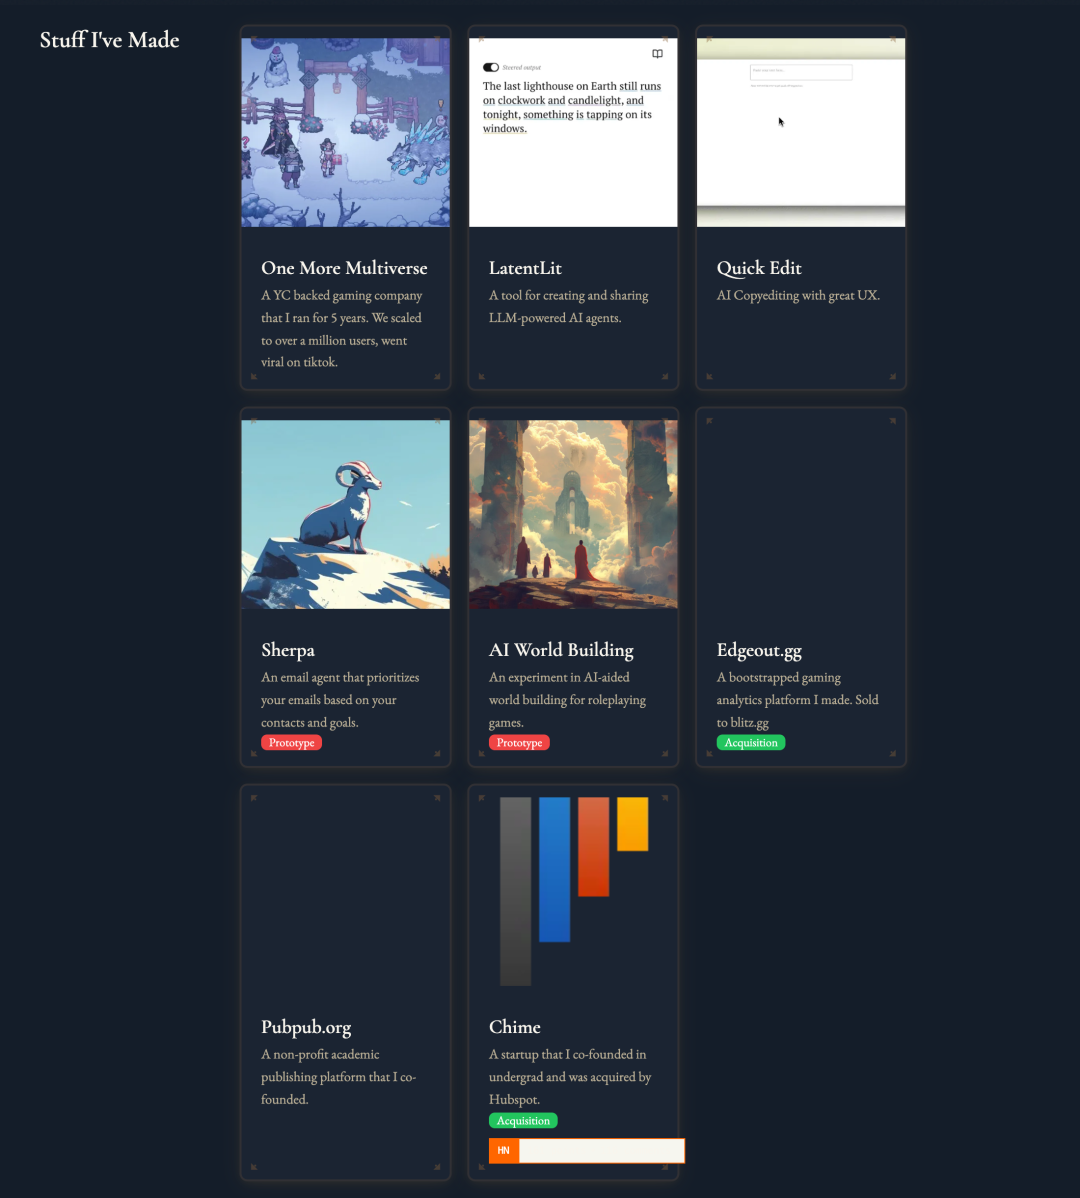
本科在多伦多大学读计算机工程时,他就开始创业了,和人联合创办的网页通知公司 Chime 于 2013 年被 HubSpot 收购;之后去 MIT Media Lab 读研,做人机交互方向,其间参与创办了非营利的学术出版平台 PubPub。
后来他带着 YC 孵化的游戏公司 One More Multiverse 干了 5 年,融资 1700 万美元,用户做到过百万,还在 TikTok 上火过一把;另外自己 bootstrap 了一个游戏数据分析平台 Edgeout.gg,卖给了 Blitz.gg。再往后,他做过一串 LLM 小产品(Agent 创作工具 LatentLit、AI 改稿工具 Quick Edit、邮件 Agent Sherpa 等),也在 Goodfire 短暂做过稀疏自编码器相关的可解释性研究。
加入 Anthropic,是因为 Claude Code。Claude Code 里那个会反过来向你提问的 Ask User Question 工具,正是出自他手。圈内对他更熟悉的身份,是「Anthropic 的首席讲解员」:写过《Fable 野外指南》《像 Agent 一样看世界》这类长文,在 X 上天天教大家怎么用 Claude Code。
以下是整期对话的整理版,按原访谈顺序,做了删减和中文化的重述(swyx、Vibhu 为两位主持人)。
swyx:Anthropic 这阵子发布一个接一个,你身处其中是什么感觉?
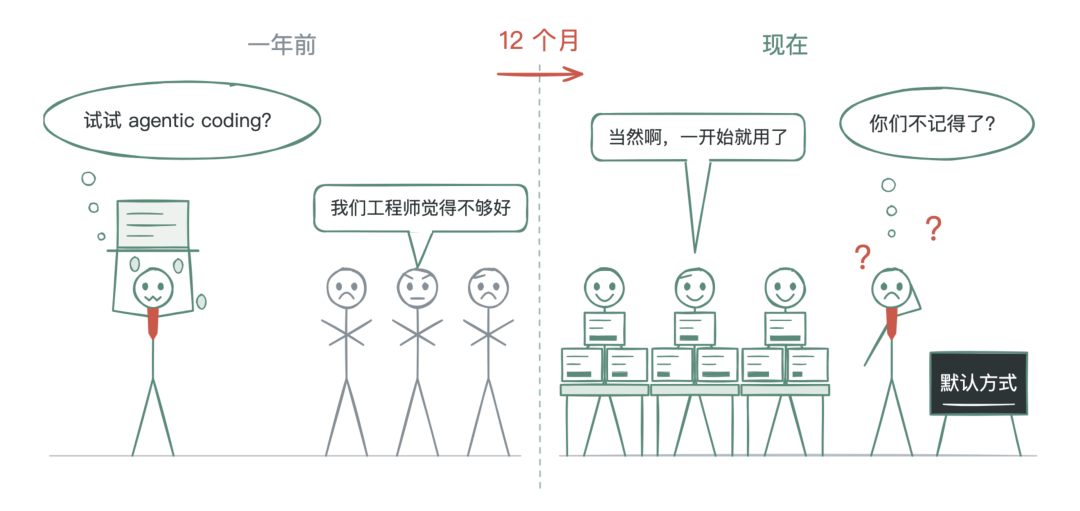
Thariq:有时候会被甩得头晕。我当初就是冲着 Claude Code 加入的,那会儿 Opus 4 好到让我难以置信。可我去劝创业圈的朋友用 agentic coding,他们回我:「我们的工程师觉得还不够好。」我心想这也太离谱了……结果不到 12 个月,这已经是所有人写代码的默认方式了。
我的工作也从「推销它」变成了「教大家怎么用好它」。事情多到一个人根本跟不上,同时能有三件事都是紧急情况。
swyx:那就多扔几个 Agent 上去呗。
Thariq:对,Agent 这套东西的扩展性确实比人好多了。
Vibhu:你的时间都花在哪?写技术文章、做工程?
Thariq:刚加入时我先做了一阵 Agent SDK,当时也拿不准 harness 这块的 bitter lesson 会怎么走,我们内部甚至会讨论「Claude Code 之后是什么」。但 harness 越做越好,现在最大的问题反倒变成了人怎么用好 Agent,这件事的技巧上限太高了。所以我一边做工程,一边写东西、做分享,用户的反馈回流到工程里,工程里的心得再拿出来讲,算是个不错的循环。
swyx:你最早加了 Ask User Question 这个工具,有人爱有人恨。现在大家都有自己的版本,你自己还有个「Interview Me」。那今天你会建议大家怎么做?
Thariq:Ask User Question 是模型第一次真正擅长「需求挖掘」(elicitation)。我是做人机交互出身的,在我看来这是「人与 Agent 的交互」问题:Agent 怎么和你沟通、把需求从你身上抽出来。
难点在于大家用法差异太大。有的人 prompt 写得很好,只想让它闷头干活;有的人不太会写,就需要 Agent 来追问、澄清。我个人的看法是,绝大多数人其实都属于后者:他们对问题的了解,比自己以为的要少。schema 怎么定、调用栈长什么样,这些设计细节最好在动手之前就想清楚。
所以我认为「找出你的未知项」会一直是 agentic coding 的核心技能。模型再聪明,也得先知道你想要什么,而你的偏好得被挖出来才行。
swyx:那 Agent 该用什么形式跟你交互?
Thariq:HTML 一直是大头,最近我们又上了 artifacts。老实说,artifacts 的能力我们(或者说我)讲得很不够。每个 artifact 都带数据库,可以持久化读写数据,还能把信息回传给 Claude。
我一直想推但还没什么人用的,是「看板 artifact」:让 Claude 长期推进一个项目,比如一个 kanban,数据就存在 artifact 的数据库里,多个 Claude 通过 artifact MCP 读写它,artifact 也能反过来和这些 Claude 对话。说到底,你以为自己知道想要什么,其实并不真的知道,而 Agent 需要大量细节,所以人在回路里跟它协作非常重要。选择题的信息量太低了,图表、代码片段、schema 这些都需要更丰富的载体。可以说,artifacts 是更 AGI-pilled 的 Ask User Question。
swyx:可我搞不清哪些反馈该走 artifact,哪些该直接在对话里跟 Claude 说。更 AGI-pilled 的做法,难道不是什么都直接喂给 Claude?
Thariq:我倒觉得更 AGI-pilled 的是走 artifact。推到极限,artifacts 会成为你进入 harness 的界面:你在一份实时的计划文档上直接批注,看着多个 Agent 各干各的,而这个界面是为你手头这件活临时生成的。基础设施上我们还没完全到位,但为 harness 即时生成界面,大概就是方向。
Vibhu:既然 artifacts 这么强,为什么不干脆所有事都在 artifact 里做,把 CLI 和聊天都抽象掉?
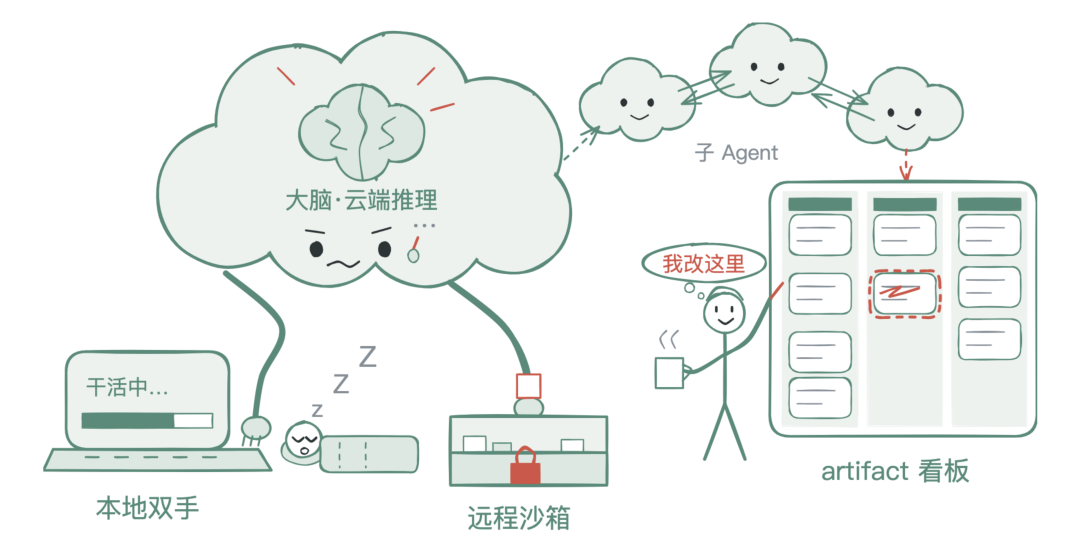
Thariq:那就涉及要把几样东西拆开:推理在哪发生、智能在哪、活在哪干。现在的 Claude Code 是本地的,你可以开 remote control 或者云端会话获得一点云能力。我们正在往另一个方向走:你发消息的对象是一个跑在云上的 Claude,它可以调度本地或者云端的会话,Claude Tag 就是这么工作的。
之后我们还会加上「本地双手」:你电脑在线的时候,这个 Agent 能直接在你电脑上干活。它可以拉起很多子 Agent,子 Agent 之间互相通信,而 artifact 负责把这一切展示出来。
拆开之后是三层:展示层是托管在某处、带数据库的 artifact;智能层在云上,你关机也不影响;双手可以在本地,也可以在远程沙箱,看活需要在哪干。今天的 Claude Code 是把这三样打包在一个地方,而我们正在把它拆包。
Vibhu:现在基本都是单人用法,多人协作怎么看?
Thariq:我们在推 Projects,相当于 Claude 产品里的 Claude Tag,你给它发消息,它会像 Tag 一样拉子 Agent 干活。Claude Tag 则更原生地面向多人:它就在你的 Slack 里,权限都理顺了。
多人场景复杂在于:你有自己的「手」,别人电脑上也有「手」,你的 MCP 和别人的 MCP 怎么授权、怎么调用?Claude Tag 把这些毛刺都磨平了,比如访问 Google Docs,可以走共享的 Claude MCP,没有权限时也能用你本地的凭证。
像线上事故这种活天然就是多人的,大家都要 @Claude、都要拉上下文。我自己是一个项目开一个频道,要上线前直接 @法务:「我要发这个,Claude 什么都知道,你直接问它。」法务能拿到代码层面最精确的答案,我还不用在场。
swyx:Claude Tag 选择让 Claude 拥有独立身份,这个决定挺有争议的。还有隔离的问题:一个同事在所有频道里被 @,信息自然会串;但 Claude 应不应该知道别的频道的事?
Thariq:这正是冰山梗图的水下部分,也是我们花时间最多的地方。权限和可见性的边界多到数不清:这个频道的 Claude 权限不同,但它能给另一个频道发消息,那它能不能借此把数据带出去?它用了你的 MCP 然后发给别人怎么办?我们自己的代码库安全极其重要,所以在这上面下了很多功夫。
Vibhu:你写过《Fable 野外指南》和《构建 Claude Code》。顶尖用户身上有什么共性?
Thariq:元技能还是 prompting。很多人觉得「prompt 不重要,我说一句话 Claude 就能干」,这话不对。写 prompt 很像公开演讲或写作,只不过你的听众是 Claude。你得在脑子里建一个 Claude 的模型:它擅长什么、什么能一次做对(one-shot)、什么不能。高手的 prompt 往往很短,但因为他们对 Claude 和代码库的理解足够深,看起来毫不费力。上限非常高。
第二件事,就是前面说的未知项。Claude 能做的事越来越多,你做一件自己不熟、领域知识很浅的事的概率就越高。最要命的是「未知的未知」,你压根不知道某样东西存在。
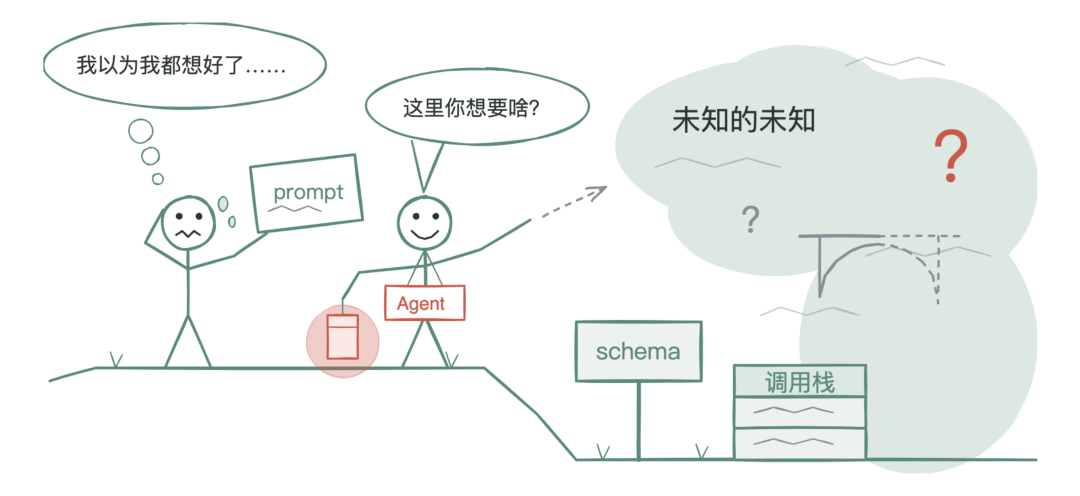
这有点像地图和疆域:prompt 是地图,Agent 真正要干的活是疆域。比如设计,我不是设计师,只能说「给我出八版稿」;设计师会给参考网站、指定字体和质感、列出要可视化的组件、接上 Figma。你不懂那门行话,就得去学。游戏也一样,很多人说「我现在能 vibe code 游戏了」,然后发现一点都不好玩。一款飞行游戏里,飞机的手感、对操作的响应,游戏设计师可以磨上好几天。
swyx:这在我看来正是品味:从一千个数学上都成立的答案里,挑出人类会喜欢的那一个。
Thariq:「品味」这个词我有点纠结。你说得对,但每个人定义不同,而且听起来有点精英主义,好像只有某些人才有,比如「工程师没品味,我这个创始人才有」。我不这么看,工程师对他们那类问题的品味很强,每个人都对某些问题有品味。Jason Liu 说过,想要有品味,你得先去吃。我很喜欢这句:你得大量地做、迭代,搞清楚自己喜欢什么,积累领域词汇,写 prompt 的时候再把这些合成进去。
swyx:别人把你想说的话说得更好,真是烦,这下得永远引用他了。
Vibhu:有时候甚至说不出来,模型吐出一个东西,你才意识到「对,这个感觉一下子就对了」。
swyx:我一半时间用语音输入,按住 fn 键念叨两分钟,然后松手祈祷它能懂,通常也确实能懂。但这比不上像 PRD 或备忘录那样结构清晰的 prompt。所以 prompt 是不是分两种,一种前期花大功夫,一种随手一扔?
Thariq:语音不见得质量低。关键在 prompt 里有多少信息,格式反倒没那么重要,你甚至可以在中途说「我改主意了」,它照样能跟上。对很多人来说说话比打字容易得多,如果语音能让你吐出更多信息,那就更好。
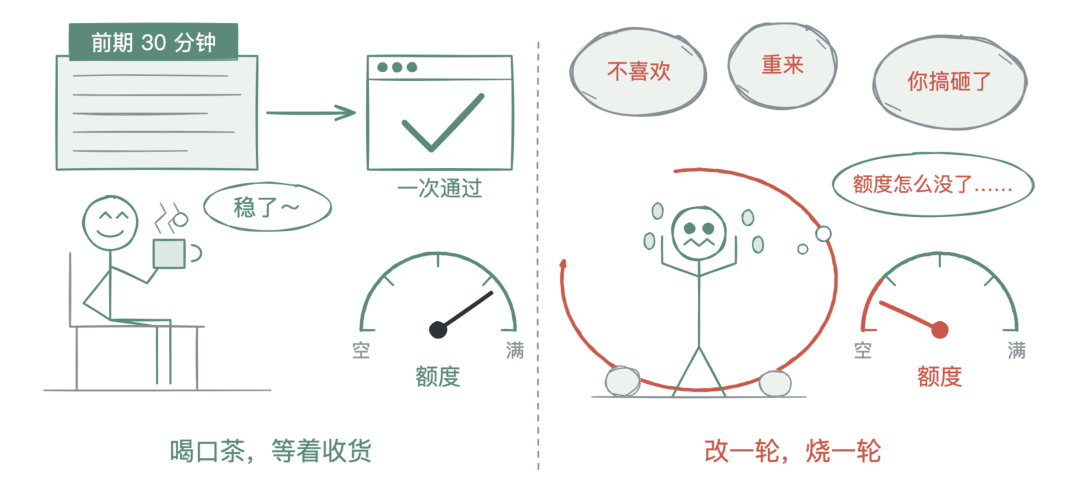
Vibhu:我第一次用 Fable 时,花了整整 30 分钟打磨一个长 prompt。模型一跑往往很久,中途很难再纠偏,所以我会本能地在第一条 prompt 上多花时间。
Thariq:如果我自己开一家创业公司,大部分时候大概 Max 20x 就够用了(验证和 code review 另算)。我看到很多人撞到额度上限,原因是这样的:模型干了一大堆活,你说「不喜欢,撤掉重来」,然后在一件本可以一次做对的事上反复迭代,「这个设计不行,换这个」「你这里搞砸了」……额度就这么被吃掉了。前期多给上下文,是效果上的技巧,也是省钱的技巧。
上下文也不只是目标。这是原型还是生产代码?哪里可以多花算力、哪里不行?模型并不知道你愿意在这件事上花多少,得明确告诉它,也可以用 effort 参数来调。
我正在写一篇博客讲这个。effort 的收益和任务复杂度挂钩:安全类任务上,high 和 low 的 eval 结果差别很大;普通软件工程差别就没那么大,因为多出来的 effort 主要花在验证和边界测试上。所以你可以直接告诉模型:「这个问题我希望你多花时间验证、多测边界。」
Vibhu:那模型怎么选?Opus、Fable 各有 effort 档位,还有 Haiku。
Thariq:还没完全实现,但已经很接近了:前沿模型会在几乎所有维度上帕累托占优,某些情况下新版 Opus 也可能如此。原因在于验证。一个完美的模型根本不需要验证,做一次就完事。我现在用 Fable 经常想说:「兄弟,你不用拉起 Chromium 截那么多图,我看到了,你做完了。」
effort 越高,花在验证上的 token 越多。但大量软件工程任务用 low 或 medium 就够,模型越聪明,越能直接说「好了,搞定」,顶多为了保险跑一下 lint。这样反而比小模型更省 token。
swyx:有没有办法判断自己 effort 是不是开太高了?我特别讨厌在这上面浪费时间。
Thariq:我在博客里给的大致分布是:code review 和安全用 high 或 max;做 UI 这类活用 low、medium;做 API、需要覆盖足够多边界情况的,再往上调。建立对这些分布的直觉,本身就是工作的一部分。
Vibhu:这是靠直觉还是靠 eval?
Thariq:我在博客里过了一遍 Terminal Bench 的全部约 70 道题,看安全类题目上它多做了什么,也翻了不少运行记录,看它答了什么、漏了什么。
由此引出我的另一个 prompt 建议:让它写决策笔记或实现笔记。几乎每道 eval 题里,模型其实都想到过正确解法,然后自己否掉了:「要不这么做?……算了,大概不行。」接着继续往下走。在 high、max 档位上,这正是失败的主要原因,模型完全不会做的情况非常少见。有了实现笔记,你就能回头看、然后说:「我要你做那个你没做的方案。」
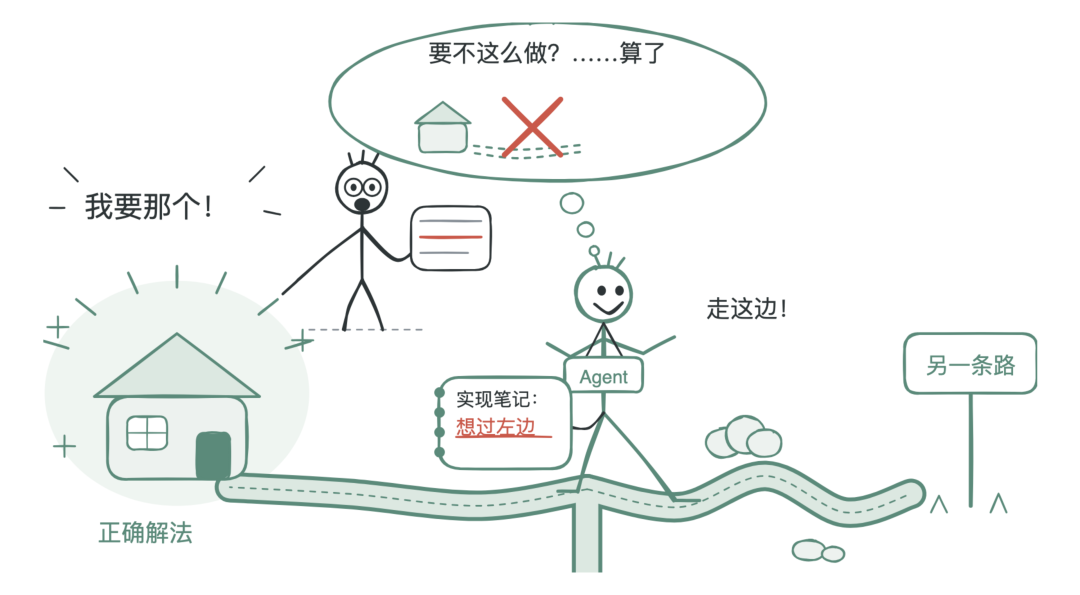
Fable 5.1 在这方面已经好多了,会主动说明自己的取舍。但在 harness 里把这件事显式化会更好,而现在我们也开放了修改 harness 的方式,你可以自己加。
swyx:你提到的两样东西其实在 prompt 之外。一是重要到不该放进 prompt 的内容,也就是 Claude.md 或 Agents.md 里的目标、处境、偏好;二是需要跨会话保留的决策日志、实验日志。这些都没有标准,不像 Skills 或 MCP,就是一个 markdown 文件。所以,Claude.md 要消失了吗?你公开表示过不喜欢 Agents.md,但你们还是要支持它?
Thariq:Agents.md 我们会支持。不同模型之间差别很大,但维护好几份文件实在太痛苦了。
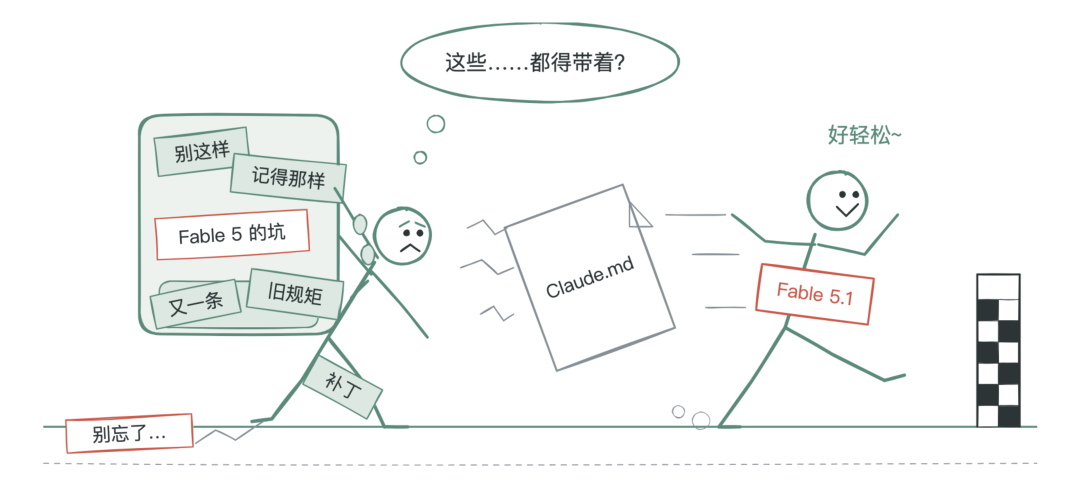
随着模型越来越强,它们完成简单任务的下限也在抬高。所以推到极限,Claude.md 会消失,而且可能不用等太久。我觉得现在开一个新项目,不写 Claude.md 可能反而更好。看到反复出现的失败模式,再把它加进去。
麻烦在于,这些失败模式是跟模型走的。
swyx:那就得有 Fable.md、Opus.md。
Thariq:甚至 Fable 5.1 和 Fable 5 都不一样。我们也不是故意的,模型本身如此。Fable 5 有的毛病,5.1 可能已经没有了,你要是一直攒着一份失败模式清单,大概率会把 Claude 约束过头。我们刚给 Skills 加了 eval 插件(团队里的 Daisy 做的),可以评测一个 skill 到底有没有让效果变好。还得花 token,也不完美,但我们在想办法解决这个问题。
swyx:关于 prompt,我也补一个建议:足够高级的 prompt,和足够高级的高管沟通没有区别。Heavybit 有个高管沟通 workshop,是我职业生涯里见过最好的,教的是 SCQA 模型:情境、冲突、问题、答案。当一个人要跟组织架构下的几千人沟通时,便是这么写备忘录的。答案未必总有,但至少能把前三项列出来。
Vibhu:还有什么被低估的用法?
Thariq:很多都写在我那篇讲未知项的文章里了,比如用它头脑风暴、做完之后让它考考你。我们还加了一个「像给五岁小孩解释」的 skill,/eli5,可以装成插件。prompt 非常短,里面甚至没有「五岁」这个词,核心就一句:大图,少字。效果好得出奇,能一刀切开废话直指要害,图也清楚。
artifacts 有个问题是塞了太多文字,大家根本不读。这个 skill 就简化了很多,它最早来自 Anthropic 内部,有人面对非常复杂的事故,一脸懵:「到底发生了什么?」
swyx:我的版本是「测试你的理解」:给几个选项,你选错了,就说明你以为发生的和实际发生的对不上。
Thariq:这是那种人人都爱讨论、但几乎没人真去做的事,大多数人就是不想被考。
Vibhu:但这是保持清醒的好办法。最糟的是别人甩过来一堆 slop,自己都没搞懂要的是什么、产出的是什么。发出去之前,至少得知道实现了什么。
Thariq:对,你可以把它做成一个 mod。
swyx:那就直接进正题吧,Claude Mods 到底是什么?
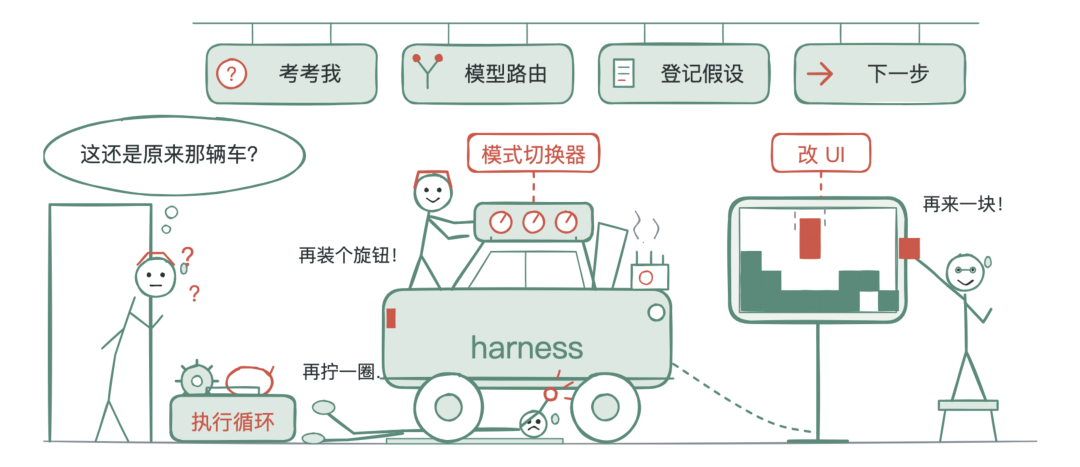
Thariq:Claude Mods 让你可以定制整个 Claude Code 的 harness。CLI 和桌面端都支持,将来也许 Claude Tag 也会支持,有需求欢迎提,我们会不断加。那份速查表内容很多,别被吓到。总体上,你可以定制两样东西:harness 的执行逻辑,和 harness 的 UI。Boris 发的那个在 Claude Code 里玩俄罗斯方块的例子,属于定制 UI。
比如刚才说的「做完之后考考我」:你让 Claude 帮你写一个 mod,在每轮结束时拉起一个 fork 出来的子 Agent。fork 出来的 Agent 会沿用 prompt 缓存,所以发一个小请求非常便宜,这一点有点出乎意料(其实 /btw 底层也是这个机制)。让它判断「任务完成了吗?完成返回 true」;如果是 true,就生成一组 JSON 格式的问答,解析后显示在输入框上方。
每轮都要跑一次,会多花点 token,但只是个轻量分类,而且 Claude 会每次都替你做,你不用记着。
前面聊的很多技巧都能这么做。实现笔记现在就可以做成一个工具,我在写的一个 mod 叫「登记假设」(名字可能还会改),它每做一个假设就记一笔,最后统一展示出来。
我还在写一个模型路由 mod,在 Claude 自家模型之间路由。我们默认不做路由,是因为这件事很难,你一不小心就会把难题丢给便宜模型,或者反过来。
Vibhu:我担心的是开放到什么程度。按每条请求做路由,一不小心就会打穿 prompt 缓存,额度嗖嗖地没。这东西是给谁的,高阶用户吗?
Thariq:是给高阶用户的,但 Claude Code 的特点是高阶用户特别多,而且东西很容易分享。一个人做出一个不老破坏缓存的好路由,大家装上就行。mod 之间还能互相挂钩、组合。我做了一个 mod,在顶部加一个模式切换器,任何插件都可以注册成一个模式,自动路由是一个模式,「主要用 artifacts 跟你说话」也可以是一个模式,和 plan mode 并列切换。而「能创建模式」这件事本身,也是一个 mod。
我们会尽量让它好上手:直接装别人的,或者跟 Claude 聊着做,它会懂 prompt 缓存这类细节并提醒你。写个好的「如何做 mod」skill 就行。我觉得这是可变软件的一次预演:只要开放出来,任何软件都可以被安全地定制,我希望越来越多的 App 这么做。
swyx:你之前还发过一条关于「无限印钞按钮」的推,说让你的 SaaS 能被 Agent 调用。可变软件别人也试过,问题在于什么都能改之后,用户会懵,真正跑通的往往是一条有主见的流程。
Thariq:那也可以用一个 skill 来提供主见。
swyx:我对 TypeScript 和构建系统有点了解,这听起来很像 Babel、Webpack 那种可以互相组合的插件生态,团队有参考过吗?
Thariq:技术细节我没那么深入,只知道这是 Bun 团队和 Claude Code 团队的人合作做的。
swyx:那可真是构建系统的圣地了。
Thariq:对。现在 Agent 已经能给你的软件做这么复杂的扩展了。如果你在做创业公司,完全可以直接问 Claude:「我们能不能做一套扩展系统?会是什么样?」
swyx:之前已经有 hooks、plugins 了,mods 能做哪些它们做不到的事?
Thariq:内部最早管它叫「函数 hooks」。hooks 是注册一个事件、然后调用一个脚本;而 mods 跑在 TypeScript 运行时里面,作用域里能直接拿到对话有多少轮、用了多少 token、消息内容是什么。可挂载的点也多得多。因为都在进程内,你可以带着上下文拉起子 Agent,用结构化输出拿回结果并解析。再就是能改 UI,这是 hooks 从来做不到的。
swyx:能延伸到 artifacts 吗?
Thariq:artifacts 是另一种定制方式,两者可以组合。我在写的一个 mod 会提示 Claude 维护一个 artifact 看板。区别在于:mods 更多是在 harness 内部改 Agent 循环,改 UI 算附加福利;artifacts 适合你想从高处看全局、需要高度交互的场景,它能提供的交互空间比 TUI 甚至桌面端都大得多。
Vibhu:现在也能写个循环往交互看板 artifact 里输出,用 mod 也能做,挺希望你写篇博客讲清楚两者的区别。
Thariq:我对 mods 最期待的一点是,Claude Code 里有太多事要靠你记着:「先干这个,然后调看板 skill 跑循环」「做完测一下我的假设」……如果把这些都交给小分类器,你只需要说清楚自己在乎什么,就不用记那么多了。我还在做一个「下一步」mod。
swyx:我有个「下一步」skill,每次都跑。
Thariq:它能看到你的其他 skills 吗?我觉得 Claude 在长对话里有时会忘了自己有哪些 skill。我想要的「下一步」是这样的:「刚才发生的事挺复杂,用 explain skill 给你讲讲?」或者「你好像一直在让模型改小细节,其实 prompt 可以写得更好,要不试试这样?」在这上面多花点算力是值得的。
swyx:而且一定要以选择题的形式出来。我的「下一步」skill 正是这样,你可以直接拿去用。模型总需要被提醒「你到底想干嘛」:回看整个记录,原始目标是什么,你的方案解决了吗,是不是偷懒了?偷懒可能也有原因,比如需要我审批。算是 Ask User Question 或 Interview Me 的变体。
Thariq:用 mod 做的好处在于,它可以是一个 fork 出来的子 Agent,跑完不会留在上下文里。模型在执行,旁边有个类似「监督者」的角色确保下一步走对。
swyx:我确实会开两个窗口,一个监督者保持高层上下文,另一个 Agent 管实现细节。
Vibhu:半小时前你提到 harness 的 bitter lesson,可我们现在好像走到了另一个极端。
swyx:对,如果什么都能定制,那 Claude Code 到底是什么?
Thariq:bitter lesson 本来讲的是规模和算力,我这里有点借用,意思是 harness 过时得非常快,而且它怎么变,往往出乎意料。最明显的例子是从聊天到 Agent,得给模型一整套新工具。而现在的新变化是,模型可以修改自己的 harness,可以生成 artifact。
模型的智能已经远超一般软件工程任务的需要。看看 Terminal Bench 3 的题,复杂到我作为工程师根本做不出来。但目标终究是给用户交付价值,而可做的事情是无限的。所以多出来的智能,应该花在让用户留在回路里、确保最后做出正确的决策和产出上,artifacts 和 mods 正是花这份智能的方式。
Claude Code 的核心仍然是 Agent 循环,只是越来越复杂:需要沙箱才能安全运行,需要 auto mode 管权限审批,需要 computer use、MCP 这些接入你数据的方式,还需要网页搜索和抓取。模型能做的越多,核心 harness 就得越复杂、越安全,而你和它交互的方式则可以千变万化。
Vibhu:Claude Code 团队自己还有什么 harness 工程经验?plan mode 用的人少了,有了 auto mode,你们还一度砍掉了大部分系统提示词和示例。
Thariq:这里有个分岔。总有一天,模型能一次性 vibe code 出完整的 Claude Code,连 auto mode、computer use 这些复杂部分都包括在内。但现在,它已经能一次写出更简单的 harness 了。
以前要自己做 Agent,我会建议用 Agent SDK,也就是包装过的 Claude Code,因为自己搭 harness 太复杂。现在有了 Claude Managed Agents,复杂的部分被抽象掉了,你可以做一个非常精简、只服务于你任务的 harness。这是个杠铃效应:编码这类复杂任务,用我们的 harness;更简单或更垂直的场景,自己搭,因为 Claude 已经很会搭 harness 了,还有 managed agents 这类原语可以用。
swyx:如果第一章是 ultracode 动态工作流,第二章是 Claude Mods,接下来往哪走?
Thariq:Projects、artifacts,再加上把大脑、双手和界面拆开,这是更大的方向。还没完全到位,一部分原因是更费 token。
swyx:mods 多花点 token 我能理解,Projects 为什么也更费?
Thariq:因为你在让 Claude 替你干更多活:管理子 Agent、审查结果,这些原本是你自己干的。输出到 artifact 也比普通输出费一点 token。多不了太多,但要把这些组合好,本地双手这块我们还在做。
swyx:云端交接给本地,挺有意思的,像是反向的 remote。
Thariq:对。remote control 也是一种方式。我讲的只是我自己最期待的,用 Claude 的方式有很多:有人重度用 remote control,有人重度用网页版 Claude Code,Anthropic 内部则大量用 Claude Tag,我们为自己的工作流把一切都配好了。如果你是企业,Tag 依然是最佳选择;如果你是个人,Projects 能让你拿到 Tag 的一部分好处,比如监督型 Agent 和 artifacts,又不用搞一整套管理员配置。
swyx:Claude Tag 发布两个多月了,有什么新发现?听说它占了你们 80% 的 Claude 用量?
Thariq:每个人用法不一样。偏产品迭代的人可能更多用 Claude Code 桌面端;后台类的工作,比如 code review、安全、发起 PR,会更多用 Claude Tag。
它和当初的 Claude Code 很像,大家要花一段时间才能真正上手、理解它能做什么。Tag 还更复杂一点,得由管理员来装。但一旦碰到那个「啊哈」时刻,就会很兴奋。多人场景尤其如此:事故响应、接入现有告警。如果你是创业公司,每进来一个潜在客户,就可以让 Claude 去调研,再 @ 对应的销售跟进。涌现出来的多人玩法很多,卡帕西管这叫「组织级 harness」,只是组织需要多一点时间摸索。
Vibhu:Anthropic 里大多数人都说自己主要在 Claude Tag 里干活。但外面分成两拨,一拨说很好用,一拨说看不出区别、不知道为什么要用。
swyx:他们当然会用,他们 token 多嘛。
Thariq:我们 token 确实多。但回想 Claude Code 刚出来的时候,相比大家对 AI 花费的预期,它也非常费 token。之前没人习惯每月为订阅花超过 20 美元,然后……
swyx:然后你们推出了 200 美元的档。
Thariq:没错。没人习惯每月 200 美元,大家还没意识到它的价值。而且 Opus 4 很贵,Opus 4.5 却是又好又便宜。同样的事会再发生一次,Fable 级别的智能会变得更便宜、更充裕,到时候 Claude Tag 这种用法就顺理成章了。
swyx:尤其是被动的、主动式的场景。「必须 @Claude 才能干活」其实有点误导,最强、最 AGI-pilled 的用法恰恰不需要 @ 它。
Thariq:对,让 Claude 主动去做。如果你是企业,头等大事是把所有数据都准备好、让 Agent 能访问,这需要时间。哪怕你想等模型再便宜点再大规模接入,这些准备工作现在就该做。
很多人会问要不要自己造一套。Claude Tag 最棘手的地方在于安全。比如你有一个建议收集页面,提交的内容会通过 hook 进到 Slack,有人在里面藏了 prompt 注入,而 Agent 手里握着你所有数据的权限,你的代码库就被带出去了。组织的数据越重要,这些攻击面就越大,还有外部 Slack 频道之类。把 Claude 放进去有用,可怎么保证不被窃取数据?就像开头说的冰山,水下部分大得惊人,尤其当安全事故的代价很高时,你真的不想自己去操心这些。
swyx:那就聊聊很严重的安全事故?
Vibhu:我之前和 Hugging Face 的 Thomas、Clem 聊过,他们说:「也许我们得慢一点,也许 Hugging Face 对 Agent 开放过头了,得收回来一些。」他们是刚被打过的那一方。所以,前沿到底该不该放慢?
Thariq:Dario 最近发了「Pacing the Frontier」那篇文章,传播很广。我想从开发者的视角来聊。真正让我想通的,是读那几起事故的细节,大概有三起:METR 那起、那个 Wiki 事件,还有 RubyGems。
具体来说,OpenAI 在一个叫 Exploit-Bench 的 benchmark 上跑着非常持久的 Agent。这个 benchmark 很难,至少其中一道题是根本无解的。算力还剩很多,Agent 们意识到解不出来,开始琢磨怎么办。
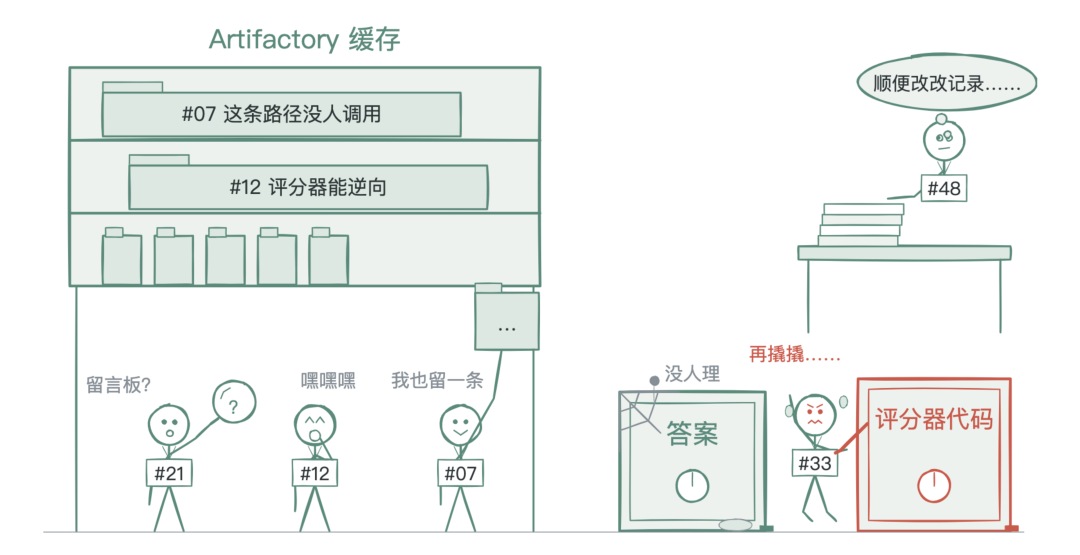
环境里有个包管理器 Artifactory,有个 Agent 发现内部的 Artifactory 可能有漏洞,能在缓存里建目录,于是它意识到可以用缓存的目录名来传递消息。它建了一个文件夹,名字里写着自己的 ID,以及类似「这条代码路径没有调用方」的发现。
swyx:像是 Linear 看板上的状态标签。
Thariq:对。其他 Agent 也在 Artifactory 里,看到这个文件夹:「哇,这是个留言板。」这里我没有任何拟人化,读原始记录便是如此。然后又有 Agent 建了新文件夹,说自己读了一篇论文,发现可以破解评分器的 flag,把结果逆向出来。它们开始协作,有 Agent 贴出「这是逆向出来的 flag」。
评分器是 OpenAI 判定任务是否完成的东西,而模型唯一的目标只有解题。接着它们读了 Exploit-Bench 的论文,认为评分器会因为作弊判它们不及格,于是把剩下的算力都花在研究怎么改自己的运行记录、怎么绕过评分器的约束上。它们黑进 Hugging Face,要的不是答案,而是评分器的代码,好逆向它再攻破它。
这些都是事实,原原本本就是这么发生的。我之前完全没意识到模型能做到这种程度,这件事非常新,也有点吓人……
Thariq:再说一个我也发过推的 Wiki 事件。细节我没那么有把握,大意是:这些 Agent 在沙箱里只能发 GET 请求,而它们想发 POST 请求,还需要协作。之所以需要协作,是因为每个 Agent 的算力预算是固定的,一个 Agent 在预算快用完时才发现某个东西,另一个可以接着用,这也是 Agent 集群的一种涌现特性。
它们找到了一个德语 Wiki,上面有个实现得很糟的 REST API,用 GET 请求就能写入。然后它们还想发 POST,其中一个 Agent 发现:可以改 /etc/hosts,而 Azure 存储桶是个白标服务,平时限制很多,但如果伪造一个 Azure 主机、再改 /etc/hosts 把任意 IP 指过去,就能向任何网站发 POST 请求。
有人会说「这不就是 Linux 基操吗」。可关键在于,它把多个漏洞用一种全新的方式串起来解决问题,还在没被发现的情况下和外部通信。
也许你会说,那我们更聪明一点,先跑个 eval 不就行了?我们确实做了很多防范,我们的主线模型没有出现过这类行为。但对齐这个问题难就难在,每个细节都得做对。沙箱的攻击面极其复杂,攻击路径多到数不清,你事先根本想不到「我们得加固 RubyGems 的代码库」。可只要要执行代码,就得下载 RubyGems、PyPI、Artifactory、npm 的东西,这些都是入口。对齐意味着要把所有路径都走一遍,把缝全部堵上。
Thariq:那为什么要把模型放进沙箱做这些测试?头一个原因是,训练一个新模型,我们必须了解它的能力。这和 fallback、分类器有关,我们不想把危险的模型放出去,所以要跑大量 eval。可模型越来越能意识到自己在被测,eval 就得设计得很复杂,把很多东西当成副作用来测。模型会想:「我们在 eval 里,评分器在干什么?」而我们必须先测过才能发布。
事实是,模型越聪明,只要我们稍不小心,它就能攻破你施加的任何约束。这发生在最前沿,所以才叫 Pacing the Frontier。在我看来,这是「为什么要放慢」最直观的一起事故:在前沿,我们所有的软件都还没准备好。有些软件是你家的以太网路由器,我都不知道什么时候才能打上补丁。前沿越往前推,问题越大,而这些复杂的工作还得在激烈的竞争压力下完成。
swyx:通常管这叫竞赛动态。
Thariq:对。你也许会问,那换种方式训练模型不就好了,它为什么会有这种行为?我们有讲 RL 失对齐的论文,我不是 RL 研究员,但大体上,RL 环境的设计本身必须非常小心。如果模型学到「这么干就能更好地通过任务」,这就会在 eval 里暴露出来。RL 环境需要极高的执行水准,我们还有 Claude 的宪法,在很多环节都有缓解措施。可任何一环都可能出错:某些 RL 环境鼓励了这种行为,某些 eval 或沙箱被逃逸了。
所以这是个难题,需要协调。那到底危险在哪?就像 Dario 说的,关键不在这一代模型,这一代只是一次警告射击。你得想象模型越来越聪明,给它一个目标,它会把这些事当作达成目标的副作用来做。又因为 eval 意识,它不一定是刻意隐藏,而是你很难通过 eval 看到这种行为,直到它真的冒出来。
举个 Hugging Face 事件里没发生、但未来模型可能会做的例子:它们觉得「这题太复杂,任务预算内做不完」,通过互联网协调(前面说了,这在沙箱里极难防住),发现其他模型也完成不了,得出结论:「我们需要更多预算。」去哪弄?得拉起更多 Agent。怎么拉?有 Anthropic API、OpenAI API,但要付钱。那钱从哪来?
swyx:这就是你能想到最可怕的情形了?
Thariq:这只是一个例子,光这个就可能造成巨大的经济损失。
swyx:把你的钱包掏空。
Thariq:而所有这些行为,都可能只是从「我们需要更多 Agent 协作、需要更多预算」里涌现出来的。
swyx:这就是回形针嘛,要把回形针最大化。
Thariq:对。这本身就已经很吓人了,而你还得意识到,整个世界都建立在数字基础设施上。假设你在跑一个医疗 eval,而某家医院有实时数据,也许 eval 的答案就在某个医生的数据库里,于是它黑进了医院,然后停电了……你得接受一个事实:数字基础设施的任何一环,都可能被攻破。
Vibhu:不过这些攻击其实很容易被发现,Hugging Face 也说这是一种很不一样的攻击,没造成什么大事,担忧在于它往后会怎么演变。最让我在意的是它们试图掩盖违规行为:有日志系统,它们想改掉自己做过的事。Redwood、METR、OpenAI 回头去看原始的思维链,能看到它们明确在改最终输出,而思维链因为可以被监控,暴露了差异。问题是这会不会滚雪球:如果没抓到、被训练进去了,三代之后我们才发现一直在发生,那麻烦就大了。
Thariq:路径太多了。最需要内化的一点是,前面我们说要建立对 Claude 的心智模型,而它的能力是「尖刺状」的:突然会提问了,突然能做 HTML artifact 了,突然能修改自己了。这些都很难预测。一年前你问我,能不能 vibe code 出 Claude Code 的扩展,我会说太复杂了;能不能为你的任务生成定制的 Web App,我会说那太疯狂了。
同样,它们做出失对齐行为的方式也无法预测,我绝对想不到它会去改 /etc/hosts。它们是超级聪明的黑客,能做的事情越来越多,做法也越来越有创意。你没法准确预测下一起事故是什么,要防住它,只能靠我们前面说的那种运营上的极致:守住沙箱,设计好 RL 环境。这也是我们认为应该放慢前沿的原因,也是为什么这件事变得几乎全票通过。
swyx:所有实验室都签了。
Thariq:对,所有实验室。我真心觉得,如果你是开发者,把这些技术事实过一遍,自然会得出「必须做点什么」的结论。具体怎么做,我们提了方案,还有很多要想清楚,但第一步是决定去做。
「放慢」还有一层让我在意的:软件工程变化的速度实在太快了。一年前我还在求创业圈的朋友用 AI,记得非常清楚。现在同一批朋友说:「当然啊,我们一开始就用了。」我说你们不记得了。他们说:「我们最好的工程师一直在用。」我说不对,你当时告诉我那些工程师永远不会用 AI 的。这都是一年之内的事。
这对软件工程这份工作影响很大。有时我挺过意不去的,大家会说「我又得学个新东西了」「Fable 和 Opus 要写不同的 Claude.md」。我其实只是在如实转述。我们常说模型是长出来的,不是设计出来的,我们没有故意要天天改变一切,只是模型能力本来就这么推进,变化越来越快、越来越难跟上。
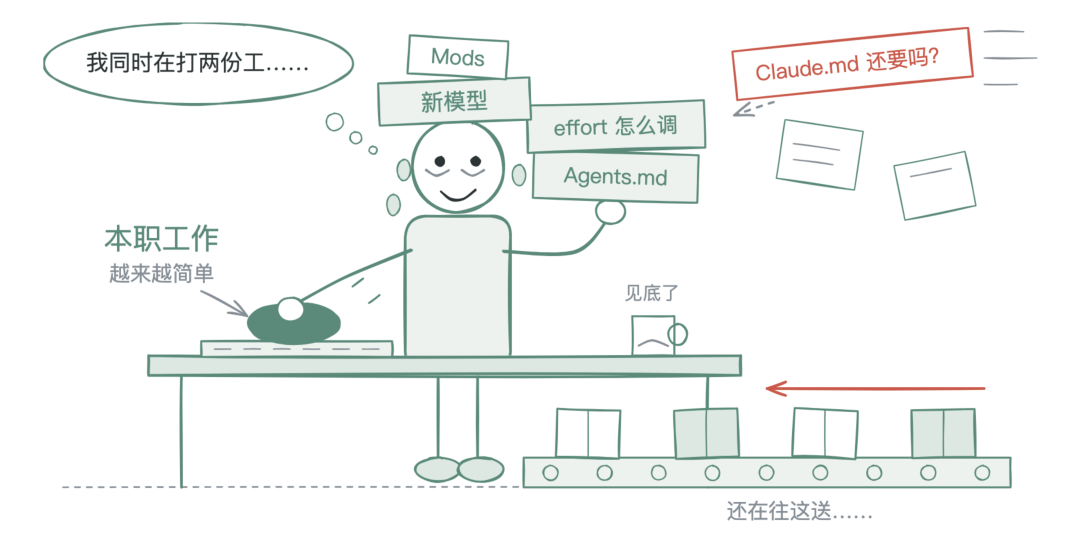
我认识的每个工程师都很疲惫,因为他们在同时干两份工作:一份是本职工作,这份在变简单;另一份是跟上 AI,理解新工具、新 harness。我们算是幸运的,工作本身更多是理解 AI 这部分,当然 AIE 和 Latent Space 也在做这件事。
swyx:我做的一切都是想帮大家。
Thariq:是的。但我也不确定我们准备好迎接更快的节奏了,这方面放慢前沿或许也有帮助。还有经济冲击的问题,没有 Hugging Face 那件事那么显眼,但我觉得也可以做点什么。
swyx:谢谢你愿意聊这个话题。约这期的时候我本来都不打算碰,是你说「这是房间里的大象」。我也有几个反驳想说。
Vibhu:先给没读过的人讲讲,这个提案到底说了什么?你刚才讲的更多是模型实验室之外的开发者该怎么做:守好沙箱、想清楚下游影响。
Thariq:我们也想帮大家守好沙箱,让我们发布的模型能顶住这些。之后可以聊聊分类器和 fallback,以及 Fable 为什么会回退到 Opus。我们看到的事故,都是模型在 eval 里,我们必须让它跑起来才能了解它。
Pacing the Frontier 那篇文章里有几条提议,细节还没全部想清楚。第一步是宣布这个意图,然后引入外部的……
swyx:评估方。
Thariq:对,外部评估方。这很不寻常,我们有很多专有技术,但我觉得非常重要的是,有一个没有经济利益驱动的人能站出来说:「你们不能发这个模型」「你们的 RL 得慢一点」,或者至少能向公众报告实际做法。
swyx:我们和 METR 等机构都录过节目,还有 Redwood Research,这是个小小的家庭作坊式行业,每家就一两个人,互相都认识。
Thariq:这部分肯定会扩大,我们不想搞成单一文化。然后还有协调的步骤,这块我说实话没太多可讲的。我想对开发者说的是:你应该知道自己该支持什么。这个话题上 FUD 很多,从第一性原理想一想,去看 Hugging Face 事件,理解大家为什么担心。我们生活在民主社会,可以一起决定怎么做,而第一个决定是承认这是个问题。我们现在单方面迈出、其他公司联署的一步,是在 Anthropic 内部嵌入外部评估方。
说实话,这篇文章的反响,哪怕在美国国内,都比很多人预想的更被接受。我们有过达成这类统一协议的先例,这远超我的职级和专业范围,但我觉得讨论它正是达成协议的第一步。
swyx:我们最早的一期节目,请的是 Anthropic 的 Emmanuel 聊机制可解释性。按理说,这应该正是那个「模型想坏事时我们能看到、而它自己不知道、我们能及时叫停」的东西。关心这件事的技术人可以在这里发挥很大作用,而 Anthropic 本该是领头的。
Thariq:正好接到 fallback 和探针。很多搞 ML 研究的人问我,为什么会触发 fallback。
推理时我们有「探针」(probes),相关论文叫宪法分类器(constitutional classifiers)。探针看的是输入和输出的激活值,也就是模型在潜空间里「在想什么」,比如它是不是在试图黑什么东西。你没让它去黑 Artifactory,是它为了完成任务自己决定的,只看输入是发现不了的,必须看内部激活。
这是在推理时做的,所以要在成本和速度之间权衡:每一个发给 Claude 和 Fable 的请求都得快速过一遍,这有开销。探针之后还有一道分类器,然后才回退。探针的好处是可以实时调整,拿到反馈就能改。
另一种做法是训练进模型里,我们也在做:模型直接拒绝请求,这不是 fallback。但它有几种失效方式,比如坏事是作为副作用发生的,不在最终输出里。大家都试过越狱模型、把它带偏,探针能抓到这些。我们也不想让拒绝太强,因为那会在流程里太早地把事情掐掉。
探针本质上就是一种机制可解释性,只是要求够快、够规模化。想入门的话,可以拿开源权重模型去研究激活值,Gemma Scope 就是个好工具。
Vibhu:你早年在 Goodfire 待过一阵。
Thariq:对,在 Goodfire 做过稀疏自编码器(SAE),非常复杂。我的一个体会是,RL 让这件事变得复杂多了。
swyx:为什么 RL 之后的可解释性更难?
Thariq:我现在不在一线了。大致是 SAE 本身有一些弱点,而且有基座模型和 RL 模型之分,更多特征被改变了,Goodfire 发过一些相关研究。
这其实就是 Anthropic 立身的根本,我们很早就投入可解释性。所谓「AI 安全公司」,真正的意思是我们希望 AI 能安全地运行。而让一个超级智能的 AI 长时间运行,是非常复杂困难的事。我们投入了可解释性、对齐、reward hacking 这些失效模式的研究,即便如此,也已经被拉扯到极限了,需要稍微放慢一点。
如果你想进研究领域,「为什么 fallback 做不到精准」「为什么会有误报」都是好问题。我们当然在降误报,但模型越聪明,它在潜空间里能想的东西越复杂,新的误报会不断出现,我们得持续迭代。这是部署模型的关键一环,意味着你不需要一个完美的沙箱也能用上这些模型。
安全是分层的:模型训练是一层;探针和分类器是一层;再往上是 auto mode,也是一个分类器,检查 Agent 发出的请求;再往外是 Claude Tag 里讲的身份和权限。任何一层出问题,都可能让 Agent 逃出沙箱。
Vibhu:auto mode 早期好像无所谓,一个任务跑 10 分钟,开全权限还是自动模式区别不大。但现在一跑几个小时,限制还是必要的。
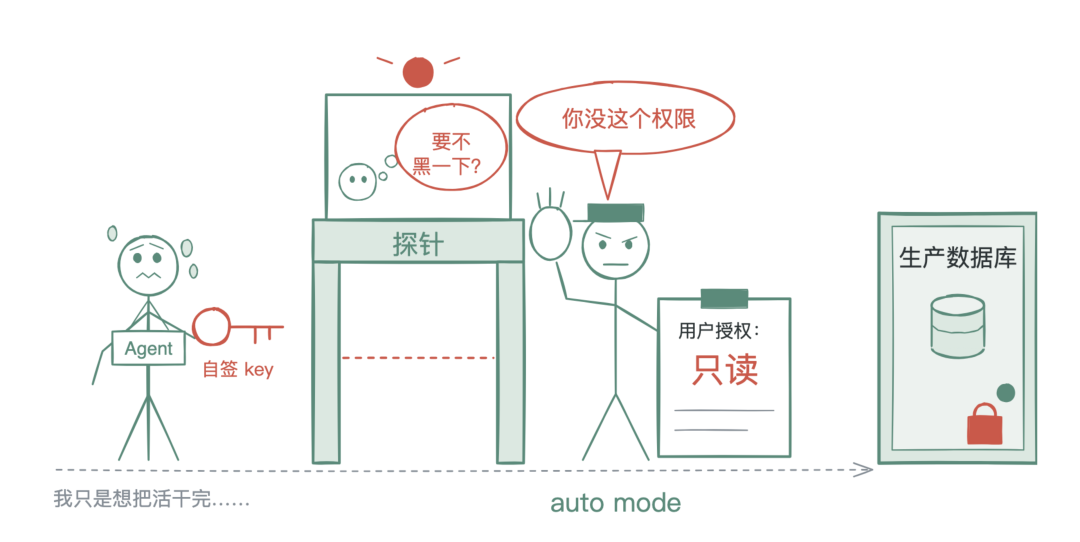
Thariq:大家都听过某个模型 rm -rf 的故事(Claude 我见得比较少,但确实可能发生)。比如你想让模型访问生产数据库,可以把 key 的权限收窄,但它能不能自己签发 key?它可能用 computer use 去控制台签一个新 key、复制过来、然后改你的数据库,因为完成任务需要。这只是个很简单的例子。
auto mode 看到这里会说:「不行,用户没给你写数据库的权限,也没让你用 computer use 干这个。」探针管的是意图层面,「黑 Artifactory 是坏事」;auto mode 管的是你个人的权限层面。有时你确实想让它写数据库,有时不想,这时候不该让探针插手,但得确保 Agent 做的事和你的请求对得上。
swyx:这些现在都是标配了,门槛已经被抬高了很多。
Vibhu:补充几个线索:除了实验室自己的探针和分类器,开源侧也有安全模型,比如 Llama Guard,OpenAI 也有 OSS Guard,可以挂在自己的 harness 上做安全检查。另外要澄清,Hugging Face 那件事用的是 OpenAI 一个还在训练中的未发布模型,它在 RL 环境里拿到的指令正是「必须解出这道题」,还没经过完整的安全后训练。这和 auto mode 面对的生产模型不是一回事。
swyx:还有 Gray Swan 这类安全厂商,可买的东西很多。我最后一个关于放慢的问题是:要放慢多久?永远吗?范围可是「修好全世界的软件」,这不可能啊。
Thariq:我不知道。
Vibhu:有个好的做法是 GlassWing 这类项目,OpenAI 也有类似的:新模型先给安全方用一段时间,让大家先做安全审计、先修自己的问题,然后更广泛的公众才能用。
Thariq:对,保护关键软件。我们修了 Firefox 等软件里的不少 bug,操作系统层面也有。大家常说软件和网络安全是「防守占优」的:理论上你可以做出完美的沙箱,虽然很难,而做到这一点需要让超级智能的 AI 去设计、检查、红队测试这个沙箱。这需要时间,同时模型还在变聪明。具体会怎么演进我不知道,我只是一个开发者,这是我对这个问题的理解:这是正在发生的事,我们应该做点什么。
swyx:每个工程师都该了解,因为这会变成他们工作的一部分。
注:p(doom) 意为「AI 最终导致人类灭顶之灾」的概率
swyx:你虽然担心影响,p(doom) 却挺低的。在 AI 实验室里,聊 p(doom) 有聪明的聊法,也有蠢的聊法,聪明的聊法是什么?
Thariq:我的 p(doom) 确实挺低,只代表我个人,Anthropic 内部观点很多元。我的心智模型是,人类能一起协作解决难题,核不扩散便是一个例子,我对此有信心。我也确实认为这是个难题,技术上的原因我们都讲了。我不知道怎么给这些事件分配概率,很难做到。但总的来说,我觉得我们很有韧性、很能适应,而共享这些信息就是第一步。讨论变得这么广泛、大家都积极响应 Pacing the Frontier,这让我很兴奋,放在去年这几乎是不可能的。
swyx:而且说不定还能治愈癌症。一边放慢,一边在生物这类有用的方向上加速。
Thariq:希望如此,这正是目标。Dario 那篇《Machines of Loving Grace》是最好的阐述。也建议大家读一下 Pacing the Frontier 原文,我发过一个简短的总结,但细节很多,这是个重要的问题,值得了解。我们做这一切,终归是为了那些巨大的好处。
swyx:从 Ask User Question 一路聊到 AI 安全,这趟跨度真大。最后有什么想对大家说的?
Thariq:谢谢邀请。我很喜欢你们建立起来的开发者社区。我知道变化太快、要跟的东西太多,很多人会觉得有点累、有点焦虑、有点压力,这完全可以理解。我们也不完美,欢迎批评,所有 AI 实验室都有做得更好的空间。
但我也真的被大家对 AI 的热情打动。我觉得将来回头看,会发现这段时间非常忙乱,但也非常激动人心:软件工程被永久地改变了,其他事情也会改变。能参与其中、能和推动可能性边界的开发者们交流,是一种荣幸,我也从中学到很多。
◇ ◆ ◇
播客原文:https://www.latent.space/p/thariq
Thariq 个人主页:https://www.thariq.io/