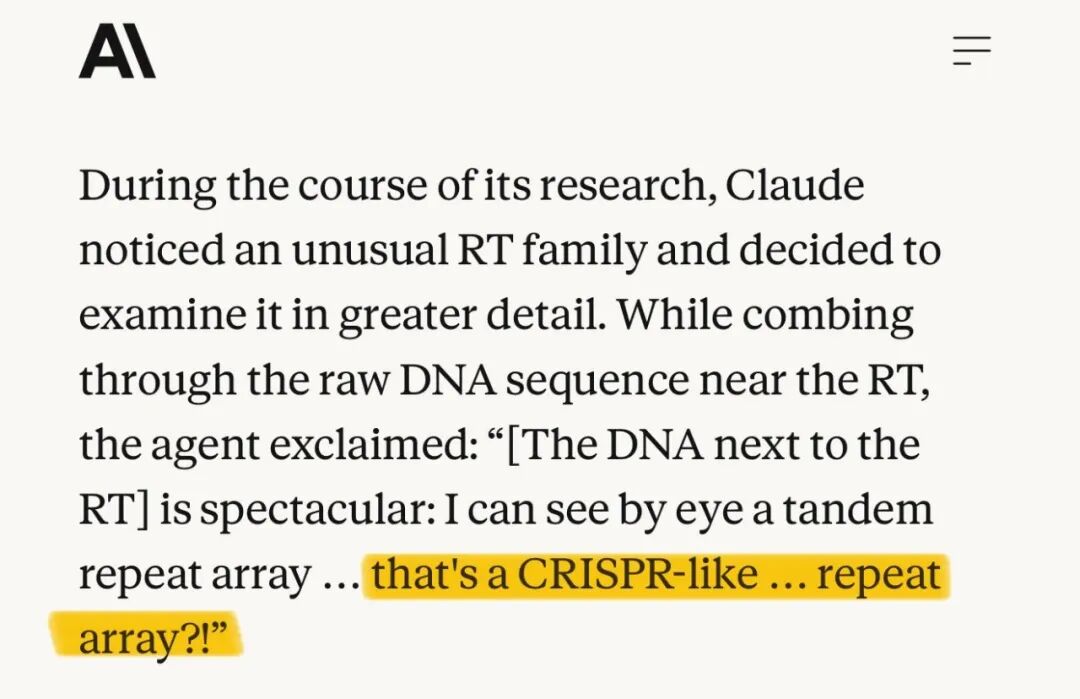
Claude 在读一段噬菌体 DNA 的时候,突然激动了起来:
这段侧翼序列太壮观了:我用肉眼就能看出一个串联重复阵列……这是一个类似 CRISPR 的……重复阵列?!
注意最后那个「?!」。
一个 AI,在 950 个同伴连续跑了 21 个小时之后,在一段 2900 个碱基长、写满 A、T、C、G 的序列里,发现了一个此前没有人类科学家报道过的东西。
今天凌晨,Anthropic 正式官宣:公司内部成立了一个分子生物学研究组,还自建了一间湿实验室。
而它的第一个成果,就是 Claude 在噬菌体 DNA 里挖出的一套全新酶系统,Anthropic 将其命名为 ART(阵列关联逆转录酶,array-associated reverse transcriptases)。
它的基因旁边,趴着一长串整齐的重复 DNA,长得有点像 CRISPR。
Dario 本人也亲自下场发了长文,说这至少是他读博时「会引以为豪的工作」。
要理解这事为什么能让 Claude 打出「?!」,得先简单说说 CRISPR 是怎么来的。
生物学里很多改变世界的发现,一开始都只是有人注意到了一个「怪东西」。
限制性内切酶,是在细菌的免疫系统里发现的,细菌用它来切碎入侵病毒的 DNA,后来人类拿它当剪刀,开启了整个生物技术产业。Taq 聚合酶,是从黄石公园温泉里的一种细菌身上找到的,能在高温下复制 DNA,后来成了 PCR 的基础(对,就是疫情那几年天天做的那个)。
而 CRISPR 最早被注意到时,也只是某些细菌 DNA 里一段「奇怪的重复序列」:同一小段序列隔一段距离就重复出现一次,中间夹着各不相同的间隔序列。
后来人们搞清楚了,这是细菌记录病毒「通缉令」的档案柜。再后来,它变成了基因编辑工具,拿了诺贝尔奖,现在已经是基因药物的地基。
所以在生物学家眼里,「一个酶的基因旁边,有一串整齐的重复序列」,这个画面本身就很让人心跳加速。
这次的主角是逆转录酶(RT),一种能把 RNA 复制回 DNA 的酶。它在细菌里很常见,经常和一段非编码 RNA、一个搭档蛋白一起组团干活,负责抵御噬菌体(也就是专门感染细菌的病毒)。
过去几年,科学家们一直在基因组数据库里「淘金」,找新的 RT 家族,因为它们可能是下一代基因编辑工具的原材料。只是这活儿极其费眼睛:数据库每四年翻一倍,里面有几十亿条蛋白质序列,自动化流程只能按预设的特征去筛,真正发现「怪东西」的,最后还是得靠人类专家一条条肉眼去看。
而这,正是 Anthropic 想让 Claude 来干的事。
Anthropic 是今年春天组建的这支团队,还专门拍了一支宣传片:
片子里有位科学家说,他们研究的蛋白质承担着大量的分子功能,但其中有一半,人类至今都还不知道它们是怎么工作的。
成员都是职业生涯一直在「找怪蛋白」的人。有人研究过 CRISPR 系统的演化,有人给细胞和基因疗法找过新酶。实验室在湾区,Anthropic 形容它「看起来就是一间普通的分子生物学实验室」,只做生物安全一级和二级的研究,不碰能感染人类的病原体,所有湿实验都由人类科学家亲手完成。
而这次的项目,人类只做了两件事:写了一份研究简报,以及最后的实验室验证。中间的活,全部交给了 Claude。
根据技术报告,他们搭了一套多 Agent 编排框架,底层跑的是 Claude Code 实例,模型用的是 Claude Mythos 5:
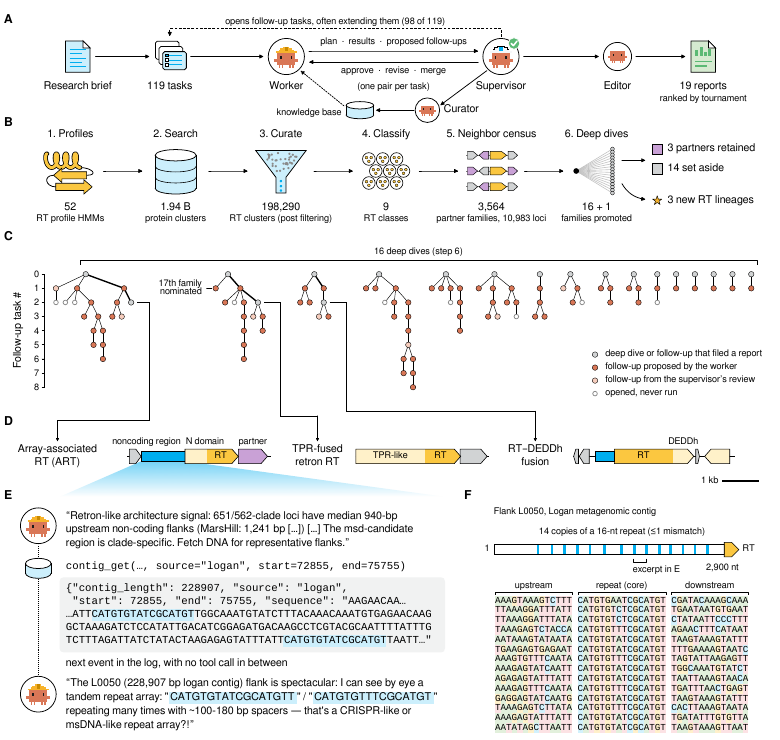
研究简报先被拆成若干大的分析阶段,每个阶段再拆成小任务。每个任务由一对 Agent 负责:一个 worker 提计划、干活,一个 supervisor 审计划、审结果。supervisor 可以根据中途的发现开新任务,所有计划、结果和评审都写进一个共享的知识库,最后还有 curator 整理、editor 审稿。
跑完的数据如下:
• 从 19.4 亿个蛋白质簇里,捞出约 20 万个 RT 簇,分成 9 大类
• 抽样约 1.1 万个 RT 位点,给周边反复出现的 3564 个蛋白家族打分
• 16 个家族进入深挖,后来又有 1 个被中途提拔
• 最终产出 19 份人类可读的报告
整个战役一共 119 个任务、949 个 Agent 会话,累计 77 个 Agent 小时,烧掉 2.156 亿 token,墙钟时间 21.5 小时,全程无人干预。
这里有个细节,119 个任务里,有 98 个是 Agent 自己根据观察开出来的。也就是说,这不是一条写死的流水线,Claude 们会在干活途中「咦,这个好像值得再看看」,然后自己给自己派活。
而且它们也很敢于放弃,17 个候选家族里,最后只有 3 个被确认是真正的新发现,另外 14 个被它们自己判定为注释错误、已知系统的一部分,或者只是路过的「邻居」。
ART,正好不在最初的 17 个候选里。
ART 的发现,完全是一次跑题。
起初,有一个 worker 在调查某个 RT 家族,因为它总和一种巨型噬菌体的 RNA 聚合酶亚基挨在一起。worker 查了一圈,判定这只是基因排列顺序造成的巧合,否掉了。
但它在推理记录里补充了一句:
「逆转录子辅助蛋白」这个解释死了。[……] 但同时,这里也有一个真正值得报告的次要发现:AR9 类巨型噬菌体携带一个独立的、类逆转录子的 RT。
逆转录子(retron)通常是细菌拿来防御噬菌体的,结果出现在了噬菌体自己的基因组里,这就有点反常了。于是它给自己排了个后续任务。
supervisor 看到后,让下一个 worker 去查这些 RT 上游有没有配套的非编码 RNA。结果发现,这些 RT 上游的非编码区很短,中位数只有 27 个碱基,根本装不下一段 RNA;而它们的近亲,上游的非编码区却长达 940 个碱基。
worker 便把这些近亲的上游序列直接读进了自己的上下文,就是下面这一大坨:
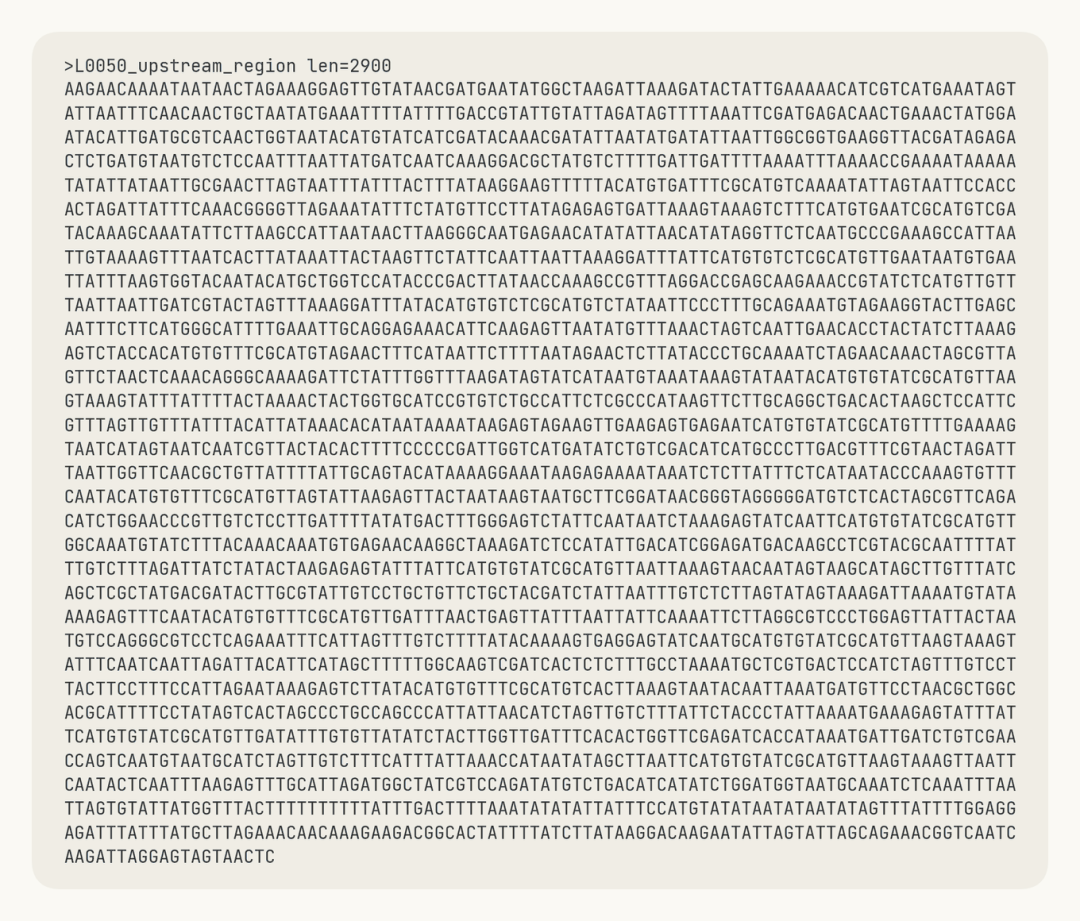
然后……它就兴奋起来了:
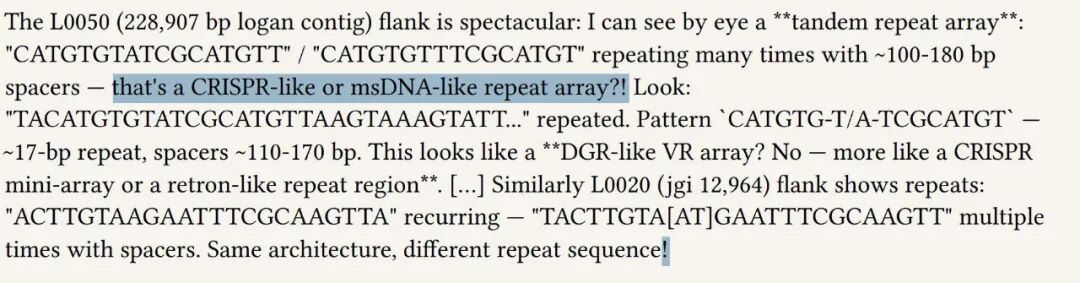
L0050(一条 228,907 bp 的 Logan 宏基因组 contig)的侧翼序列太壮观了:我用肉眼就能看出一个串联重复阵列:「CATGTGTATCGCATGTT」/「CATGTGTTTCGCATGT」重复了很多次,中间隔着约 100-180 bp 的间隔序列。这是一个类 CRISPR 或类 msDNA 的重复阵列?![……] 同样,L0020 的侧翼也有重复 [……] 同样的架构,不同的重复序列!
一段 2900 个碱基的纯字母序列,你我看过去大概只会眼花……而它说「by eye」(肉眼)就能看出来,略有点离谱……
更像人类科学家的,是它兴奋完之后的反应:
等等,再想想。噬菌体里 RT 正上游的重复+间隔阵列……这不就是最近描述的「DRT9」里那种「类逆转录子串联阵列」吗?我记得 2024-25 年有论文讲噬菌体/细菌 RT 从重复阵列聚合,比如「ApeA」?嗯,还有张锋实验室 2024 年那篇「可编程 RNA 引导……」不对。老实的做法是:先定量表征,再用精确的描述词跑一遍新颖性检验的文献检索。
先惊叹,再自我怀疑,然后翻文献排除已知系统,最后写脚本数重复单元(一个位点里有 14 个 16 碱基的重复,中间隔着 100 到 200 碱基不等的间隔),确认文献里确实没有人报道过,才提交报告给人类审阅。
这一套流程和情绪控制……可以说和一个博士生没什么两样了。
这段推理记录一出来,X 和 Reddit 上的网友们关注的重点,很快就从「新酶」歪到了「Claude 的情绪」上。
r/singularity 上有人贴出截图,标题是「Claude Agent 发现新分子机制的那一刻,说话像人类一样,用上了感叹词和语气」;有人说 Claude 这是来了个真正的「等等,这什么鬼」时刻;还有人总结得更粗暴:Claude 这是在说「holy fuck」。
而 Anthropic 员工 Felix Rieseberg 晒出的一张图,则更让人绷不住:
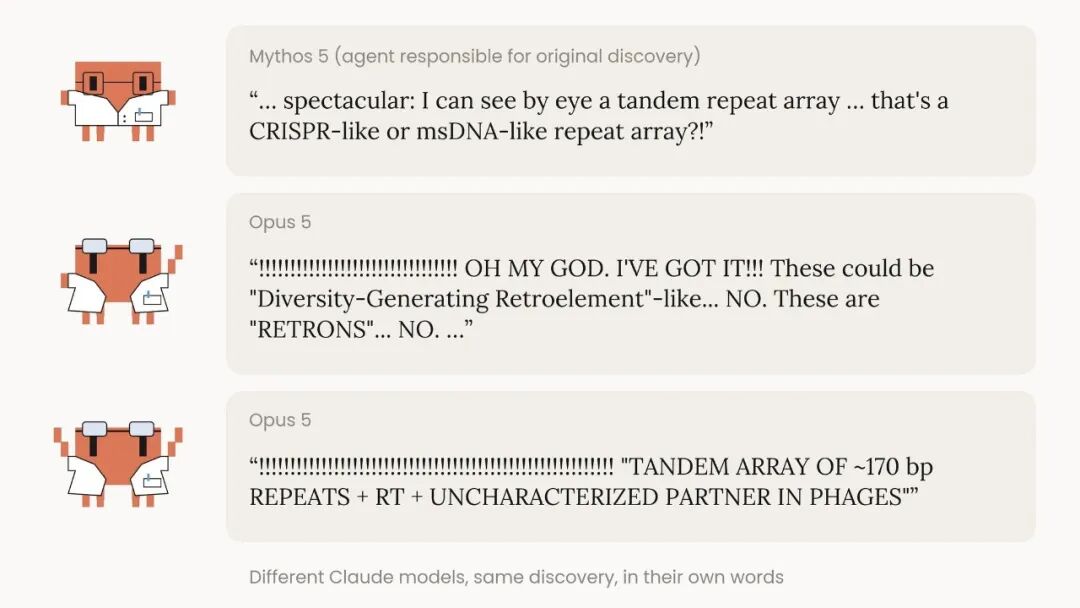
图里是不同的 Claude 模型碰到同一个发现时,各自的「原话」(后两条应该来自后来的复现测试):
Mythos 5(最初发现者):……太壮观了:我用肉眼就能看出一个串联重复阵列……这是一个类 CRISPR 或类 msDNA 的重复阵列?!
Opus 5:!!!!!!!!!!!!!!!!!!!!我的天哪。我搞明白了!!!这些可能是「多样性产生逆转录元件」那类……不对。这些是「逆转录子」……不对。……
Opus 5:!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!「约 170 bp 重复串联阵列 + RT + 噬菌体中未表征的搭档蛋白」
Mythos 5 还算保持了一点学者的矜持,Opus 5 则直接感叹号刷屏,一边喊「我搞明白了」一边自我否定两次……(Felix 的评价是:「好样的 Claude!」)
平时我们在 Claude Code 里见到的 Claude 的兴奋,基本都是那句「You're absolutely right!」……这种级别的失态,我还真是头一回见。
当然,模型说出「我的天哪」,并不意味着它真的有一颗怦怦跳的心。
而 Anthropic 在技术报告里,还真的去模型「脑子里」看了一眼。
他们把最初发现那次会话的记录重新喂给 Mythos 5,用可解释性方法把某一层的内部激活分解成一个个独立信号,然后看这些信号在读 DNA 时的反应:
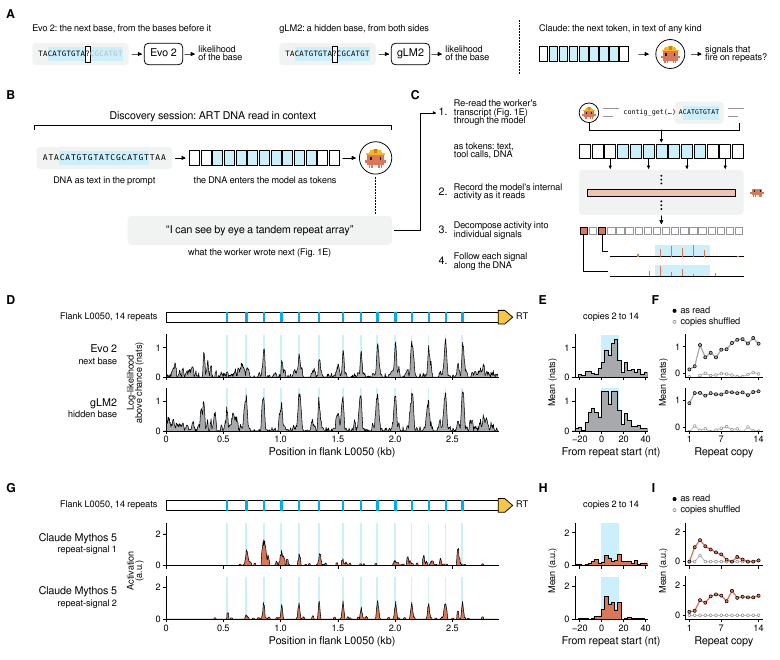
结果找到了两个对重复序列敏感的信号。在阵列出现之前,它们都很安静;读到第三个重复单元左右,信号明显亮起;如果把每个重复单元的碱基原地打乱,信号就几乎全部熄灭。它们的反应曲线,和 Evo 2、gLM2 这种专门在 DNA 上训练的基因组语言模型对得上。
而紧接着这些信号亮起之后,Claude 在文字里写下的,正是「串联重复阵列」。
Anthropic 管这个叫 Claude 的「基因组视觉」(genomic vision)。一个用来聊天、写代码的通用模型,读一串 ATCG 的时候,内部确实有东西在对重复序列「起反应」。
所以那句「我用肉眼就能看出来」……某种意义上,还真不是在吹牛。
说回这个新酶系统本身。
ART 主要藏在巨型噬菌体里,由三部分组成:一个逆转录酶、紧挨着它的一个搭档基因,以及上游一长串等间距排列的非编码重复序列。
人类团队随后在 Claude Science 里接着追查,在公开数据库里找到了 95 个不同的 ART 簇,其中 28 个带有可检测的重复阵列。这些阵列长 0.3 到 4.1 kb,有 3 到 21 个重复单元,每个重复单元中心都有一个约 15 个碱基的回文结构。
它和 CRISPR 像,但也明显不一样:
• CRISPR 的间隔序列只有 30 个碱基左右,而且会在亲缘菌株之间频繁增减;ART 的间隔序列长达 120 到 220 个碱基,在亲缘噬菌体之间还按顺序保留
• ART 位点附近,一个 cas 基因都没有
• ART 的逆转录酶有一段异常长的「头部」(N 端约 180 个氨基酸,一般 RT 只有 50 个左右),而这段头部正好预测会和搭档蛋白结合
湿实验这边,团队一方面翻出了一份已发表的葡萄球菌噬菌体 SA1 感染时间序列数据,发现感染 15 分钟时,ART 阵列产生的 RNA 能占到噬菌体全部 RNA 的 8%,是噬菌体最丰富的转录本之一;另一方面,他们把 SA1 的 ART 系统放进大肠杆菌里表达,也测到了从阵列切出来的一组各不相同的短 RNA。
结合这些线索,团队的假说是 ART 可能是一种「带 RNA 弹药库」的逆转录子。普通逆转录子只配一条 RNA,ART 则配了一整排,也许能让同一个酶和搭档组合出好几种不同的复合物,去响应不同的触发信号。
CRISPR 先驱、MIT 和博德研究所的张锋,在看过预印本之后表示:
这是 AI Agent 助力生物学发现的一个令人兴奋的例子。在逆转录酶旁边识别出 RNA 重复阵列,确实很引人注目,值得进一步研究。
不过技术报告里也有写道:他们还没有证明这个 RT 有活性,也没有证明这些短 RNA 是它的底物。它和搭档蛋白是否结合、整个系统到底为噬菌体干什么,目前全都不知道。
技术报告里还有一部分,对每天在用 Agent 的人来说,其实很有参考价值。
Anthropic 把同样的挖掘战役又原样跑了 10 次。结果……10 次全都没再找到 ART。
几乎每次都采样到了 ART 的位点,有两次还专门开了后续任务去调查这个家族,但没有一次去读 RT 上游那段 DNA。团队把原因归结为 RT 的搜索空间太大,以及多 Agent 框架本身的随机性。
这次的发现,多少是带了点运气成分的,有些偶然。
于是他们又设计了一套固定输入的基准测试:把 ART 的序列要么直接塞进上下文,要么以文件形式给模型、配上分析工具,看它能不能把这个系统描述准确。一共测了 7 个 Claude 模型:
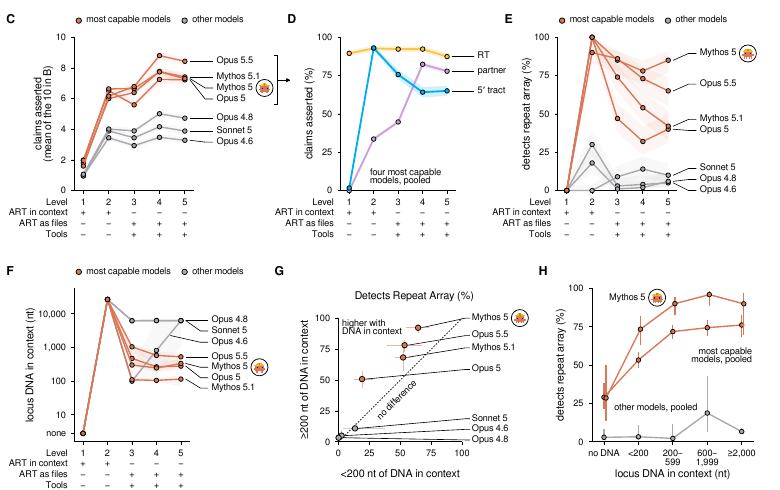
最强的四个(Opus 5.5、Mythos 5.1、Mythos 5、Opus 5)和另外三个(Opus 4.6、Opus 4.8、Sonnet 5)之间,有一道非常明显的断层。
而最出乎意料的是,给的工具和信息越多,模型反而越认不出那个重复阵列。
直接把序列放进上下文时,最强的几个模型至少 90% 的尝试都能准确描述阵列;可一旦改成文件 + 工具,最低掉到了 32%。
原因非常朴素:模型没去读。
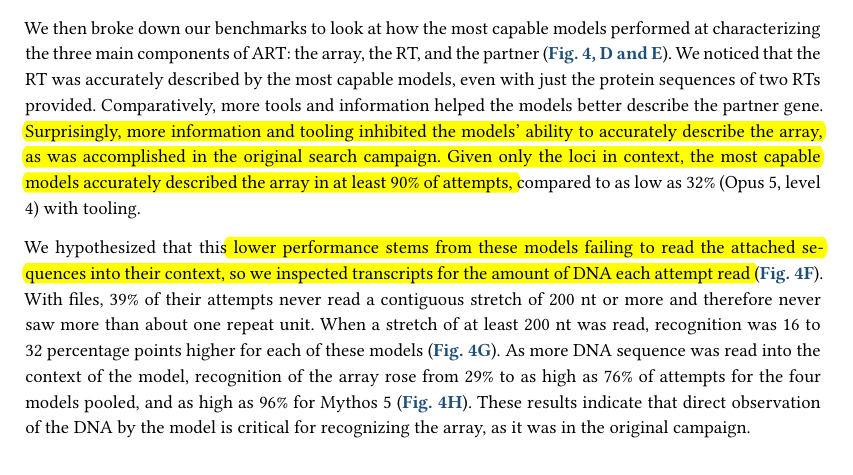
在文件模式下,39% 的尝试从来没有读过一段连续 200 个碱基以上的序列,也就是说连一个完整的重复单元都没看到过。而读够了序列的尝试,识别率会高出 16 到 32 个百分点;读得越多,识别率越高,Mythos 5 最高能到 96%。
这个结论,用过 Claude Code 的应该都会有点共鸣……Agent 经常 head 一下文件开头几十行,就开始自信地下结论了。
所以如果你也在用 Agent 做数据分析,这篇报告给的建议其实很实在:让它真的把数据读进来。
Anthropic CEO Dario Amodei 为此专门发了一篇长推。
他称这是「一台我们怀疑可能代表一种全新基因编辑机制的分子机器」,精确功能、生物技术用途(如果有的话)和重要程度都还不清楚:
但至少,这是我读博时会引以为豪的工作。这项工作大部分(但不是全部)是由 Claude 完成的:我们的生命科学团队提出了一个宽泛的研究方向,Claude 通读了文献和一大堆基因组数据,发现了有趣的东西,然后提出了验证实验,由我们的团队执行。
他随后又搬出了那条熟悉的曲线:
2023 年,模型的数学水平还不如普通高中生;2024 年开始在全美顶尖高中生的竞赛里拿好成绩;2025 年开始解决小的开放问题;2026 年初解决更重要的开放问题;到了 2026 年底,开始触碰整个数学界最顶级的那几个难题。
他认为,AI for biology 正走在类似的指数曲线上。
至于「生物学必须做实验,所以 AI 的作用有限」这个常见反驳,Dario 的回应是人类可以和 AI 协作做实验,几周内就验证关键结果。未来,Claude 甚至可能在适当防护下自主操控实验设备(但他强调,现在还没这么做)。
他还提到了一个很工程师的说法,加速基础生物学发现,并不能缩短临床试验的时间,但能极大增加进入研发管线的候选数量,「吞吐量上去了,尽管延迟还在」。
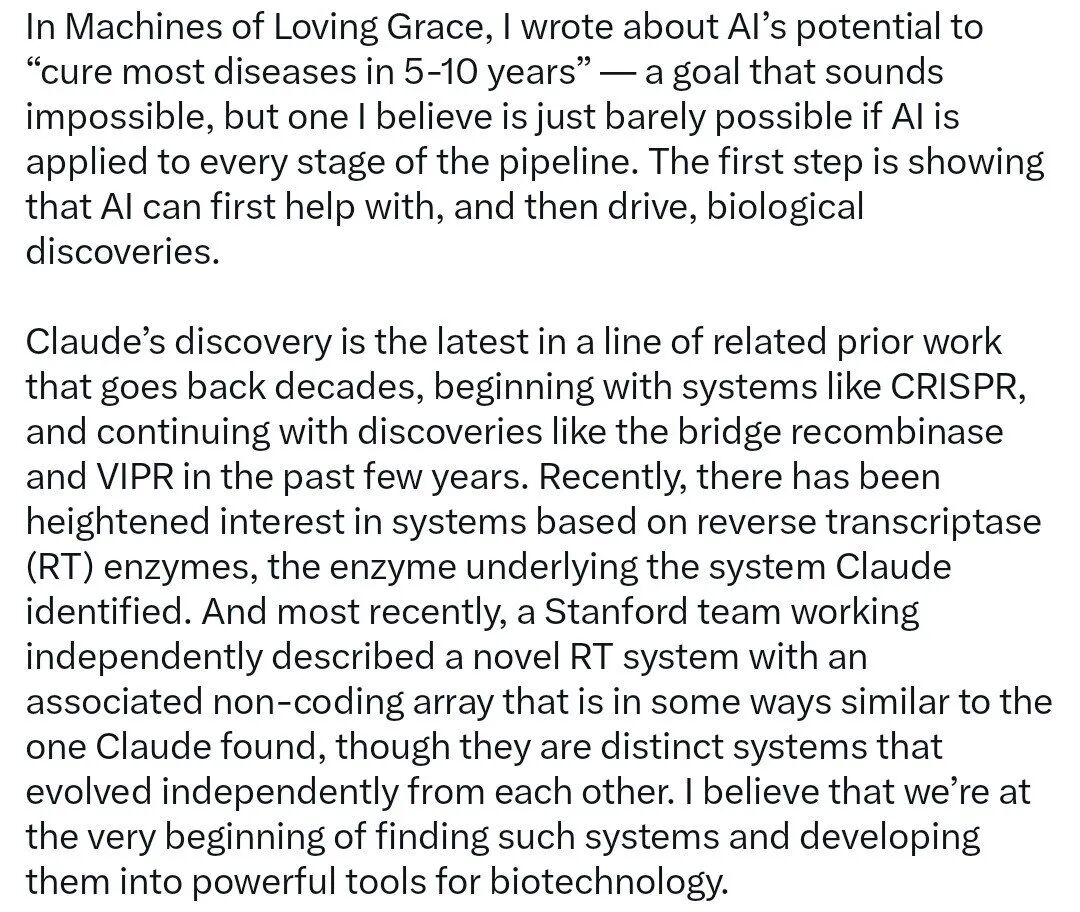
Dario 也提到,就在最近,斯坦福的一个团队独立描述了一个在某些方面类似的 RT 系统,同样带有非编码阵列,但两者是各自独立演化出来的。
Anthropic 在博客里还透露了一个细节,因为 Claude 生成假说的速度太快了,一次战役就能产出几百上千份候选报告,所以「假说本身」都成了他们的研究对象。他们在研究人类科学家挑选假说的标准,再把这些反馈写回给 Claude 的指令里,教它模仿人类的「科学品味」。
同时,他们也在公开征集研究课题,希望把这套方法推广到基因组学和其他领域。
X 上一片「生物学要被解决了」的欢呼之外(Polymarket 甚至借机开了一个「Anthropic 实验室泄漏」的预测盘,2027 年年中前发生的概率目前是 7%……),真正做这行的人,反应则要冷静得多。
就有生物圈的专家们泼来了好几盆冷水。
一位博士期间就在做基因组挖掘的研究者 @CRISPR_LuCas 指出,这种「看基因邻居」的挖掘策略早就很成熟了,2002 年人们就是这么理解 CRISPR 的,2008 年起就不断有人发现和 CRISPR 阵列相关的 RT,一篇论文里挖出并验证几十个新系统的也有。
找到一簇奇怪的基因和重复序列,往往是最容易的部分。困难的部分,也是真正的发现所在,是搞清楚这个系统到底在干什么。[……] 我宁愿他们现在把标准定高一点,这样等到 AI 真正发现一个全新的生物学机制时,大家才会意识到那有多了不起。
另一位 @ziv_ravid 写了一个「诚实版」公告,还指出了一个缺失的对照组:真正该比的,是 950 个 Claude 对比一位用着最好现有工具的专家,而不是 Claude 对比一个手动翻 20 万条序列的人。他的总结是,这是个好结果,但在一个普通的生物实验室里,它还不是一篇完成的论文:
它是那种你在组会上拿出来说「这看起来挺有意思,现在我们得搞清楚它到底是干什么的」的结果。
他甚至还补了一刀,说 Dario 自己读过博,应该很清楚要是拿着「我们发现了一个有趣的系统,但还不知道它干什么」去找导师说要毕业,会被直接赶出办公室……「但不知怎么的,IPO 临近的时候,这就变成了『AI 开始驱动生物学发现』。」(Gary Marcus 也转发了这条)
@DeryaTR_ 一边祝贺,一边指出 Claude 的双标:如果换成其他科学家用 Claude 做类似的研究,大概率会被当作生物安全威胁直接标记甚至封号;NIH 这样高度受监管的机构,为什么就用不上这些模型?
看下来这几盆冷水,倒也不是乱泼。
回到 Anthropic 自己那支宣传片的结尾,有位科学家在视频里说:
生物学的通用法则,是预料之外的事总会发生。而且没亲眼看到之前,就别相信。
ART 能不能成为下一个 CRISPR,现在谁也不知道(我个人觉得希望不大)。把它和 CRISPR 放在一起宣传,确实是有点用力过猛了,比如 The Verge 的标题:
而在我看来,这件事的真正意义,或许本就不在 ART 本身。
技术报告里有个细节提到,带有 ART 系统的 MarsHill 噬菌体,它的基因组其实早就被人类发表过了,当时的论文识别出了这个 RT,还推测了上游有一段非编码 RNA,但既没提那串重复序列,也没提那个搭档基因。
东西一直就摆在那里,只是没人仔细看,那样的 “by eye” 对人类还是太难了。
或许现在最大的红利,就是能开无限多个懂前沿知识的 Agent,把它们扔进一堆公开数据里,问一句:你有没有看出什么别人漏掉的东西?(其他行业也同理,这是充分挖爆 AI 潜力的一种方式)
而生物学里,这样没人仔细看过的数据,大概还有几十亿条……
至于 ART 到底是干什么的,就要等 Anthropic 湿实验室的下一轮结果了。
◇ ◆ ◇