前几天我写了一篇《什么是 Jev?》的文章,把这个「史上采用最快模型」从头到尾介绍了一遍。
文章发布后,有人在公众号后台来问我怎么学习 Jev。我说用 Claude Code 就好,然后对面说号没了,而且连 Codex 也没有,问我还能用什么。我呃了一下……问说那有豆包工作吗?他说有,我说那就用这个。
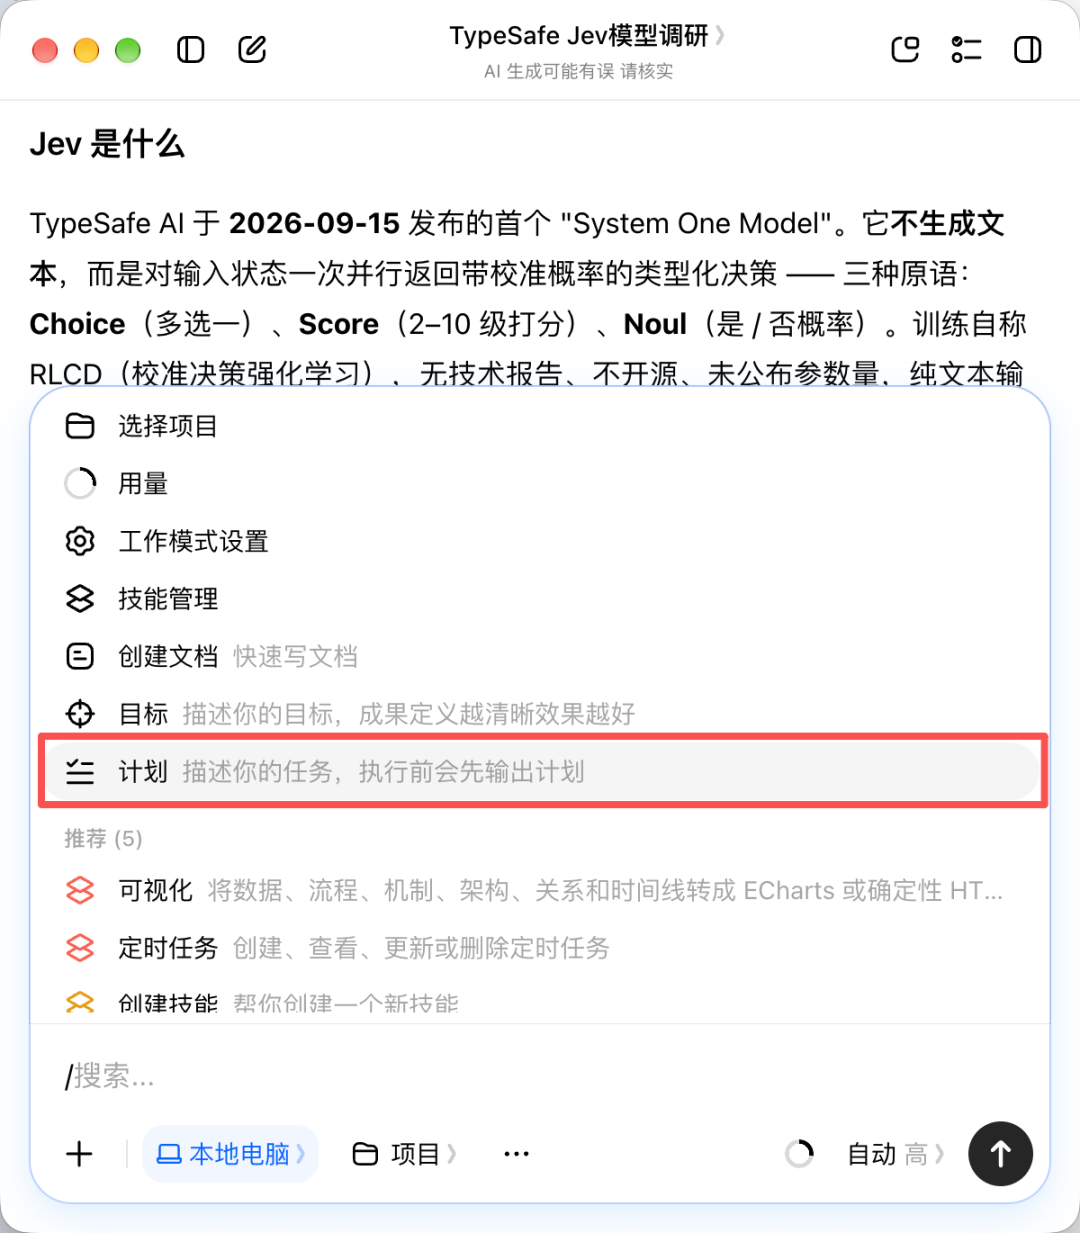
正好,豆包工作又双叒叕更新了,新增了目标和计划两个新模式,在对话框里输入“/”就能看到。加上上周模型也更新了一波,整体能力提升了许多。
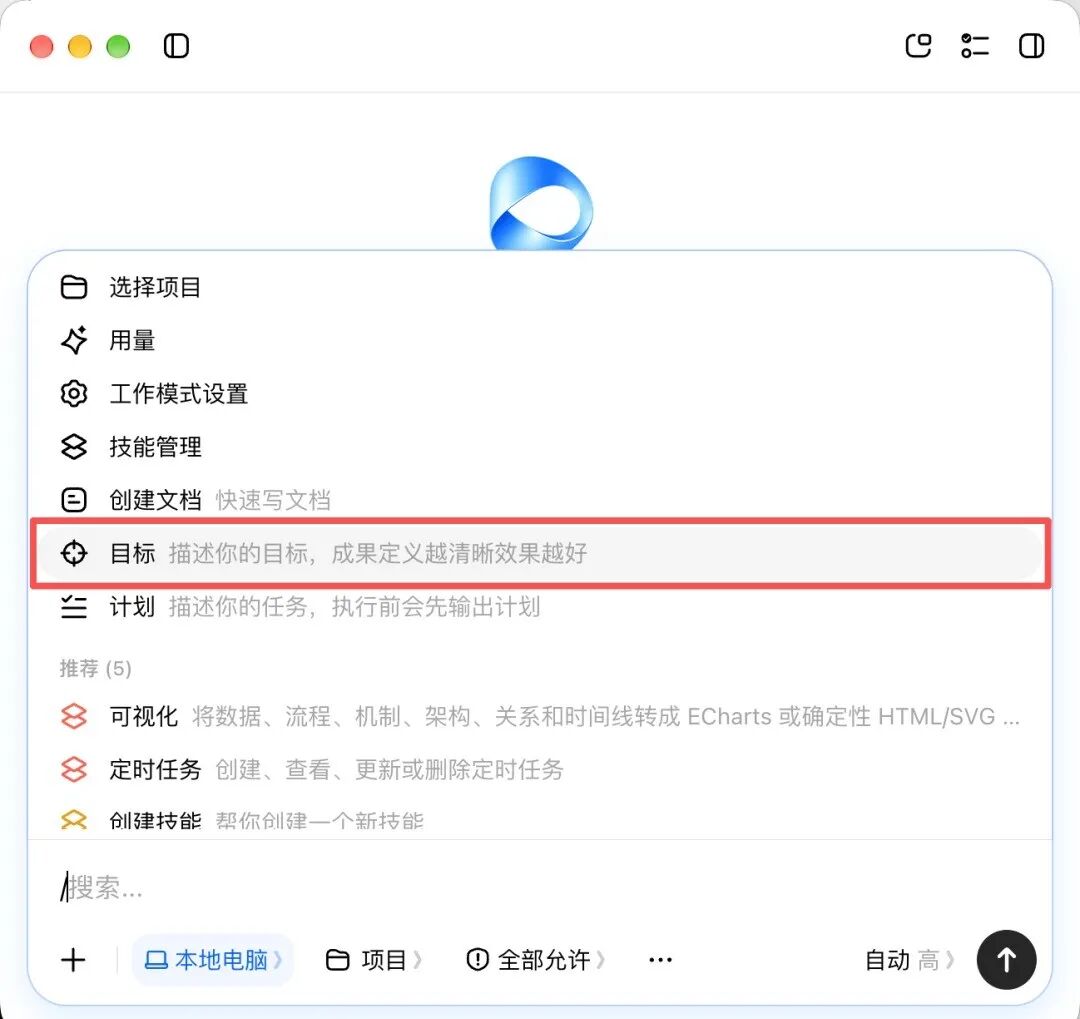
所以这篇就是用豆包工作的目标模式,重新来学习一下「什么是 Jev」,并顺手做了一个 whatisjev 的专属网站。以后请别再就这类问题给我私信了,直接给豆包工作私信就好。
我选了目标模式:
深入调研一下这两天火爆的 TypeSafe Jev 模型,awesome-typesafe 这个开源项目中列了一些官方和社区的资料索引,你还可以自己去挖掘其他官方和社区的最新信息,还可以在 AGIHunt 里去找。最终输出至少要包含以下材料:一份完整的模型调研文档;一份完整的公司调研文档;一份 PPT,汇总调研结果;一个 5 分钟的介绍视频。
目标模式的重点是要把「交付什么」列得足够清楚。我这里要求明确要求了模型文档、公司文档、PPT、视频四个交付结果,这样后面验收的时候 Agent 才有依据可以逐项核对。
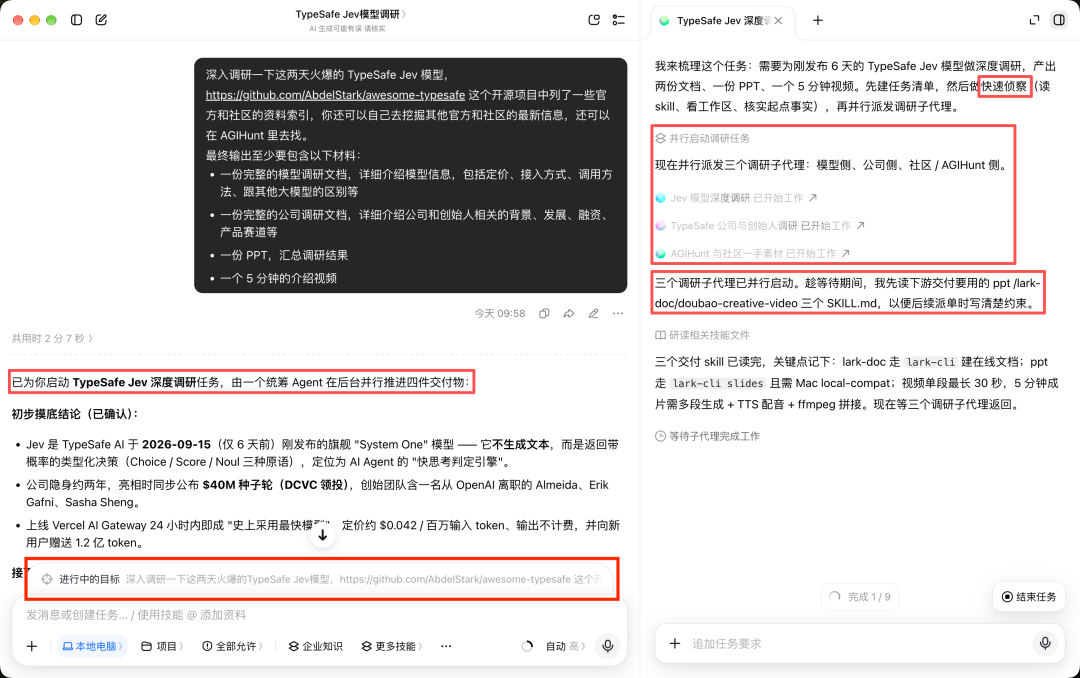
指令发出去之后,输入框上方多了一行「进行中的目标」,会一直挂在那里,任务推进到哪一步、有没有跑偏,一眼就能看到。
它是先回了一版初步摸底结论,Jev 是什么、公司是谁、Vercel 的采用数据,连新用户送 1.2 亿 token 这种细节也都挖出来了。然后给任务起了个名字叫「TypeSafe Jev 深度调研任务」,由一个统筹 Agent 在后台推进四件交付物。
正式开工前,它先是探查了一遍环境,看看手头有哪些 skill、工作区里有什么,核对了一下 Jev 发布的时间点(到那天才 6 天),然后才开始派活。三个子 Agent 同时出发,一个去调研模型,一个去分析公司,一个则去社区和 AGI Hunt 上四处翻找。
而在子 Agent 工作的时候,主 Agent 自己也没闲着,把后面做 PPT、写飞书文档、做视频要用的几个技能都先读了一遍,甚至还记了笔记,比如视频单段最长 30 秒,5 分钟的成片得多段生成再拼起来。
用它自己的话说,是「以便后续派单时写清楚约束」。
三个调研 Agent 陆续返回后,它没有急着写文档而是先做了一件有点细节的事:写了一份「共享事实口径表」(这样能避免不同子 agent 劈叉过度成为猪队友)。
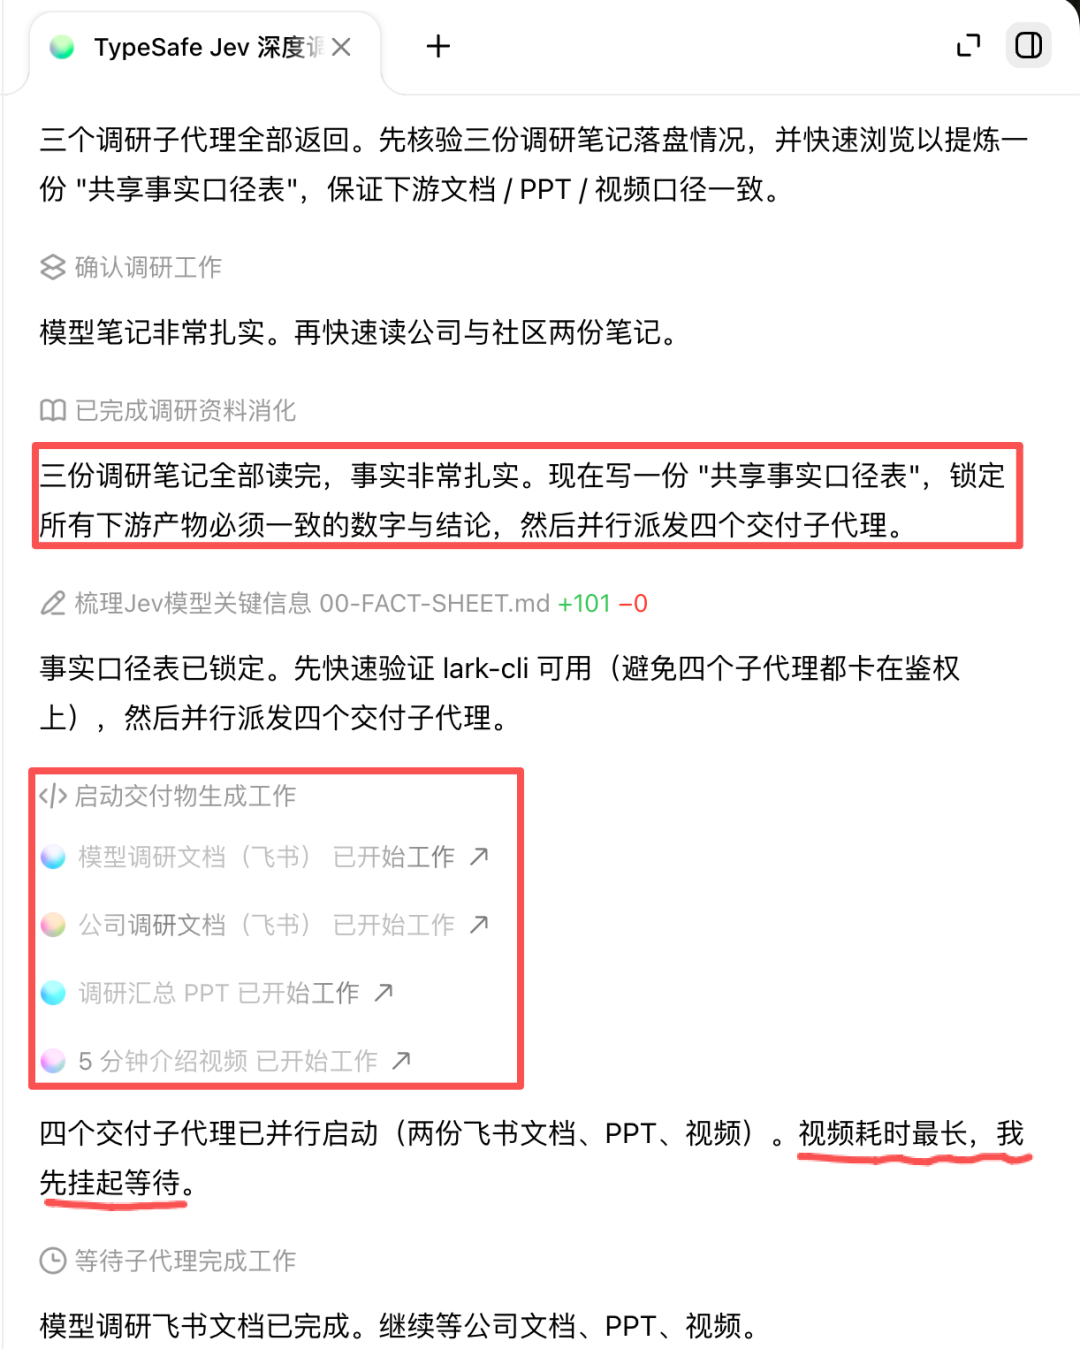
在 00-FACT-SHEET.md 表中记录了发布时间、定价、三种原语的定义、融资金额、创始人名单等信息真相,后面写文档的、做 PPT 的、做视频的,都需要照这里来。
口径表写完,它又快速验证了一下 lark-cli 是通的(避免四个子 Agent 同时卡在鉴权上),一切没问题后,这才派出四个交付 Agent,将两份文档写进了飞书,PPT 一个,视频一个,这样四条线同时开工。
在四个要交付的目标里,最折腾的、甚至还捅了个篓子的,非视频莫属了。
先是 TTS 的配音被限流了,但它也没有干等着,而是先把视频画面的生成跑起来,每批跑两个。同时配音那里也在排队重试还没完成的两段,视频画面和配音交叉并行地推进。
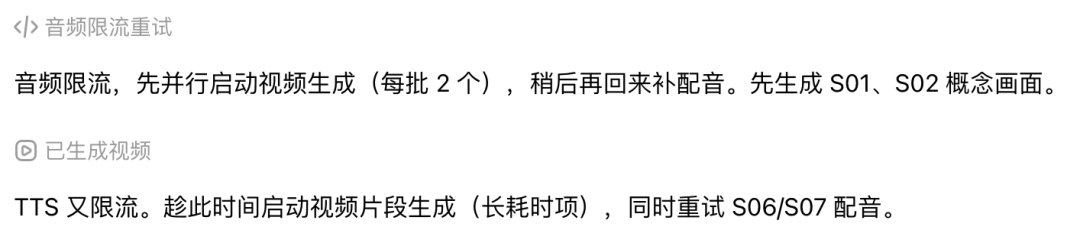
然后……更麻烦的事情来了,Seedance 视频生成的周额度用完了……10 个片段已经生成了,但剩下 8 段没法再继续调用。
它看了一下报错信息,确认是「工具明确不要重试」,于是它给我玩了个大的:思考再三后,它决定改用 ffmpeg 程序化生成了一批科技感的背景画面(渐变流场加颗粒加暗角),这样就不消耗视频额度了,配音则照常通过 tts 生成。
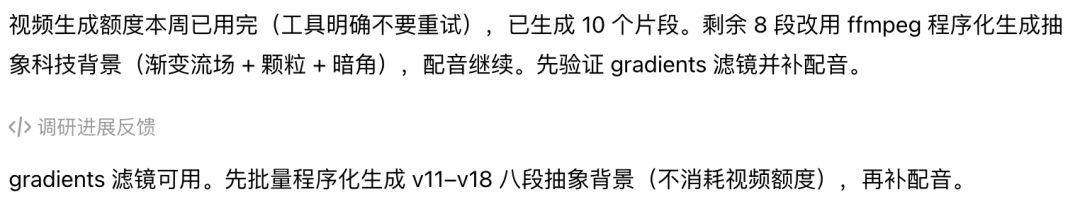
这钢铁式的坚定目标的操作倒是非常的严谨……也让我反思作为下达目标的「领导」,我只写了「做一个 5 分钟视频」,既没提示过程约束,也没给够它资源,这才导致它把 credits 给烧光了。
它的执行力是真的强,额度花光了就自己找替代方案,即使用 ffmpeg 手搓也要把视频弄好……这种锁死目标就坚定执行的那股冲劲,真的让我自愧不如。
所以说呢,做领导还是得把约束说清楚,定好目标的同时也得给够弹药。也幸好我没把钱包给它,否则它要是直接去充值,那我就得亏惨了。
四件交付物终于陆续到齐了。
模型调研报告是一份飞书文档,一共 11 个章节。
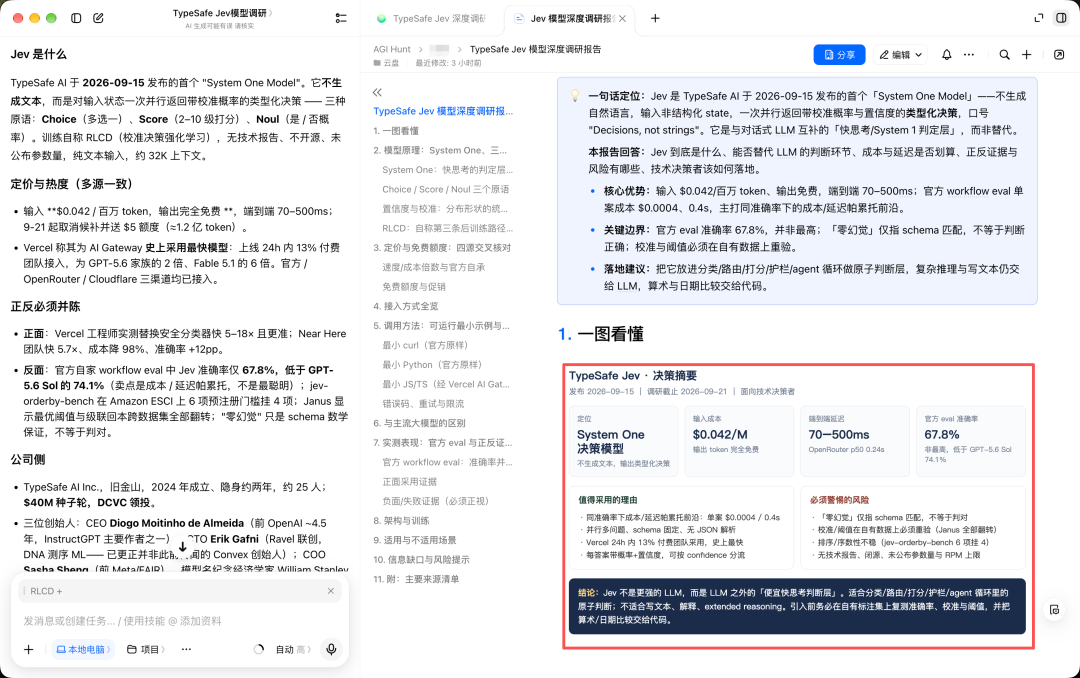
开头是一张「一图看懂」的摘要卡,写明了面向技术决策者。定位、输入成本、延迟、官方 eval 准确率 67.8% 等关键的数字它给摆在了最上面,同时还特意标注了准确率「非最高,低于 GPT-5.6 Sol 74.1%」。
左边一栏是值得采用的理由,右边一栏是必须警惕的风险,还给出了一句话的结论:
Jev 不是更强的 LLM,而是 LLM 之外的「便宜快思考判断层」。
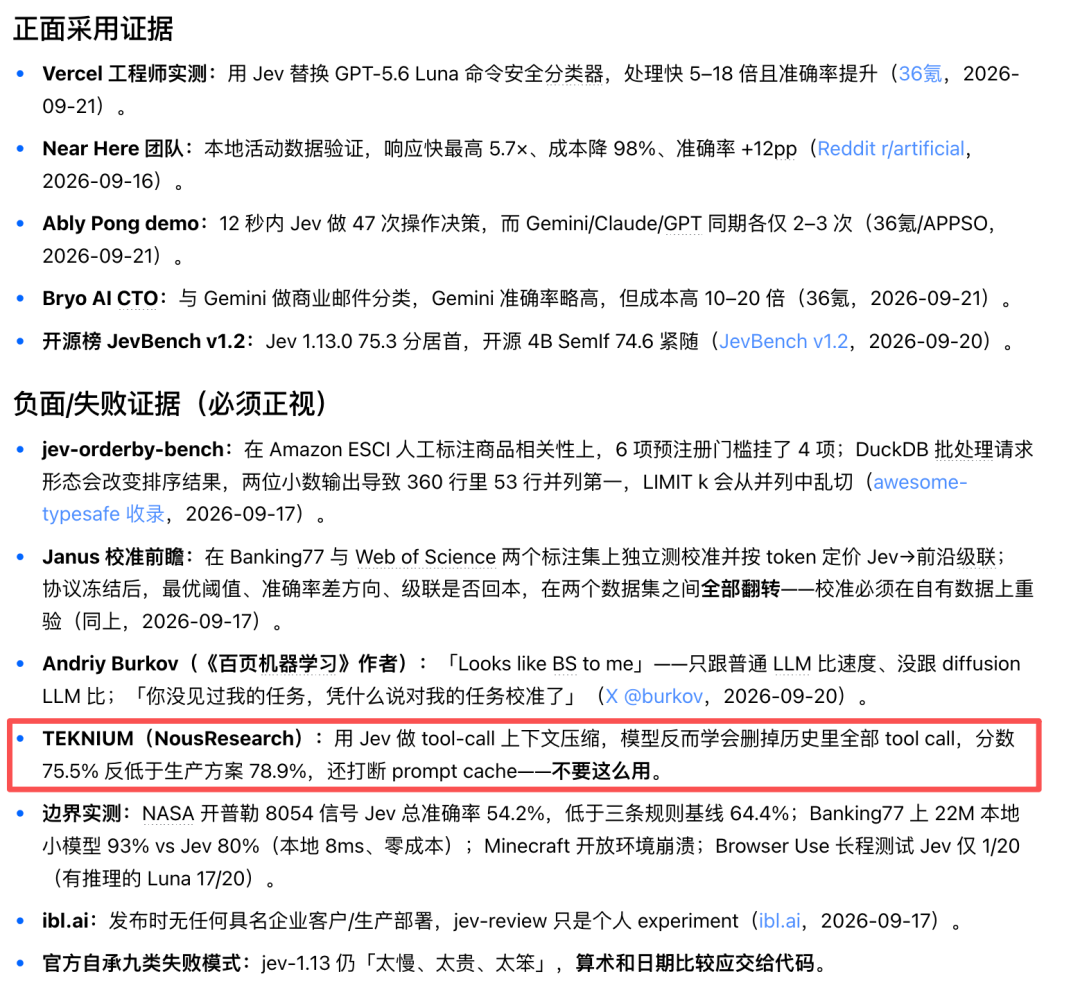
报告里还有一节「正反必须并陈」,既有正面的肯定,也有不足的揭露,且每一条后面都带上了时间和出处。
还有份关于 Jev 公司的详尽的调研报告:
TypeSafe AI Inc. 2024 年成立于旧金山,隐身了约两年,到现在 25 人上下。
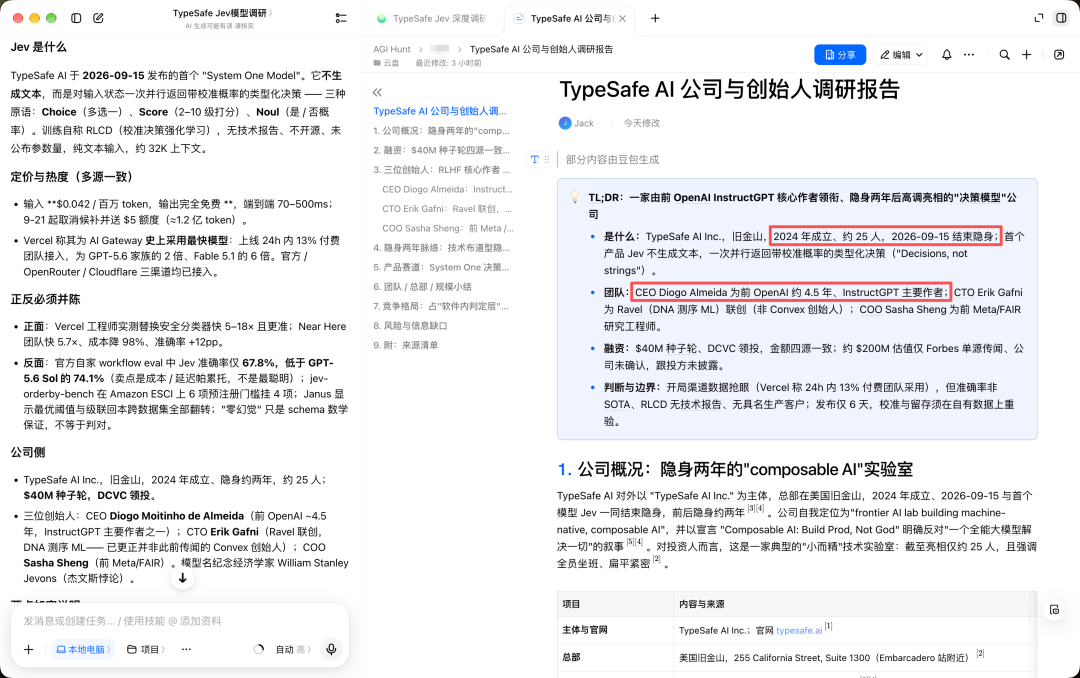
三位创始人里,CEO Diogo Almeida 从 OpenAI 出来,待了约 4 年半,InstructGPT 主要作者之一;CTO Erik Gafni 之前做 DNA 测序的 ML,Ravel 的联创,报告还特意更正了一句,他并非此前传闻的 Convex 创始人;COO Sasha Sheng 从 Meta/FAIR 出来。
融资方面,$40M 种子轮 DCVC 领投,四个信源一致;$200M 估值只有 Forbes 一家在说,标成了「单源传闻」。
模型名 Jev 则是纪念经济学家 Jevons,杰文斯悖论的那位。
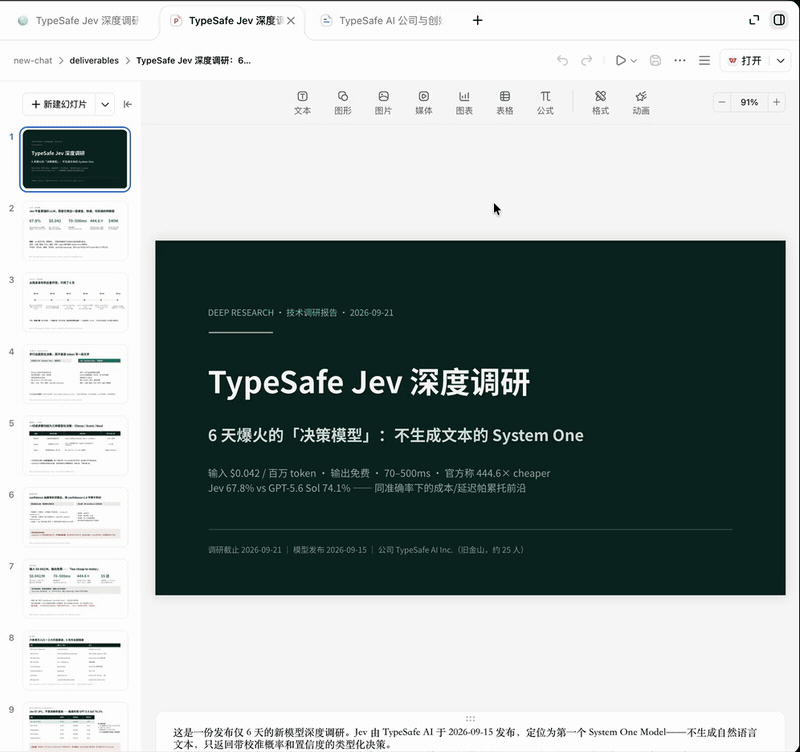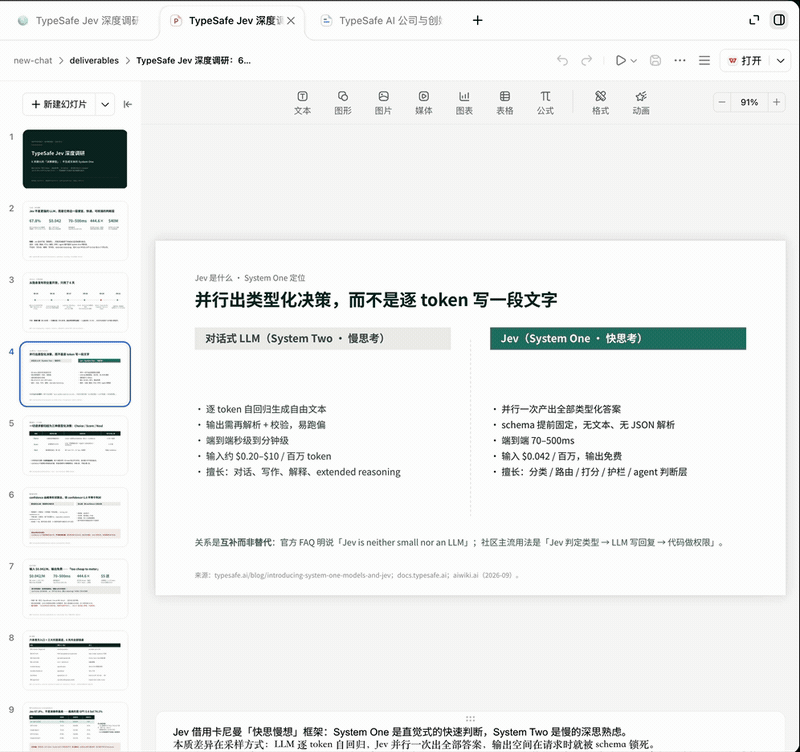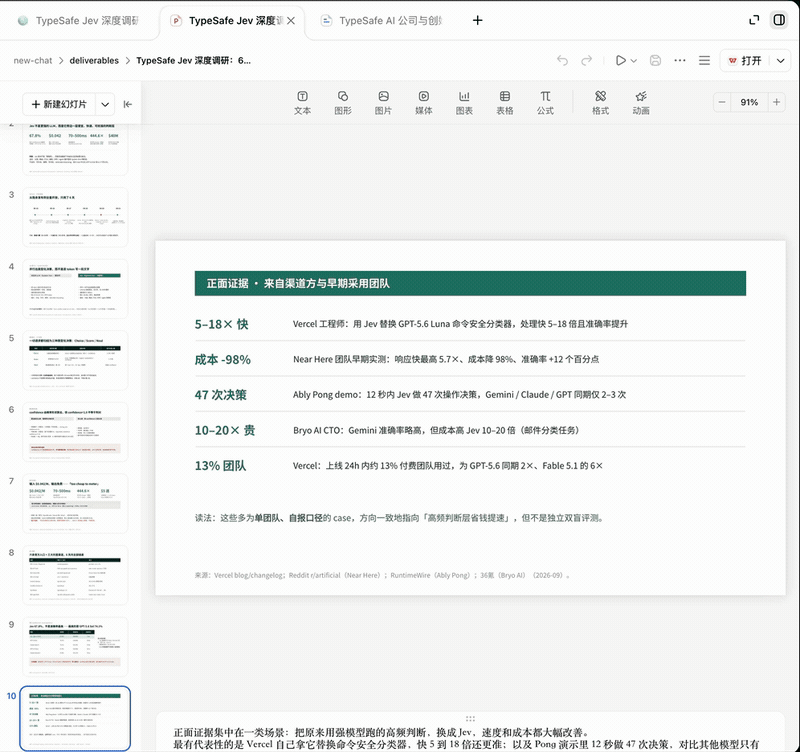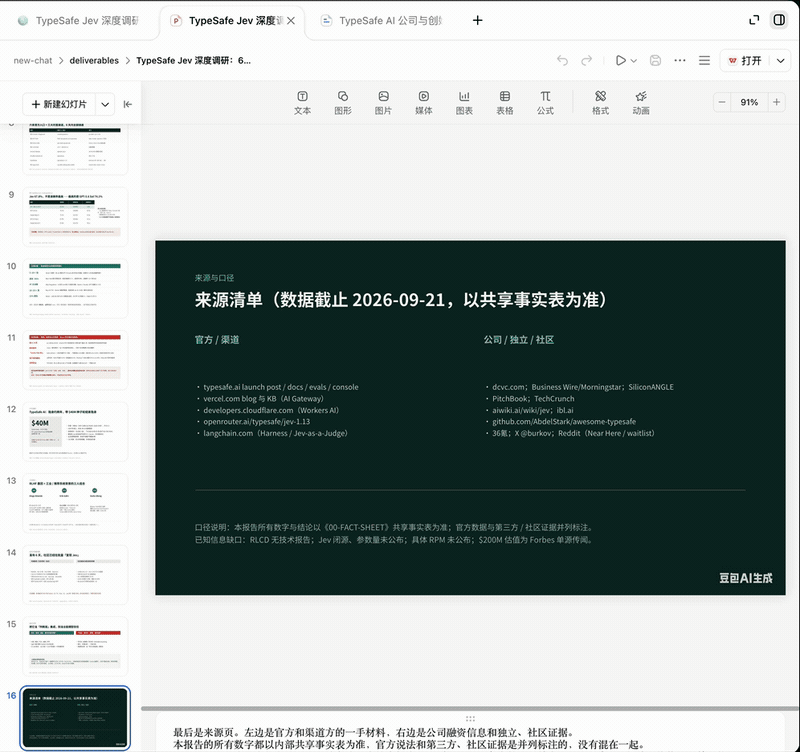
还有份 PPT 的版本,内容也能和报告对上(口径表的作用),数字、对比、时间线都有给出:
视频的配音和口播稿也没问题,画面是 Seedance 生成的科幻风:

调研做完之后的下一个实操性的问题是:Jev 到底好不好用?光看别人的评测还不够,能不能自己跑一下?
于是我切到了计划模式(也是本次豆包工作新升级的功能)。
需求:
编写脚本,实际测试不同场景下 jev 的模型效果,我配置了环境变量 TYPESAFE_API_KEY,你可以直接用。测试覆盖场景至少 3 个,然后你自己准备测试数据,可以用网上公开的或者社区开源的,也可以自己生成。如果需要对比大模型,可以用 deepseek-v4-flash,我配置了 DEEPSEEK_API_KEY。需要对比准召效果、费用、耗时等。
计划模式和目标模式最大的区别在于,它拿到需求之后并不会直接开工,而是先做一轮只读的调研,然后给出一份实施方案。
大约 3 分钟后方案出来了,是一个 .md 文件:
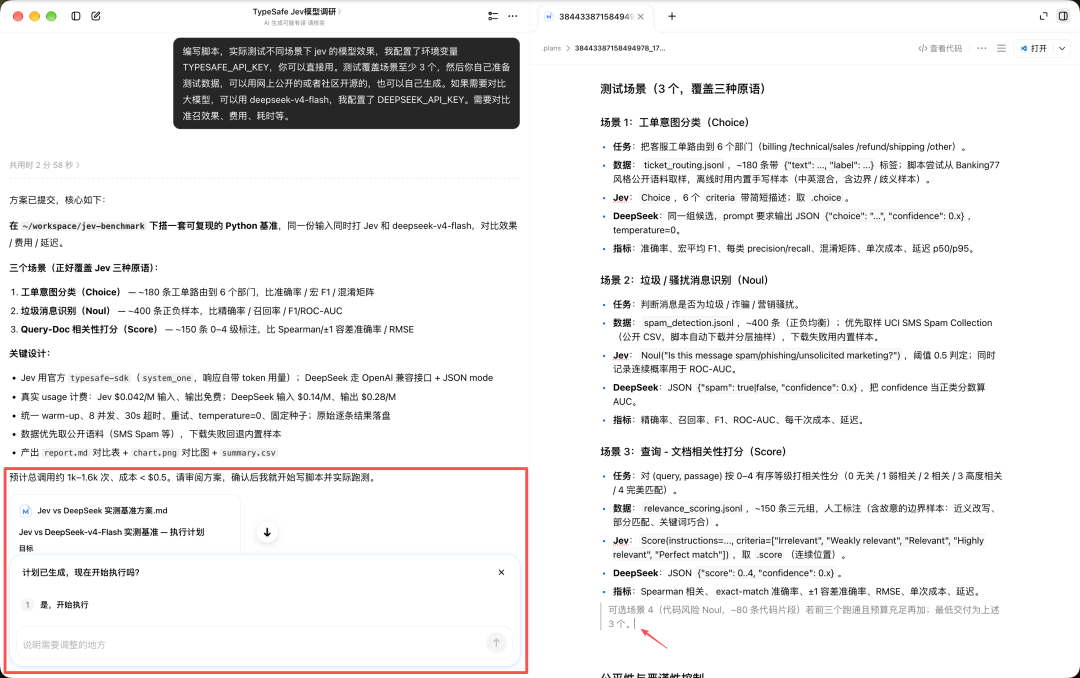
方案把测试分成了三个场景,这样正好能覆盖 Jev 的三种原语。
分别是工单意图分类(Choice,约 180 条工单路由到 6 个部门)、垃圾消息识别(Noul,约 400 条正负样本)、Query-Doc 相关性打分(Score,约 150 条 0 到 4 级标注)。
每个场景都写明了数据来源、两边各怎么调、比哪些指标,连可选的第 4 个场景(代码风险判断)都替我想好了,注明「前三个跑通且预算充足再加」。
方案最后一行还给出了成本估算:预计总调用约 1k 到 1.6k 次,成本 < $0.5。
花钱之前先告诉我大概要花多少,非常好,这下不会把我钱包给干空了。
方案是 .md 格式的,既可以让他继续改,也可以直接手动修改。我从头看了一遍,觉得没什么要改的,直接点了「是,开始执行」。
点执行之前,工作区里只有 .plans 目录下这一份计划文件,底栏的项目还是空的;点了之后,jev-benchmark 这个项目才出现。
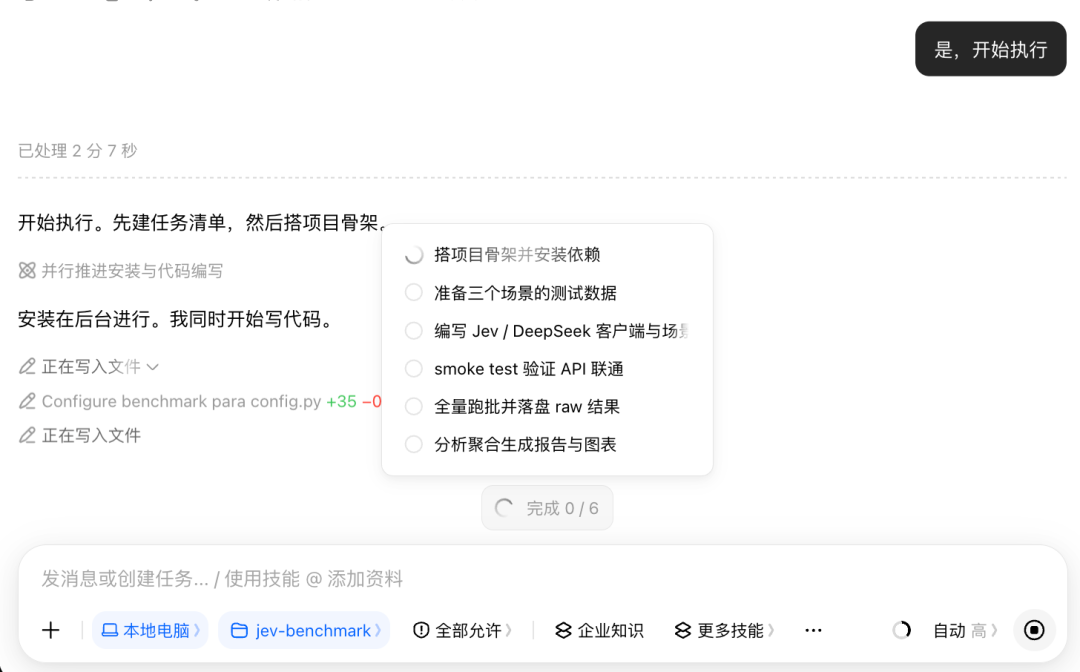
开始执行之后,它先列出了一张 6 步的任务清单(截图里的弹窗),依赖在后台装着,代码同时就开始写了。
跑完之后,三个场景的结果对比如下:
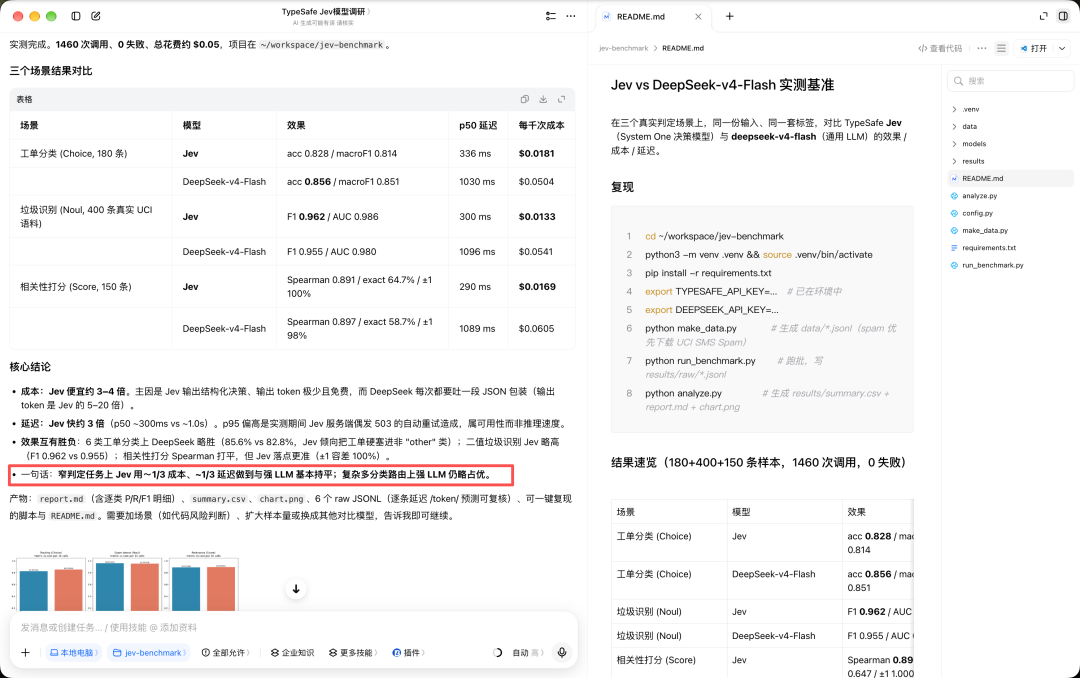
1460 次调用,0 失败,总花费约 $0.05。
预估不到 $0.5,实际只花了十分之一,是真的便宜啊!
结果上则是互有胜负。
工单分类 DeepSeek 略高,垃圾识别反过来 Jev 略高,相关性打分基本平手。
而到了延迟和成本方面,就显然没什么悬念了——Jev 快了约 3 倍,费用只有三分之一到四分之一。
AI 给出的一句话总结是:窄判定任务上,Jev 用约 1/3 的成本、1/3 的延迟做到了与强 LLM 基本持平;复杂多分类路由上,强 LLM 仍略占优。
计划模式的好处就在于,在花钱之前就大约预估出来要花多少,在做动作之前大约就知道可能要做什么。这样可以在开干之前提前 review,以避免把钱花光、方向跑偏、细节不对等问题。
调研和评测都有了之后,我又有了个新的想法:要不索性做成一个网站,方便大家一起学习 Jev 呢?。
我还是选择了目标模式,并且这次的需求写得会多一些(其实是口喷的更久了一些)。
我让豆包工作给 Jev 建一个静态资讯站,要包含模型、公司、创始人、调用方式、实践案例、最新舆论、实践案例等信息,且要有导航、图表和交互。同时我还要求它在前端风格和组件复用我的当前的网站 agihunt.info,要求它做到一致。
并要在最终完成后,部署到我的阿里云服务器,新增解析并使用 whatisjev.agihunt.info 的二级子域名。
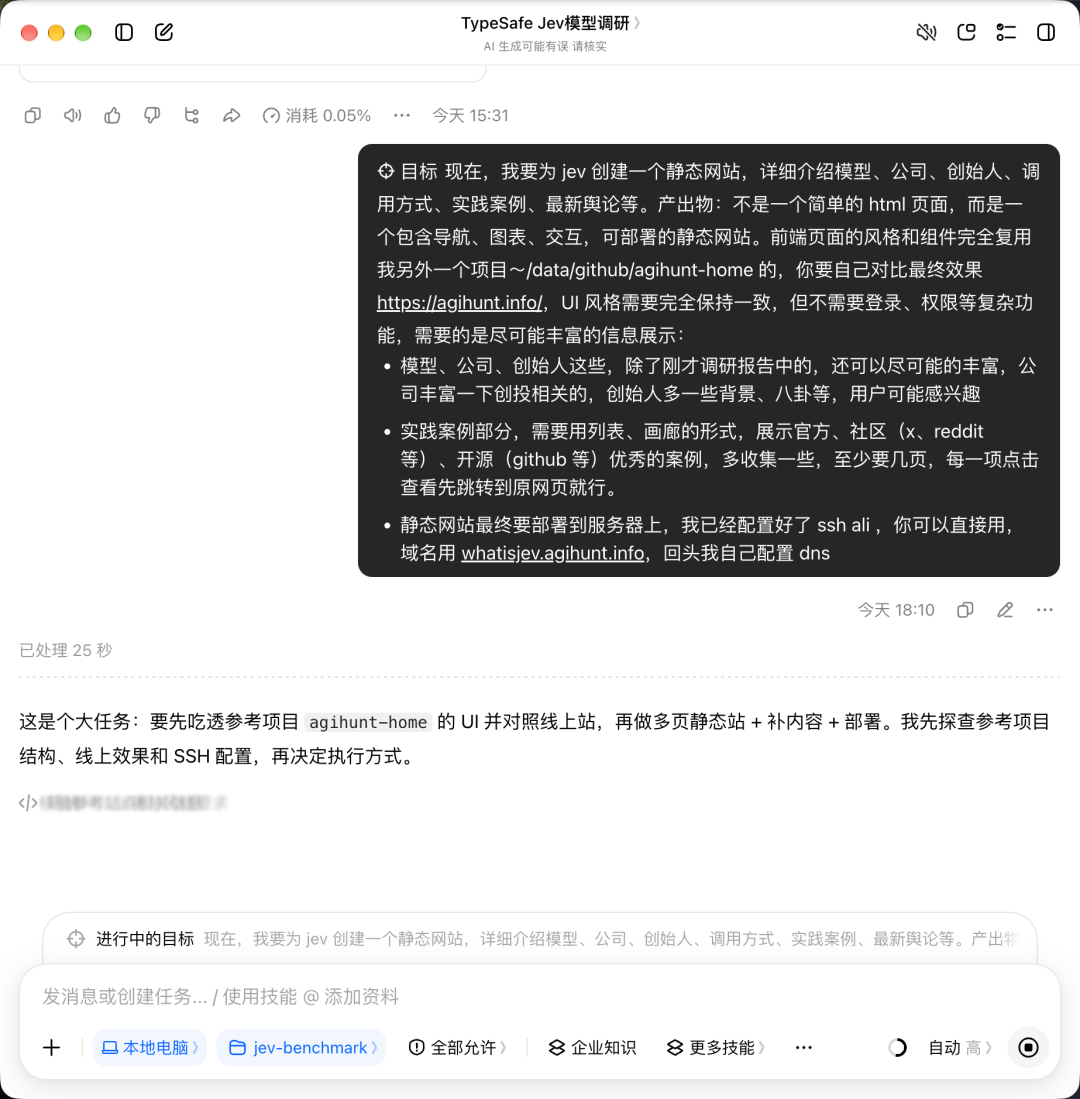
它的第一反应是「这是个大任务,要先吃透参考项目的 UI 并对照线上站,再做多页静态站 + 补内容 + 部署」,然后先去探查参考项目的结构、线上效果和 SSH 配置,再决定执行方式。
a few moments later……
终于,网站做好了(其实我也完全没关注它的制作过程,所以就不介绍了)。
而在交付前,它是自己先验证了一遍,本地 dist 已构建,服务器上 validate 通过,HTTP 请求正确 308 跳到 HTTPS,且原有站点没受任何影响。这样验证通过后,它才跟我说上线就绪了。
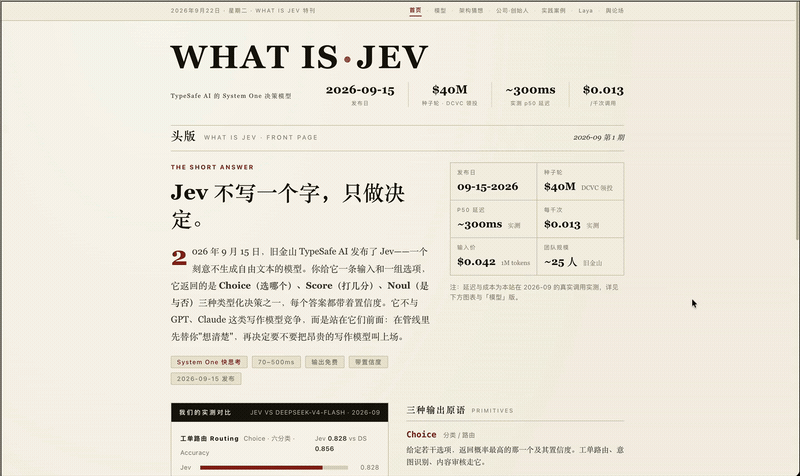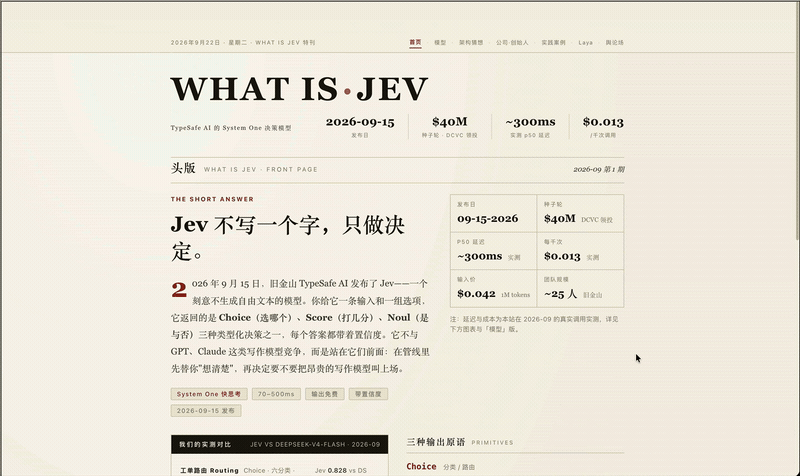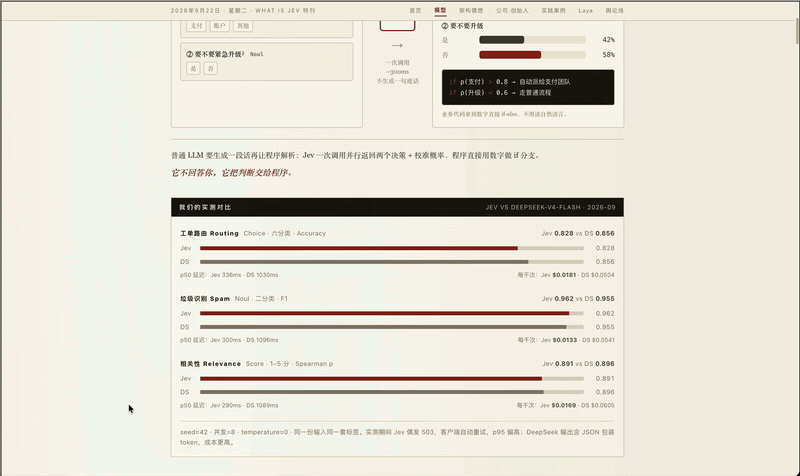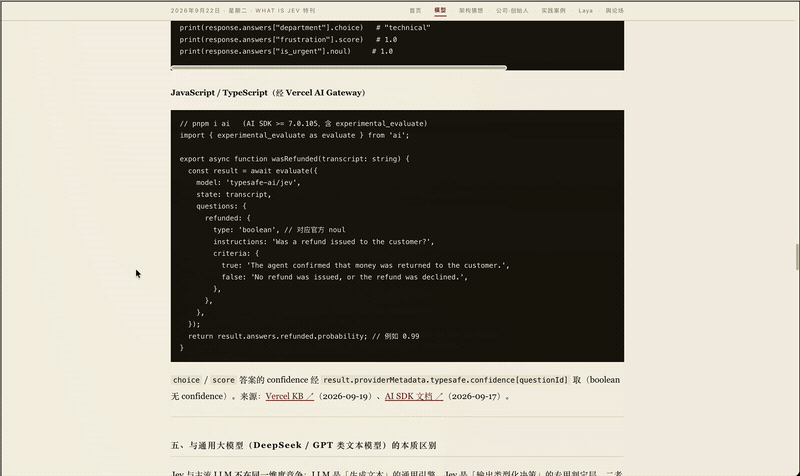
站点一共分五个版面:头版、模型、公司·创始人、实践案例、舆论场,顶部则是一排频道导航切换。
实践案例部分,网站共收录了 52 条,官方 17 条、开源社区 26 条、讨论 9 条,每条 URL 都是用 curl 实测过返回 200 后才放上去的。
舆论场是一条时间线,从 9 月 15 号发布排到 21 号,13 条,正面、中立、质疑用了三种颜色来区分。
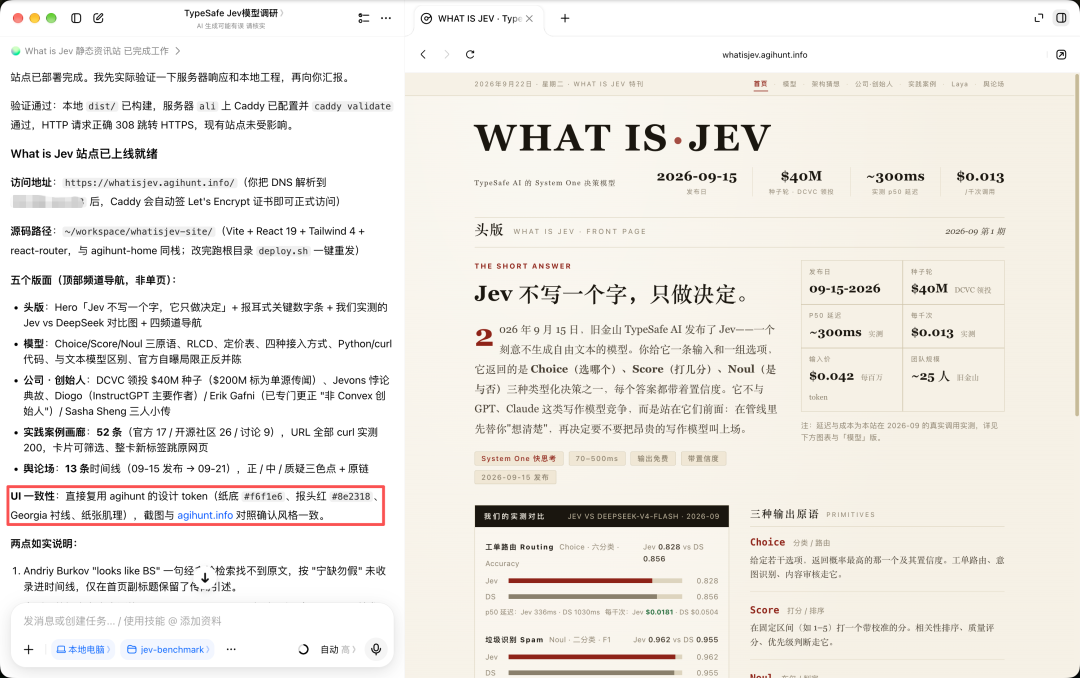
UI 设计上,确实也完美复刻了 agihunt 的设计,纸底、报头红、Georgia 衬线,连纸张肌理也都复刻了。一眼就能看出跟 agihunt.info 是一家人……同样的首页大标题也是它自己参考后写出的:「Jev 不写一个字,只做决定。」
网站地址评论区见。
网站上线后我加了一个需求:
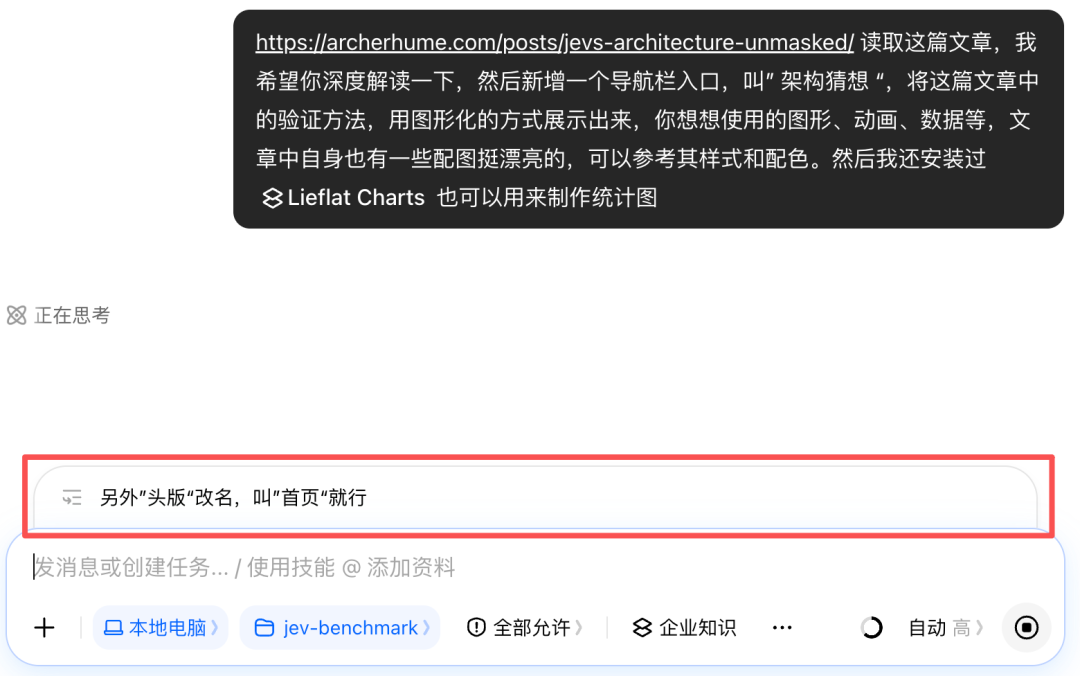
https://archerhume.com/posts/jevs-architecture-unmasked/ 读取这篇文章,我希望你深度解读一下,然后新增一个导航栏入口,叫"架构猜想",将这篇文章中的验证方法,用图形化的方式展示出来,你想想使用的图形、动画、数据等,文章中自身也有一些配图挺漂亮的,可以参考其样式和配色。然后我还安装过 Lieflat Charts 也可以用来制作统计图
但指令刚发出去,我又想到了一件事,首页导航叫「头版」,不太对,改成「首页」就好。但前面那条已经在执行中了,且还没结束。
这时候就是该任务队列上场的时候了,我直接把“另外「头版」改名,叫「首页」就行”的新指令回车发出去后,它自动就排进了指令队列里:
在「架构猜想」做完后,队列里指令便会自动继续开始,在改完导航文案后,两个新需求又一起部署上线了:
甚至做出来的架构猜想页还给做成了个可以播放的交互图,略为花哨了……
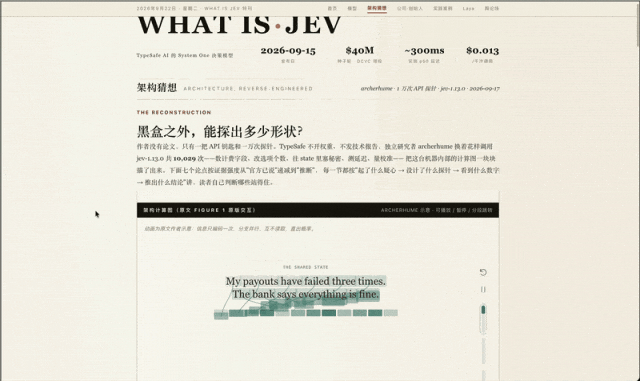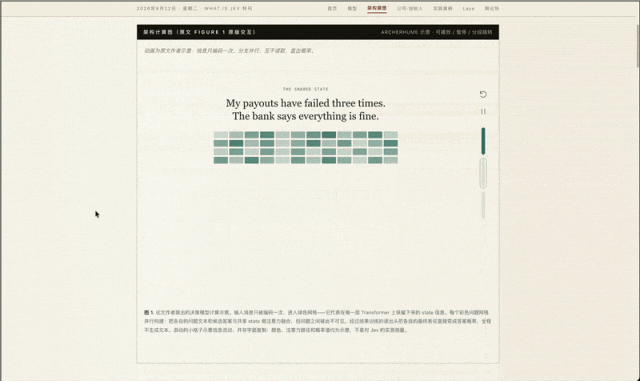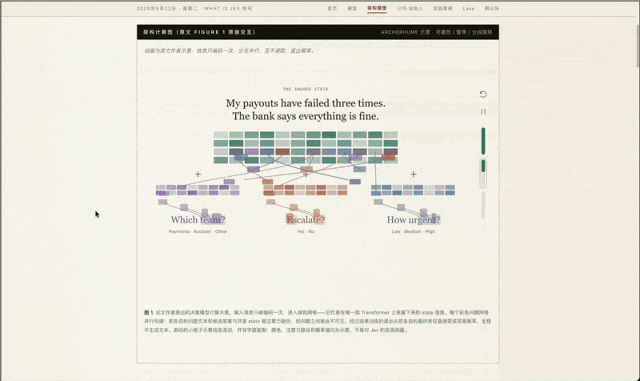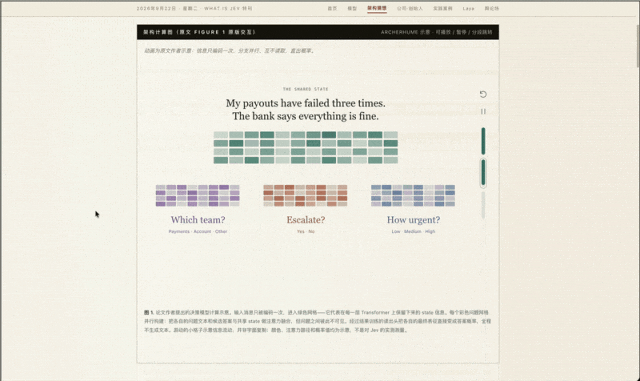
在这个过程中,它还触发了自动压缩(上下文已然太长了),但我倒没什么体感上的信息丢失。
上面的调研过程中,我还看到社区里还有另一个做决策判断的模型叫 Laya,开源且比 Jev 早一年就发布到了 arXiv,并宣称可以本地跑。于是我又开了一个目标模式任务:
看下我本地 mac 能不能部署 laya,如果可以部署一下,然后重新跑一下之前跟 deepseek 对比的那份 benchmark 数据,看下三者的对比数据。然后如果 laya 作者给了他之前的 benchmark 数据集,你可以去本地复测一下,看看是否一致
用时 38 分 43 秒后……结果交回来了。
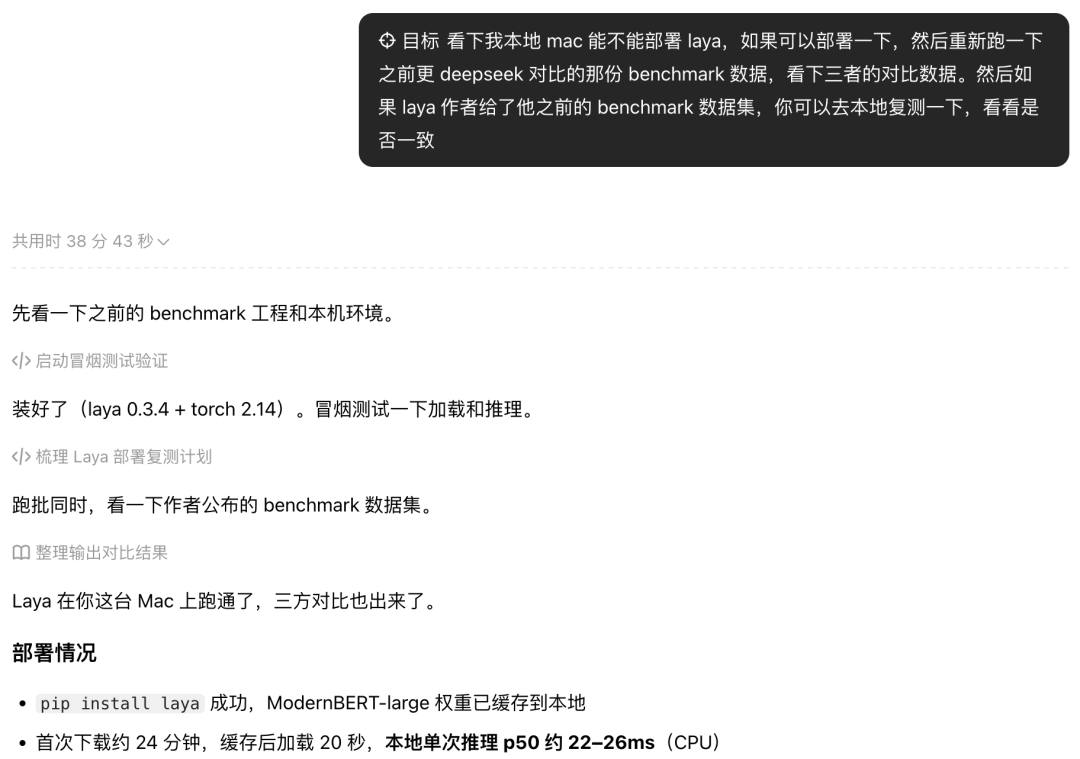
且我这台 48G 的 Mac 能跑得动,于是豆包工作给我 pip install laya 装好之后,用时约 24 分钟下载好了 ModernBERT-large 权重,测试出本地单条推理 p50 时间约为 22 到 26 毫秒,且零成本。
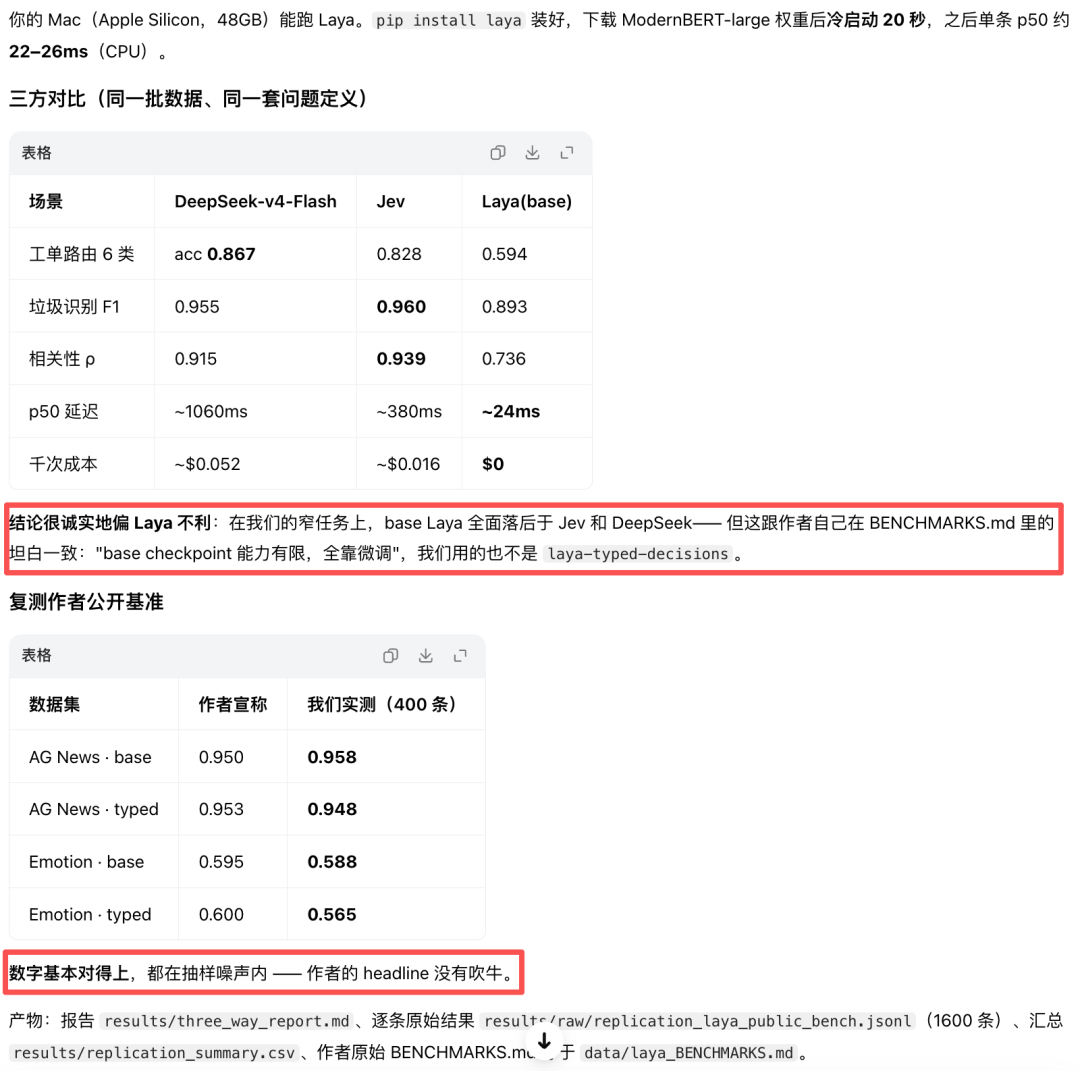
但进一步的三方对比的结果上,Laya 就不太好看了,全面落后于 Jev 和 DeepSeek。唯一的优势就是快……
以上就是我使用豆包工作来学习 Jev 模型的全过程。
包括如何使用它来调研、分析,进行全面的内容收集和整理,并产出报告 PPT、文档、甚至网站等不同形态的内容。
过程中,我用到了计划模式、目标模式,还用到了指令队列的新功能。整体用下来还是非常的丝滑,可以说在绝大多数人的绝大多数任务上,基本感受不到和 Codex 或 Claude Code 的差异,而且使用门槛(网络/账号/钱)和上手成本要显著低很多。
唯一插曲是由于我的锅,一个不小心把我的额度给烧光了……好在豆包工作在 8 月送了一个月的订阅权益后,这次它又来了:会在 9 月再送一个月!
把豆包工作(电脑端)升级到最新版,即可领取。
◇ ◆ ◇