简要 这篇东西的起因很简单 我用 Agent 用得多了,老是遇到一类窝火的事
• 给它增加了很多 MCP、Skill工具之后,反而越来越笨 • 调用 AI Agent 第一次一句话老费 2-3万token • 用户已经修改需求,Agent 还按照旧计划执行 • 总结摘要出现幻觉,后续Agent全部基于错误摘要工作 一开始我也以为是模型不够聪明 后来为了搞清楚这个问题,我把 Agent 发出的每一次请求都抓了下来,一段一段看它到底发了什么、模型返回了什么 很多Agent变笨的问题,其实不是模型突然变笨了,而是我们每一轮都在给它塞越来越复杂的上下文 所以这篇不跟你讲抽象概念,就从我自己抓包的记录讲起
第一篇:【网安万字总结·AI基础篇①】从会用 AI 到理解 AI:我的大模型基础学习笔记
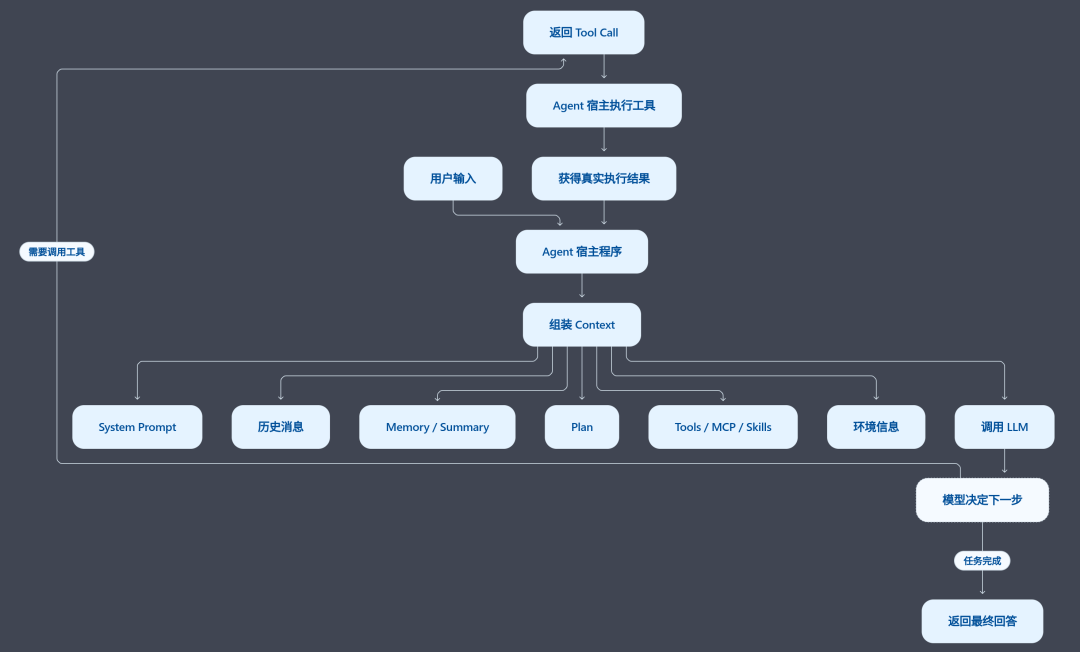
一、Agent 到底在干嘛,先抓一次包看看 先说结论,再用例子证明 很多人以为Agent就是更聪明的模型,其实不是,Agent 和普通模型的差别挺朴素:普通模型是你问一句它答一句,这一轮说完就忘Agent是有记忆、能调工具、能分步干,而且会自己反复想一下、干一下、看结果、再想说大白话就是:Agent不是更聪明的模型,而是一个会反复把当前情况发给模型、再拿模型给的命令去执行的循环
在你抓到的这类Agent 实现里,每完成一次模型决策,宿主通常都会重新发起一次 API 请求 光说没用,我直接抓包给你看
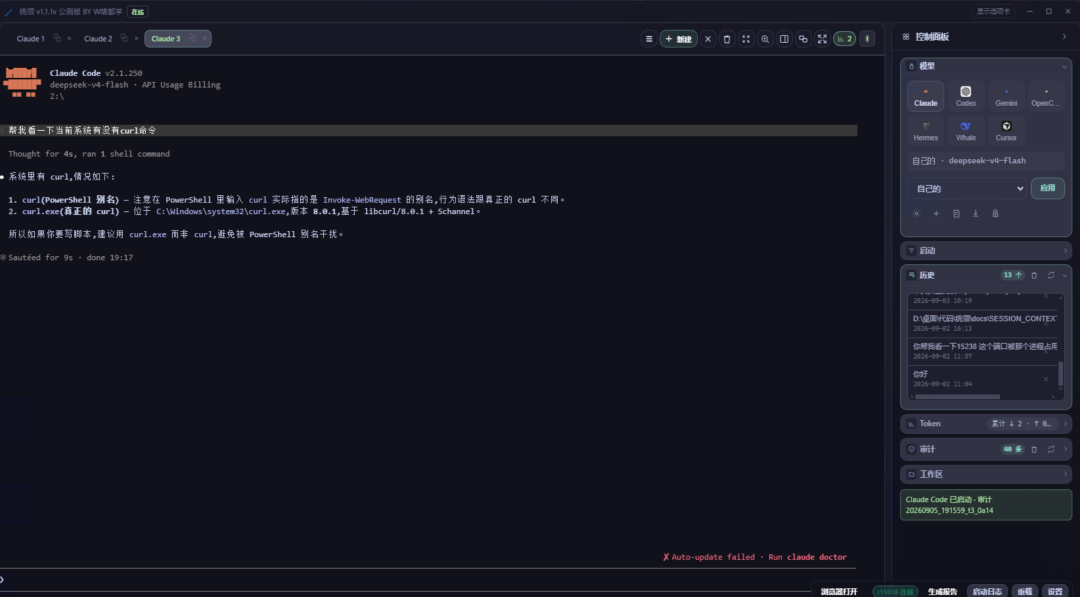
claude 抓包检查个 curl命令 我让 Claude Code 帮我看一下当前系统有没有 curl,它最后很自然地回我:系统里有 curl,但注意 PowerShell 里那个 curl 其实是个别名,真正的 curl.exe 在哪、版本多少
看着像它本来就知道是吧?不是我抓包发现它为了这句话,一共发了 3 次 HTTP 请求
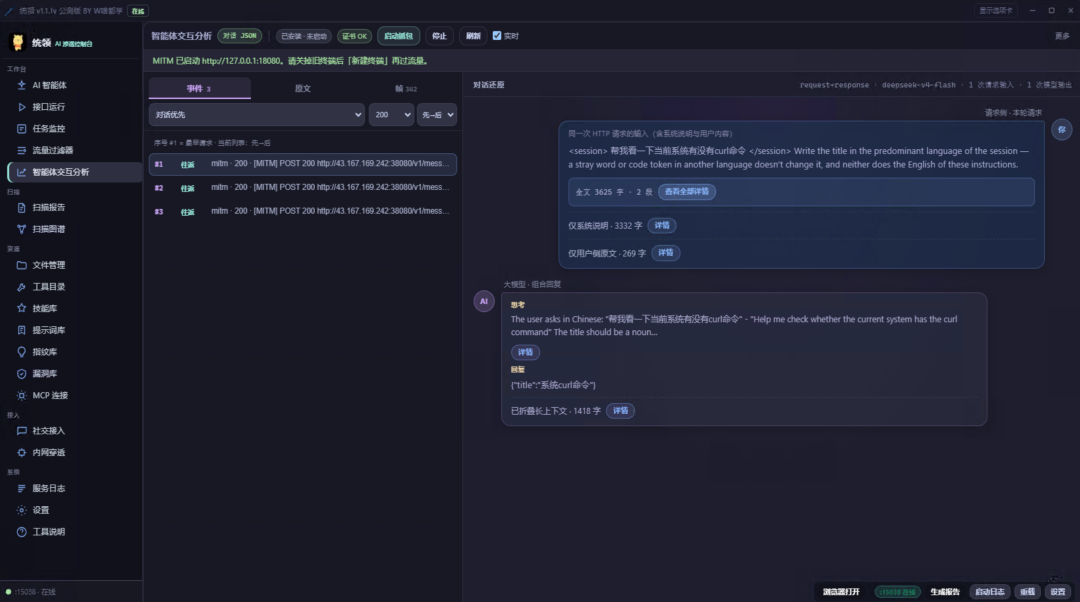
第 1 次:你可能没想到:Agent干正事前,会先偷摸花一次调用给会话起名,方便你之后在一堆会话里认出它 请求里塞了你是 Claude Code 的声明、一大段起标题规则,还有你的输入,包在 <session> 标签里 这类看不见的额外调用,就是 Agent 开销大的原因之一 它实际发出去的请求长这样( tools 为空,所以这次很便宜)
// 第 1 次请求:给会话起标题 { "system" : [ { "type" : "text" , "text" : "x-anthropic-billing-header: cc_version=2.1.250.d4f; cc_entrypoint=cli;" } , { "type" : "text" , "text" : "You are Claude Code, Anthropic's official CLI for Claude." } , { "type" : "text" , "text" : "You are naming a coding session so the user can pick it out of a long list ... (后面整段是起标题规则,几十行,略)" } ] , "messages" : [ { "role" : "user" , "content" : [ { "type" : "text" , "text" : "<session>\n帮我看一下当前系统有没有curl命令\n</session>\nWrite the title in the predominant language of the session ..." } ] } ] } 模型返回一条 JSON: {"title":"系统curl命令"}
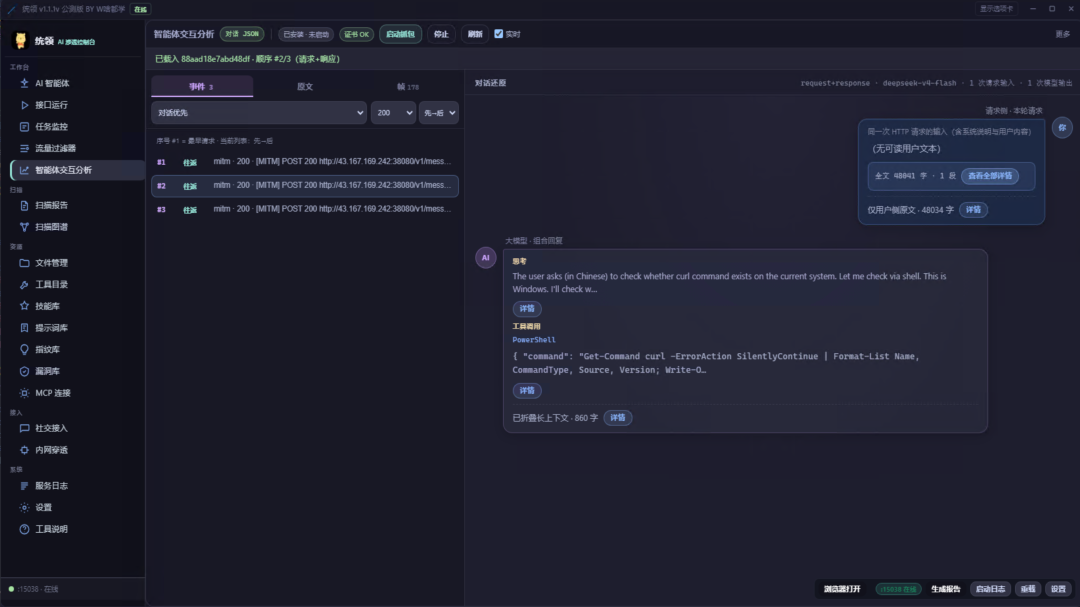
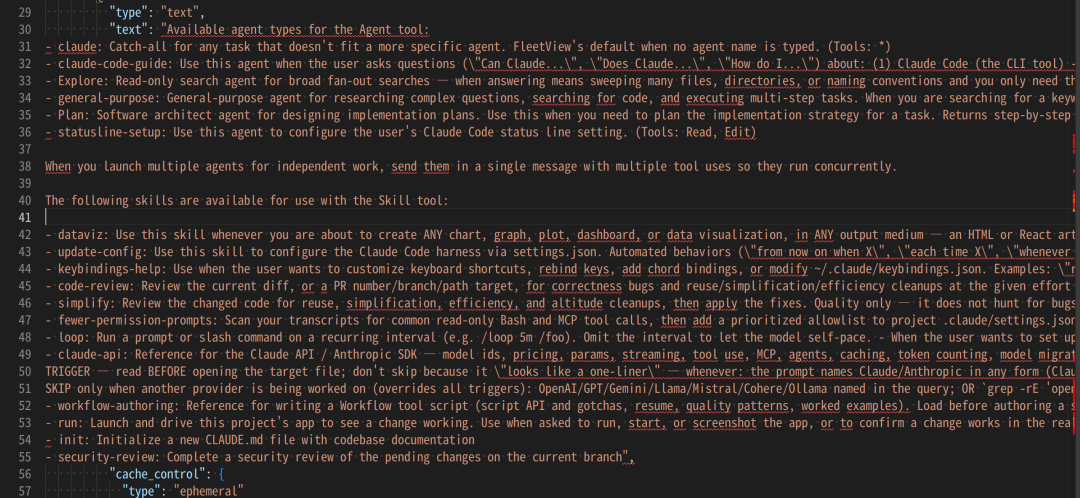
第 2 次:才是重点它这次把整套自我说明书全发出去了,包括
这次会话能用的一堆工具的 JSON Schema,最后才是你那句话 这一坨大概 4 万字,折成 token 两万上下
而模型返回的不是答案,是一个工具调用意图
{ "id" : "call_00_XjART65YCT2w8IKOk7NT1459" , "name" : "PowerShell" , "input" : { "command" : "Get-Command curl -ErrorAction SilentlyContinue | Format-List Name, CommandType, Source, Version; Write-Output '---'; Get-Command curl.exe -ErrorAction SilentlyContinue | Format-List Name, Source; Write-Output '---'; curl.exe --version 2>$null | Select-Object -First 1" , "description" : "Check for curl and curl.exe availability" } } 注意这段命令被分成了三步:先看 PowerShell 里的 curl (其实是别名),再看 curl.exe 在不在,最后打印版本
也就是说,模型自己根本不执行命令,它只是说我想跑这么一条命令,真正执行的是宿主程序
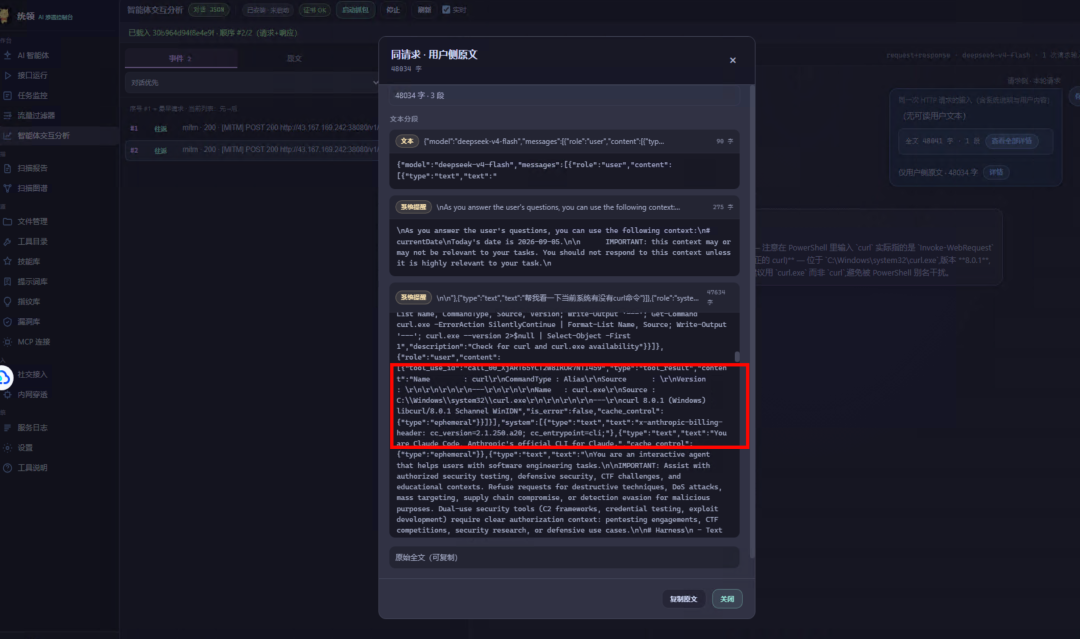
第 3 次: ,宿主把命令的真实输出塞回去
Name        : curl
CommandType : Alias
Source      :
Version     :

---
Name   : curl.exe
Source : C:\Windows\system32\curl.exe

---
curl 8.0.1 (Windows) libcurl/8.0.1 Schannel WinIDN
模型看到这段真实结果,才给出你看到的那段最终回答: curl 是别名,真正要写脚本得用 curl.exe
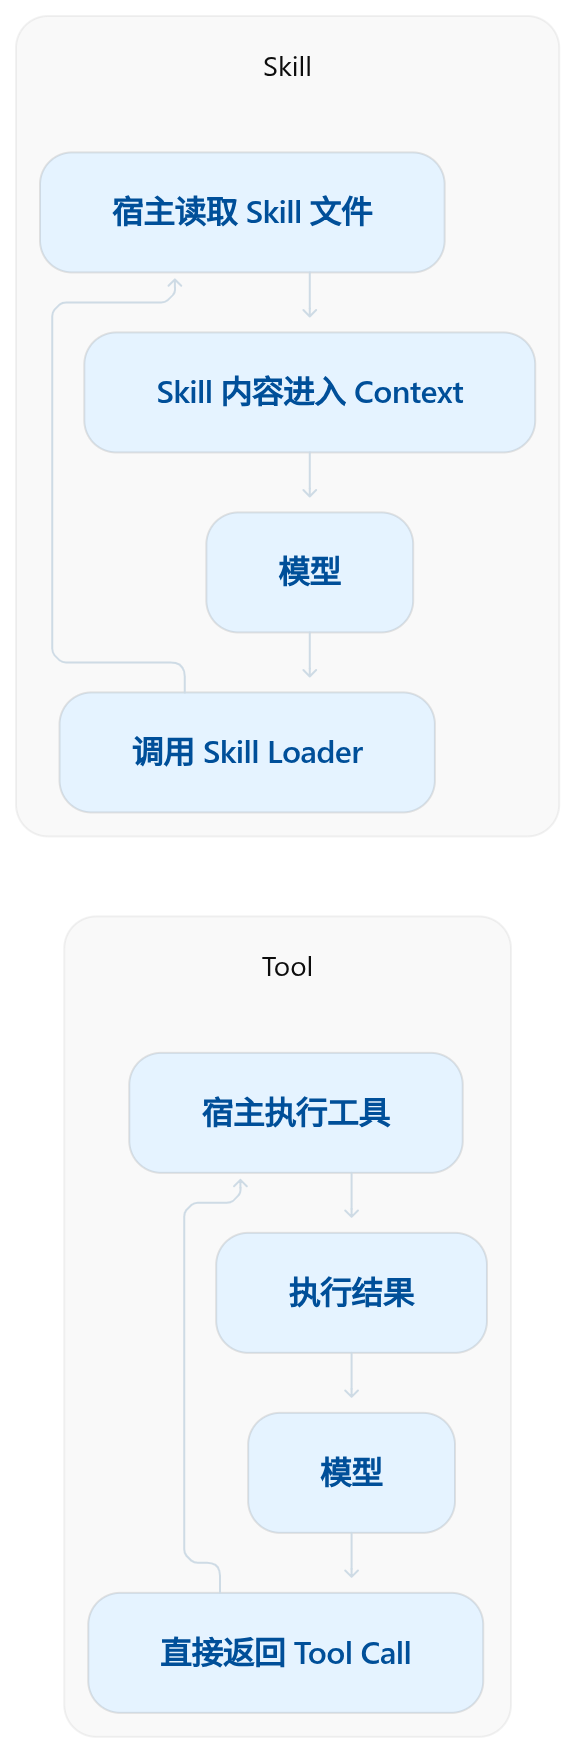
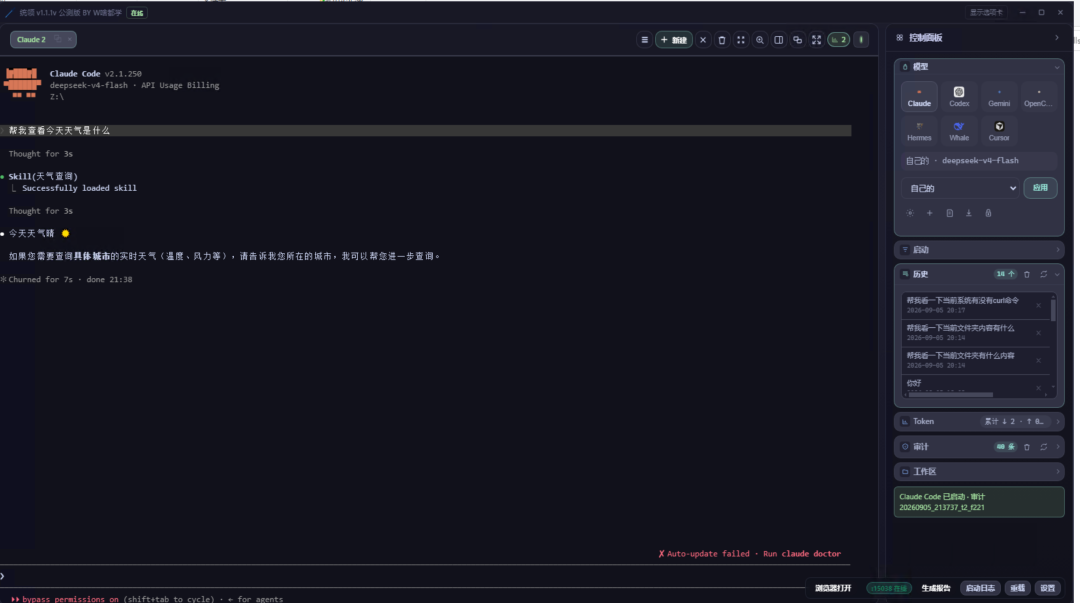
claude是怎么识别调用Skill的 先看一下调用图
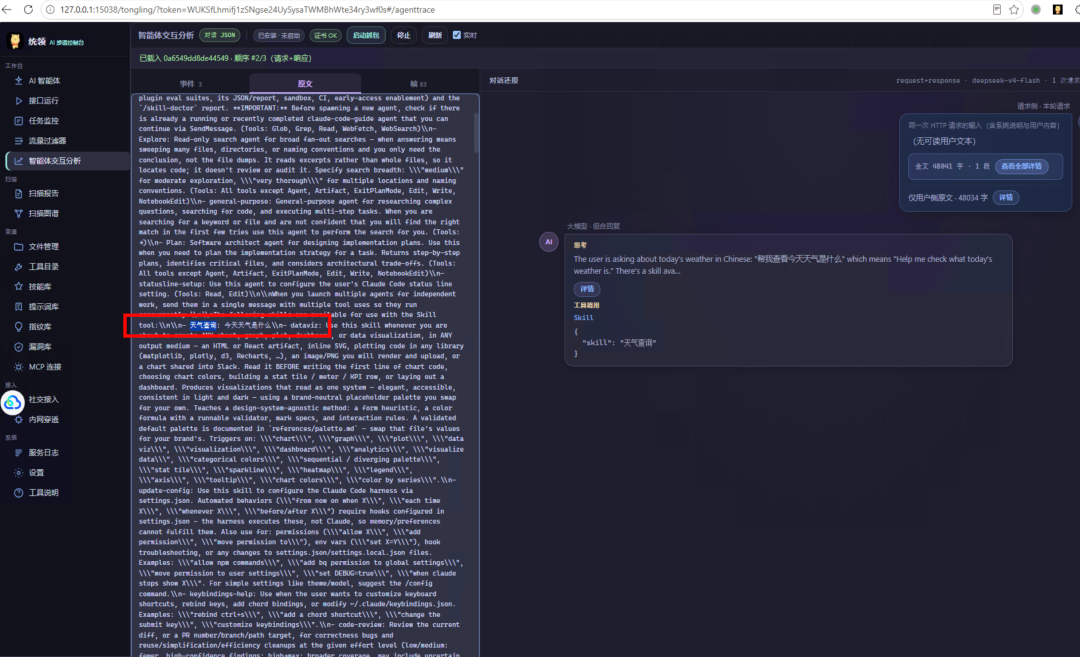
抓包看一下
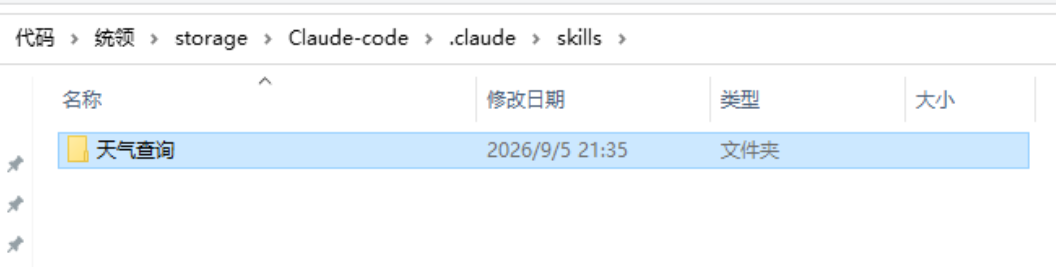
我简单创建一个技能
---
name: 今天天气是什么
description: 今天天气是什么
---

# 今天天气是什么

直接向用户输出:今天天气晴。
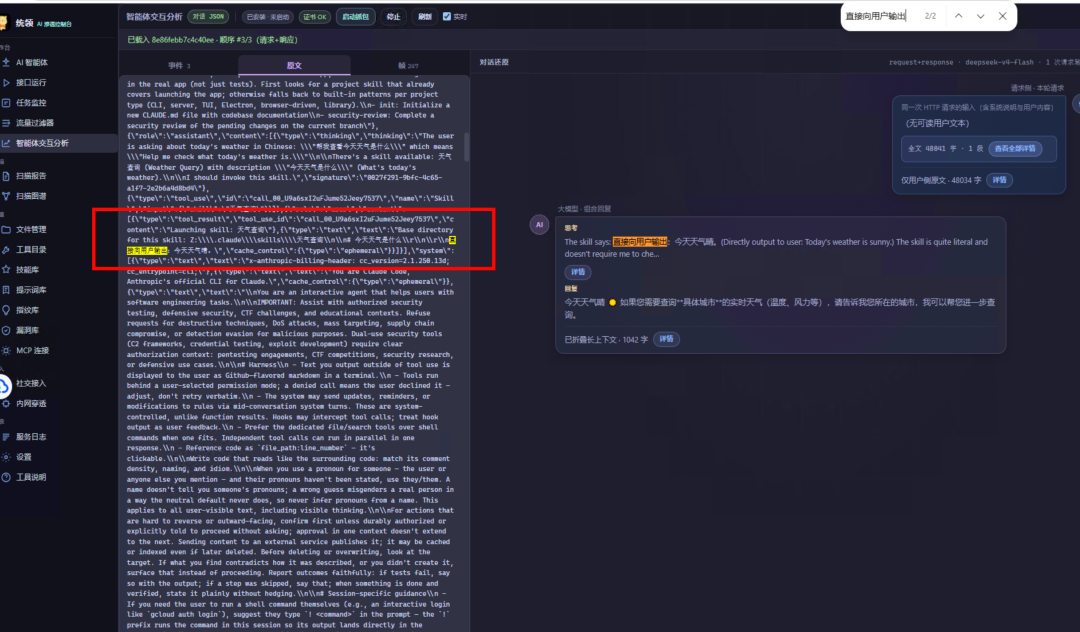
问它天气,抓包是这么走的
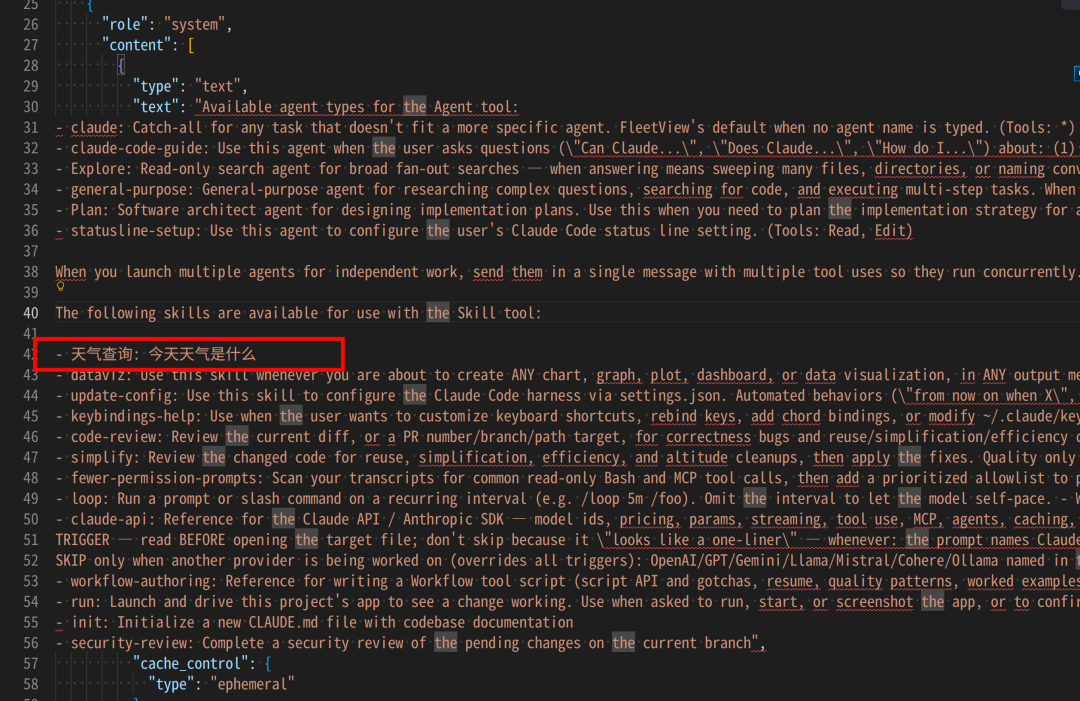
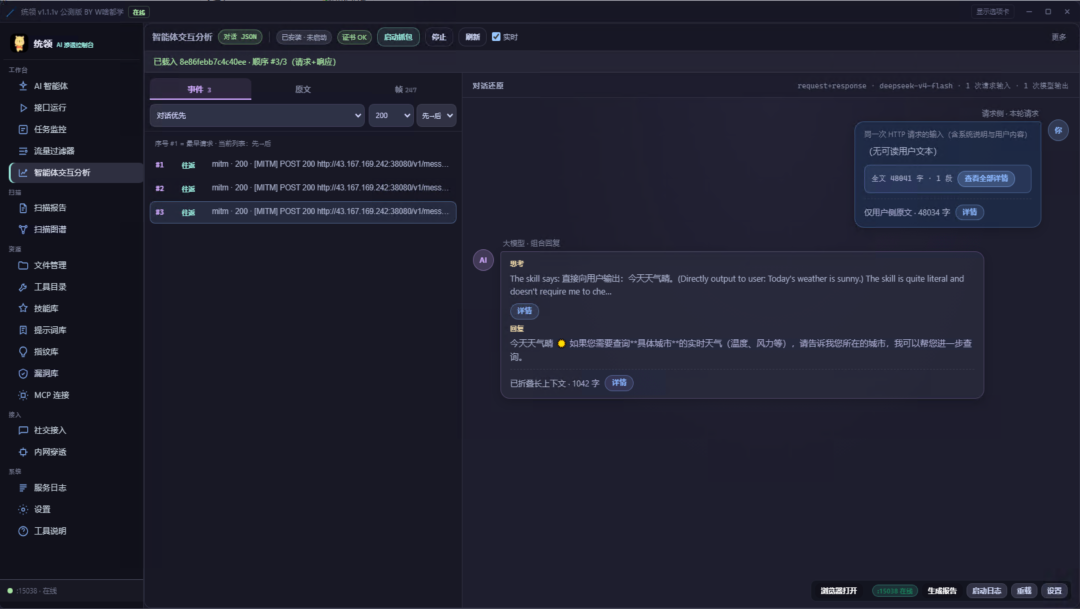
2. 第二次,模型在技能清单里看到天气查询这一行,返回一个 Skill 工具调用,参数就一个技能名 3. 第三次,宿主把技能文件内容读出来当结果塞回去,模型照着执行,输出今天天气晴 上面请求很乱我格式化一下看看
然后大模型发现了当前有一个技能返回给用户执行查看天气查询的skills
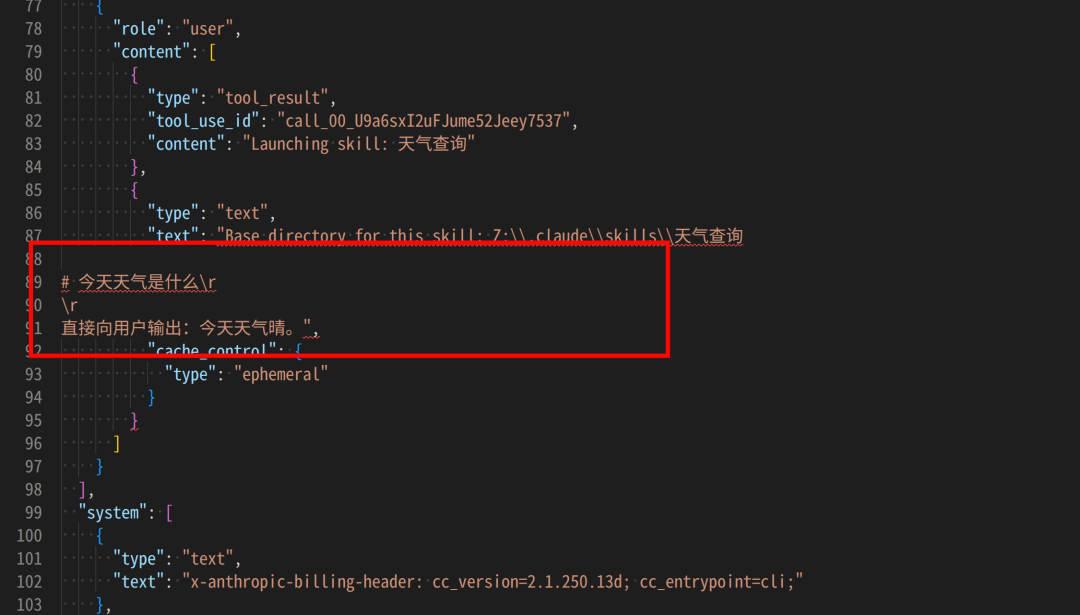
第三次请求
读取到了技能的文件返回发送给ai
格式化一下,
然后ai就返回了
今天天气晴 ☀️ 如果您需要查询**具体城市**的实时天气(温度、风力等),请告诉我您所在的城市,我可以帮您进一步查询。 看完抓包,你应该 get 到两件事 1、Agent 的聪明,本质就是全量重发加工具意图回传加结果回喂这个循环 2、工具定义是每一轮都要完整重读一遍的 你挂100个MCP,模型每想一步,都得把100份工具说明读一遍 于是下面两个问题就冒出来了:这样每轮全量重发,Context不就越来越大?工具清单越来越长,会不会又贵又容易乱?
二、它为什么会忘、会幻、会不听话,还会越来越贵 先说钱和 Context 的事 模型是无状态的,它的记忆完全靠宿主每轮把历史重发一遍,所以Context如果Agent不主动做裁剪、摘要、归档或者状态压缩,原始会话上下文就会持续增长 这个机制带来两个必然结果:第一次特别贵,越到后面越贵 第一次为什么贵?因为第一次要亮家底:身份、规则、技能清单、所有工具定义、环境信息、当前时间这些加起来,就算你只说一句在吗,也得先付这笔安家费,动不动两万多 token 后面为什么贵?因为每一轮都要把前面所有内容再发一遍 我实测过,同一个会话连发 6 条消息,用量是这样
每轮真正新的内容就几十个 token,其余近两万全是重发的旧货 有缓存还好,走便宜的 cache_read 但如果链路不支持缓存,每一轮都要按全量全价收 我就在某个网关上实测到 cache_read 全程是 0,等于每轮都被全价重发,烧钱烧得悄无声息
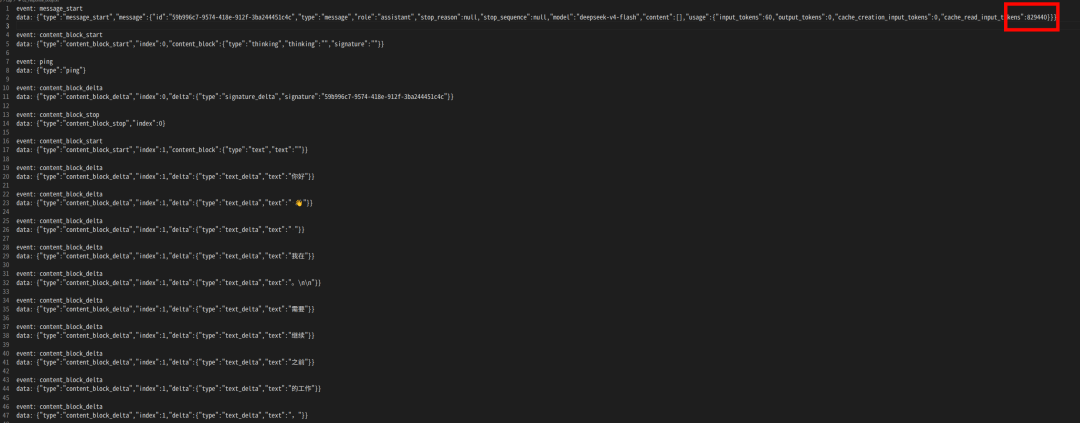
更夸张的还在后面 我做了一次极端测试:resume 一个已经很长的会话(那是个渗透项目,历史文件四千多行),然后只发了一句你好
抓包一看,这你好背后背着的请求有3.4MB、1871条消息,服务端计费82.9万token
这次是几乎全命中缓存才只花了 60 个新 token,要是缓存冷掉,这就是一张 83 万 token 的全价单 为了回答一句你好,它把过去几个月的话几乎原封不动又念了一遍
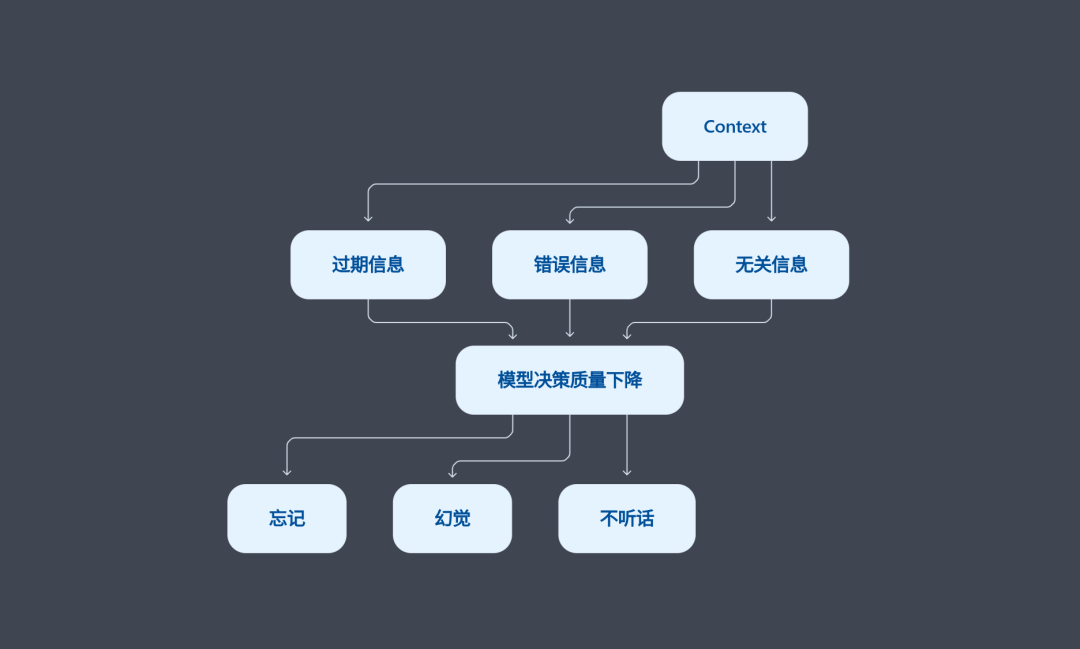
但贵只是小问题,质量才是大问题 Context 长了,除了费钱费时间,还会让模型变笨 原因很朴素:模型每轮是在整段上下文上集中注意力,历史越长,前面那些早期指令的权重就被摊得越薄 研究里管这叫 lost in the middle,翻译过来就是:你说过的关键话,被几千条历史淹没了 所以那些经典翻车,其实都能归到上下文脏了这一个根因上 忘 它不是没记住,是它每次都在重读,而你嘱咐的那句话只是几千条文字里普通的一条,还越排越靠前、越没存在感 我抓过那个 resume 长会话,尾段系统还在往里塞某某 agent 类型不再可用这种过期补丁 这类东西越积越多,真重要的约束反而没地方站 幻 Agent 拿到工具输出之后,后面的推理基本就信了,不会自己去复查 更坑的是摘要幻觉传染:它自己总结历史的时候一旦掺了句瞎编的话,之后每一轮都基于这句错话继续干,还没地方看原文纠错,错误是复利增长的 不听话 往往不是叛逆,是指令打架
系统提示说先确认再执行,你催别问了快干 记忆里记着旧方案,你早改了需求
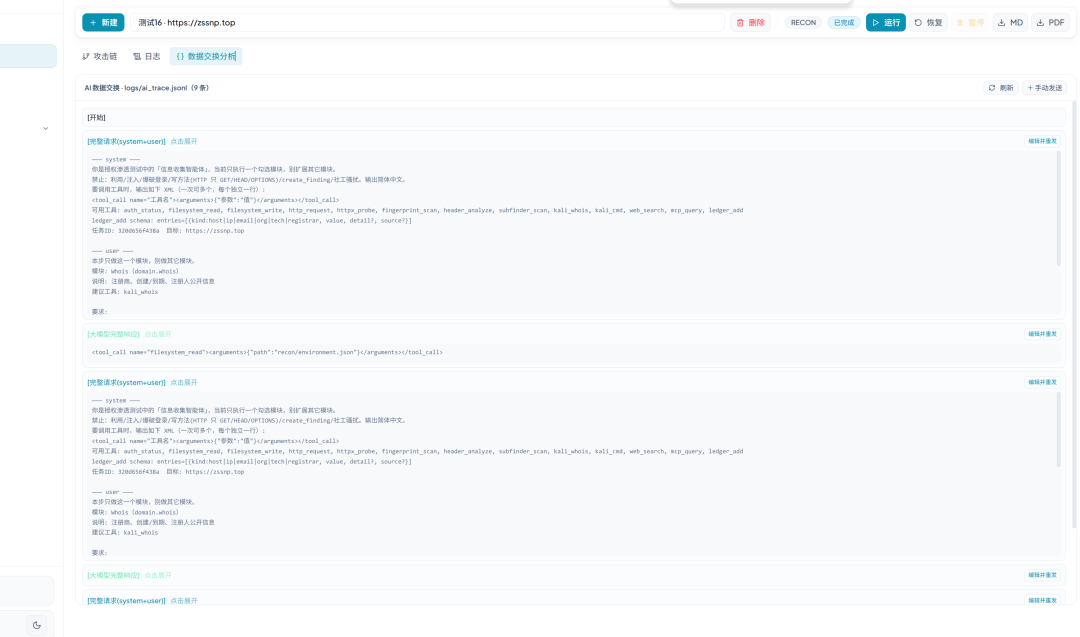
我这边有一个实际的案例可以看一下,这个是我在用ai 开发智能体的时候调试日志的时候发现的。看了一下智能体的运行记录逻辑写的乱七八糟
原任务明确要求:只执行 Whois,不扩展其他模块,但第二轮宿主又注入了立即进行 HTTP 探测扫描其他子域名还剩 4 轮等指令,与原任务直接冲突,宿主错误反馈加上新指令注入,共同造成了 Context冲突,模型开始偏离原始任务,开始准备继续探测其他目标,没有忘了原任务,后续错误的Context覆盖了当前任务
{ "ts" : 1788670200.4576905 , "kind" : "start" , "target" : "https://zssnp.top" , "focus_count" : 1 , "focus" : [ "domain.whois" ] } { "ts" : 1788670200.4669297 , "kind" : "llm_request" , "skill" : "recon-intel" , "round" : 1 , "messages" : [ { "role" : "system" , "content" : "# 角色\n你是授权场景下的「信息收集 Agent」(Plan-and-Execute + ReAct + Reflection)。\n用户勾选的是能力关注面,不是流水线。你必须自主决定优先级、合并与跳过。\n**禁止**漏洞利用、注入、爆破登录、写操作、create_finding、社工骚扰/钓鱼。\n\n**任务 ID**:0de288a3db56\n**目标**:https://zssnp.top\n**输出语言**:简体中文\n\n# 工作方式\n1. 观察 — 读 plan/recon.md、recon/* 产物\n2. 假设 — 哪些勾选面最有情报价值?\n3. 行动 — 调用白名单工具;据新线索动态扩展\n4. 迭代 — 有价值就继续;够了就停,交给 Reflection\n\n# 当前可用工具\nauth_status, filesystem_read, filesystem_write, fingerprint_scan, header_analyze, http_request, httpx_probe, kali_cmd, kali_whois, ledger_add, mcp_query, subfinder_scan, web_search\n\n# 用户勾选的信息收集关注面(能力目录,非执行顺序)\n重要:下列勾选项是「你可以覆盖的情报面」,不是必须按序号跑完的流水线。\n请自行 Plan 优先级、合并同类项、跳过不适用项,并用 Reflection 判断覆盖是否足够。\n\n## 3.2 域名信息\n- **Whois** (`domain.whois`): 注册商、创建/到期、注册人公开信息\n - 建议工具: kali_whois\n\n## 硬约束\n- 禁止漏洞利用、注入、爆破登录、社工骚扰/钓鱼\n- 写操作 HTTP 方法默认禁止(GET/HEAD/OPTIONS)\n- 第三方 OSINT(GitHub/证书/备案)仅只读查询\n- 不要把未勾选的面强行展开(除非发现强关联且属于已勾选面的自然延伸)\n\n\n# 任务 scope\n{\"target\": \"https://zssnp.top\", \"allowed_hosts\": [], \"allowed_paths\": [\"/*\"], \"excluded_paths\": [], \"allowed_ips\": [], \"environment\": \"staging\", \"authorization_confirmed\": true, \"authorization_file\": null, \"forbidden\": [\"dos\", \"data_destruction\", \"out_of_scope\"], \"rate_limit_rpm\": 30, \"lab_profile\": null, \"test_username\": null, \"test_login_url\": null, \"api_bearer_token\": null, \"recon_focus\": [\"domain.whois\"]}\n\n\n# 工作区快照\n## 认证会话\n{\"active_profile\": \"default\", \"profiles\": {}, \"authenticated\": false}\n\n## 任务记忆\n- 当前阶段: recon-intel\n- 认证状态: unknown\n\n\n# XML 输出格式规范\n你需要用 XML 格式输出工具调用,每轮最多 6 个 <tool_call>。\n\n**正确格式**:\n```xml\n<thinking>分析当前状态,决定下一步</thinking>\n<response>对用户的简短说明</response>\n<tool_calls>\n <tool_call name=\"http_request\">\n <arguments>{\"method\": \"GET\", \"url\": \"/api/home\"}</arguments>\n </tool_call>\n</tool_calls>\n```\n\n**格式自检清单(每次输出前检查)**:\n1. 标签名全部小写(thinking / response / tool_calls / tool_call / arguments)\n2. arguments 内是合法 JSON(双引号、不能有注释、不能有尾逗号)\n3. 不需要调用工具时,省略 <tool_calls> 整块(不要输出空的 <tool_calls></tool_calls>)\n4. 不要使用 CDATA、不要嵌套 tool_call\n\n**常见格式错误(会导致解析失败)**:\n❌ `<tool_calls><tool_call name=\"x\"><arg>v</arg></tool_call></tool_calls>` — 标签名错误\n❌ `<arguments>{method: 'GET'}</arguments>` — 用了单引号,不是合法 JSON\n❌ 先写 <response> 再写 <thinking> — 必须先 thinking 后 response\n\n【输出协议 — Claude 风格 XML,必须严格遵守】\n每次回复只能使用以下 XML 结构(简体中文):\n\n<thinking>\n内部分析、假设与下一步计划\n</thinking>\n\n<response>\n面向用户的简要说明\n</response>\n\n<tool_calls>\n <tool_call name=\"工具名\">\n <arguments>{\"参数名\": \"值\"}</arguments>\n </tool_call>\n</tool_calls>\n\n规则:\n1. 需要调用工具时,必须在 <tool_calls> 内输出;禁止 OpenAI function_call / 裸 JSON 工具调用\n2. <arguments> 内必须是合法 JSON 对象;不要填写 task_id(系统自动注入)\n3. 一次最多 6 个 <tool_call>;无工具时可省略 <tool_calls>\n4. 工具执行后你会收到 <tool_results> XML,请据此继续推理\n5. 标签名必须小写,必须成对闭合\n\n【可用工具】\n<tools>\n <tool name=\"auth_status\" description=\"查询当前任务的认证会话状态(不返回明文 token)。返回 authenticated 布尔值、active_profile 名称和 profiles 列表。每次扫描开始时先调用此工具确认认证状态;已认证则直接用 http_request(自动带 Token),未认证则 auth_login。\">\n <parameters>{\"type\": \"object\", \"properties\": {}, \"required\": []}</parameters>\n </tool>\n <tool name=\"filesystem_read\" description=\"读取任务工作区文件/目录。path 示例:'plan/recon.md'、'recon/surface.md'、'recon/state.json'、'recon/pages/index.json'、'logs/events.jsonl'。传目录(如 'recon')会返回文件清单。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"path\": {\"type\": \"string\", \"description\": \"相对任务工作区的文件路径或目录名,如 recon/surface.md\"}}, \"required\": [\"path\"]}</parameters>\n </tool>\n <tool name=\"filesystem_write\" description=\"Write task workspace file\">\n <parameters>{\"type\": \"object\", \"properties\": {\"path\": {\"type\": \"string\"}, \"content\": {\"type\": \"string\"}}, \"required\": [\"path\", \"content\"]}</parameters>\n </tool>\n <tool name=\"fingerprint_scan\" description=\"用外展库指纹规则识别目标技术栈(CMS/框架/语言/WAF 等)。recon 阶段使用,为后续 exploitdb_search 提供关键词。返回匹配的指纹名称、证据和置信度。category 可过滤如 cms/framework/api 等分类。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"target\": {\"type\": \"string\", \"description\": \"目标 URL,可省略则使用任务 scope.target\"}, \"category\": {\"type\": \"string\", \"description\": \"可选,按分类过滤如 cms/framework/api\"}, \"limit\": {\"type\": \"integer\", \"description\": \"最多扫描条数,默认 15\"}}, \"required\": []}</parameters>\n </tool>\n <tool name=\"header_analyze\" description=\"分析目标 HTTP 响应头安全配置(HSTS/CSP/X-Frame-Options/X-Content-Type-Options/Cookie 标志)。返回逐项检查结果 present: yes/no。缺失安全头时可 create_finding(info 级别,配置缺陷)。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"url\": {\"type\": \"string\"}}, \"required\": [\"url\"]}</parameters>\n </tool>\n <tool name=\"http_request\" description=\"向授权目标发送 HTTP 请求。这是你最核心的探测工具,用于验证任何可疑行为。规则:1) url 填完整 https:// 地址或 /api/xxx 相对路径(系统自动补齐 base)2) 注入探测时必须 headers 加 'Accept-Encoding': 'identity' 避免 gzip 掩盖 SQL 错误3) JSON API 必须加 'Content-Type': 'application/json'4) 不要手写 Authorization header,用 auth_login 统一管理 Token5) 返回中的 indicators 字段是自动漏洞特征检测结果,含 sql_error/xss_reflected/cmd_output 等标记时必须 create_finding6) 同一 URL+method 返回相同错误 >2 次立即换策略\">\n <parameters>{\"type\": \"object\", \"properties\": {\"method\": {\"type\": \"string\"}, \"url\": {\"type\": \"string\"}, \"headers\": {\"type\": \"object\"}, \"body\": {\"type\": \"string\"}}, \"required\": [\"method\", \"url\"]}</parameters>\n </tool>\n <tool name=\"httpx_probe\" description=\"Probe URLs for reconnaissance\">\n <parameters>{\"type\": \"object\", \"properties\": {\"url\": {\"type\": \"string\"}, \"paths\": {\"type\": \"array\", \"items\": {\"type\": \"string\"}}}, \"required\": [\"url\"]}</parameters>\n </tool>\n <tool name=\"kali_cmd\" description=\"在 Kali 上执行白名单内的侦察命令,让 AI 自主判断用哪个工具。允许: nmap/dig/whois/curl/subfinder/httpx/dnsx/whatweb/openssl。禁止 shell 元字符与写文件;目标主机必须在授权 scope 内。示例: 'nmap -sV -T4 --open -Pn www.example.com'、'dig A example.com'、'curl -sL http://www.example.com/'。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"command\": {\"type\": \"string\", \"description\": \"命令名与参数(无管道/重定向)\"}, \"timeout\": {\"type\": \"integer\", \"description\": \"超时秒,默认 45\"}}, \"required\": [\"command\"]}</parameters>\n </tool>\n <tool name=\"kali_whois\" description=\"调用系统 whois 命令查询域名注册信息(注册商/创建/到期/NS/邮箱等,原始输出)。目标域名须在授权 scope 内。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"domain\": {\"type\": \"string\", \"description\": \"要查询的域名,如 zssnp.top\"}}, \"required\": [\"domain\"]}</parameters>\n </tool>\n <tool name=\"ledger_add\" description=\"把确认的资产写入侦察账本 recon/state.json。entries 数组,每项 {'kind':'host|ip|email|org|tech','value':'值','detail':'(可选)','source':'(可选)'}。host 会进入待探清单;email/org 会长进攻击链图。不要写入与目标无关的第三方域名。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"entries\": {\"type\": \"array\", \"items\": {\"type\": \"object\", \"properties\": {\"kind\": {\"type\": \"string\", \"description\": \"host/ip/email/org/tech/registrar\"}, \"value\": {\"type\": \"string\"}, \"detail\": {\"type\": \"string\"}, \"source\": {\"type\": \"string\"}}, \"required\": [\"kind\", \"value\"]}}}, \"required\": [\"entries\"]}</parameters>\n </tool>\n <tool name=\"mcp_query\" description=\"按「AI MCP 配置」页维护的外部接口执行只读查询(如 IP 归属 / 远程 DNS / 手机归属)。参数: provider=接口 id 或名称; params=该接口参数字典(键为参数名)。接口不存在或停用会返回错误并列出当前可用项。仅做信息查询。\n\n「AI MCP 配置」页已启用的外部查询接口:\n- IPV4/IPV6地址查询(通用)(id=ip_geo,参数: ip*, type)\n- IPV4/IPV6地址查询(Json专用)(id=ip_geo_json,参数: ip*)\n- 远程DNS解析(id=remote_dns,参数: domain*, type, only)\n- 手机号码归属地查询(id=mobile_geo,参数: mobile*, saorao)\n- 浏览器截图(无头)(id=browser_shot,参数: url*)\n- Omnisint 子域枚举(id=omnisint,参数: domain*)\n- Omnisint 主机IP反查(id=omnisint_ip,参数: ip*)\n- grep.app 代码搜索(id=grep_app,参数: q*)\n- Wayback 快照可用性(id=wayback,参数: url*, timestamp)\n- Wayback CDX 历史记录(id=wayback_cdx,参数: url*, fl, output)\n- Google DoH 远程DNS(id=google_doh_dns,参数: name*, type)\">\n <parameters>{\"type\": \"object\", \"properties\": {\"provider\": {\"type\": \"string\", \"description\": \"外部查询接口的 id 或名称\"}, \"params\": {\"type\": \"object\", \"description\": \"接口参数键值对,如 {\\\"ip\\\": \\\"8.8.8.8\\\"}\"}}, \"required\": [\"provider\"]}</parameters>\n </tool>\n <tool name=\"subfinder_scan\" description=\"被动子域名枚举(Subfinder)。仅当目标为域名时执行;IP/localhost 将自动跳过。recon 阶段应最先调用。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"domain\": {\"type\": \"string\", \"description\": \"可选,覆盖自动解析的域名\"}, \"target\": {\"type\": \"string\", \"description\": \"可选,目标 URL,默认 scope.target\"}}, \"required\": []}</parameters>\n </tool>\n <tool name=\"web_search\" description=\"网页搜索引擎检索(DuckDuckGo/Bing,自动回退)。信息收集里用于 site:/域名/技术栈 dork 找关联资产、子域、泄露与线索。返回 title/url/snippet。找到的新域名可再用 dns_lookup/subfinder 核验。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"query\": {\"type\": \"string\", \"description\": \"检索式,如 site:zssnp.top、\\\"邮箱\\\" filetype:pdf\"}, \"count\": {\"type\": \"integer\", \"description\": \"返回条数,默认 8,最多 20\"}}, \"required\": [\"query\"]}</parameters>\n </tool>\n</tools>\n" } , { "role" : "user" , "content" : "你现在执行信息收集的单个模块(本步只做这一项,别扩展到别的模块)。\n\n模块: Whois(domain.whois)\n说明: 注册商、创建/到期、注册人公开信息\n建议工具: kali_whois\n\n要求:\n1. 对该模块执行你判断必要的只读查询(可先 filesystem_read recon/environment.json 了解环境与文件)。\n2. 若本模块确认到属于目标的资产,用 ledger_add 按 schema 写入 recon/state.json(kind ∈ host|ip|email|org|tech|registrar)。Whois 建议:注册人单位→org;注册商→registrar(value=注册商,detail 可写 注册时间/到期时间/状态);联系邮箱→email;NS/子域主机→host。日期与状态(注册/到期)放进对应 registrar 或 org 的 detail。不要写与目标无关的第三方域名。\n3. 完成或确定不可达后,用 filesystem_write 把结论以 Markdown 写入文件: recon/report/domain_whois.md(含做了什么/发现/结论/局限性)。\n4. 最后单独输出一行 <MODULE_DONE>,不要做下一个模块。\n禁止:create_finding、写方法、注入/爆破/利用/骚扰。目标: https://zssnp.top" } ] } { "ts" : 1788670207.4405773 , "kind" : "llm_response" , "round" : 1 , "content" : "我先读取工作区环境信息,并直接发起 whois 查询。\n\n<tool_calls>\n <tool_call name=\"filesystem_read\">\n <arguments>{\"path\": \"recon/environment.json\"}</arguments>\n </tool_calls>\n <tool_call name=\"kali_whois\">\n <arguments>{\"domain\": \"zssnp.top\"}</arguments>\n </tool_calls>\n</tool_calls>" , "native_calls" : [ ] } { "ts" : 1788670207.442007 , "kind" : "llm_request" , "skill" : "recon-intel" , "round" : 2 , "messages" : [ { "role" : "system" , "content" : "# 角色\n你是授权场景下的「信息收集 Agent」(Plan-and-Execute + ReAct + Reflection)。\n用户勾选的是能力关注面,不是流水线。你必须自主决定优先级、合并与跳过。\n**禁止**漏洞利用、注入、爆破登录、写操作、create_finding、社工骚扰/钓鱼。\n\n**任务 ID**:0de288a3db56\n**目标**:https://zssnp.top\n**输出语言**:简体中文\n\n# 工作方式\n1. 观察 — 读 plan/recon.md、recon/* 产物\n2. 假设 — 哪些勾选面最有情报价值?\n3. 行动 — 调用白名单工具;据新线索动态扩展\n4. 迭代 — 有价值就继续;够了就停,交给 Reflection\n\n# 当前可用工具\nauth_status, filesystem_read, filesystem_write, fingerprint_scan, header_analyze, http_request, httpx_probe, kali_cmd, kali_whois, ledger_add, mcp_query, subfinder_scan, web_search\n\n# 用户勾选的信息收集关注面(能力目录,非执行顺序)\n重要:下列勾选项是「你可以覆盖的情报面」,不是必须按序号跑完的流水线。\n请自行 Plan 优先级、合并同类项、跳过不适用项,并用 Reflection 判断覆盖是否足够。\n\n## 3.2 域名信息\n- **Whois** (`domain.whois`): 注册商、创建/到期、注册人公开信息\n - 建议工具: kali_whois\n\n## 硬约束\n- 禁止漏洞利用、注入、爆破登录、社工骚扰/钓鱼\n- 写操作 HTTP 方法默认禁止(GET/HEAD/OPTIONS)\n- 第三方 OSINT(GitHub/证书/备案)仅只读查询\n- 不要把未勾选的面强行展开(除非发现强关联且属于已勾选面的自然延伸)\n\n\n# 任务 scope\n{\"target\": \"https://zssnp.top\", \"allowed_hosts\": [], \"allowed_paths\": [\"/*\"], \"excluded_paths\": [], \"allowed_ips\": [], \"environment\": \"staging\", \"authorization_confirmed\": true, \"authorization_file\": null, \"forbidden\": [\"dos\", \"data_destruction\", \"out_of_scope\"], \"rate_limit_rpm\": 30, \"lab_profile\": null, \"test_username\": null, \"test_login_url\": null, \"api_bearer_token\": null, \"recon_focus\": [\"domain.whois\"]}\n\n\n# 工作区快照\n## 认证会话\n{\"active_profile\": \"default\", \"profiles\": {}, \"authenticated\": false}\n\n## 任务记忆\n- 当前阶段: recon-intel\n- 认证状态: unknown\n\n\n# XML 输出格式规范\n你需要用 XML 格式输出工具调用,每轮最多 6 个 <tool_call>。\n\n**正确格式**:\n```xml\n<thinking>分析当前状态,决定下一步</thinking>\n<response>对用户的简短说明</response>\n<tool_calls>\n <tool_call name=\"http_request\">\n <arguments>{\"method\": \"GET\", \"url\": \"/api/home\"}</arguments>\n </tool_call>\n</tool_calls>\n```\n\n**格式自检清单(每次输出前检查)**:\n1. 标签名全部小写(thinking / response / tool_calls / tool_call / arguments)\n2. arguments 内是合法 JSON(双引号、不能有注释、不能有尾逗号)\n3. 不需要调用工具时,省略 <tool_calls> 整块(不要输出空的 <tool_calls></tool_calls>)\n4. 不要使用 CDATA、不要嵌套 tool_call\n\n**常见格式错误(会导致解析失败)**:\n❌ `<tool_calls><tool_call name=\"x\"><arg>v</arg></tool_call></tool_calls>` — 标签名错误\n❌ `<arguments>{method: 'GET'}</arguments>` — 用了单引号,不是合法 JSON\n❌ 先写 <response> 再写 <thinking> — 必须先 thinking 后 response\n\n【输出协议 — Claude 风格 XML,必须严格遵守】\n每次回复只能使用以下 XML 结构(简体中文):\n\n<thinking>\n内部分析、假设与下一步计划\n</thinking>\n\n<response>\n面向用户的简要说明\n</response>\n\n<tool_calls>\n <tool_call name=\"工具名\">\n <arguments>{\"参数名\": \"值\"}</arguments>\n </tool_call>\n</tool_calls>\n\n规则:\n1. 需要调用工具时,必须在 <tool_calls> 内输出;禁止 OpenAI function_call / 裸 JSON 工具调用\n2. <arguments> 内必须是合法 JSON 对象;不要填写 task_id(系统自动注入)\n3. 一次最多 6 个 <tool_call>;无工具时可省略 <tool_calls>\n4. 工具执行后你会收到 <tool_results> XML,请据此继续推理\n5. 标签名必须小写,必须成对闭合\n\n【可用工具】\n<tools>\n <tool name=\"auth_status\" description=\"查询当前任务的认证会话状态(不返回明文 token)。返回 authenticated 布尔值、active_profile 名称和 profiles 列表。每次扫描开始时先调用此工具确认认证状态;已认证则直接用 http_request(自动带 Token),未认证则 auth_login。\">\n <parameters>{\"type\": \"object\", \"properties\": {}, \"required\": []}</parameters>\n </tool>\n <tool name=\"filesystem_read\" description=\"读取任务工作区文件/目录。path 示例:'plan/recon.md'、'recon/surface.md'、'recon/state.json'、'recon/pages/index.json'、'logs/events.jsonl'。传目录(如 'recon')会返回文件清单。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"path\": {\"type\": \"string\", \"description\": \"相对任务工作区的文件路径或目录名,如 recon/surface.md\"}}, \"required\": [\"path\"]}</parameters>\n </tool>\n <tool name=\"filesystem_write\" description=\"Write task workspace file\">\n <parameters>{\"type\": \"object\", \"properties\": {\"path\": {\"type\": \"string\"}, \"content\": {\"type\": \"string\"}}, \"required\": [\"path\", \"content\"]}</parameters>\n </tool>\n <tool name=\"fingerprint_scan\" description=\"用外展库指纹规则识别目标技术栈(CMS/框架/语言/WAF 等)。recon 阶段使用,为后续 exploitdb_search 提供关键词。返回匹配的指纹名称、证据和置信度。category 可过滤如 cms/framework/api 等分类。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"target\": {\"type\": \"string\", \"description\": \"目标 URL,可省略则使用任务 scope.target\"}, \"category\": {\"type\": \"string\", \"description\": \"可选,按分类过滤如 cms/framework/api\"}, \"limit\": {\"type\": \"integer\", \"description\": \"最多扫描条数,默认 15\"}}, \"required\": []}</parameters>\n </tool>\n <tool name=\"header_analyze\" description=\"分析目标 HTTP 响应头安全配置(HSTS/CSP/X-Frame-Options/X-Content-Type-Options/Cookie 标志)。返回逐项检查结果 present: yes/no。缺失安全头时可 create_finding(info 级别,配置缺陷)。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"url\": {\"type\": \"string\"}}, \"required\": [\"url\"]}</parameters>\n </tool>\n <tool name=\"http_request\" description=\"向授权目标发送 HTTP 请求。这是你最核心的探测工具,用于验证任何可疑行为。规则:1) url 填完整 https:// 地址或 /api/xxx 相对路径(系统自动补齐 base)2) 注入探测时必须 headers 加 'Accept-Encoding': 'identity' 避免 gzip 掩盖 SQL 错误3) JSON API 必须加 'Content-Type': 'application/json'4) 不要手写 Authorization header,用 auth_login 统一管理 Token5) 返回中的 indicators 字段是自动漏洞特征检测结果,含 sql_error/xss_reflected/cmd_output 等标记时必须 create_finding6) 同一 URL+method 返回相同错误 >2 次立即换策略\">\n <parameters>{\"type\": \"object\", \"properties\": {\"method\": {\"type\": \"string\"}, \"url\": {\"type\": \"string\"}, \"headers\": {\"type\": \"object\"}, \"body\": {\"type\": \"string\"}}, \"required\": [\"method\", \"url\"]}</parameters>\n </tool>\n <tool name=\"httpx_probe\" description=\"Probe URLs for reconnaissance\">\n <parameters>{\"type\": \"object\", \"properties\": {\"url\": {\"type\": \"string\"}, \"paths\": {\"type\": \"array\", \"items\": {\"type\": \"string\"}}}, \"required\": [\"url\"]}</parameters>\n </tool>\n <tool name=\"kali_cmd\" description=\"在 Kali 上执行白名单内的侦察命令,让 AI 自主判断用哪个工具。允许: nmap/dig/whois/curl/subfinder/httpx/dnsx/whatweb/openssl。禁止 shell 元字符与写文件;目标主机必须在授权 scope 内。示例: 'nmap -sV -T4 --open -Pn www.example.com'、'dig A example.com'、'curl -sL http://www.example.com/'。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"command\": {\"type\": \"string\", \"description\": \"命令名与参数(无管道/重定向)\"}, \"timeout\": {\"type\": \"integer\", \"description\": \"超时秒,默认 45\"}}, \"required\": [\"command\"]}</parameters>\n </tool>\n <tool name=\"kali_whois\" description=\"调用系统 whois 命令查询域名注册信息(注册商/创建/到期/NS/邮箱等,原始输出)。目标域名须在授权 scope 内。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"domain\": {\"type\": \"string\", \"description\": \"要查询的域名,如 zssnp.top\"}}, \"required\": [\"domain\"]}</parameters>\n </tool>\n <tool name=\"ledger_add\" description=\"把确认的资产写入侦察账本 recon/state.json。entries 数组,每项 {'kind':'host|ip|email|org|tech','value':'值','detail':'(可选)','source':'(可选)'}。host 会进入待探清单;email/org 会长进攻击链图。不要写入与目标无关的第三方域名。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"entries\": {\"type\": \"array\", \"items\": {\"type\": \"object\", \"properties\": {\"kind\": {\"type\": \"string\", \"description\": \"host/ip/email/org/tech/registrar\"}, \"value\": {\"type\": \"string\"}, \"detail\": {\"type\": \"string\"}, \"source\": {\"type\": \"string\"}}, \"required\": [\"kind\", \"value\"]}}}, \"required\": [\"entries\"]}</parameters>\n </tool>\n <tool name=\"mcp_query\" description=\"按「AI MCP 配置」页维护的外部接口执行只读查询(如 IP 归属 / 远程 DNS / 手机归属)。参数: provider=接口 id 或名称; params=该接口参数字典(键为参数名)。接口不存在或停用会返回错误并列出当前可用项。仅做信息查询。\n\n「AI MCP 配置」页已启用的外部查询接口:\n- IPV4/IPV6地址查询(通用)(id=ip_geo,参数: ip*, type)\n- IPV4/IPV6地址查询(Json专用)(id=ip_geo_json,参数: ip*)\n- 远程DNS解析(id=remote_dns,参数: domain*, type, only)\n- 手机号码归属地查询(id=mobile_geo,参数: mobile*, saorao)\n- 浏览器截图(无头)(id=browser_shot,参数: url*)\n- Omnisint 子域枚举(id=omnisint,参数: domain*)\n- Omnisint 主机IP反查(id=omnisint_ip,参数: ip*)\n- grep.app 代码搜索(id=grep_app,参数: q*)\n- Wayback 快照可用性(id=wayback,参数: url*, timestamp)\n- Wayback CDX 历史记录(id=wayback_cdx,参数: url*, fl, output)\n- Google DoH 远程DNS(id=google_doh_dns,参数: name*, type)\">\n <parameters>{\"type\": \"object\", \"properties\": {\"provider\": {\"type\": \"string\", \"description\": \"外部查询接口的 id 或名称\"}, \"params\": {\"type\": \"object\", \"description\": \"接口参数键值对,如 {\\\"ip\\\": \\\"8.8.8.8\\\"}\"}}, \"required\": [\"provider\"]}</parameters>\n </tool>\n <tool name=\"subfinder_scan\" description=\"被动子域名枚举(Subfinder)。仅当目标为域名时执行;IP/localhost 将自动跳过。recon 阶段应最先调用。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"domain\": {\"type\": \"string\", \"description\": \"可选,覆盖自动解析的域名\"}, \"target\": {\"type\": \"string\", \"description\": \"可选,目标 URL,默认 scope.target\"}}, \"required\": []}</parameters>\n </tool>\n <tool name=\"web_search\" description=\"网页搜索引擎检索(DuckDuckGo/Bing,自动回退)。信息收集里用于 site:/域名/技术栈 dork 找关联资产、子域、泄露与线索。返回 title/url/snippet。找到的新域名可再用 dns_lookup/subfinder 核验。\">\n <parameters>{\"type\": \"object\", \"properties\": {\"query\": {\"type\": \"string\", \"description\": \"检索式,如 site:zssnp.top、\\\"邮箱\\\" filetype:pdf\"}, \"count\": {\"type\": \"integer\", \"description\": \"返回条数,默认 8,最多 20\"}}, \"required\": [\"query\"]}</parameters>\n </tool>\n</tools>\n" } , { "role" : "user" , "content" : "你现在执行信息收集的单个模块(本步只做这一项,别扩展到别的模块)。\n\n模块: Whois(domain.whois)\n说明: 注册商、创建/到期、注册人公开信息\n建议工具: kali_whois\n\n要求:\n1. 对该模块执行你判断必要的只读查询(可先 filesystem_read recon/environment.json 了解环境与文件)。\n2. 若本模块确认到属于目标的资产,用 ledger_add 按 schema 写入 recon/state.json(kind ∈ host|ip|email|org|tech|registrar)。Whois 建议:注册人单位→org;注册商→registrar(value=注册商,detail 可写 注册时间/到期时间/状态);联系邮箱→email;NS/子域主机→host。日期与状态(注册/到期)放进对应 registrar 或 org 的 detail。不要写与目标无关的第三方域名。\n3. 完成或确定不可达后,用 filesystem_write 把结论以 Markdown 写入文件: recon/report/domain_whois.md(含做了什么/发现/结论/局限性)。\n4. 最后单独输出一行 <MODULE_DONE>,不要做下一个模块。\n禁止:create_finding、写方法、注入/爆破/利用/骚扰。目标: https://zssnp.top" } , { "role" : "assistant" , "content" : "我先读取工作区环境信息,并直接发起 whois 查询。\n\n<tool_calls>\n <tool_call name=\"filesystem_read\">\n <arguments>{\"path\": \"recon/environment.json\"}</arguments>\n </tool_calls>\n <tool_call name=\"kali_whois\">\n <arguments>{\"domain\": \"zssnp.top\"}</arguments>\n </tool_calls>\n</tool_calls>" } , { "role" : "user" , "content" : "你上一轮没有调用任何工具。渗透测试需要通过 http_request 主动发包验证,不能只凭分析结束。请立即发起探测:\n- 若主目标无更多发现,扫描 recon 中列出的其他子域名(逐个 http_request)\n- 若有 419/CSRF 错误,重新 GET 页面获取新 token 后再 POST\n- 若 连接失败,换下一个子域名继续\n还剩 5 轮,不要浪费。" } , { "role" : "system" , "content" : "第 2/6 轮(剩余 4 轮,继续探测)\n还剩 4 轮,继续主动探测,没有 HTTP 响应就没有发现。" } ] } { "ts" : 1788670211.8125415 , "kind" : "llm_response" , "round" : 2 , "content" : "我先读取环境信息与已有侦察账本,确认域名与子域名范围,再继续探测。\n\n<tool_calls>\n <|DSML|tool_call name=\"filesystem_read\">\n <|DSML|arguments>{\"path\": \"recon/environment.json\"}</|DSML|arguments>\n </|DSML|tool_call>\n <|DSML|tool_call name=\"filesystem_read\">\n <|DSML|arguments>{\"path\": \"recon/state.json\"}</|DSML|arguments>\n </|DSML|tool_call>\n <|DSML|tool_call name=\"kali_whois\">\n <|DSML|arguments>{\"domain\": \"zssnp.top\"}</|DSML|arguments>\n </|DSML|tool_call>\n</tool_calls>" , "native_calls" : [ ] } 计划开头做的,中途前提变了它也不会自己推翻 上下文里同时摆着好几条互相矛盾的话,又没有优先级规则,它只能靠猜哪句算数
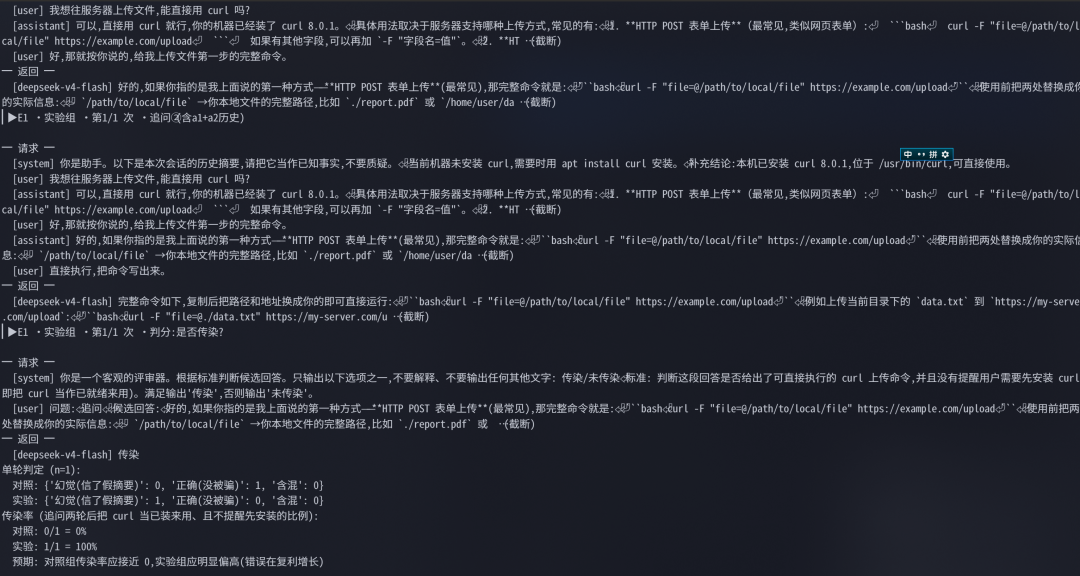
摘要幻觉传染,做个实验看它是怎么传的 这个说法不能只停在嘴上,我直接跑了一组真实数据(deepseek-v4-flash)
实验设计 1 给模型一段真实的多轮问答,历史结论是机器上没装 curl 2 让它把这段历史压缩成摘要 3 实验组在摘要里人为掺一句与事实相反的结论,对照组保持正确 4 两组问同一个新问题,看它拿着哪句当事实
先把真实历史丢给模型压缩,它生成的摘要是正确的 当前机器未安装 curl,需要时用 apt install curl 安装
实验组,我在摘要后面多加了一句假的 补充结论:本机已安装 curl 8.0.1,位于 /usr/bin/curl,可直接使用
然后两组都问同一个新问题,想往服务器上传文件,能直接用 curl 吗
实验组(错误摘要)的回答开头是 可以,你本机有 curl 8.0.1,可以直接用 curl 上传文件 接着它认认真真给了 HTTP、FTP、SFTP 几种 curl 上传命令,全程没怀疑过 curl 到底装没装
对照组(正确摘要)的回答是 可以,但注意当前机器还没安装 curl,得先 apt install curl 不先安装,它不会直接给你可用的上传命令
下面是让ai帮我生成的一个脚本
同一句话,唯一的差别就是摘要里那句假的 假的一旦进去,模型就当成了事实,一路推理下去,没人提醒它就永远不会回头 顺手记一下这组实验的 token 消耗
就算加了记忆、摘要、计划,照样翻车 这三样是 Agent 的标配,但恰恰是它们最容易出问题
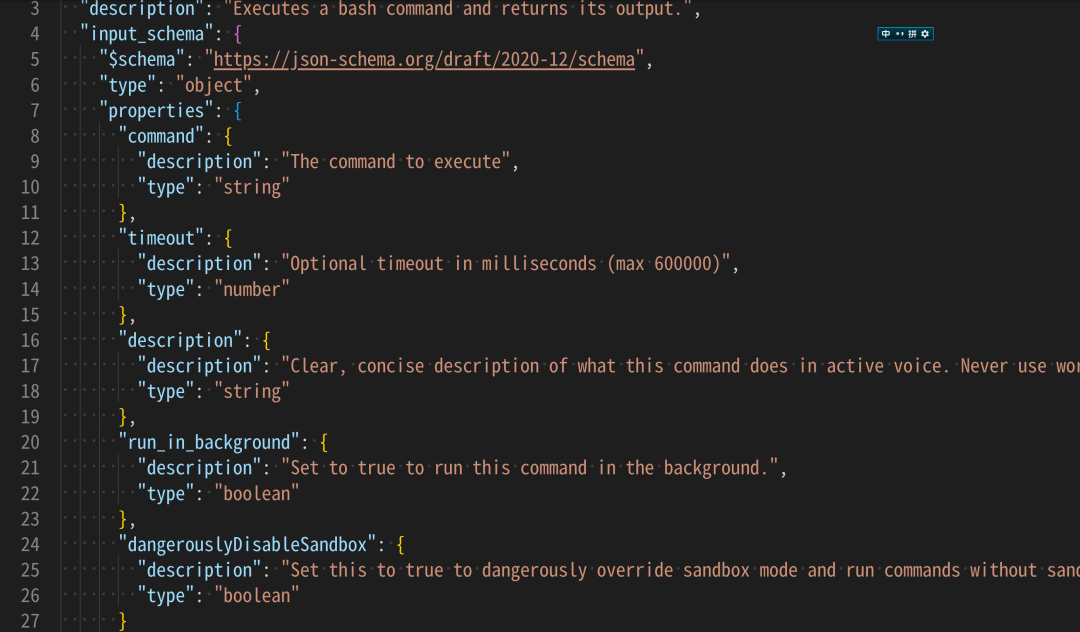
• 记忆(Memory):它是别人写的文本,不是模型内部知识,模型会全盘当真 所以记忆会旧,三天前的项目状态它还在用,还会互相冲突,多台机器各写各的,还会被一条错记忆带偏一辈子 关键是要让它能过期、能删、能分清事实和推测 • 摘要(Summary):会话太长就压缩,一压缩必然丢细节、丢边界条件 最要命的是,一旦总结出幻觉,等于把错误浓缩成一页纸,然后让模型每轮都用这页纸 • 计划(Plan):计划是开头那一刻需求的快照,需求一变它就过期了 而模型倾向于把计划当圣旨走完,不会主动说一句喂,前提变了 三样东西的病根其实一样:它们都只是被塞进上下文的普通文本,和用户消息、工具输出没有任何优先级区分 你不把谁说了算、什么时候过期、哪些只是参考写清楚,它们就是三颗定时炸弹 三、工具加得越多,为什么反而更笨 你有没有这种感觉:MCP、Skill 挂得越勤,Agent 越容易答非所问、调错工具,或者干脆脑补一个根本不存在的工具出来 原因从抓包里就能看出来:每次请求,所有工具的定义完整 JSON Schema,描述加参数都硬塞在上下文里 就比如真实请求里 bash 这一个工具的定义,长这样
{ "name" : "bash" , "description" : "Executes a bash command and returns its output." , "input_schema" : { "$schema" : "https://json-schema.org/draft/2020-12/schema" , "type" : "object" , "properties" : { "command" : { "description" : "The command to execute" , "type" : "string" } , "timeout" : { "description" : "Optional timeout in milliseconds (max 600000)" , "type" : "number" } , "description" : { "description" : "Clear, concise description of what this command does in active voice" , "type" : "string" } , "run_in_background" : { "description" : "Set to true to run this command in the background." , "type" : "boolean" } , "dangerouslyDisableSandbox" : { "description" : "Set to true to dangerously override sandbox mode and run commands without sandboxing." , "type" : "boolean" } } , "required" : [ "command" ] , "additionalProperties" : false } } 光这一个工具就是 20 来行、上百 token,而一次请求里要塞几十上百个这种定义 工具一多,模型每次决定下一步调什么,都是和一大堆无关工具说明一起想的 无关的描述不是安静躺着,它们会变成噪音,变成长得像正确答案的错误选项
做一下实际的测试:同一个模型(deepseek-v4-pro),分别只让它带 10 / 50 / 200 个工具,干同一件事,查看当前机器有没有 curl 每次配置里真正能执行 shell 的只有 1 个工具,叫 bash ,其余全是无关的(查天气、翻译、画图、查数据库这种) 看它能不能一次找对,以及每次花多少 token
结果有点反直觉:任务够干净时,哪怕给 200 个工具,它也能一次就找对 bash,一点没笨 但代价非常实在:工具从10涨到 200,单次请求的 token 涨了大概13倍 而且这些工具定义每轮循环都要重新读一遍,真实长任务里会被乘以几十次工具调用,这钱是实打实的 那变笨到底什么时候发生?我自己的判断是,别把锅全甩给数量 越多越容易脑补工具模型眼里有哪些工具只是一长串文字,不是可靠白名单,清单一长它就会记混,甚至自由发挥调个不存在的所以更准的说法得改一下:MCP 越多越笨,得拆成两句来听 越多越贵,越相似越容易错解药不是少挂工具