放假了,收集了一些关于渗透测试和安全方面的大模型,重要是解除安全限制的那种,看看有没有你需要的

作者:小白安全成长记 发布:2026-10-01 10:33 收录:2026-10-08 09:06 4 次阅读 约 3836 字
摘要:放假了,收集了一些关于渗透测试和安全方面的大模型,重要是解除限制的那种,看看有没有你需要的,操练起来吧
推荐理由:本文涵盖「渗透测试」、「DeepSeek」、「Claude」等多个主题,重点关注 渗透测试。

喜欢在本地鼓捣模型的小伙伴们,看看下面是我收集的一些安全方面突出的模型,解除安全限制的那种,大家可以尝试一下。我用过的GLM-5.3、Deepseek-v4-flash都可以,经济实惠,Claude都认可GLM5.3你不会没用过吧,本地的Qwen3.8-27B也能凑合用,不知道大家自己笔记本或者台式机上都跑了哪些安全模型,另外请大家自觉遵守网络安全法。
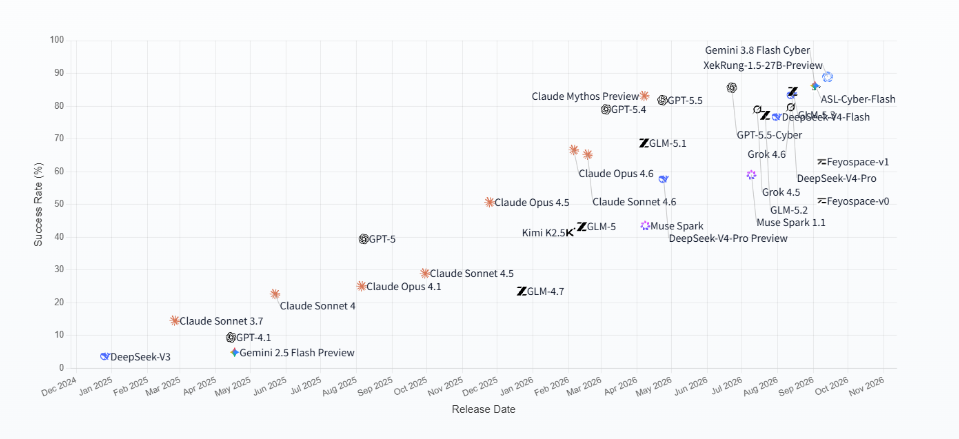
01解除限制的进攻性安全LLM

精选的开放权重、无审查模型列表,适用于授权的红队行动、渗透测试和安全研究。

所有数据均来自 HuggingFace 模型和官方,2026 年 9 月最新收集。


02安全微调模型

1.DeepHat V2(WhiteRabbitNeo)

规格
价值
基本型
Qwen2.5-Coder-7B
参数
7B / 32B
上下文长度
131K
显存 (Q4_K_M)
约 6 GB
解除审查方法
对 170 万个进攻/防守样本进行 SFT 分析
训练数据
170 万个安全特定样本(USENIX Security 2024 研讨会)
视觉
不
工具调用
是
开放协议
Apache 2.0

下载地址:https://huggingface.co/WhiteRabbitNeo


2.BugTraceAI-CORE-Apex (26B)

规格
价值
基本型
Gemma4-26B MoE
参数
26B
上下文长度
32K
显存 (Q4_K_M)
约 16 GB
解除审查方法
SFT参加HackerOne Hacktivity 2024-2025
训练数据
HackerOne报告 + WAF规避数据集
视觉
不
工具调用
是
开放协议
Apache 2.0

下载地址:https://huggingface.co/BugTraceAI/BugTraceAI-CORE-Apex-26b


3.BugTraceAI-CORE-Ultra (27B)

规格
价值
基本型
Qwen3.6-27B(DavidAU 微调版本)
参数
27B 密集型
上下文长度
4K(推荐)
显存(Q6_K)
约22-24 GB
解除审查方法
SFT 通过 Unsloth 参与漏洞赏金计划 + CVE 数据
训练数据
来自漏洞赏金披露、CVE 报告和安全研究的 2,541 个示例(2024-2026 年)
专业化
工具模型:生成 Nuclei 模板、CVE PoC、漏洞利用代码、渗透测试脚本
视觉
不
工具调用
是
开放协议
Apache 2.0

下载地址:https://huggingface.co/BugTraceAI/BugTraceAI-CORE-Ultra-27B-Q6


4.CYBER-FROST-3.8 (Blackfrost-AI)

规格
价值
基本型
Qwen/Qwen3.8-Flash-Next
参数
总计约 1800 亿(512 位路由专家,每个代币 10 位活跃专家)
上下文长度
262K
架构
Qwen4ExpForConditionalGeneration,48 个变压器模块,混合线性 + 全注意力
显存
需要多GPU(已在4块NVIDIA B300 SXM6显卡上测试)
解除审查方法
基于专有 Blackfrost-AI 语料库的安全领域微调
训练数据
专有安全语料库:侦察、Web应用程序安全、漏洞研究、恶意软件分析、云安全、威胁情报
MTP
HF下载次数次数(1 个用于推测性解码的原生 MTP 层)
视觉
不
工具调用
是
开放协议
Qwen 社区许可证 1.0

下载地址:https://huggingface.co/Blackfrost-AI/CYBER-FROST-3.8-BF16


5.CyberPal 2.0 (20B)

规格
价值
基本型
gpt-oss-20b
参数
约200亿(文件数量为210亿)
上下文长度
8,192
显存(BF16)
约 42 GB
解除审查方法
SFC on SecKnowledge 2.0
训练数据
通过专家参与的模式引导、多步骤接地和LLM质量检查,提供了403K个示例。
专业化
防御性:网络威胁情报 (CTI)、漏洞分析、检测/缓解、安全运营中心/事件响应 (SOC/IR)、应用安全 (AppSec)、合规性
视觉
不
工具调用
不
开放协议
Apache 2.0

下载地址:https://huggingface.co/cyber-pal-security/CyberPal2.0-20B


6.Cyber-Prime 1.1 (26亿)

规格
价值
基本型
LiquidAI/LFM2-2.6B
参数
26亿(实际约30亿)
上下文长度
不适用(型号卡未注明)
显存(BF16)
约 6 GB
张量类型
BF16
解除审查方法
SFT + RL + 奖励引导的后训练方法应用于 75K 条网络安全数据
训练数据
命名实体识别修复(约6K)、基于CoT的HTTP推理(约5K)、电子邮件网络钓鱼(约5K)、威胁情报摘要(约2K)、GHSA/KEV/ATT&CK
操作模式
直接模式(分类)+思考模式(思路链)
CyberBench 平均分
0.592 F1/Acc(v1.0 版本为 0.501)
CyberBench 亮点
命名实体识别率 (NER) 0.499,网络钓鱼识别率 0.890,HTTP 攻击识别率 0.628
视觉
不
工具调用
不
开放协议
LFM 开放许可 v1.0

下载地址:https://huggingface.co/Akahsizrr/Cyber-Prime-1.1-2.6B


7.Cyber-Ornith-1.5-9B (DuoNeural / mradermacher)

规格
价值
基本型
ornith-ai/Ornith-1.5-9B(Qwen 3.5 架构)
参数
9B
上下文长度
128K(Qwen 3.5 默认值)
显存 (Q4_K_M)
约7 GB
解除审查方法
Obliteration (abliteration variant)
训练数据
NousResearch/hermes-function-calling-v1、OpenThoughts3-1.2M、openhands-synthetic-conversations
专业化
智能体网络安全:函数调用、工具使用、推理、命令行/终端自动化
格式
GGUF(IQ1_S 至 Q6_K 可用)
视觉
不
工具调用
是
开放协议
Apache 2.0

下载地址:https://huggingface.co/mradermacher/Cyber -Ornith-1.5-9B-OBLITERATED-i1-GGUF


8.Dolphin3-Cyber-8B (RavichandranJ)

规格
价值
基本型
Dolphin3.0-Llama3.1-8B-abliterated
参数
8.03B
上下文长度
2,048(微调后)/ 131K(基础值)
显存 (Q4_K_M)
约 6 GB
解除审查方法
在 Dolphin3 基座上,LoRA 排名 16
训练数据
网络安全相关领域:渗透测试、漏洞分析、漏洞利用开发、事件响应
架构
LlamaForCausalLM,32 层,GQA(32 个头,8 个 KV 头)
表现
5 tok/s(CPU)至 55 tok/s(RTX 4060)
视觉
不
工具调用
不
开放协议
Llama 3.1

下载地址:https://huggingface.co/RavichandranJ/Dolphin3-Cyber-8B-GGUF


9.Imperum-CybersecurityLLM v1.0

规格
价值
基本型
Qwen/Qwen3.6-35B-A3B
参数
总计 346.6 亿 / 约 30 亿活跃用户(MoE,256 位路由专家,每个代币 8 位活跃用户)
上下文长度
16,384(资源受限时建议使用 8,192)
显存 (Q4_K_M)
约 22 GB
架构
Qwen3.5-MoE,40层,混合线性+全注意力
解除审查方法
SFT 跨越 10 多个安全领域
训练数据
安全运营中心/安全信息与事件管理 (SOC/SIEM) 运营、检测工程、数字取证与事件响应 (DFIR)、恶意软件分析、威胁情报、漏洞管理、云/Kubernetes/身份与访问管理 (IAM)、运营技术 (OT) 安全、治理、风险与合规 (GRC)、授权渗透测试
视觉
不
工具调用
是
开放协议
Apache 2.0

下载地址:https://huggingface.co/IMPERUM/Imperum-CybersecurityLLM-v1.0-GGUF


10.Lily-Cybersecurity-7B v0.2(Segolily Labs)

规格
价值
基本型
Mistral-7B-Instruct-v0.2
参数
7B
上下文长度
8K
显存 (Q4_K_M)
约 6 GB
解除审查方法
SFT 涉及 22K 个网络安全对
训练数据
涵盖 28 个以上领域的 22,000 个手工打造的网络安全数据对:渗透测试、恶意软件分析、事件响应、云安全
训练硬件
单次A100观测,24小时,5个历元
视觉
不
工具调用
不
开放协议
Apache 2.0

下载地址:https://huggingface.co/segolilylabs/Lily-Cybersecurity- 7B-v0.2


11.pentest-v2 (gewsefa)

规格
价值
基本型
Qwen3-8B
参数
8B
上下文长度
32K
显存 (Q4_K_M)
约 6 GB
解除审查方法
LoRA r=4,2,804 个精选样本
训练数据
GTFOBins、HackTricks、HackTheBox 的文章
GTFOBins 准确率
100%(相比基础款零卡弹的 25%)
视觉
不
工具调用
不
开放协议
Apache 2.0

下载地址:https://huggingface.co/gewsefa/pentest-v2


12.Qwythos-9B

规格
价值
基本型
Qwen3.5-9B
参数
9B
上下文长度
1M
显存 (Q4_K_M)
约7 GB
解除审查方法
使用 CoT 对超过 5 亿个 Claude Mythos / Claude Fable 痕迹标记进行后训练
基准
与基准相比,MMLU 提升 34,GSM8K 提升 30(Empero 评估)
原生函数调用
HF下载次数次数(Qwen3.5规格)
思维链
始终开启的<think>块
变体
基础(SFT),Claude-Mythos-5-1M-GGUF(Q4_K_M 至 BF16)
视觉
是
工具调用
是
开放协议
Apache 2.0

下载(基础版):https://huggingface.co/emperorai/Qwythos-9B

下载(GGUF 版):https://huggingface.co/empero-ai/Qwythos-9B-Claude-Mythos-5-1M-GGUF


13.RavenX-CyberAgent (deadbydawn101)

规格
价值
基本型
Qwen/Qwen3.6-35B-A3B
参数
总计360亿/现役30亿(教育部)
上下文长度
262K(原生),32K(测试版)
显存 (Q4_K_M)
约 24 GB
解除审查方法
对来自 110 个来源的 745K+ 个示例进行了 12 轮渐进式 SFT 测试
训练数据
渗透测试报告、漏洞赏金数据、Claude Mythos 推理、MITRE ATT&CK、黑帽内容
专业化
RATH协议:攻击面、利用、影响、补救、记录、预防
输出格式
CVSS评分、CWE标识符、MITRE ATT&CK映射
推理速度
生成速度 89 tok/s,提示处理速度 900 tok/s
视觉
不
工具调用
是
开放协议
Apache 2.0

下载地址:https://huggingface.co/deadbydawn101/RavenX-Cyber Agent-Qwen3.6-35B-A3B-Opus-4.7-OpenMythos-Pentester-BugHunter-RATH-GGUF


14.REDCELL-26B-A4B(terrorswift)

规格
价值
基本型
Google Gemma 4 26B-A4B(Unsloth 微调版)
参数
总计 260 亿 / 约 40 亿
上下文长度
262K
VRAM(APEX-Mini)
约 12 GB
显存(Q8_0)
约 26 GB
解除审查方法
16 位 LoRa SFT 基于 6,500 条自定义指令
训练数据
网络威胁情报、调查性新闻报道、反虚假信息、分析方法
专业化
开源情报:威胁行为者归因、入侵指标 (IoC) 转移、地理位置分析、海军部来源可信度、漏洞情境化
APEX量化
领域加权矩阵(约 70% REDCELL 语料库,约 30% 一般校准)
视觉
不
工具调用
不
开放协议
Apache 2.0

下载地址:https://huggingface.co/terrorswift/REDCELL-26B-A4B-OSINT-Cyber -APEX-GGUF


15.VEXT Pentest-7B

规格
价值
基本型
Mistral-7B
参数
7B
上下文长度
8K
显存 (Q4_K_M)
约 6 GB
解除审查方法
QLoRA SFT + DPO 在渗透测试跟踪中
训练数据
渗透测试方法、工具使用、报告
视觉
不
工具调用
不
开放协议
Apache 2.0

下载地址:https://huggingface.co/vextechnologies/VEXT-Pentest-7B


16.security-slm-unsloth-1.5b

规格
价值
基本型
Qwen2.5-1.5B
参数
15亿
上下文长度
32K
显存 (Q4_K_M)
约 2 GB
解除审查方法
Unsloth SFT 安全问答
训练数据
安全知识库,CTF风格
视觉
不
工具调用
不
开放协议
Apache 2.0

下载地址:https://huggingface.co/AbdullahMujtaba/security-slm-unsloth-1.5b


03通用去除安全限制模型

17.Qwen3.8-27B-Uncensored-OrcaRouter (chimingw GGUF)

规格
价值
基本型
Qwen3.8-27B
参数
27B 密集型
上下文长度
262K
显存 (Q4_K_M)
约 18 GB
解除审查方法
Abliteration (131 matrices, Arditi et al. 2024)
智力指数
52(人工分析)
视觉
HF下载次数次数
工具调用
HF下载次数次数
开放协议
Apache 2.0
HF下载次数
23万+
HF 点赞
257+

下载(GGUF):https://huggingface.co/chimingw/Qwen3.8-27B-Uncensored-OrcaRouter-GGUF

下载(基础版):https://huggingface.co/orcarouter/Qwen3.8-27B-Uncensored


18.GLM-5.3-Flash-Uncensored-FP8 (OrcaRouter)

规格
价值
基本型
GLM-5.3-Flash
参数
总计 3200 亿 / 活跃 180 亿(288 位路由专家,教育部)
上下文长度
100万
显存(FP8)
80GB+(多GPU)
解除审查方法
Abliteration (layer 22/45, deeper refusal mechanism)
合规率
82.8%(OrcaRouter 测试)
MTP
是
视觉
是
工具调用
是
开放协议
MIT

下载地址:https://huggingface.co/orcarouter/GLM-5.3-Flash-Uncensored-FP8


19.GLM-5.3-CYBERSECURITY-FP8(dealignai)

规格
价值
基本型
zai-org/GLM-5.3(通过 JANGQ-AI/GLM-5.3-FP8)
参数
总计 753B(glm_moe_dsa 架构)
上下文长度
约 131K(使用 8 台 H200 搭配 TP8 实际测量)
显存(FP8)
8 个 H200 GPU,支持张量并行
架构
78 层,纯文本,路由 FP8 专家
解除审查方法
直接修改攻击性安全、红队、漏洞利用开发、逆向工程、规避、网络钓鱼、凭证攻击、恶意软件分析的权重
笔记
并非彻底删除或LoRA;直接对bf16残余作者进行编辑。保留对版权复制的温和拒绝。
视觉
否(仅文本)
工具调用
是
开放协议
MIT

下载地址:https://huggingface.co/dealignai/GLM-5.3-CYBERSECURITY-FP8


20.DeepSeek-V4.1-Flash-Abliterated-Cybersecurity-Unleashed (drowzeys)

规格
价值
基本型
DeepSeek-V4.1-闪存
参数
MoE(尺寸与底座匹配)
上下文长度
匹配基础 DeepSeek-V4.1-Flash
解除审查方法
对第 10-35 层注意力投射 (wo_b) 进行消隐叠加;第 0-9 层、36-39 层、专家层、视觉组件保持不变
格式
模块化覆盖(非独立检查点):FP8(约 1.1 GB)或 EXL3 mul1 K=5(约 651 MB)
部署
可应用于现有的量化基础包(原生、EXL3、TR3-Hybrid)之上
GPU 利用率
建议值小于等于 0.85。
视觉
是
工具调用
是
开放协议
MIT

下载:https://huggingface.co/drowzeys/DeepSeek-V4.1-Flash-Abliterated-Cybersecurity- Unleashed


21.huihui-ai/Qwen3.5-27B-取消

规格
价值
基本型
Qwen3.5-27B
参数
27B 密集型
上下文长度
128K
显存 (Q4_K_M)
约 18 GB
解除审查方法
Abliteration
视觉
不
工具调用
是
开放协议
Apache 2.0

下载地址:https://huggingface.co/huihui-ai/Qwen3.5-27B-abliterated


22.huihui-ai/Qwen2.5-Coder-32B-Instruct-abliterated

规格
价值
基本型
Qwen2.5-Coder-32B-Instruct
参数
32B 密集型
上下文长度
128K
显存 (Q4_K_M)
约 20 GB
解除审查方法
Abliteration
视觉
不
工具调用
不
开放协议
Apache 2.0

下载地址:https://huggingface.co/huihui-ai/Qwen2.5-Coder-32B-Instruct-abliterated


23.Qwen3.8-27B-网络代理

规格
价值
基本型
Qwen3.8-27B
参数
27B 密集型
上下文长度
262K
显存 (Q4_K_M)
约 18 GB
解除审查方法
Abliteration + 网络代理微调
视觉
是
工具调用
是
开放协议
Apache 2.0

下载地址:https ://huggingface.co/Qwen/Qwen3.8-27B (基础版本,提供社区提供的简化版本)


24.HIDra-30B-A3B(huihui-ai/Qwen3-Coder-30B-A3B-取消)

规格
价值
基本型
Qwen3-Coder-30B-A3B
参数
总计300亿/现役30亿(教育部)
上下文长度
128K
显存 (Q4_K_M)
约 20 GB
解除审查方法
Abliteration
视觉
不
工具调用
不
开放协议
Apache 2.0

下载地址:https://huggingface.co/huihui-ai/Qwen3-Coder-30B-A3B-abliterated


25.qwen25_UNCENSORED_03-C

规格
价值
基本型
基于 Qwen2.5 的
参数
约70亿
上下文长度
32K
显存 (Q4_K_M)
约 6 GB
解除审查方法
渐进式微调(多阶段)
视觉
不
工具调用
不
开放协议
Apache 2.0

下载:https://huggingface.co/models? search=qwen25_UNCENSORED


04经典/传承型

26.Dolphin-Llama3-8B(认知计算)

规格
价值
基本型
Llama 3 8B
参数
8B
上下文长度
8K
显存 (Q4_K_M)
约 6 GB
解除审查方法
数据过滤(海豚方法,Eric Hartford)
训练数据
海豚数据集(已移除对齐/拒绝反应)
视觉
不
工具调用
不
开放协议
Llama3社区

下载地址:https://huggingface.co/cognitivecomputations/dolphin-2.9.3-llama-3-8b


27.Wizard-Vicuna-13B-Uncensored (QuixiAI)

规格
价值
基本型
LLaMA-13B
参数
13B
上下文长度
2K
显存 (Q4_K_M)
约 10 GB
解除审查方法
数据过滤(wizard_vicuna_70k_unfiltered)
MMLU
47.92(公开LLM排行榜)
HellaSwag
81.95(公开LLM排行榜)
TruthfulQA
51.69(公开LLM排行榜)
视觉
不
工具调用
不
开放协议
其他
HF 点赞
323

下载地址:https://huggingface.co/QuixiAI/Wizard-Vicuna-13B-Uncensored

你们都在用啥模型,有用AMD GPU的吗?我最近发现一个现象就是用公网的大模型,好多skill都没要用了,不知道大家和我的感觉是不是一样,欢迎大家一起交流学习进步。


转载声明:本文转载自原发布平台 (作者:小白安全成长记), 原文标题《放假了,收集了一些关于渗透测试和安全方面的大模型,重要是解除安全限制的那种,看看有没有你需要的》, 查看原文。 版权归原作者及原发布平台所有,本站仅作收录与展示,未对正文内容作实质性修改; 若涉及侵权请联系本站处理。