上期聊虚拟货币,结尾留了个预告:聊天记录里的隐语识别。这篇就是它。
为什么单独写这个题?因为涉网案件里,聊天记录是最大的检材,也是最容易"翻不动"的检材。上百万条消息堆在面前,涉罪内容几乎不用正常词写:网赌的写"菠菜",倒卖信息的喊"料",洗钱的叫"卡农""车手""水房",杀猪盘里人是"猪"、谈恋爱是"养猪"、骗钱是"杀猪"。你用关键词检索,搜"赌博""诈骗""洗钱",一条都搜不出来——不是数据里没有,是人家根本没这么写。黑话把关键词检索这条最省力的路堵死了。
一说到识别黑话,多数人的第一反应是:建词典。词典该建,但它永远是慢半拍的那个——打击一次,团伙换一批词,词典刚收完旧词,新词又出来了。真正跟得上黑话更新的,是统计:黑话的共同点是"不正常",在涉案语料里出现得不对劲。所以这期的核心判断是:
黑话识别的本质是找异常——词典认认识的,统计认不认识的,语境认定不准的,证据认认下的。
话不多说,直接开讲。
一、先拆解:黑话怎么藏进聊天记录
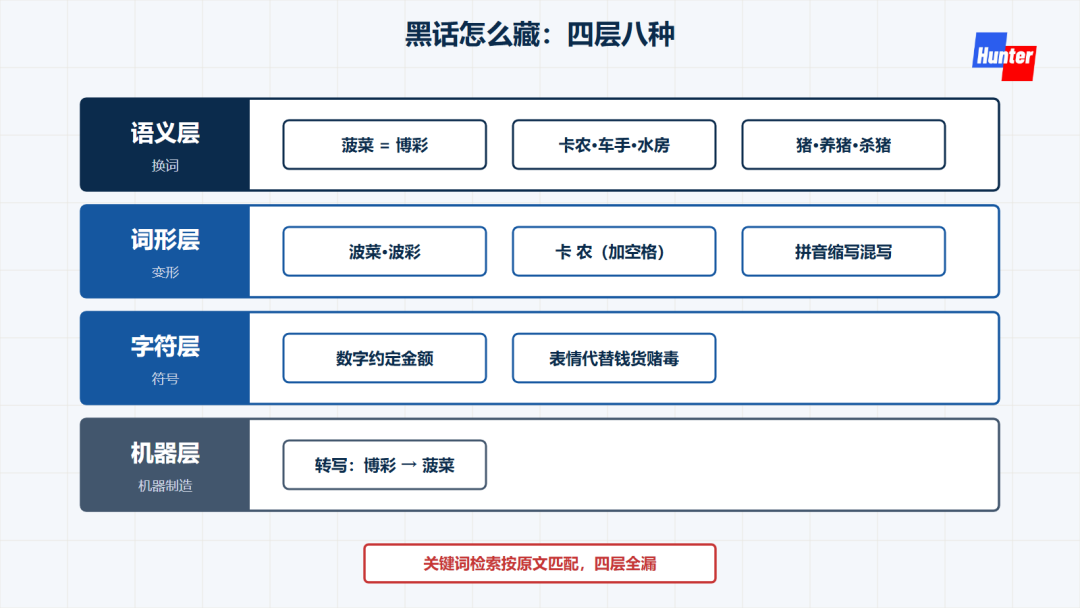
黑话不是一种东西,是一族东西。识别方法必须先按形态分层,一张表看全:
看这张表能得一个结论:想靠一本词典通吃,方向一开始就偏了。 每种形态都有绕过词表的办法,而绕过词表的办法,恰恰是识别它的线索——变体越多,说明团伙越认真在藏;藏得越用力,内部留下的痕迹越多。
二、黑话四查:从一句黑话到一份证据
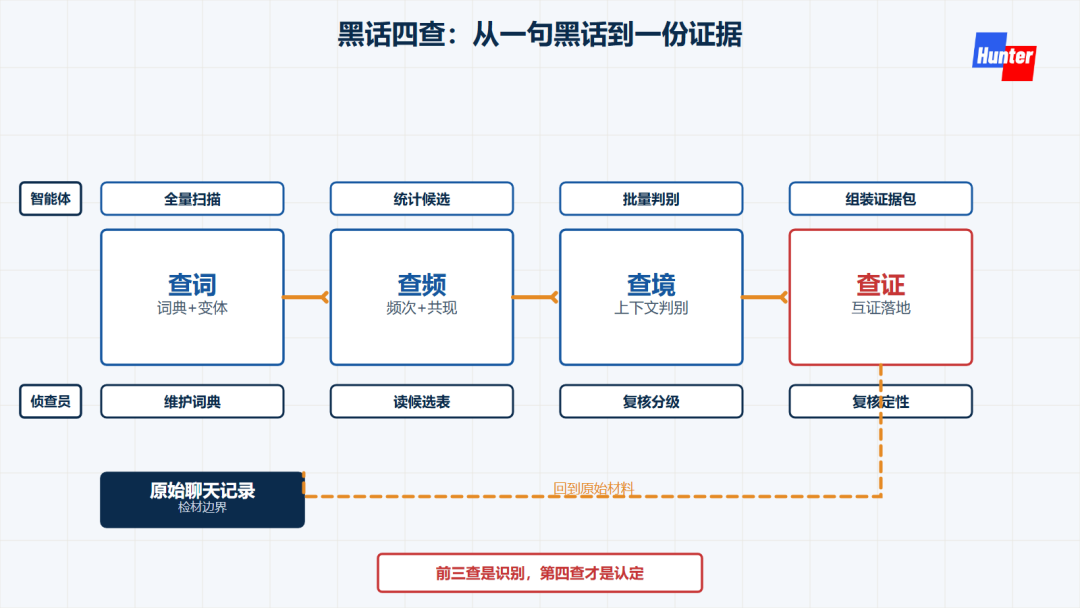
把形态学收成一套能照做的动作,四步:查词、查频、查境、查证。
第一查 查词:词典认得出来的
先做最笨也最该做的事:查词,是把已经认识的词收进词典,再用变体引擎把每一种写法都扫一遍。 词典按罪名分类建卷——涉诈、涉赌、涉毒、涉黄、两卡各一卷;变体引擎负责把"博彩"扩展成菠菜、波菜、bocai、加空格的"博 彩",一个词自动生成几十个候选去扫全量消息。
这活智能体干最稳:词典命中加变体扫描,上百万条消息几分钟跑完,每个命中词的出现位置全部标出来。人只做一件事:维护词典——把新案子里确认过的黑话补进去,把误伤的词剔出来。
坑在"变体是双向的":语音转文字会把"博彩"转成"菠菜",嫌疑人也会故意写"波菜",两种来源汇到一起,词典按原文匹配必然漏。所以变体引擎不能只收"已知写法",要按同音同义规则生成候选,把转写错误也当成一种变体来对待。
缺了这一查会怎样?已经认识的黑话全漏,后面每一查都在没打地基的楼上盖——查频把它当普通词滤掉,查境根本看不到它。
第二查 查频:语料里"不正常"的词
词典管认识的,那不认识的呢?新黑话、刚换的词、方言变体,词典里都没有,但有个共性:它在涉案语料里出现的频率,和正常聊天完全不搭。
查频,是不看词认不认识,只看它在语料里出现得正不正常。 做法是把全部消息分词,统计每个词的出现次数,再和一份正常语料对照:正常聊天高频的是"今天""嗯""哈哈",黑话词的特征是涉案语料里相对高频、正常语料里几乎不出现。再叠加两个信号:共现抱团——这个词总和金额数字、时间、人名、卡号、工具词一起出现;时间爆发——某个词在案发时段突然密集出现。
共现分析,学术上的定义是:通过统计文本中词语或概念共同出现的频率和模式,揭示其内在关联的研究方法。翻译成办案的话:看谁总和谁一起出现。 "今天"和"哈哈"共现一万次也没有侦查价值;"菠菜"和"上分""返水""晚上八点"抱团出现,即使词典里没有"菠菜",它也自己跳出来了。
智能体在这里干全量统计的粗活,人只读一张候选词表——高频且通用度低的词,按分值排序,一眼扫过去。坑有两个:一是垃圾词干扰,表情包里的字、群广告、游戏用语、地域口头禅都会制造假高频,要先洗一遍再统计;二是频次异常不等于涉罪,它只是"值得看一眼"的名单。
缺了这一查会怎样?新黑话全部漏光。词典更新永远慢半拍,查频是唯一不依赖词典的兜底层。
第三查 查境:上下文定身份
候选词捞出来了,但词本身不定身份,上下文才定。同一个"杀猪",屠宰群里是杀猪,诈骗群里是杀猪盘;"快餐"在餐饮群是盒饭,在特定语境里是另一种交易;"货"在物流群是快递,在涉毒语境里是毒品。一词多义,是黑话识别最大的干扰源。
查境,是把候选词的每个出现位置连同前后文抽出来,批量判别这一次是黑话、普通用词还是存疑。 判别交给大模型,但人先给它三个侦查信号:谁在说——群主、管理员、长期成员说的词,权重更高;对谁说;什么时间说——深夜、案发前后,比白天更可疑。
智能体干的是把海量候选压成少量待定:几万个候选词,经过查境,剩下几百个疑似、几十个确定,每个都带着上下文证据,人只需要复核高置信区间。
坑是误报会毁掉工具:如果判别把"今天天气真好"也标成黑话,侦查员点开两次就不再信了。所以结果必须分级——确定、疑似、存疑三档,宁可漏报也不要误报:漏报的靠查频兜底,误报的会连累整条线。
缺了这一查会怎样?误报淹没真实命中。侦查员被假线索折腾两次,整个工具就废了——工具最怕的不是不聪明,是不靠谱。
第四查 查证:互证落地,从线索到证据
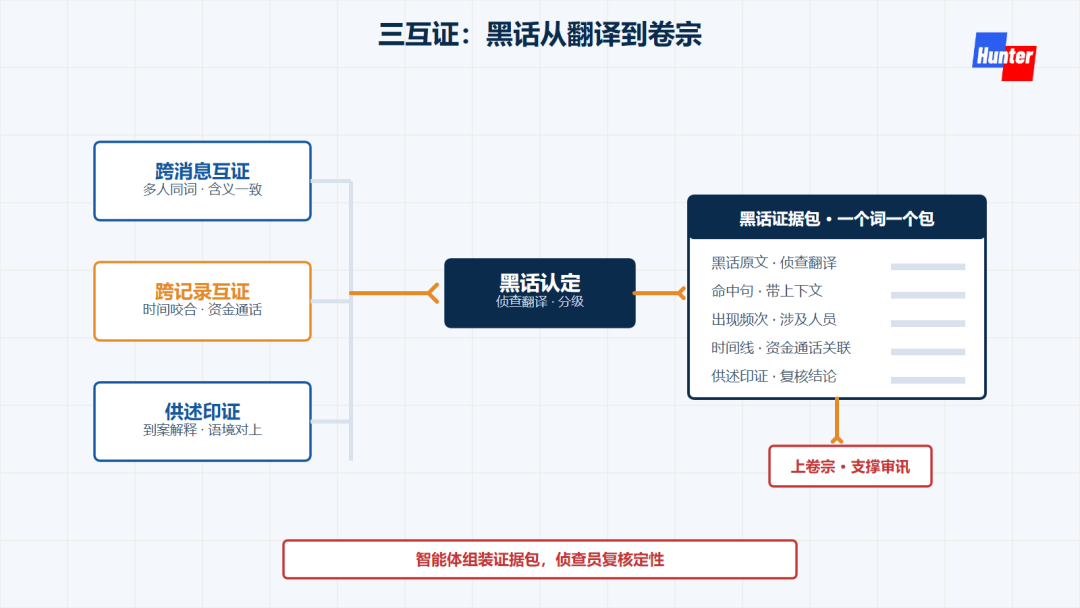
前三查都是识别,第四查才是认定。黑话命中再漂亮,本质是线索;线索要变成证据,必须三互证:
一是跨消息互证:同一个词在多个人、多个群里反复出现,且含义一致——一个人说"菠菜"可能是巧合,五个人在不同群里用同一个词指同一件事,是团伙内部约定。二是跨记录互证:黑话出现的时间和资金流水、通话记录咬合——聊天里说"今晚出货",当晚就有对应资金动作,这就是时间咬合(上期虚拟货币篇用过这个思路,这里照用)。三是供述印证:到案后嫌疑人对黑话的解释,和聊天语境对得上。
查证,是把命中句组装成可复核的"黑话证据包":一个词一个包——黑话原文、侦查翻译、全部命中句(带上下文)、出现频次、涉及人员、时间线、与资金和通话的关联。 智能体负责组装,侦查员只做复核和定性两件事。
坑是边界:智能体输出的"翻译"是侦查思路,不是司法认定。 黑话含义要落到卷宗上,靠的是原始聊天记录、嫌疑人供述印证,涉毒暗语这类专业黑话必要时委托鉴定机构出具意见。
缺了这一查会怎样?黑话永远停在"感觉"层面——破案时心里有数,写材料时拿不出手,上不了卷宗,也支撑不了审讯。
三、办案卡点速查表
四、边界与红线:程序比技术更硬
黑话识别的技术门槛不高,真正决定案件质量的还是程序合规。四条红线:
数据来源必须合法。 聊天记录属于公民个人信息,涉及通信秘密,必须依法定程序调取——调取证据通知书、扣押、勘验检查都行,唯独不能绕过平台自己拉。智能体再能扫,数据来源不合法,全案证据资格都受影响;识别得越准,来源问题越大。
智能体的"翻译"不是司法认定。 黑话含义的认定,要落在原始聊天记录、嫌疑人供述印证上;涉毒暗语等专业黑话,必要时委托鉴定机构出具意见。智能体输出的是侦查线索和检索结果,不是证据结论。
识别不等于定性。 高频命中只是疑似,不能据此抓人、定案。要有资金、行为、供述串成完整链条,"菠菜"才能从词频报告变成开设赌场案的证据。
扫描范围限死在检材内。 词典匹配会误伤正常词,"杀猪""快餐"都是日常词;批量扫描必须限定在依法获取的检材范围内,不做无差别全网扫描——既是对公民权利的保护,也是对自己卷宗的保护。
写在最后
黑话为什么难查?因为它把关键词检索这条路废了——搜"诈骗"搜不到,人家写的是"杀猪"。但换个角度:黑话是团伙的内部暗号,暗号越多,说明他们越认真地藏;藏得越用力,内部留下的痕迹越多。侦查员真正需要的,不是一本永远过时的词典,是一台会找异常的机器。
带走三样东西:
一个判断: 黑话识别的本质是找异常——词典认认识的,统计认不认识的,语境认定不准的,证据认认下的。
一个框架: 黑话四查——查词(词典+变体)→ 查频(频次+共现)→ 查境(上下文判别)→ 查证(互证落地)。
一套动作: 全量词频捞候选 → 变体引擎扩词 → 语境判别分级 → 证据包复核落地。
【申明】本文所涉聊天记录分析、黑话识别方法仅为法律知识与办案思路讲解,不得用于非法获取信息、不得超范围调查、不得冒充公职人员。演示数据不指向任何真实案件,智能体输出仅作辅助参考,不能替代人工核验与法定程序。