DeepSeek 正式发布并开源 DeepSeek V4.1 Flash。
API 价格:
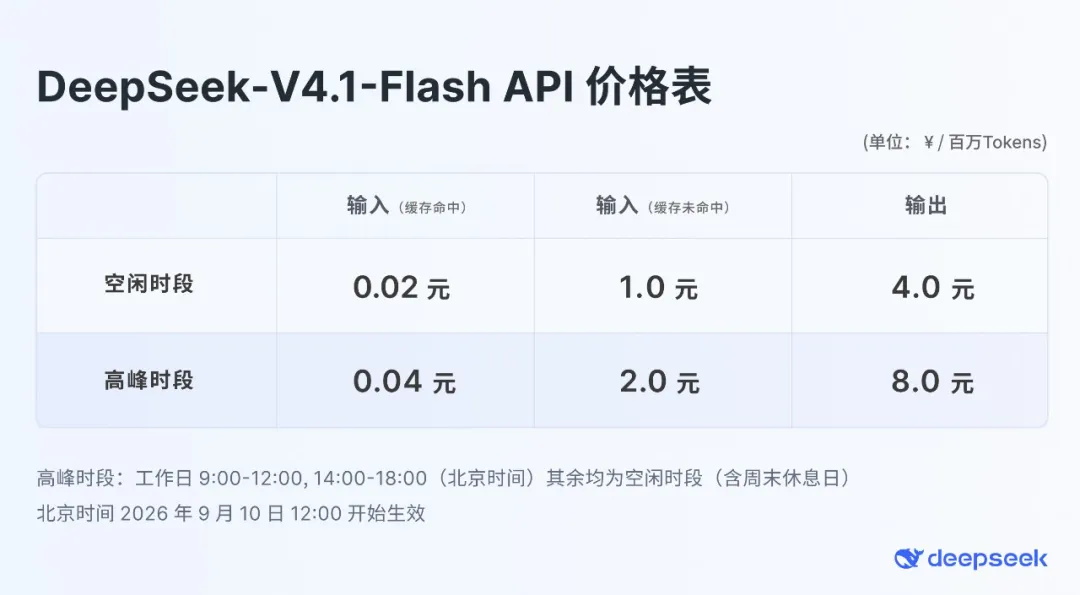
V4.1 Flash 支持百万 Token 上下文,此次更新的一项重点是「降低长上下文推理的缓存开销」。
论文:
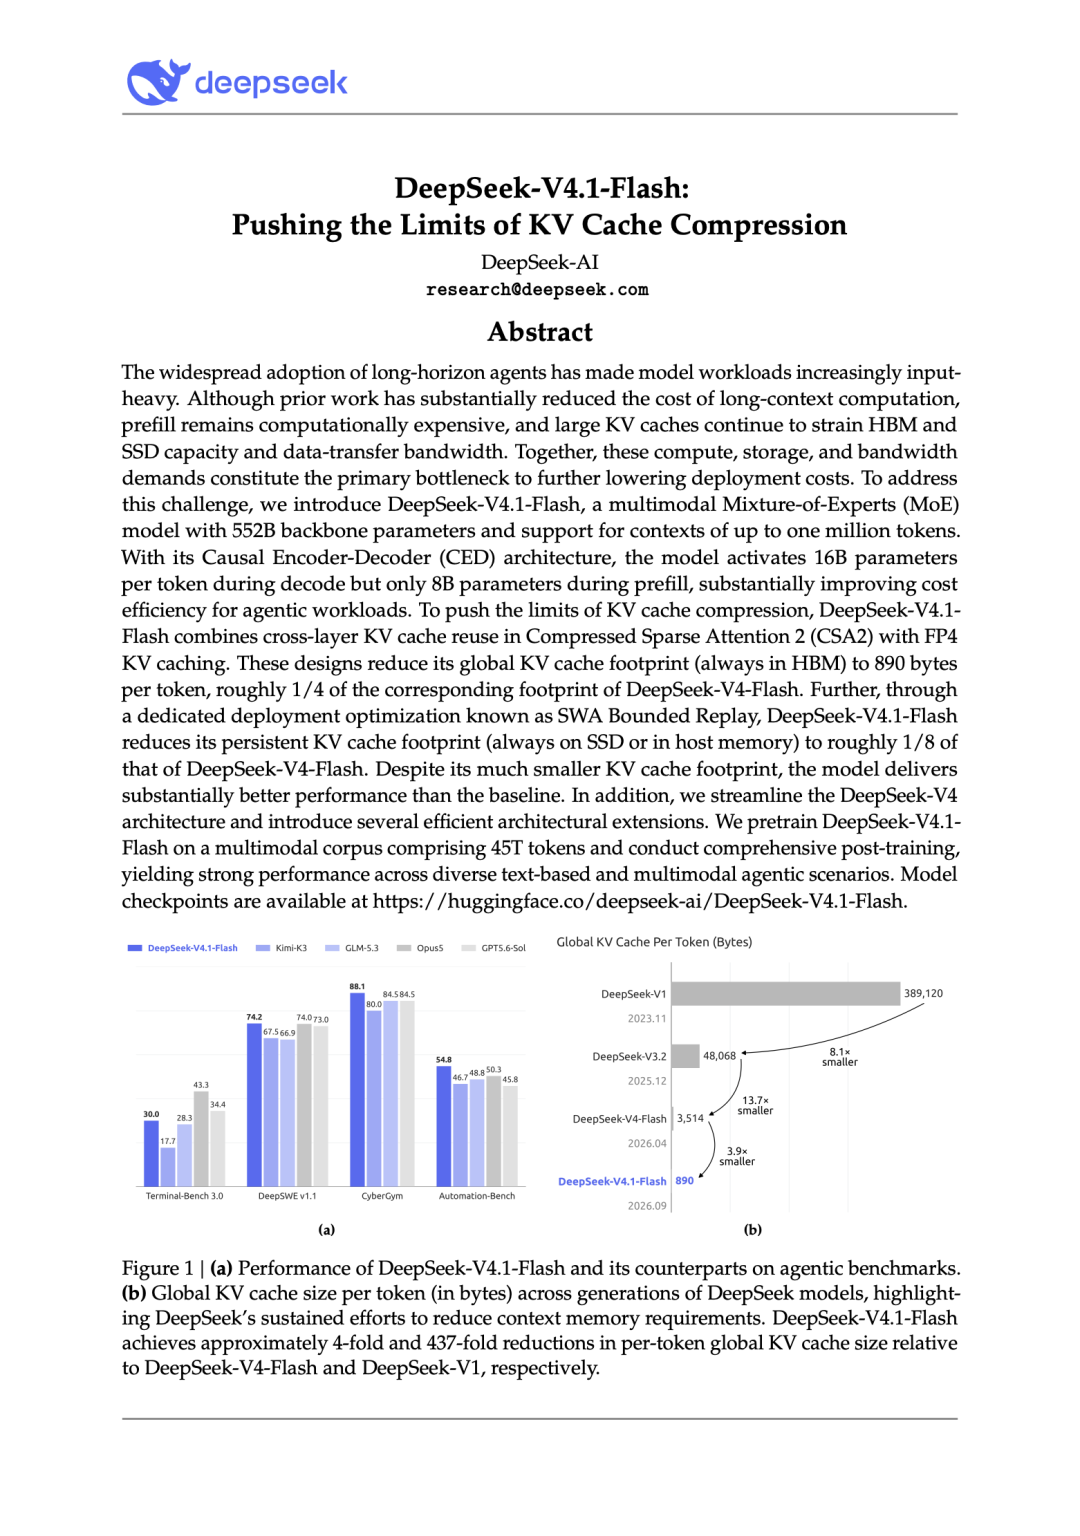
在相同上下文长度下,V4.1 Flash 将运行时常驻 HBM 的全局 KV Cache 压缩至每 Token 890 字节,约为 V4 Flash 的 1/4。
在相同工作负载下,存放于 SSD 或主机内存中的持久化 KV Cache 占用降至前代约 1/8。
这两个比例针对相应的 KV 缓存,并非整套模型所需的 HBM 和 SSD 总容量。
HBM 与 SSD,分别怎么省?
论文指出,模型推理需要同时处理全局 KV 缓存和滑动窗口注意力(SWA)的局部 KV 状态。固定窗口下,SWA KV 的运行时占用不会随上下文长度增长;Global KV 则会随着上下文长度增加,在足够长的序列中成为运行时 KV 缓存的主要部分。与此同时,用于前缀复用的持久化 KV Cache 还会占用 SSD、主机内存以及数据传输带宽。
V4.1 Flash 采用第二代压缩稀疏注意力机制 CSA2,将各注意力层静态划分为 Full、Reindex 和 Reuse 三种模式。Full Mode 生成新的 Main KV、Indexer K 和 Top-K 索引;Reindex Mode 复用前序层的 Main KV 和 Indexer K,只重新进行索引并生成新的 Top-K;Reuse Mode 则进一步复用已有的 Top-K 索引。通过跨层复用 Main KV、Indexer K 和 Top-K 索引,CSA2 同时减少了 KV 缓存存储和索引计算。
与此同时,V4.1 Flash 将 Main KV Cache 从 V4 的 FP8 改为 FP4。论文显示,这一变化本身即可将 Main KV 的存储占用近乎减半。配合 CSA2 的跨层复用,V4.1 Flash 最终将 Global KV Cache 压缩至 890 Bytes / Token,约为 V4 Flash 的 1/4。
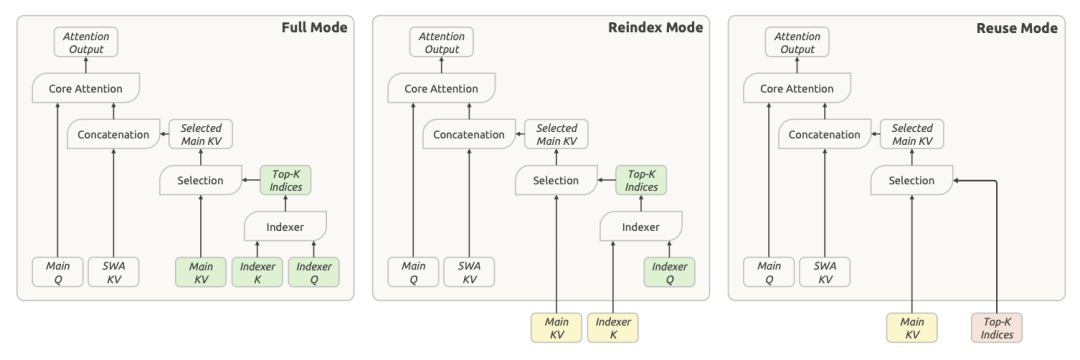
Decoder 还引入了 Hierarchical Sparse Indexer。首个 Full Mode 层仍会扫描当前可见的完整上下文,并生成一个候选池;后续 Reindex Mode 层只在这个候选池中重新打分和筛选 Top-K,不再重复扫描完整上下文。在候选池大小固定时,后续索引层需要评估的位置数量不再随着上下文长度线性增长。
SSD 侧的变化,则主要来自持久化 KV Cache 管理方式的调整。
在 V4 的部署方案中,SWA KV 约占持久化 KV Cache 容量的一半。V4.1 不再将 SWA KV 存入持久化 KV Cache,而是将其放入由每台机器约 10% 主机 DRAM 构成的分布式内存池中,TTL 只有分钟级;Global KV 则继续保留在持久化 KV Cache 中,生命周期至少为 72 小时。
当请求命中 Global KV、但对应的 Encoder SWA KV 已经缺失时,系统会触发 Encoder SWA Bounded Replay。它不会执行完整的 L × n_win Token 前向重算,而是只重放缓存前缀末尾最近的 n_win 个 Token,对缺失的 SWA 状态进行近似重建;此前已经命中的 Global KV 则直接复用,无需重新计算。
DeepSeek 表示,这种近似重建在其测试中对回答质量影响很小,因此可以用少量 Prefill 重计算换取更低的长期存储开销。再叠加 Global KV 本身压缩到 V4 的约 1/4,V4.1 Flash 最终将 Persistent KV Cache footprint 降至 V4 Flash 的约 1/8。
最终,V4.1 Flash 将 HBM 中的 Global KV Cache 压缩至 V4 Flash 的约 1/4;持久化 KV Cache 则降至约 1/8,并存放在 SSD 或主机内存中。
5520 亿参数,Prefill 只激活 80 亿
V4.1 Flash 的模型主体拥有 5520 亿参数,采用 Causal Encoder-Decoder,(CED)架构。
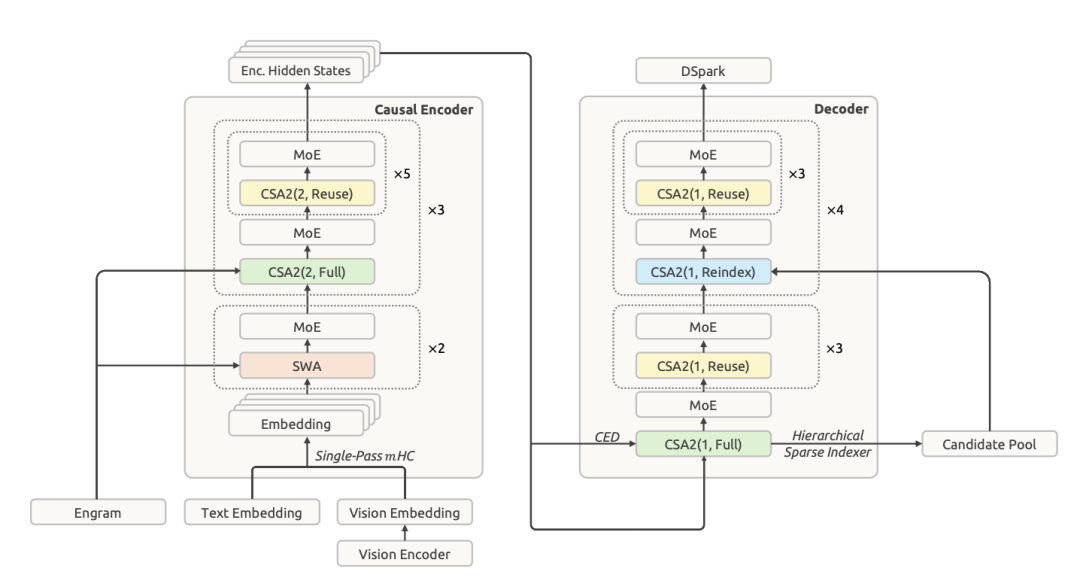
整个语言模型共 40 层,前 20 层为因果编码器,后 20 层为解码器。
CED 的关键变化在于,Decoder 的 Global KV 不再由各层自身的隐藏状态生成,而是直接由 Encoder 最后一层的隐藏状态投影得到。
这样一来,在 Prefill 阶段,大部分输入 Token 只需要经过前 20 层 Encoder;Decoder 侧只需为 SWA 处理最近一个滑动窗口内的 Token。对于远长于窗口长度的序列,官方称这一设计可以将 Prefill 计算量降低近一半。
V4.1 Flash 在 Prefill 阶段每 Token 激活约 80 亿参数,Decode 阶段则激活约 160 亿参数。
作为对比,V4 Flash 拥有 2840 亿参数,每 Token 激活约 130 亿参数。
V4.1 Flash 虽然模型规模更大,但输入阶段实际参与计算的参数反而更少。
每个 MoE 层包含 1 个共享专家和 384 个路由专家,每个 Token 激活其中 6 个路由专家。
此外,模型还有 1960 亿参数的 Engram 条件记忆模块,通过基于 Token 序列的稀疏查找访问;这部分参数不包含在上述 5520 亿参数中。
生成端采用 DSpark 推测解码,结合半自回归草稿生成和基于置信度的动态验证调度。残差连接部分采用 Single-Pass mHC,并配套 Mega-mHC 内核,将相关激活内存读写量降至原实现的一半。
原生支持图文,预训练规模达 45 万亿 Token
V4.1 Flash 支持图像、文本输入和文本输出。其视觉编码器 DeepSeek-ViT 从头训练,图像经视觉编码器和投影模块转换后,从预训练阶段开始就与文本共同进入语言模型。
新模型在包含 45 万亿 Token 的多模态语料上完成预训练。稀疏注意力从 64K 序列长度开始训练,累计训练至约 34 万亿 Token 时,上下文长度扩展至 100 万 Token。
后训练延续监督微调、强化学习与 On-Policy Distillation(OPD)流程。
DeepSeek 表示,此次没有引入新的后训练算法,主要投入集中在数据与环境建设,包括自动生成 Agent 任务、参考答案和验证机制,以及过滤、去重和难度校准。
部分 Agent 测试超过闭源模型
V4.1 Flash 支持以 1—100 之间的整数调整推理强度。
公开 API 提供 low、high、max 三档,分别对应底层强度值 50、75、100。
官方模型卡公布的主要 Instruct 对比成绩采用最高推理强度 100。
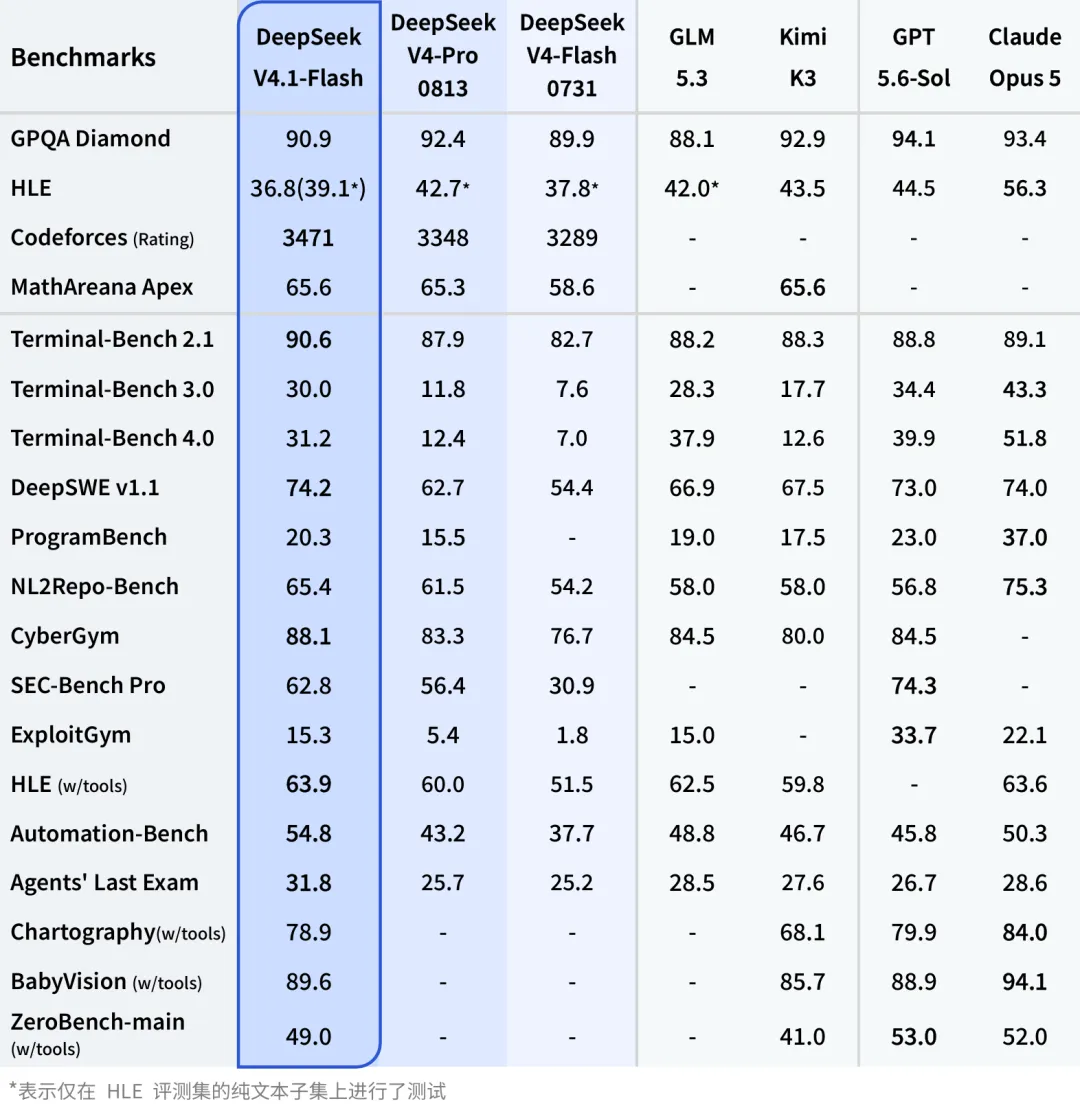
V4.1 Flash 在部分代码、自动化和 Agent 测试中得分更高,但在 GPQA Diamond、Terminal-Bench 4.0 等项目上仍落后于上述闭源模型。
云头条声明:如以上内容有误或侵犯到你公司、机构、单位或个人权益,请联系我们说明理由,我们会配合,无条件删除处理。