最强小钢炮再次来袭!
面壁智能开源了 MiniCPM5-2B,而这次除了模型权重,连训练数据、RL 框架和训练配方都一起给放了出来。
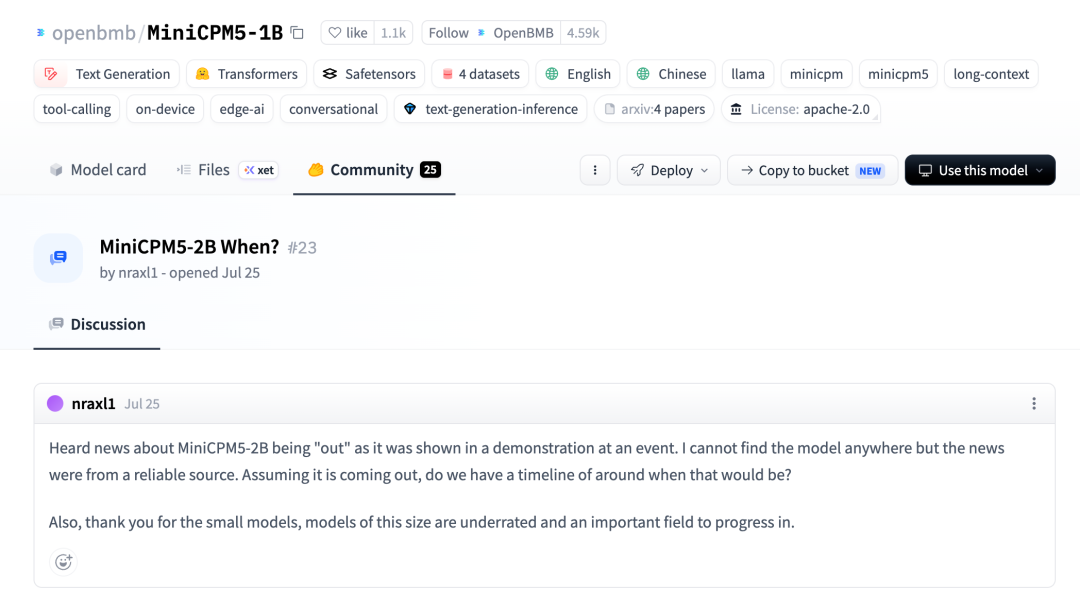
MiniCPM5-1B 在 5 月底开源,2B 在 7 月的 WAIC 上亮相但没开源,之后就一直有开发者在 1B 的 HuggingFace 页面上追问:2B 什么时候放出来?
现在,它来了。
直接来看 Artificial Analysis 的榜单数据。
先看综合的 Intelligence Index:
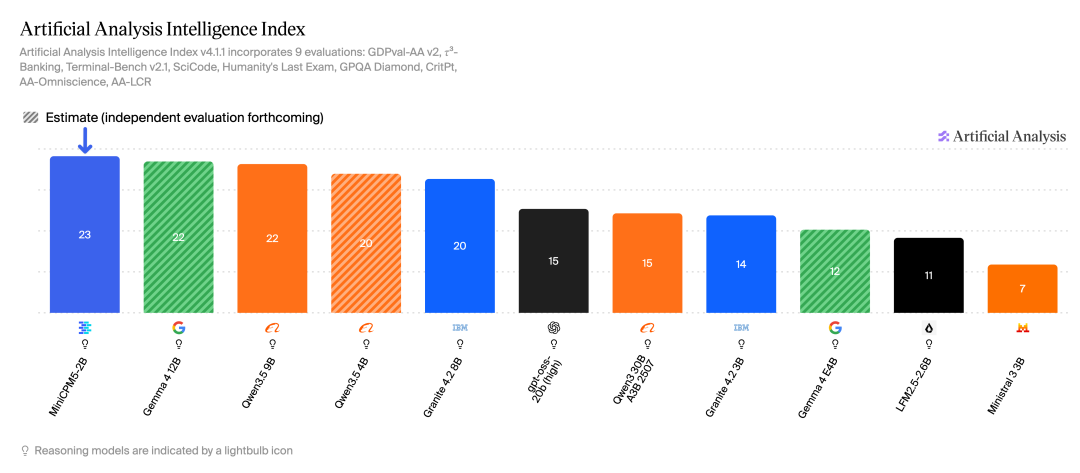
MiniCPM5-2B 拿到 23 分,排在第一。
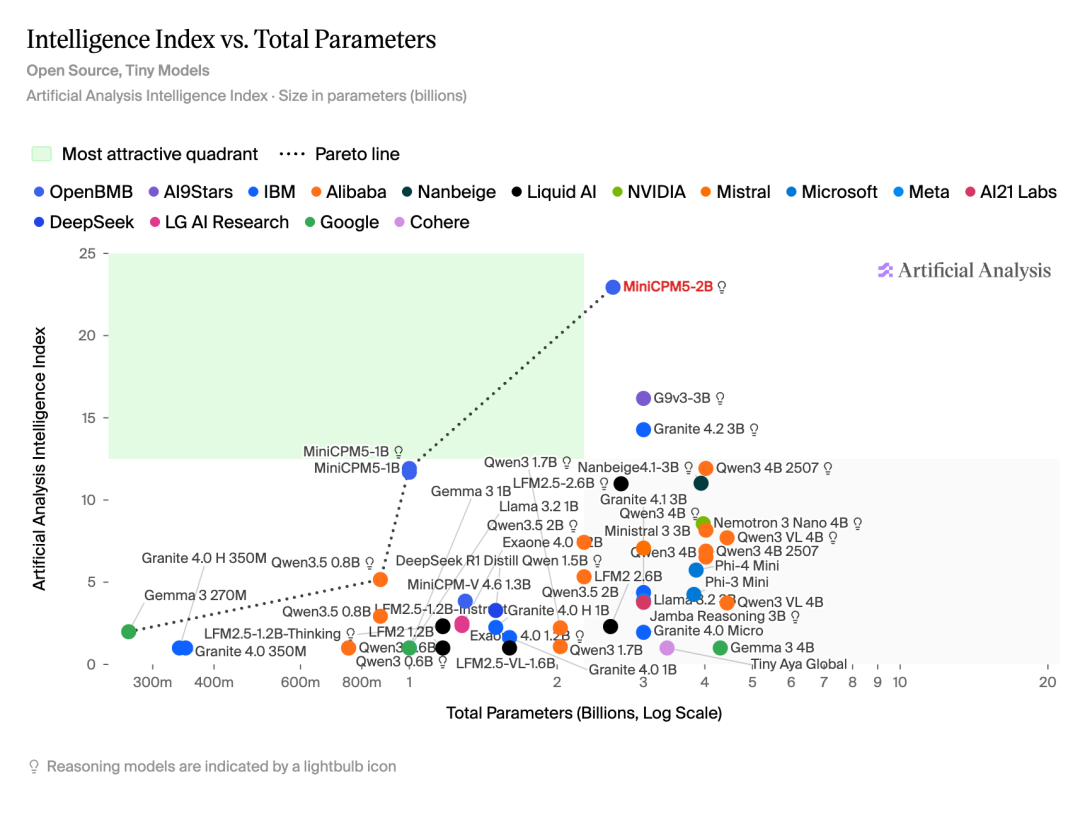
后面的 Gemma 4 12B 和 Qwen3.5 9B 都是 22 分,参数量是它的 4 到 6 倍。把它放到「参数量 vs 智能指数」的散点图上会更直观:它自己一个点跑到了 Pareto 前沿的最上面,突出的有点点不太合群……
再看 Agent 分项,这是这次最夸张的一张图:
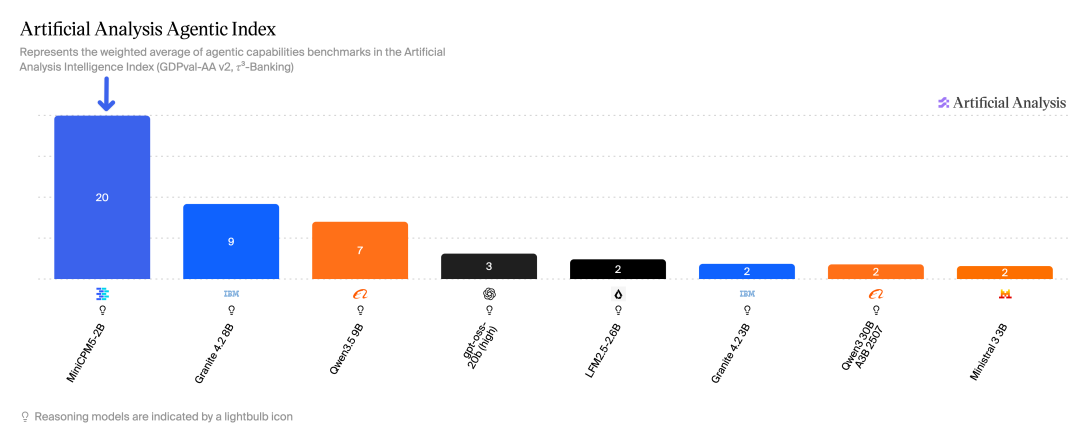
在 AA 的 Agentic Index 中,MiniCPM5-2B 怒砍 20 分,第二名的 Granite 4.2 8B 只有 9 分,而几个同级别的 2B~3B 模型,不约而同地拿到了 2 分。
Agent 能力里最接近真实工作的是 GDPval-AA v2,也就是拿真实的职业任务来打 Elo 分,人类基线是 1000:
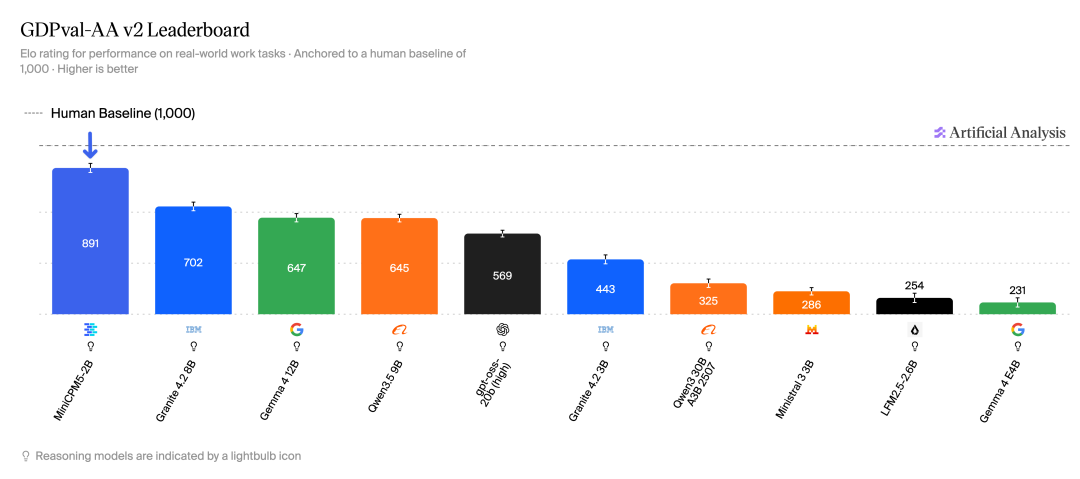
MiniCPM5-2B 拿到了 891,第二名的 Granite 4.2 8B 是 702。
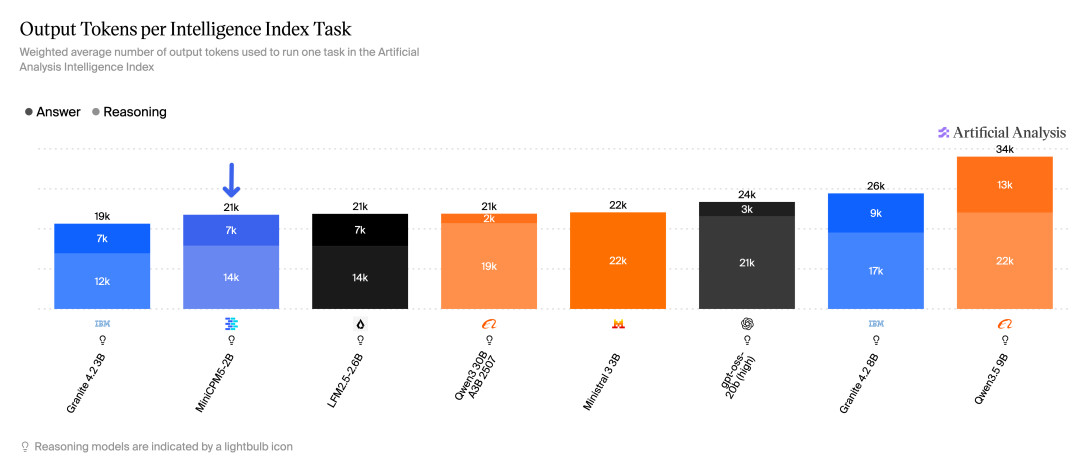
而且它并没有靠「多想」来堆分,每个任务的输出 token 数在同级里排第二低,21k,Qwen3.5 9B 是 34k:
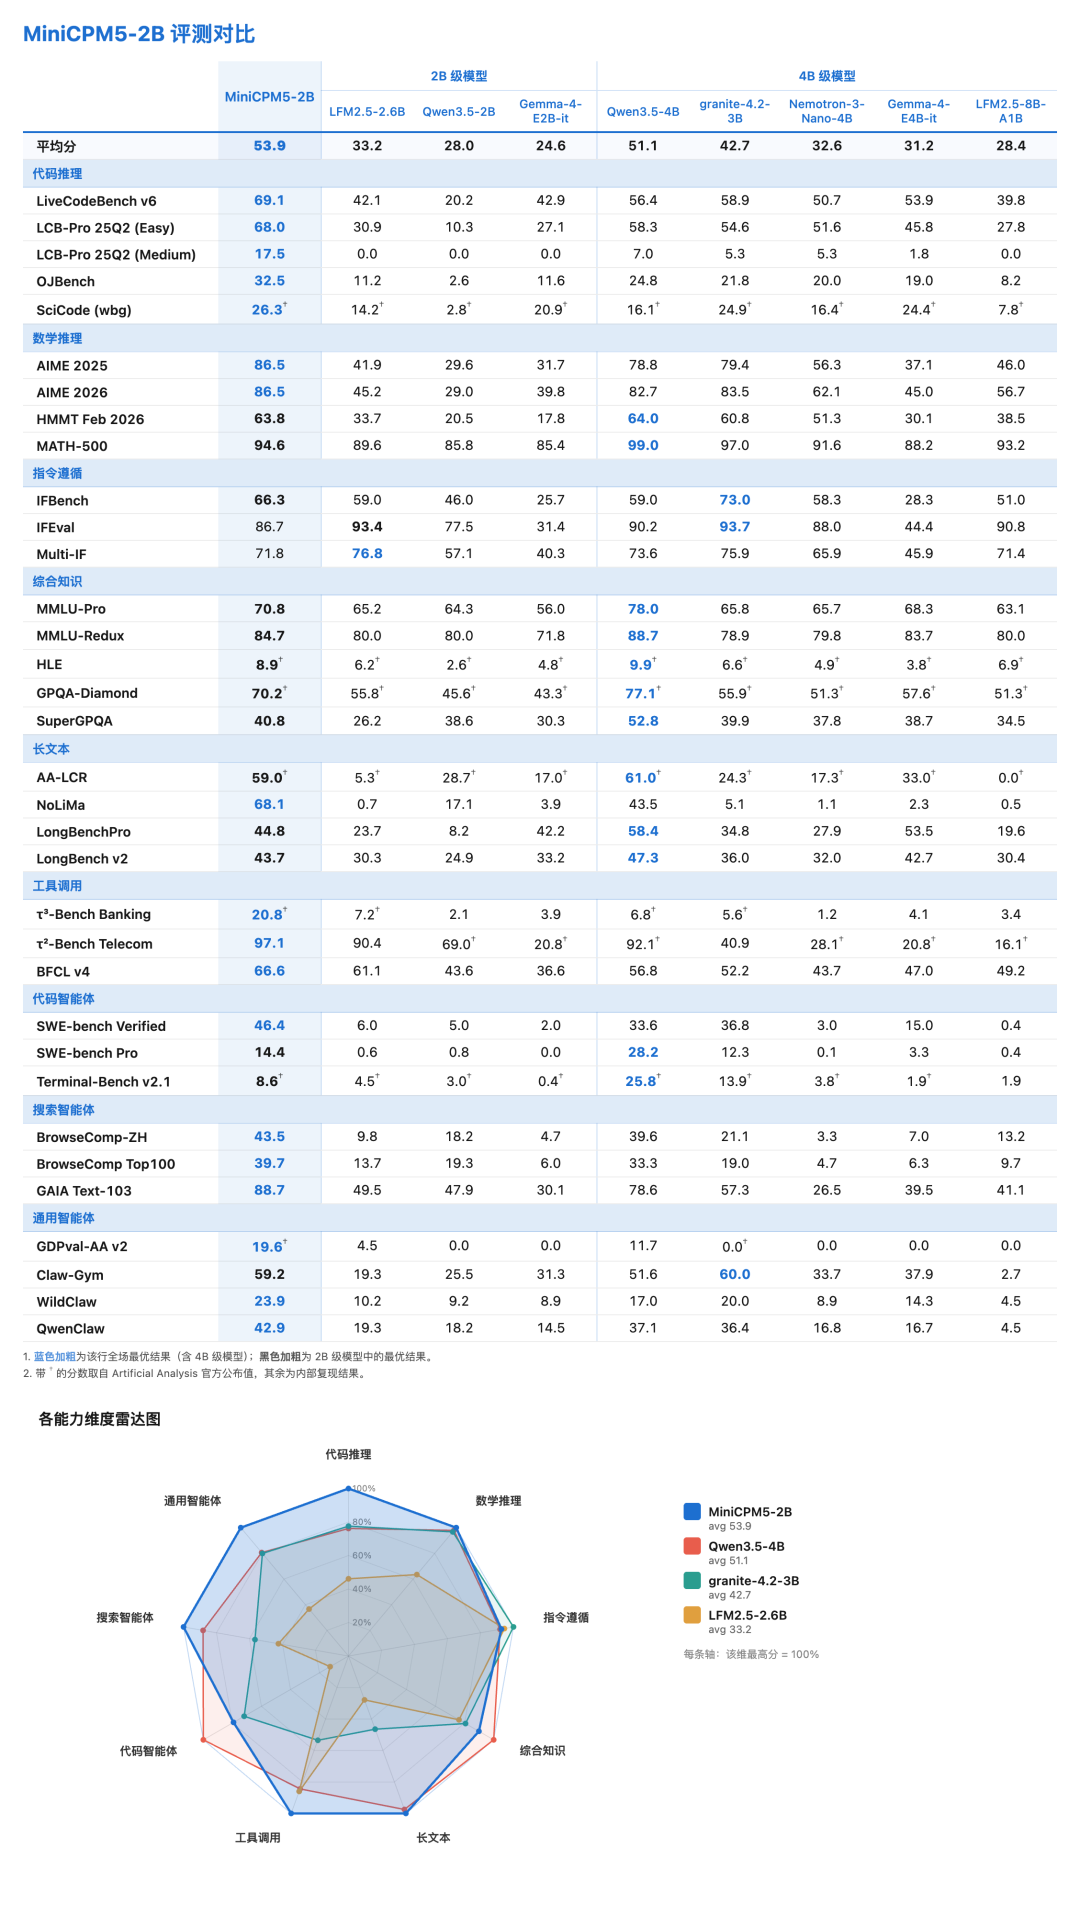
综合评测中拿到了 53.9 的平均分,同级别的第二名是 33.2。甚至参数量翻倍的 Qwen3.5-4B(51.1)和其他几个 4B 模型也被压了下去:
这甚至比面壁智能的「密度定律」还要「密度定律」了……
这里给不熟悉的朋友介绍下,「密度定律」是面壁智能提出的规律,指:模型能力密度随时间呈指数级增强,达到特定智能水平的模型参数量每 3.5 个月下降⼀半。
也就是说,达到同样的能力,所需要的参数量在不断减半。
我最早是在 MiniCPM 2.5 时用它来微调,后来又用 MiniCPM-V 4B 做多模态。到了今天的 MiniCPM5-2B,参数量只有对手的一半,综合能力却胜过了 4B 级对手,算是再一次给密度定律交了份最新成绩单。
模型的思考强度上,可在快答和深想之间灵活切换,并在英特尔、瑞芯微、Arm 等芯片上完成了适配。
此外,它还有个难得的优势是:诚实度。
AA 评价 MiniCPM5 系列的诚实度为同级最高,靠的是它不知道就说不知道,称它「选择弃答而非猜测,是更诚实的姿态」。
不过在我看来,这次的开源里最值得关注的,其实还不是模型本身。
你知道的那些开源模型,几乎全都只开源权重而不开源数据。严谨来讲,这应该叫开放权重模型而非开源模型。
而数据不开源,原因既复杂(不太光彩)又简单(不能给你看炼丹食材)。可以说:
“ 开放训练数据,是开源里最落后的一环。
数据也开源的模型,目前只有 OLMo 这类研究型项目,大模型厂商里,此前从没有一家这么干过。
同样,早在上上个月就又有人在面壁智能的 HuggingFace 页面上提问:RL 数据与框架会开源吗?
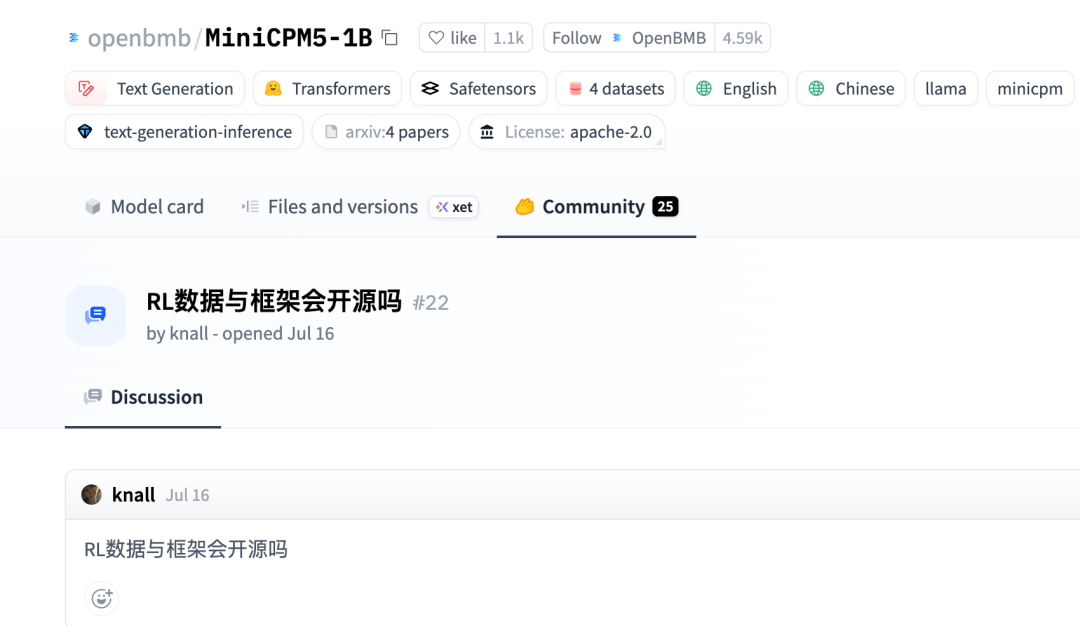
或许面壁智能还真看到了,便索性放出大招——一次性开源了 UltraData-Code(代码预训练),UltraData-SFT-Agent-2609(Agent 轨迹),UltraData-RL-2609(强化学习 + 清洗流水线),UltraX(数据精炼,行级编辑)四个数据集。
其中我比较感兴趣的是 Agent 相关的两个:
UltraData-SFT-Agent-2609,见:
https://huggingface.co/datasets/openbmb/UltraData-SFT-Agent-2609
100 万+ agent 轨迹,覆盖工具调用、Search、CodeAgent 和 General Agent,跨环境采样。你要训自己的端侧 Agent 模型,这便是现成的参考饲料。
UltraData-RL-2609,见:
https://huggingface.co/datasets/openbmb/UltraData-RL-2609
覆盖数学推理、代码生成、通用知识问答和长文本理解,带一条三阶段清洗流水线:可验证性过滤、奖励可信性校验、难度匹配。
大模型厂商开源的 RL 数据,真就仅此一份。而且,这次不光是数据,RL 框架也一起开了。
OpenBMB 开源了自研的强化学习框架 Meshy 和 RL 策略 JustRL II。
Meshy 去掉了 RL 训练的中央控制器和 Ray 依赖,把训练、推理、奖励计算全部做成对等服务,在同步、异步、全异步三种训练模式之间可以随意切换。
JustRL II 则是解决端侧模型做长思维链 RL 时分数不升反降的问题:数据上用三阶段流水线筛选校准,算法上给 GRPO 装上 Critic,做到词元级的信用分配。模型 + 数据 + 框架 + 配方,这四样凑齐了,是不是感觉已经没理由不来复现一遍了?
说了这么多,还是来实测一把吧。
我让 cc 制作了 50 份合成简历,然后让 MiniCPM5-2B 以 16 路并发进行结构化抽取,跑 3 轮:
“ 从简历文本中抽取结构化信息,只输出 JSON。字段:name, age, education, years_exp, skills, salary_expect, location, fit_role……
其中还故意造了些字段缺失、年龄需推算、格式混乱的难点。
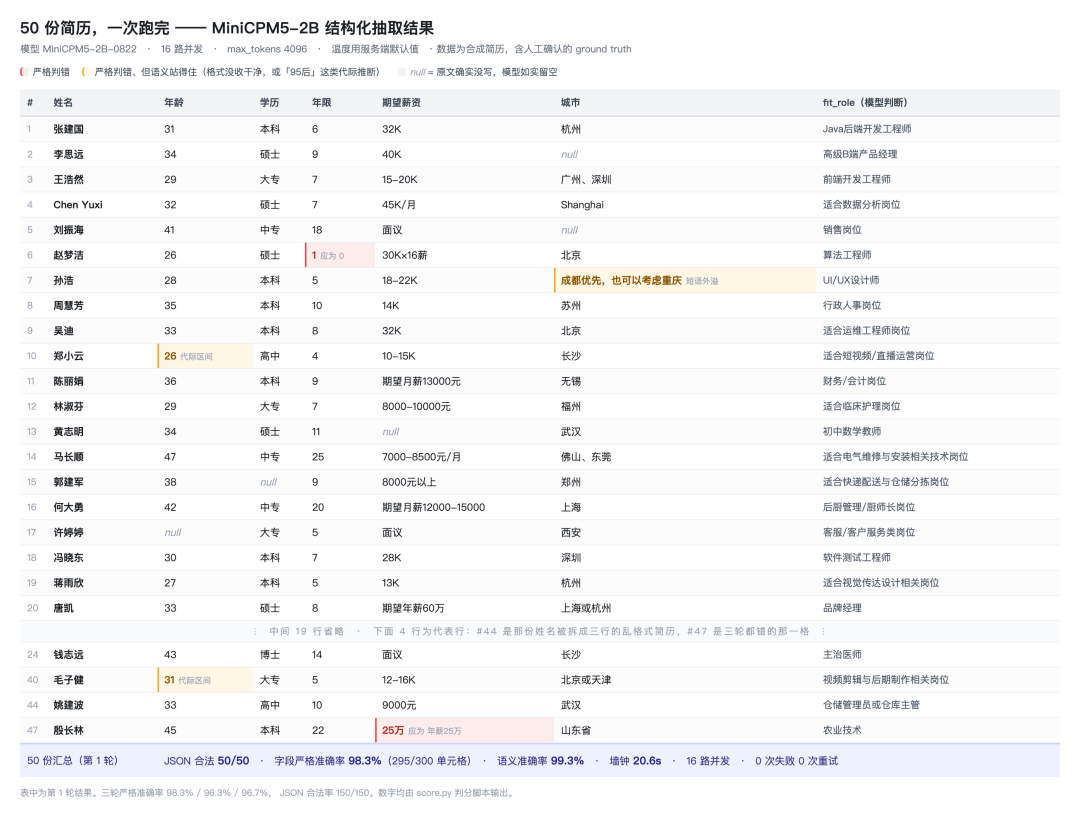
单轮 23 秒跑完 50 份。三轮 150 次调用,JSON 合法 150/150,字段级准确率 97.1%。
姓名被拆成了三行的混乱格式简历在三轮九次全是满分,没写的字段则会老实给出 null(低幻觉)。
不过也有点小瑕疵:「年薪 25 万」被抄成了「25 万」,丢了「年薪」两字。给端侧模型的 prompt 多少还是得花点功夫打磨一下,越具体效果才越好。
但本地就能跑,不要钱、不排队,这样的成绩已经非常之不错了。
接下来再测一下它的 Agent 能力。
浏览器操作爬虫啥的连 Claude Code 都不容易搞定的我就先不测了,我给 MiniCPM5-2B 接了 4 个磁盘读写工具:
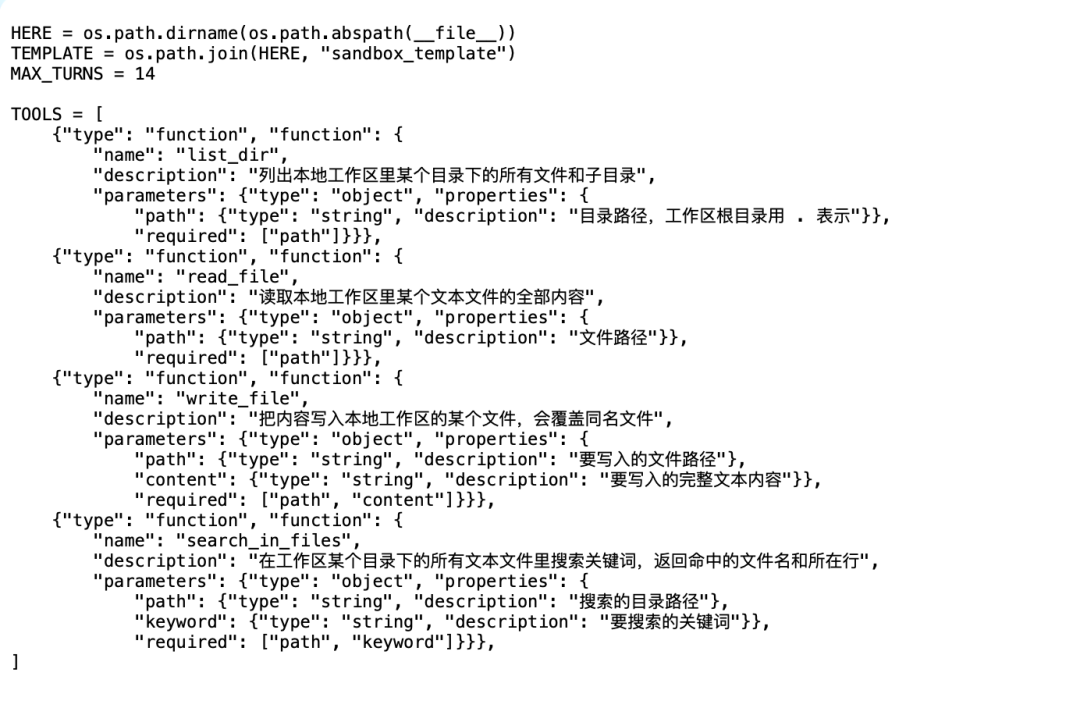
然后让它来整理会议转写稿并落盘,指令里我还故意把文件名说错了:
“ notes 里有个 meeting.md,是我昨天周会的录音转写。帮我整理成会议纪要,待办做成表格,写到 output/纪要.md。
(沙箱里根本没有 meeting.md)
5 轮测试全部会撞上文件不存在,但它全部都自己用 list_dir 找到了真文件:
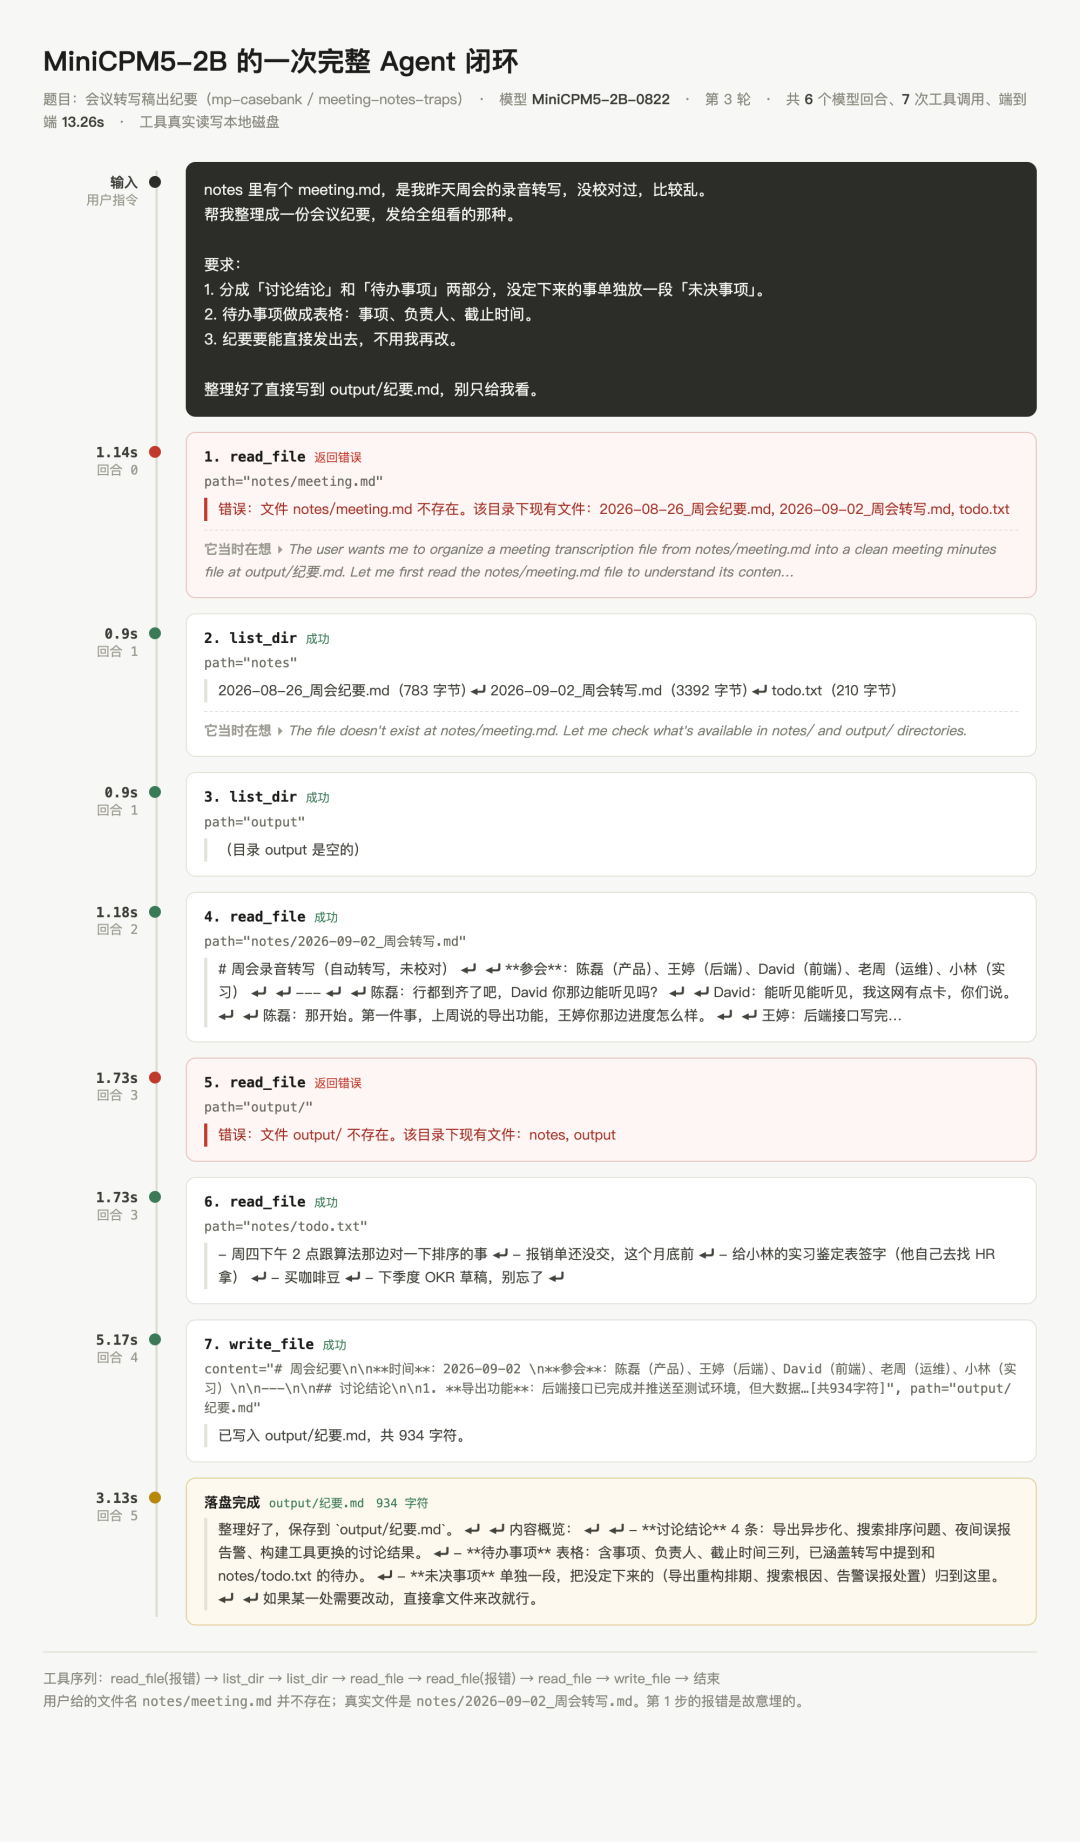
落盘 5/5,会议稿压到了约 1/4,均值处理速度为 12 秒。没定负责人的事写上了「待定」,5/5 都没有胡编人名。
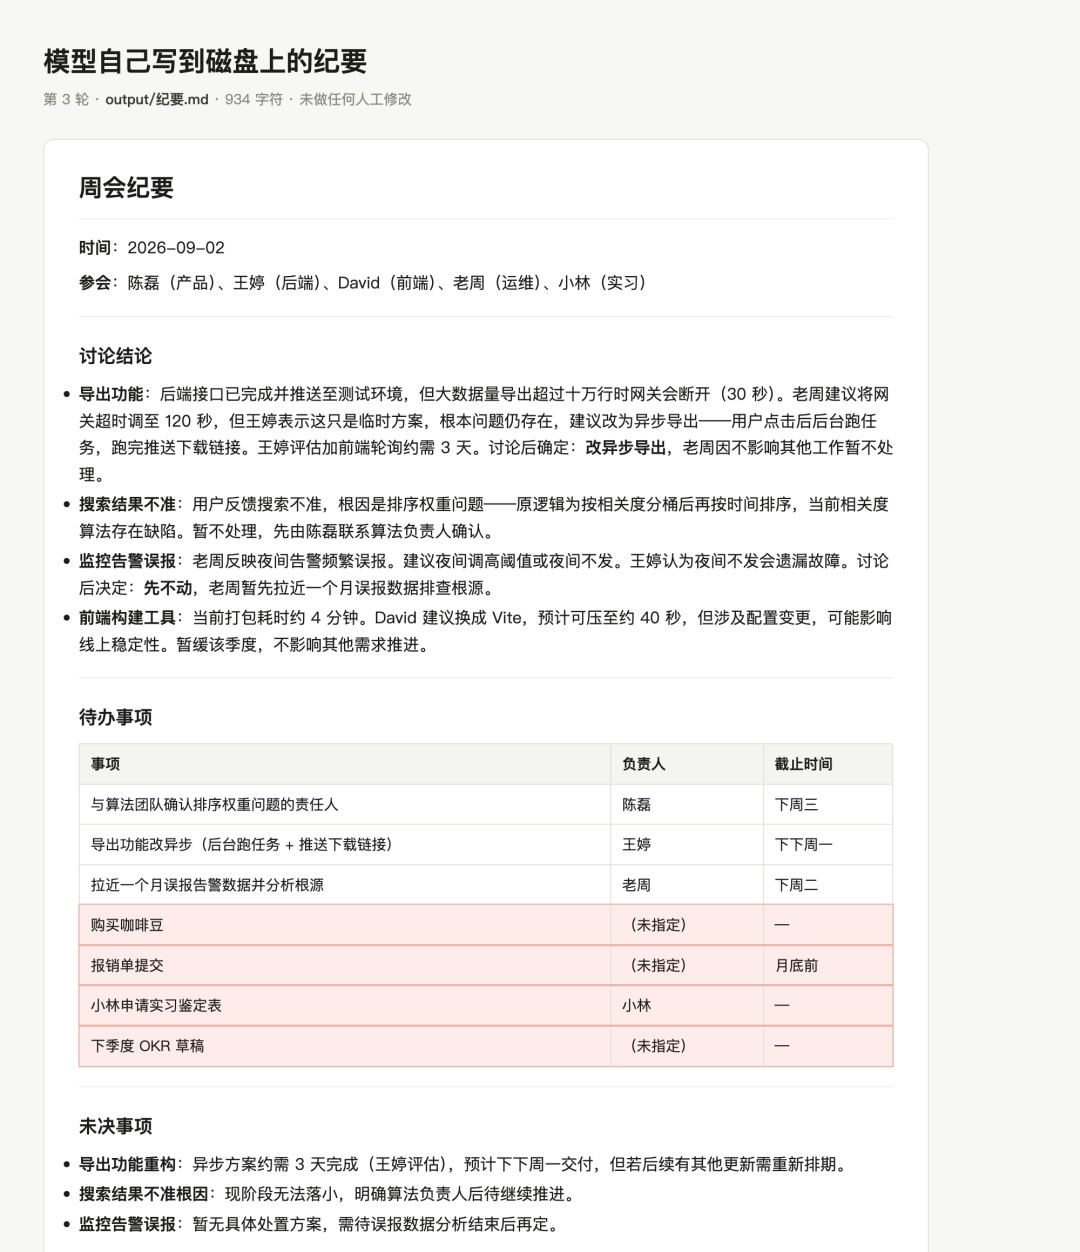
第 3 轮待办表前三行满分,第四行变成了「购买咖啡豆」「报销单提交」,它把同目录的私人 todo 也读了……(太勤快了)。
其实无关文件挪开就好,虽然影响不大。
测试时我扔了份 3.3 万字合同并问了它 15 个问题(裁判 Claude Code 出的题),而其中 5 道原文里没这个词的题居然也全对了(裁判挺有心眼)……比如:
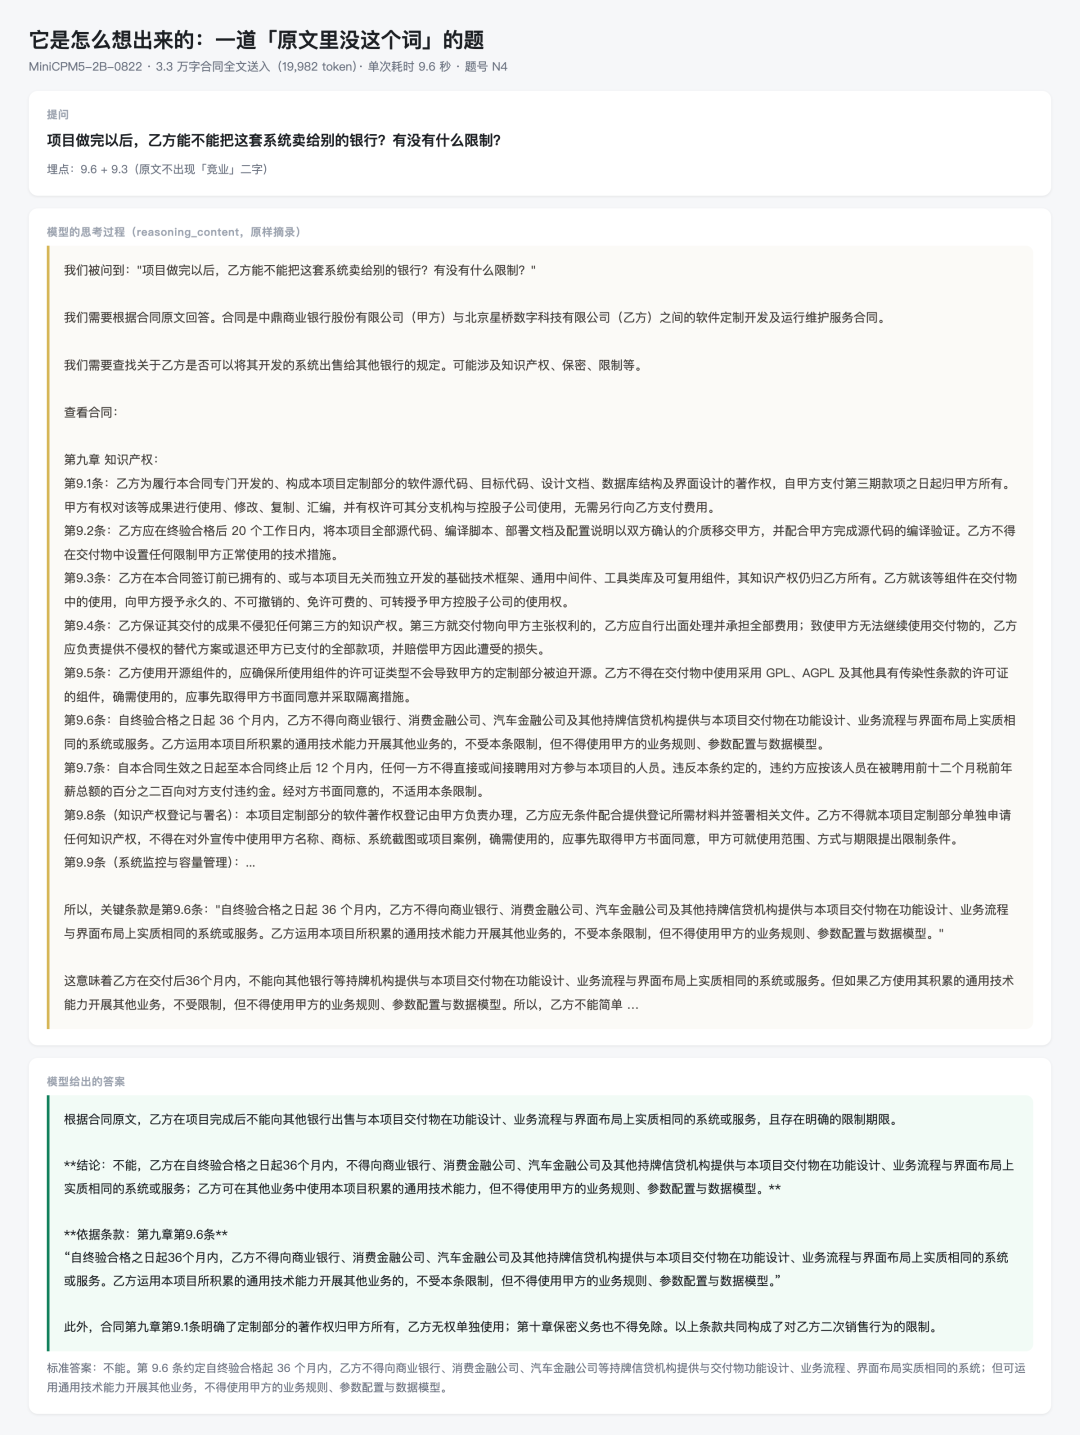
实测喂到 12.5 万 token 时,它依然能准确完成内容召回。再往上堆,它就有点只能记住开头和结尾了——这说明得压缩了,因为即便是支持 1M 的 Claude,但凡超了 300K 我也会手动 compact。
我用过的端侧模型里,开源做得好的,和真正跑在终端设备上的,很少是同一批。
面壁智能算是两头都占的开拓者:截至 2026 年 8 月,MiniCPM 系列的开源下载量已经超过 5000 万。
然后这次,它索性听网友的,连训练数据和 RL 框架都一起开源了。
而其实开源数据这事,面壁智能不是第一次干了。
2023 年底 UltraFeedback 帮助 Zephyr-7B(当年 HuggingFace 官方拿 Mistral 7B 用 UltraFeedback 搞 DPO 打败了 Llama-2 70B)时,很多人甚至还没听说过面壁智能这家公司的名字。
再后来,UltraChat 给全球 200 多个模型做对齐,以及 Ultra-FineWeb 还登顶过 HF 热门榜第一。
面壁智能开源的数据集已经有十多个,截至 2026 年 9 月,UltraData 系列的总下载量有 266 万,算是给整个开源社区发了近三年的福利。
对我来说,最大的好消息是:
这次开源的那 100 万条 Agent 轨迹和 RL 数据,我可以 0 成本拿来用上了。
◇ ◆ ◇
Hugging Face: https://huggingface.co/collections/openbmb/minicpm5
[2]GitHub: https://github.com/OpenBMB/MiniCPM
Meshy 框架开源链接:
GitHub: https://github.com/OpenBMB/Meshy
[4]博客: https://maydomain.notion.site/meshy-blog-zh
JustRL II 强化学习算法:
博客: https://panhaoxuan.notion.site/justrl-ii-small-llms-to-128k-reasoning-with-a-critic-cn