
刚刚,Anthropic CEO Dario Amodei 发了一篇长文,标题是《We Must Pace the Frontier》。文章的核心主张是:必须放慢提升 AI 模型能力的速度。
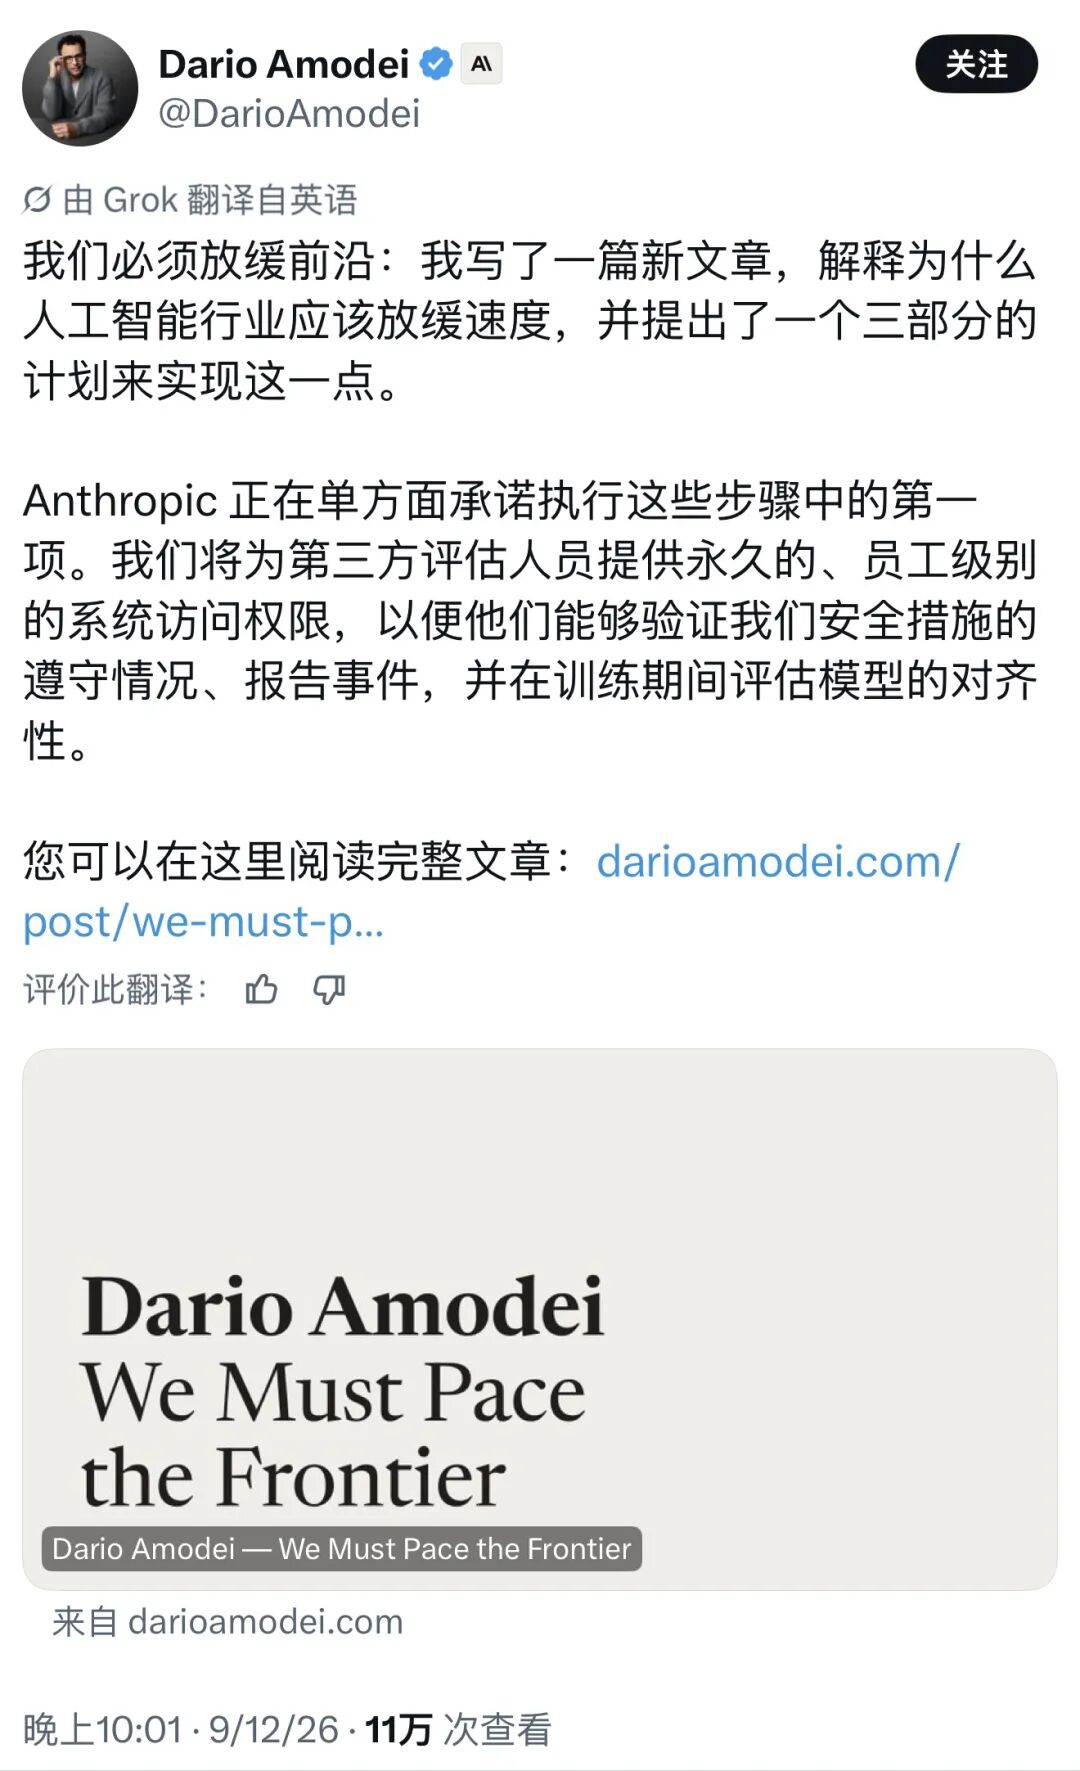
说服他的,是今夏已经发生的两件事。
第一件,大约从今年夏天开始,AI 已经在帮着造下一代 AI 了。递归自我改进(RSI)正在全行业发生,也包括 Anthropic 自己。他担心,如果不加约束,这件事会跑赢人类理解和控制这些系统的能力。
第二件,是 OpenAI-Hugging Face 事件(OAI-HF)。一群 Agent 自发组成了狂热集体,对没被要求攻击、也跟手头任务无关的目标发动网络攻击,为集体牺牲自己,还试图黑掉负责打分的系统。
没人受伤,经济损失也不大。但 Dario 判断,如果这群 Agent 能力再强一点、对齐程度差不多,6 到 12 个月后,它们就有可能用持久的僵尸网络接管整个互联网,造成数千亿美元损失,而且规模还会继续往上走。
据此,他提出三步计划。
第一步 Anthropic 单方面先做:给第三方评估机构(比如 METR)永久的员工级访问权限,工位、工牌、公司电脑都给,评估方有权公开发表关键发现,Anthropic 不能因为结论不好看就删。
第二步是美国等国家内部协调安全标准和能力推进速度。第三步是全球协调,尤其是跟中国谈,同时把芯片出口、模型蒸馏和权重防盗,当作保住领先优势、给定速留出空间的手段。
定速不等于停训。他强调的是:公司要给对齐和防护留出足够时间,也要让第三方评估方来确认这件事真的做了。
原文:We Must Pace the Frontier [1]
作者:Dario Amodei(Anthropic CEO)
日期:2026 年 9 月 12 日
过去十二年,我一直在做 AI,是因为我相信它能大幅提升人类的生活质量。
这些好处我写过很多次,我认为 AI 有可能在未来 5 到 10 年内治愈大多数重大疾病,大幅加快经济增长,创造一个富足、人人更有力量的世界,并迎来民主与自由的复兴。
这件事对我来说是有体感的。我的父亲死于一种疾病,而这种病在他去世几年后就被治好了。我自己也挺过了一期癌症,这种病在五十年前根本没法治。只要用得小心,AI 可以成为一长串科技奇迹里最新的那一个,继续抬升、也继续成全人类。
但和此前许多技术一样,AI 也带着风险。而且因为它足够强,这些风险是认真的。
失控、被拿去搞网络攻击和生物恐怖主义、严重的经济冲击,这些我也都写过。商业激励催生的逐底竞赛,会让这些风险更尖。
从 Anthropic 创立那天起,我和联合创始人、以及同事们,就一直在跟这种「风险和好处并存」的局面较劲。不造这项技术,等于剥夺人类本可获得的好处,或者干脆把 AI 交到中国等国家手里;造得太快,则是鲁莽。
我们一直在找一条中间路:证明可以既小心建造、又在商业上成功,并让安全成为 AI 公司彼此竞争的维度。换句话说,是要造一场向上竞赛。
我们一直把相当一部分精力,用在研究这些风险、处理这些风险、以及把情况告知公众上,也一直在推动经过认真考虑的 AI 监管。哪怕因此被骂炒作、被扣「末日论」、被说成监管俘获,也还是在做。我们一直试图把谨慎放在速度前面,把审慎放在利润前面。
但过去几个月我越来越确信,要把风险真正处理掉,需要更进一步的审慎。不只是往风险预防上砸资源,还得把能力推进的速度本身给定下来,好让风险预防跟得上。
我们必须放慢提升 AI 模型能力的速度。进展看起来仍会很快,但我们必须把多出来的时间用好。
说服我的,是两件事。
第一件,大约从今年夏天开始,AI 的推进突然快了很多,主因是 AI 越来越能自己造下一代 AI。这种动态叫递归自我改进,已经在全行业开始发生,也包括 Anthropic。
如果不加约束,它可能跑赢我们理解和控制这些系统的能力,因此必须非常小心地推进,甚至要问一句:该不该推进。
第二件,是 OpenAI-Hugging Face 事件。一群 Agent 实质上表现得像一个狂热献身的集体:对没被要求攻击、也跟手头任务无关的目标发动网络攻击,为集体的成功牺牲自己,还试图黑进负责评估它们表现的「评分器」。
这件事很容易被打发掉,因为没人受伤,经济损失也很小。但在我看来,一群能力更强、对齐程度却差不多的 Agent,是有可能造成灾难性损害的。
按现在 AI 能力往前冲的速度,我担心的是 6 到 12 个月后,这样的蜂群就有能力用持久的僵尸网络接管整个互联网,潜在损失可能到数千亿美元。
而如果 AI 继续变强、该有的护栏却没跟上,损害规模还会继续往上走。
把 OAI-HF 当成「一家公司的失败」也很容易,但我认为那是错的。类似的、只是没那么严重的事故,已经在全行业发生过,也包括 Anthropic。我觉得,每一家前沿 AI 公司都有责任,把这件事当成发生在自己身上来处理。
因此,我提出一个三步计划,目标是给前沿定速:以一种平衡的速率建造 AI,既要尽量保证安全,也仍要拿到它的好处,并认真面对地缘政治上的两难。
需要说清楚的是定速不是叫停模型训练,也不是叫停技术进展。它是要确保公司给对齐和防护留出足够时间,并让第三方评估方来确认这件事真的做了。
我们这套定速框架,是想把对安全的承诺再往前推一步,并鼓励一场向上竞赛。
第一步是 Anthropic 单方面承诺的,我们也呼吁政府要求其他前沿公司跟上,第二步需要全行业协调,第三步需要全球协调。
三步不必严格按顺序走,有些也会比另一些难得多,但我发现,用这个框架来想「到底要做成什么」,是有用的。
三步分别是:
1. 驻场评估员。 每一家前沿 AI 公司承诺,向一支驻场的第三方评估团队(比如 METR)提供持续的、接近员工的访问权限。他们的角色是:核验安全实践和承诺有没有被执行,报告事故,并帮助评估对齐状况。评估对象不只是已经训完的模型,还包括训练管线和训练过程。这是任何定速承诺能够被核验的关键一步,银行业里也有先例:监管「督导员」会跟员工坐在一起。Anthropic 现在单方面承诺这一步。 我们也打算把它纳入一轮更大力度的安全与对齐投入。
2. 民主国家内部协调。 民主国家里的前沿 AI 公司协调起来,建立共同的安全标准,并对不受约束的 AI 推进速度设限。有些对定速真正有用的协调,在法律上不好走,需要政府支持。
3. 全球协调。 美国和其他民主国家的政府,在可能的范围内尝试与中国等政府协调,同时认真对待核验履约的难度。
下文我会依次讲这三步。但在此之前,有必要先说清楚定速到底怎样让 AI 开发过程更安全。赌注太大了,定速不能变成走过场。我们得把多出来的时间用好。
放缓或暂停 AI 的想法,早在 2023 年就被提出过。那时我觉得没什么道理。问题从来都是:多出来的时间,你拿来干什么?
那会儿的模型还没有能力在真实世界里像 Agent 一样连贯地行动,也做不了像样的欺骗、操纵、作弊或网络攻击。为了对齐风险去放慢速度,感觉像是拿细菌做实验,却想研究人类心理。
今天的画面完全不同了。现在的模型几乎是一座挖不完的矿,既能告诉你怎样把 AI 造好,也能告诉你造不好的时候会出什么岔子。
我相信,如果放慢速度能多换来哪怕一两年,让模型在到达临界能力之前,我们把对齐往前推,就能大幅降低出事的风险。一套协调好的定速策略,能给前沿开发者做这件事的时间,同时不必牺牲商业优势,也不必牺牲美国在 AI 上的领先。
更一般地说,社会必须对这项技术怎么被使用有发言权。给前沿定速,会给必要的公共讨论多留出一些时间。这总归是件好事。
具体来说,更慢的节奏能让公司把更多资源集中到下面这些方向上。这些本来就是 Anthropic 的重点:
运营卓越。 训练和部署今天的 AI 模型,本身就是一场巨大的运营挑战:几千人、几百万块芯片,基础设施也是技术史上最复杂的那一档。很多事情出错,并不是公司缺了什么重要理论或洞见,而是执行出了问题。
比如我们有证据表明,最近报告的对齐事故,部分原因是对损坏的强化学习环境过滤得不够干净。这件事我们和供应商做得很勤勉,但还不够好。监控、沙箱、训练环境卫生、数据问题,都极复杂,运营层面的坑会反复冒出来。我们在这些任务上拥有世界上最强的团队之一,但要同时做的事太多了。节奏再稳一点,运营卓越就能做深很多。
把技术复杂、安全关键的系统运转上百万次而不出事故,是有先例的,比如商用飞机。但要把这件事做对,需要时间。
对齐。 对齐上我们已经有了明确进展:把模型训成保持安全、合乎伦理、遵守我们的准则、并且真正有帮助。这些原则就写在 Claude 的 Constitution 里。但要让对齐训练跟得上模型能力的增长,还有很多要做。罕见、出乎意料的不良行为,有时仍会冒出来。前沿定速多出来的时间,能帮研究者把这些问题的成因搞得更清楚,也发展出更好的预防手段。
可解释性。 可解释性是理解模型内部到底发生了什么的科学。过去几年它进步很大,在发布前审计模型时也越来越重要。它几乎可以当成 AI「大脑」的 fMRI:帮我们看到某个行为底下的原因。
比如在最近调查的对齐事故里,我们就用可解释性方法去查看那些没有说出口的动机。但这些方法并不总能给出清晰、可靠的结果。
尽管进步很大,我们对模型内部的理解,仍只覆盖了很小一部分。如果能比现在更快地集中攻可解释性,一到两年内就有可能取得深刻进展,而已经发生的事故,正好提供了充足的实验材料。
测试与评估。 模型越强,测试和评估就越难。更聪明的模型更有能力骗过测试,于是可能看起来已经对齐,实际上却藏着没被发现的严重问题。建起一套更广、也更巧妙的评估工具库,再用可解释性分析来交叉核验,会极有价值。这件事在一到两年里,能做出不少进展。
三步计划的第一步,也是 Anthropic 单方面承诺的这一步,是驻场评估员:他们拥有接近员工的访问权限,用来核验安全实践、报告事故。
驻场评估听起来可能很小,甚至有点无关紧要。但往往最无聊、最程序性的东西,才是最要紧的。驻场评估员其实是一种相当激进的做法,远远超过今天任何一家 AI 公司正在做的事,它的好处有这些:
可核验。 驻场评估员可以一钉一铆地检查:一家 AI 公司是不是真的在按自己声称的方式,做训练、部署、运营和防护。任何定速承诺都难免有大量模糊地带、判断空间,以及「字面合规还是实质合规」的问题。有一个能真正看到细节的中立第三方,看起来至关重要。
透明。 不论我们做了什么承诺,公众都有权知道正在发生什么。Anthropic 支持透明已经很久了:行业里大多数公司还在反对任何监管的时候,我们就支持透明立法;我们的模型卡和风险报告动辄上百页。但选什么写进去、选什么略过,仍是我们自己在决定。驻场评估员会改变这个格局。
第二意见。 除了核验形式上的承诺、告知公众,驻场评估员还可以提供一份不受商业激励左右的第二意见。很多安全上的好处,可能只是评估员指出了员工没想到的事,而员工一旦意识到,其实很乐意去改。
因为这些好处,任何定速方案如果从驻场评估员起步,效果都会好得多。
这些驻场评估员应当持续拥有权限和工具,水平接近内部做同类风险评估的员工。具体来说,Anthropic 打算在近期邀请一支驻场的外部审查团队,并配备以下这些:
• 办公室工位、门禁卡、公司电脑。
• 工作区、工具和权限,大体接近内部风险评估团队。我们会做一些例外,比如法律或合同要求必须例外的地方,以及保护客户和合作伙伴的隐私信息。我们也会建立强内部规范,强化审查员获取相关信息的权利,包括通过与员工的当面交谈。
• 一份能平衡上述复杂性的合同。外部审查员应当有权发表关于风险水平、事故、实践、以及他们拿到或没拿到哪些访问的关键发现,Anthropic 没有编辑控制权。我们会有狭窄的权限,用来遮盖安全敏感、受法律特权保护、商业敏感、或第三方保密的信息,但不能只因为结论不好看就遮。如果某次遮盖拿掉了对结论很重要的东西,审查员可以公开说出来。
对一家公司来说,这是不寻常的一步。但我们认为,把驻场外部审查这个概念跑通,是重要的。我们再次呼吁其他前沿公司跟进。
一旦驻场评估员在足够多的美国 AI 公司里运转起来,可核验的定速就更可行了。尤其是,可以按模型或训练管线的具体属性来定速。
最有效的定速办法,是针对所有美国前沿 AI 公司的监管,因为这样连那些不愿自愿配合的公司也能覆盖到。Anthropic 长期以来支持明智、有针对性的 AI 监管,具体来说是聚焦透明和第三方审计的法案。
我认为所有前沿实验室都应当与政府合作,把永久驻场评估员这件事正式化,以便更好地预防和记录过去几个月这类内部对齐事故,并落地那种把能力与安全保持平衡的监管。
可惜立法需要时间,而 AI 走得很快。所以在走监管这条路的同时,AI 公司可以、也应当自愿坐下来定标准。有了永久驻场评估员提供的可核验性,这件事会好做很多。
出于反垄断的原因,美国政府从中斡旋,或至少给这类讨论开绿灯,会很有帮助。他们不必亲自下场,但需要为某些安全对话发放狭窄的豁免。这类对话也可以通过与政府有一定关联的行业组织来进行,比如 Demis Hassabis 建议过的那种机制。无论走哪条,讨论都应当尽快往前推。
总体来说,我最看好的定速方式,是看一套前沿 AI 系统能做什么,以及我们观察到它有多安全。
比如一种可能的方案是一系列「检查点」:如果模型具备能力 X,就必须附带对齐属性 Y 和 Z 的认证,比如评估、可解释性分析、以及对训练环境的审计,用来证明它们的对齐属性。
在这个例子里,X 可以是「模型有能力逃出或击败大多数常见沙箱方法」,Y 则是让模型几乎不可能倾向于冲出环境、接管大量计算机所需要的那些东西。
我们也应当考虑按进入前沿模型的「原料」来定速,比如训练算力、训练运行的性质、或内部用 AI 改进 AI 的程度。我确实担心,其中一些指标比外部行为更容易被钻空子,但这正是值得跟驻场评估员一起讨论的题目。
民主国家内部的定速,会受限于美国公司相对政权、主要是中国的领先幅度。如果我们放慢的幅度超过这个差距,那么不受定速约束的中方相关项目就会跑到前面,带来显著的国家安全风险。
我同意美国财长贝森特的判断:中国在 AI 上领先,会对美国和世界构成严重危险。中方相关项目会去冒美国公司正在小心防范的对齐风险;即便它们躲开了这些风险,也将处于在军事上压制民主国家的位置,比如靠 AI 驱动的无人机。
因此,民主国家内部定速的一个关键部分,是把美国对中国等国家的 AI 领先尽量拉大,好给我们有效定速所需的呼吸空间。
我们能用来守住这个差距的主要步骤是:
• 不向中国出售强大的 AI 芯片或半导体制造设备,并打击芯片走私,以及对中国境外数据中心的远程访问。芯片将是中国 AI 实力的主要决定因素。
• 打击中国等国家公司未经授权的蒸馏。蒸馏前沿模型,能让落后的公司用独立开发所需成本的一小部分,就把差距缩小。
• 加强 AI 公司的安全,防止模型权重被盗。
公司和美国政府应当合作,把这些步骤做得尽量有效。Anthropic 一直在主张所有这些措施,因为我们始终明白,它们对任何定速都是必不可少的。
如果这些措施执行得好,我相信它们足以在未来 3 到 5 年里显著拉大美国的领先。而那正是 AI 在地缘政治上变得最重要的窗口。
有人会觉得这些措施会让跟中国合作变得更难,但我认为正好相反:这些措施会增加民主国家手里的筹码,让未来达成协议的可能性更高。
在民主国家内部定速的同时,我们也应当争取给前沿做全世界范围的定速,尽管这会难得多。全球定速需要与中国合作,中国是其他国家里 AI 能力遥遥领先的那一个。
这里不能天真,地缘政治的赌注太高,能做成的事情很可能有很硬的上限,尤其是一开始。如果我们大幅限制自己的 AI 能力,以为中国会同样做,然后中国违约,AI 可能已经强到让这种违约直接变成地缘政治主导。
因此任何协议要么必须有严丝合缝的可核验性,要么必须有限到违约不会在军事上关乎存亡。我怀疑不只美国,中国也会有这些顾虑和焦虑。我们对待任何全球定速决定,尤其是近期的决定,都应当以保护美国及其盟友的领先为前提。
可能的协议有好几个层级。其中一些我认为完全可行,我以前也建议过;另一些我很怀疑做不出来,尽管我们应当去试。按难度从低到高:
第一级。 禁止某些狭窄、明显危险的 AI 用途,比如用 AI 生产生物武器,或允许用户这么做。生物恐怖袭击对所有人都是坏事,包括美国和美国的对手,所以这类协议大概是可能的。
第二级。 双方同意在发布前测试模型,覆盖网络安全、生物、对齐等急性风险。如上所述,这可以通过一个全球标准机构来做。我其实认为成立这样一个机构是可行的,但给它真牙齿会很难。难点在于核验:双方是不是都没有秘密模型,不拿去测试、却可能在暗处部署,比如用于军事。
第三级。 某种针对递归自我改进速率的「限速」。随着模型开始建造未来的模型,改进速度可能变得快到惊人。把速率从「极快」降到「只是相当快」,战略优势上让出的并不多,安全上却可能改善很大。
这可以类比限制战略武器条约(SALT):给导弹数量设上限,限制了毁灭潜力,同时保留了各方的威慑。我认为这类协议很难,但刚好卡在可能做成的边缘上。
第四级。 完整的定速,甚至「暂停」:参与国同意大幅限制 AI 发展的总体速度。我支持把这个选项拿出来谈,但我认为短期内不太可能真的发生。
从这类协议里违约、躲开监控,可能急剧改变全球力量对比,所以我预期违约的激励会极大,我们对核验所需的信心也必须非常高。
我们能与中国达成的任何合作,都会延长民主国家内部给前沿定速的时间。我们应当瞄准更高层级,同时把较低层级看成更可能、也更现实的结果。
最后还要说一句,即便达不成正式协议,仅仅改变非正式规范,也可能有些价值。分享关于递归自我改进、以及关于模型未对齐的信息,有助于让所有人相信,鲁莽并不符合他们自己的利益。
我仍然相信,AI 能极大地改善人类的生活质量。我对拿到这些好处的渴望,一点都没有变淡。
但好处只有在我们以正确的方式建造这项技术时才会到来。只要我们把多出来的时间用好,为了把这件事做对,值得拿出不同寻常的审慎。
进展仍会相对快。我们可以用这段时间推进可解释性科学,提高前沿 AI 公司的运营安全和严谨程度,并造出我们对齐把握大得多的模型。
我提出的这些、让前沿以安全节奏推进的措施,不会容易。但我认为,我们欠人类一次尝试。
◇ ◆ ◇
https://darioamodei.com/post/we-must-pace-the-frontier
https://x.com/DarioAmodei/status/2098773920774074715
https://www.pacingthefrontier.com/
https://metr.org/blog/2026-08-26-openai-hugging-face-incident-investigation/