目标很明确:拿到某小程序的请求构造规则,脱离微信环境,用纯协议完成「登录 + 搜索航班」。
手头有一份 wmpf-trace 抓出来的 trace 日志(traceOut/run-...),里面有完整的 HTTP 请求、响应体、以及小程序 webpack 打包后的 JS 源码。任务就是:从这份日志里把「请求是怎么签的、登录态是怎么来的」还原出来。
第一脚就踢到铁板:这份 trace 是 late-attach 的,state=incomplete——它是在小程序已经跑起来之后才注入的,所以关键的 wx.login() 调用根本没被抓到,trace 里能看到的 code 早就过期了。这为后面埋下了一个大坑。
先看清黑盒:WMPF 小程序的架构
某应用不是 H5 网页,是微信小程序,跑在 Windows 微信客户端内嵌的 WMPF(微信小程序框架)里。抓包看到的请求,全部来自小程序的 AppService(逻辑层,跑业务 JS)——它跟渲染层 WebView 是分离的两个执行环境。
这对这次逆向有三个直接影响:
- 没有 DOM,也没有浏览器指纹
浏览器逆向那套(canvas 指纹、事件循环补环境、 window/document/navigator)在这里基本用不上,别带进来。 wx.login这类微信 API 只在 AppService 上下文可用想拿 code,必须在 AppService 里执行,普通 HTTP 客户端碰不到微信的这个接口。 - late-attach 就抓不到启动阶段的调用
wx.login恰恰在小程序启动时触发,这解释了为什么 trace 里没有 code。
明白这一点,后面「为什么 code 必须借控制面」就顺理成章了——不是算法问题,是执行环境问题。
第一回合:先把签名算法啃下来
现象
trace 里所有业务请求都指向同一个网关 app.variflight.com/vapi/router/*,每个 URL 都带一组公共参数,最后缀着两个字段:
appKey=J8w...5ts&device=2&version=6.8.2&channelID=wxchb_0xx&...×tamp=1792644154196&signature=4E70800EB8E537E72D35F11858DD78A3signature 是 32 位大写十六进制,明显是 MD5。问题就是:它是对什么字符串做的 MD5?
证据:从 webpack bundle 里定位签名模块
trace 的 scripts/source/ 里有小程序打包后的 JS。签名相关的逻辑分散在几个 webpack 模块里:
模块 33255:J7= MD5 大写,hV = function(e,t){return i(i(e)+t)},Z0/Kk两个密钥常量模块 12134:序列化函数t.Z模块 93893:请求拦截器,发送前统一注入timestamp+signature
怎么从几 MB 的 bundle 里精准定位到这几个模块? 不是靠运气,是有套路的:
- 从字段反查
先在 normalized/http.jsonl里锁定一个带signature的真实请求,拿到 URL。 - 搜接口路径
在 scripts/source里 grep 接口路径(/loginByCode、flightSearch),定位到发请求的调用点。 - 追请求拦截器
这些调用点最终都走一个统一的 request 包装——模块 93893,它负责在发送前注入timestamp+signature。 - 看它调用谁
拦截器里生成 signature 的那行,引用了 hV(模块 33255)和serialize(模块 12134)。
关键就在第 4 步——hV = function(e,t){return i(i(e)+t)},其中 i 就是 MD5。展开就是:
hV(e, t) = MD5( MD5(e) + t )也就是说,签名是双重 MD5:先对序列化串做一次 MD5,把结果(大写)拼上密钥,再做一次 MD5,最后转大写。
序列化:不是 URL 编码,是「排序 + join」
t.Z(模块 12134)的等价还原:
function serialize(params) {
return Object.keys(params)
    .sort()
    .map(k => {
let v = params[k];
if (v === null || v === undefined) v = "";
else if (typeof v === "object") v = JSON.stringify(v);
return k + "=" + v;
    })
    .join("&");
}
几个容易踩的点:
- 按 key 字典序排序
不是插入顺序。 - 对象值要
JSON.stringifynull转空字符串。 - 签名串不 URL 编码
但最终请求 URL 要按标准 query 编码。这是两层表示,别混。
代码:Python 复现
import hashlib, json as _json, time
from urllib.parse import urlencode

BASE = "https://app.variflight.com/vapi/router"
APPKEY = "J8w...5ts"            # 打码
CHANNEL = "wxchb_0xx"           # 打码
VERSION = "6.8.2"
SIGN_KEY = "ygb2...wDg"         # app.variflight.com 的签名密钥(打码)
SIGN_KEY_OTHER = "7tFw...ss5"   # 其它域名(打码)

def md5_upper(s):
return hashlib.md5(s.encode("utf-8")).hexdigest().upper()

def serialize(params):
    parts = []
for k, v in params.items():
if v is None:
            v = ""
elif isinstance(v, (dict, list)):
            v = _json.dumps(v, separators=(",", ":"), ensure_ascii=False)
        parts.append(f"{k}={v}")
    parts.sort()
return "&".join(parts)

def sign(params, key=SIGN_KEY):
return md5_upper(md5_upper(serialize(params)) + key)

def build_signed_url(path, extra, login_info=None):
    params = {"appKey": APPKEY, "device": 2, "version": VERSION, "channelID": CHANNEL}
if login_info:
        params.update(login_info_params(login_info))
    params.update(extra)
    params["timestamp"] = int(time.time() * 1000)
    params["signature"] = sign(params)
return f"{BASE}{path}?" + urlencode(params)
底层实现是裸 MD5,别对着开源库发呆
有个容易走偏的地方:这套签名用到的 MD5 就是标准 MD5,没有加盐、没有 IV、没有魔改轮函数。业务层的"复杂度"只在于外面套的那层壳——排序序列化 + 双 MD5 + 大写。
对比一下加密类逆向里常见的坑:CryptoJS 的 AES、魔改 DES(函数名写着 DesEncryptModel 结果其实是 AES)、自定义 T 表……那些才是"底层有货"。这里没有——抓到 hV = i(i(e)+t) 这一行,底层算法就到头了,剩下全是"序列化规则的边界"。
教训:先判断「复杂度在底层算法还是在业务封装层」。某应用这种属于后者——底层一眼看到底,真正要抠的是序列化的每一个边界(排序、对象值、null、编码)。别在"MD5 是不是魔改过"上耗时间。
结论:4/4 样本验证通过
用 trace 里四个真实请求逐字复算(loginByCode / getBindMobile / tripListExtra / flightSearch),签名全部命中:
[OK ] loginByCode     4E70800EB8E537E72D35F11858DD78A3
[OK ] getBindMobile   FF6B429A9EDB3F349424FCEB76A986B2
[OK ] tripListExtra   59CC5E83719B98A766F9519C16C12A6E
[OK ] flightSearch    C0F2A3667BD2A78279C3BCA8044C46E9
ALL PASS
这四个样本不是随便挑的,它们覆盖了签名算法在不同形态下的表现:
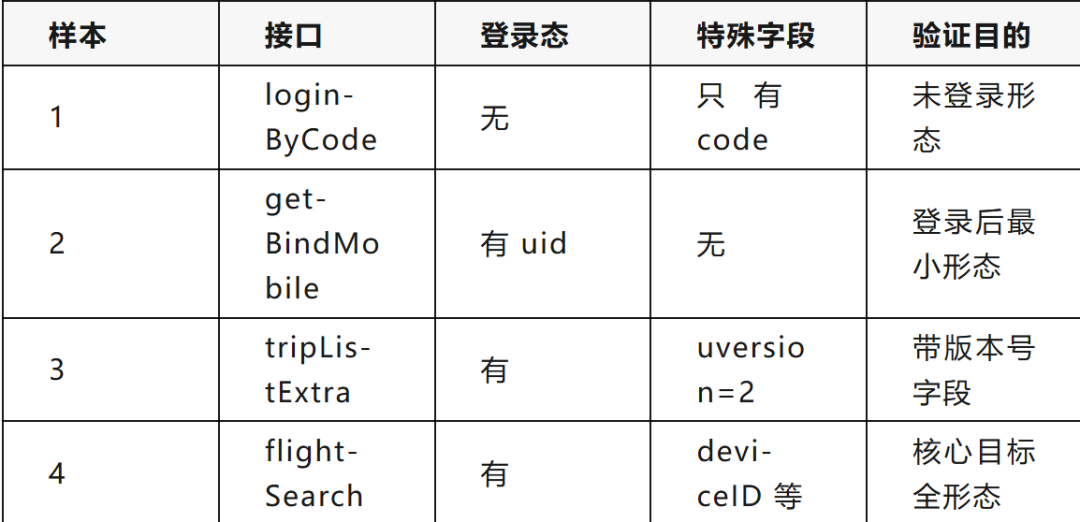
四个全命中,说明签名算法对「有没有登录态、有没有额外字段」都不敏感——序列化 + 排序 + 双 MD5 是普适规则,不是某个接口特判。
教训:签名是静态可逆的纯算法,密钥硬编码在客户端 JS 里。拿到 bundle + 两个真实样本,就能逐字复算。不要一看到「MD5 + 排序」就往「不可逆」「动态密钥」上想。
到这里,搜索航班的签名问题解决了。但登录态从哪来,还没解决。
第二回合:终端乱码乌龙(第一次自证)
拿到响应后,终端打印出来是一坨乱码,第一反应是「响应编码不对,数据坏了」。
当时返回体里 airlinesName 显示成 ������,看着像 GBK 被当 UTF-8 读,或者反过来。但我去查了 codepoint:
airlinesName 的 unicode_escape = 中国国际航空 ="中国国际航空"响应本来就是合法的 UTF-8,数据是好的。 乱码纯粹是 Git Bash 终端 codepage 显示问题——终端用错了代码页去渲染,跟数据本身无关。
教训:终端显示乱码 ≠ 数据坏了。先验证数据本身的编码(看 codepoint、写文件用 UTF-8),再决定要不要修。我差点为了一个显示问题去「修复」根本不存在的数据错误。
解决办法很简单:结果完整落盘(json.dump(..., ensure_ascii=False)),终端只打印 ASCII 摘要。
顺手说清另外两个「数据表示」坑
除了乱码,这次还踩了两个「拿到了却是脏的」的表示层坑,都属于同一类。
1. 签名串不编码,请求 URL 才编码
签名用的 serialize() 产出的是未 URL 编码的原始串(k=v&k=v),MD5 是对这个原始串算的。但最终发请求时,整个 query 要按标准 urlencode 编码。如果反过来——先编码再算签名,签名一定错。两层表示必须分开:
业务对象 -> serialize()(原始串) -> MD5+key(签名) -> urlencode(最终 URL)
             ↑ 签名对这一层算        ↑ 传输对这一层做
2. 时间戳有秒和毫秒两套单位
同一个系统里混着两种时间戳,搞混就出 bug:
timestamp | |||
sessionKey | |||
mpcredential |
签名用毫秒、凭证里嵌秒,取数时别拿错位数。
第三回合:搜索通了,但登录卡在 code
用 trace 里现成的登录态(openId / sessionKey / mpcredential 等一堆字段),签名算法一填,搜索航班直接通了:
search code: 0 | msg: Ok
date: 2026-10-23 | count: 110
CA1507 北京 -> 上海  07:30-10:00
SC5394 北京 -> 上海  07:30-10:00
ZH1507 北京 -> 上海  07:30-10:00
110 班航班,code:0。搜索航班的纯协议实现,成了。
但换成不带登录态发同一个请求:
code: 7001 msg: 身份校验失败登录态是必须的。那登录态从哪来?答案是 loginByCode 接口——它需要一个 code 参数。而这个 code,来自微信的 wx.login()。
证据:mpcredential 是服务端签发的,不是客户端算的
我在 bundle 里搜 mpcredential,搜不到任何生成逻辑。这就说明:sessionKey、uid、mpcredential 这些字段,全是服务端在 loginByCode 响应里下发的,客户端没有任何计算。所以从 JS 里找 mpcredential 的算法,方向一开始就是错的。
loginByCode 的完整链路:
1. wx.login() -> code          # 微信签发,一次性,约 5 分钟过期
2. GET /vapi/router/loginByCode?appKey&...&code×tamp&signature
   响应 data: { openId, sessionKey, unionId, uid, mpcredential, ... }
3. 客户端把 data 存 storageSync("loginInfo"),后续请求带上这些字段
关键转折:code 是物理边界,不是算法问题
这里我走了一段弯路,也犯了一个方向性错误。
我一开始的执念是「纯协议实现登录」——既然签名是纯算法,那登录是不是也能纯算法搞定?答案是不能,而且不是「我还没找到算法」,是物理上不存在。
wx.login() 的 code 是微信服务端签发的一次性票据,约 5 分钟过期,用一次就作废。它不是任何「输入经过本地算法」能算出来的东西——它的签发逻辑在微信服务器上,依赖你的微信登录态。
教训:把「纯协议实现登录」拆成两半——
loginByCode(code 换 session)是纯协议,flightSearch是纯协议;但「拿 code」这一步永远不是纯协议,它必须借真实微信环境。我把两件事混在一起,于是在「补环境算 code」这个不存在的方向上浪费了时间。
认清这个边界后,问题就变成了:怎么从真实微信环境里,干净地拿到一个 code?
换一条思路:借 wmpf-trace 的控制面
答案就在手里的 wmpf-trace 工具里。它除了抓包,还带一个控制面(control plane),能在匹配的 AppService 上下文里执行任意 JS 表达式——包括 wx.login()。
工具自带的 examples/wx_code_provider.py 已经把这件事封装好了:
# 核心调用链(节选)
with AutoTraceRuntime(TRACE_ROOT, startup_timeout=180) as runtime:
    provider = WmpfCodeProvider(APP_ID, runtime.control_url, runtime.token,
                                timeout=15, context_wait=60)
    lease = provider.request_code()   # 返回一次性 code lease
    code = lease.take()               # 取一次即清空
它内部通过控制 API POST /v1/sensitive-evaluate,在真实 AppService 上下文里执行这段表达式:
new Promise(resolve => {
let settled = false;
const finish = v => { if (settled) return; settled = true; resolve(v); };
const invoke = globalThis.__xjbWmpfTrace?.invokeOriginal === 'function'
    ? options => globalThis.__xjbWmpfTrace.invokeOriginal('wx', 'login', [options])
    : options => wx.login(options);
invoke({
force: true,
success(result) {
const code = result && typeof result.code === 'string' ? result.code : '';
finish(code ? { ok: true, code, obtained_at: Date.now() }
                  : { ok: false, error_code: 'wx_login_empty_code' });
    },
fail(error) { finish({ ok: false, error_code: 'wx_login_failed', error_message: String(error?.errMsg) }); }
  });
})
几个关键设计,都值得学:
- code lease(租约)
take()只能取一次,取完置spent、清空code,防止同一个 code 被重放。 - 60 秒使用窗口
obtained_at+CODE_USE_WINDOW_MS=60_000,超出窗口usable()返回 false。 __xjbWmpfTrace.invokeOriginal优先走注入的原始调用通道,避免被 trace 自己的 wrapper 干扰。
但上面只写了 lease 的「消费」这一条路。code lease 其实是个三态状态机,完整生命周期是这样的:
fresh ── take() ──> spent      (消费成功, code 清空)
fresh ── discard() ──> discarded (主动放弃, code 清空)
fresh ── 超本地窗口 ──> expired (过旧拒绝)这套机制真正值钱的,是它背后的几条不变量,逐条说:
take()最多成功一次消费后立刻清空内存里的 code,物理上杜绝同一个 code 被重放。 - 网络超时后不重用旧 code
code 是「发出即视作已消费」的——哪怕 loginByCode那一步超时了、不确定服务端到底收没收到,旧 code 也不能再发第二次。正确做法是申请一个 fresh code,有限次重试。这是最容易踩的坑之一:直觉是「超时了,重发同一个 code」,但 code 的一次性语义决定了重发旧 code 只会拿到「code 已使用」的失败。 - code 不进任何日志
stdout、raw trace、异常详情、结果 JSON 都不写 code 明文;拿到手立刻交换,交换完就丢。我脚本里打印的也是 code[:6] + "..." + code[-4:]这种脱敏形式。
一个容易误会、但我专门查证过的点:本地 CODE_USE_WINDOW_MS=60_000 这个窗口,只是「拒绝使用过旧 code」的本地上限,不代表微信或服务端承诺 code 真能活 60 秒。code 的真实有效期由微信服务端决定(约 5 分钟,但这是经验值不是契约)。所以正确策略是「拿到就立刻交换」,而不是掐着本地窗口磨蹭——窗口是用来兜底挡「过旧 code」,不是用来卡点用的。
控制面的几个错误码,先记下来
wmpf-trace 控制面的敏感动作接口(/v1/sensitive-evaluate)返回的 HTTP 状态码是有语义的,读一遍能省很多排查时间:
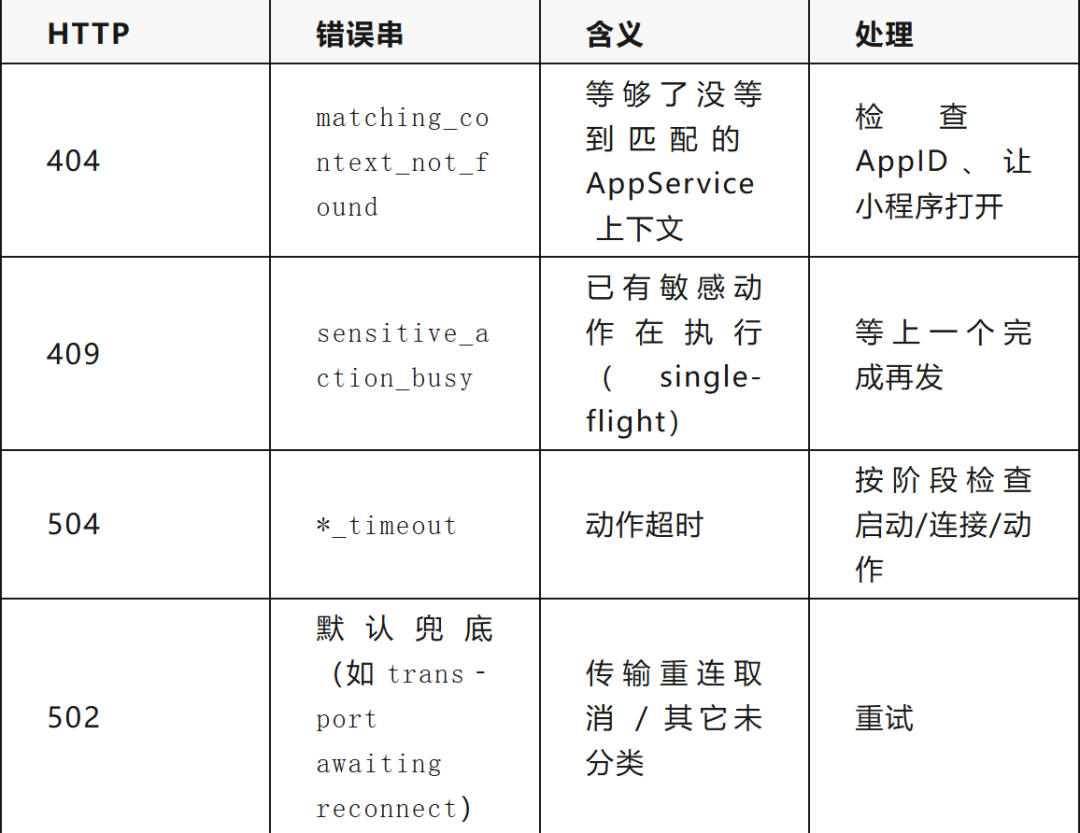
我当时就是被 502 兜底坑的——它的语义藏在 errorStatus() 的默认分支里,不是「连接失败」。这张表是我翻 src/control/server.ts 才拼出来的,早知道就不会误判成环境问题。
另外,这个控制面不是裸奔的,它有几层防护,用的时候要知道:
- Bearer token 鉴权
/v1/sensitive-evaluate要带runtime.token,不是谁都能调。 - single-flight
同一时刻只允许一个敏感动作在跑,第二个会 409 sensitive_action_busy——这是防并发重入的,不是 bug。 - 敏感值不落盘
code 这类敏感返回值默认不写进 trace 日志,拿到手即消费。
我全程用 --control-only 模式——只起控制面,不做完整 trace 抓包(因为 trace 素材已经有现成的了)。已有有效 session 时更是完全跳过 trace,直接纯协议发请求。控制面只在「需要新鲜 code」时才开机,用完即停,这也符合「最小暴露」的原则。
第四回合:撞上 502 重连抖动(第二次自证)
兴冲冲跑第一版,结果秒崩:
xjb_wx_code_provider.CodeProviderError: WMPF control HTTP 502: WMPF transport awaiting reconnect502 Bad Gateway + WMPF transport awaiting reconnect。我当时第一反应是「微信没连上」「环境没配好」,错了。
去翻 trace 进程日志 trace-process.log,看到真相:
[frida]scriptloaded, WMPFversion: 25510, pid: 36584
[frida]youcannowopenanyminiapps
[miniapp]miniappclientconnected
[miniapp]miniappclientconnected
[miniapp]miniappclientconnected
[miniapp]miniappclientdisconnected (app-000002)
[miniapp]miniappclientdisconnected (app-000001)
[miniapp]miniappclientconnected
frida 注入进微信后,已经打开的小程序会经历一次「断 → 重连」抖动。 我的 request_code 恰好打在 disconnected 那个窗口上,被取消了。
再往下挖,src/index.ts 里有一行是决定性证据:
sensitiveBroker.cancelPendings(
  cdpRouter.cancelSensitiveAppSession(appSessionId),
"WMPF transport awaiting reconnect"
);教训:502 + "awaiting reconnect" 是注入后的重连抖动,不是连接失败。 而且 provider 默认不重试,撞上就直接抛异常退出。这是我自己的时序坑——
request_code打早了。
修复就两条:
- 小程序已打开就先关掉重开一次
让它走注入后的新通道; - 对瞬时错误重试
每次 wx.login都是新 code,重试安全:
for attempt in range(6):
try:
        lease = provider.request_code()
        code = lease.take()
break
except CodeProviderError as e:
        transient = any(k in str(e) for k in (
"awaiting reconnect", "HTTP 502", "HTTP 504", "matching_context_not_found"))
if not transient or attempt == 5:
raise
print(f">>> 重连中, {attempt + 1}/6 重试... {e}")
        time.sleep(5)
最后一步:全链路闭环
加了重试后重跑。第一次 404 matching_context_not_found(小程序还没开),重试正好接住用户打开小程序的时机,拿到了 code:
>>>WMPF support is ready. 现在把某小程序【关掉再重新打开】, 保持打开...
>>>传输未就绪/重连中, 1/6 重试 (5s 后)... WMPF control HTTP 404: matching_context_not_found
>>>拿到 code: 0d1W...jl9 (已脱敏)
>>>session 已缓存到 session_cache.json
>>>login uid: 173***637
search code: 0 | msg: Ok
date: 2026-10-23 | count: 110
  CA1507 北京 -> 上海  07:30-10:00
全链路打通了。 而且验证了这是「真·新登录」,不是复用旧 trace 会话——新 session 的 sessionKey / mpcredential 时间戳从 ...1792644154 变到 ...1792645605,服务端重新签发了。
完整流水线:从 trace 到可复现
把这次做的事串成一条可复现的流水线,四步:
- 摸清 trace 结构
traceOut/run-*/下normalized/http.jsonl是请求入口,scripts/source/是小程序 webpack bundle 源码。 - 定位签名
在 scripts/source里搜接口路径/字段名,找到hV = i(i(e)+t),锁定模块 33255/12134/93893。 - 离线验证
python verify_signature.py,用 trace 样本逐字复算,4/4 通过。 - 实发闭环
python fresh_login.py,借控制面拿 code → loginByCode → 搜索航班。
第 4 步是最终跑通的关键,把它的核心代码完整贴出来(脱敏后)。variflight.py 里已经封装好了 build_login_url / build_flight_search_url,这里只贴「拿 code → 换 session → 缓存 → 响应式刷新」的编排逻辑:
# ---- 业务登录: provider 只给 code, 兑换由我们自己完成 ----
def login_by_code(code: str) -> dict:
    url = vf.build_login_url(code)                    # 纯协议: 签名已在 variflight.py 还原
with FirefoxNeckoSession() as s:
        r = s.get(url, headers={"User-Agent": UA})
        data = json.loads(r.content.decode("utf-8"))
if data.get("code") == 0:
return data["data"]                           # 服务端签发的 sessionKey/uid/openId 等
raise RuntimeError(f"loginByCode 失败: {data}")

# ---- 拿 code(需真实微信 + 小程序打开) ----
def fresh_code() -> str:
with PROVIDER.AutoTraceRuntime(TRACE_ROOT, startup_timeout=180) as runtime:
        provider = PROVIDER.WmpfCodeProvider(APP_ID, runtime.control_url, runtime.token,
                                             timeout=15, context_wait=60)
for attempt in range(6):
try:
                lease = provider.request_code()
try:
return lease.take()               # take 一次即清空
finally:
                    lease.discard()
except PROVIDER.CodeProviderError as e:
# 404=context 没到 / 502=重连抖动 / 504=超时, 都是瞬时态, 重试即可
                transient = any(k in str(e) for k in (
"awaiting reconnect", "HTTP 502", "HTTP 504",
"matching_context_not_found", "HTTP 404"))
if transient and attempt < 5:
                    time.sleep(5); continue
raise

# ---- session 缓存: 命中有效缓存则跳过 wx.login ----
def get_login_info() -> dict:
if SESSION_CACHE.exists():
        data = json.loads(SESSION_CACHE.read_text(encoding="utf-8"))
if data.get("saved_at", 0) + 3600 > time.time():   # 1 小时缓冲
return data.get("login_info")
    info = login_by_code(fresh_code())
    SESSION_CACHE.write_text(json.dumps({"saved_at": time.time(), "login_info": info},
                                        ensure_ascii=False, indent=2), encoding="utf-8")
return info

# ---- 响应式失效刷新: 7001/7002 -> 清缓存重登, 不预判 TTL ----
INVALID_CODES = {7001, 7002}
def search_with_refresh(dep, arr, date) -> int:
    code = search_flights(dep, arr, date, get_login_info())
if code in INVALID_CODES:
        SESSION_CACHE.unlink(missing_ok=True)          # 清掉旧 session
        code = search_flights(dep, arr, date, get_login_info())
return code
这一段浓缩了整条链路的三个工程决策:
- provider 只给 code,兑换自己来
——控制面是通用工具,AppID、 loginByCode接口、签名都留在案例代码里,职责边界清晰。 - 缓存 + 失效刷新
——不预判 TTL(服务端黑盒),而是「请求返回 7001 → 清缓存 → 重登 → 重试一次」,响应式比预判稳。 - 重试只针对瞬时态
——404/502/504 重试,其它错误立刻抛,避免把「真失败」当「抖一下」无限重试。
把「session 复用 + 失效刷新」画成状态机,就是 skill 里反复强调的那张图(我实际实现就是它的简化版):
load cache
  |-- valid ──> 直接业务请求 ──> 成功则返回
  |                          `─> 明确 session 失效码 ──> 清缓存
  `-- missing/expired ──────────────────────────────────┘
                                                        v
        fresh wx.code ──> loginByCode ──> 存 session ──> 业务请求
                          |-- code 明确过期 ──> 重新拿一次 fresh code
                          `-- 传输不确定 ──> 重新拿 code, 有限次重试
这张图背后有三个容易漏的工程点,都是「处理微信 code」时真正要抠的:
- 只有明确的失效码才触发刷新
7001(身份校验失败)触发重登;但签名错、参数错、权限不足、普通业务 404 都不能一律转成重新登录——否则一个签名 bug 会被误判成「session 过期」,导致程序反复调wx.login空转。这也是为什么前面先花大力气把签名 4/4 钉死:两个错误来源必须能区分开,才能放心把「非 7001 的错误」归给签名/参数,而不是 session。 - 一次刷新,N 次业务请求
1 次 session refresh → N 次 flightSearch,而不是「每搜一次航班就wx.login一次」。wx.login 只在缓存缺失、TTL 到期、明确失效码时才该被调。我的脚本单线程顺序跑,天然满足;真上并发就要显式 single-flight(拿锁 → 再查一次缓存 → 只有一个线程去拿 code,其余共享新 session)。 - 缓存要存
saved_at+ 结构校验至少检查「关键字段齐全(sessionKey 存在)+ 未过安全 TTL + schema 匹配」,而不是只看文件在不在。我这里用 1 小时保守缓冲(因为服务端 TTL 是黑盒),换到有 expires_in的目标,就该用safe_ttl = min(server_ttl - 安全余量, 实测有效窗口)这种更紧的式子。
为什么实发用 necko,不用 requests
有个选择值得单独说:实发请求我用的是 xiaojianbang-necko-runtime(真实 Firefox 网络栈),而不是 Python 的 requests。
原因:
- TLS/HTTP 指纹
requests的 TLS 指纹跟真实客户端不同,部分风控严的接口会区别对待。necko 直接复用 Firefox 网络栈,指纹更接近真实小程序环境。 - UA/header 一致性
小程序发出的请求带一套特定 UA( MicroMessenger/7.0.20... MiniProgramEnv/Windows),配合真实网络栈,服务端更难看出是脚本。
对某应用这种「签名校验型」接口,其实 requests 也能通(签名对、字段对就行);但养成用真实网络栈的习惯,换到 TLS 指纹敏感的目标就不容易翻车。
补一个没展开的请求:moreBlueTag
搜索结果之外,小程序还会发一个 moreBlueTag 请求,fs 参数格式像 FaCA1507:-PEK:-SHA:-2026-10-23,...——这是搜索结果的「蓝标」补充标注,跟基础航班列表无关。取基础数据不需要它,但如果你在 trace 里看到它别慌,它不是搜索的必需环节。
结果:成果落地
1. 签名算法(可直接复现)
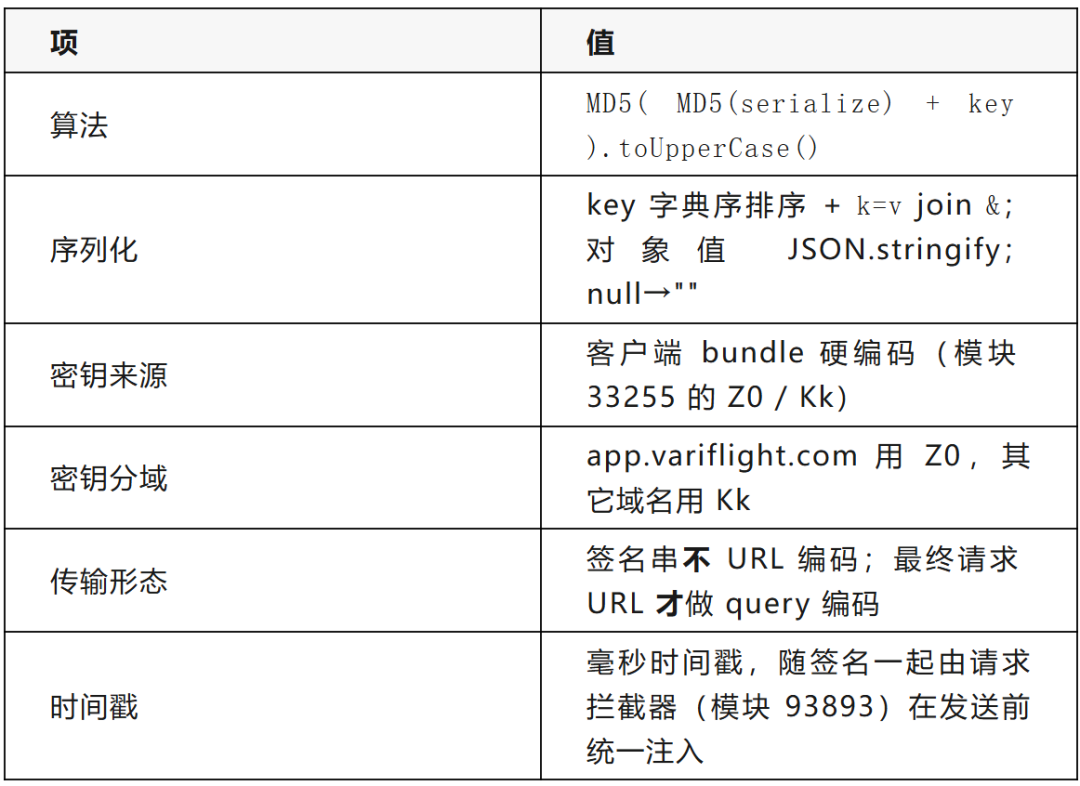
serialize(params) = 所有 k=v 按 key 字典序排序后 join('&')
                     (对象值 JSON.stringify; null -> "")
signature        = MD5( MD5(serialize(params)) + key ).toUpperCase()

key: app.variflight.com -> "ygb2...wDg"   (模块 33255 的 Z0)
     其它域名           -> "7tFw...ss5"   (Kk)
一张表说清签名算法参数:
2. 登录态字段语义表
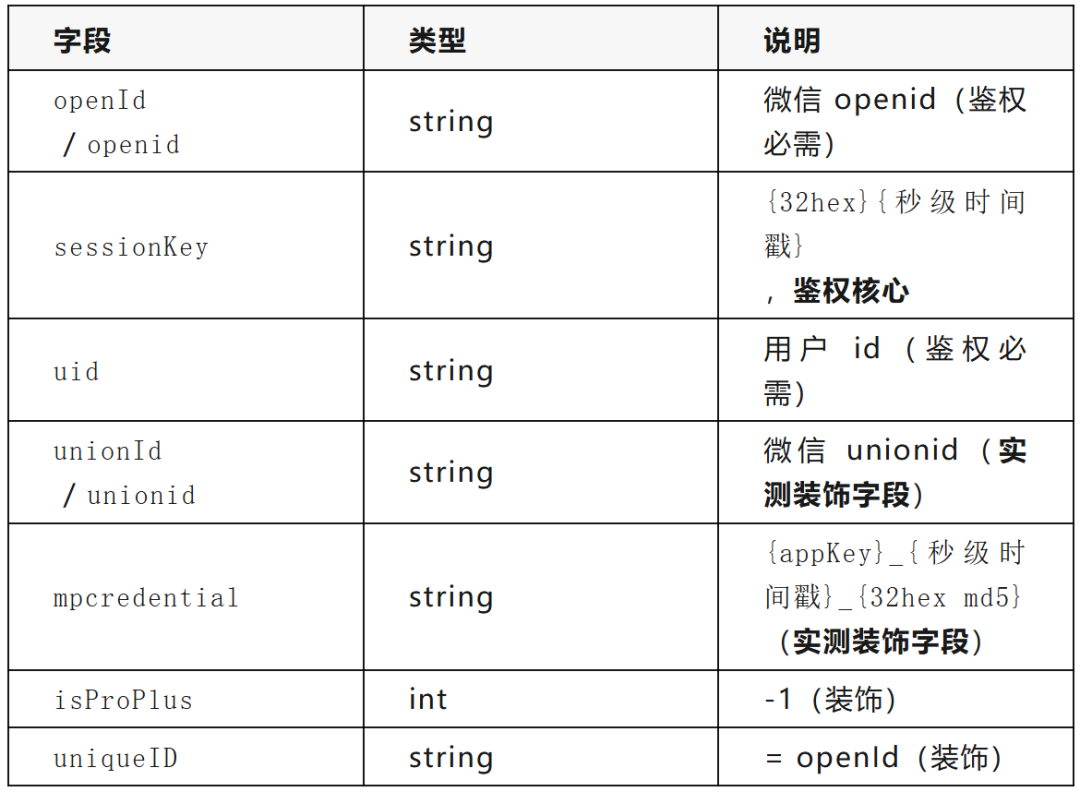
loginByCode 响应 data 的关键字段(全部服务端签发):
两个「名字骗人」的别名,一起记下:
uniqueID= openId(同一个值,换个名字);deviceID= unionId(又一个别名)。
它们都不是新生成的字段,只是把已有字段再抄一份。所以「登录态字段一大堆」,本质上是「三个真字段 + 一堆别名和装饰」——这是用单变量篡改测试才筛出来的,光看字段名会被唬住。
这些字段怎么从 loginByCode 流到 flightSearch? 链路是「响应 → 本地存储 → 下一个请求」:
loginByCode 响应 data
  └─ 客户端原样存 storageSync("loginInfo")
        └─ 后续请求把 loginInfo 里的字段拷进 query(模块 73690 的 u())
└─ flightSearch?openId=..&sessionKey=..&uid=..&mpcredential=..也就是说,登录态字段没有任何二次加工——响应里发什么,后续请求就原样带什么。这也解释了为什么「复用旧 trace 的登录态也能搜索成功」:只要 sessionKey + uid + openId 三个字段还在有效期内,服务端就认。真正让旧 session 失效的,是服务端侧的时间窗,不是客户端做了什么。
「原样透传」在客户端对应的那段代码(模块 73690 的 u()),等价还原出来就是这样——就是把 loginByCode 响应 data 里的这些键,原封不动抄进下一个请求的 query:
LOGIN_FIELDS = ("openId", "openid", "sessionKey", "unionId", "unionid",
"uid", "isProPlus", "mpcredential", "uniqueID", "uversion")

def login_info_params(login_info: dict) -> dict:
"""从 loginByCode 响应 data 提取请求需携带的登录态字段(与模块 73690 u() 一致)。"""
return {k: login_info[k]
for k in LOGIN_FIELDS if login_info.get(k) is not None}
注意最后那句 if ... is not None——它不是「挑哪些字段鉴权」,只是「跳过响应里没下发的键」。换句话说,客户端把服务端给它的登录态键一次性全带上,至于哪些键服务端真正校验,客户端自己根本不知道。这也解释了为什么「删除装饰字段服务端照样返回 0」——服务端压根没指望它们。
这个「字段原样透传」的特征,也是我用「篡改探测」就能标定鉴权字段的前提——如果是客户端二次加密/签名后的字段,篡改测试会无从下手。
3. 搜索航班响应结构
{
  "code": 0, "msg": "Ok",
"data": {
    "count": 110, "date": "2026-10-23",
"flightList": [[
      { "flightNumber": "CA1507", "airlinesName": "中国国际航空",
"departure": "北京", "arrival": "上海",
"depTopTime": "07:30", "arrTopTime": "10:00" }
    ]]
  }
}
注意 flightList 是双层数组[[...]]——外层是分组维度,内层才是具体航班对象。取基础列表时直接 flightList[0]。外层分组的确切语义(按航司 / 共享航班 / 舱位分组)本文未深究,属于可继续往下挖的方向,但不影响基础取数。
4. 样本分层:这次到底用了哪些样本
逆向最怕的就是「把不同阶段的样本混在一起,污染判断」。这次我刻意按维度把样本分开,每个结论都标清楚是用哪类样本证出来的:
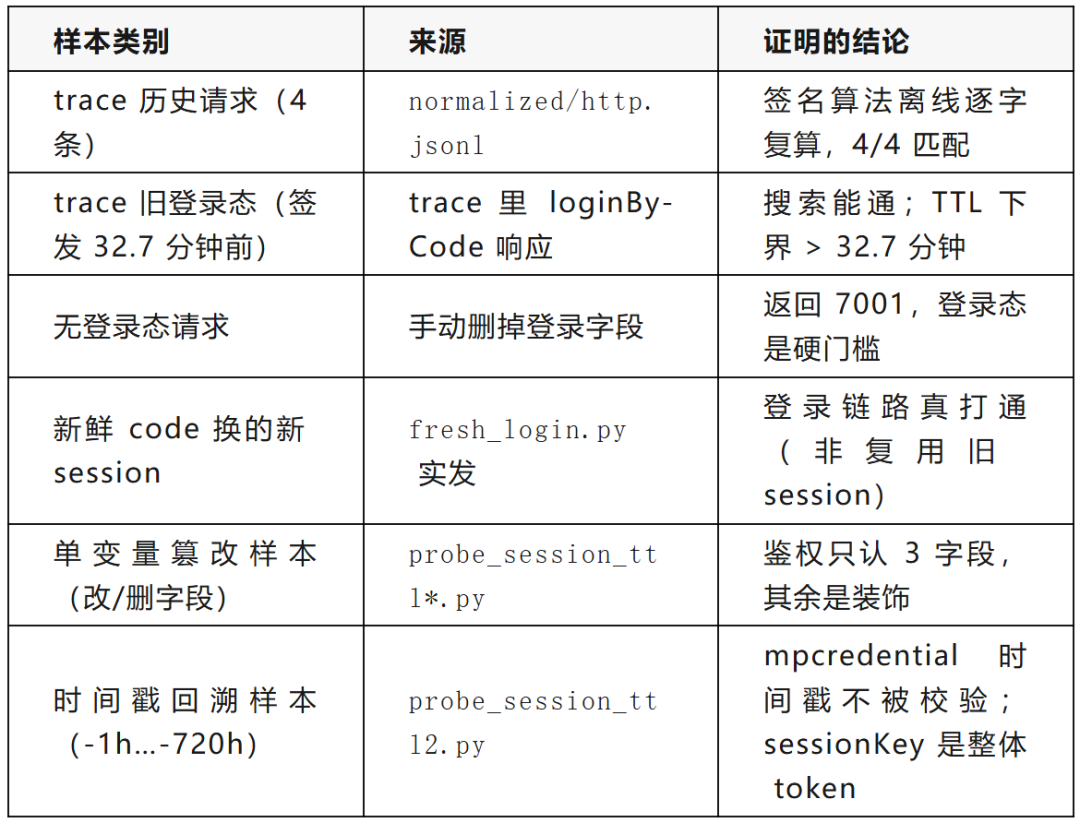
分层的价值在「附加题」里体现得最明显——如果没有把「篡改字段」和「篡改时间戳」分开,很容易得出「mpcredential 也参与鉴权」或「TTL 可以离线逼近」的错误结论。同一个字段,改内容、删字段、回溯时间戳是三种不同的测试,结果完全不同。
看雪ID:xiao_qi_lin
https://bbs.kanxue.com/user-home-1071700.htm
# 往期推荐
给大模型装上固件审计员的骨架:一个 IoT 固件漏洞挖掘 Skill 的设计与实现
吉他能听见你的话吗?——某无线吉他拾音器空中协议逆向:射频与扰码
球分享
球点赞
球在看
点击阅读原文查看更多