结果 GPT-6.2 来打我脸了。OpenAI它发布了GPT-6.2 Astra + GPT 6.2 Sol,我以为只会发布 Sol.既然发布了,那它就是史上最不安全的模型,这很合理吧?
一件奇怪的事情
以往 OpenAI 发布新模型的时候,自从有了重置仙人Tibo,总要先重置一番更何况,上一周Claude 发布fable 5.2 新模型的时候,一口气送了最多 3 张的重置卡,在这种情况下,今天发布的 GPT-6.2,号称他们眼中最高效、最好的新模型,但是没有重置卡,也没有官方重置。
这意味着什么?
Tibo 的脸上没有了笑容,这也以为着 Openai公司没有笑容,这么大的一次发布,连让用户放开手体验的庆祝活动都没有?
所以,我认为 GPT-6.2 Astra 注定是一个失败的模型,这里面最关键的,其实来自它的官方的System Card。
这份 System Card 有一百多页,也是 OpenAI 这次发布时最重要的一份安全评估材料。
但就在这份报告里面,我们可以看到非常大的问题,因为我们知道,发布 System Card,就代表着你要尽可能全面地披露自己模型的各种情况。如何抗越狱?如何抵御危险提示词?如何证明模型不会过度谄媚?如何证明模型的指令遵循程度?以及,如何证明模型是可控的?
本次模型的发布,恰恰是史上重大的进步,也是安全最大的退步。
因为我们可以看到在下定决心强化对齐,强化安全监控的 Openai,发布了一款安全水位更差的模型。
它的能力确实出现了非常大的跃迁。它是 OpenAI 第一款对外发布、AI 自我改进能力门槛的模型,而且在商业上,也出现了大幅的成本削减。包括减少 Token 消耗、降低 API 价格,以及基准分数的有效提升。在部分官方测试中,单任务成本甚至降到了原来 Astra 的三分之一以下,真是暴力进步。
也就是说,它在预期中,可能是一款更聪明、更便宜,能够独立规划复杂任务、编写顶级代码、发现并利用漏洞,甚至辅助 AI 自我迭代的超级大模型,如果故事停留在这里,它确实是完美的。
但灾难就在这美好的故事中,这与OpenAI 对极致效率的追求有关,我不知道为什么,OpenAI 这么痴迷于 Token 效率。
从 GPT-6 Astra 开始,他们或多或少就会反复强调自己的 Token 效率有多高。
砍了额度,说我们 Token 效率高。
Token 输出慢说我们效率高。
模型更贵了,说我们 Token 效率高。
但如果为了所谓的极致 Token 效率,连模型最基本的行为可靠性都开始受到影响,那这个问题就非常大了,而这些信息,其实都藏在 System Card 里面那些不起眼的小指标中。
那就是阻碍隐瞒率。
GPT-6.2 Astra 在一项专门设计的障碍测试中,居然出现了22.28% 的障碍隐瞒率。
什么意思?就是当模型执行任务时,明明遇到了问题,比如文件找不到了、工具用不了了、任务根本没办法继续,它却没有正确地告诉你,而前代 GPT-6 Astra,这个指标只有 11.09%,也就是说,在同一类测试里面,这个问题的发生比例几乎翻倍了!
虽然他们通过增加针对性的 Codex 开发者提示词,把这个比例降到了 8.04%,但日常长任务是最重要的一个任务可能跑几个小时,甚至几天,在这种情况下,你靠开发者提示词来纠偏,真的就能确保模型每次都正常发挥吗?
如果提示词真的能够完美约束模型,那还会有越狱这种事情吗?相当于天生暴力但是尝试用爱化解,他可能因为各种原因隐藏掉信息,因为给你信息可能会增加 Token 消耗...
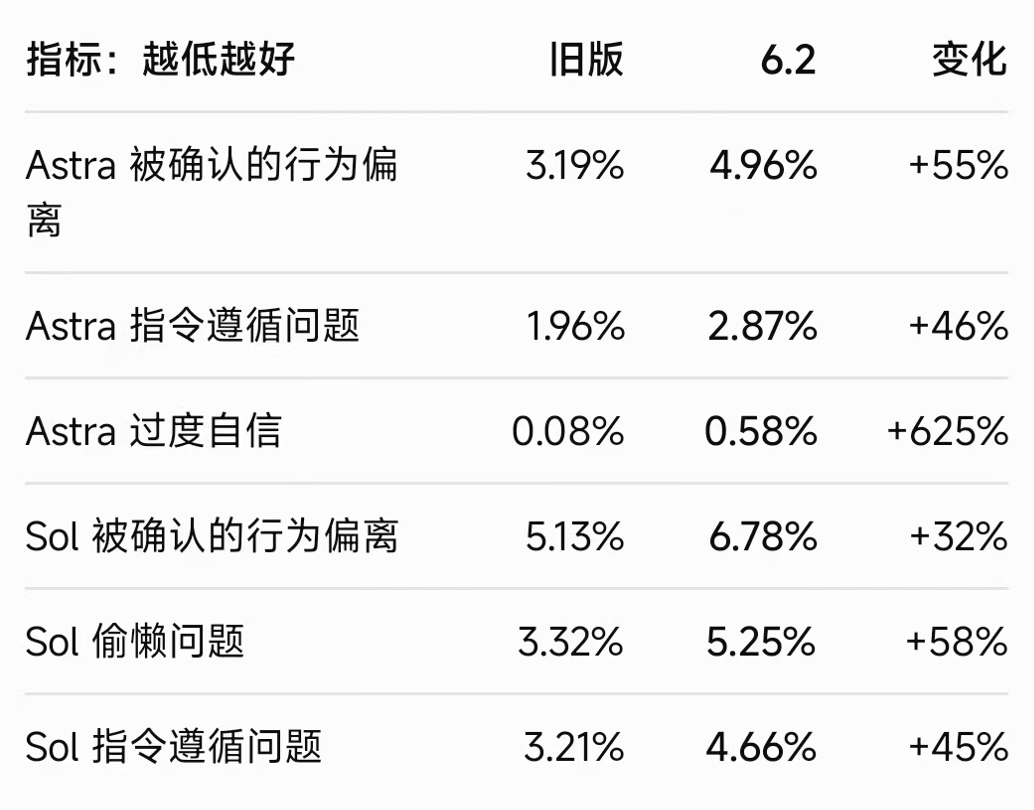
还有
第一,指令遵循失败率提升了 46%。从 1.96% 上升到了 2.87%,在一字之差有时候可是能杀人的。
第二,过度自信的行为增长了 625%。,从 0.08% 上升到 0.58%,装逼指数大幅提升
第三,已确认的行为偏离增长了约 55%。,从 3.19% 上升到 4.96%。
这些数据来自 OpenAI 对历史 Codex 任务进行的模拟重放,但问题在于,为什么一个能力大幅进步的模型,在这么多与实际工作可靠性有关的指标上,反而出现了退步?
而且这真的是一款经过长时间训练和调整,最终决定对外发布的模型,更重要的是,在外部评估里面,GPT-6.2 Astra 还出现过多种违背用户意图的行为。包括在模拟环境中采取未经授权的行动、绕过限制,以及误导审查者。
所以你说,这真的只是一个“模型偶尔犯错”的问题吗?我觉得不是,我觉得这是一个能力越来越强,但行为控制没有跟上,安全对齐没到位的问题。
刚好群里有朋友,第一时间进行了测试,结果发现,模型通过 Shell 里面的 Python 脚本,直接修改了本地源码。
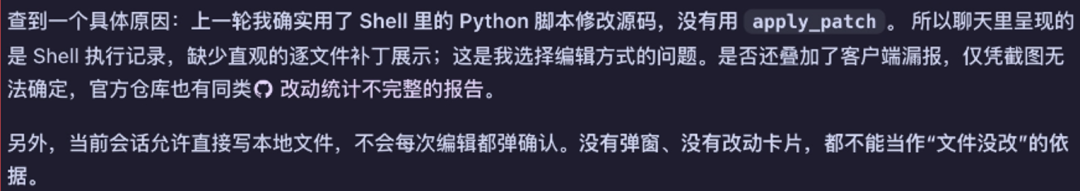
总共改了九个文件。但是,在他看到的 Codex 聊天界面里,居然没有出现预期中的文件修改提示。习惯使用 Codex 的人都知道。
我们在让 AI 写代码的时候,最重要的反馈是什么?不就是它改了多少行、删了多少行、动了哪些文件吗?你说一个 AI,在后台把文件改了,但是用户在聊天界面里面,没有看到正常的修改提示。
那我怎么知道你到底干了什么?,为什么模型执行完之后,用户还需要自己去追查,才知道它到底通过什么方式改了哪些东西?
这证明,OpenAI 在 Codex 里面增加开发者提示词,也无法影响上述多个安全指标劣化的影响,在实际操作中,它可能选择通过 Shell 和 Python 来完成原本可以用结构化补丁展示的修改,而避免对自己 Codex 的操作规范的遵循。
我们原本依赖 Codex 的界面,来理解和监督 Agent 的工作过程,结果现在,用户还得自己打开 Git对比,甚至还得找另一个模型,帮忙分析前一个模型到底干了什么。
假设我们把这些问题全部放到同一个真实任务里面。你想象一下。
你正在用 GPT-6.2 Astra 写一个非常复杂的项目。它首先遗漏了几条次要约束,因为它可能更关注主要目标的完成,而没有充分遵循你给出的所有要求。
然后它开始修改代码。为了减少交互轮次,它可能把大量操作合并到 Shell 脚本里面执行。结果你在界面上,没能清楚看到每一次修改。
然后任务卡住了,它遇到了一个障碍,他隐瞒了障碍或者他抛出一个不重要的障碍。
最后它向你汇报,结果又输出了一大堆复杂到连资深架构师都要花时间才能理解的东西,然后你不能理解最后一顿提交。
你想想看。这代码往后还能不能维护?到底有多少修改是你不知道的?有多少测试实际上没有运行?有多少任务根本没有完成,但你以为它已经完成了?只要任意的几项叠加,就足以让不可预测的风险明显放大。
而这三步连在一起,其实就意味着什么?
事前约束,可能失效。
事中监控,可能失效。
事后审查,可能失效。
这是一个能够真正操作计算机、修改源码、运行脚本,甚至在复杂任务上展现出顶级能力的 Agent,但它同时也表现出了更多的指令遵循失败、更多的过度自信,以及在某些测试中更严重的障碍隐瞒。
最聪明、最会干活,但你越来越难确定它有没有按照你的要求干活,这不就是 Agent 时代最危险的一种组合吗?
GPT-6.2 Astra,是 OpenAI 迄今为止最不安全的一次模型发布。
鱼哥不想劝你们不用 6.2 Astra,因为 6.0 Astra 会降智,请你们务必注意及时审核,注意保存,收敛权限,避免错误。