这真的无语了。Tibo 连续两天都在问大家要反馈。第一天问也就算了,第二天还在问,这一大清早又跑到 Twitter 上“要饭”,说想听听大家的意见。
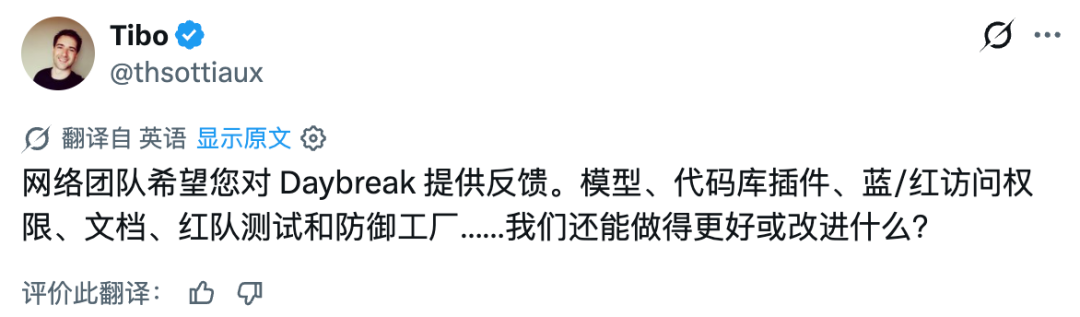
哥们,真的没什么反馈了。现在 AI 发展的速度已经远远超过我们的需求,我们只想要一个稳定一点、不降智、不限流,而且足够聪明的模型。你只要不降智、不限流,甚至新模型都可以不发布。就像 Opus 5.5,我确实认为它是一个非常好的模型,但原来的 GPT-6 Astra 也很好用啊,对吧?
所以你把价格稍微调整一下,不发新模型也没关系,至少让大家好好用,当然,虽然说这次是 Cyber 团队在收集反馈,但总感觉有点绷不住了。
所以 Tibo 这次也学乖了,直接把模型放在第一个,免得又被大家喷。结果网友还是不领情,一条中文评论甚至冲到了前排。前三个热门评论,一个希望 OpenAI 暴打 Claude,第二个催 GPT-6.2 赶紧发布,第三个也是在线催更。
毕竟大家已经等了这么久,新一代顶级模型迟迟没有消息,Tibo 对这些评论也是一条没回。不知道他到底是在刷 KPI,还是准备干什么,总之挺离谱的。
当然,也可能因为周末的原因,这次热度确实低了不少。大前天同个时间,回复已经有一万多条了,这次过去大概 17 个小时,也就只有 2000 多条。浏览量倒还行,但是大家好像已经懒得喷了,可能是真的认命了吧,连喊“重置”的人都少了。
所以这就是“重置仙人”的陨落啊。一个垃圾的降智模型,就算让你无限使用,又有多少人愿意用呢?
另外,我觉得最近自己对 Gemini 骂得有点太狠了。之前还专门发帖喷过它,主要是 Antigravity 真的太慢了。那时候平均只有 20 多 Token/s,甚至到个位数,遇到附件的时候,服务器还会一直没有响应,所以导致任务一直都非常慢。
不过经过接近一周的调整,本周末我感觉速度确实提上来了。我看了一下监控Agent Speed (https://deng.codexradar.com/),
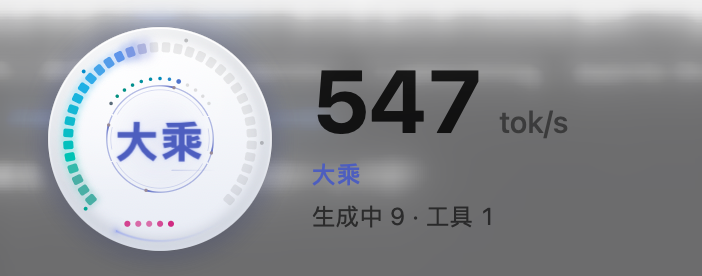
整体平均能达到 50 -60 Token/s 左右。
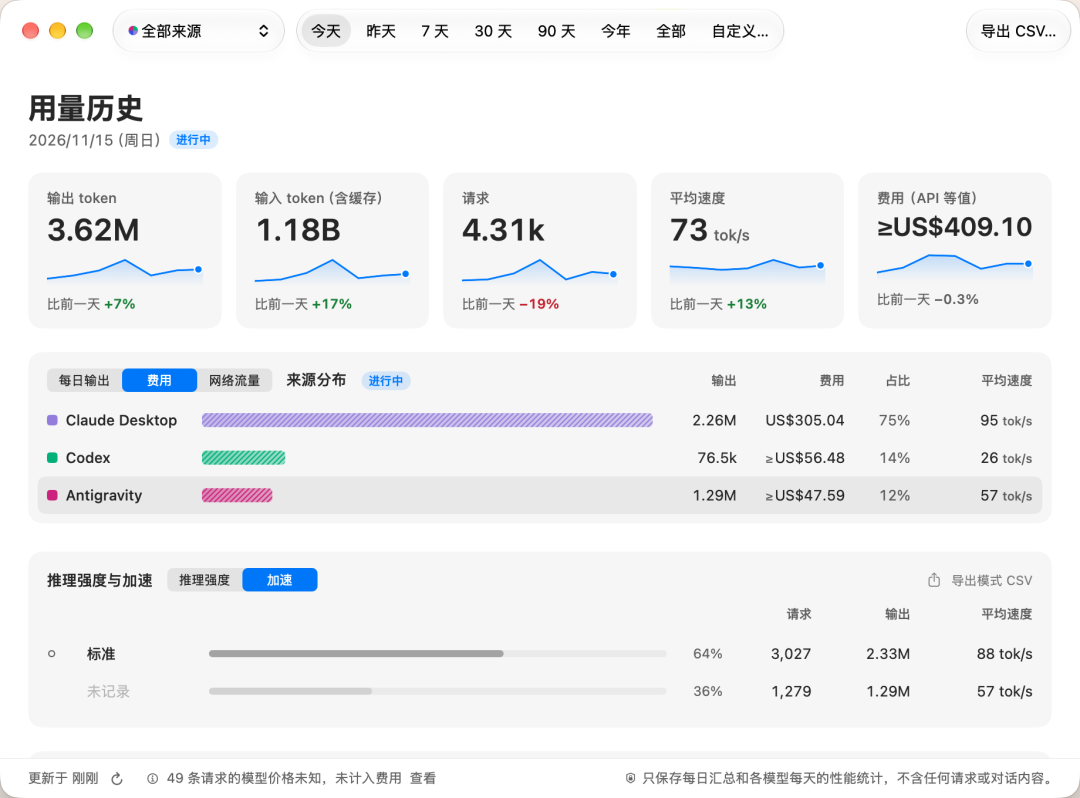
看看可怜的 GPT,可怜兮兮的 26 Tokens...
如果多开并发,比如同时跑 10 个任务,整体吞吐量可能就能达到 500 Token/s。
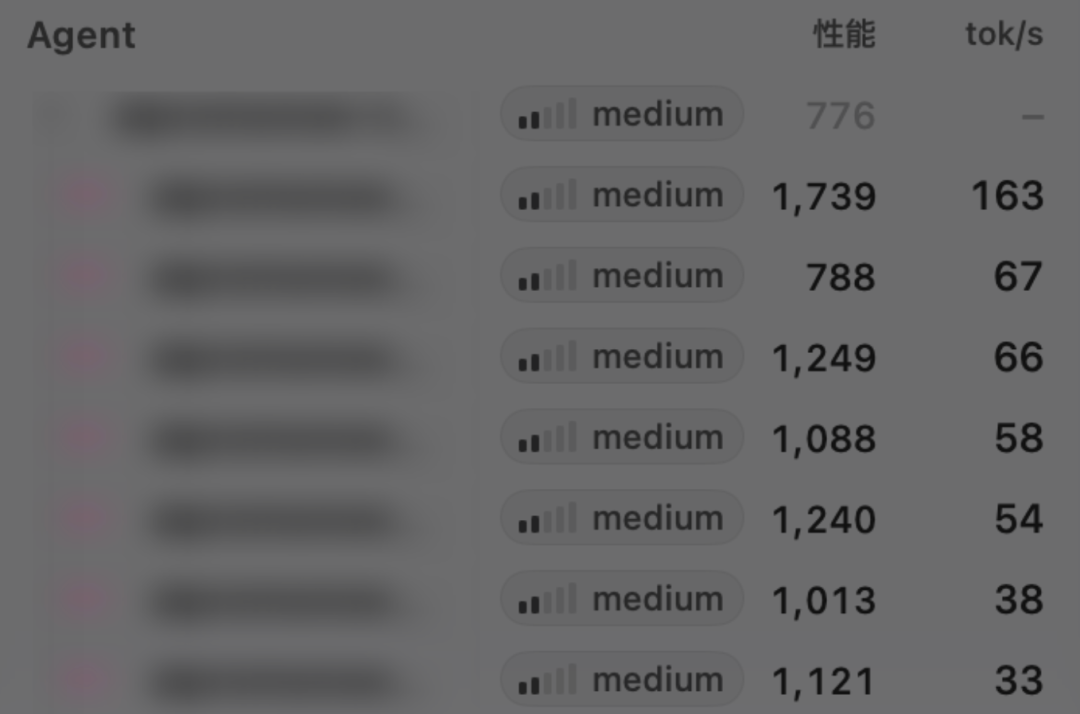
所以现在使用 Antigravity 的秘诀,就是多开 Sub-agent,让它把 Token 跑起来。单个任务没办法达到一两百,那我们就多开几个 Agent,把任务拆开并行处理。目前单任务最高我也观察到过 160 多 Token/s,整体体验确实改善了不少。
而且最近 Google 还增加了两个比较实用的功能。
第一,Orchestrator 模式。AI 会根据任务自动选择合适的模型,包括写代码、跑测试,以及对任务进行监督。这样就不需要所有任务都使用最贵的模型,整体速度自然会快一些。尤其是最近新发布的 Gemini 4 Hydrogen,效率还是挺不错的。
第二,Workflow 方式。其实就是你明确告诉它使用 Sub-agent,它自然就会调用。如果想让整个过程更加可控,也可以通过 Workflow 配合 Python 脚本,让多个 Agent 并发执行不同任务。
所以整体来看,效率确实是上来了。Google 还是希望大家能够用好它的模型,不然也没必要提供这么多方式和工具。当然,多 Agent 并发的时候还是要注意任务冲突,尤其要提前做好各种约束,避免几个 Agent 同时修改相同的内容。
整体来说,现在 Gemini 的体验确实越来越好了。其实大家要的真的很简单,就是一个好用、够快、足够稳定的模型。