ds_re_j02
描述:解密,第八行的第二列数据是 flag
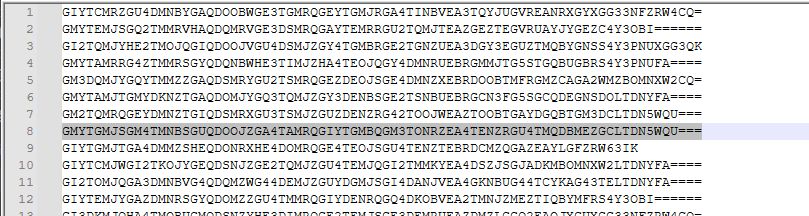
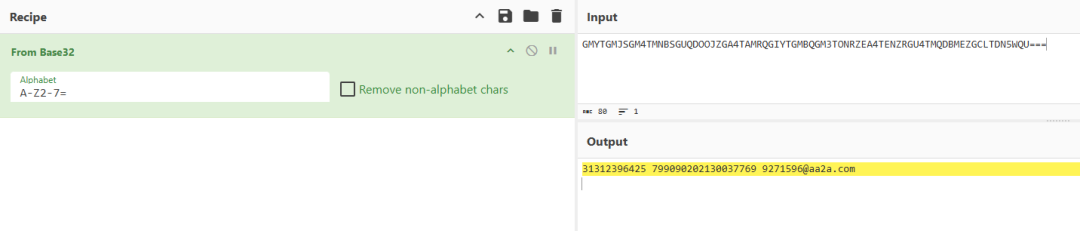
打开文件找到第八行,丢到cyberchef中解码,根据提示,第二列,就是799090202130037769
wm
描述:分析获取水印信息
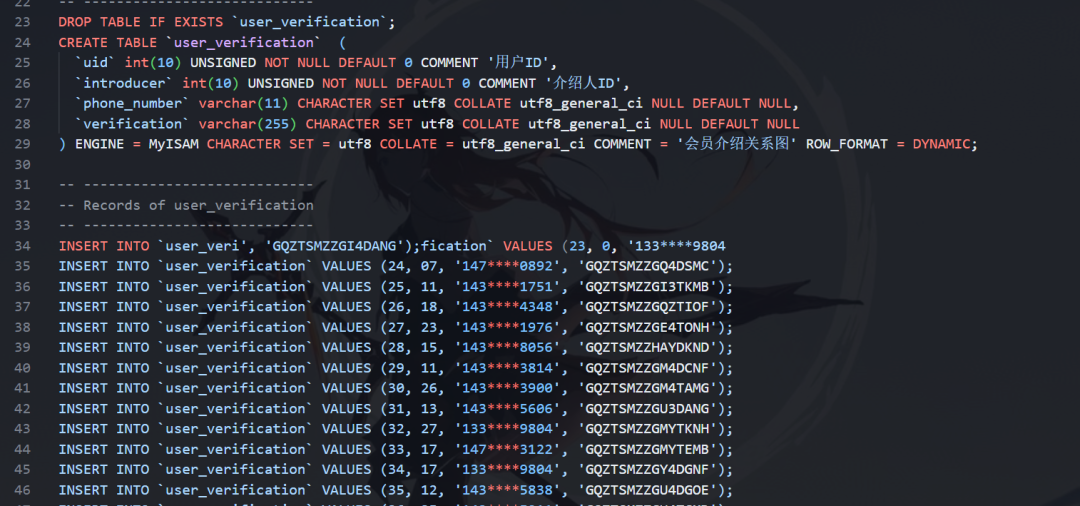
verification这列非常可疑,先写个脚本提取一下
import re

with open("user_verification.sql", "r", encoding="utf-8") as f:
    for line in f:
        match_case = re.search(r"', '(.*?)'", line)
        if match_case:
            print(match_case.group(1))
但是后面是怎么做的我个人感觉有点迷
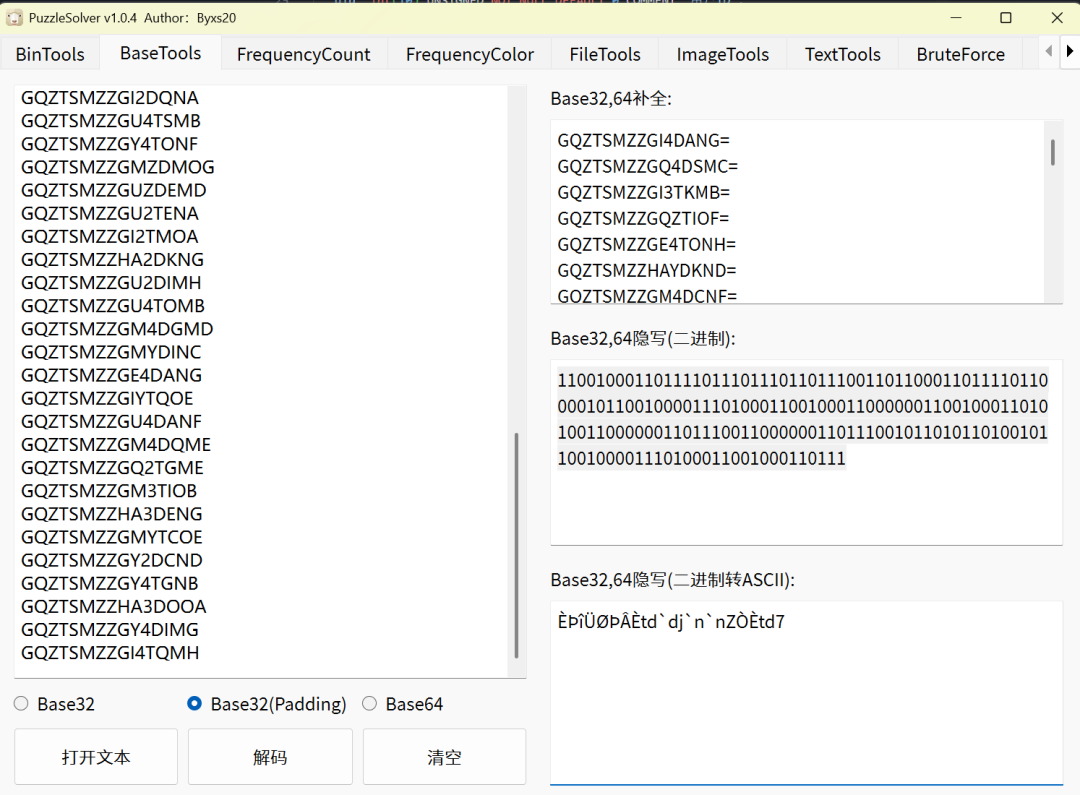
先是放到PuzzleSolver中进行base32解码,然后将二进制最前面补个0,但是这是为什么呢???
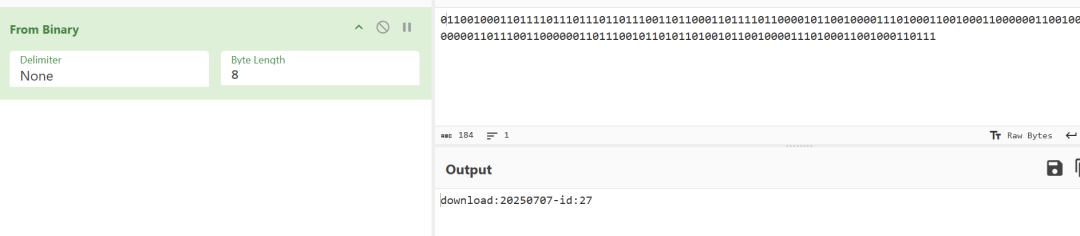
奇怪的加密文件
描述:某公司使用国产商用密码加密保护员工考勤数据,因管理员意外离职未交接密码,导致考勤文件无法解密。这直接影响了公司财务部对员工的薪资核算。公司邀请你,专业的数据安全高手,请发挥你的技能特长,运用已知的线索来破解这个难题,解密考勤文件获取 flag。
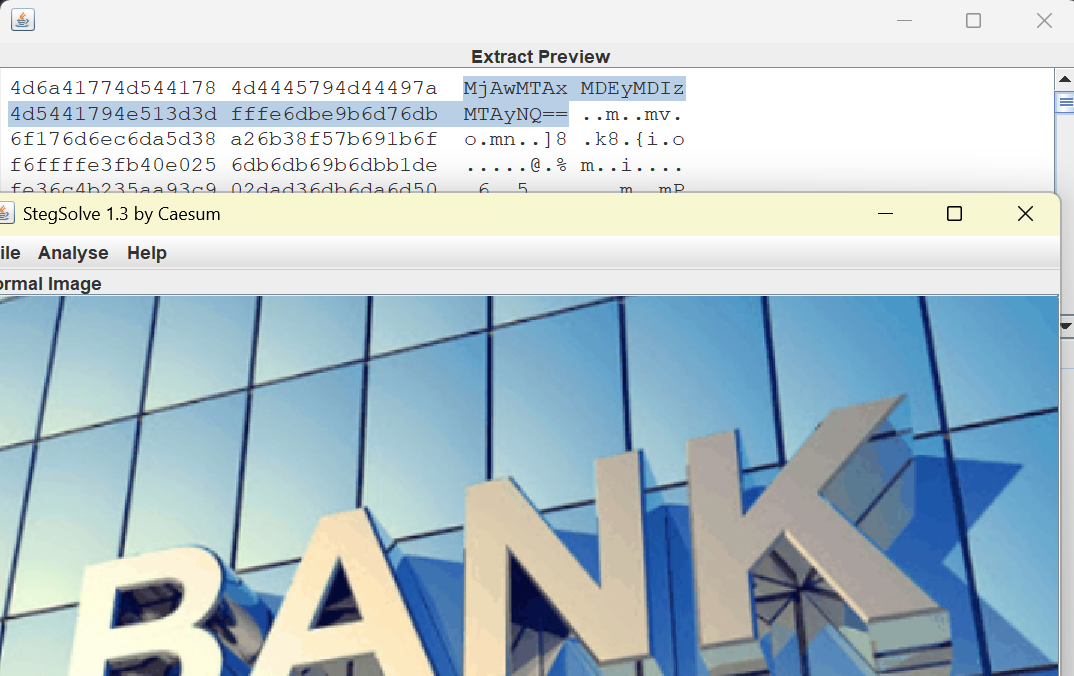
给了一张png文件,常规思路就是看下宽高和lsb隐写,发现疑似base编码的密文
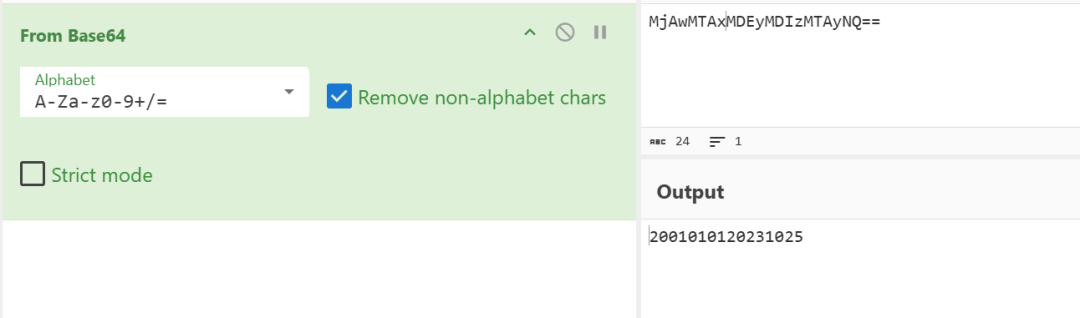
随波逐流解码得到的结果长度为16,猜测是密钥。但是至于为什么是sm4加密,应该就是题目提示,说是使用的商用密码
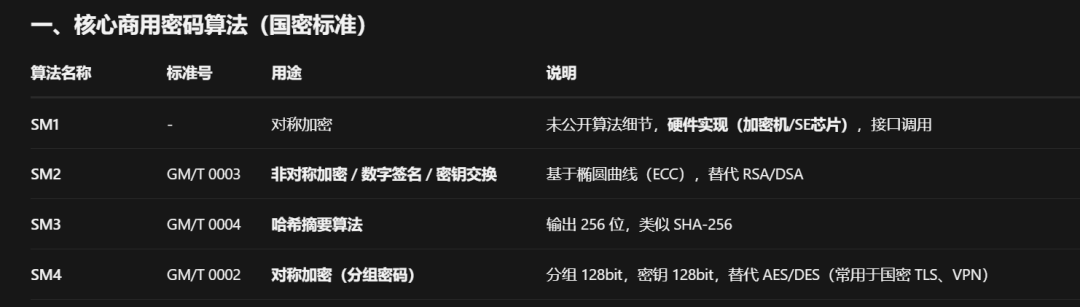
正好sm4这里的密钥也是16B,刚好吻合,但是这里的iv值我不太明白,看其他师傅的wp说是默认的iv值
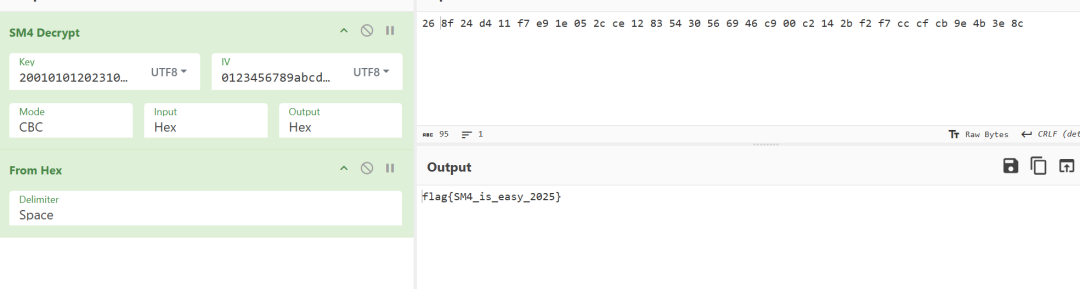
默认iv值为0123456789abcdef
公司机密
描述:某上市公司 CE0 李总,惊悉公司重要商业机密遭到泄密,这可能给公司带来巨大经济损失和声誉危机。经过初步排查,李总怀疑与自己的心腹小赵有关。据了解,小赵有个特殊癖好,喜欢用一些看似莫名其妙的文件创建时间作为密码,可关键文件目前已被删除。在报警后,警方介入调查后,运用专业的数据恢复工具,成功找回了部分相关文件,其中包含一张奇怪的图片,图片上是一些杂乱无章的几何图形和颜色色块,但文件创建时间却难以确定,仅能推断其肯定早于文件修改时间。此外,调查发现有个客户曾给小赵发送过一个秘密文件,而该文件的密码正是这位客户的名字。现在,摆在你面前的任务是:通过技术手段,找到恢复文件中的 flag,帮助公司。
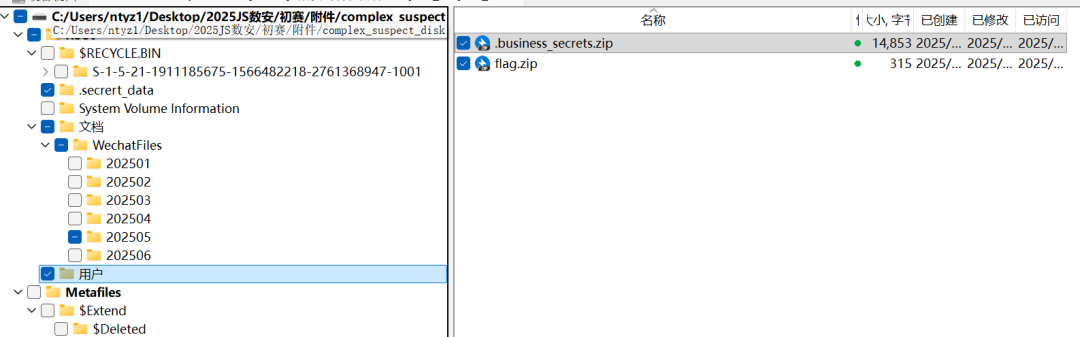
挂载镜像找到这两个文件夹,猜测flag.zip就是客户给小赵发送的秘密文件,.business_secrets.zip就是那个以时间为密码的文件。
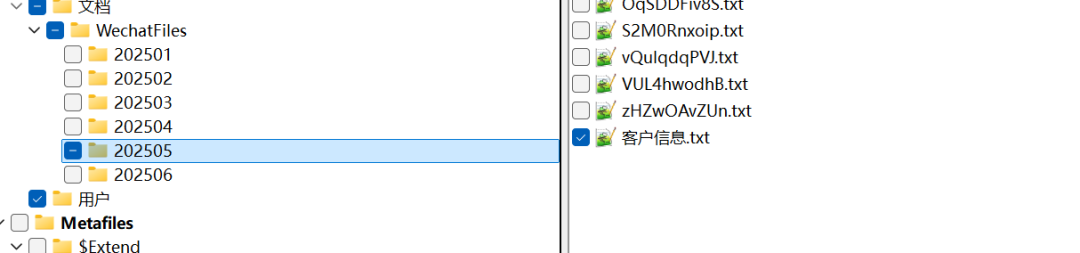
又发现有客户信息,里面是客户名,最简单的方法就是把客户名的拼写做成字典直接爆破flag.zip,这里我们按照预期解去推,先解密.business_secrets.zip
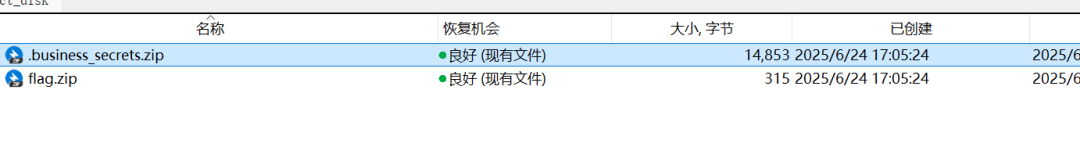
看到这个文件的创建时间,用20250624170524测试发现是错误的,这里日期固定,直接爆破时间
可以看到口令恢复,就是20250624155509
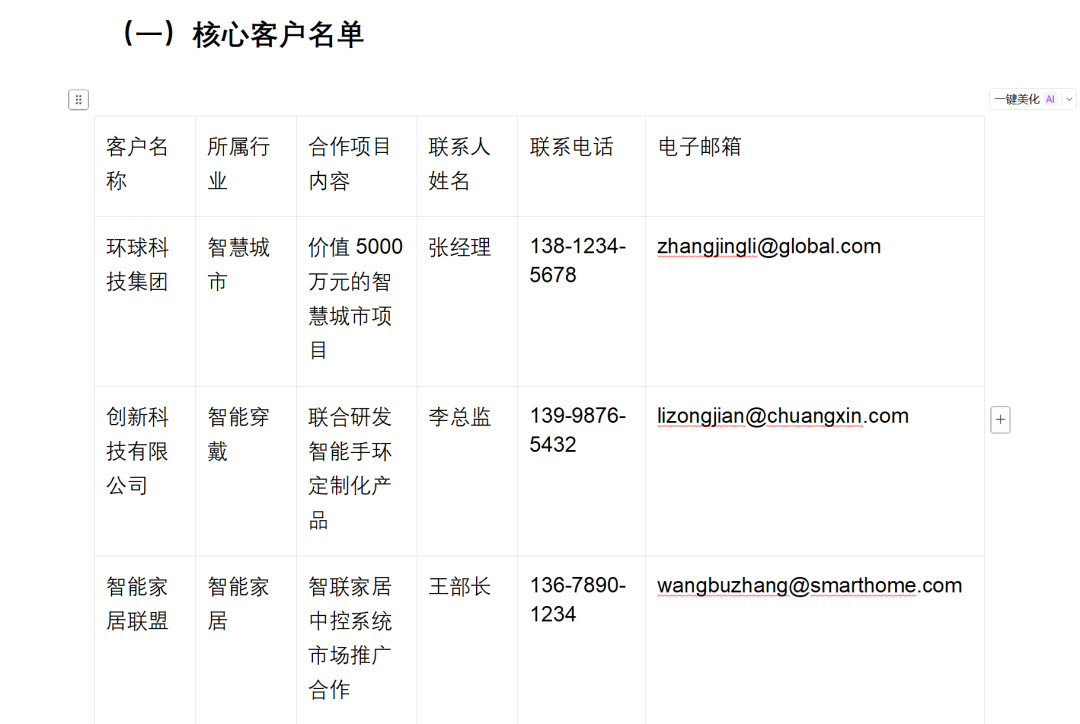
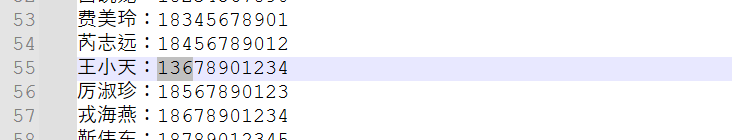
解压后获取到word文档,找出和兴客户名单,一个个尝试,最终找到是王小天的拼音是匹配的:wangxiaotian,直接解压flag.zip得到flag
API访问⻛险评估
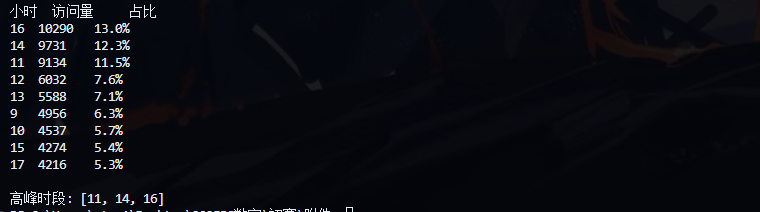
描述:以小时为单位,分析一天工作时间(9:00-17:00)内各小时的访问量分布,找出企业业务高峰时间段。 访问高峰时段定义为:该小时的访问量超过 9:00-17:00 全时段内平均每小时访问量的时间段。
【评测标准】请提交访问高峰时段的小时数(24 小时制),多个小时按从小到大排序,用英文逗号分隔。
import csv
import pandas as pd

with open('场景附件/api_logs.csv', 'r', encoding='utf-8-sig') as infile:
    reader = csv.DictReader(infile)
    with open('场景附件/access_times.csv', 'w', newline='', encoding='utf-8-sig') as outfile:
        writer = csv.writer(outfile)
        writer.writerow(['访问时间'])
        for row in reader:
            writer.writerow([row['访问时间']])

df = pd.read_csv('场景附件/api_logs.csv', encoding='utf-8-sig')
access_times = pd.to_datetime(df['访问时间'], errors='coerce').dt.hour
work_hours = (access_times >= 9) & (access_times <= 17)
hourly_visits = df[work_hours].groupby(access_times).size()
average_visit = hourly_visits.mean()
peak_hours = hourly_visits[hourly_visits > average_visit].index.tolist()

print(f"\n{'小时':<4}{'访问量':<8}{'占比':<6}")
for hour, count in hourly_visits.sort_values(ascending=False).items():
    ratio = (count / df.shape[0]) * 100
    print(f"{hour:<4}{count:<8}{ratio:.1f}%")
print(f"\n高峰时段: {sorted(peak_hours)}")
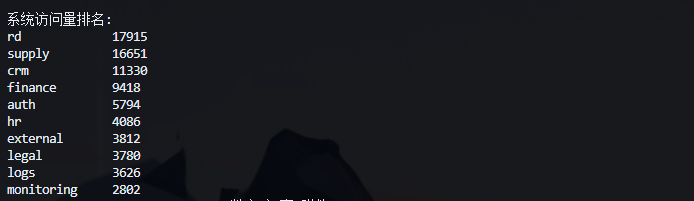
统计各个业务系统在⼀天中的访问量,找出访问量前三的系统。
import pandas as pd

# 读取CSV文件
df = pd.read_csv('场景附件/api_logs.csv', encoding='utf-8-sig')

# 提取系统名称(URL路径中的第二级目录)
system_column = df['请求URL'].str.extract(r'v1/(.*?)/', expand=False).fillna('未知接口')

# 统计每个系统的访问次数
system_counts = system_column.value_counts().sort_values(ascending=False)

# 输出结果
print("\n系统访问量排名:")
for system, count in system_counts.items():
    print(f"{system:<15}{count}")
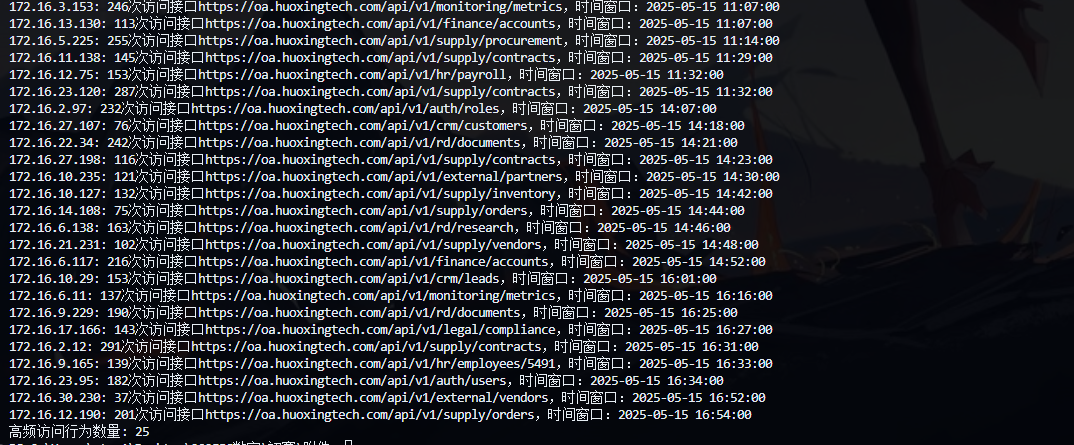
检测⾼频访问⾏为,识别可能的恶意 IP。⾼频访问⾏为定义为:同⼀ IP 在任意⼀个⾃然分钟内 (即每连续 60 秒且起始时间为整点或整分,如 08:05:00-08:05:59)对同⼀个接⼝的请求次数超过 30 次。
import sys
from collections import defaultdict
import datetime

def main():
    ip_url_minute_counts = defaultdict(int)
    with open("场景附件/api_logs.csv", "r") as f:
        # 跳过表头行
        first_line = next(f).strip()
        if first_line == "访问时间,访问IP,请求URL,HTTP状态码,user-agent":
            # 正常CSV文件,继续处理后续行
            for line in f:
                parts = line.strip().split(",")
                if len(parts) < 3:
                    continue
                timestamp_str = parts[0]
                ip = parts[1].strip()
                url = parts[2].strip()

                # 修改时间格式以匹配日志中的 '2025/5/15 0:00'
                dt = datetime.datetime.strptime(timestamp_str, "%Y/%m/%d %H:%M")
                minute_start = dt.replace(second=0, microsecond=0)

                key = (ip, url, minute_start)
                ip_url_minute_counts[key] += 1
        else:
            # 非标准CSV文件,处理全部行
            for line in f:
                parts = line.strip().split(",")
                if len(parts) < 3:
                    continue
                timestamp_str = parts[0]
                ip = parts[1].strip()
                url = parts[2].strip()

                dt = datetime.datetime.strptime(timestamp_str, "%Y/%m/%d %H:%M")
                minute_start = dt.replace(second=0, microsecond=0)

                key = (ip, url, minute_start)
                ip_url_minute_counts[key] += 1

    num = 0
    # 输出高频访问行为
    for (ip, url, minute_start), count in ip_url_minute_counts.items():
        if count >= 30:
            num += 1
            print(f"{ip}: {count}次访问接口{url},时间窗口:{minute_start}")

    print(f"高频访问行为数量: {num}")
if __name__ == "__main__":
    main()
为了保障数据安全,公司内部仅允许正常⽤⼾的浏览器的User-Agent和开发使⽤的postman、curl、requests等⼯具对API进⾏访问。请检查User-Agent,找到使⽤其他⼯具访问API的IP地址。
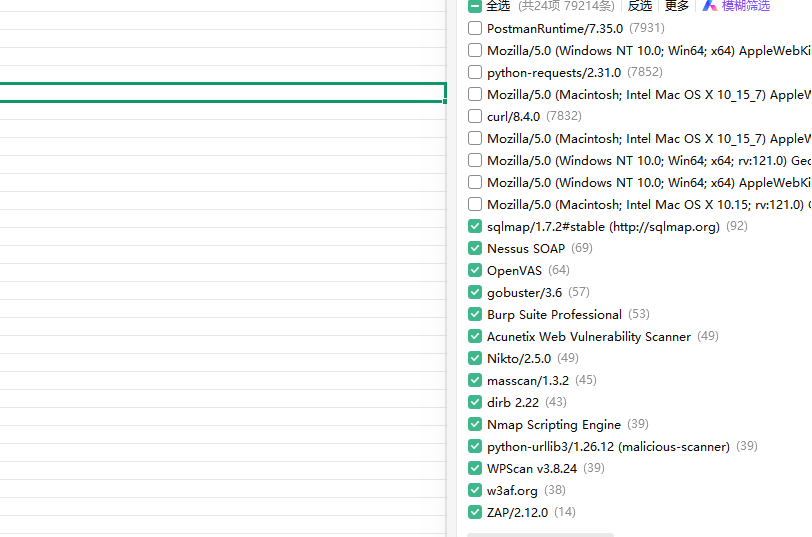
这道题反而直接在excel表中操作更快,首先筛选出恶意的user-agent
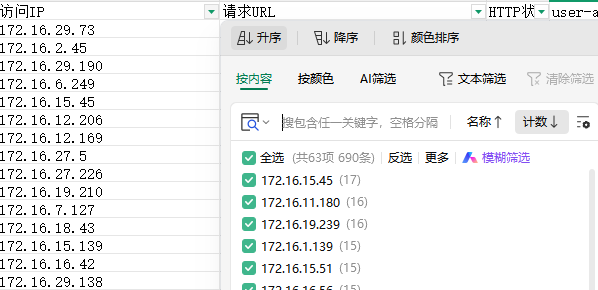
然后看一共63项
科研平台数据安全检查
背景:某⾼校建⽴了⼀个科研成果平台,⽤于共享和备份科研成果,使⽤FTP协议。平台规定,所有的成果上传到平台都需要使⽤每个⼈对应的aes256密钥进⾏加密,且同时上传sha256哈希⽂件,⽤于校验恢复后⽂件的完整性。为了保证平台数据安全,需要对平台流量进⾏审计。
分析提供的流量⽂件,找到哪些研究成果只上传了成果⽂档,但是没有上传哈希⽂件。
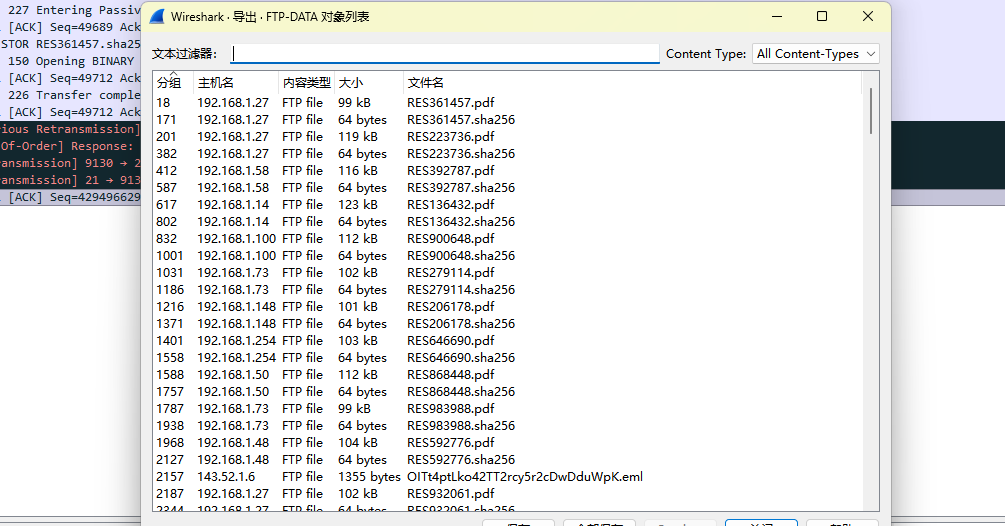
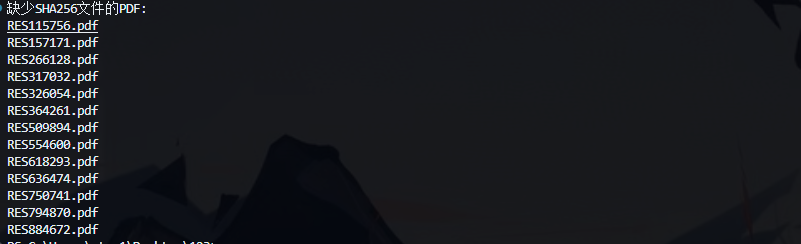
这里直接手动导出所有的pdf文件以及sha256文件,然后写个脚本筛选一下
import os

dir_path = os.getcwd()
pdf_files = [f for f in os.listdir(dir_path) if f.endswith('.pdf')]
missing_sha256 = []

for pdf in pdf_files:
    base_name = os.path.splitext(pdf)[0]
    sha256_file = f"{base_name}.sha256"
    if not os.path.exists(os.path.join(dir_path, sha256_file)):
        missing_sha256.append(pdf)

print("缺少SHA256文件的PDF:")
for file in missing_sha256:
    print(file)
科研成果在提交到平台之前,都会进⾏审核并记录哈希,现在检查发现有些成果上传的和提交审查的⽂件存在区别,请使⽤提供的aes256密钥解密⽂件,并校验哈希,找到哪些科研成果存在区别。
不会😭
近期在平台上发现了⼀些.eml后缀的垃圾邮件,检查流量,找到登录并上传这些eml垃圾邮件的⽤⼾名数量
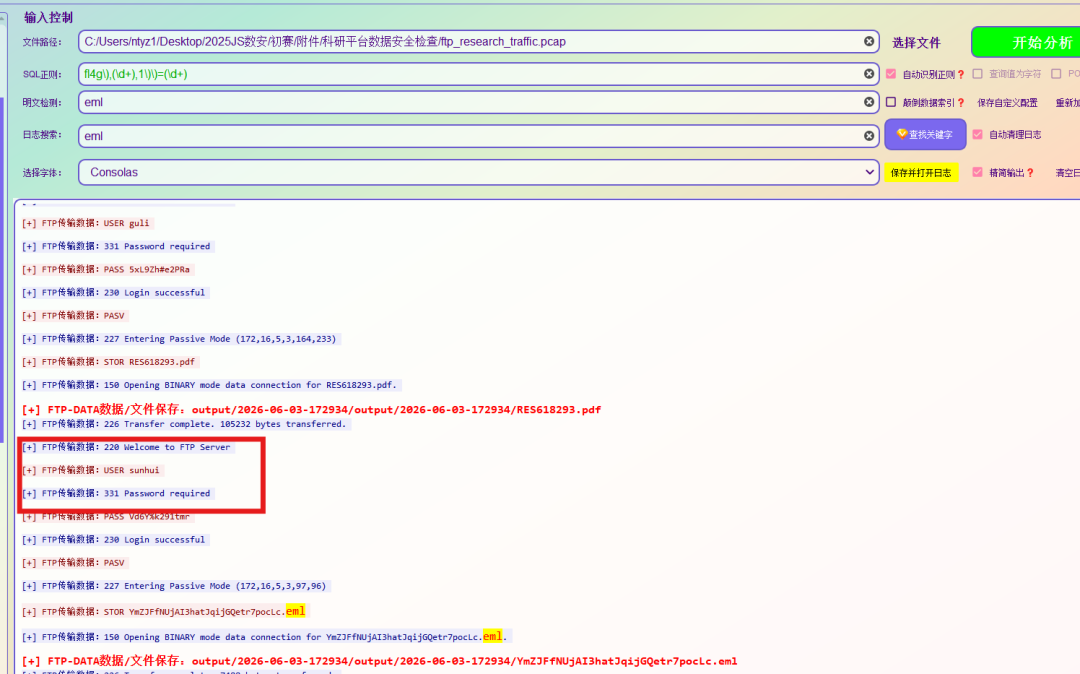
neta一把锁找到user名,一个个找上传eml文件的用户
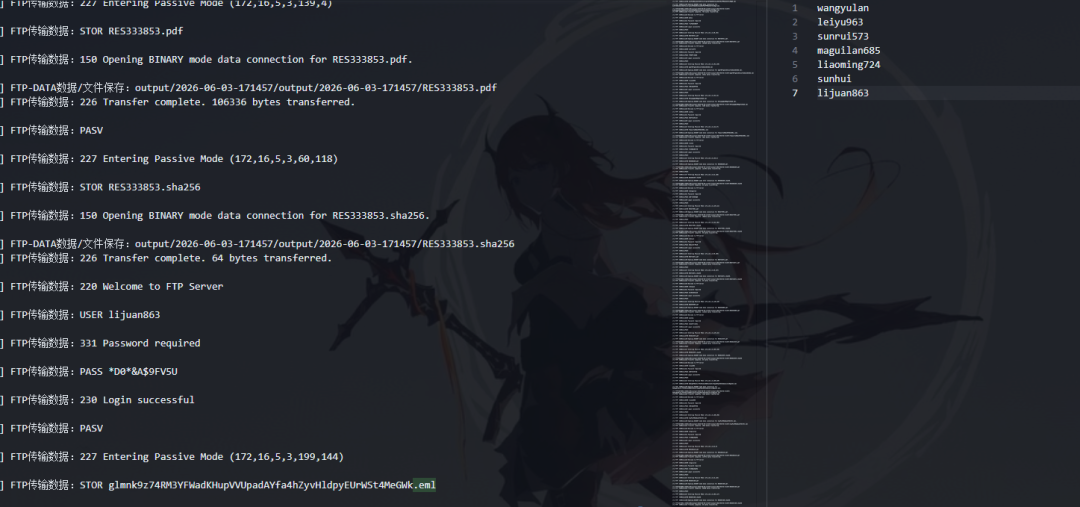
手动筛选找到7个不同的用户