前言
暑假一直想锻炼一下自已读反编译伪代码的能力,就找了一道SUCTF的题目练练手,结果一搞就是3天,还是自已太菜了😭😭😭
这里分享一下自已的解题过程。顺便说一下,我在结尾放了一个小彩蛋(*❦ω❦)
具体过程
拿到一个附件发现是一个安装程序
用InnoUnpack打开该压缩程序
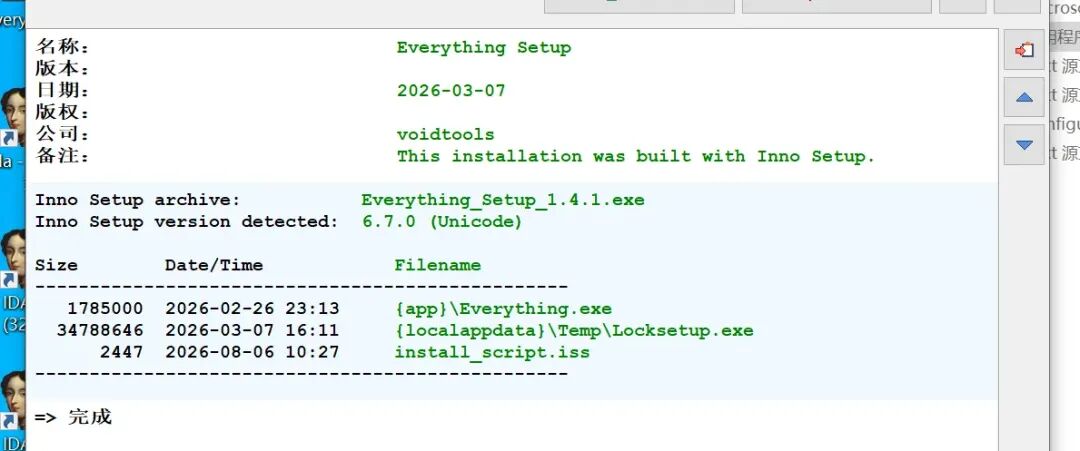
除了释放出Everything外,还会释放出一个Locksetup.exe程序,这里是需要密码的,所以工具提取不了 尝试运行一下这个程序,因为题目提示需要开启内核调试模式,这里推测是要加载未签名的驱动
bcdedit /set testsigning on
开启后尝试运行程序
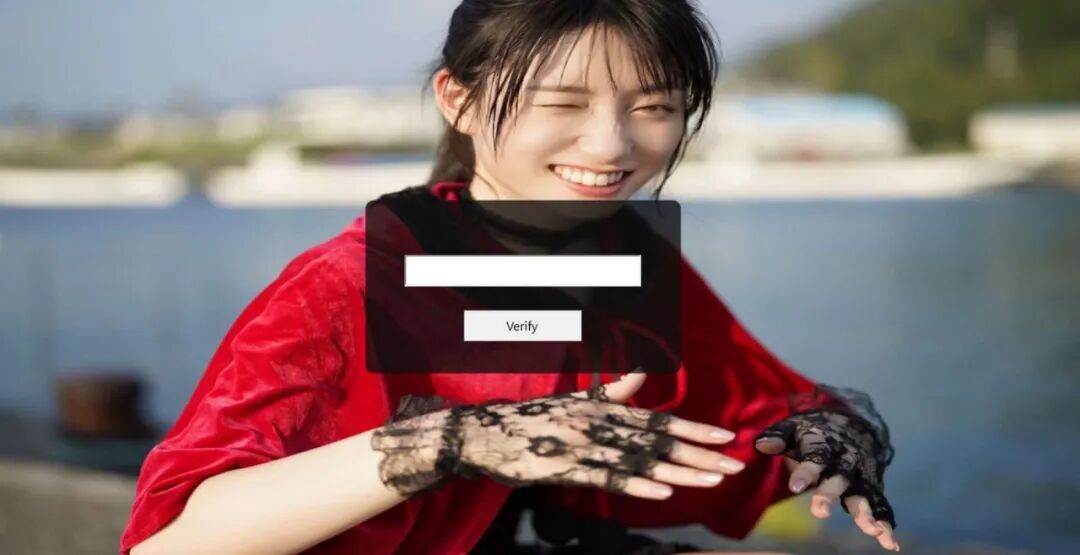
出现了 flag 校验界面,这个应该就是那个Locksetup.exe搞的鬼,之前我们已经知道他会释放到Tmp文件夹里,所以直接分析用DiskGenius分析对应编号的虚拟机vmk文件
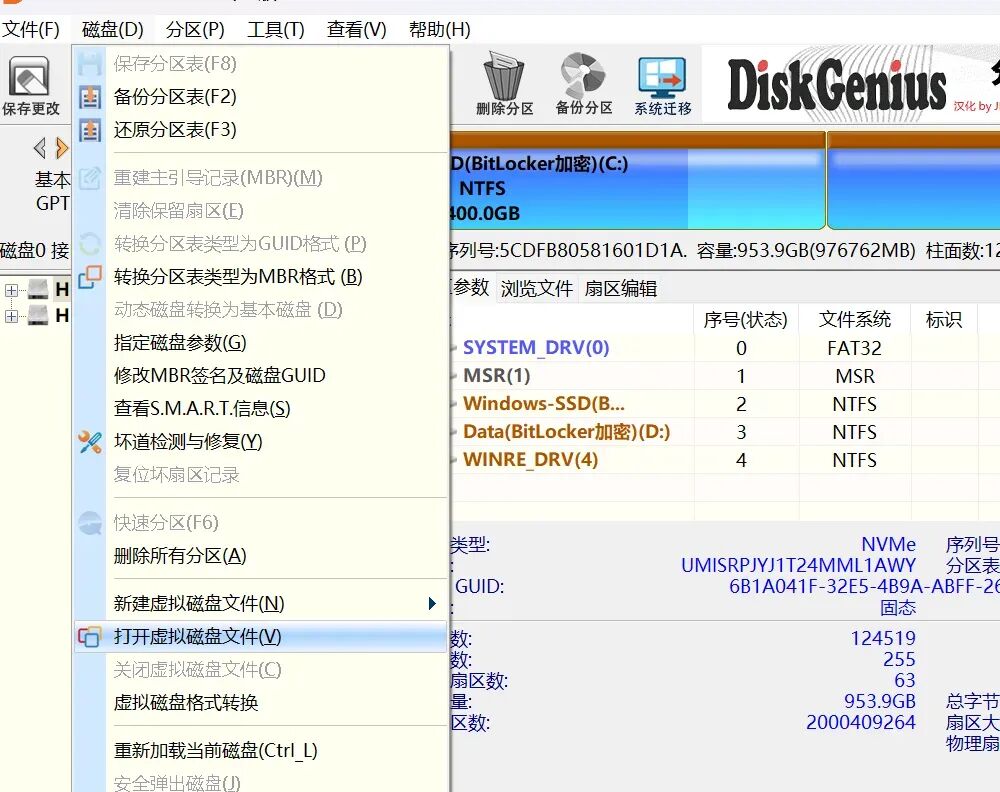
打开虚拟磁盘文件

找到释放后的文件,提取出来
因为之前提到过,这个程序可能会释放驱动,相比释放的这个驱动肯定比较重要,先将驱动提取出来
释放的驱动一般会通过CreateServiceA这个 API 启动,在 IDA 中找到该 API
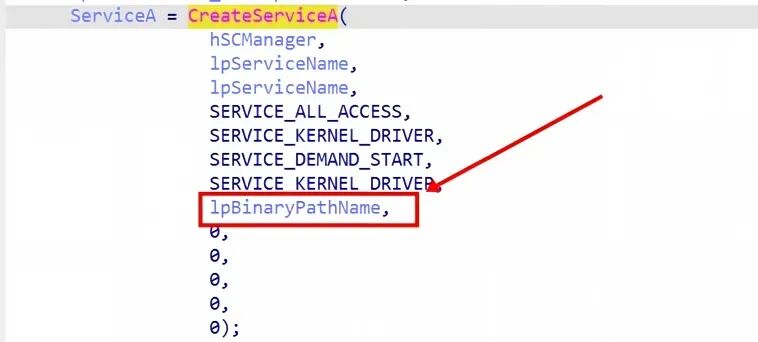
动态调试到这里的IpBinaryPathName,找到驱动的位置 但这里存在反调试,我们需要进行绕过
我们需要用管理员身份去运行 IDA,这里动态调试过程中目标程序也是以管理员身份运行
找到ExitProcess这个 API,交叉引用查看,可以一直定位到跳转处
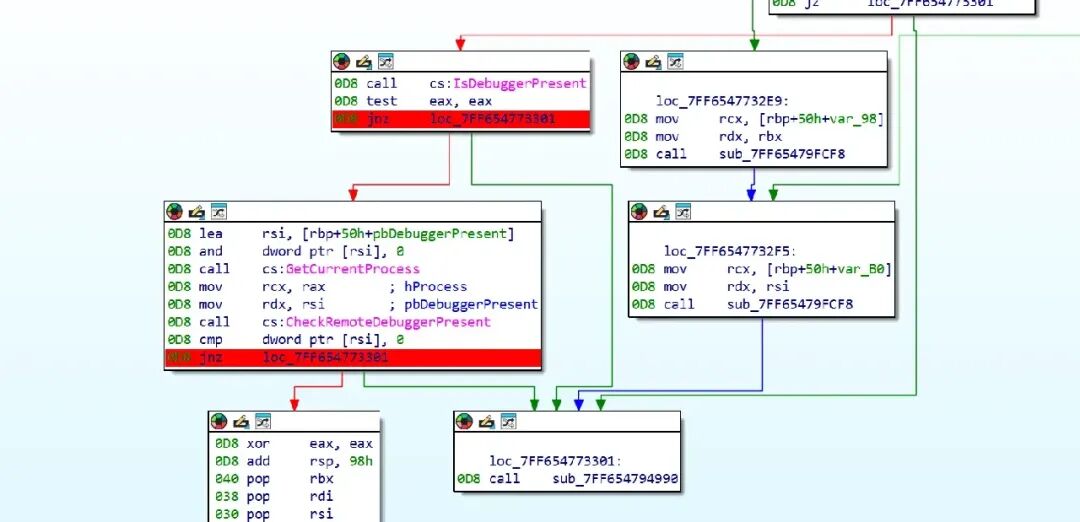
这里在这两处地方打断点,运行时通过SetIp去改变控制流,即可绕过该反调试
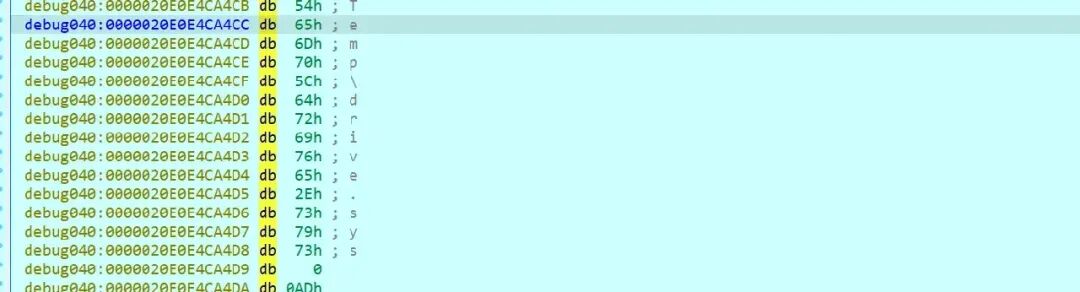
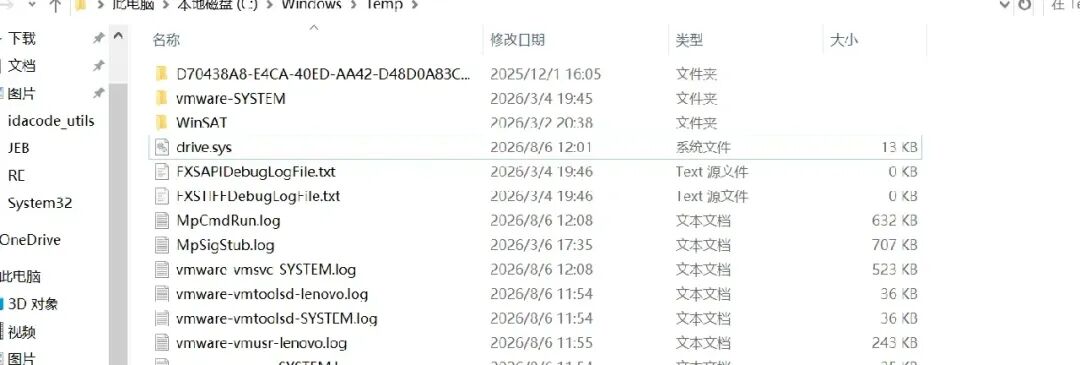
这里看来会释放一个drive.sys的文件,在文件资源管理器中提取
通过在字符串中寻找,没有找到verify字段,sys文件运行在内核态,会通过IofCompleteRequest这个 API 将底层的处理结果返回到用户态,这里跟踪这个 API
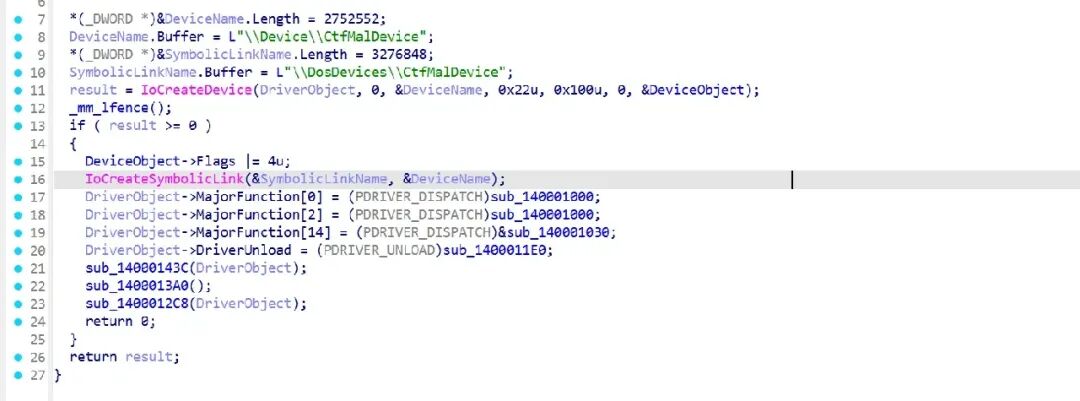
这里内核态与用户态之间交流时通过\\Device\\CtfMalDevice这个设备进行交流的,下面为不同的指令注册 IRP 派遣函数,根据 IRP 主功能号进入不同的函数
这里处理逻辑是sub_140001030这个函数
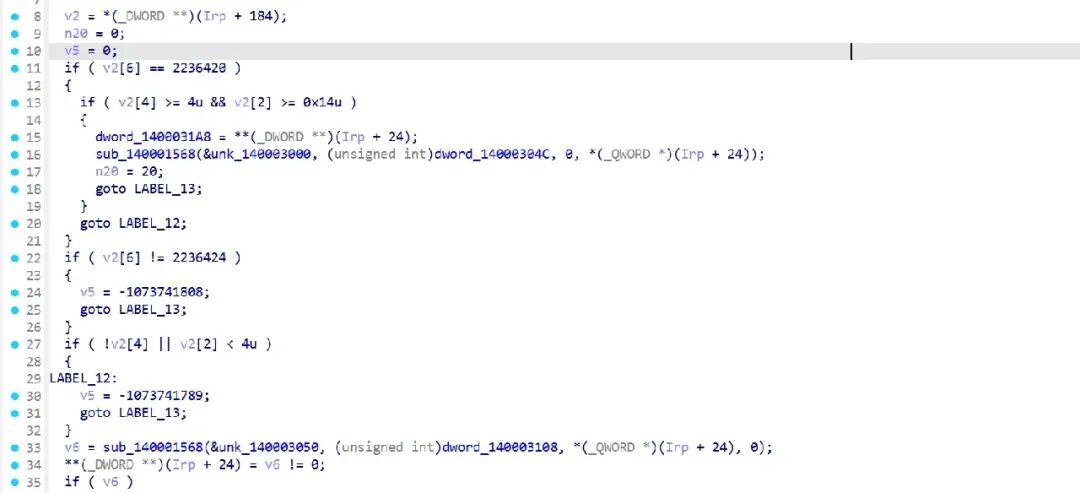
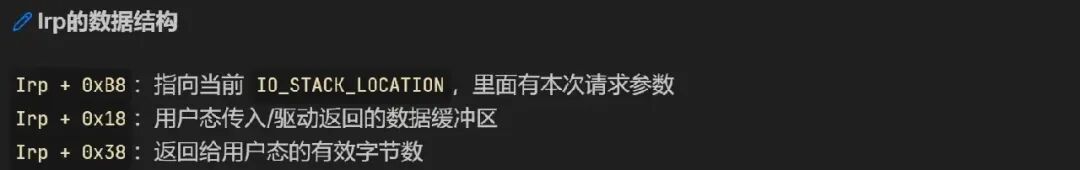
这里抽象出来的逻辑如下:
if ( IoControlCode == 0x222004 )
{
    dword_1400031A8 = **(_DWORD **)SystemBuffer;
    sub_140001568(&unk_140003000, (unsigned int)dword_14000304C, 0, *(_QWORD *)SystemBuffer);
    goto LABEL_13;
}

v6 = sub_140001568(&unk_140003050, (unsigned int)dword_140003108, *(_QWORD*)SystemBuffer, 0);
LABEL_13:
*(_QWORD *)IoStatus.Information = 20;
IofCompleteRequest((PIRP)Irp, 0);
return v5;
这里会判断操作码是否是0x222004,分别进入不同的函数,查看一下sub_140001568这个函数
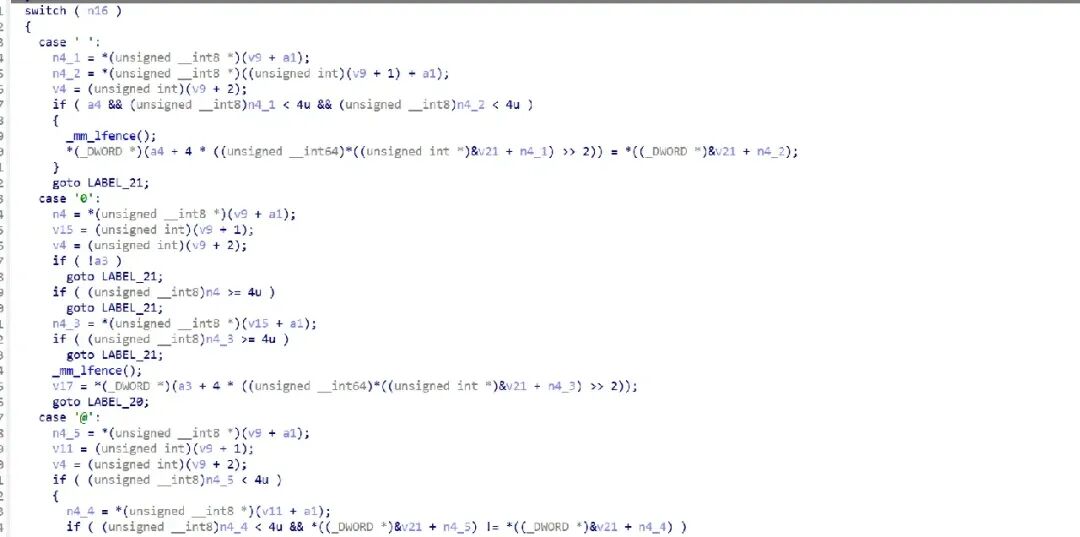
这里是一个虚拟机,抽象出来的逻辑如下:
  while ( 1 )
  {
    opcode = vmcode[v4];
    v9 = (unsigned int)(v4 + 1);
    n4 = vmcode[v9];
    v4 = (v9 + 5);
    if ( (unsigned __int8)n4 < 4u )
    {
      v17 = vmcode[v9 + 1];
      register[n4] = v17;
    }
  }
  switch ( opcode )
  {
    case 0x20:
      n4_1 = vmcode[v9];
      n4_2 = vmcode[v9+1];
      v4 = (unsigned int)(v9 + 2);
      if ( a4 && (unsigned __int8)n4_1 < 4u && (unsigned __int8)n4_2 < 4u )
      {
        a4[register[n4_1] >> 2] = register[n4_2];
      }
    case 0x30:
      n4 = vmcode[v9];
      n4_3 = vmcode[v9+1]
   v4 = (unsigned int)(v9 + 2)
      v17 = a3[register[n4_3] >> 2];
      register[n4] = v17;
    case 0x40:
      n4_5 = vmcode[v9];
      v4 = (unsigned int)(v9 + 2);
   n4_6 = vmcode[v9+1]
      if ( (unsigned __int8)n4_4 < 4u && register[n4_5] != register[n4_6] )
          return 0;
  }
  return opcode == -1;
}
0x10的逻辑是读取 4 字节放入寄存器中,0x20的逻辑是向缓冲区填数据,0x30的逻辑是从缓冲区读数据,0x40的逻辑是比较两个寄存器的值
通过两个不同的指令函数传参的位置可以推测出,当指令为0x222004时,向缓冲器写数据,其它是,从缓冲区读取数据。这里推测是在sys中生成密钥,传入用户态,用户态加密后,再传入内核态进行比较,返回比较结果
先解释0x222004的指令集:
import sys


register = [0] * 15

buffer = [0]*100

def execute_vmcode(vmcode):

    """

    模拟 VMP 虚拟机执行器

    参数:

        vmcode: 字节码数组,包含操作码和操作数

    """


    # Buffer 用于存储 a4 操作的结果 (长度256)

    buffer = [0] * 256

    ip = 0  # 指令指针

    step = -1

    print(f"{'Step':<10} {'IP':<10} {'Opcode':<10} {'Description':<40} {'Action':<50}")

    print("-" * 100)

    while ip < len(vmcode):

        opcode = vmcode[ip]

        if opcode == 0x10:  # LOAD_REG

            # 指令格式: [0x10, operand(0-3), value, padding...]

            operand = vmcode[ip + 1]

            value = vmcode[ip + 2]|(vmcode[ip + 3]<<8)|(vmcode[ip + 4]<<16)|(vmcode[ip + 5]<<24)

            if ip + 2 >= len(vmcode):

                print(f"Error: LOAD_REG instruction incomplete at IP={ip}")

                sys.exit(1)

            step = step+1

            print(f"Step {step}: IP={ip:02x} | Opcode=0x{opcode:02X} | "

                  f"Operand={operand} | Value=0x{value:02X}")

            print(f"         => register[{operand}]=0x{value:02X}")

            # 存入寄存器池

            register[operand] = value

            # 跳过 5 字节

            ip += 6

        elif opcode == 0x20:  # STORE_REG

            # 指令格式: [0x20, operand1, operand2]

            if ip + 2 >= len(vmcode):

                print(f"Error: STORE_REG instruction incomplete at IP={ip}")

                sys.exit(1)

            operand1 = vmcode[ip + 1]

            operand2 = vmcode[ip + 2]

            # 获取寄存器值

            reg_val_1 = register[operand1]

            reg_val_2 = register[operand2]

            # 计算目标索引: reg_val_1 >> 2

            target_index = reg_val_1 >> 2

            step = step+1

            print(f"Step {step}: IP={ip:02x} | Opcode=0x{opcode:02X} | "

                  f"Operand1={operand1} ({reg_val_1:#06x}) | Operand2={operand2} ({reg_val_2:#06x})")

            print(f"         => Buffer[{target_index}]=0x{reg_val_2:02X}")

            # 存入 buffer

            buffer[target_index] = hex(reg_val_2)

            # 跳过 2 字节

            ip += 3

        else:

            print(f"Error: Unknown opcode 0x{opcode:02X} at IP={ip}")

            sys.exit(1)

    return register, buffer


# ==================== 测试用例 ====================

if __name__ == "__main__":

    # 硬编码示例字节码

    # 指令1: LOAD_REG, operand=2, value=0x3A

    # 指令2: LOAD_REG, operand=3, value=0x4B

    # 指令3: STORE_REG, operand1=1, operand2=2

    vmcode = [

0x10, 0x0, 0x8e, 0x6a, 0x37, 0x9e, 0x10, 0x1, 0x0, 0x0, 0x0, 0x0, 0x20, 0x1, 0x0, 0x10, 0x0, 0xef, 0xbe, 0xad, 0xde, 0x10, 0x1, 0x4, 0x0, 0x0, 0x0, 0x20, 0x1, 0x0, 0x10, 0x0, 0xbe, 0xba, 0xfe, 0xca, 0x10, 0x1, 0x8, 0x0, 0x0, 0x0, 0x20, 0x1, 0x0, 0x10, 0x0, 0xde, 0xc0, 0x37, 0x13, 0x10, 0x1, 0xc, 0x0, 0x0, 0x0, 0x20, 0x1, 0x0, 0x10, 0x0, 0xd, 0xf0, 0xad, 0xb, 0x10, 0x1, 0x10, 0x0, 0x0, 0x0, 0x20, 0x1, 0x0               # STORE_REG: Buffer[register[1]>>2] = register[2]

    ]

    print("=== VMP 虚拟机执行器 ===\n")

    register, buffer = execute_vmcode(vmcode)

    print("\n=== 最终寄存器状态 ===")

    for i in range(15):

        if register[i] != 0:

            print(f"register[{i}] = 0x{register[i]:02X}")

    print("\n=== 最终 Buffer 状态 ===")

    print(buffer)
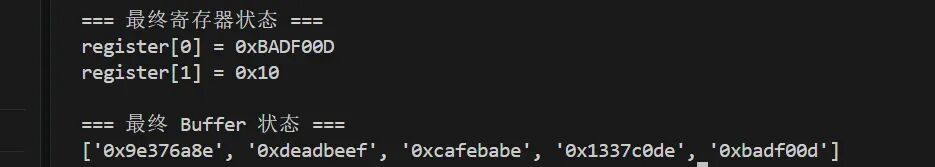
最终得到传入的 5 个密钥 然后解释其它指令:
registers = [0] * 16

flag= []

def interpret_bytecode(bytecode):

    """

    VMP字节码解释器


    """

    i = 0

    results = []

    while i < len(bytecode):

        opcode = bytecode[i]

        if opcode == 16:  # 无条件跳转指令

            # 格式:[16, 寄存器索引, 值]

            operand = bytecode[i + 1]

            value = bytecode[i + 2] | (bytecode[i + 3] << 8) | (bytecode[i + 4] << 16) | (bytecode[i + 5] << 24)

            # 输出: register[寄存器索引] = 值

            print(f"register[{operand}] = {hex(value)}")

            # 在寄存器数组中存入该值

            if operand < 16:

                registers[operand] = value

            i += 5  # 指令长度:1字节(操作码) + 1字节(操作数) + 1字节(值)


        elif opcode == 0x30:  # 从buffer加载指令

            # 格式:[0x30, 目标寄存器, 源寄存器]

            dest_reg = bytecode[i + 1]

            src_reg = bytecode[i + 2]

            # 计算buffer索引:register[源寄存器] >> 2

            buffer_index = registers[src_reg] >> 2

            # 输出: register[目标寄存器] = buffer[计算索引]

            print(f"register[{dest_reg}] = buffer[{buffer_index}]")


            i += 3

        elif opcode == 0x40:  # 比较指令

            # 格式:[0x40, 寄存器1, 寄存器2]

            reg1 = bytecode[i + 1]

            reg2 = bytecode[i + 2]

            # 取出两个寄存器的具体值

            val2 = registers[reg2]

            # 输出:register[reg1](val1) CMP register[reg2](val2)

            print(f"register[{reg1}] CMP register[{reg2}]({hex(val2)})")

            flag.append(hex(val2))

            i += 3

        else:

            # 未知指令,跳过

            i += 1

    return results


# 示例使用

if __name__ == "__main__":

    # 示例字节码序列

    # 16(无条件跳转): register[2] = 10

    # 0x30: register[1] = buffer[0] (register[0]=0, 0>>2=0)

    # 0x40: register[3](0) CMP register[4](0)

    # 0x20: Buffer[0] = 0

    vmcode = [

    0x10, 0x1, 0x0, 0x0, 0x0, 0x0, 0x30, 0x0, 0x1, 0x10, 0x2, 0x93, 0xc7, 0x69, 0xd5, 0x40, 0x0, 0x2, 0x10, 0x1, 0x4, 0x0, 0x0, 0x0, 0x30, 0x0, 0x1, 0x10, 0x2, 0x18, 0xde, 0xea, 0x40, 0x40, 0x0, 0x2, 0x10, 0x1, 0x8, 0x0, 0x0, 0x0, 0x30, 0x0, 0x1, 0x10, 0x2, 0x93, 0xdb, 0x13, 0x6c, 0x40, 0x0, 0x2, 0x10, 0x1, 0xc, 0x0, 0x0, 0x0, 0x30, 0x0, 0x1, 0x10, 0x2, 0x87, 0xc9, 0xed, 0x4b, 0x40, 0x0, 0x2, 0x10, 0x1, 0x10, 0x0, 0x0, 0x0, 0x30, 0x0, 0x1, 0x10, 0x2, 0x70, 0x15, 0xe9, 0x87, 0x40, 0x0, 0x2, 0x10, 0x1, 0x14, 0x0, 0x0, 0x0, 0x30, 0x0, 0x1, 0x10, 0x2, 0x1c, 0x3, 0x3e, 0xea, 0x40, 0x0, 0x2, 0x10, 0x1, 0x18, 0x0, 0x0, 0x0, 0x30, 0x0, 0x1, 0x10, 0x2, 0xc8, 0xc5, 0x66, 0x5a, 0x40, 0x0, 0x2, 0x10, 0x1, 0x1c, 0x0, 0x0, 0x0, 0x30, 0x0, 0x1, 0x10, 0x2, 0x7c, 0x11, 0xf, 0xfa, 0x40, 0x0, 0x2, 0x10, 0x1, 0x20, 0x0, 0x0, 0x0, 0x30, 0x0, 0x1, 0x10, 0x2, 0xa9, 0x8a, 0x88, 0xee, 0x40, 0x0, 0x2, 0x10, 0x1, 0x24, 0x0, 0x0, 0x0, 0x30, 0x0, 0x1, 0x10, 0x2, 0xb4, 0x74, 0xa2, 0x1f, 0x40, 0x0, 0x2    ]

    print("VMP字节码执行结果:")

    print("=" * 50)

    results = interpret_bytecode(vmcode)

    for line in results:

        print(line)

    print("=" * 50)

    print(f"最终寄存器状态: {registers}")

    print(flag)

这里得到了最终的比较值
现在内核态已经解决了,需要分析一下用户态中的内容,内核填通过IofCompleteRequest这个 API 与用户态进行通讯,用户态通过DeviceIoControl与内核态进行通讯,但是在Locksetup.exe中没找到这个 API。这里又释放了一个文件,与内核态进行通讯。竟然释放了文件,那必然会写,查看包含Write的 API
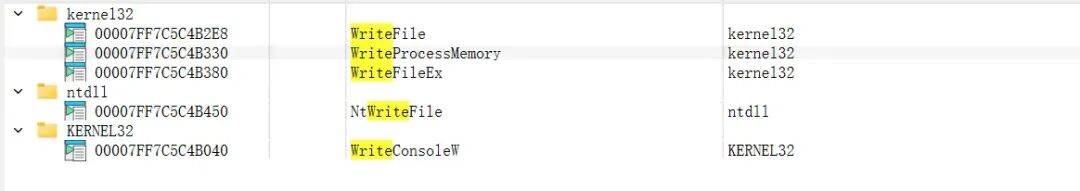
这里有一个WriteProcessMemory的 API,会往内存中写数据,且文件不落地,跟踪该 API
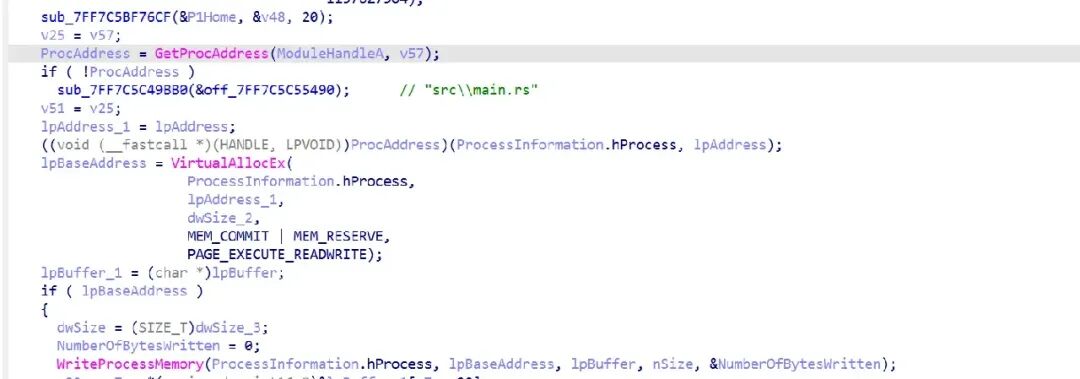
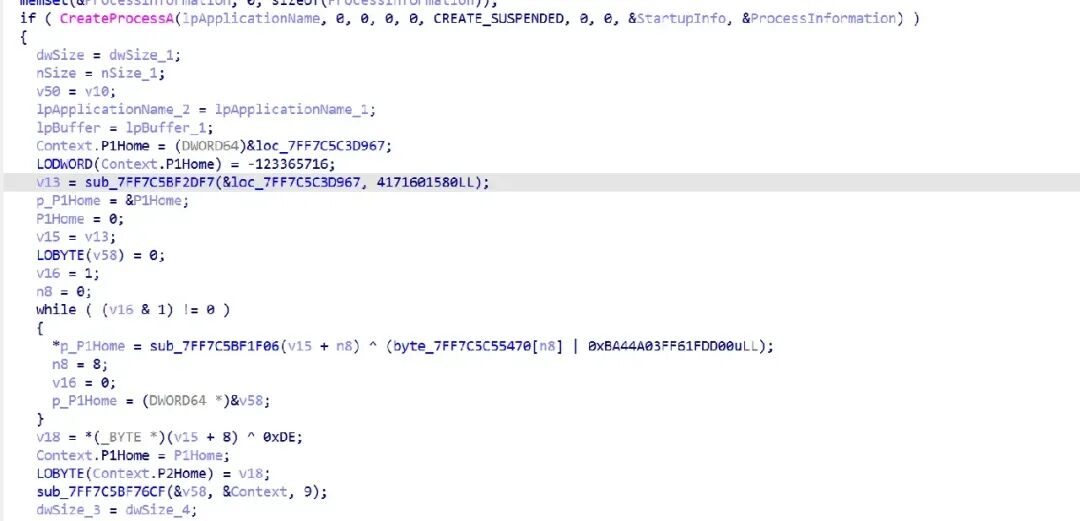
这里利用了进程镂空技术
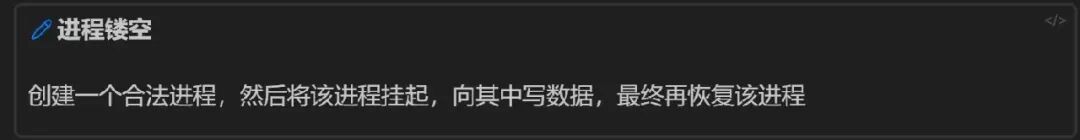
这里我们可以获取创建进程的 PID,用于该进程的上下文,找到对应的程序,提取出来
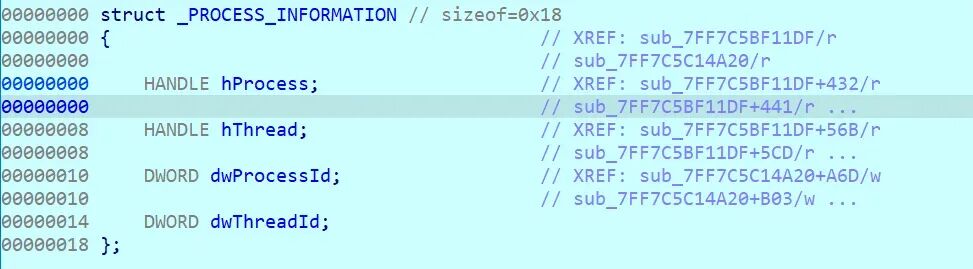
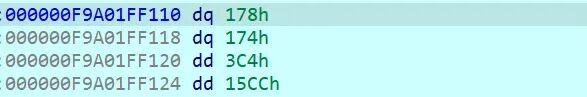
定位到Process_Information这个结构体,找到进程的 PID 为0x3c4
这里还需要可以找到进程名,写入的该进程上下文的起始地址

进程名为svchost.exe
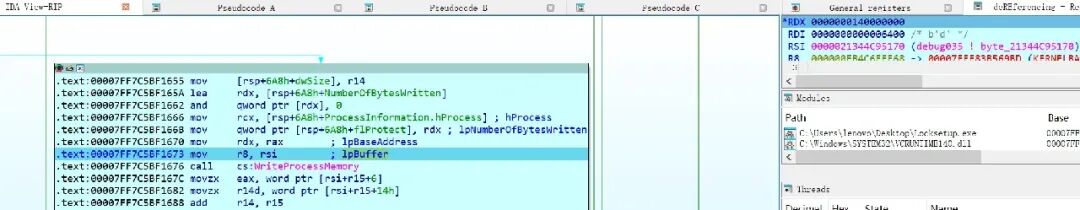
关注 RDX 的值,基址为0x140000000
再启动新的 IDA 附着到该进程中
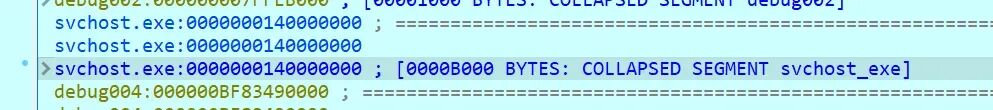
找到该程序了,从内存中进行读取
这里存在一个问题,程序中内存中运行时和在磁盘上存储时的对齐大小不同,所以不同段的偏移量会有所不同,这里让 AI 生成一个脚本,给他指定的 PID,并给定 PID 上下文中的起始地址,让其解析 PE 结构,最终 dump 下来完整的 PE 文件
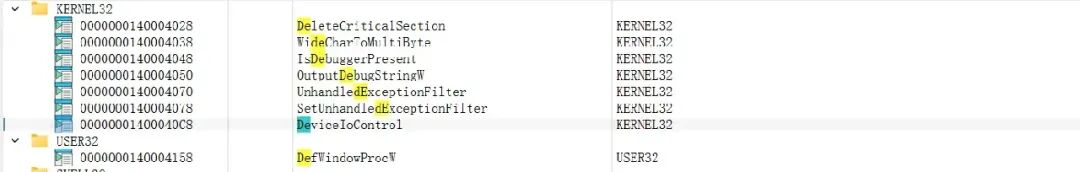
最终找到了该 API,跟踪这个 API
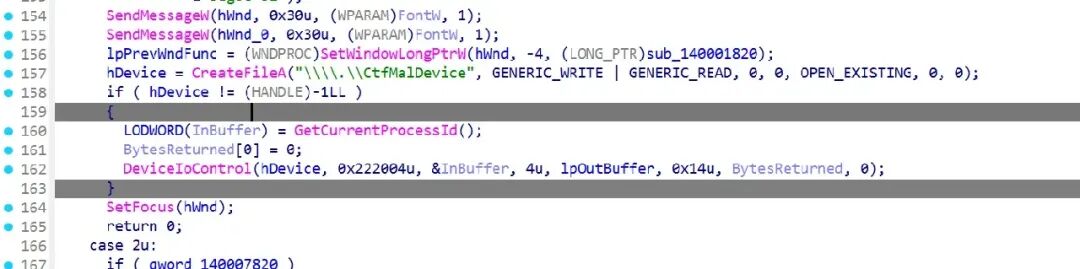
这里注册设备,用于和内核态通讯,设备名和内核态一致
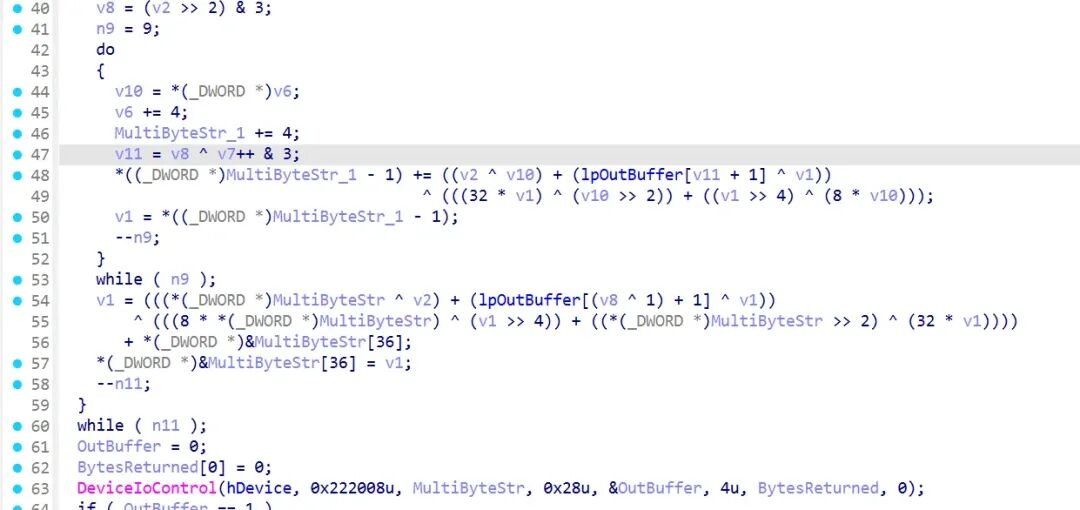
这段代码用返回回来的密钥对用户输入进行加密,最终传入内核态进行比较 具体代码抽象逻辑如下
Input_1 = <用户输入>

Input = []

string = []

for i in range(10):

    Input.append(ord(Input_1[4*i]) | (ord(Input_1[4*i+1]) << 8) | (ord(Input_1[4*i+2]) << 16) | (ord(Input_1[4*i+3]) << 24))

key = [0x9e376a8e, 0xdeadbeef, 0xcafebabe, 0x1337c0de, 0xbadf00d]

v1 = Input[9]

v2 = 0

v3 = key[0]

k=1

index = 0

m =0

for index in range(11):

    v2 += v3

    v2 = v2 & 0xffffffff

    v7 = 0

    v8 = (v2 >> 2) & 3

    for j in range(9):

        v10 = Input[k]

        k = k + 1

        v11 = v8 ^ v7 & 3

        v7 = v7 +1

        if index == 9 and j == 8:

            print("Stop")

        Input[j] +=  ((v2 ^ v10) + (key[v11 + 1] ^ v1))^ (((32 * v1)&0xffffffff) ^ ((v10 >> 2)&0xffffffff)) + (((v1 >> 4)&0xffffffff) ^ ((8 * v10)&0xffffffff))

        Input[j] = Input[j] & 0xffffffff

        v1 = Input[j]


    k = 1

    v1 = (((Input[0] ^ v2) + (key[(v8 ^ 1) + 1] ^ v1))^ ((((8 * Input[0])&0xffffffff) ^ ((v1 >> 4)&0xffffffff)) + (((Input[0] >> 2)&0xffffffff) ^ ((32 * v1)&0xffffffff))))+ Input[9]

    v1 = v1 & 0xffffffff

    Input[9] = v1
根据上述内容生成解密脚本(这里包含我检验算法时的脚本)
Input_1 = "abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMN"

Input = []

string = []

for i in range(10):

    Input.append(ord(Input_1[4*i]) | (ord(Input_1[4*i+1]) << 8) | (ord(Input_1[4*i+2]) << 16) | (ord(Input_1[4*i+3]) << 24))

key = [0x9e376a8e, 0xdeadbeef, 0xcafebabe, 0x1337c0de, 0xbadf00d]

v1 = Input[9]

v2 = 0

v3 = key[0]

k=1

index = 0

m =0

for index in range(11):

    v2 += v3

    v2 = v2 & 0xffffffff

    v7 = 0

    v8 = (v2 >> 2) & 3

    for j in range(9):

        v10 = Input[k]

        k = k + 1

        v11 = v8 ^ v7 & 3

        v7 = v7 +1


        Input[j] +=  ((v2 ^ v10) + (key[v11 + 1] ^ v1))^ (((32 * v1)&0xffffffff) ^ ((v10 >> 2)&0xffffffff)) + (((v1 >> 4)&0xffffffff) ^ ((8 * v10)&0xffffffff))

        Input[j] = Input[j] & 0xffffffff

        v1 = Input[j]


    k = 1

    v1 = (((Input[0] ^ v2) + (key[(v8 ^ 1) + 1] ^ v1))^ ((((8 * Input[0])&0xffffffff) ^ ((v1 >> 4)&0xffffffff)) + (((Input[0] >> 2)&0xffffffff) ^ ((32 * v1)&0xffffffff))))+ Input[9]

    v1 = v1 & 0xffffffff

    Input[9] = v1


enc =[0x8da1e7b1, 0xcaa432e5, 0x6eec27bc, 0xefc12b53, 0xfa7505c2, 0x54ac88a6, 0x2f96ad99, 0x77741a15, 0x3e8673c1, 0xc2b9f282]

k=9

index1 = 0


for index1 in range(11):

    v2_1 = 0

    for _ in range(11 - index1):

        v2_1 +=v3

        v2_1 = v2_1 & 0xffffffff

    v1 = enc[8]

    v8 = (v2_1 >> 2) & 3

    enc[9] = enc[9] - ((((enc[0] ^ v2_1) + (key[(v8 ^ 1) + 1] ^ v1))^ ((((8 * enc[0])&0xffffffff) ^ ((v1 >> 4)&0xffffffff)) + (((enc[0] >> 2)&0xffffffff) ^ ((32 * v1)&0xffffffff)))))&0xffffffff

    enc[9] = enc[9] & 0xffffffff

    v7 = 9

    k=9

    for j in range(8,-1,-1):

        v1 = enc[j-1]

        v10 = enc[k]

        k = k-1

        v7 = v7 - 1

        v11 = v8 ^ v7 & 3

        enc[j] -=  ((v2_1 ^ v10) + (key[v11 + 1] ^ v1))^ (((32 * v1)&0xffffffff) ^ ((v10 >> 2)&0xffffffff)) + (((v1 >> 4)&0xffffffff) ^ ((8 * v10)&0xffffffff))

        enc[j] = enc[j] & 0xffffffff

for i in enc:

    a = (i >> 0 ) & 0xff

    string.append(chr(a))

    b = (i >> 8 ) & 0xff

    string.append(chr(b))

    c = (i >> 16 ) & 0xff

    string.append(chr(c))

    d = (i >> 24 ) & 0xff

    string.append(chr(d))

for i in string:

    print(i,end='')
最终解出 flag

彩蛋
其实这个小彩蛋是接上一篇浪漫土狗师傅的文章,这里补充一下江苏省第四届数据安全技能应用职业技能竞赛决赛的幽灵协议这道题的题解
初赛的那个逆向我死扣了2个小时,最终还是没做出来,留下了不小的阴影。决赛第一遍看到题干中有逆向两个字直接跳了,最后30分钟的时候其它的题实在做不出来了,才反过来看看这道题
其实这道题没有想象中的那么难。逆向不是二进制文件,而是一个python源码,分析python脚本可以得知,该协议的结构写在了注释里:
  [Magic: 2 bytes] [Version: 1 byte] [Type: 1 byte]

  [Seq: 2 bytes BE] [Payload Length: 2 bytes BE]

  [Encrypted Payload: variable] [Checksum: 1 byte]
协议以GH开头,我们重点分析第9个字节到倒数第二个字节就行了 通过分析python脚本,这里是对单个字节先做一个移位,然后进行异或算法,关键算法如下
# === Encryption Parameters ===

_CAESAR_SHIFT = 3

_XOR_KEY = 0x7A

def _caesar_encrypt(text, shift):

    """Caesar cipher on alphabetic characters only."""

    result = []

    for ch in text:

        if ch.isalpha():

            base = ord('A') if ch.isupper() else ord('a')

            result.append(chr((ord(ch) - base + shift) % 26 + base))

        else:

            result.append(ch)

    return ''.join(result)

def _encrypt_payload(plaintext):

    """Encrypt payload: Caesar(shift=3) then XOR with key byte."""

    caesar_text = _caesar_encrypt(plaintext, _CAESAR_SHIFT)

    encrypted = bytes([b ^ _XOR_KEY for b in caesar_text.encode()])

    return encrypted
脚本中其实已经报解密函数已经写好了
def _decrypt_payload(encrypted):

    """Decrypt payload: XOR with key byte then Caesar(shift=-3)."""

    xored = bytes([b ^ _XOR_KEY for b in encrypted])

    plaintext = _caesar_encrypt(xored.decode(), -_CAESAR_SHIFT)

    return plaintext
直接引用常量即可,生成解密脚本
_CAESAR_SHIFT = 3

_XOR_KEY = 0x7A


def _caesar_encrypt(text, shift):

    """Caesar cipher on alphabetic characters only."""

    result = []

    for ch in text:

        if ch.isalpha():

            base = ord('A') if ch.isupper() else ord('a')

            result.append(chr((ord(ch) - base + shift) % 26 + base))

        else:

            result.append(ch)

    return ''.join(result)


def _decrypt_payload(encrypted):

    """Decrypt payload: XOR with key byte then Caesar(shift=-3)."""

    xored = bytes([b ^ _XOR_KEY for b in encrypted])

    plaintext = _caesar_encrypt(xored.decode(), -_CAESAR_SHIFT)

    return plaintext


buffer = <加密字节>


buffer_1 = _decrypt_payload(buffer)


print(buffer_1)
分析数据包,找到以GH开头的数据包即可
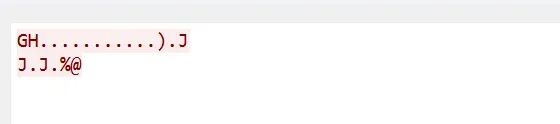
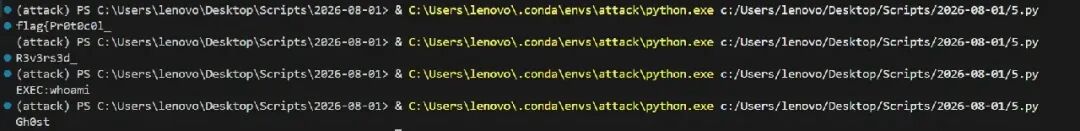
最终flag:flag{Pr0t0c0l_R3v3rs3d_Gh0st}
完结撒花🎉
结语
太菜了😭,还要多向浪漫土狗师傅学习