DeepSeek 把 App 里的联网搜索、网页抓取、OCR 等几乎所有能力,都单独开放成了 API,见前文:刚刚,DeepSeek 放出全家桶 API,可 1:1 复刻自己
其中我有点儿关注的,是它以前从来没放出来过的语音识别。
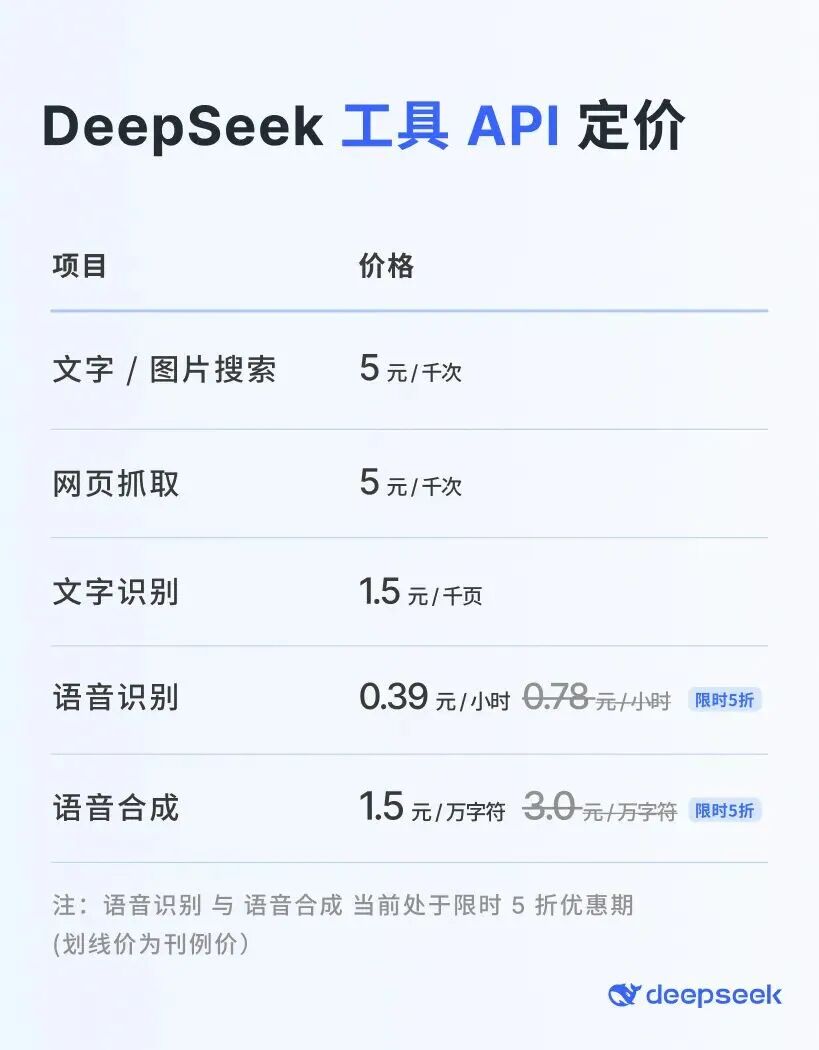
价格上依旧非常良心,并且限时 5 折,1 小时音频只要 0.39 元。
我有个叫口喷鸡的项目,就是用来更好地做语音输入的。它可以完全替代 Typeless,而且比 Typeless 的体验更好,速度更快,效果也更好。
它还有各种非常好用的 feature。比如单击 Fn 开始录音,识别过程中你就能看到文字,如果文字没问题,直接双击 Fn 就发送出去了,不用再自己按回车。
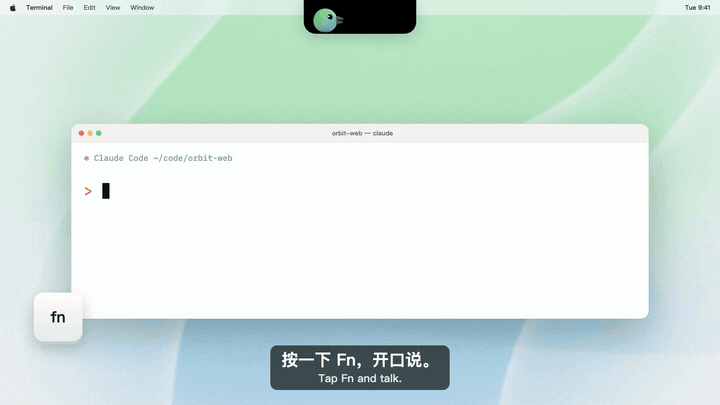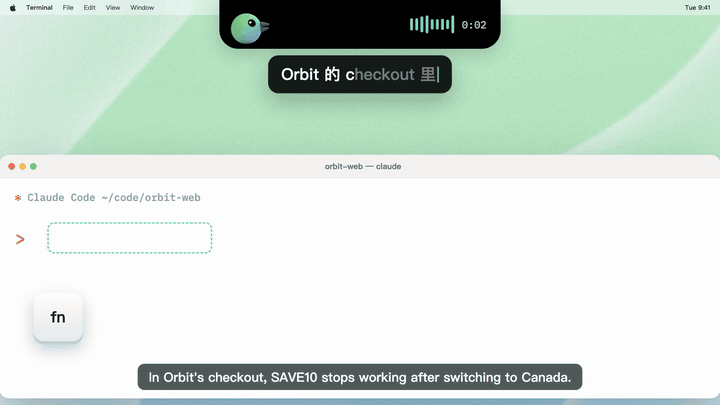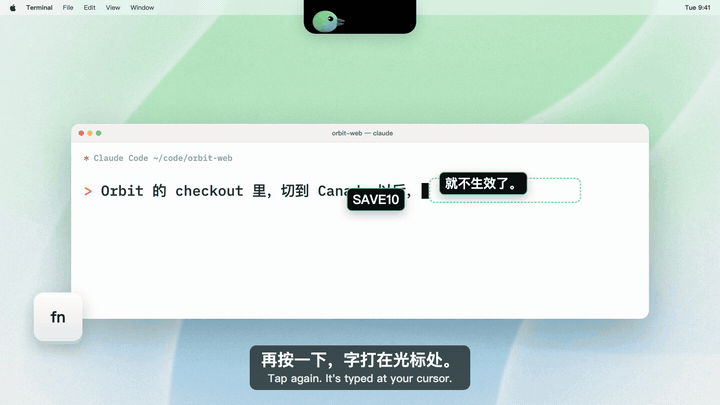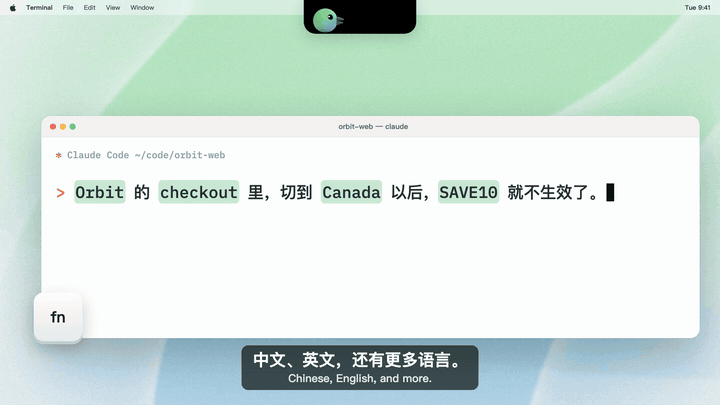
它还会把你光标所在输入框里的上下文,作为语音识别的参考,这样能认得更准,也会记住你在不同应用里的使用习惯。
甚至如果你发现,用英文和 Codex 聊会更聪明,用英文和 Claude Code 聊会更安全,那直接双击 Command,就可以说中文、出英文了。
当然它还有很多很多其他功能,比如:
但今天要说的,主要是和语音识别相关的部分。
那看到 DeepSeek 又来新模型,并且还这么便宜,我就想是不是需要整合一下,在口喷鸡里加进去作为一个可选项,所以就有了这次实测。
于是我对着 Claude Code,也是口喷了一句:
DeepSeek 的新出的语音识别模型刚刚推出了,你看一下我们系统里接一下,它好像是每小时 4 毛钱左右,感觉质量可能还不错,你可以试一试,看看它的性能如何。不错的话,把它加进来,作为我们的语音识别渠道之一。
我平时的语音输入已经全部用口喷鸡了,Typeless、Wispr Flow 这些都已经卸载了,豆包、微信输入法的语音输入也不用了。
口喷鸡默认在本机跑的是千问的 Qwen3-ASR 1.7B,效果还不错。
识别完之后,会再用本地或者云端的模型做一遍润色,云端润色我优先推荐的是 DeepSeek Flash,当然,我自己用的是本机的。
不过我电脑上的这个 1.7B 并不是原版,而是用我自己的口述数据重新训练过的。
起因是我每天要口喷好几个小时,可还是得时不时停下来手动改字,改得最多的就是人名、产品名和英文词。之前口喷鸡就把 README 听成过「李娜」,连口喷鸡自己都被听成了「口喷肌」……
而口喷鸡本来就会把每次口述的录音和最后打出来的字存在本地。
所以我每天说的这些废话,本身就是现成的训练数据。
于是我让 AI 把带录音的 829 条口述都翻了出来,一共 4.8 小时,让 Claude Sonnet 子 Agent 当标注员,对照几个模型的识别结果,把识别错的地方找出来,写下我每一句到底说了什么。它们拿不准的近 200 段,我再自己一段段过了一遍。然后在我自己那张 4090 上做了个 LoRA 微调,训练一轮只要 5 分钟左右。
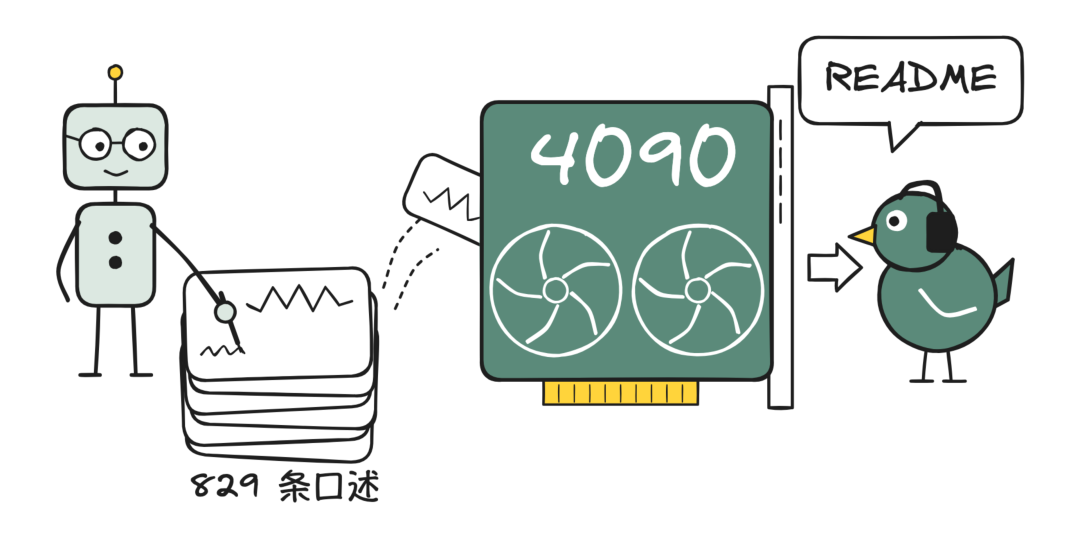
效果相当牛逼。
现在不管是人名、专业术语,还是中英混说,它都认得非常准。英文词和产品名的识别率从 85% 涨到了 94%,放回口喷鸡里测,错误率从 2.48% 降到了 1.66%;就算句子里有训练时从没见过的英文词,错误率也从 8.32% 降到了 2.72%。
上线之后,我又拿新录的口述测了一次,原版是 5.45%,微调版只有 2.07%,错误少了六成。
我正计划把这个能力开放出来,有需要的可以留言。
如果没有微调过的模型,又想要更准,口喷鸡也可以切到云端的千问 Qwen3-ASR Flash,或者火山的 Seed-ASR 2.0。千问 Flash 一小时大约 8 毛钱,火山大约 1 块钱,而 DeepSeek 只要 4 毛,比千问还便宜一半。
好了,言归正传,开测!
为了给口喷鸡选一个好的语音识别模型,我之前自己攒了一套测试集,一共 95 条我真实口述的录音,加起来 34 分钟。内容都是我平时对着 AI、对着微信、对着各个地方说的各种话,里面夹杂着一堆 GitHub、feature、iOS 之类的英文词。
另外还有 AISHELL(普通话)、ASCEND(中英混合)、LibriSpeech(英文朗读)这几个公开的 benchmark,以及 Common Voice 的日语和德语。
这次我把 DeepSeek 也接进了这套测评脚本,在各个 benchmark 上,和之前测过的十多个模型用同一套标准来 PK。
总共约 60 分钟的音频,全部跑完只花了 6 美分,也就 4 毛钱左右。
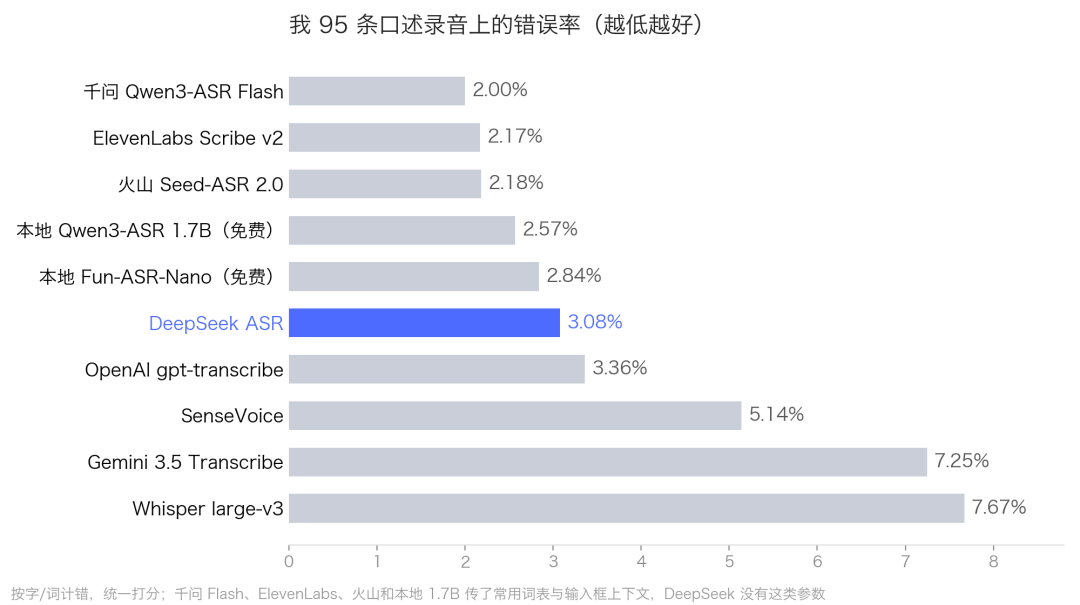
在我自己这 95 条录音上,DeepSeek 的错误率是 3.08%,排在中间靠后。有点意外,但好像也在预期之内吧……
它比 OpenAI 的 gpt-transcribe(3.36%)、Gemini(7.25%)和 Whisper large-v3(7.67%)都要好,但比千问 Flash(2.00%)、ElevenLabs(2.17%)、火山(2.18%)要差一些。
但最尴尬的是,它连原版的 Qwen3-ASR 1.7B(2.57%)都没比过……
而且这套评测是在微调之前做的,图里的本地模型还是原版。我拿现在用的微调版,在同样这 95 条录音上又跑了一遍(这批录音不在训练数据里),错误率只有 1.80%,比所有云端模型都低,DeepSeek 就更没法比了。
当然,这对 DeepSeek 有点不太公平。千问 Flash、ElevenLabs、火山和本地 1.7B 测的时候,都带上了口喷鸡的常用词表,而 DeepSeek 根本没地方传这个词表,它的接口没法带 prompt,只能传一个音频文件。
但就算千问 Flash 什么都不带,在同样的 89 条录音上,错误率也只有 2.24%,DeepSeek 是 2.95%,还是差了一截。
公开数据集上的成绩,我也整理成了一张表:
| 6.59% | ||||
| 1.08% | 1.08% | |||
不过 DeepSeek 也并不是全面落后,在公开的中英混合数据集上,它居然是这四家里最好的,英文朗读也和火山并列第一。
如果单说「听清楚」,它其实还可以,尤其如果你英文很流利,日常就说英文的话,也够用了。
那为什么 DeepSeek 实战起来就这么差呢?
我逐条看了一下,问题主要集中在三个地方。
第一个问题,也是最要命的,是中英混说的时候。
我有一条录音说的是「请在 GitHub 的 issue 上增加一个叫做语音识别时仅识别自己的声音……这样的一个 feature 的诉求」,DeepSeek 听成了这样:
现在给它help在艺术上,增加一个。叫做语音识别是金。识别自己的声音……
GitHub 的 issue,成了「help在艺术上」……
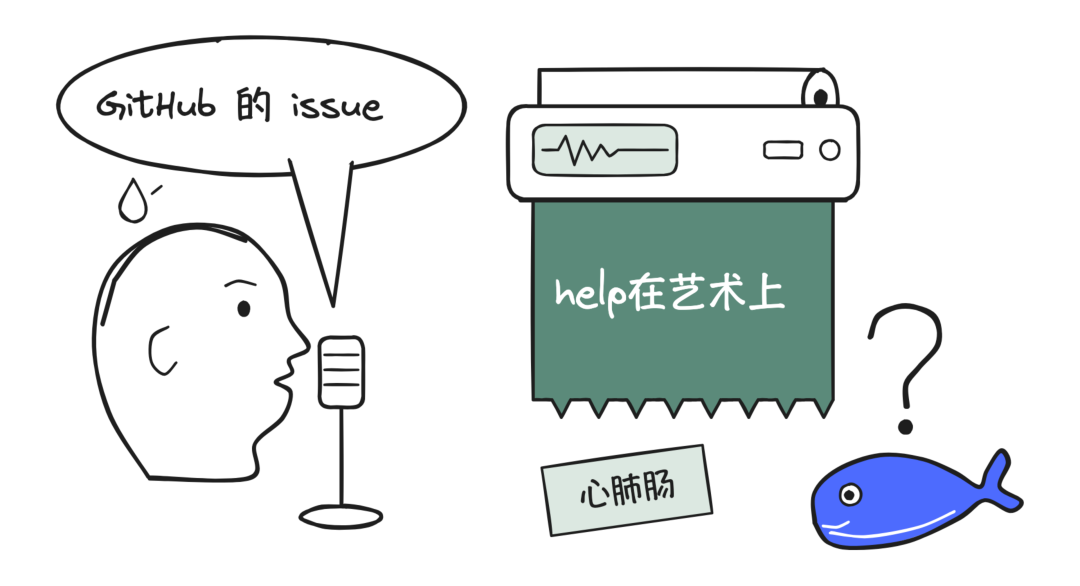
更离谱的是,它还把 feature 听成了「心肺肠」,口喷鸡的英文名 Blurt 听成了 Blood,iOS 成了「IO S」……
如果只看录音里的英文词和专有名词,DeepSeek 只认对了 66%。千问 Flash 是 80%,就算什么上下文都不给它,也还有 74%。
所以公开 benchmark 里的中英混合,和程序员嘴里的中英混合,根本不是一回事。
而这些词,偏偏是我日常说得最多的,也是语音识别最难的地方,毕竟我又不是个只说中文、字正腔圆的播音员。
可 DeepSeek 的接口只支持传一个音频文件,没有热词、没有 prompt,也没有上下文参考。
口喷鸡在处理这类问题的时候,会把你的常用词表和光标所在输入框里的上下文,一起传给识别模型。同样那 89 条录音,千问 Flash 用上这些之后,错误率还能从 2.24% 再降到 1.82%。
但 DeepSeek 不支持,这招就用不上了,那效果也算是在预期内的糟糕吧。
第二个问题出在标点符号上,尤其是句号。
我说话的时候经常是边说边想的,不会想好了再说,又不是给老板汇报。给 AI 说话就是边想边说,所以中间会有各种停顿、各种呃呃啊啊,然后 DeepSeek 就会打出各种句号,「然后版本,要改为。1.0.7。」这样的句子非常多。
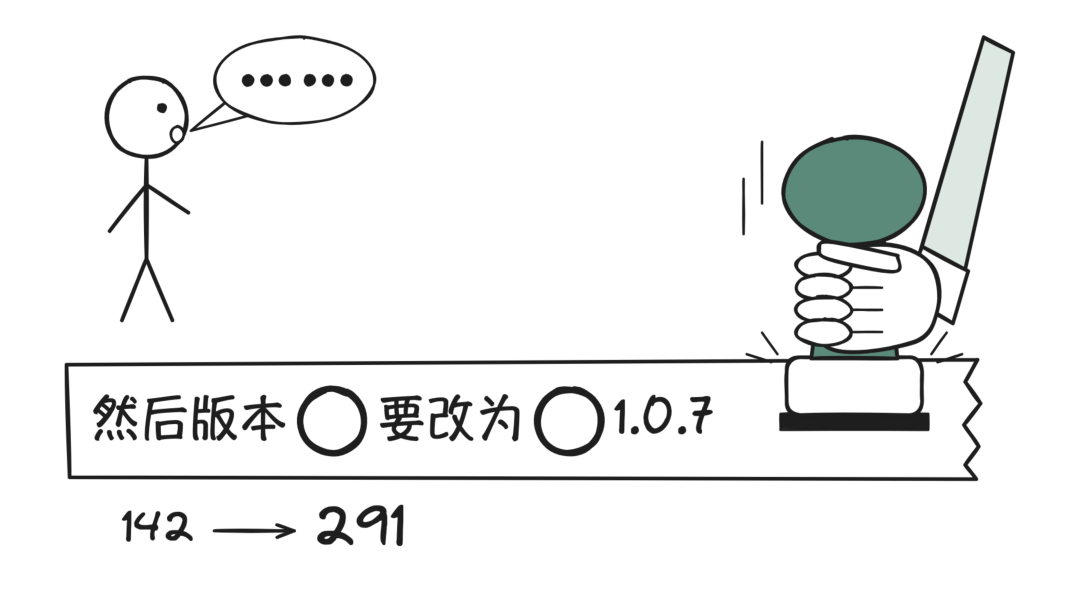
我 95 条录音的参考文本里一共有 142 个句号,DeepSeek 搞出来了 291 个,翻了一倍还多,其他几家都在 200 个左右。
而且它在中英文之间不加空格(Option T有一大段文字),也不太符合我的打字习惯。英文单词前后我都会习惯性地加上空格,这也是 GitHub 上流传很广的《中文文案排版指北》里的第一条规则:中英文之间需要增加空格。
第三个问题是慢。
10 秒以内的短句,DeepSeek 从发出请求到拿到结果,中位数要 0.84 秒;40 秒以上的长段,要 2.35 秒。
而我本地的 1.7B,说完之后只要 0.16 秒就出结果,长段也只要 0.38 秒。
因为本地是边说边识别的,而 DeepSeek 不支持流式识别,必须等你说完、整段上传之后才开始识别,说得越长,等得越久。火山的流式接口也是边说边识别,你闭嘴之后大约 0.5 秒就给出结果了,基本跟你说了多久没太大关系。
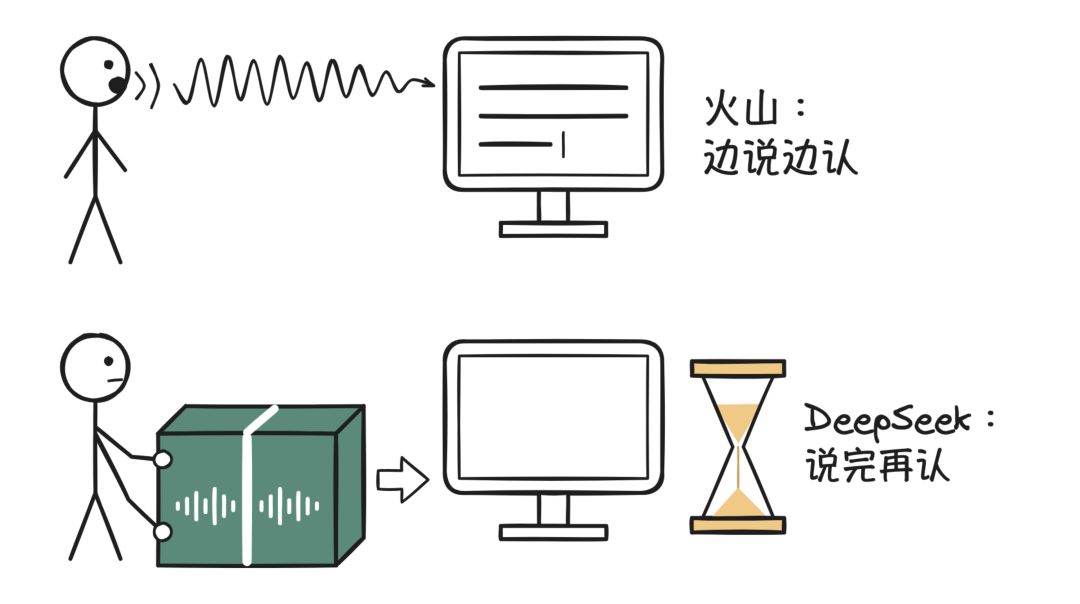
而对语音输入来说,出结果的速度还是非常重要的,本来就是为了省时间,那肯定是越快越好。
另外,DeepSeek 单次识别最长只支持 120 秒,这也非常不够用。我自己有时候会一口气说 10 分钟,甚至连着说好几个 10 分钟,然后扔给 AI,让它干一个又猛又大的活。换成 DeepSeek,我就得经常打断一下了。
它也不返回时间戳,不过这个对口喷鸡来说影响倒是不大。
测完之后,我很想知道 DeepSeek 这个语音识别背后,到底用的是什么模型。
不过查了一圈,DeepSeek 官方并没有公开任何相关信息,文档里没有模型名,没有论文,也没有 WER、CER 之类的评测成绩。GitHub、Hugging Face 和 arXiv 上,也没找到它在语音方向公开过的模型或论文。
这和 DeepSeek 一言不合就开源的风格,也有点不太一致。它以前开源过不少多模态模型,像 DeepSeek-VL、DeepSeek-VL2、Janus、JanusFlow、Janus-Pro,还有 DeepSeek-OCR 和 DeepSeek-OCR 2,只不过全都是视觉方向的。
那会不会是拿 Whisper 改的呢?
我看了一下,应该可以排除。在我那 95 条录音里,去掉标点之后,DeepSeek 和 Whisper large-v3 一字不差的只有 25%,错误率也差了一倍多(3.08% 和 7.67%)。
而且 Whisper 一次只处理 30 秒音频、支持 99 种语言,和 DeepSeek 的 120 秒上限、21 种语言也对不太上。
反而是阿里开源的 Qwen3-ASR,和 DeepSeek 对上了很多地方。
DeepSeek 支持的 21 种语言,全部落在 Qwen3-ASR 的 30 种里,连菲律宾语、匈牙利语、波兰语这几个比较少见的也都在。
于是我又把各个 benchmark 上的识别结果逐条拿出来,去掉标点之后,看 DeepSeek 和哪个模型的输出一字不差的条数最多,结果全都指向了 Qwen3-ASR 1.7B。
作为参照,我也算了 Qwen3-ASR 自家 1.7B 和 0.6B 两个版本之间的一致率,以及 DeepSeek 和千问 Flash、火山的一致率:
| 86% | ||||
| 62% | ||||
| 68% | ||||
| 92% | ||||
| 88% | 88% |
在每一个数据集上,DeepSeek 和 Qwen3-ASR 1.7B 的输出,都比 Qwen3-ASR 自家两个尺寸之间还要像。日语的错误率也几乎一样,一个 15.94%,一个 16.02%。
而且 DeepSeek 跟开源的 1.7B,比跟阿里自家商用的千问 Flash 还要像。只有在普通话这种相对简单的数据上,大家的输出才都差不多,火山也有 88%。
但也有对不上的地方。
在 Qwen3-ASR 的技术报告里,匈牙利语和菲律宾语正好是它表现最差的两个语种,错误率分别有 34% 和 24%。可 DeepSeek 把这两个都支持了,反倒没支持 Qwen3-ASR 表现好得多的荷兰语(7%)。
另外,这次一起开放的 DeepSeek 语音合成支持 10 种语言,和 Qwen3-TTS 也只重合了 4 种。
所以我大胆猜测一下……它很可能是在开源的 Qwen3-ASR 1.7B 基础上,用自己的数据再训练过,语种也按自己的用户重新挑过。
当然,DeepSeek 自己没说,这只是我从输出上推出来的。
而且在开源模型基础上训练自己的版本,本也就是很正常的做法,开源的意义也正在于此。
不过从这个接口没有热词、没有上下文、也没有流式来看,它更像是把 DeepSeek App 里语音输入的对应能力,直接先开放了出来。
在 App 里,你说的话识别完是交给大模型去理解的,听错几个英文单词,模型多半也能猜出你的意思;但在语音输入法里,打出来的字便是最终结果,GitHub 变成了「help在艺术上」,就只能自己动手去改了……
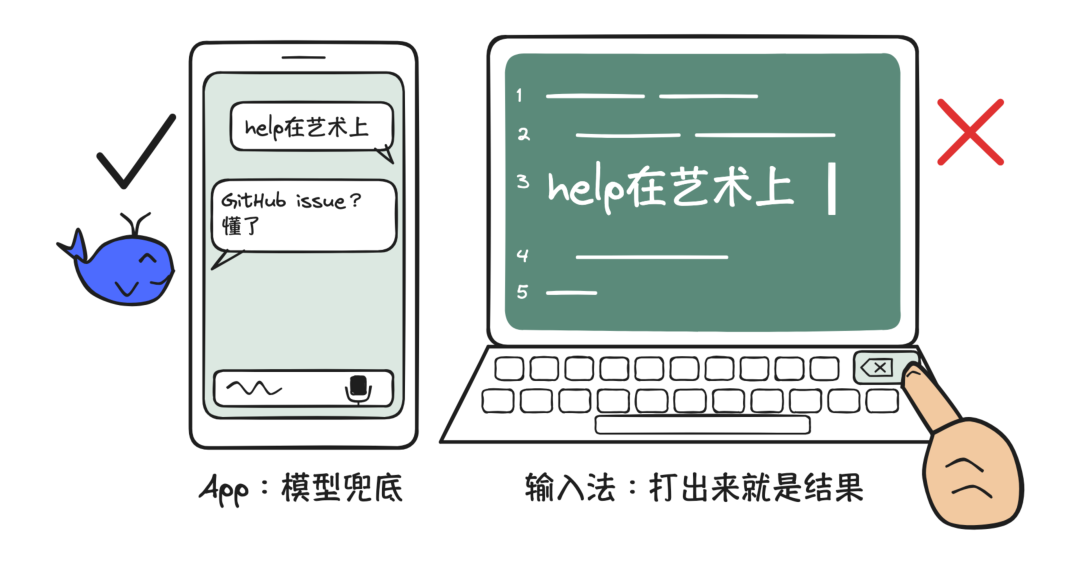
所以它在公开 benchmark 上看着还行,但到我的录音上就表现非常平平。
所以,暂时就先不支持了,等它更好之后,我再接入。
毕竟在我的录音上,它连我原版的本地免费模型都比不过,每小时省下的那 4 毛钱,也就没那么香了……
测评脚本我已经留好了,等 DeepSeek 哪天加上了热词或者上下文参数,再跑一遍就知道了。
本文是用口喷鸡语音输入,用于 15 分钟完成,欢迎来用口喷鸡。
◇ ◆ ◇
