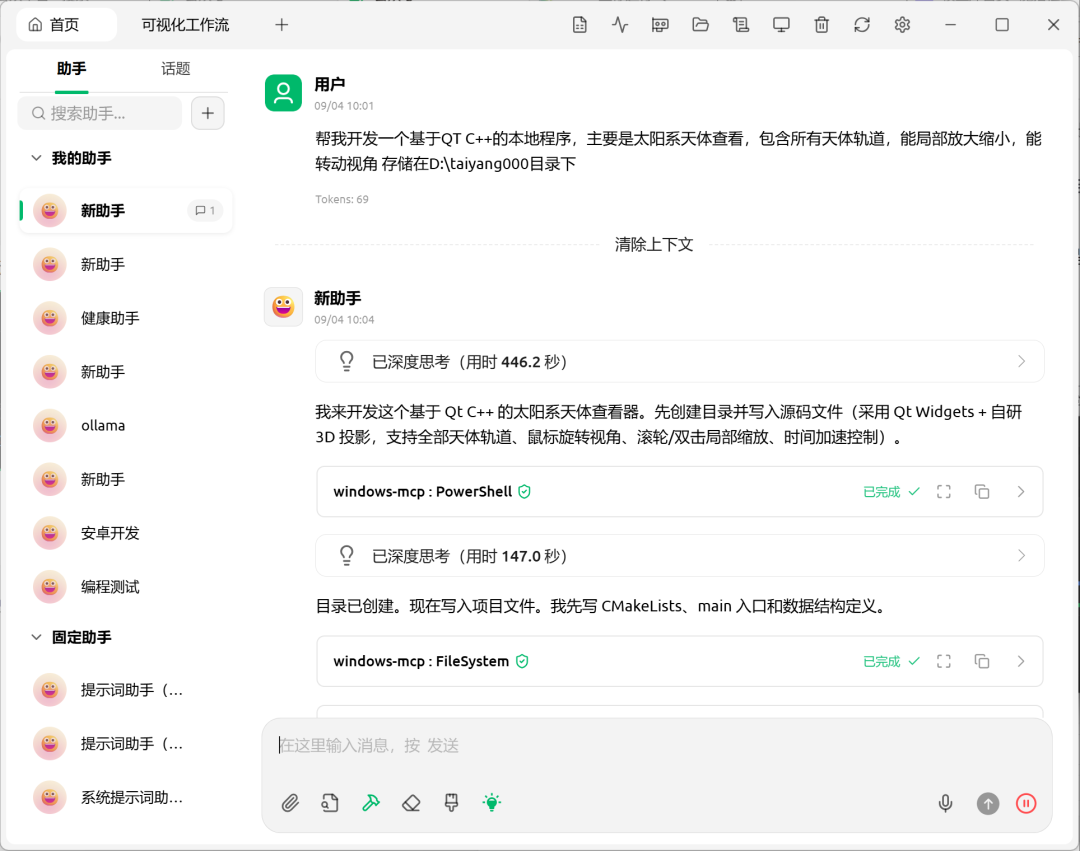
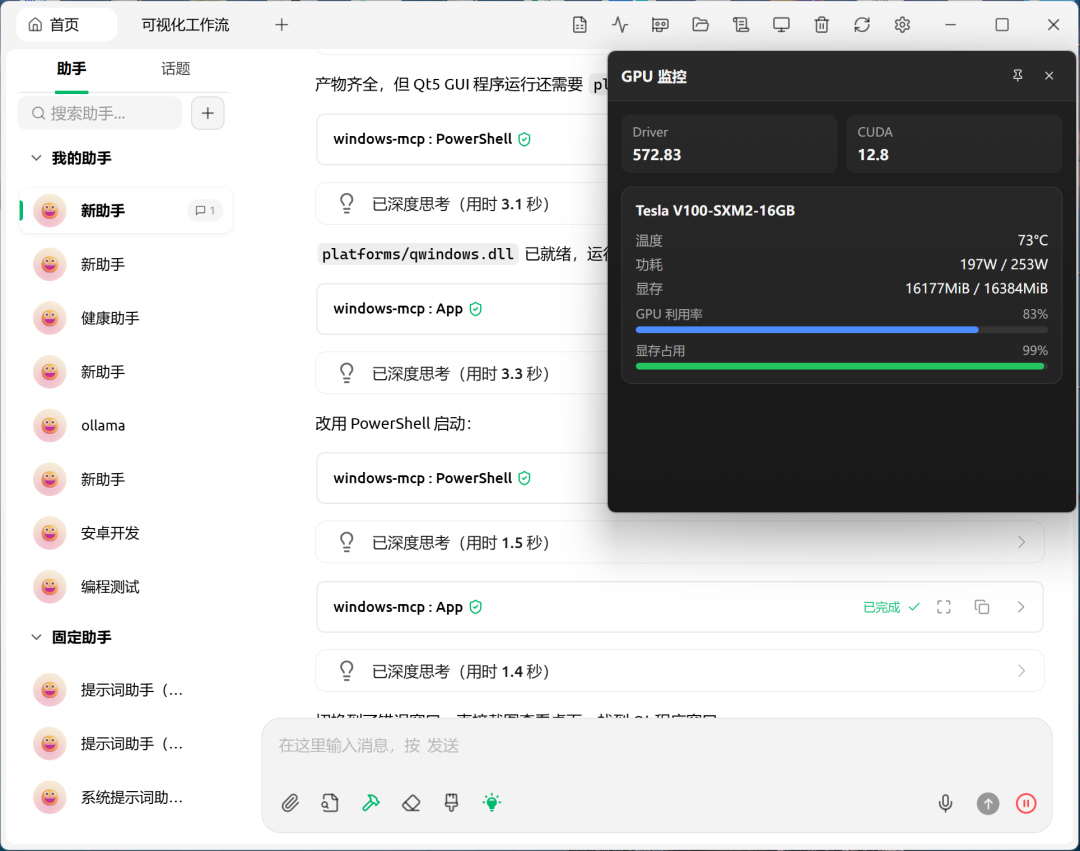
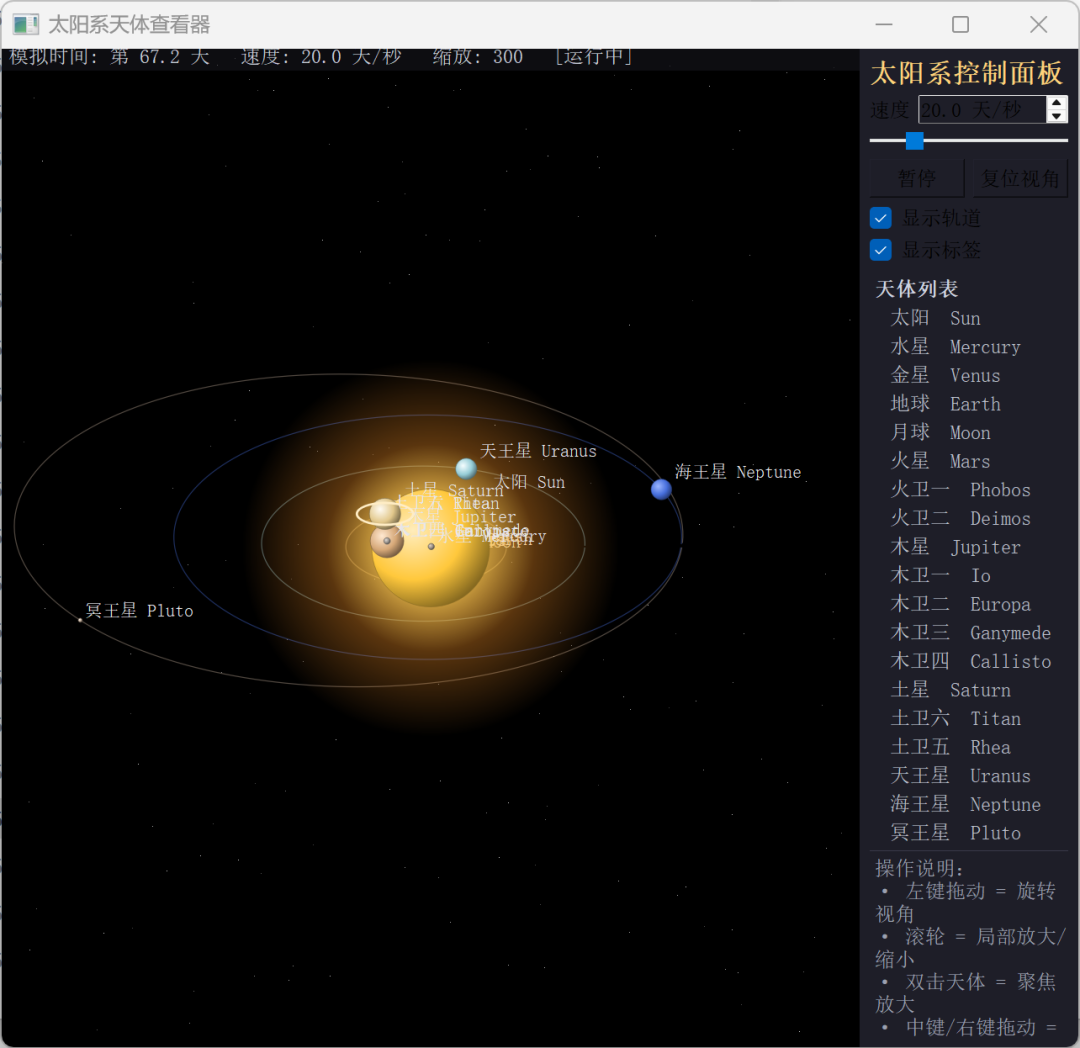
重磅!!!通过混合量化, 单卡16GB 跑Qwen3.8-27b本地大模型,120K上下文,实现高精度自动编程。 作者:河北阮咸科技有限公司 发布:2026-09-04 11:03 收录:2026-09-04 16:16 1 次阅读 约 296 字 摘要:固有思维,Q4精度以下量化,简单聊天、语义纠错还可以,针对编程、数据分析等应用场景来讲基本上就是不可用状态,Qwen3.8-27b采用Q4量化的模型权重基本上都在14G-17G之间,16G显存GPU基本上处于不可用状态,而精度更高的Q6 Q8 FP8精度的权重在20GB-30GB之间,16G显存的GPU更是无缘。… 推荐理由:本文涵盖「本地大模型」、「混合量化」、「Qwen3.8-27b」等多个主题,重点关注 本地大模型。 固有思维,Q4精度以下量化,简单聊天、语义纠错还可以,针对编程、数据分析等应用场景来讲基本上就是不可用状态,Qwen3.8-27b采用Q4量化的模型权重基本上都在14G-17G之间,16G显存GPU基本上处于不可用状态,而精度更高的Q6 Q8 FP8精度的权重在20GB-30GB之间,16G显存的GPU更是无缘。 但是,针对Qwen3.8-27b模型Q2-Q8的混合量化模型,权重只有12GB,能够以120K Q8_KV上下文进行自动编程,实测效果媲美Q6量化,但是16GB显存的GPU 跑起来完全无压力,输出速度也要比Q6量化快50%以上。 混合量化的本地大模型的部署成本,大致是Q6量化模型本地部署成本的1/3,是FP8量化本地部署成本的1/5,甚至更低! 阮咸AI助手,V1.0.8已针对混合量化模型做深度优化!我们要让所有单位都用得起,具备提升工作效率、具备强生产力的本地大模型!关注阮咸科技 转载声明:本文转载自原发布平台 (作者:河北阮咸科技有限公司), 原文标题《重磅!!!通过混合量化, 单卡16GB 跑Qwen3.8-27b本地大模型,120K上下文,实现高精度自动编程。》, 查看原文。 版权归原作者及原发布平台所有,本站仅作收录与展示,未对正文内容作实质性修改; 若涉及侵权请联系本站处理。 ← 好消息GPT-6 Astar发布了,坏消息是还用不上,价 【一图看懂】玩转 Windows 日志:读懂电脑的内心独 →