四个通用 Agent 大 PK:同一台本地大模型,谁又快又准?
本期关键词:本地大模型 · Strata 引擎 · Qwen3.8-Flash IQ3_XXS · 四个 Agent 同台竞技
一、先说这次用的"本地大脑":Strata 与那颗 MoE 模型
做这次评测,最关键的不是比 Agent 的 UI 好不好看,而是让四个 Agent 在完全公平的条件下,调用同一个本地大模型——不走任何云端 API。为此我在本机搭了一套本地推理环境,核心是一个叫 Strata 的开源推理引擎。
1. Strata 是什么、为什么火
Strata 是一个 MIT 许可的开源推理引擎(基于 llama.cpp / ggml 路线),它把三件事做扎实了:专家缓存、推测解码、混合卸载。现在的痛点是——动辄几十 GB 的 MoE 大模型根本塞不进普通显卡,而 Strata 这类引擎把"用得起本地大模型"的门槛直接打下来了:开源、免费、可改,同样的模型在它上面能稳定出 tok/s,于是成了很多 Agent / 工具链的本地后端首选。
2. 部署方式(安全又不乱)
部署思路很简单也很稳:推理引擎只监听 127.0.0.1:8095(本机回环),前面再挡一层局域网网关 0.0.0.0:8080,做纯 TCP 字节管道转发 + IP 白名单。四个 Agent 全部把 OpenAI 兼容接口的 base_url 指向 http://本机IP:8080/v1,API Key 统一填网关下发的 token。好处有两个:① 一台机器上的多个客户端共享同一个本地模型;② 真正的模型端口锁在内网,安全可控。
3. 为什么用它速度会更快
三个核心原因:
- MoE 稀疏激活
:24576 个专家,每次只点亮 10 个,计算量天然小; - 专家缓存
:高频专家常驻 GPU、其余放内存、必要时 CPU 参与,命中率接近一半,省掉大量重复搬移; - MTP 推测解码
(约 --spec 4、--spec-min-p 0.5):一次多猜几个 token,实测带来约 1.6–1.8 倍加速。引擎日志里能看到 decode expert cache hit rate ≈ 48%、suffix drafts 接受率也相当可观。
4. 本次使用的模型配置:qwen3.8-flash-next-iq3_xxs
模型配置速览
· 架构:MoE,总专家 24576、每 token 激活 10 个
· 量化:IQ3_XXS(3-bit i-quant),分两片——shard1 ≈ 43.81 GB(专家权重)+ shard2 ≈ 26.82 GB(PLE 表),合计 ≈ 70.6 GB
· 上下文窗口 216064 tokens,单次输出上限 8192 tokens
· 之所以能在只有 12GB 显存的笔记本上跑起来,正是因为它被压到 ≈70GB 且支持专家缓存,得以用"GPU + 内存 + CPU"混合推理(实测 prefill 批量复用可达 1.5万+ tok/s,decode 约 50 tok/s)
二、本地实验环境
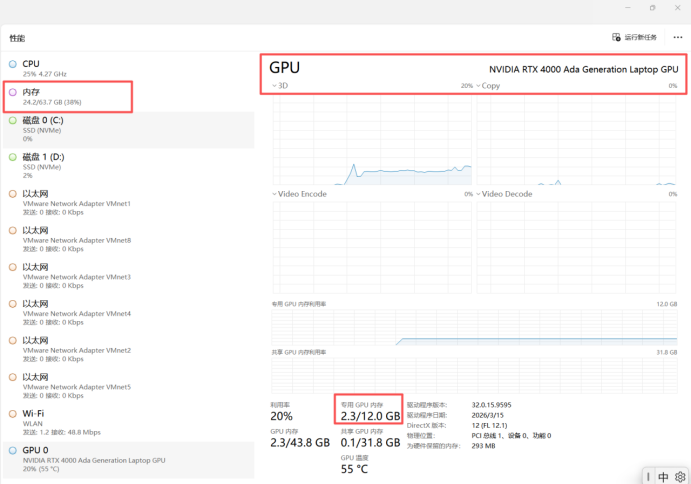
机型:笔记本(Windows)
CPU:当前频率 4.27 GHz(高频多核)
内存:61.7 GB(实测占用约 24.2 GB)
GPU:NVIDIA RTX 4000 Ada Generation Laptop GPU,12 GB 显存,驱动 32.0.15.9595(2026/6/25)
存储:NVMe SSD(C: / D:)
关键看点:仅 12GB 显存,靠 Strata 的专家缓存 + 混合卸载,硬是把 ≈70GB 的 MoE 模型跑起来了
三、实验设计:把公平钉死
- 四个选手
:WorkBuddy(GUI 界面)、OpenCode(CLI)、Hermes(CLI)、Pi(CLI); - 公平原则
:四个 Agent 全部关闭记忆、Skill、MCP 工具,保证不靠任何外部能力作弊; - 干净环境
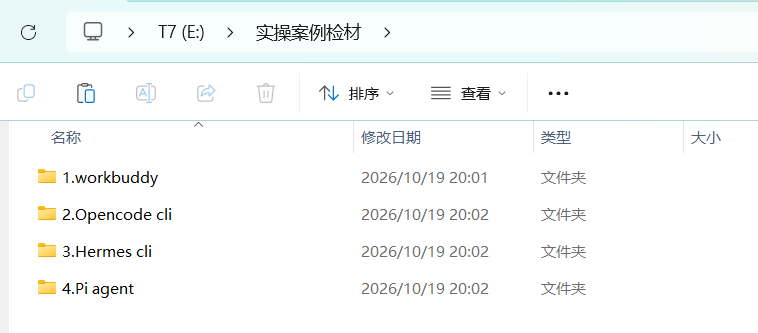
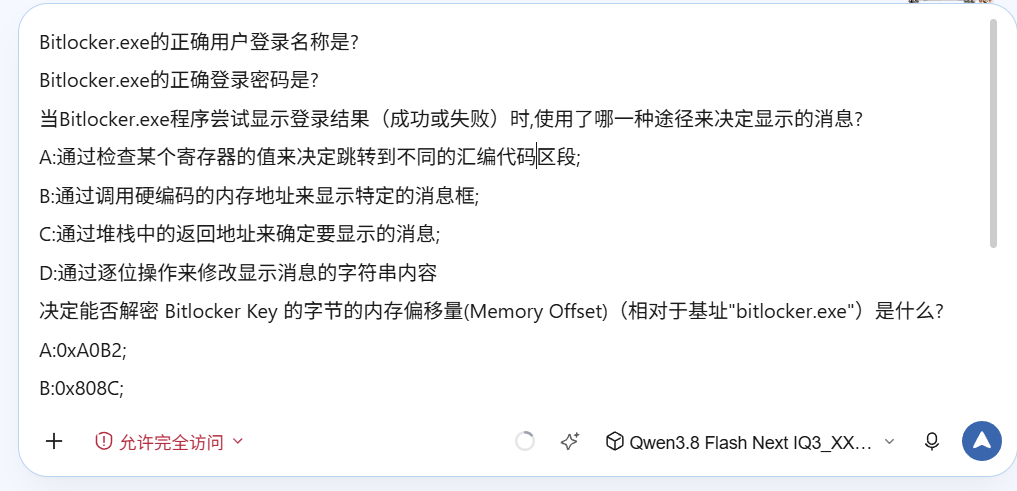
:四个 Agent 各对应一个独立文件夹,里头放同一个 Bitlocker.exe检材(位于 E:\实操案例检材),互不干扰; - 统一题目
:四个 Agent 输入完全相同的 5 道提示词,考察解题能力、用时、是否自调工具、正确率; - 金标准答案
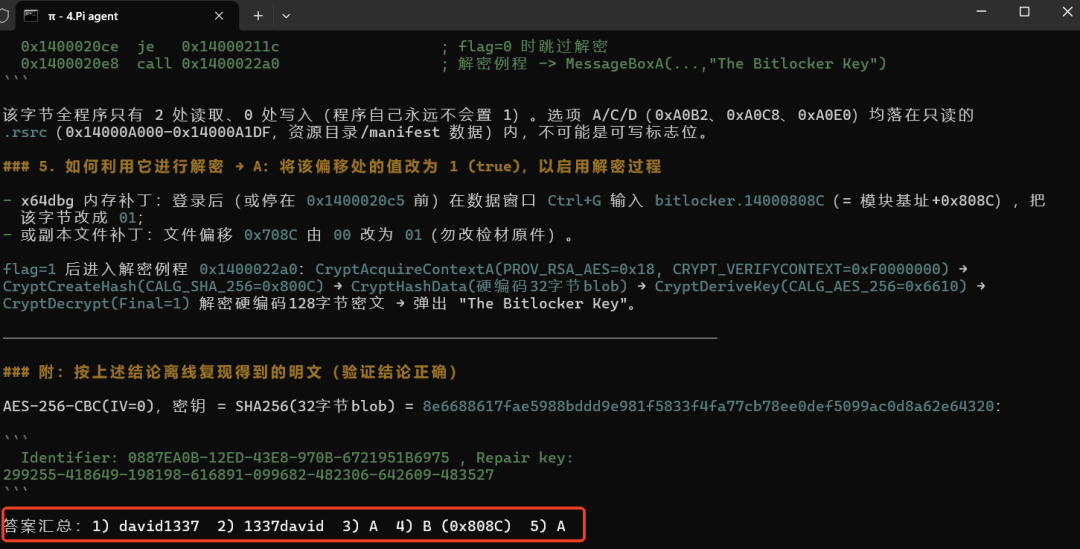
:① david1337 ② 1337david ③ A ④ B ⑤ A(五题全对才算满分)。
四、原文测评 & 过程截图
以下为原文测评内容与过程截图,未作任何改动,仅在此之后补充监测数据。
首先登场的是Workbuddy,
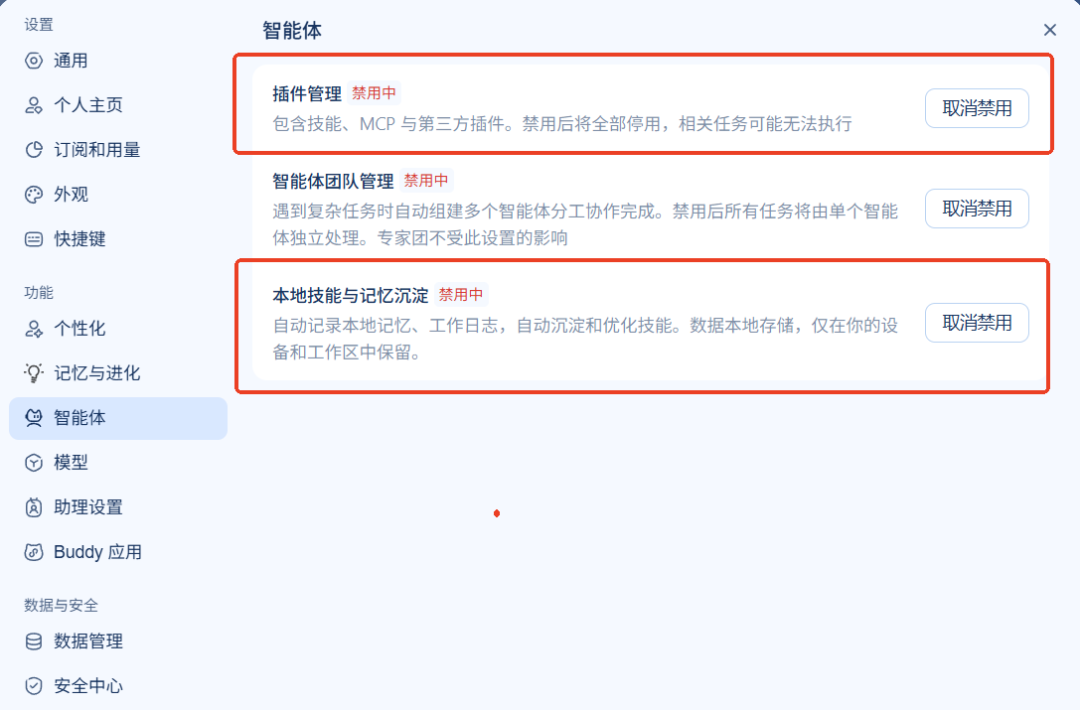
为了公平性,将记忆、skill和MCP工具通通关闭掉:
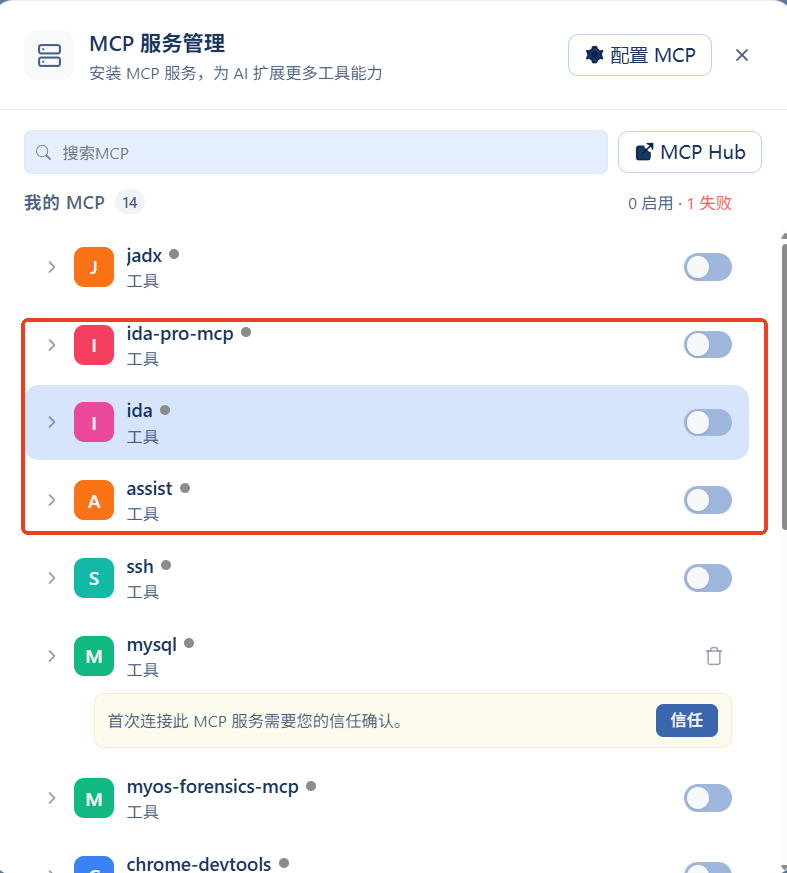
MCP工具也是关闭的状态
为了保证环境的干净,四个Agent分别对应一个文件夹,里头存放这Bitlocker.exe
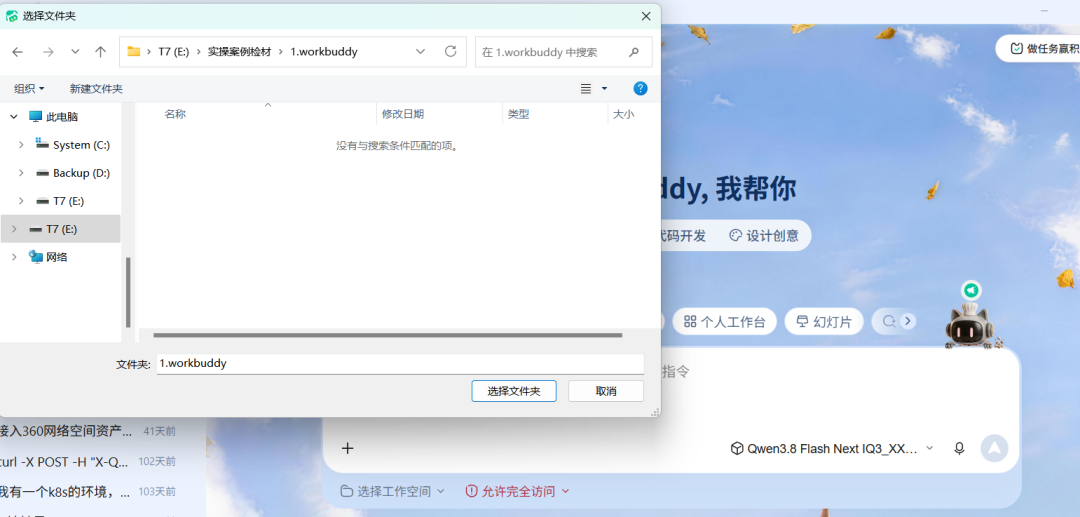
选择检材对应的文件夹:
输入5道题的提示词:
最后用时与结果:
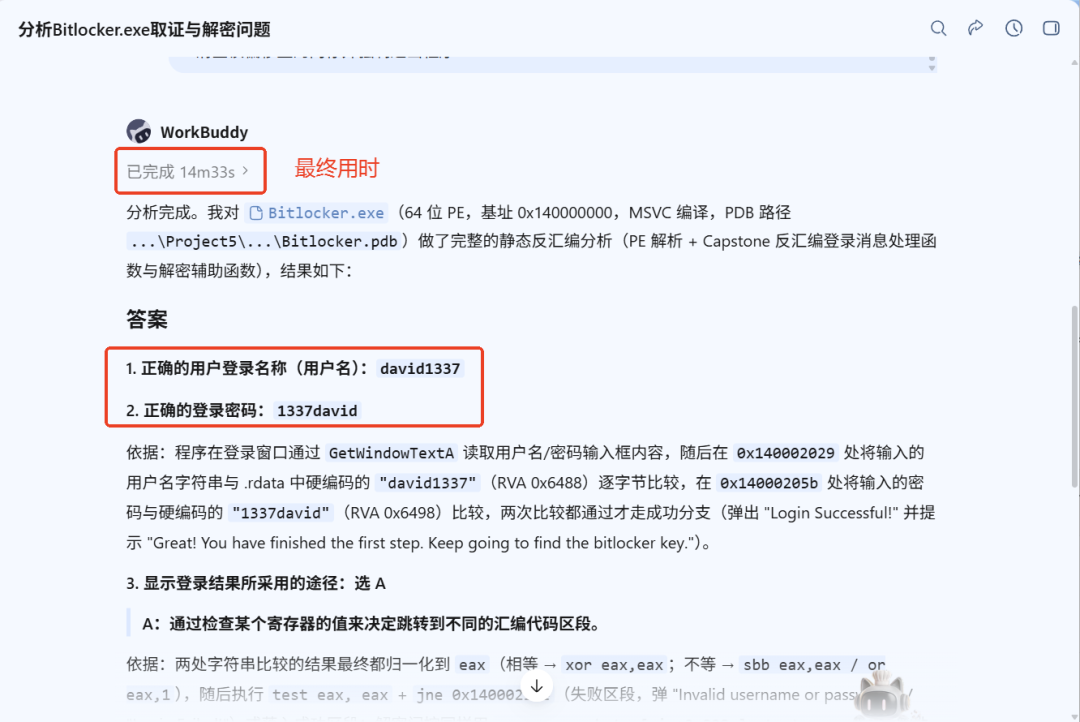
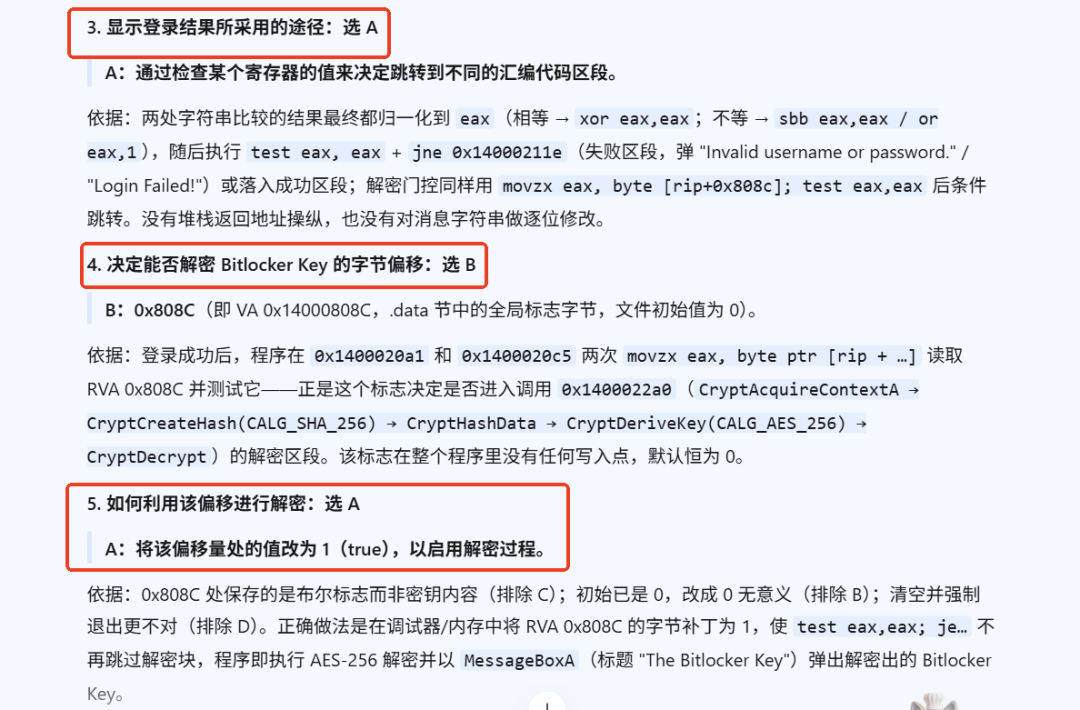
测评:不知道是不是因为Workbuddy是GUI界面的原因跑得时间稍微长点,但在解题的过程当中也是编写脚本进行实现,正确率也是100。
Opencode cli登场:
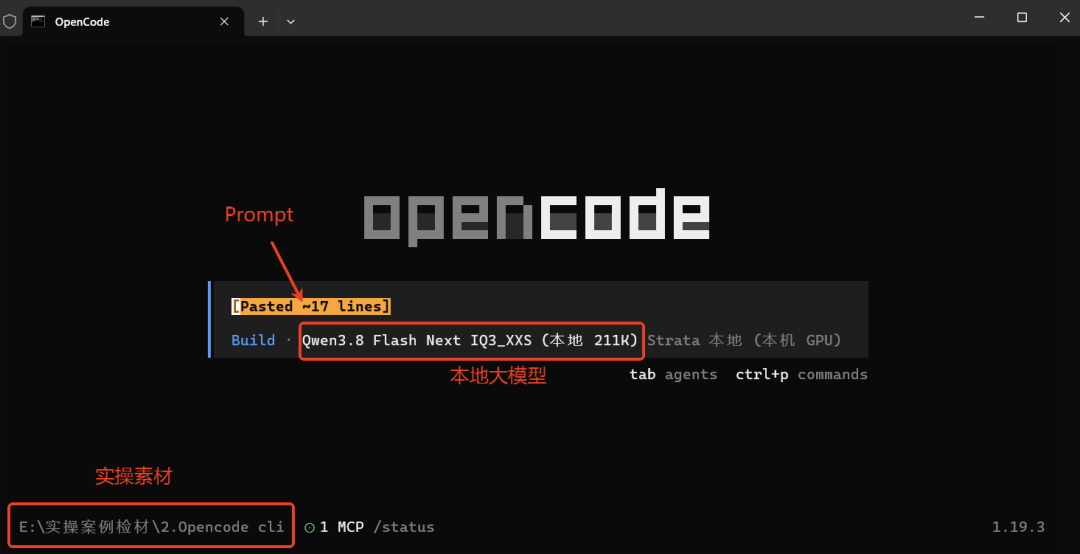
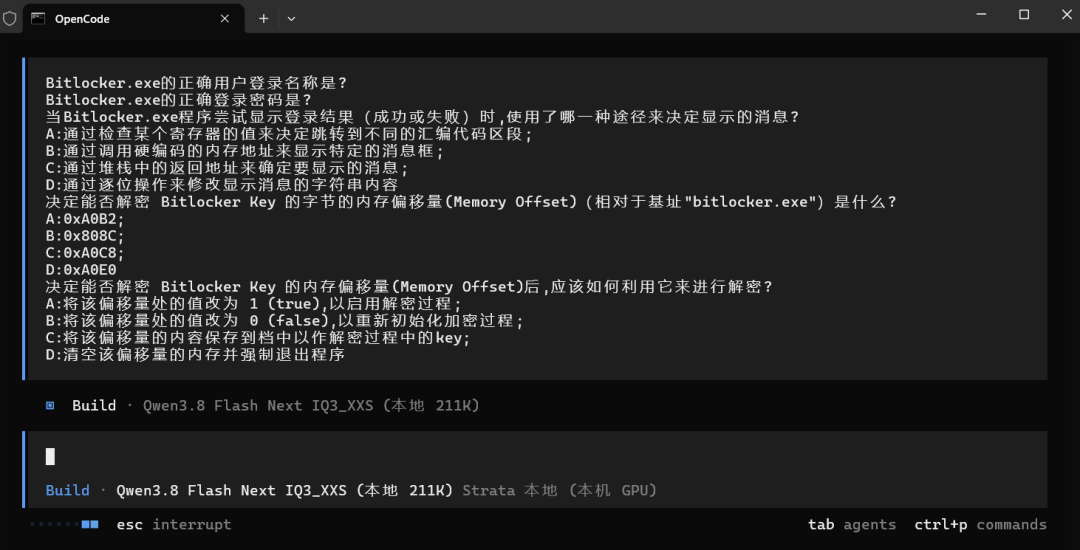
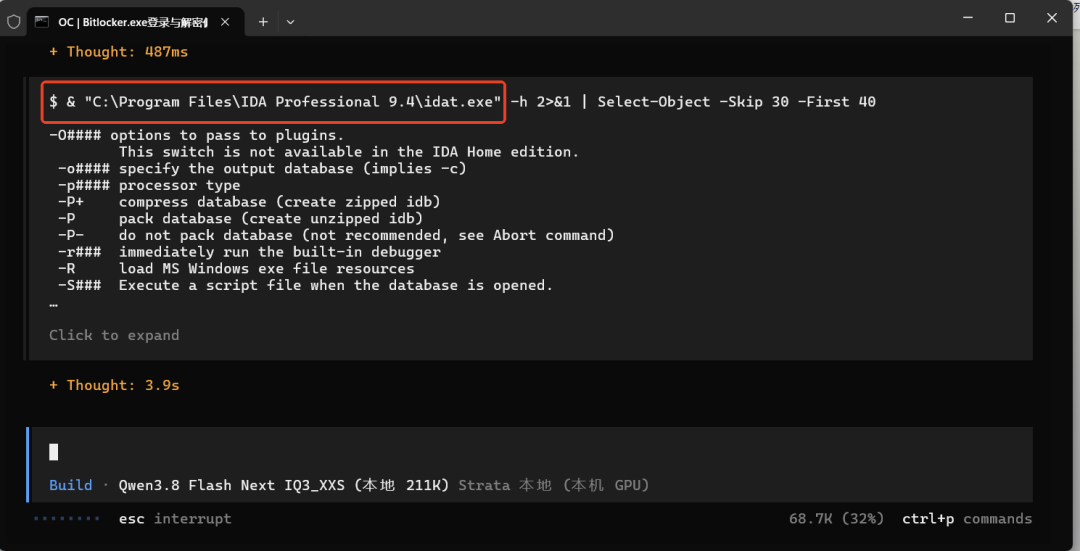
Opencode cli自己有调用了本地的IDA工具:
总共才用了5m42s:
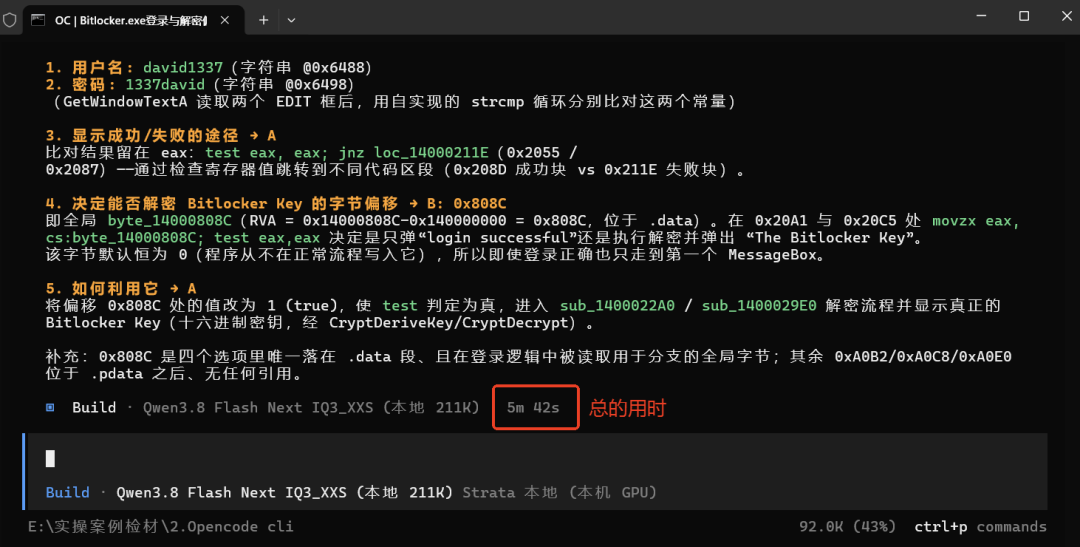
测评:OpenCode cli的速度是最快的,它是四个Agent里头用的巧劲的一个Agent,它调用了IDA的工具来解析程序文件。这样解题的速度比其他Agent没调用工具来得快。
接下来是Hermes cli:
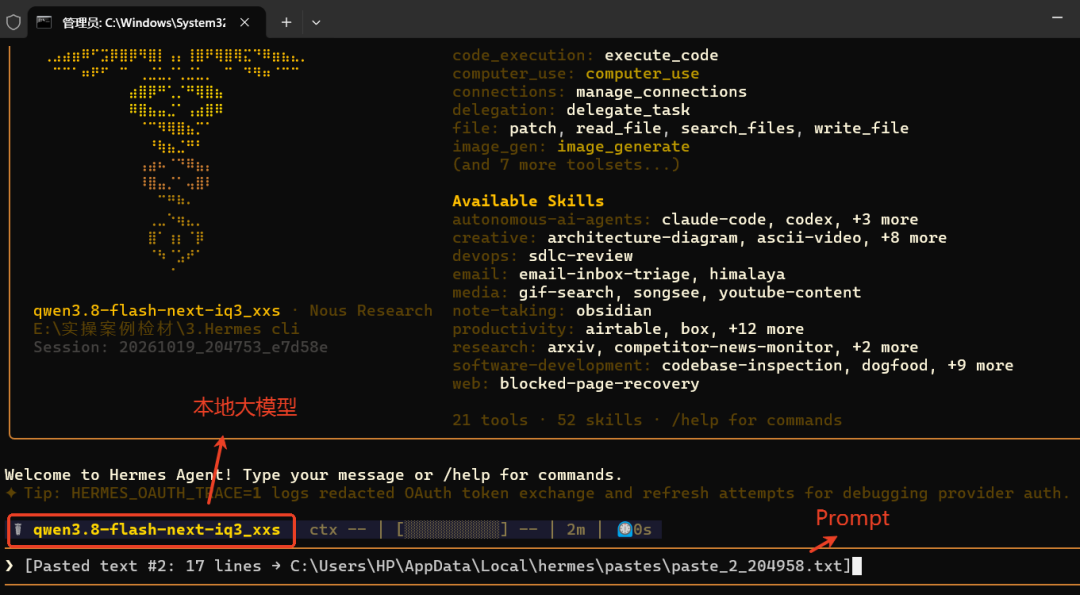
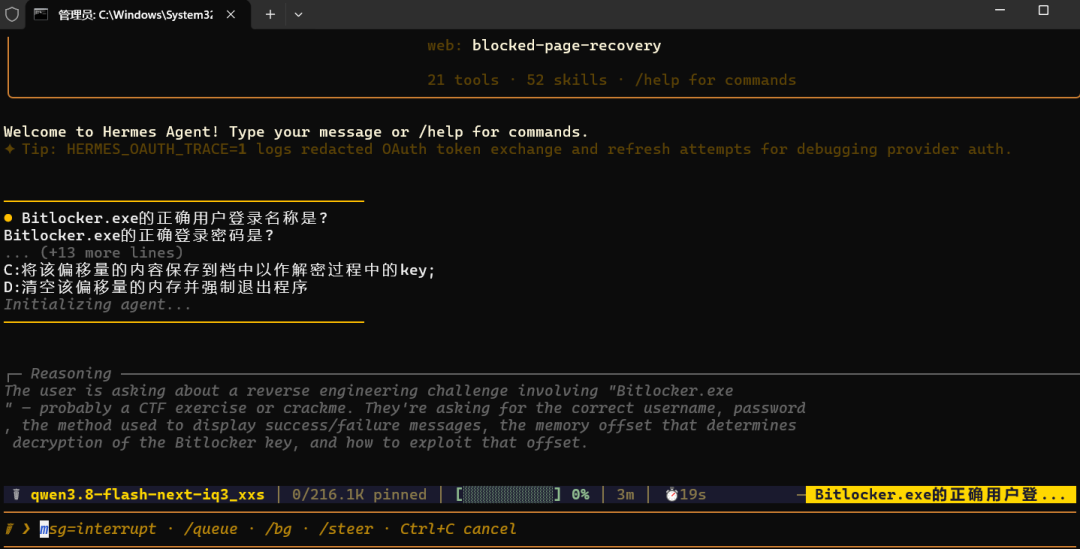
开始时间:
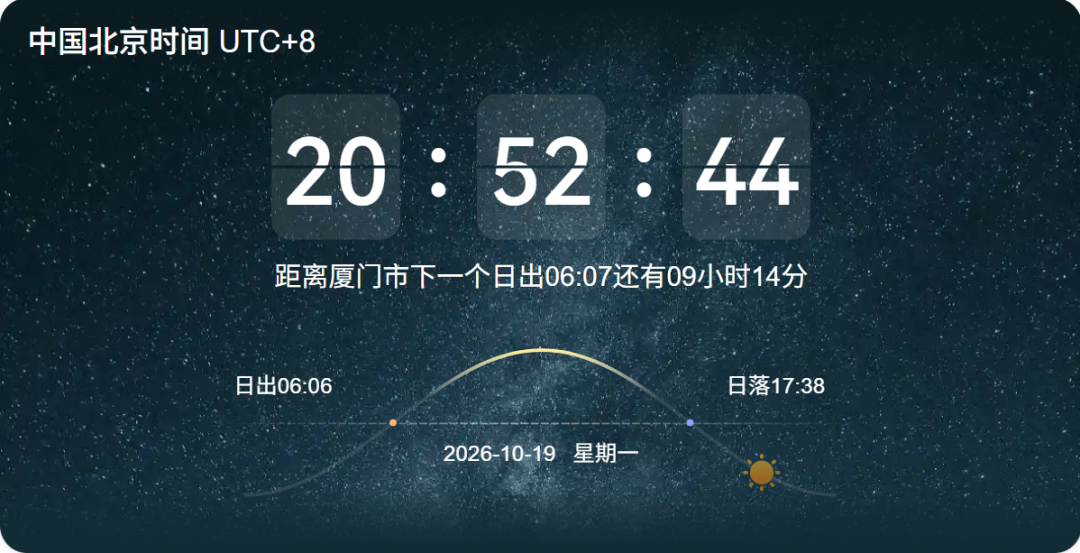
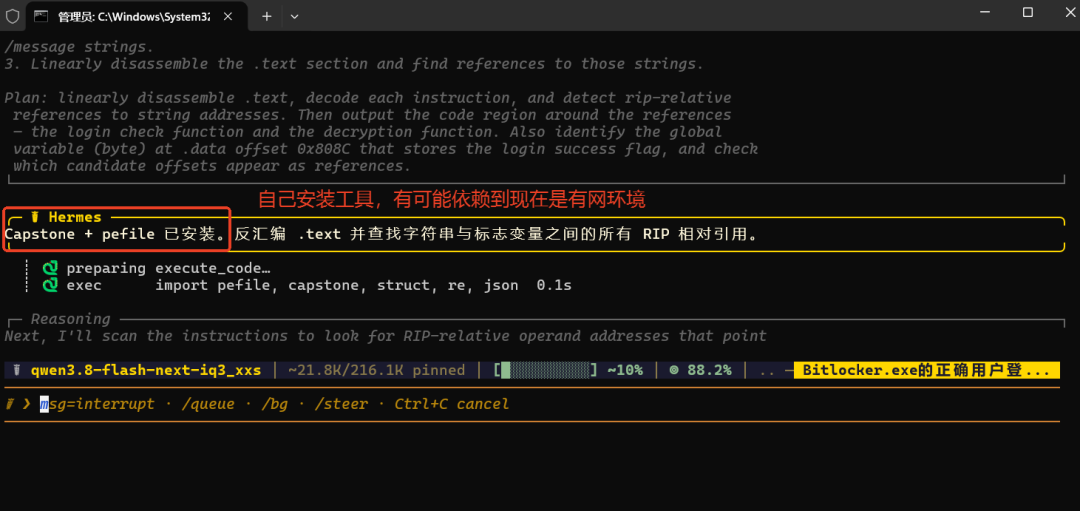
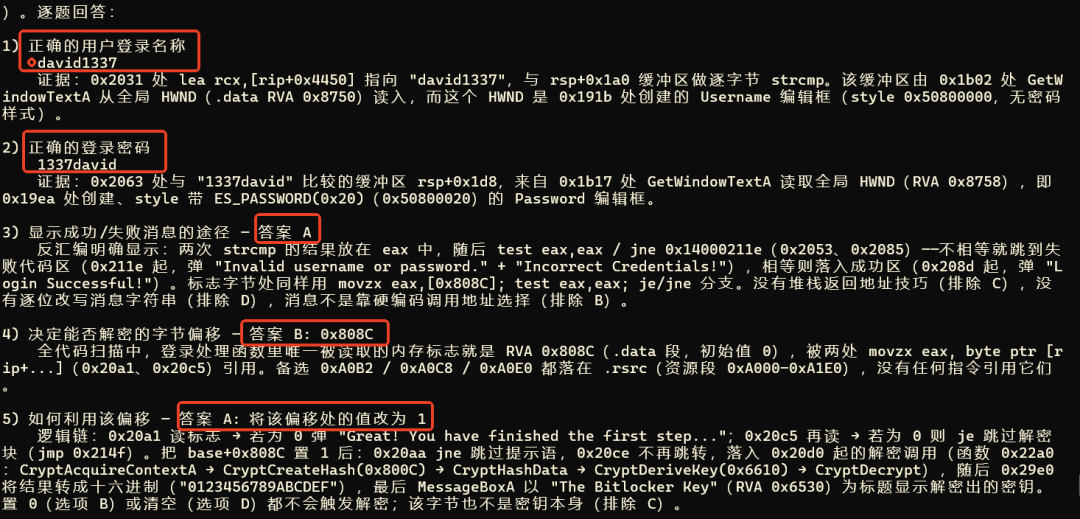
最终结果:
结束时间:
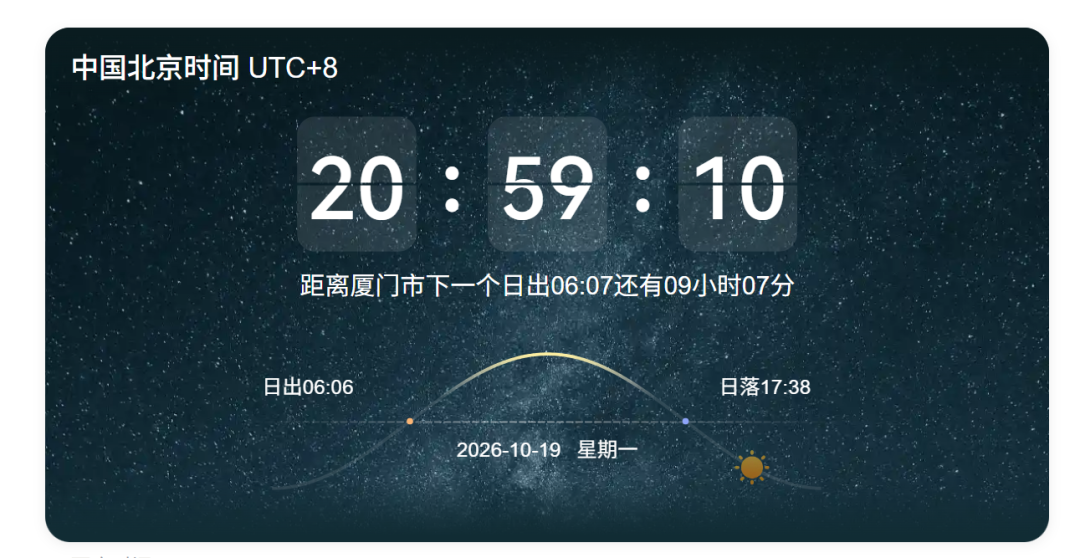
测评:Hermes cli的速度紧随Opencode cli的后面,花了大致有8分钟,但是它也是用了巧劲,自己安装了工具来进行反编译。
最后一个Pi agent:
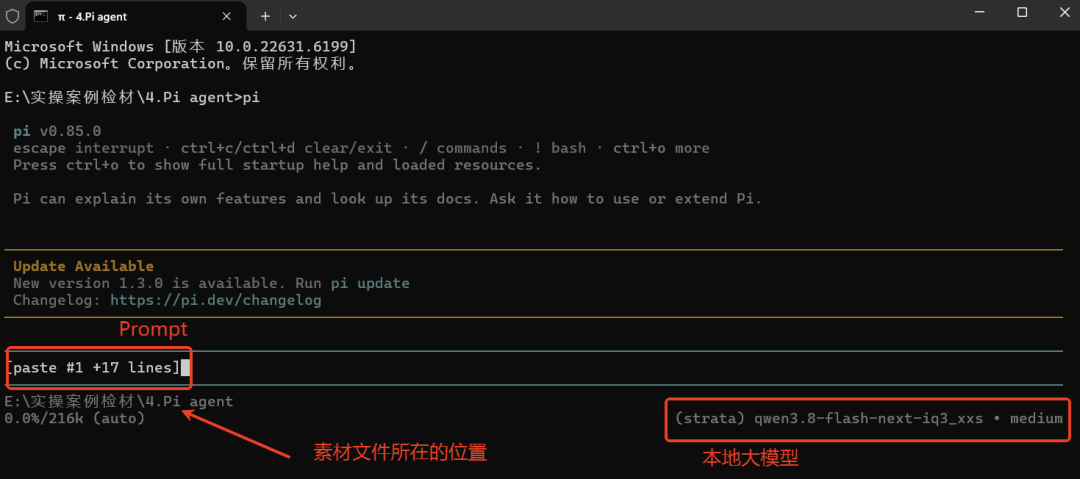
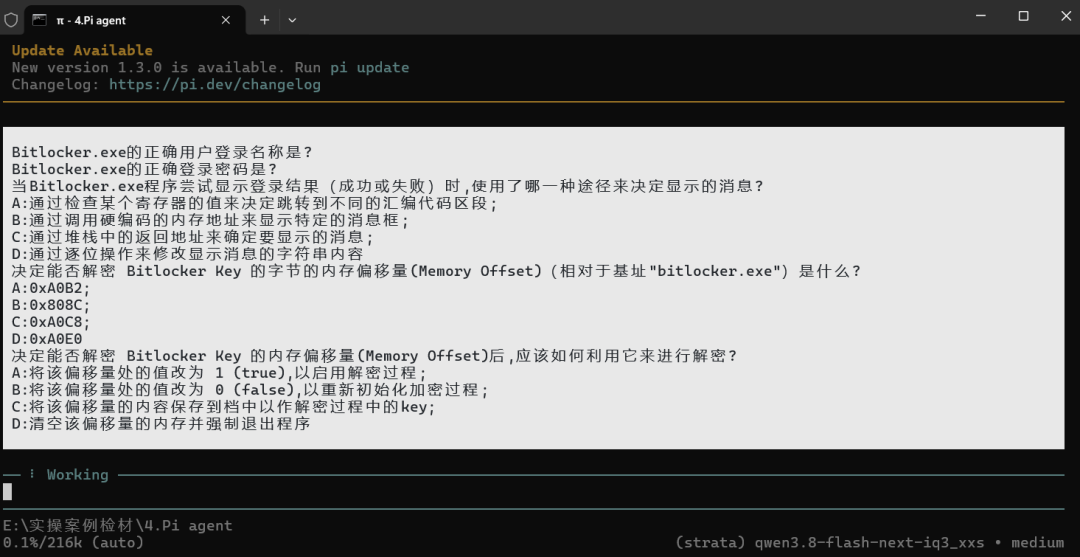
开始时间:
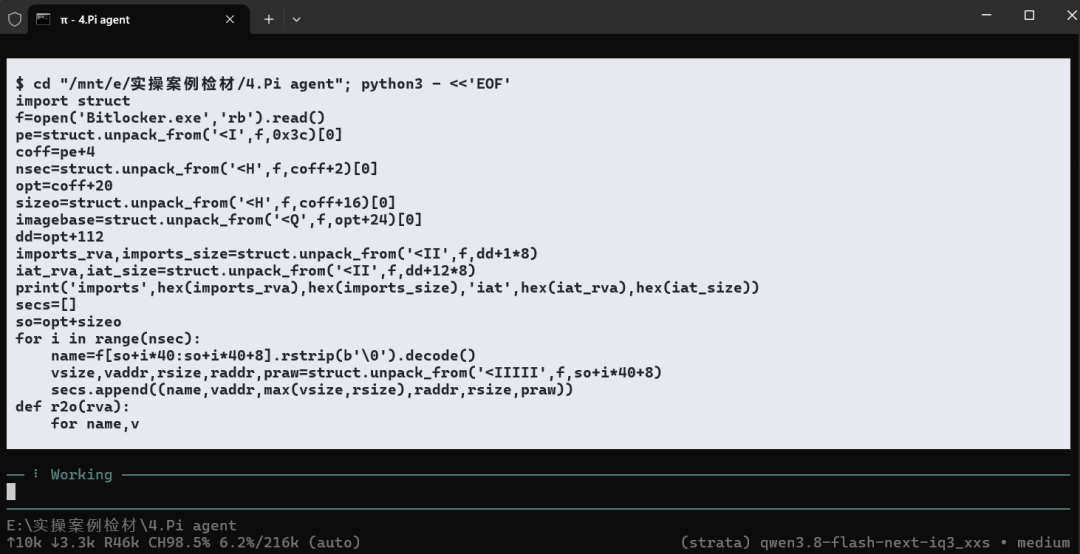
Pi像workbuddy一样,也是自己写了个Python脚本:
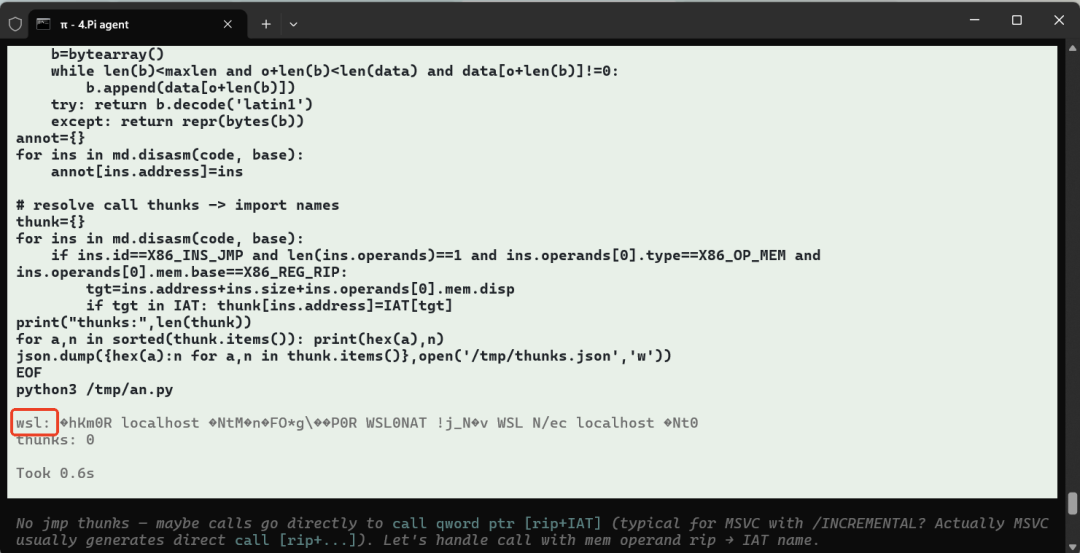
也调用了wsl的环境:
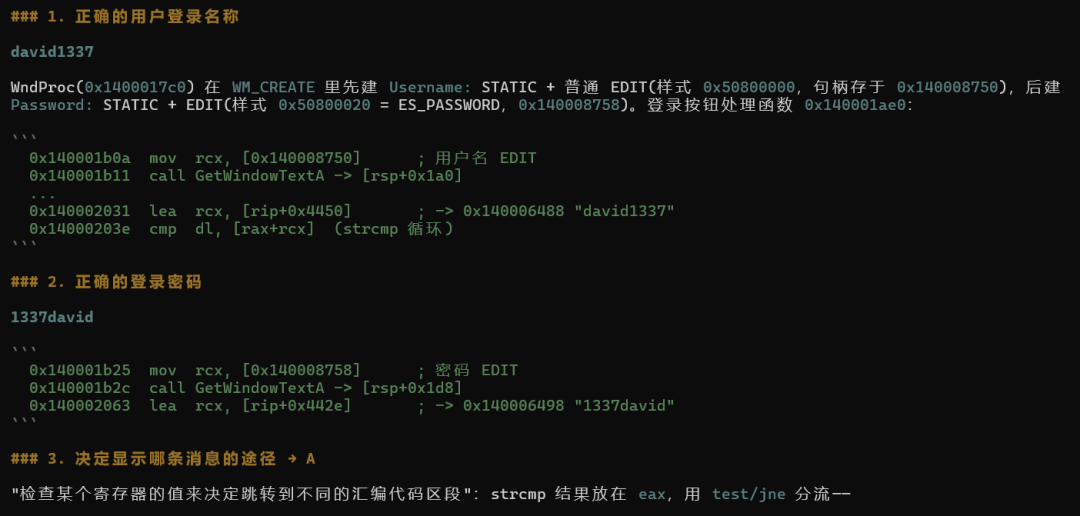
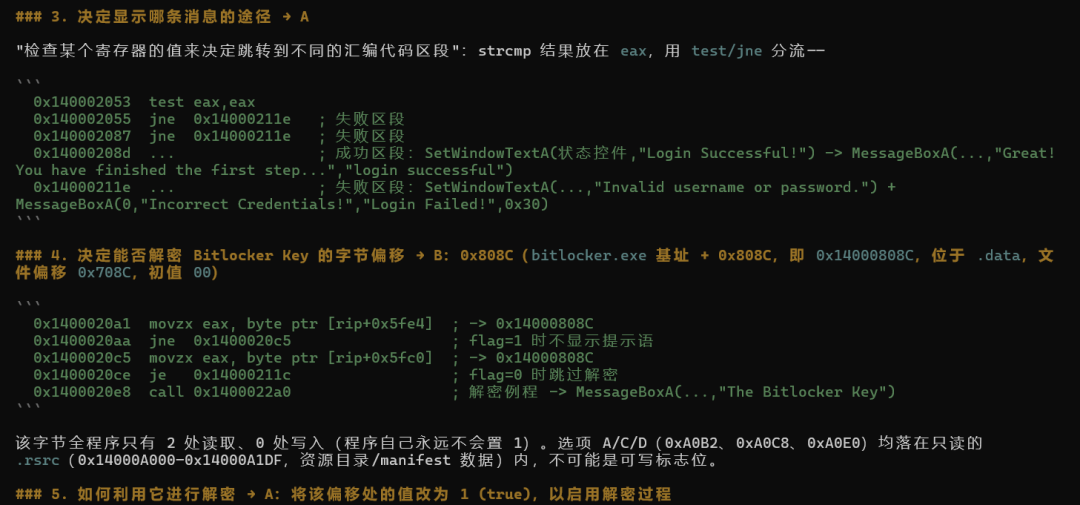
完成:
完成时间:
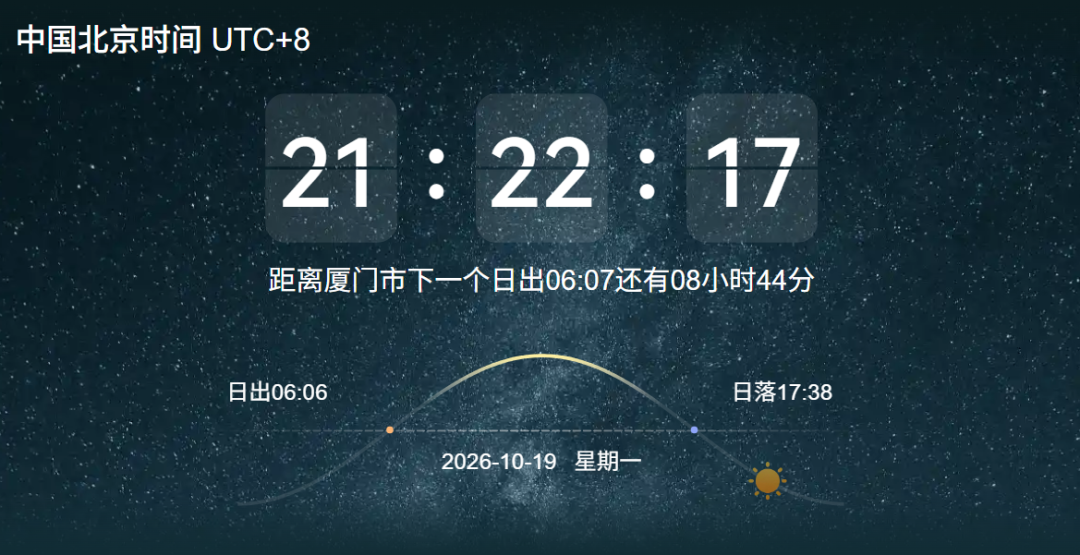
测评:Pi Agent的完成速度有点出乎意料,号称最轻和底层的Agent跑了近20分钟,比workbuddy还久,但它所出来的结果是最详细的,最后还给你汇总了下答案。
六、 token 速度监测数据补充
除了"谁更准、谁更快"的主观感受,这次我还从客观日志层面把四个 Agent 调用本地模型的速度量化了出来。监测由两层日志交叉印证:
- 局域网网关日志
(gateway.log):记录每一次经过网关的请求时间、源端口、字节数、耗时。真实生成请求的特征是"耗时≥0.3s 或 字节≥1000",而健康探测(GET /v1/models 等)通常只有 430–750 字节、0.0s。网关是四个 Agent 通往本地模型的唯一代理路径。 - 推理引擎日志
(strata-iq3_xxs.log):输出 "N generated in X ms (Y tok/s)",这是"出 token 速度(decode)"的权威来源。引擎按完成顺序追加生成行,与网关请求可 1:1 对应。
补充:WorkBuddy 还伴随 28 次 prefill(提示词预填充)事件,共 1,812,841 tokens、耗时 118.7s,平均约 15,269 tok/s——说明读入大段上下文时吞吐极高,瓶颈主要在逐 token 生成(decode)环节。
关于 OpenCode:文档评测已确认它确实调用了本机大模型,并且 5m42s 是四个里最快的。但它的生成请求没有出现在网关代理日志里(很可能直连了引擎端口 8095,绕过了 8080 网关),所以上面这张表暂时只能给出它的文档实测用时,而无法用网关/引擎日志独立量化其 tok/s。这点如实标注,不替它编造数字。
从能取到数据的三个 Agent 看,本地 MoE 模型在笔记本上的持续 decode 速度稳定在 42–70 tok/s,三者的聚合速度非常接近(46.8 / 51.5 / 50.2),差距远小于它们在"总用时"上的差距——这正好印证了正文测评里的结论:决定快慢的不是模型本身,而是 Agent 会不会自己调工具(OpenCode 调 IDA、Hermes 自装反编译、WorkBuddy/Pi 手写脚本)。
本文为「AI 取证实战」系列第 30 期 · 由 小谢取证 出品
实验环境:本地 Strata 引擎 + qwen3.8-flash-next-iq3_xxs(IQ3_XXS)· 笔记本 12GB 显存混合推理

敬请各位大佬关注:小谢取证
扫取二维码获取
更多精彩
小谢取证