把"逐页截图 + 数据汇总"交给 AI
—— 网络在线提取的一次效率实验
电子数据取证里有一类很"磨人"的活儿:网络在线提取。它不需要拆硬盘、不用镜像,只要在办案电脑上打开目标网站,把涉案页面一页页固定下来。听起来简单,做起来却是体力活——本文用一个真实场景,对比一下传统做法与AI 赋能做法,看看机器到底能替人省下什么,又留下了哪些待讨论的问题。
一、传统做法:12 步走完,人累在哪
参照《网络在线提取笔录》的标准流程,一次规范的网络在线提取大致是这样的:
传统提取的典型步骤(节选)
① 配置标准取证环境,用录屏软件全程录像
② 火绒全盘杀毒,确认无病毒报警
③ 打开国家授时中心网站校时,核对本机时间
④ 查看 hosts、刷新 DNS、查看内网 IP、tracert 路由
⑤ 清除浏览器缓存后登录目标网站
⑥ 用 FastStone Capture 逐页截图、导出列表,保存到本地
⑦ 用 WinRAR 压缩,再用 HashMyFiles 计算 SHA-256 校验值
⑧ 制作《电子数据提取固定清单》,人工誊抄数据、签署确认
流程本身没问题,问题出在"逐页""人工""誊抄"这些字眼上:
传统做法的四个痛点
耗时费力 列表有几十上百页时,FastStone 只能截"当前屏/滚动屏",翻页仍然要人一次次点。
易张冠李戴 截图里不一定带 URL,第几页对应哪个地址,全靠人记,事后很难自证。
数据要誊抄 页面里的表格要人工抄进 Excel,页数一多就容易错行、漏行。
留痕粗放 全程录屏动辄几百 MB,事后想按"某一页"检索,几乎无从下手。
二、AI 赋能:把重复劳动交给机器
思路很朴素——凡是"点一下、看一眼、抄一行"的机械动作,都交给程序去干。本次实验里,AI 驱动浏览器自动翻页、自动截图、自动解析表格,全程不需要人工逐页操作。
三、AI 具体替我做了哪几件事
3.1 逐页截图,而且每一页都带 URL
这是最关键的改进。程序通过浏览器的调试接口(CDP)直接驱动页面翻页,每加载完一页,就对整个浏览器窗口截图——注意,是连地址栏一起截。这样每张图天然携带了"这一页是哪个网址、第几页",URL 与页面内容一一对应,彻底消除了事后对不上号的问题。下面三张就是程序自动抓取的第 1、2、3 页原图:
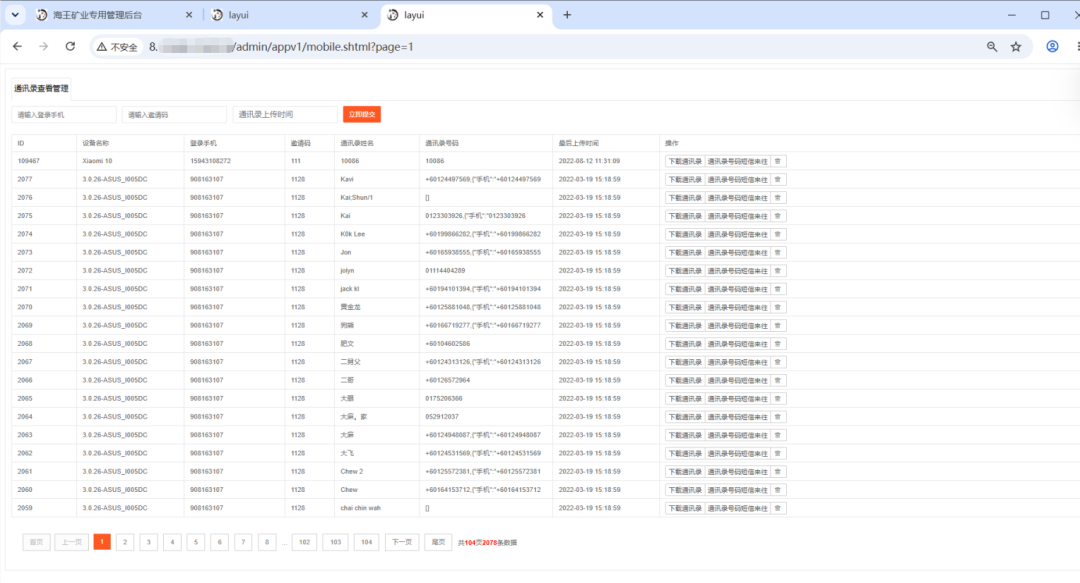
▲ 第 1 页:地址栏可见完整 URL,含 ?page=1 参数
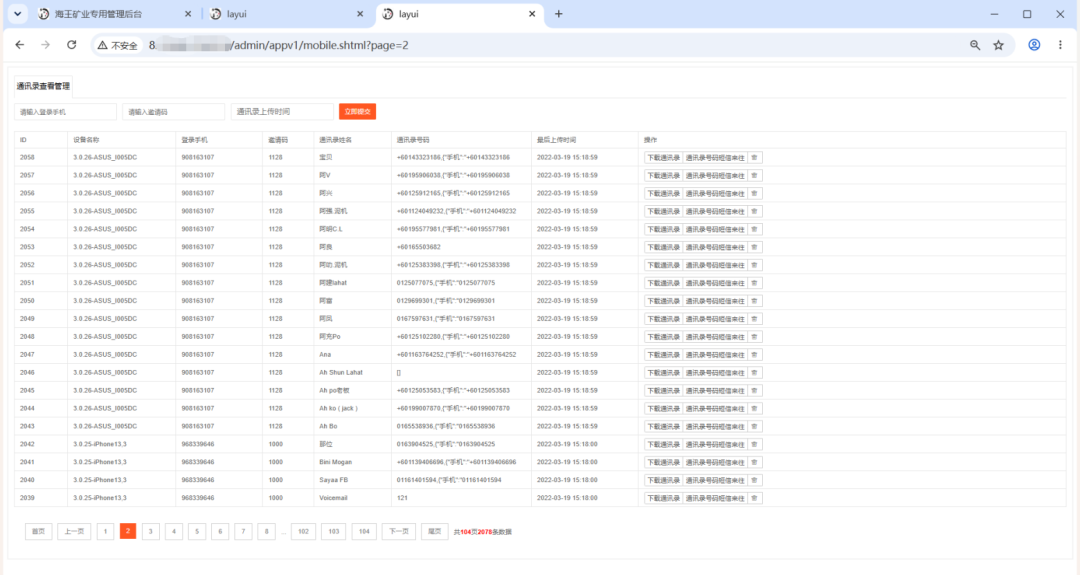
▲ 第 2 页:同样带 URL,表格内容已翻到第 2 页
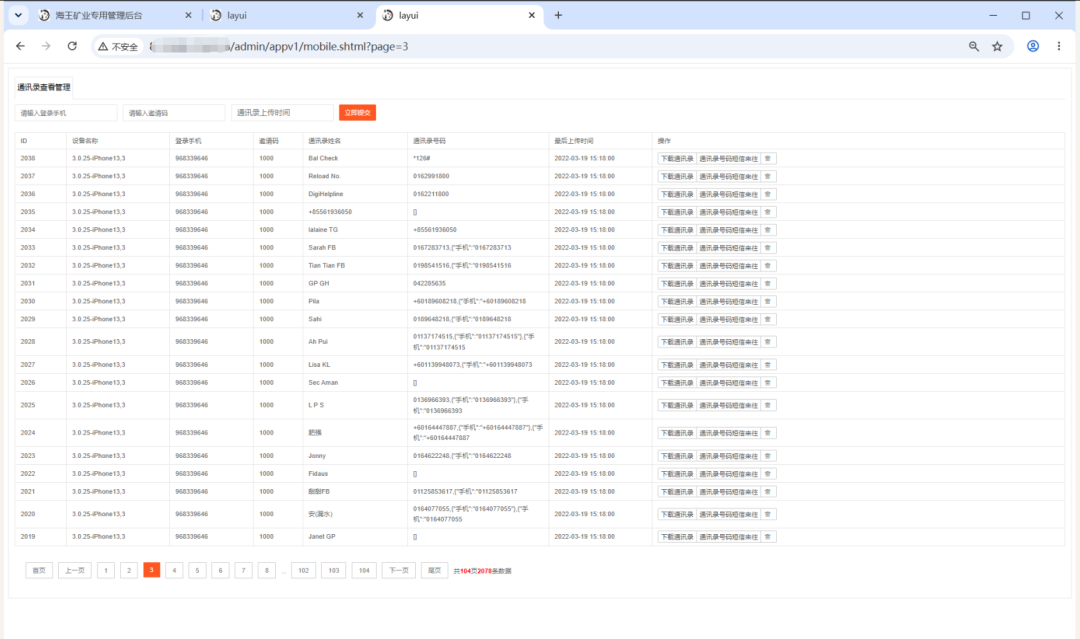
▲ 第 3 页:连续翻页无需人工干预
3.2 自动解析表格,一键汇总成 Excel
截完图,程序顺手把页面里的表格结构也读了出来,直接生成一张汇总表——本次前 20 页共 400 条记录、8 个字段,另附一页"统计概览"。下面是汇总表的结构与样例:
(上表为自动汇总结果的样例行,原表共 400 行,另含统计概览工作表。)
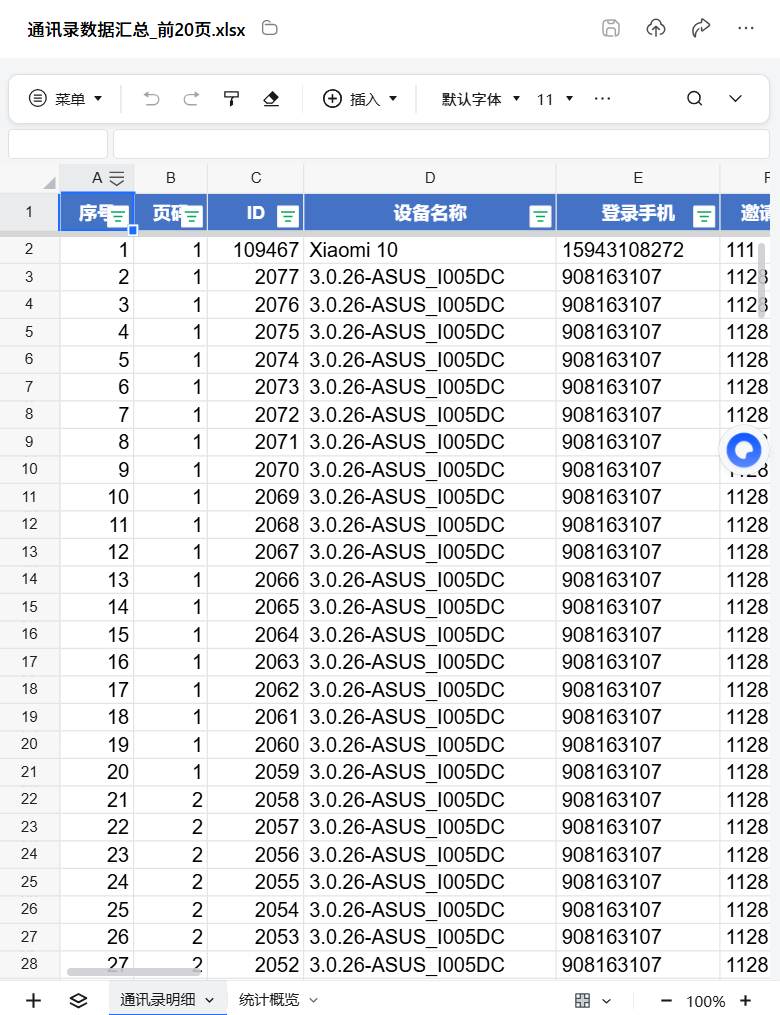
3.3 顺手留痕:截图清单与哈希校验
程序在截图的同时,自动记录每张图的文件名、SHA-256 校验值、对应 URL、首末记录编号,并生成一份采集报告。这一步呼应了传统流程里"HashMyFiles 校验 + 制作清单"的要求,只是把人工誊抄换成了机器生成,既快又不容易错。
四、用到的工具与环境
本次实验的环境
浏览器 Google Chrome(以调试模式启动,供程序驱动)
驱动方式 Chrome DevTools Protocol(CDP),无需安装额外插件
脚本 Node.js 负责翻页与解析,Python 负责窗口整屏截图
输出 PNG 原图 + JSON 结构化数据 + Excel 汇总表
注:整套流程只做只读的浏览、截图与数据读取,不修改、不删除目标网站的任何数据。
五、优势与不足:一张表说清
一句话总结:AI 把"重复、机械、易错"的环节做得又快又准,但它目前替代不了取证人员的判断、见证与法律责任。
六、规范探讨:AI 赋能网络在线提取的"边界"
三个绕不开的问题
① 它是一种"侦察能力" 网络在线提取本身就是侦查行为。AI 让它变得更快、更省力,也就意味着同类"侦察活动"可以更容易、更大规模地开展——这种能力的授权范围、适用条件、审批留痕需要更明确的规定。
② 自动抓取的数据,能直接当证据吗 机器截的图、导出的表格,其真实性、完整性由谁保证?是否仍需要按规范做哈希封存、全程录像、见证签字?目前并没有针对"AI 参与"的专门条款。
③ 责任归属 当 AI 抓错页、漏行或解析出错时,责任在工具还是在使用者?这就要求 AI 始终停留在"辅助性、机械性"的定位上。
现有的技术标准(如 GA/T 756-2008《数字化设备证据发现提取固定方法》)是面向人工取证设计的。在 AI 赋能的新场景下,建议把握一条底线:
建议的边界
AI 做 翻页、截图、解析、汇总、算哈希等机械性、可复核的工作
人来做 提取范围的确定、见证、审批、哈希封存、笔录与清单的签署确认
可讨论 AI 赋能网络在线提取的行为规范、证据能力与责任划分,仍有待进一步明确
七、结语
这次实验证明:在网络在线提取这类"体力活"上,AI 能实实在在地把人从逐页点击、手工誊抄中解放出来,效率与准确率都明显提升。但它更像是一把更快的手术刀——刀快不等于刀法好。真正决定取证结论是否站得住脚的,仍然是规范、程序和人。
(本文用于教学交流,文中涉及的网址、数据均已由作者自行处理。)

敬请各位大佬关注:小谢取证
扫取二维码获取
更多精彩
小谢取证