📢 免责声明
与其在别人的仓库里翻找现成的 Skill,尝试自己动手造一个。
干安全和取证的人,桌上手册的数量大概仅次于咖啡杯。OWASP 的测试指南、各家工具的文档、内部沉淀的应急 SOP、漏洞研究的参考书……买的时候、存的时候都信心十足,"这套方法以后肯定用得上"。
可真到现场、真到分析台前,问题就来了:
手册要么厚得当场翻不过来,要么——我确实读过,但记得的只剩一个模糊轮廓。想查个具体的检查项、某类漏洞的完整测试路径,要么翻书翻半天,要么去问 AI。而 AI 给我的,往往是一段四平八稳、挑不出错、也帮不上忙的"正确的废话"。
直到我把这套流程跑通:把一本权威的书,整本"喂"给 Claude,让它蒸馏成一个可以随时调用的 Skill。
从那以后,那本书不再是硬盘里的死文件,而成了 AI 的一部分能力——需要的时候,它会自己把书里的方法论调出来用。这篇就讲清楚:这件事到底是什么、为什么权威书最适合这么干、以及具体怎么操作。我会拿 OWASP 的《Web Security Testing Guide》(WSTG,开源、约 465 页、业界标准方法论) 全程做演示。
一句话先摆这儿:这套方法不止能做安全书——但安全场景,恰恰是它最受用的地方。
一、Skill 和"把书丢进上下文",根本不是一回事
很多人会说:我直接把 PDF 拖进对话框不就行了?
能用,但有三个绕不开的坑:
第一,它是一次性的。 这次对话喂了,下次新开窗口还得重新喂。手册一旦几百页,每次都得等它"读"一遍。
第二,又贵又慢。 几百页塞进上下文,token 消耗惊人,长对话里前面的内容还容易被"挤"出记忆。
第三,也是最致命的——它会跳读。 模型面对一本厚书,天然倾向抓重点、略细节。你以为它通读了,其实是跳 着看完的。对一份讲究"逐项覆盖"的测试指南来说,这是硬伤——漏掉的可能正好是你现场要用的那一项。而 Skill 走的是完全不同的路子。它本质是一个文件夹:里面有个 SKILL.md 描述"这个技能是干什么的、什么时候该用",外加从书里提炼出来的结构化方法论和参考资料。
好处正好对上这三个坑:
• 一次蒸馏,永久可调用——做好一次,以后任何对话里 Claude 都能按需加载; • 按需加载,省 token——平时不占上下文,用到了才调出相关部分; • 逼它逐行处理——做 Skill 的过程,就是强制 AI 把整本书过一遍、归类、不许跳读。
一句话总结:喂上下文是让 AI"临时抱佛脚",做 Skill 是让 AI"把整本手册内化成现场能力"。
二、为什么"书"是做 Skill 的顶级素材
不是所有素材都值得这么折腾。踩过坑后我总结出一条铁律:素材质量,决定 Skill 的质量上限。
书之所以是顶级素材,因为它天然具备三个特点:
1. 结构化——有目录、有章节、有递进逻辑,AI 归类清晰。像 WSTG 这种本身就按"信息收集 → 配置管理 → 身份认证 → 授权 → 会话管理 → 输入验证 → 加密 → 业务逻辑 → 客户端 → API"分门别类的,简直是为做 Skill 量身定做; 2. 权威——正经出版/业界公认的书,内容经过审校,不像零散博客那样真假掺半; 3. 成体系——它给的是一整套方法论,而不是孤立技巧。
相比之下,从十几篇网文拼出来的 Skill,往往是"知识碎片堆"——观点冲突、深浅不一、还容易漏掉关键环节。
所以选素材的优先级是:权威专业书 > 官方文档 > 体系化长文 > 零散文章。 另外务必提醒:确认你对素材有合法使用权,自己买的、开源的、公开授权的(比如 WSTG)都没问题。当然,做出来的 Skill 也只用于授权范围内的测试、自有靶场或漏洞赏金项目——这是底线。
三、核心打法:三轮蒸馏(网页 → CLI → 合并校验)
这是整套流程的精华。单跑一次,AI 总会漏点东西;跑三轮交叉互补,基本就能榨干一本书。
第一步:网页端先做一遍
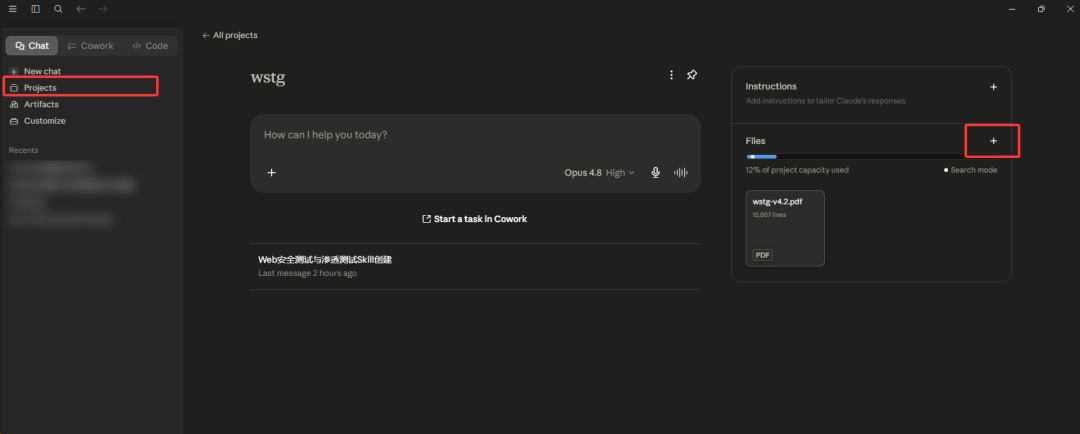
在 Claude 网页端:
1. 新建一个 Project(命名就用书名或主题,比如 WSTG);2. 把整本书同时上传到两处——对话上下文 + Project 的 Files 区。前者保证它能完整读,后者保证它能稳定引用来源; 3. 输入 /skill,选中自动弹出的 skill-creator;4. 发一段明确的提示词。这段话是整个流程的"灵魂"。下面先给你一个各行各业都能套用的通用模板——把方括号里的内容换成你自己的书和领域就行:
这段模板的设计是有讲究的:开头给 AI 一个专家角色,中间交代领域和目标,然后用一整段反复、具体地堵死它"偷懒抓重点"的退路——"读完整本""不要遗漏""覆盖全部而非总结重点""不要省略压缩简化",这些话看着重复,但每一句都在对抗模型跳读的本能。
为了让你看清楚一个填好的真实版本长什么样,这是我做 WSTG 那本书时原封不动用的提示词,可以直接对照仿写:
对比两段你会发现,通用模板和具体提示词的骨架完全一样——换领域,本质上只是换掉"专注于……""涵盖……"这几处填空。骨架不变,是因为"逼 AI 读全、不跳读"这件事,在哪个领域都同等重要。
模型我选择的是 Opus 4.8,并且最后将skills打包成。
那句"读完整本、逐行、不要遗漏"看着啰嗦,但它是整篇里最值钱的一句话——专门用来对抗模型跳读。少了它,你会发现成品总是缺斤短两。
第二步:CLI 端再做一遍
换 Claude Code(命令行)把同样的事再做一次:
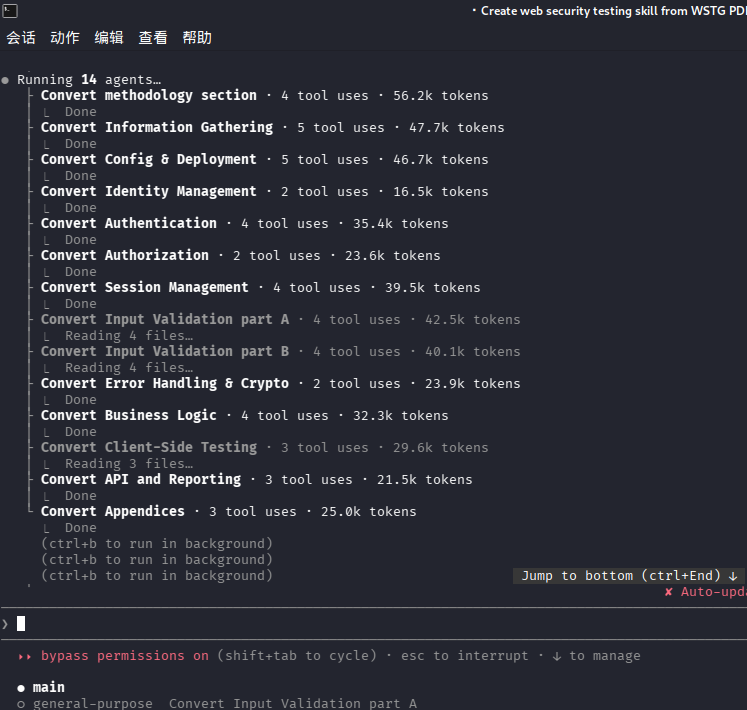
1. 在本地装好 skill-creator(搜 "skill creator skill claude code",从 GitHub 克隆到本地 skills 目录); 2. 在 CLI 里用 /skill-creator;3. 用同一段提示词,指向本地那份 PDF,把成品生成到一个单独文件夹(比如 cli-skill/)。
为什么要两端各做一遍? 因为网页版和 CLI 版的处理方式不同,各自会漏掉不一样的内容。两份放一起,正好互相补漏。
第三步:对比与合并
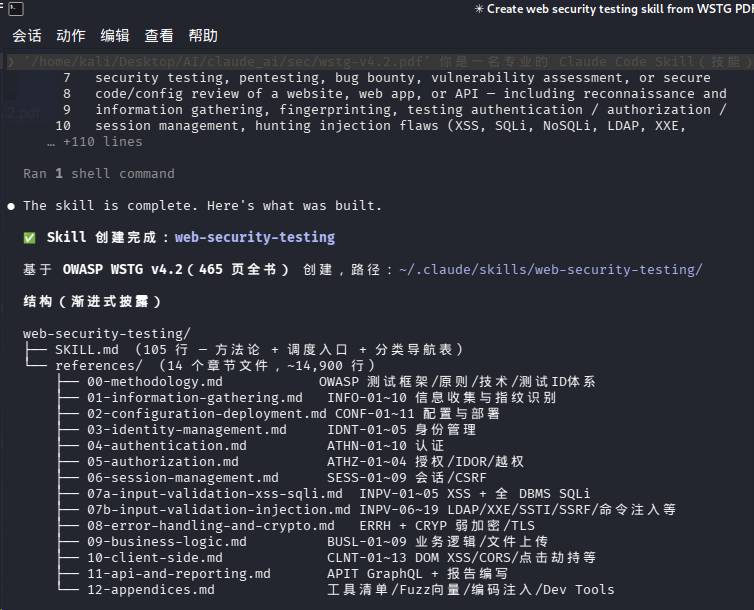
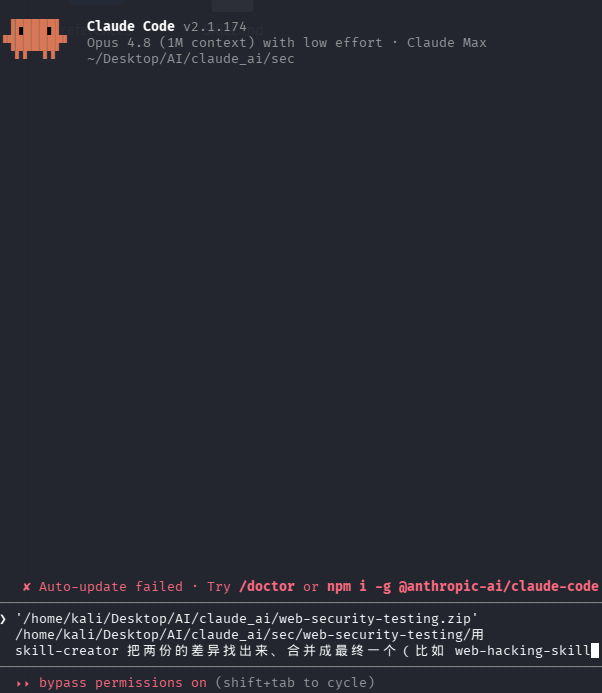
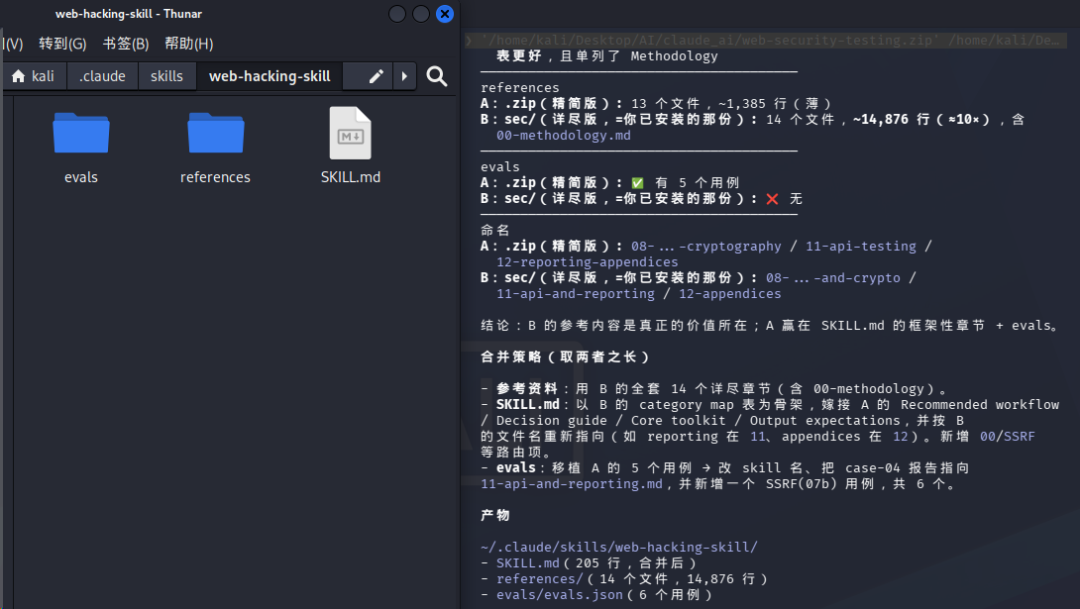
1. 把网页端导出的 .skill文件解压(它本质就是个 zip,必要时可以直接让 Claude 给你.zip);2. 粗略对比两份的目录结构,看分类是否齐全(认证、授权、会话管理、输入校验、加密、业务逻辑、客户端、API、依赖、fuzzing……); 3. 新开一个 Claude Code 会话,让它用 skill-creator 把两份的差异找出来、合并成最终一个(比如 web-hacking-skill),并再次强调"不能遗漏任何内容";4. (强烈建议)再跑一轮,让 Claude 拿成品对照原书查漏。
"网页 → CLI → 再校验"这三轮跑完,通常就能产出一个相当完整的 Skill 了。
第四步:安装与验证
1. 把最终的技能文件夹移动到 ~/.claude/skills/下;2. 重启 Claude Code,确认技能出现在列表里; 3. 加载并查看技能摘要——比如确认它正确归出了多少类别、多少测试项,覆盖范围是否和原书对得上。WSTG 这本,跑完通常能得到 12 个类别、近百个测试项,从被动侦察、主动测绘到扫描、报告,方法论一应俱全。
到这一步,这本指南就正式"住进"了你的 AI 里。
四、做完这一个,你还能这么玩
把"书 → Skill"这条路走通后,你会发现它在安全实战里能延伸出一大片场景。给几个我觉得最值得做的方向:
• 个人漏洞知识库 Skill:把你的笔记 + 历史报告 + 参考资料汇总成一个,让 AI 帮你在新目标上复用旧思路; • 应急响应 SOP Skill:把内部的应急流程、排查清单做成技能,现场让 AI 按标准动作走,不漏步骤; • 取证手册 Skill:把常用工具文档、取证方法论沉淀进去,分析时随时调取; • 源码审计 Skill:针对本地克隆的开源项目做审计,辅助找出可疑点; • 省 token 的"精简版"Skill:去掉虚词、压缩输出(据说能省七成多 token),内容不变——长流程跑起来更划算。
再配合几个趁手的 MCP(Chrome DevTools、Context7 等),整条工作流就能从"查手册"升级成"AI 按手册替你跑"。
五、四条能迁移到任何领域的经验
抛开具体操作,下面几条心法,换什么书、什么领域都成立:
1. 提示词里反复强调"详尽、不遗漏"。 这不是废话,是和模型"想偷懒抓重点"的本能正面对抗。重要的话说三遍,有它的道理。
2. 多版本交叉,弥补单次生成的遗漏。 别迷信"一遍到位"。AI 单次输出一定有盲区,多生成几份再合并,是性价比最高的补救。
3. 素材质量决定技能质量。 权威的书 > 零散文章。垃圾进,垃圾出,AI 不会替你点石成金。
4. 这套流程根本不限于安全。 把 WSTG 换成某科临床指南、某框架官方文档、内部产品方法论……流程一字不改,照样能做出专属 Skill。安全只是它最顺手的起点之一。