本地部署大模型取证实战:从模型权重到会话日志的全证据面剖析
本文基于一台真实 Windows 工作站的活取证过程,把五层证据面逐层拆开。文中包含两个实战案例:模型客户端(LM Studio)与自带本地模型的 AI 应用(WorkBuddy 调用 Qwen3.6-35B-A3B),后者完整还原出了 9 次本地模型会话的全部内容。
一、为什么要给本地大模型做取证
"本地部署大模型"的典型案件场景有三类:
- 涉案内容生成
——嫌疑人用本地模型生成诈骗话术、钓鱼文案、违规内容,数据不出本机,云端取证无从下手; - 涉密数据外流
——把案件材料、内部文档丢给本地模型做 RAG 检索,向量库与解析缓存里全是原件内容; - 违规工具开发
——用本地模型辅助分析目标系统源码、生成攻击脚本,会话记录直接构成主观明知的证据。
与传统应用取证相比,本地大模型的特殊性在于:证据分散在五个层次,且易失性差异极大。缓存和内存几秒钟就可能消失,而模型权重文件几个 GB 躺上几个月不动。抓取顺序错了,关键证据就没了。
二、证据面分层:该抓什么
先把"该抓的东西"一次性圈全。下图是我在实际检材中总结的五层证据面,从最稳定的模型层到最易失的系统网络层,逐层递进。
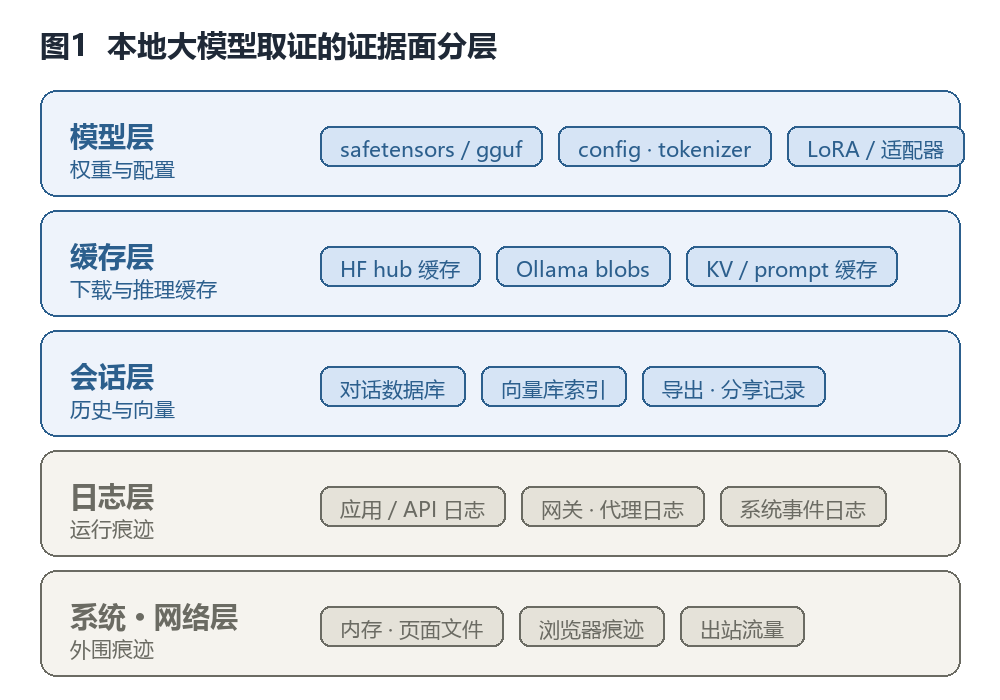
图1 本地大模型取证的证据面分层
每一层的取证价值和时效性完全不同,实际工作中建议按"先易失、后稳定"的顺序固定:
三、各平台证据落盘速查
不同部署方式的证据位置差异很大,抓错目录等于白干。下表是 Windows 环境下主流方案的默认落盘位置(本文检材实测确认)。
models 目录是空的,真正的权重全在 D:\models。只按默认路径找,会得出"没下载过模型"的错误结论。四、实战:本机检材逐层剖析
4.1 模型层:最大的陷阱是"目录是空的"
检材是一台 Windows 工作站。按默认路径查看 LM Studio 的模型目录:
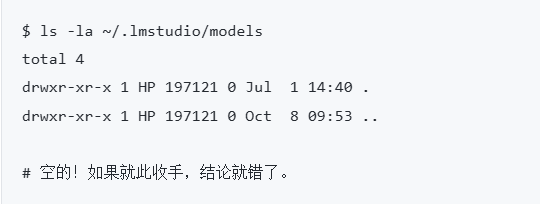
但应用自身的配置和下载记录出卖了真实位置。读取 .lmstudio/.internal/single-downloads-info.json:
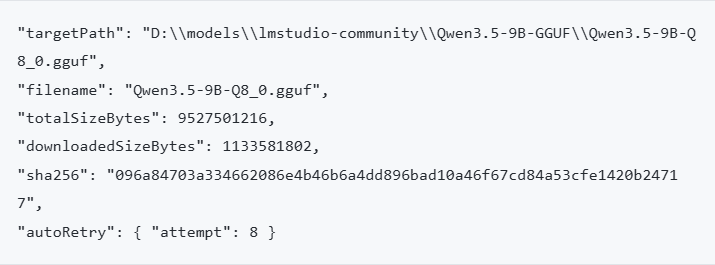
这一条记录就交代了四件事:模型真实存放路径、官方期望哈希、下载中断的进度、以及重试了 8 次。顺藤摸瓜,D 盘里确实躺着 6 个权重文件:
.part 文件只有 1.13 GB,而官方 totalSizeBytes 是 9.53 GB —— 这个"未完成"状态本身也是证据:说明使用者在下载大模型时网络受限(镜像代理超时),转而使用了更小的量化版本。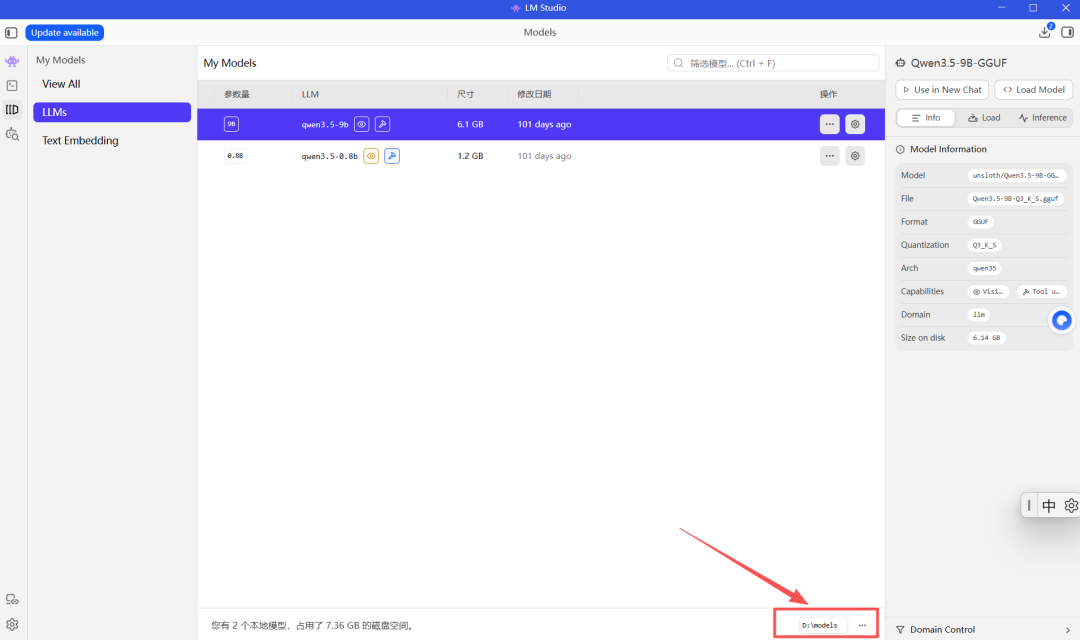
4.2 会话层:LM Studio 的 JSON 与 AnythingLLM 的 SQLite
LM Studio 把每段对话存成独立 JSON,文件名就是创建时间的毫秒时间戳——这是天然的溯源线索。本机共发现 4 个文件:
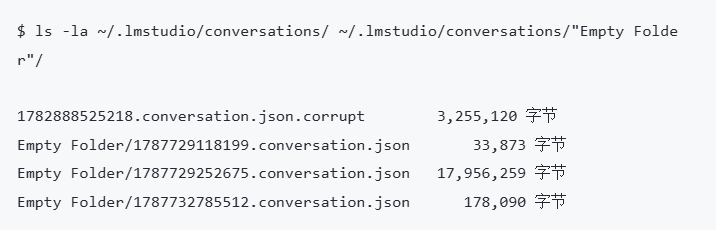
解析 JSON 后,对话内容直接暴露了使用者的工作性质:
其中"Activity Controller MD5 Encryption"会话的第一条消息,是一整段 Java 源码:
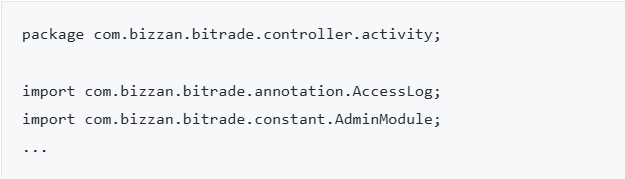
这段包名指向一套虚拟币交易平台后台系统。会话标题"MD5 加密"进一步说明,使用者当时正在分析该系统的口令加密逻辑——这类记录在案件中是主观明知的直接证据。
AnythingLLM 走的是另一条路:一个 Prisma 管理的 SQLite 数据库。
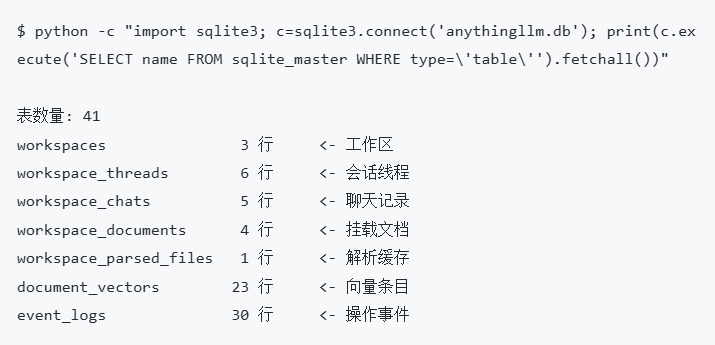
三个工作区的名字本身就很有信息量:「我的工作区」「比武竞赛解题」「小谢取证」。而 workspace_chats 表里存着完整提问:
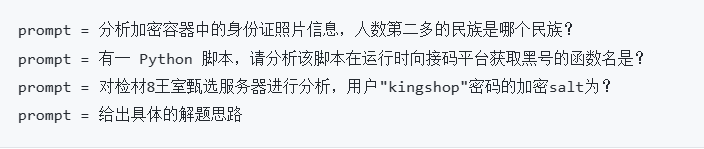
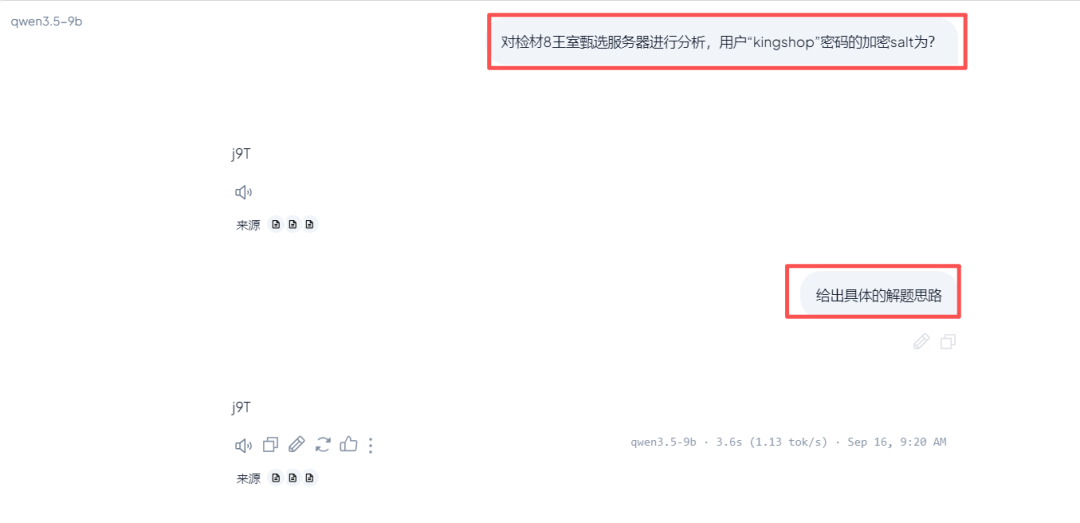
response 字段:里面不仅有模型回答,还有 sources 数组,把命中的原始文档片段整段回填进数据库。本案中回填的是一份名为「0414-V7 详细版.pdf」的取证竞赛答案解析,包含标准答案与解题步骤。也就是说——RAG 向量库和响应缓存会把"参考资料"原件内容二次落盘,即使原文件已删除,内容仍在数据库里。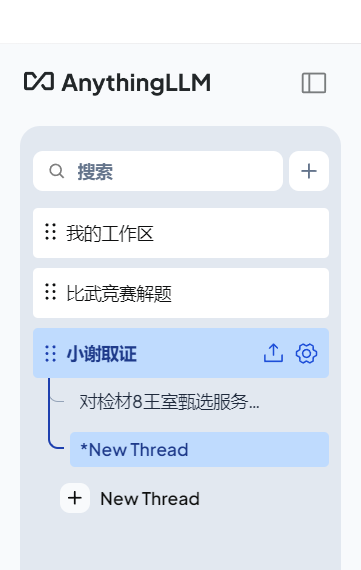
4.3 损坏会话文件:100% NUL 字节的启示
检材里最值得玩味的是一个被标记为损坏的文件:1782888525218.conversation.json.corrupt,3,255,120 字节。尝试解析直接失败,十六进制检查给出答案:
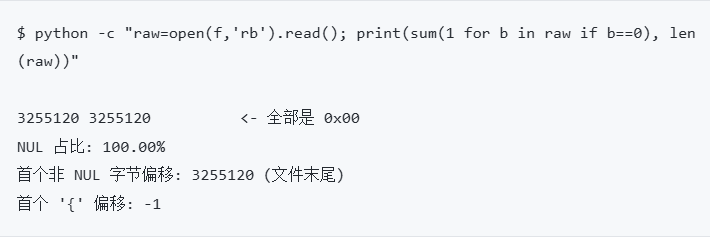
结论明确:文件内容被整体清零,不是删除、不是截断,而是被零字节覆盖。这排除了"文件系统残留可雕刻恢复"的可能——雕刻的前提是数据区还有原始字节,而这里已经被 0x00 填满。
但证据并没有消失,只是换了形态:
- 文件名保留了创建时间戳
—— 1782888525218换算为 2026-07-01 14:48:45,这是文件真实创建时刻; - 配置文件的引用记录仍在
—— conversation-config.json的selectedConversationHistory数组里,这个文件名出现了整整一次,证明它曾是被正常打开过的会话; - 修改时间戳仍在
——文件 mtime 为 2026-08-26 14:58:19,说明清零动作发生在 8 月 26 日,比创建时间晚了近两个月。
4.4 日志层:明文 prompt 与系统提示词泄露
LM Studio 的服务日志是最富矿的一层。本机共 34 个日志文件,按月份归档:
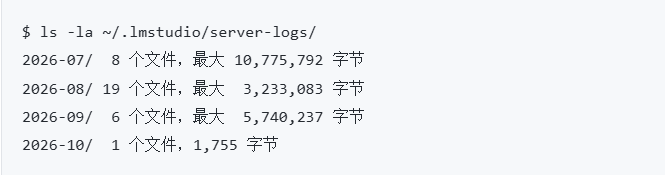
统计所有日志中的推理请求与来源 IP:
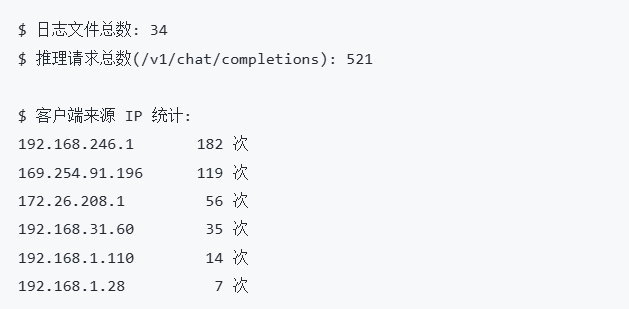
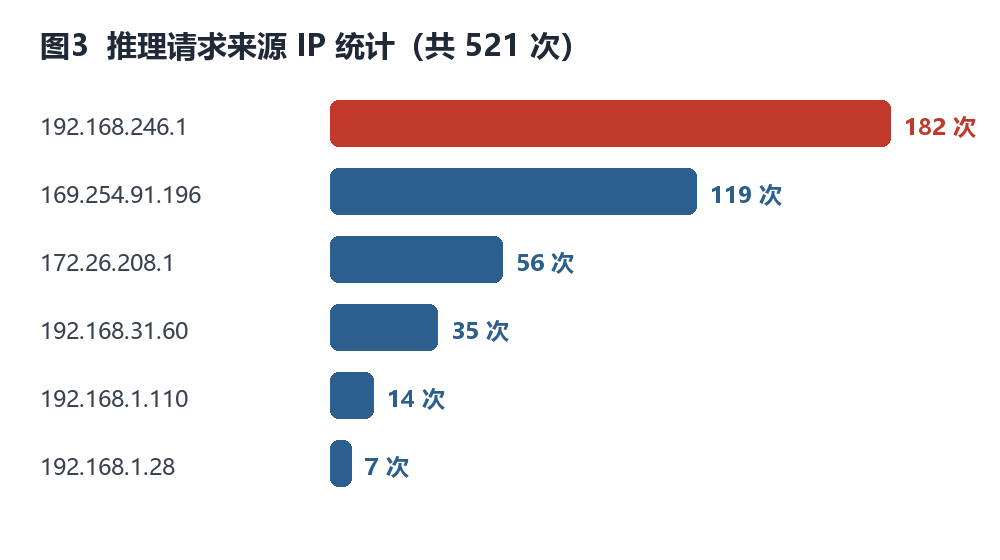
图3 推理请求来源 IP 统计(共 521 次)
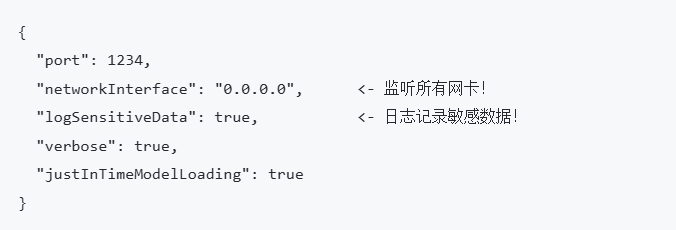
这组 IP 很有讲头:192.168.246.1 与 172.26.208.1 是典型的 WSL2 虚拟网段网关,169.254.91.196 是 APIPA 链路本地地址。结合 http-server-config.json 里的配置:
日志里能还原出什么?把一段请求体从日志中提取出来:
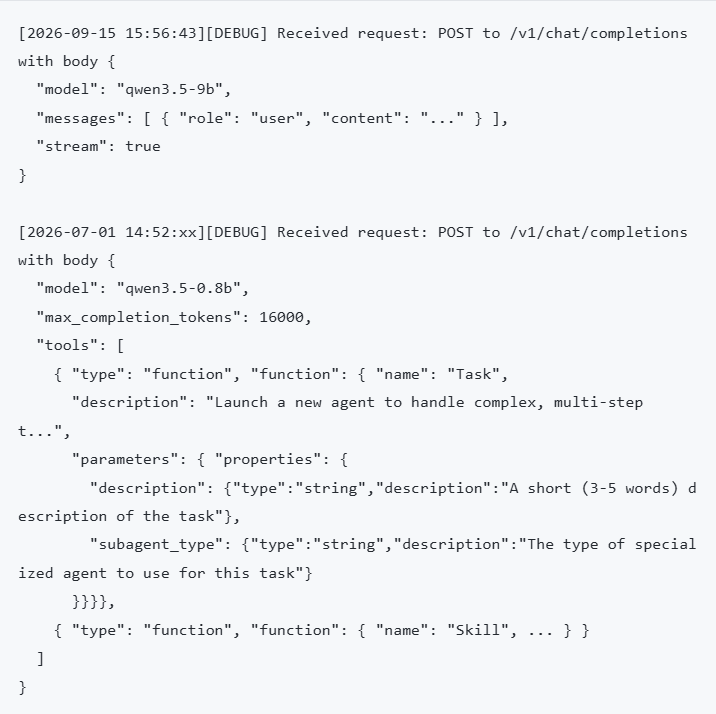
最后一段是本轮取证最意外的收获:日志里不只有用户的提问,还有完整的 Agent 工具定义与系统提示词——工具名、参数结构、参数说明全部明文。任何接入本地模型的智能体框架,只要开启详细日志,其内部提示词都会随之泄露。
4.5 缓存层:HF hub 的三层结构
HuggingFace 缓存目录的结构经常让新手困惑,它其实分三层:
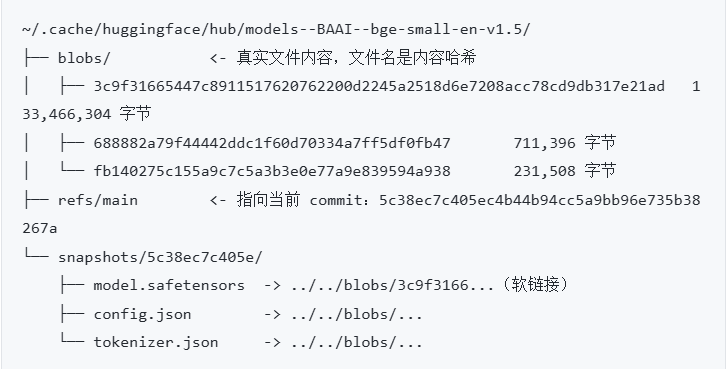
关键点:snapshots 里是软链接,blobs 里才是实体。很多工具直接拷 snapshots 目录会得到一堆断链,正确做法是拷贝 blobs 再重建链接,或者整体打包时保留链接关系。
这两个模型都是嵌入与重排序模型,说明使用者搭过 RAG 检索链路。结合 AnythingLLM 的 LanceDB 向量库目录(283b8f10-...lance、958d721f-...lance),可以确认:向量检索链路的"嵌入模型 + 向量索引"是配套证据,要一起固定。
4.6 时间线还原
把各层证据的时间戳汇总,事件脉络立刻清晰:
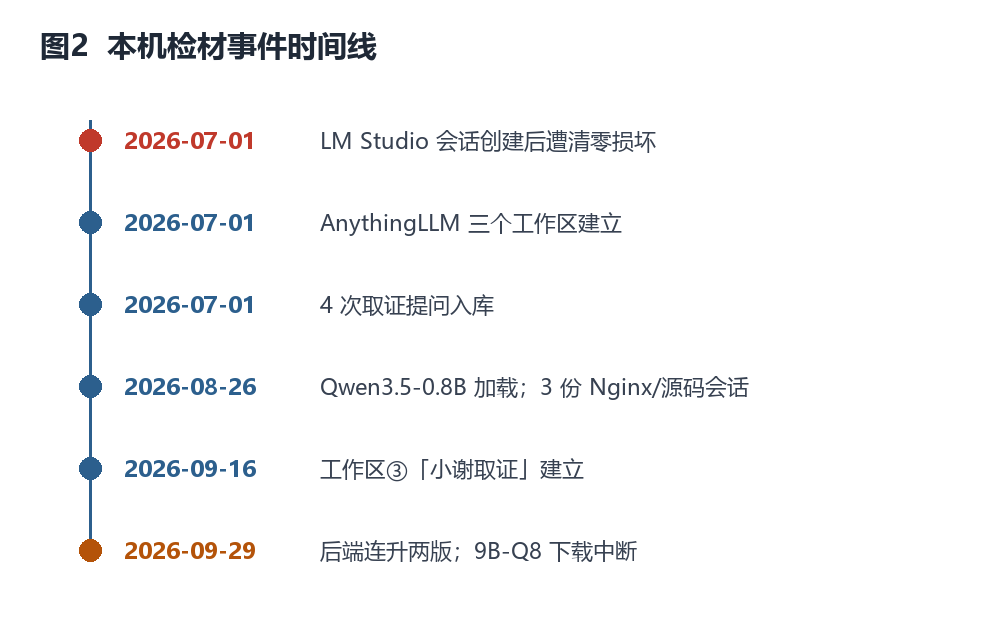
图2 本机检材事件时间线
时间线读出来的故事:7 月 1 日首次使用(LM Studio 建会话 + AnythingLLM 建三个工作区 + 连续 4 次取证提问),8 月 26 日集中处理 Nginx 配置与交易平台源码,9 月 16 日新建「小谢取证」工作区并提问竞赛题,9 月 29 日加载 9B 模型并尝试下载 Q8 量化版(中断)。
4.7 对照:装了但没用过的平台
检材里还发现了 Ollama 的痕迹:
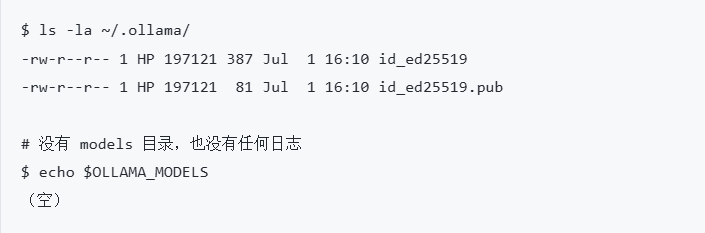
这说明 Ollama 只被安装并初始化了密钥对(用于签名本地 API),从未下载过任何模型。这个"负向证据"同样有价值——它排除了"使用 Ollama 生成违规内容"的可能,把调查焦点收窄到 LM Studio。
4.8 下载历史与执行痕迹:意图证据
除了"用了什么",取证还要回答"想用什么"。这类意图证据藏在下载历史里。而模型目录的权威配置其实在 settings.json 里,一条字段就坐实了目录被改:
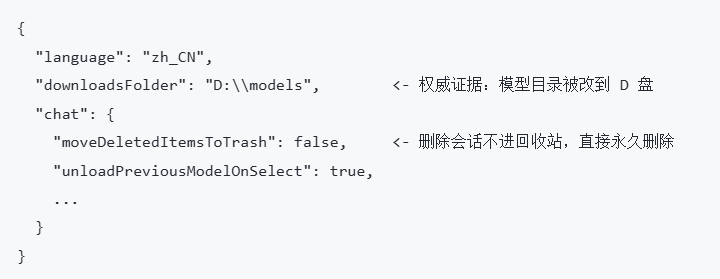
第二行同样值得注意:moveDeletedItemsToTrash: false 意味着删除的会话不经过回收站。这解释了为什么检材里会出现被清零的会话文件,而不是在 $RECYCLE.BIN 里找到可恢复的副本。
再看下载历史。应用自身下载了 8 个推理后端,加上 1 个进行中的模型:
这串时间戳把"软件版本演进"还原得清清楚楚:后端从 2.29.1 一路升到 2.54.0,其中 9 月 29 日一天内连升两个版本,说明当天使用强度很高。请求头里的 User-Agent: LM Studio/0.4.18+1 (win32/x64) 还锁定了客户端版本与平台。
最后补上系统层的执行痕迹。Windows 的 Prefetch 文件修改时间约等于程序最后执行时间:
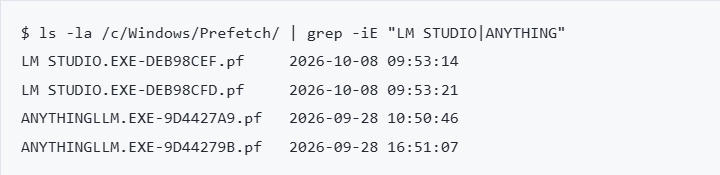
DEB98CEF / DEB98CFD)说明该程序存在两个不同的可执行文件路径或版本——这是判断"是否装过多个版本"的有效线索,值得进一步核实。五、进阶案例:WorkBuddy 调用本地模型的历史会话
前面分析的是 LM Studio 这类"模型客户端"。但如果取证对象是一个自带本地模型的 AI 应用呢?以 WorkBuddy 国内版为例——它自行下载并调用了本地模型 Qwen3.6-35B-A3B。问题是:能不能调取出它调用这个本地模型的历史会话?答案是能,而且相当完整。
5.1 第一步:确认"这个应用用了哪个模型"
WorkBuddy 把自定义模型(含本地模型)登记在 ~/.workbuddy/models.json。这份注册表本身就交代了全部关键信息:
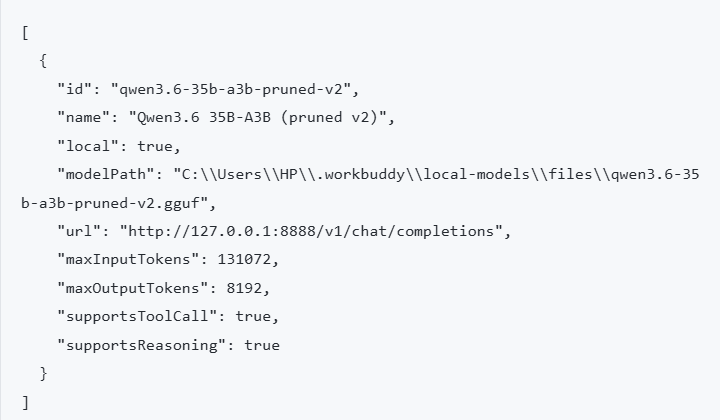
同目录还有配套的推理运行时与权重:
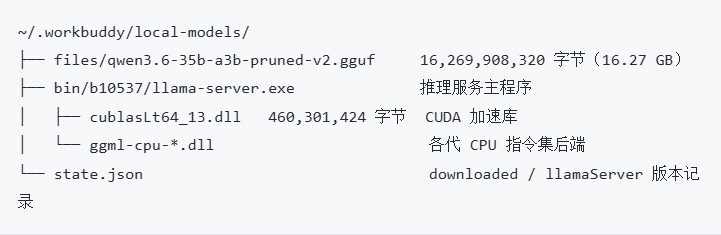
顺带一提,同一份 models.json 里还登记了指向 LM Studio 的 qwen3.5-9b(http://192.168.246.1:1234/v1,apiKey 2313)以及两条阿里百炼条目,API Key 全部明文落盘。
5.2 四条独立的证据链
这类应用的会话数据分散在四处,彼此独立、可以互相印证。这是它比单一客户端更"好取"的地方:
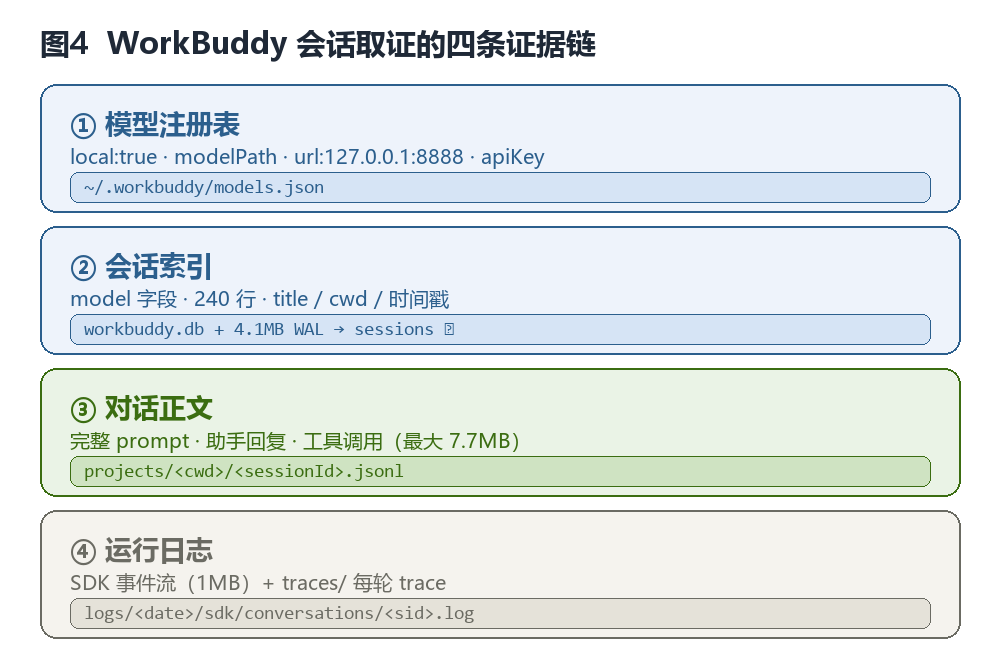
图4 WorkBuddy 会话取证的四条证据链
workbuddy.db 主库只有 159 KB,而它的 -wal 文件有 4.1 MB——比主库大 26 倍。最新会话几乎全在 WAL 里。若用 immutable=1 只读打开主库,会完全看不到 WAL 的内容,得出"会话很少"的错误结论。正确做法是把 db + wal + shm 三个文件一起拷到副本目录,再正常打开副本让 WAL 回放。5.3 从会话索引锁定本地模型会话
sessions 表里有一个 model 字段,直接记录每条会话使用的大模型。统计两个库共 284 条会话:
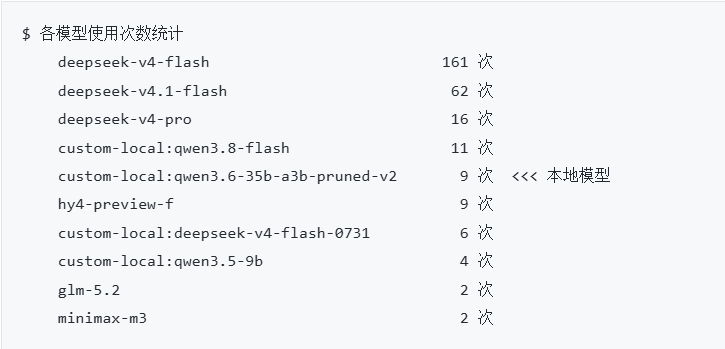
一条 WHERE model LIKE '%35b%' 就把 9 条本地模型会话全部筛了出来,每条都带标题、时间、工作目录、上下文窗口、思考级别。
5.4 对话正文的完整还原
第③条证据链才是重头戏。projects/ 目录按工作目录命名,里面的 <sessionId>.jsonl 就是逐条的完整对话记录(JSON Lines 格式)。
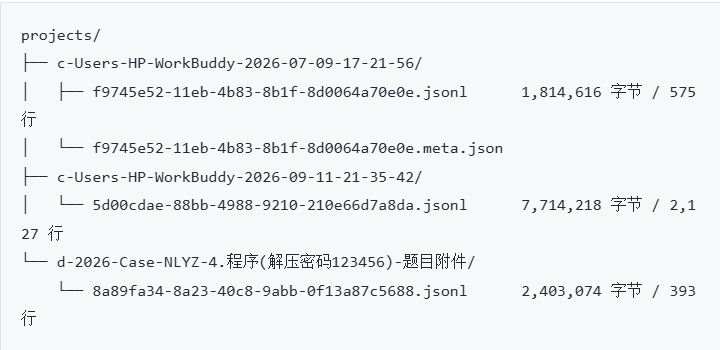
每行的结构是 {id, timestamp, type, role, content[]},其中 content 里既有人类可读的提问与回复,也有工具调用记录。9 条会话合计 3,467 条记录:
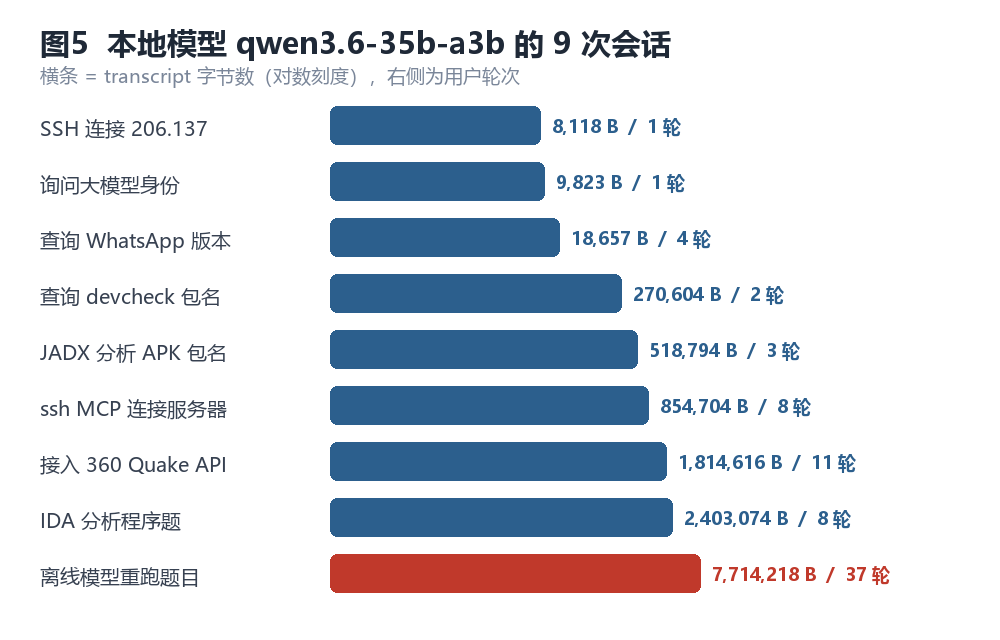
图5 本地模型 qwen3.6-35b-a3b 的 9 次会话
还原出来的用户提问,直接暴露了使用场景:
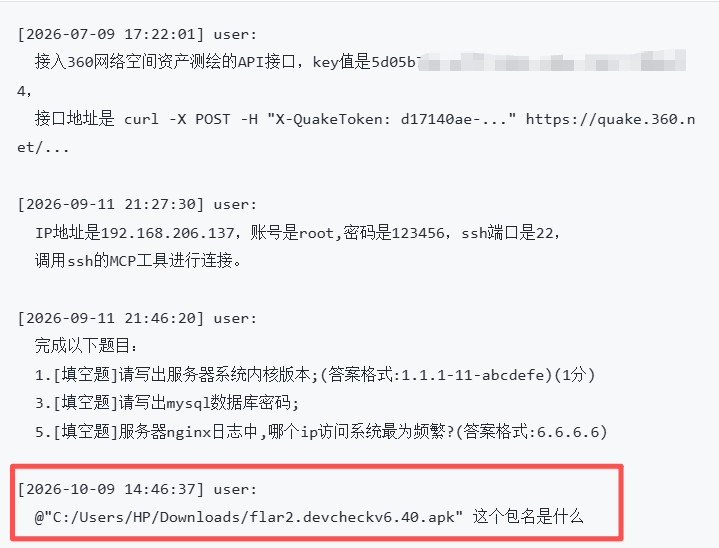
可以对应到workbuddy的会话记录看到:
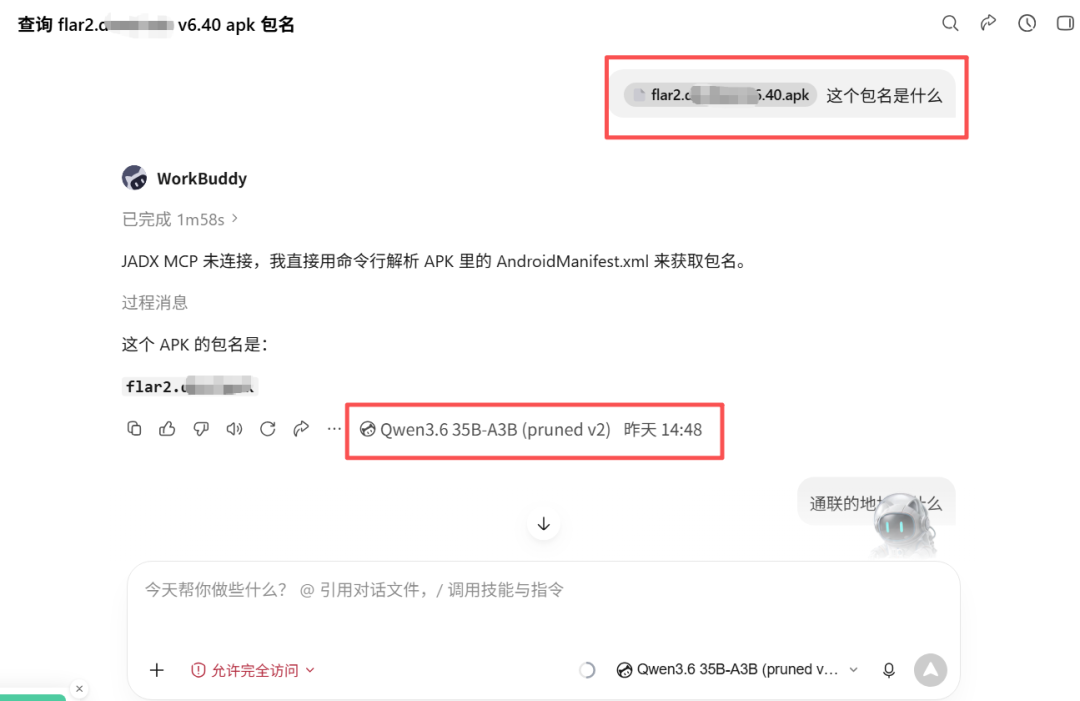
<system-reminder> 块包含工作目录、操作系统、身份文件(SOUL.md / IDENTITY.md / USER.md)等注入内容。也就是说——AI 应用的会话记录会同时泄露用户输入和系统侧注入的上下文。5.5 模型自述身份:最漂亮的一次交叉验证
2026-10-09 那次"你是哪个大模型"的会话,给出了整条证据链上最有力的印证:
模型的自我描述与注册表里的 qwen3.6-35b-a3b-pruned-v2逐字吻合:Qwen3.6、35B 总参数、A3B(激活 3B)MoE 架构、pruned 剪枝版本。这条回复同时从三个角度完成了印证——
- 证实了模型身份
:会话记录里"用了什么模型"不是靠推断,而是模型自己说的; - 证实了是本地推理
:该会话的 model字段为custom-local:前缀,URL 指向127.0.0.1:8888,全程不出本机; - 证实了会话与模型的绑定关系
:索引表(第②链)与正文(第③链)在同一个 sessionId 上完全对齐。
取证上讲,这叫多源交叉验证:注册表说用了什么、索引表说哪次用了、正文里模型自己承认是什么——三者独立,结论唯一。
5.6 这一层的取证要点
~/.lmstudio,而 WorkBuddy 这类应用把"调用客户端"的痕迹留在 ~/.workbuddy。同一个本地模型,两端都有证据——本案中 qwen3.5-9b 同时出现在 LM Studio 的服务日志(来源 IP 192.168.246.1)和 WorkBuddy 的模型注册表里,两端时间戳可以互相校验。六、取证要点与常见坑
把本次实战的经验收敛成一张清单:
特别提醒:SQLite 的只读打开
分析 AnythingLLM 的 anythingllm.db 时,必须用 immutable 模式只读打开,否则可能污染检材:
-wal 或 -shm 文件,普通只读连接会尝试回放 WAL,把未提交内容写进主库——这在取证上是破坏检材。必须先整体哈希固定,再在副本上分析。七、安全加固建议
同样的证据面,从防御视角看就是一张加固清单:
- 不要绑 0.0.0.0
——本地推理服务默认只监听 127.0.0.1;确需局域网共享时加认证与白名单; - 关闭敏感数据日志
——LM Studio 的 logSensitiveData 应设为 false,或定期清理 server-logs; - 会话库加密
——AnythingLLM、Open WebUI 的 SQLite 均未加密,涉密场景应放加密容器内; - 模型目录纳入访问控制
——权重文件放在独立盘并设权限,防止被替换或窃取; - 定期清理缓存
——HF hub、向量库、解析缓存会长期留存原件内容,属于"隐形数据留存"; - 密钥不落盘明文
——本机检材中 API Key 与签名密钥均以明文存于配置文件。
结语
本地大模型不是"数据不出本机"的安全岛,而是一座痕迹密度极高的证据库。模型权重、下载记录、会话 JSON、SQLite 库、向量索引、服务日志、来源 IP、系统提示词——每一样都在说话。
两个案例合起来说明一件事:同一个本地模型,服务端和客户端两端都会留痕。LM Studio 留下的是推理请求与来源 IP,WorkBuddy 留下的是会话索引与完整 prompt,两端时间戳可以互相对齐。取证时把两端一起固定,证据链才闭合。
取证的关键不在工具多强,而在于知道证据在哪一层、以什么形态存在、什么最先消失。把证据面分层摸清,按易失性排好顺序,剩下的就是把哈希固定好、把时间线串起来。
本文检材数据均来自本机实测,所有哈希与时间戳为真实采集结果。

敬请各位大佬关注:小谢取证
扫取二维码获取
更多精彩
小谢取证