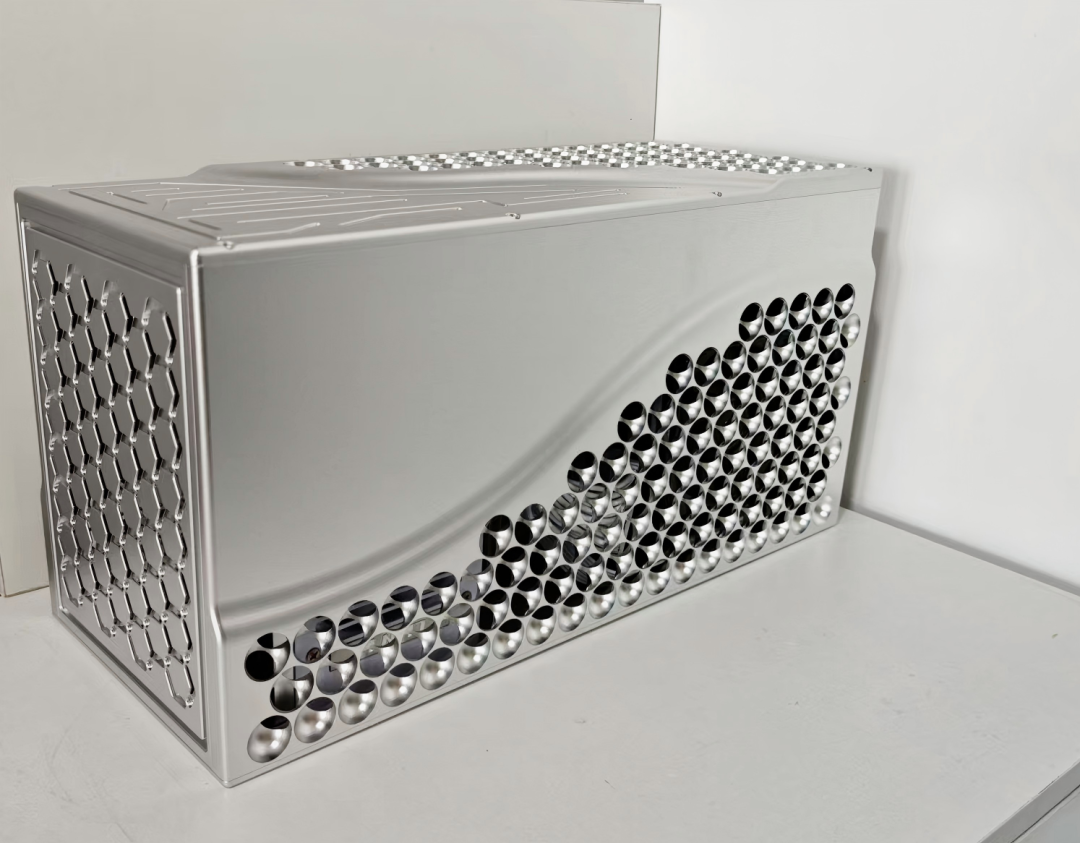
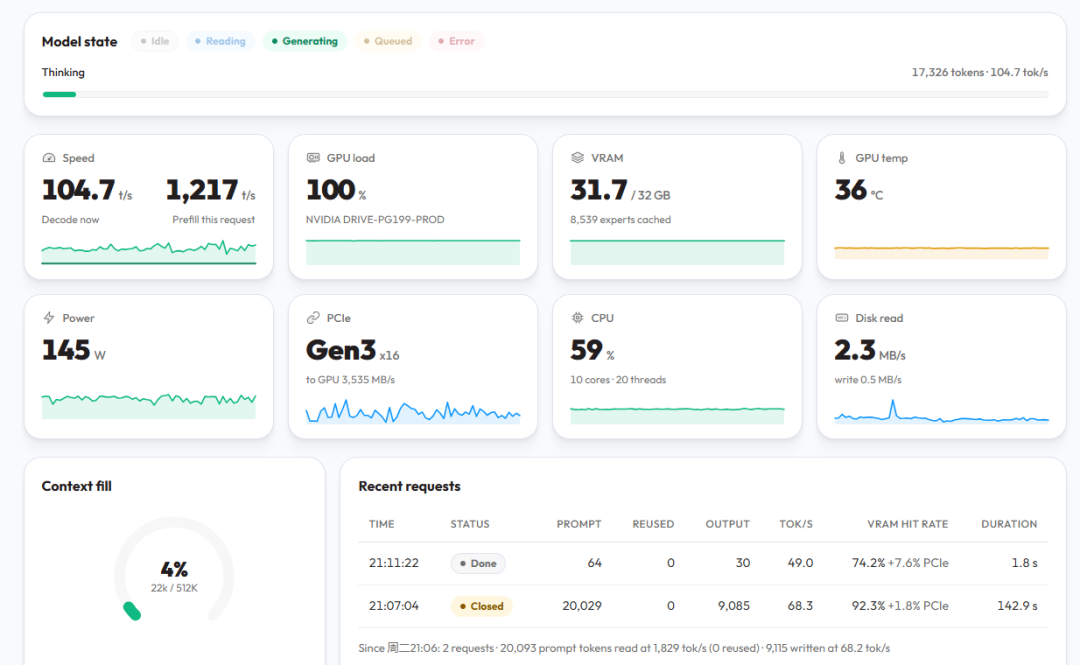
阮咸AI助手-搭配高性能AI小型塔机,适配125B本地大模型,全面超越Qwen3.8-27B 作者:河北阮咸科技有限公司 发布:2026-10-06 21:32 收录:2026-10-08 11:49 4 次阅读 约 117 字 摘要:阮咸科技的阮咸AI助手软件搭配定制生产的AI标准塔,实现Qwen3.8-flash-next-125B大模型离线本地流畅运行,输出速度最高能达到100-150tokens/秒,可实现512K上下文, 无论是智能化程度还是速度,均远远强于Qwen3.8-27b(性能实现仅限标准塔机,阮咸AI助手V1.0.9版本更新),实… 推荐理由:本文涵盖「阮咸AI助手」、「本地大模型」、「Qwen3.8-27b」等多个主题,重点关注 阮咸AI助手。 阮咸科技的阮咸AI助手软件搭配定制生产的AI标准塔,实现Qwen3.8-flash-next-125B大模型离线本地流畅运行,输出速度最高能达到100-150tokens/秒,可实现512K上下文, 无论是智能化程度还是速度,均远远强于Qwen3.8-27b(性能实现仅限标准塔机,阮咸AI助手V1.0.9版本更新),实测接近于DeepSeek-flash V4.1。关注阮咸科技 转载声明:本文转载自原发布平台 (作者:河北阮咸科技有限公司), 原文标题《阮咸AI助手-搭配高性能AI小型塔机,适配125B本地大模型,全面超越Qwen3.8-27B》, 查看原文。 版权归原作者及原发布平台所有,本站仅作收录与展示,未对正文内容作实质性修改; 若涉及侵权请联系本站处理。 ← 微软和 Meta 正在大幅减少内部的 Token 用量, Mistral Large 4 发布:1T 参数、49B →