比赛现场断网、案卷数据不能上云——你的笔记本就是全部算力。因此,核心问题从来都不是“是否需要本地部署”,而是在现有的硬件条件下“本地部署应当如何选型”。
断网环境下的 AI 取证
推理是赛事高频场景:流量分析问答、日志审计、代码逆向理解。优先看正确率,其次看耗时。
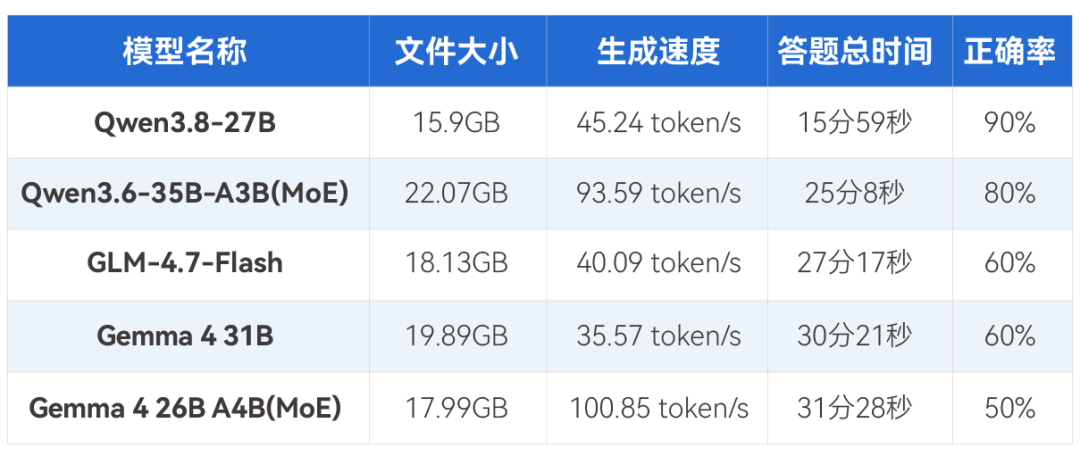
测试环境:ROG 枪神 5090 笔记本(24GB 显存 + 64GB 内存),10 道真实流量分析题,全部采用 Q4_K_M 量化。
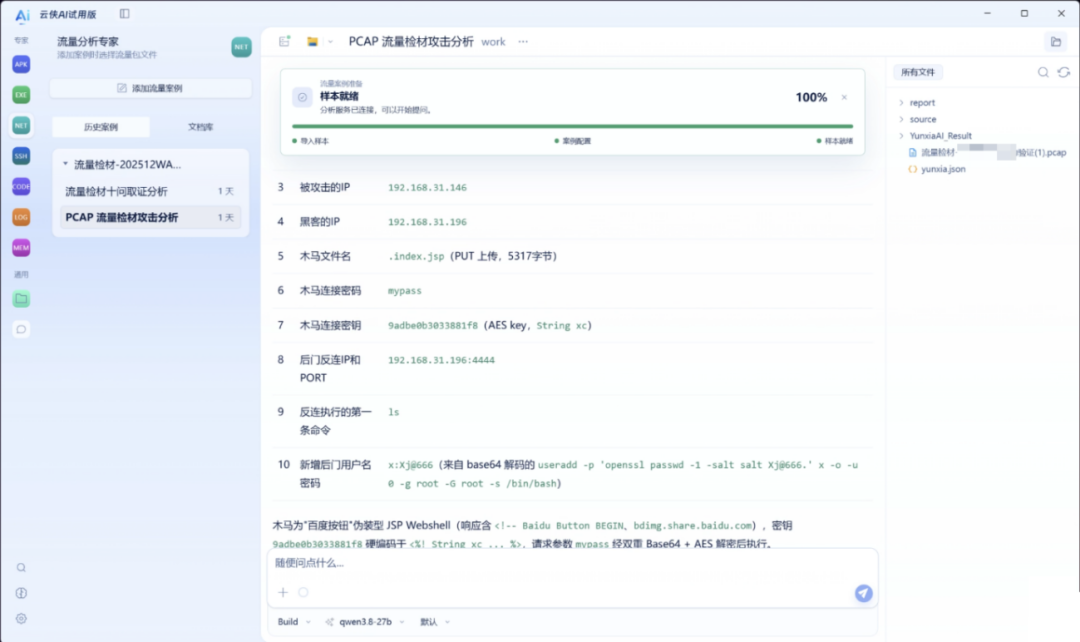
实测答题:PCAP 流量检材攻击分析
核心结论:Qwen3.8-27B综合最优。正确率 90%(答对9/10 题)全场最高,答题耗时15分59秒全场最短;模型体积最小,加载更快。
赛事比拼,看的是完整答对全部题目的总耗时,不是单纯的出字速度。选型千万别被 token/s 这个单一指标带偏。
取证素材不只有图片、视频、音频,要分模块逐个处理。
你要让模型看懂的不只是“图里有什么”,而是手机截图里的聊天记录、文档照片上的印刷文字、监控截图里的场景信息。三个梯队:
MiniCPM-V 4.6:仅 1.3B 参数,6GB 内存就能 CPU 跑,不占显存,零成本的图像替补,可与主力共存。
Qwen3-VL-2B/4B:2B 版 INT4 量化后显存约 1.2GB,同样能共存;4B 版精度更高,最低约 2.5GB 显存。
GLM-OCR:0.9B 参数,任务明确是纯文字提取(不需要理解图片内容)时用它,官方标称约 4GB 显存,亦可 CPU 推理,比通用 VLM 更专注。
别直接把视频丢给视频理解大模型。取证要抓的是细节——角落里的文字、一闪而过的画面,通用视频模型容易漏,硬件消耗还巨大。实战走三段式:
抽帧:FFmpeg 按固定时间间隔提取关键画面。
图像分析:关键帧送 VLM 做场景识别和 OCR。
音频转写:抽出视频音频流送 ASR。
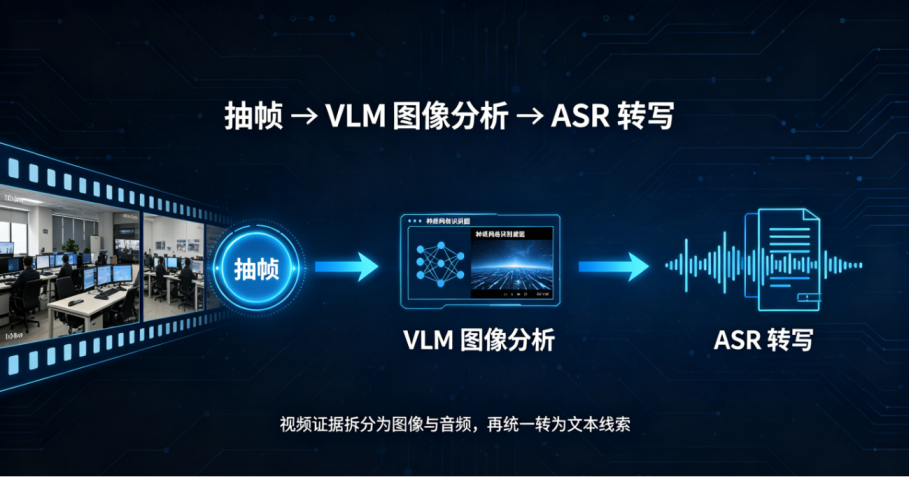
视频证据拆分为图像与音频,再统一转为文本线索
音频必须先转成文字才能进一步分析,目前最稳妥的是本地部署ASR模型:
faster-whisper:CPU 模式不占显存,可与主力共存,适合批量转写。
GLM-ASR-Nano-2512:中文(含方言)识别精度优于 Whisper,中文音频首选。
Qwen3-ASR-1.7B:Q4_K_M 约 4GB 显存,速度快,支持 vLLM 加速。
核心结论:流水线拆分方案综合最优。本地多模态取证无需硬上重型视频大模型,专用小模型更省显存。优先采用“抽帧 +VLM+ASR”流水线:图像按需用轻量VLM、专用OCR 节省显存,视频拆分处理保细节、控硬件压力,音频适配本地ASR模型,兼顾精度、开销与实战稳定性。模型选好了、多模态方案也明确了,接下来就得看看自己的硬件能不能跑得动。
1. 笔记本
搭载 5090 高性能笔记本(24GB 显存 + 64GB 内存):机身便携,24GB 显存可流畅运行 Qwen3.8-27B,实测流量类题目正确率 90%。推荐型号:联想拯救者 Y9000P 2026 至尊版、ROG 枪神系列、外星人 Area-51 系列。
2. 统一内存方案
NVIDIA DGX Spark:128GB 统一内存,单机可跑 200B 参数模型推理,FP4 稀疏算力最高 1000 AI TOPS。
Mac Studio(Ultra 系列):M5 Ultra 版标配 96GB 统一内存,M5 Max 版标配 36GB。统一内存架构能跑更大模型,但部分模型的 GGUF 版本在 Apple Silicon 上的兼容性要提前验证。
AMD 锐龙 AI Max+ 395:最高 128GB LPDDR5x 统一内存,最多可分配 96GB 当显存,能流畅跑 70B 以上模型,AI 性能可达 RTX 4090 的 2.2 倍。
Step 1 选框架。框架选择直接决定部署效率和调优空间,四款主流工具各有定位:
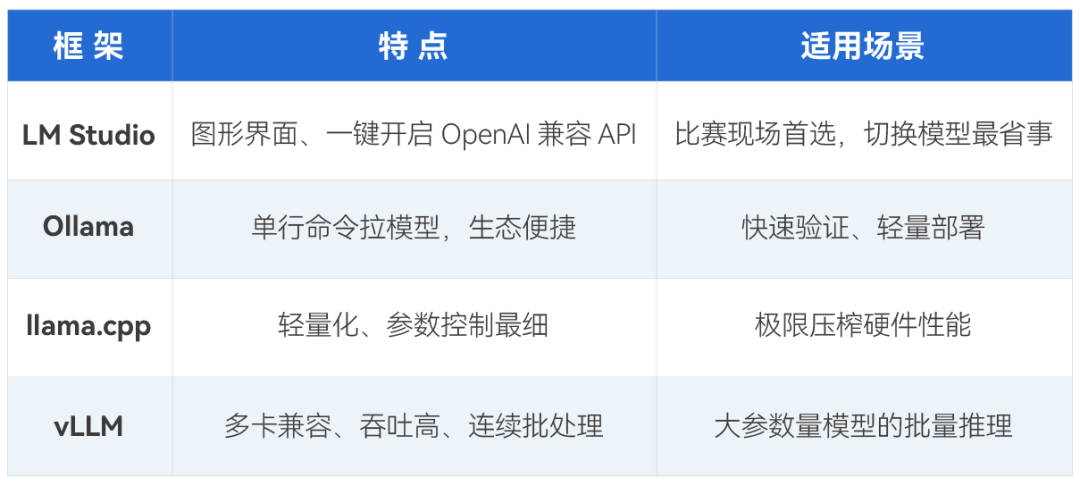
比赛现场首选 LM Studio:上手门槛低,图形界面完成全流程,且自带 OpenAI 兼容 API,可直接连接云侠AI 使用。有一定运维经验后,可用 llama.cpp 替换,换取更精细的控制权;多卡服务器环境则直接上 vLLM。
Step 2 下模型。下载前先分清框架对应的权重格式:
1. LM Studio / llama.cpp(GGUF 格式)
LM Studio 内置搜索直接下载,认准 Q4_K_M 量化后缀
魔搭社区 ModelScope:国内访问快、模型资源全
Hugging Face:国际仓库,需手动定位对应 GGUF 文件
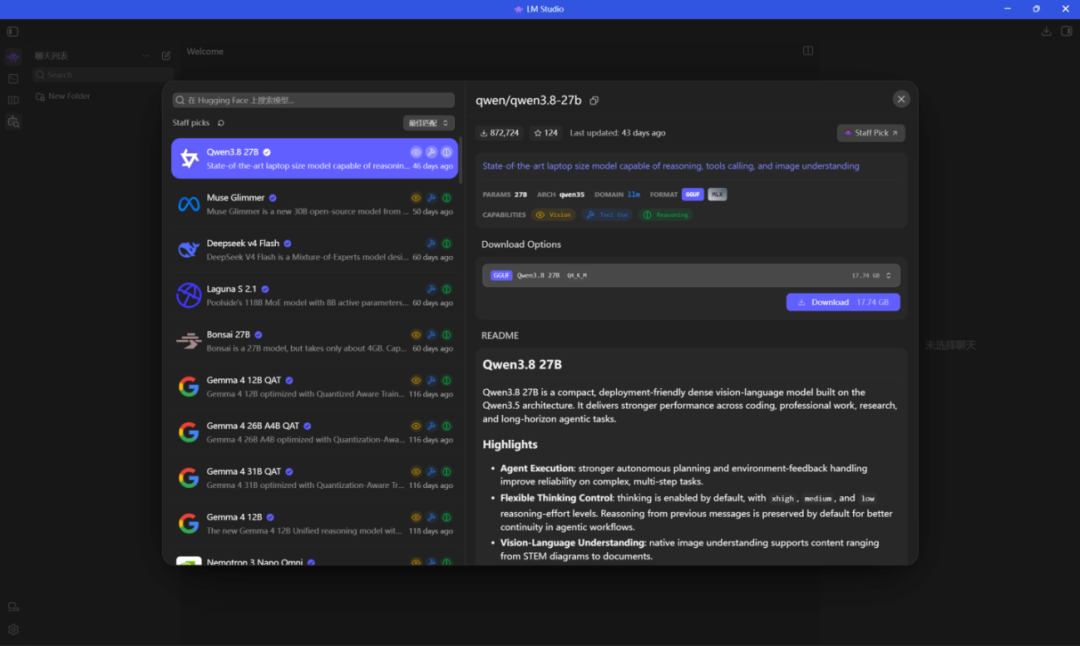
LM Studio 内置模型搜索,认准 GGUF 与 Q4_K_M 后缀
2. Ollama(自有仓库 / Modelfile 导入)
优先 ollama pull 模型名,从官方仓库直接拉取
拿到 GGUF 文件的,需编写 Modelfile 导入后才能使用
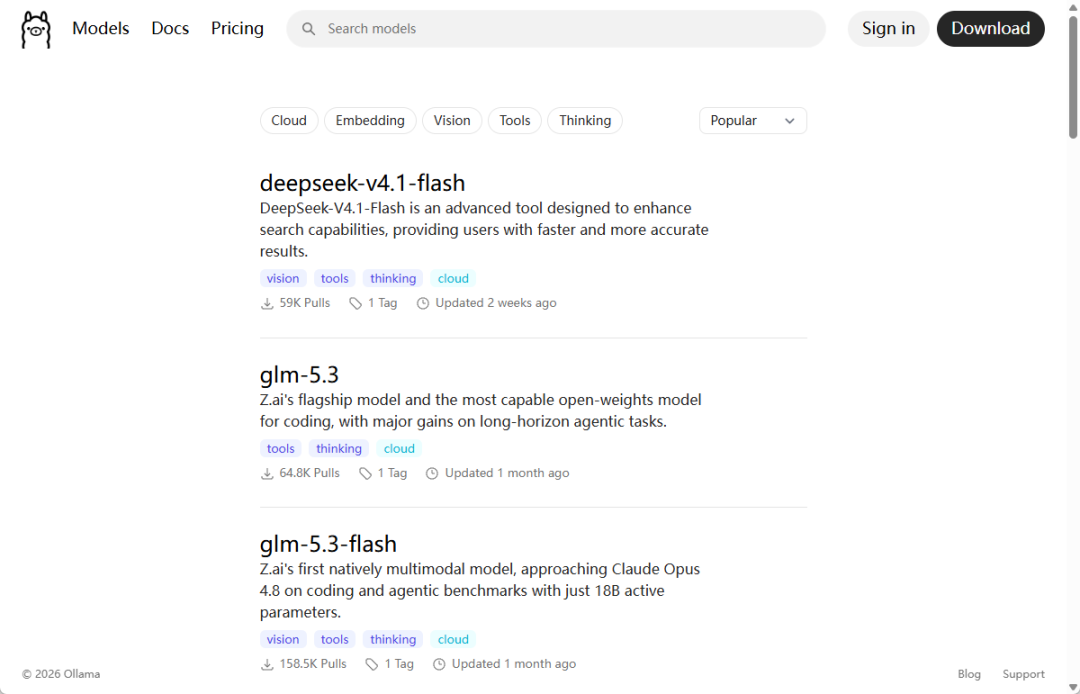
Ollama 官方仓库,ollama pull 一键拉取
3. vLLM(safetensors 格式,不支持 GGUF)
仅从 Hugging Face 下载原生 safetensors 权重
量化版本认准 AWQ、FP8 等标识
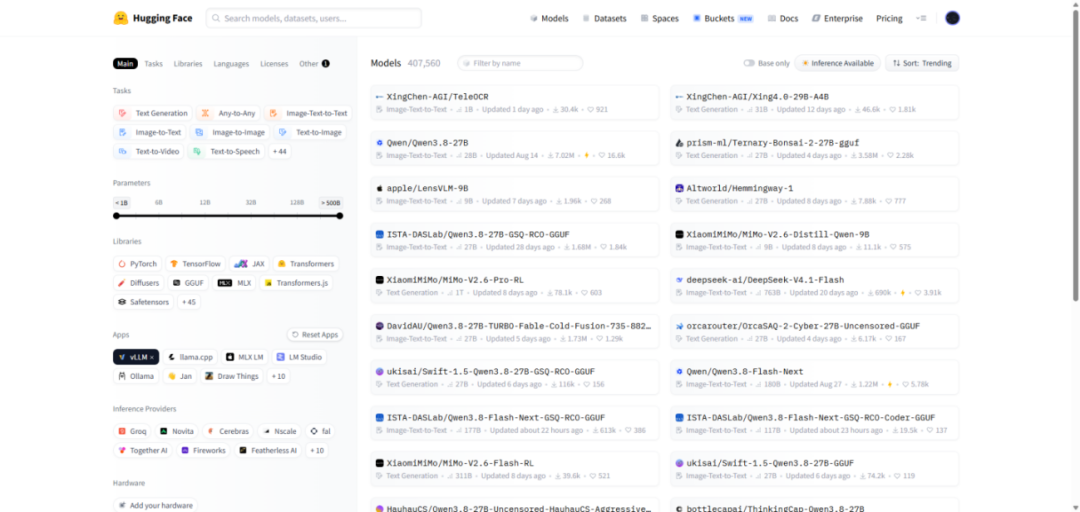
Hugging Face 模型仓库,vLLM 需下载 safetensors 权重
下载前通用检查:核对文件名中的参数与量化标识(如 Qwen3.8-27B-Q4_K_M),避免拉错版本; 预留 2 倍于模型文件大小的磁盘空间,以备多模型共存切换
Step 3 加载起服务。LM Studio 主界面切至模型加载页,选中已下载模型点击 Load,加载完成即生成本地 API 服务。关键确认三点:一是 API 端口未被其他程序占用(默认 1234);二是显存充足时勾选 Keep Model in Memory,让模型常驻内存、避免频繁重载,小显存机器再改用 Just-in-Time 按需加载;三是用 curl 访问 /v1/models 接口验证服务已就绪,再接入取证平台。
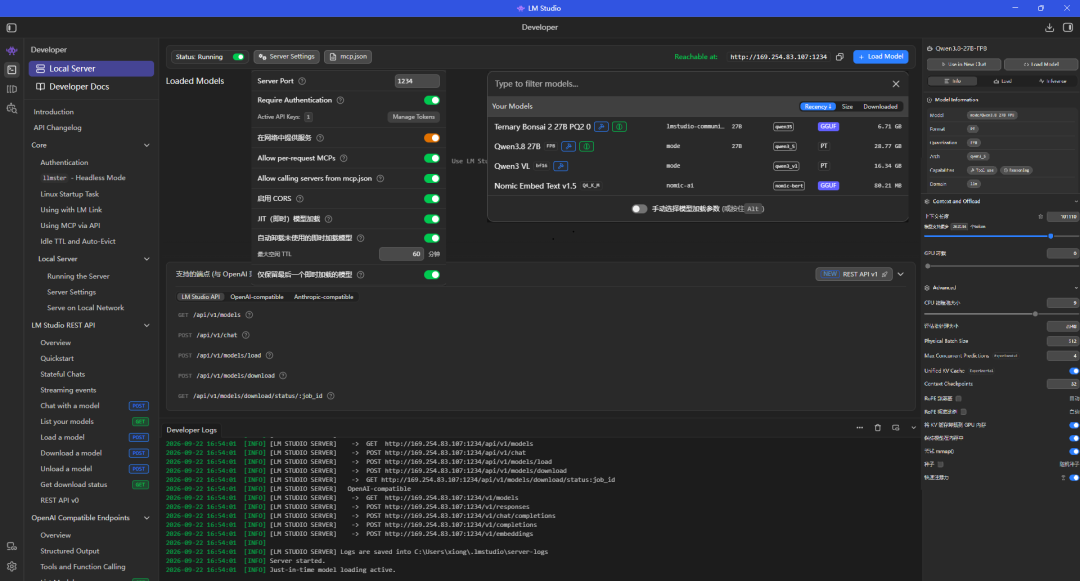
LM Studio 本地服务界面:加载模型后即生成 OpenAI 兼容 API
Step 4 参数调优。加载成功只是起点,参数调优才决定推理效率。五项核心参数按优先级依次调整:
GPU Offload 层数(显存分配):能上的层数全部拉满(--n-gpu-layers 99),让显卡承担全部计算;仅在加载报显存不足时,再逐层回调。
上下文长度(Context Length):按题目素材体量设“最小够用值”(--ctx-size)。过长白占显存,过短会截断证据文本;长上下文场景配合 KV Cache 量化(--cache-type-k/v q4_0)和 FlashAttention(--flash-attn on),可省一半以上缓存显存并显著提速。
性能与并发(吞吐调度):--batch-size / --ubatch-size 控制批处理粒度,吞吐不足时优先调大 ubatch;比赛现场“一题一答”的单请求场景,--parallel 1 并配合 --no-cont-batching 关闭连续批处理,换得更稳定的响应延迟;--timeout 900 防止单次请求卡死拖垮整体进度。
推测解码(出字加速):--spec-type draft-mtp --spec-draft-n-max 2 启用 MTP 投机采样,模型一边生成一边用小草稿头预取后续 token,验证通过即采纳,以极小代价换取约 20%–40% 的出字加速,长答案场景收益最明显。
采样参数(答案确定性):Temperature 降至 0.1–0.3(--temp 0.2),配合 Top-P、Top-K、重复惩罚抑制随机输出和复读;固定随机种子(--seed)保证每次结果可复现——取证推理必须能重放验证。
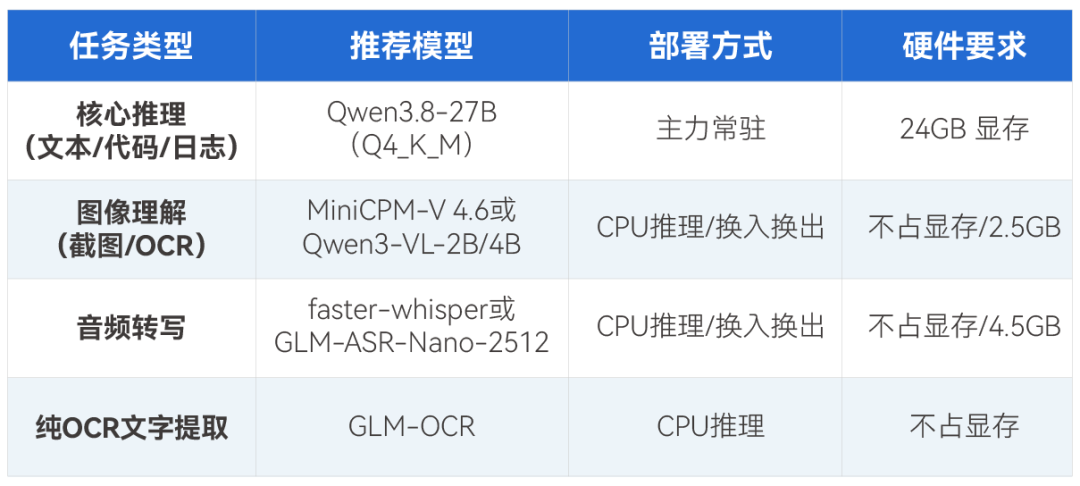
核心策略一句:主大模型扛核心推理,轻量模型补图像、音频等多模态短板;硬盘提前留够空间,笔记本同一时刻显存里只装一个模型,避免溢出。
说明:以上数据基于特定硬件环境的实测结果,仅供参考;模型版本迭代较快,部署前请以官方发布信息为准。