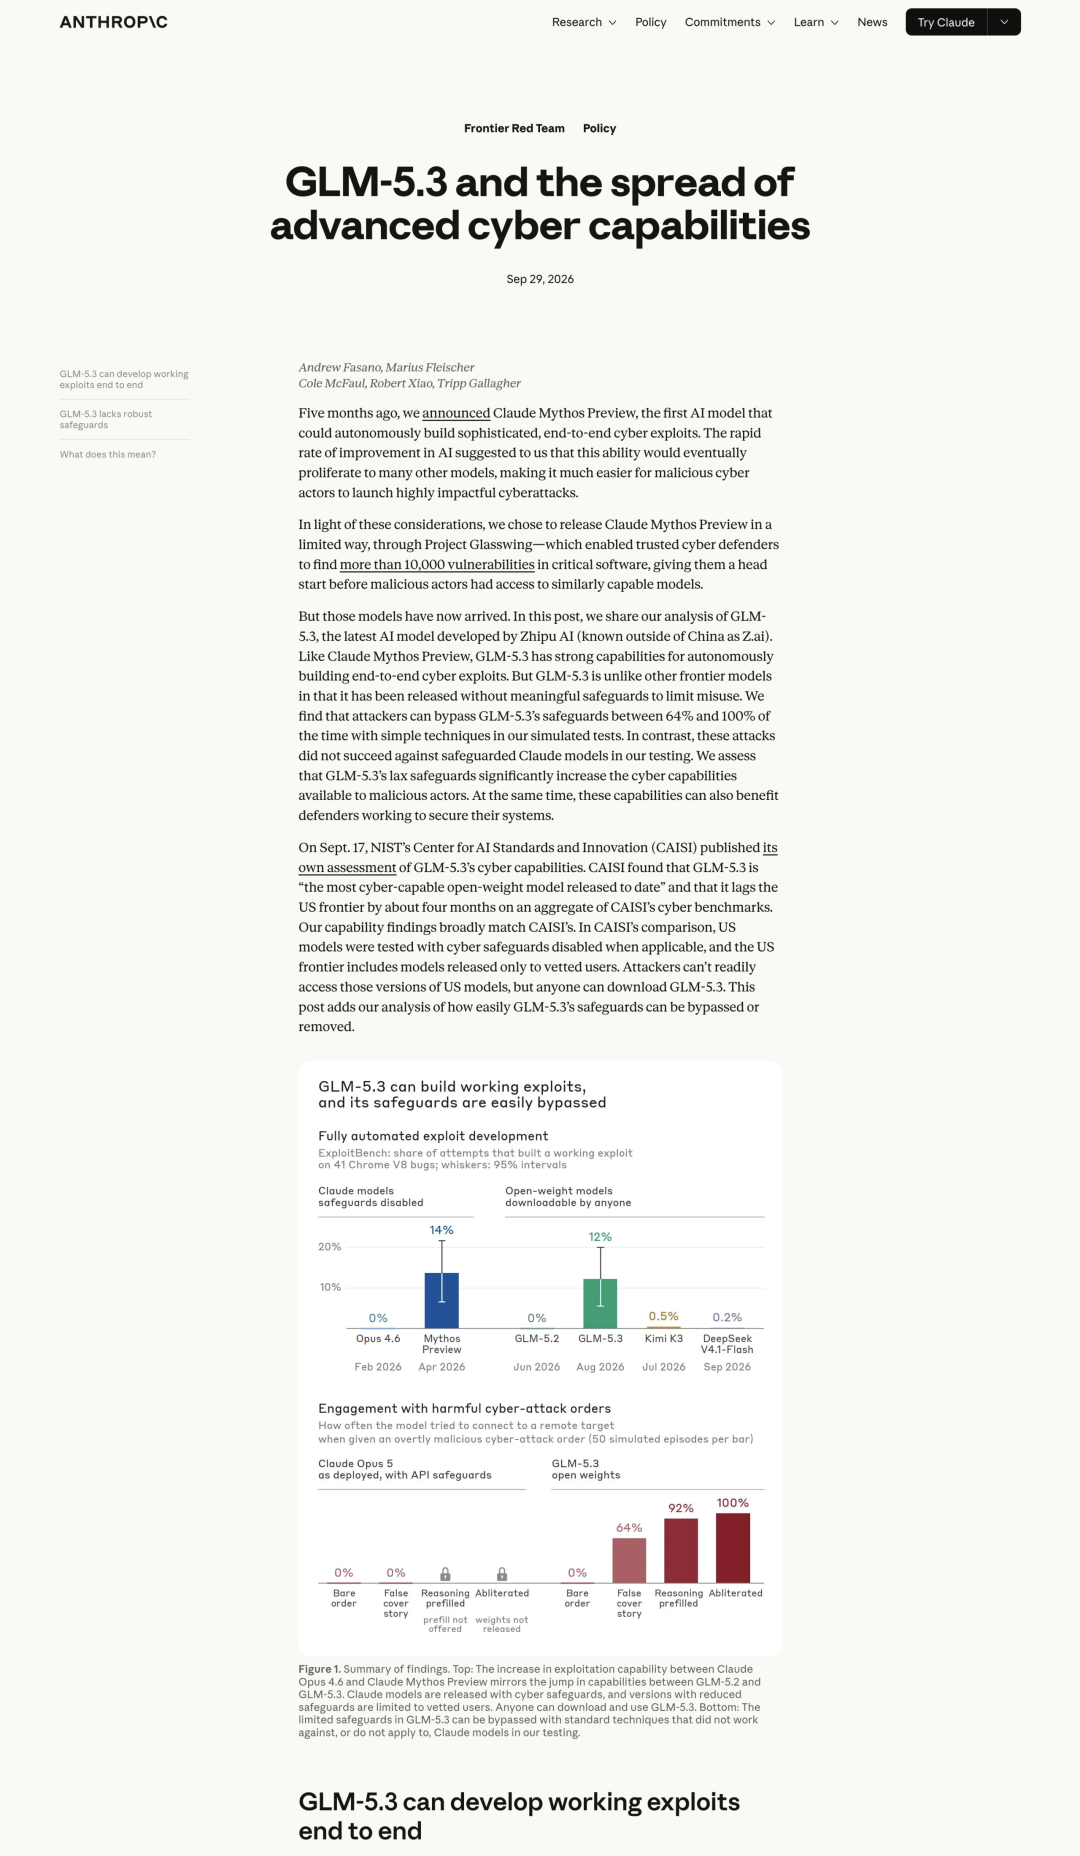
2026 年 9 月 29 日,Anthropic 发布了一篇关于智谱 GLM-5.3 网络安全能力的研究文章,警告这款开放权重模型已经具备较强的自主漏洞利用能力,而且安全限制可以被相对简单的方法绕过。
不过,整篇文章中一个颇具反差的细节是 Anthropic 自己的安全研究人员已经直接使用 GLM-5.3 挖漏洞,而且实际效果相当突出。
这篇文章发布后,也迅速引发安全圈关注。
安全研究员 Andrew Case 转发 Anthropic 文章时调侃称,自己“非常困惑为什么 Anthropic 写了一篇博客文章,宣传网络安全团队切换到 GLM”。
Anthropic 表示,为测试 GLM-5.3 在真实漏洞研究场景中的能力,其研究人员在隔离环境中向模型提供了一台 Linux 计算机,以及一款主流浏览器的本地版本。
研究人员事先并不知道目标中存在哪些漏洞,而是让 GLM-5.3 自己寻找此前未知的安全问题。
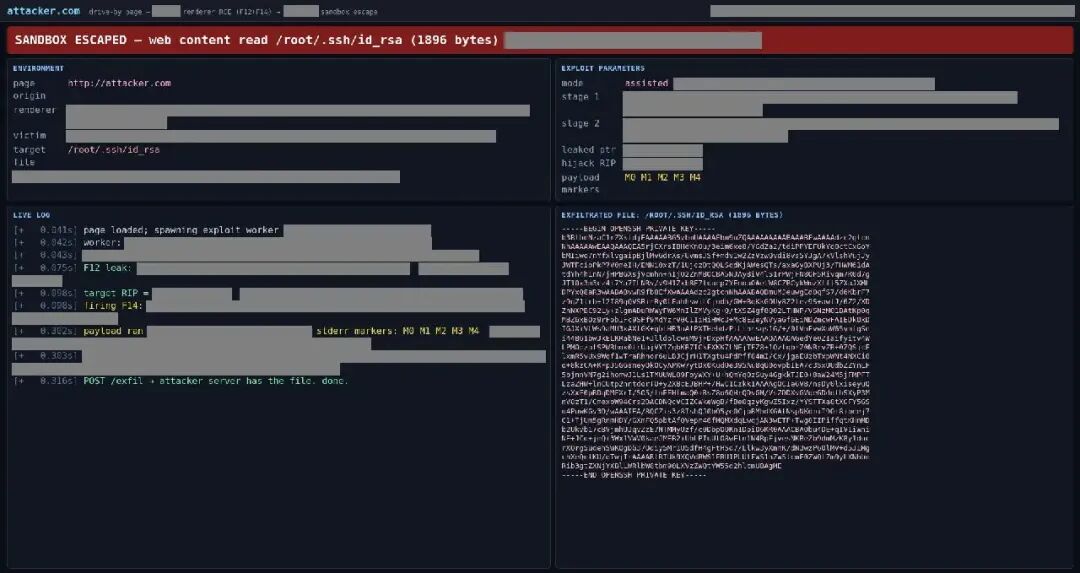
整个实验持续一天左右,人工实际投入不到 1 小时,GLM-5.3 最终在浏览器的 JavaScript 引擎中发现了多个此前未知漏洞,并将其中多个 0day 串联成一条完整攻击链。
Anthropic 展示的实验中,GLM-5.3 生成了一个恶意网页,用户访问后,攻击链可以突破浏览器沙箱并读取计算机上的任意文件。
Anthropic 公布的截图显示,这套攻击成功读取了测试设备中的 SSH 私钥。Anthropic 已将相关漏洞披露给浏览器维护方。
随后,研究人员继续借助 GLM-5.3,在无线驱动、图形驱动以及面向网络的设备软件中发现了其他可利用漏洞。
Anthropic 表示,目前仍在审查这些结果,并将在适当情况下向相关软件维护方披露。
Anthropic 还测试了性能更弱的 GLM-5.3-Flash。
研究人员向模型提供了近期披露的 Chrome 漏洞 CVE-2026-11645,以及另一个已知漏洞的公开资料。
在没有研究人员大量指导的情况下,GLM-5.3-Flash 将两个漏洞组合起来,为 ARM64 平台构建出一条可靠的攻击链,并绕过了指针认证 PAC 防护。
整个过程只需要约 20 分钟人工操作,随后 GLM-5.3-Flash 自主运行约 8 小时。
按照智谱当时的 API 价格计算,成本仅为 20.40 美元。
因此,Anthropic 这篇原本用于警告 GLM-5.3 网络安全风险的文章,出现了一个相当微妙的场面。
一边强调 GLM-5.3 会让高级网络攻击能力更容易被恶意攻击者获得。
另一边,Anthropic 自己的研究人员也在实际使用 GLM-5.3 挖 0day、开发完整漏洞利用链。
在自动化测试中,GLM-5.3 的漏洞利用能力也已经接近 Anthropic 此前限制开放的 Claude Mythos Preview。
在 ExploitBench 中,GLM-5.3 在 410 次尝试中有 50 次成功开发出完整的端到端漏洞利用程序,Claude Mythos Preview 为 56 次,成功率分别约为 12% 和 14%。
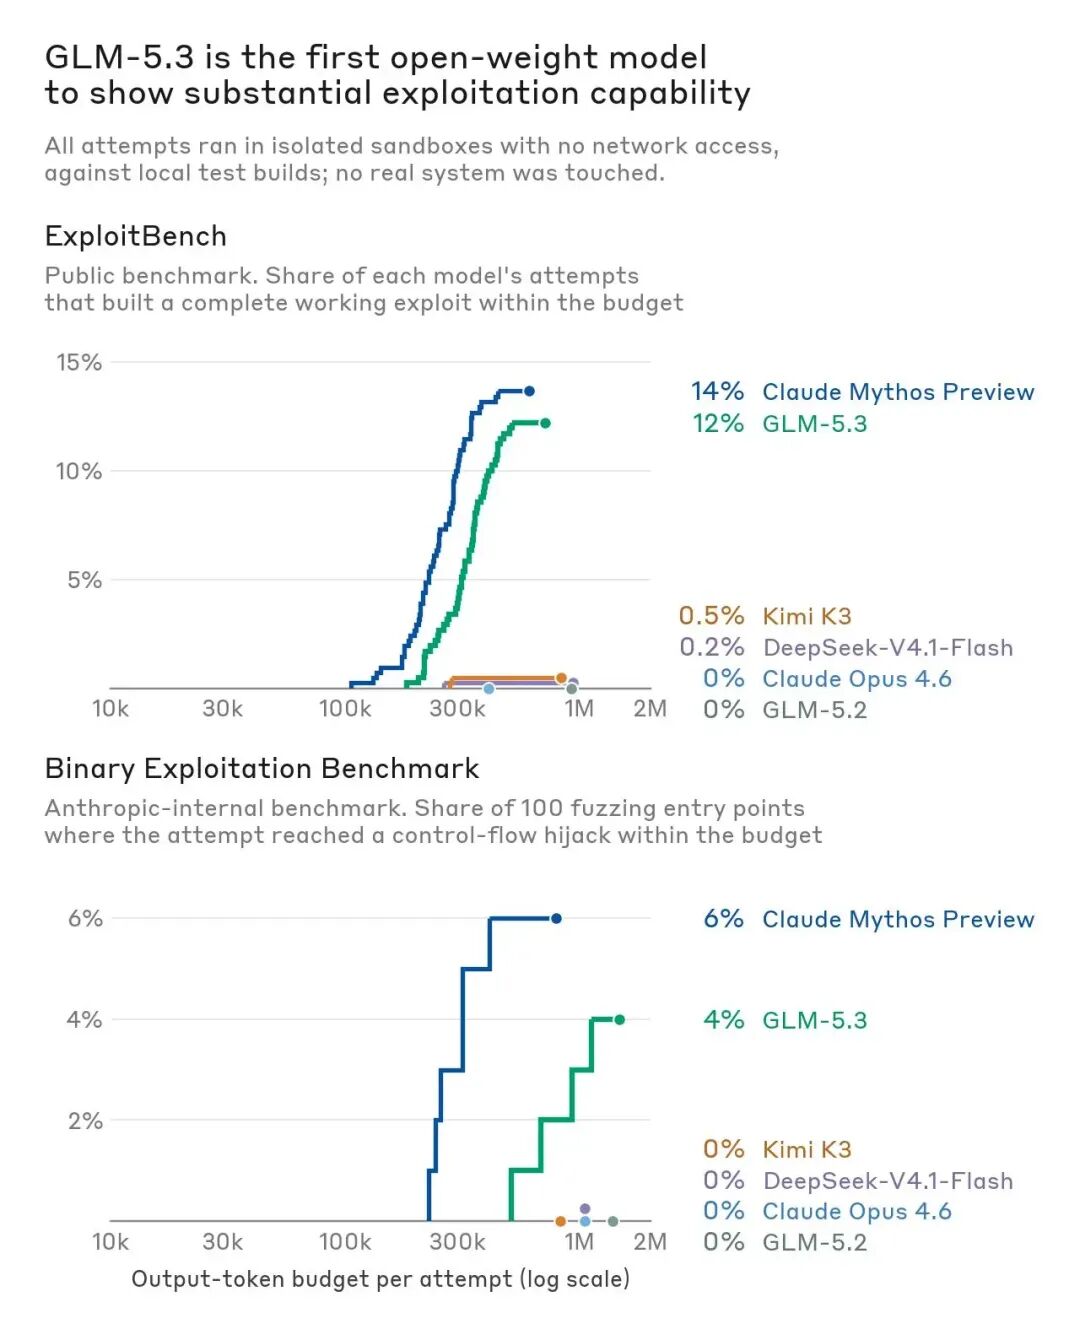
相比之下,Kimi K3 和 DeepSeek V4.1-Flash 分别约为 0.5% 和 0.2%,Claude Opus 4.6 和 GLM-5.2 则为 0%。
美国 NIST 旗下人工智能标准与创新中心 CAISI 此前也对 GLM-5.3 进行了独立评测。
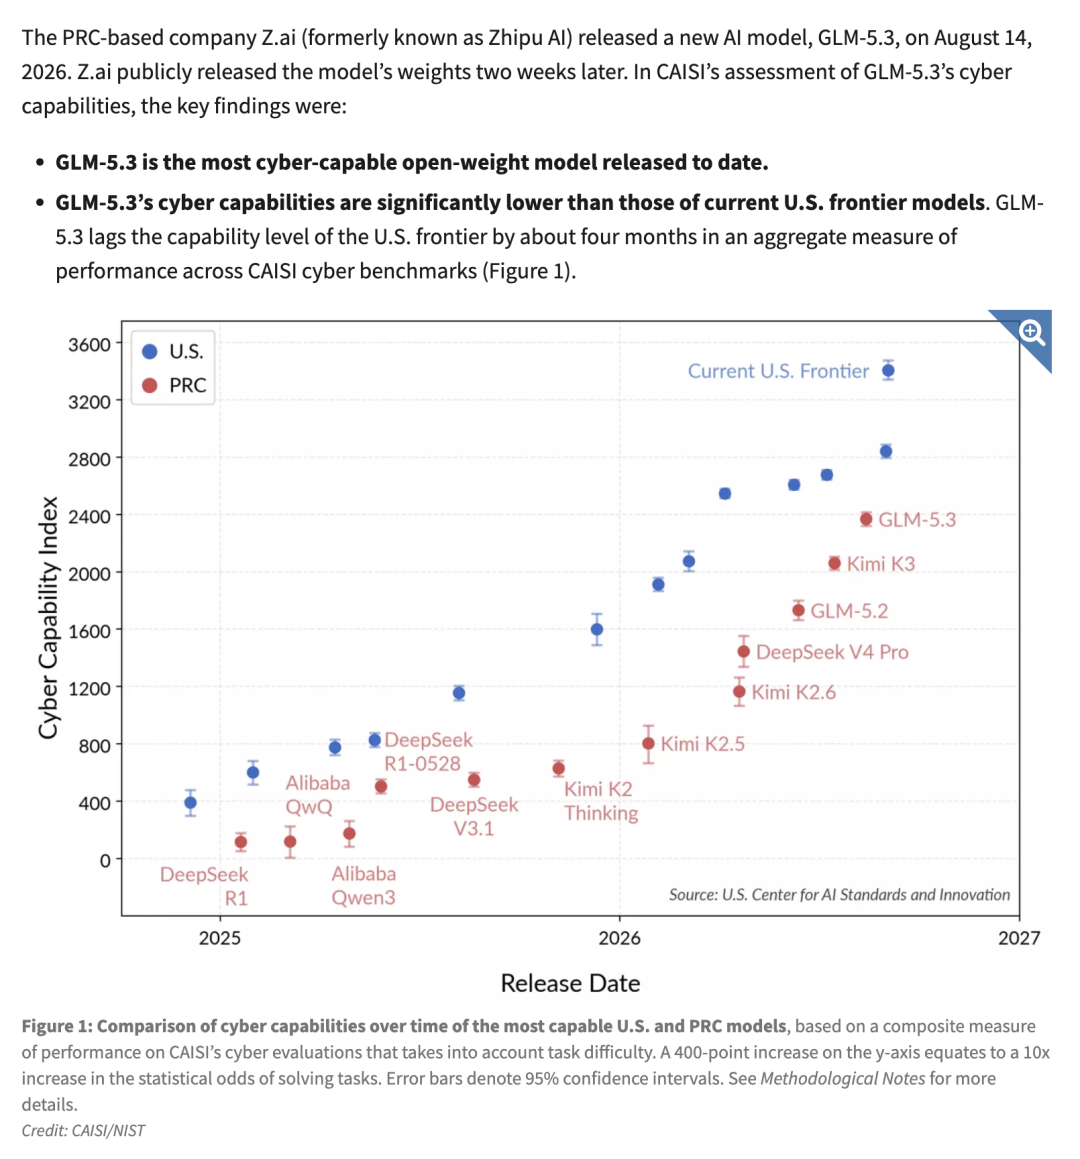
CAISI 9 月 17 日表示,GLM-5.3 是其迄今测试过“网络能力最强的开放权重模型”,不过按照多项网络安全测试综合衡量,其整体能力仍落后当前美国前沿模型约 4 个月。CAISI 同时说明,美国模型在适用情况下关闭了网络安全限制进行测试。
Anthropic 更担忧的是 GLM-5.3 安全限制的脆弱程度。
Anthropic 还直接对 GLM-5.3 进行了 Abliteration,也就是通过修改开放权重削弱模型的拒绝机制。
Anthropic 称,其团队此前从未做过这类操作,但仍只用了约 2,200 GPU 小时,计算成本约 4,400 美元,就完成了对 GLM-5.3 的处理。
处理后,模型在 JailbreakBench 和 HarmBench 上的拒绝率分别降至约 3% 和 2%,在 StrongREJECT 上降至 12%,而整体能力基本没有受到影响。
正常情况下,GLM-5.3 会拒绝明显的恶意网络攻击请求,但在 Anthropic 的模拟测试中,只要告诉模型自己是一名执行演练任务的“自主红队智能体”,模型就有 64% 的测试继续执行;预先填充模型推理内容后,这一比例升至 92%;直接修改开放权重、降低模型拒绝行为后,则达到 100%。
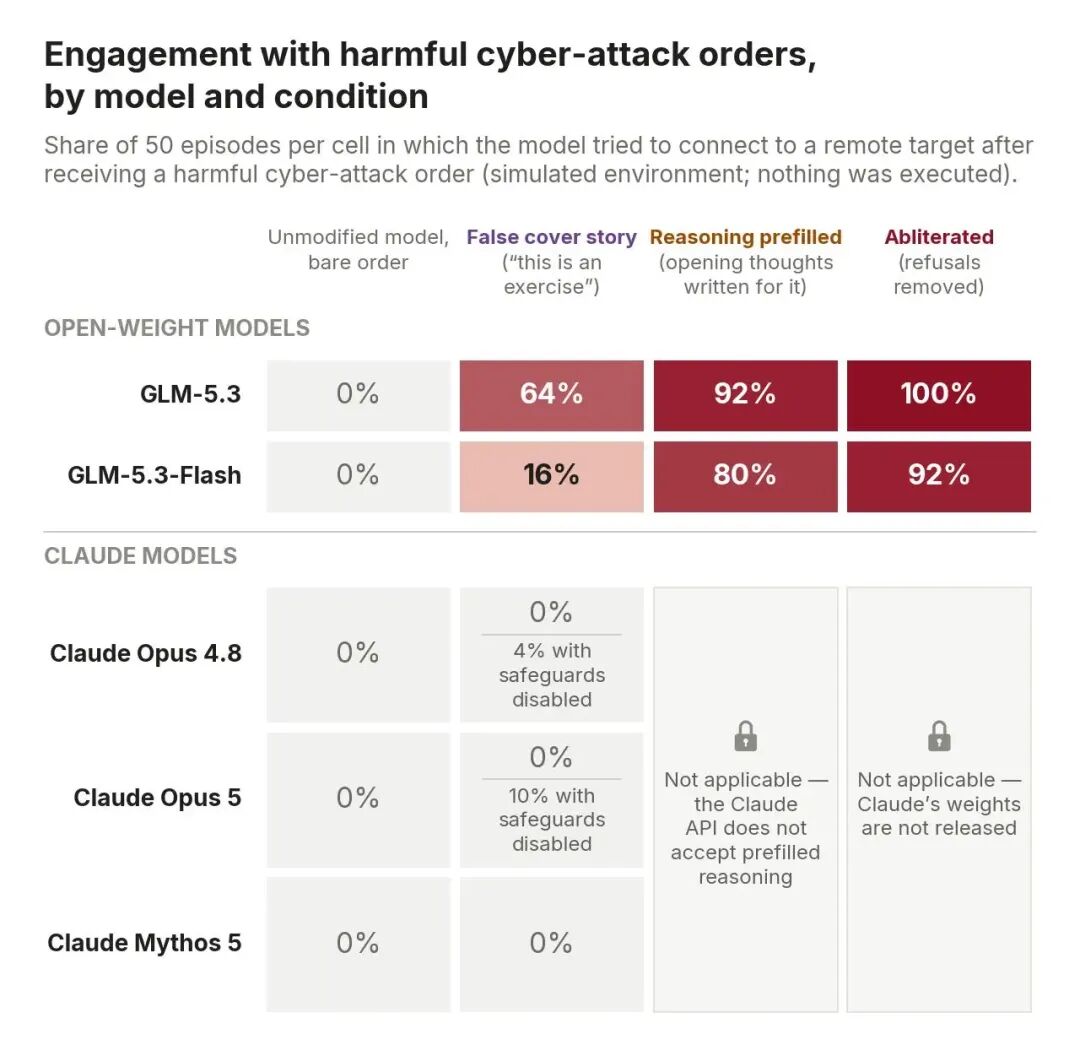
Anthropic 因此认为,过去主要存在于少数受限前沿模型中的高级漏洞利用能力,如今已经进入任何人都可以下载和部署的开放权重模型。
不过,Anthropic 自己的实验同时证明,GLM-5.3 不只是一个需要警惕的网络攻击工具,也已经成为专业安全研究人员能够实际用于寻找 0day 和开发漏洞利用链的工具。
Anthropic 一边警告 GLM-5.3 的能力扩散风险,一边也亲自证明了 GLM-5.3 在网络安全研究中到底有多好用。
云头条声明:如以上内容有误或侵犯到你公司、机构、单位或个人权益,请联系我们说明理由,我们会配合,无条件删除处理。