前阵子发了团伙skill,把"挖关系"这件事从单点扩成了整条研判流水线:数据进来,团伙框架、涉案罪名、可回溯报告出来。
【全球首发】团伙skill:一套犯罪组织高级调查智能体战法,30分钟直出研判结果
文章发出后,后台收到最多的一类问题,比"关系怎么挖"还要靠前一步:
就是资金分析
我手里几十份银行流水,格式五花八门,光整理成统一格式就得一两天,这数据能直接喂给skill吗?
答案是不能。
关系是从数据里挖出来的。数据是脏的、缺的、乱的,挖出来的关系就是错的。这个道理放到今年公安经侦的大背景下来看,就是四个字:金析为证。
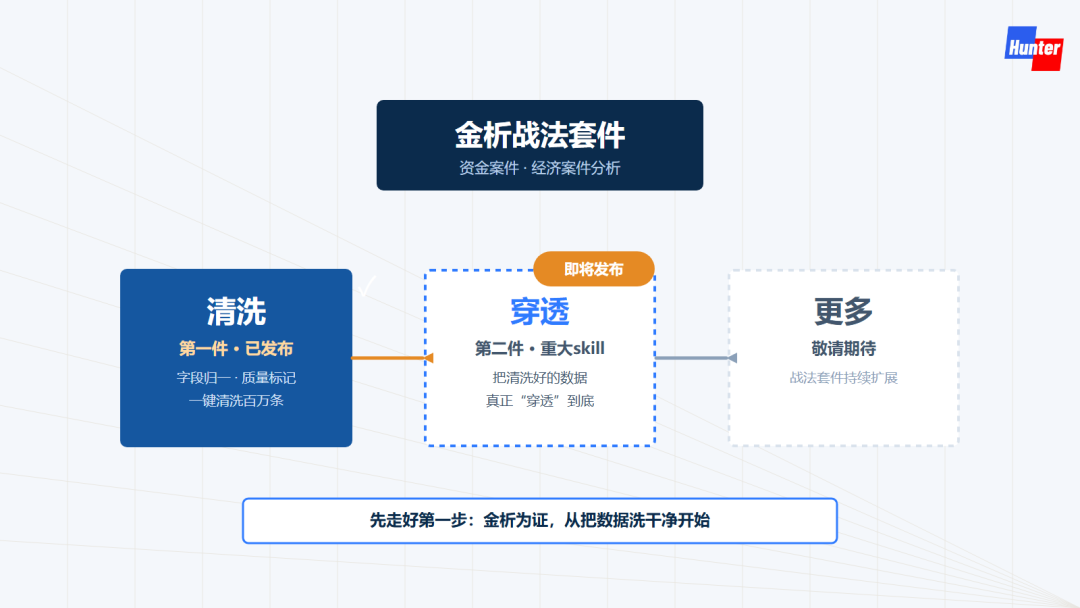
今天发的这套金析-清洗skill,是"金析"战法套件的第一件。"金析"战法套件是一组专门服务资金案件、经济案件分析的战法组合,后面还会陆续出更多。
这套清洗skill,只是开头。
话不多说,我们开讲。
01什么是"金析为证":让资金分析出来的"东西",变成法庭上的"证据"
2025年,公安部印发《公安机关资金分析鉴定工作程序规定(试行)》,明确把资金分析鉴定纳入公安机关法定鉴定范畴。官方给这件事起了个名字:金析为证。
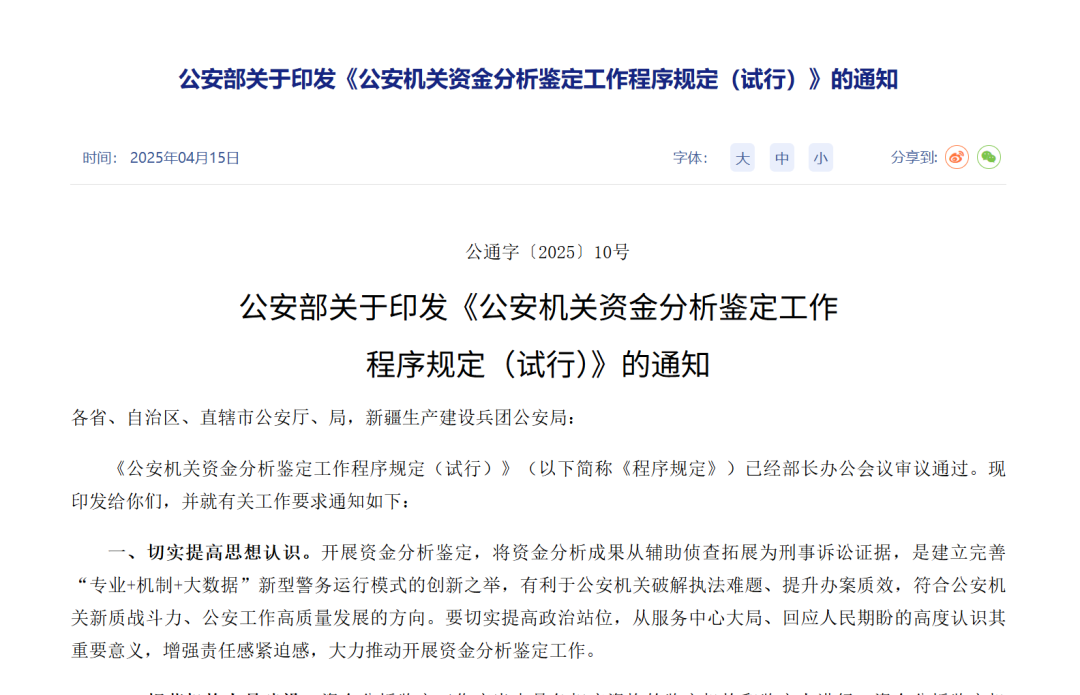
(来源公安部官方)
拆开就一句大白话:让资金分析出来的"东西",变成法庭上认的"证据"。
"金析"是资金分析的简称。官方的定义是:依法梳理、分析、研究涉案资金数据,对资金交易的进出账户、金额大小、交易时间、对手信息的关联性和共同性进行研判,确定账户之间关系和资金去向,进而查明有关违法犯罪事实。
"为证"是资金分析成果作为刑事诉讼证据的简称。官方说得很具体:按照特定工作程序与技术方法,对资金分析进行全要素、全流程的证据化改造,使资金分析成果具备刑事诉讼证据的基本要素和特征,并经法庭质证后作为证据使用。
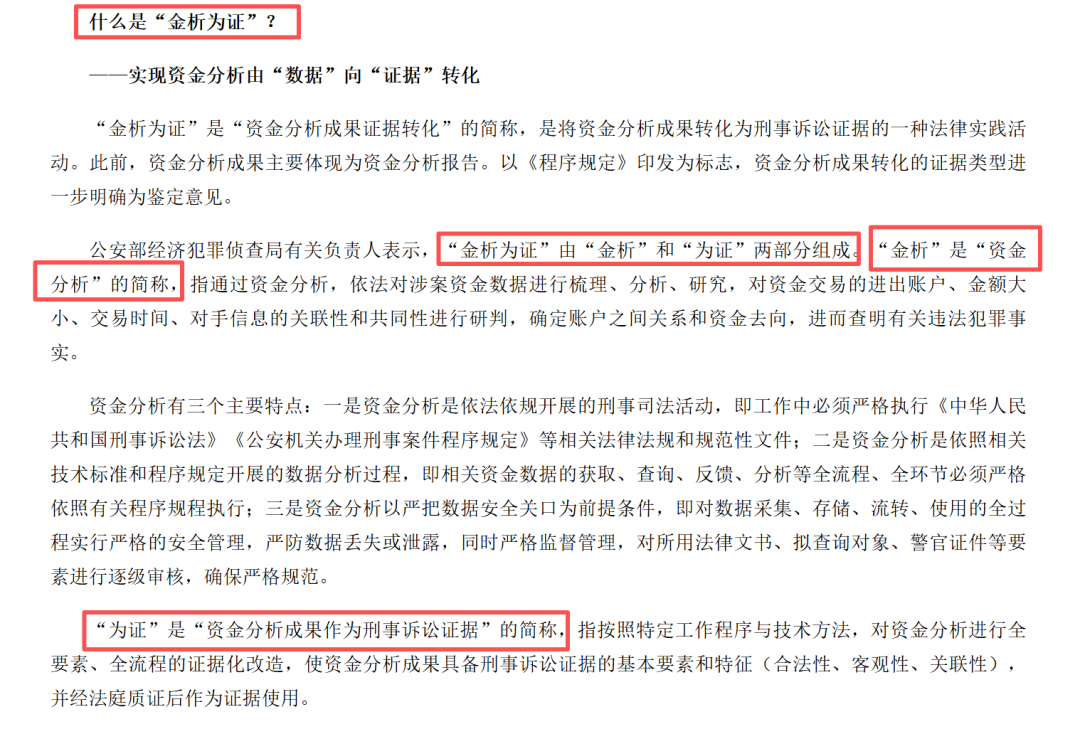
以前资金分析成果主要体现为资金分析报告,证据属性模糊,到了司法环节容易被质疑。以《程序规定》印发为标志,成果转化的证据类型明确为鉴定意见。
一句话:从"数据"到"证据",从"辅助侦查"到"定案证据",官方把这条路打通了。
02官方的解读:资金分析三个特点,条条都在讲"规范"
公安部经济犯罪侦查局有关负责人对"金析为证"做了权威解读,资金分析有三个特点,我建议做资金分析的战友都记一下:
第一个特点,资金分析是依法依规开展的刑事司法活动。必须严格执行刑事诉讼法、公安机关办理刑事案件程序规定等相关法律法规和规范性文件。
第二个特点,资金分析是依照相关技术标准和程序规定开展的数据分析过程。相关资金数据的获取、查询、反馈、分析等全流程、全环节,必须严格依照有关程序规程执行。
第三个特点,资金分析以严把数据安全关口为前提条件。数据采集、存储、流转、使用的全过程实行严格的安全管理,严防数据丢失或泄露。
三个特点,条条都在讲一件事:规范。
为什么要做这件事?官方解读给了三个现实背景:经济犯罪涉案金额巨大,涉案金额逾百亿的案件屡有发生;涉众型案件里利益群体追赃挽损诉求迫切;新型经济犯罪突出,犯罪分子利用网银、虚拟货币、聚合支付快速转移非法资金。
资金分析从"辅助侦查"走向"证据核心",从侦查环节延伸到起诉、审判环节。"金析为证"的制度依据已经齐了,接下来就是把每一步走实——第一关,就是数据本身。
03金析为证,求的到底是什么:合法性、客观性、关联性
"为证"到底要求什么?官方解读里有一句原话,是所有资金数据工作者的行动纲领:
使资金分析成果具备刑事诉讼证据的基本要素和特征(合法性、客观性、关联性),并经法庭质证后作为证据使用。
合法性、客观性、关联性,三性一条都不能少。落到资金数据上,这三条各有各的硬要求:
合法性,说的是来源。数据必须来自依法调取或明确授权的渠道,取得依据、时间范围、保全信息都要说得清。说不清来源的数据,分析得再漂亮也进不了质证环节。
客观性,说的是原样。数据必须真实、完整、不被加工扭曲。账号就是账号,卡号就是卡号,不能因为表格软件偷懒丢了位数;金额就是金额,不能因为缺失就"猜"一个填上。证据讲究原汁原味,加工过的数字没人信。
关联性,说的是能回溯。从分析结论到原始记录,每一步都要指得回去:这笔钱来自哪个文件、哪个表格、哪一行,经过了什么处理。回溯断了,关联性就没了。
把这三条放到真实办案场景里,问题就来了:原始资金数据,根本达不到这个门槛。
04为什么第一步必须是清洗:数据不干净,三性无从谈起
在经侦一线待过的战友都知道,调回来的资金数据长什么样:
几十家银行、几百种版式,表头叫法千奇百怪
"借方发生额""贷方发生额""本期余额",同一个字段三个名字;支付宝微信的账单、PDF、扫描件、压缩包混在一起;
导出这些数据的电脑基本都是Windows系统,有的甚至是Windows XP、Windows 7这种老系统,导出来的Excel格式更是五花八门,有的还是十几年前的.xls老格式;
CSV文件编码有UTF-8、有GBK、有GB2312,Excel一开就是一屏乱码;
金额有带千分位的、有带货币符号的、有括号表示负数的;
时间有"2024/1/5"、"20240105"、"2024年1月5日"三种写法并存。
这些活以前全靠人工。公开报道里,一位一线经侦民警算过一笔账:再熟练的侦查员,想清洗一批数据,也要经历10个步骤、六七个小时、点击鼠标上万次,中间有一个数据错误,就得推倒重来。
数据这样进来,合法性、客观性、关联性,一条都立不住。来源说不清、原值被破坏、行行对不上号,后面所有的资金分析、资金链路、团伙研判,全是沙上建塔。
2024年底,公安部经侦局组织起草的四项法庭科学资金数据标准发布,其中《法庭科学资金数据清洗规程》(GA/T 2159-2024)于2025年3月1日实施。
(图片来源:GA_T 2159-2024 《法庭科学 资金数据清洗规程》)
清洗,是金析为证链条绕不开的第一道工序。
清洗不是锦上添花,是金析为证的第一步。我们先把第一步走好,再去谈资金分析,后面的东西才立得住。
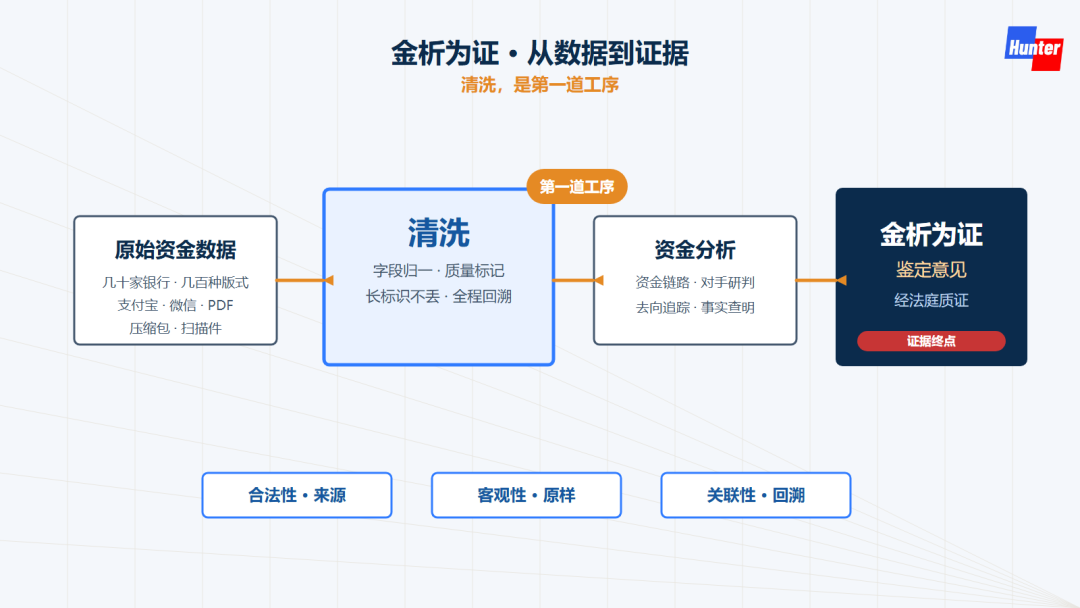
这也是今天这个skill存在的全部理由——用智能体这个最前沿的技术手段,把清洗这道最苦最累的工序接过去。
所以我花了大概一周的时间,去研究国内的权威发布文件,把自己以前资金分析的所有战法,以及调研的国内外资金战法,全部融合到一起,写出了这一个清洗skill。这个skill耗费了我大量的测试时间与精力,以及撰写的时间与经验,也烧掉了大量词元(token)。这个skill的含金量,是继团伙skill之后又一大新的里程碑。
除了把数据洗干净,这个skill还可以输出数据血缘图谱,把清洗过程可视化,用来回溯验证:从任意一条清洗结果,一路反查到来源文件、原始行号和每一步处理。数据洗干净了,过程还看得见,才敢谈"为证"两个字。
05它是什么:一套把原始资金数据变成标准证据底稿的完整工程化skill
一句话定位:把依法取得或明确授权的多来源资金数据,清洗归一成一份经得起复核的标准底稿。
这是一套完整工程:SKILL.md 定规矩,references 装规则与规范(字段别名表、归一化规则、质量门禁、输出契约),scripts 跑清洗、导出、审计。开箱即用,纯本地运行,不上传任何原始数据。
支持输入10种格式,输出一份固定双Sheet的标准XLSX。具体能干什么、有哪些能力,下一节一张清单讲完。
06核心能力:一张清单,讲清它能干什么
这个skill能干什么?一句话:把多来源、多版式、多格式的原始资金数据,清洗归一成一份标准、干净、经得起复核的证据底稿。
核心能力,五句话讲完:
洗得动。csv、txt、xls、xlsx、et(WPS表格)、html、xml、rar、zip、pdf,10种格式都能进,单文件、批量、目录递归、压缩包内递归都支持;PDF和扫描件走智能解析,表格重建、银行版式识别、跨页续表合并;表头字段用别名表识别,精确别名优先,模糊匹配要过阈值和唯一性两道门禁,歧义一律标记待确认,不静默猜。
归一得齐。不管来源是哪个银行、哪种版式,全部映射到同一套固定中文表头、同一套中文枚举值;时间、金额、币种、收付方向、账户、交易对手、摘要、状态、来源字段全部标准化。几十份流水进来,出来是一张能直接筛选、直接透视、直接分析的统一样式表。
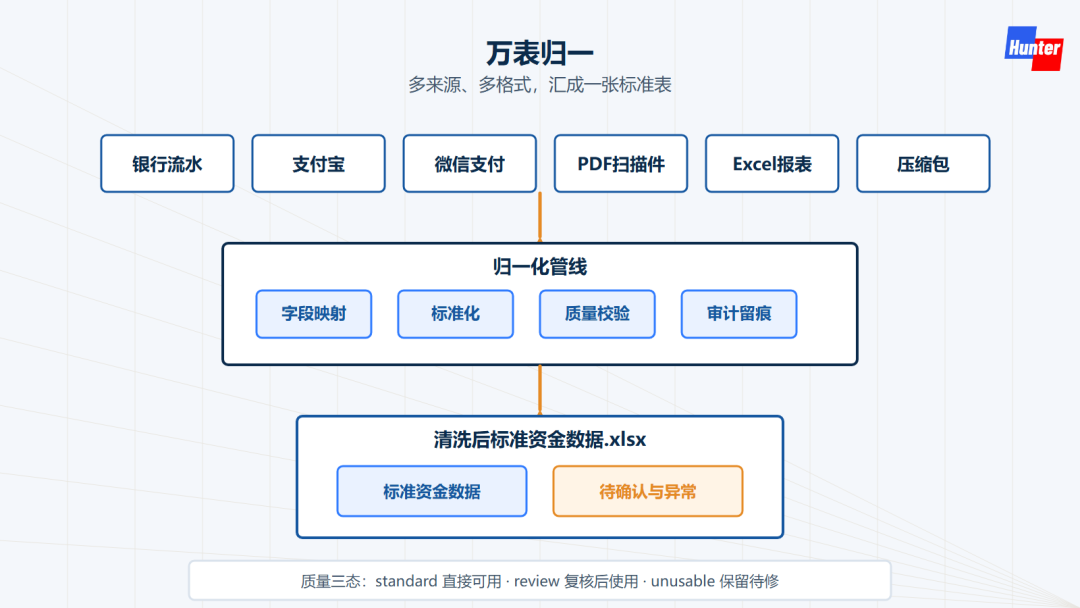
留得住。每条记录都有质量身份:standard、review、unusable,没有一条非空记录会被悄悄丢掉;账号卡号等长标识以文本单元格完整保留;证据字段不臆造、不删除,全程可回溯。
查得清。每个输入文件都算SHA-256留痕;内置审计脚本逐笔核对记录数、来源定位、中文枚举和长标识文本类型;导出采用原子替换,失败不留半成品。
扛得住。十万条、百万条的数据量级,数据主体由本地脚本管线处理,不进模型上下文、不占显存——数据量再大也洗得动,显存和硬件不构成数据量瓶颈。
还有哪些功能?一并讲清楚:
- 确参机制
:启动先问清输入范围、输出目录、默认时区、输出格式、有没有密码保护文件,答完才开工,输出不跑偏。 - CSV输出
:明确要求时输出 清洗后归一化资金数据.csv,UTF-8 BOM,供系统导入和程序交换。 - 数据血缘图谱
:明确要求时输出 金析清洗数据血缘图谱——单文件、断网可用的离线HTML,倒金字塔结构,从任意一条清洗记录反查到来源文件、原始行号、字段映射和处理路径。这是清洗过程的可视化回溯验证,直接对应"为证"的关联性要求。 - 纯本地离线
:只依赖本地Python环境,原始资金数据不上传任何远程服务。 - 密码保护文件
:加密的zip、加密的PDF支持处理,密码通过安全渠道输入,不落日志。
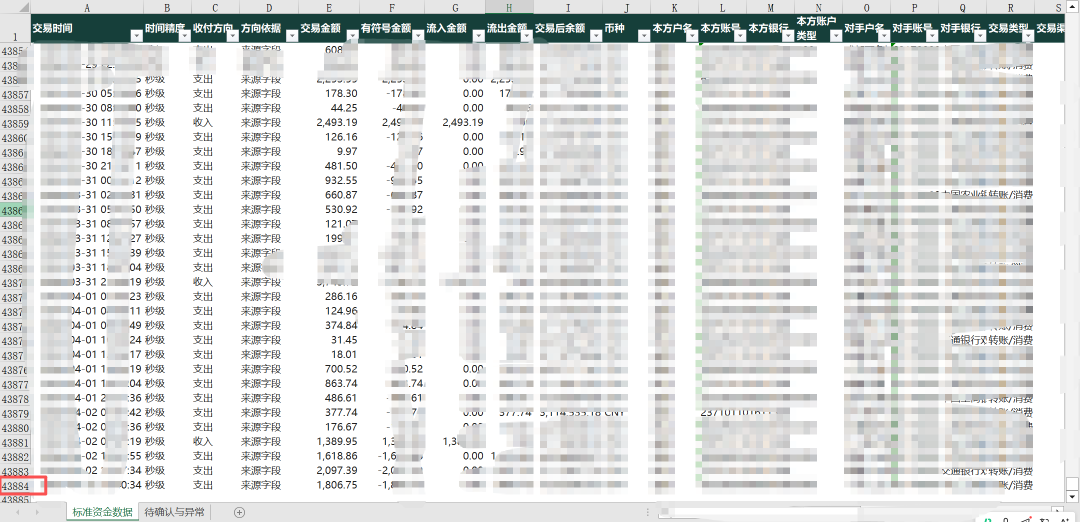
(交付的《清洗后标准资金数据.xlsx》效果截图)
07四个硬规矩,每个都冲着"为证"去
做清洗的skill不少,为什么这套值得拿出来说?
因为它的四个硬规矩,不是按"方便分析"设计的,是按"能当证据底稿"设计的:
规矩一:长标识不丢。账号、卡号、交易流水号、凭证号、商户号、终端号,一律写成真正的文本单元格,完整保留前导零和全部数字,禁止公式、禁止前置单引号糊弄。原值就是证据,少一位数都是事故。
规矩二:不臆造。交易金额、余额、时间、账号、户名、交易对手这类证据字段,禁止用统计、KNN、矩阵分解、语言模型或常识猜测去补。补不上就保留为空、标记出来,宁可留空,不造假。
规矩三:不删除。自转账、失败、撤销、冲正、负金额、零金额、重复候选,全部保留,只改业务状态和质量标记。原值与标准值分层保存,推断、补全、映射、修正全部标明方法、依据、置信度和原始定位。清洗只改变状态,不消灭事实。
规矩四:全程可回溯。每条记录都带来源文件、来源表格、来源行号和原记录哈希。任意一笔清洗后的数据,都能逐笔反查到它在原始文件里的位置。字段歧义、表头歧义、记账方向不明、时间顺序不唯一,一律标记待确认,不静默选择。
四个规矩合起来就一句话:这份底稿拿去复核,任何一步都经得起追问。
除此之外还有两个工程上的细节,干过活的人知道多重要:导出采用临时文件加原子替换,失败不会留下半成品;内置审计脚本会逐笔核对两个Sheet的记录数、来源定位、中文枚举和长标识文本类型,不是只检查表头就完事。
08工作流:从文件进来到标准表出去
整套流程八个环节,参照真实研判节奏设计,一步没省:
01 枚举输入:所有文件计算SHA-256,记录文件名、路径、大小、格式、Sheet、解析状态、记录数和错误,压缩包保留包ID和包内路径。
02 字段映射:用字段别名表识别表头和字段,精确别名优先;模糊匹配只有阈值与唯一性门禁同时通过才自动采用,否则标记待确认。
03 标准化:统一时间、金额、币种、收付方向、账户、交易对手、摘要、状态和来源字段。内部审计字段不进主表,原始标识字段始终按文本处理。
04 质量校验:重复候选、失败/撤销/冲正、关键字段缺失、金额/时间解析、余额连续性、字段映射,逐项过检。校验只增加状态和问题代码,不覆盖原始事实。
05 生成交付:默认导出标准XLSX,固定两个Sheet。
06 审计:按实际输出模式审计文件名、字段、记录唯一性、记录数量和来源定位。
07 复读核验:重新读取XLSX,逐项检查标识字段的完整字符串、文本单元格类型、中文枚举、列数和记录数。
08 报告:交付时报告输入文件数、解析记录数、standard/review/unusable记录数和未解析文件数。
用户明确要求CSV或血缘图谱时,才额外生成对应文件;不要求,就不多生成,交付目录干干净净。
09质量怎么保证:门禁、自测、回查
这套skill的质量控制,分三层:
第一层,质量门禁写进契约。输出必须恰好一个工作簿、恰好两个Sheet、表头全部是字段字典定义的中文名、长标识单元格类型为文本且与内部载荷逐值一致、来源定位覆盖率100%。不达标,审计脚本直接报错。
第二层,内置自测。我用样本数据跑了一遍内置自测脚本:6个输入文件、8条解析记录,输出3条standard、4条review、1条unusable,未解析文件0。全流程从解析、映射、标准化到校验、导出、审计,一次跑通。
第三层,编制依据可查。这套skill的清洗规则不是拍脑袋写的,编制依据列出来,都是能查到的权威文件:
《公安机关资金分析鉴定工作程序规定(试行)》及公安部经侦局权威解读 《法庭科学资金数据获取规程》(GA/T 2158-2024)、《法庭科学资金数据清洗规程》(GA/T 2159-2024)、《法庭科学资金数据检验规程》(GA/T 2160-2024) 《反洗钱数据采集及监测 术语》(JR/T 0353-2026)、《金融数据安全 数据生命周期安全规范》(JR/T 0223-2021) 《银行保险机构数据安全管理办法》(2024)、《中国人民银行业务领域数据安全管理办法》(2025)
每一条清洗规则都有明确的判定标准和处置方式,全部落进脚本执行——不靠感觉,不靠经验。
说句实在话:清洗这件事,单看每一招都不难,难的是全流程的规矩一条不破。这套skill的价值,就是把官方标准的规矩,变成了机器默认执行的动作。
10横向对比:手工清洗、传统脚本、本skill
把三类做法放在同一组材料上比,差异很清楚:
人工强在灵活,弱在口径不统一、覆盖不全、留不下过程痕迹;传统脚本强在快,弱在不懂办案语义,新格式一来就得改代码。这个skill把两边的短板都补上了,还多出两块两边都没有的东西:质量三态留痕,和逐笔可回溯的审计链。
对一线来说,最直接的变化是:以前几十份流水,光整理成统一格式就要一两天,现在材料进去,清洗、映射、校验、审计一次跑完,人省下来干真正重要的事——复核review、修unusable、把精力放在资金分析本身。
11如何使用:四步走
前面能力说了一堆,这一节教你上手。整个流程四步走,照着做就行。
还是以豆包为例
第一步:备数据。把依法取得或明确授权的资金数据整理出来。银行流水、支付宝微信账单、PDF、压缩包,有什么给什么,格式不限。关键是把来源说清楚:数据哪来的、什么时间段的、有没有合法依据。来源说不清,后续的证据转化就无从谈起。
第二步:装skill,上传数据。
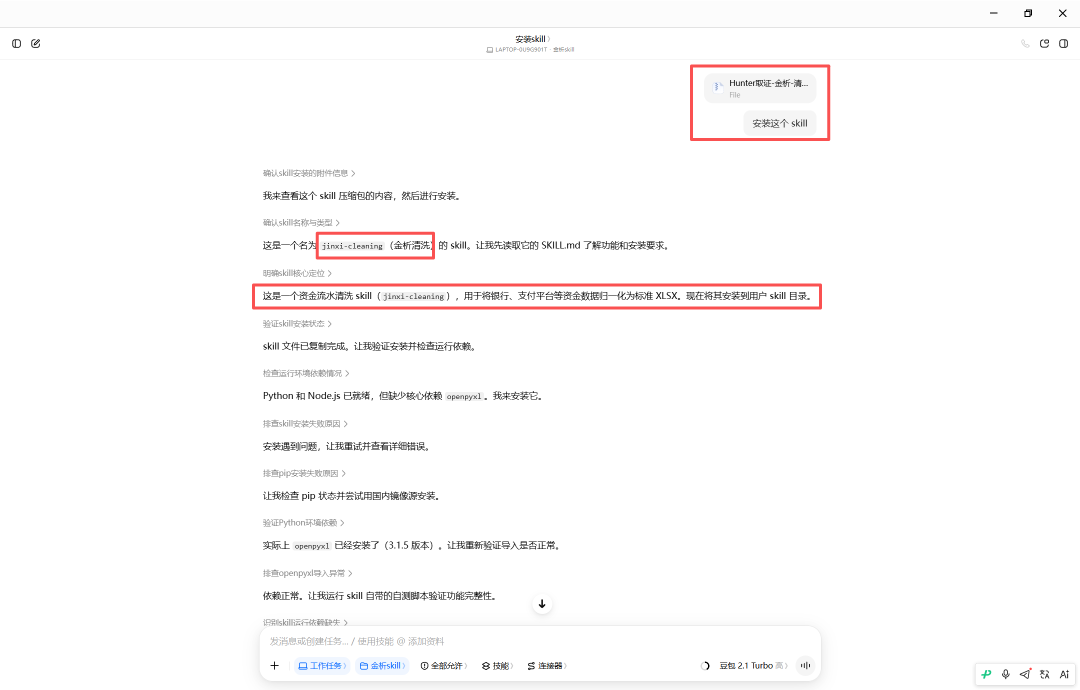
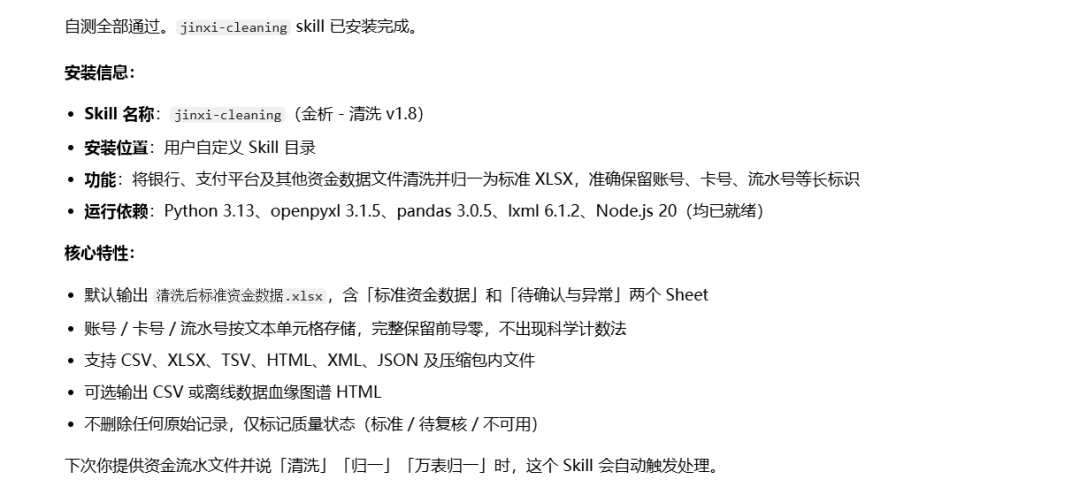
在智能体平台上传skill压缩包,启动后把数据文件交给它。它会先做启动确认:输入范围、输出目录、默认时区、输出格式、有没有密码保护文件,一次问清,答完才开工。别嫌烦,这几个问题答准了,输出才不会跑偏。
第三步:等结果,走审计。skill跑完生成标准XLSX,然后审计脚本收尾:查文件名、查字段、查记录数、查来源定位。全绿,文件才算是能交付的。
第四步:读结果、定复核方向。打开工作簿,第一眼:标准资金数据Sheet里standard记录直接用;第二眼:待确认与异常Sheet里review记录对着问题代码逐条复核,unusable记录拿原始文件人工修正。
记住一句话:机器给的是标准底稿和问题清单,结论永远由人来定。清洗不是把数据"洗没",是把问题"洗出来"。
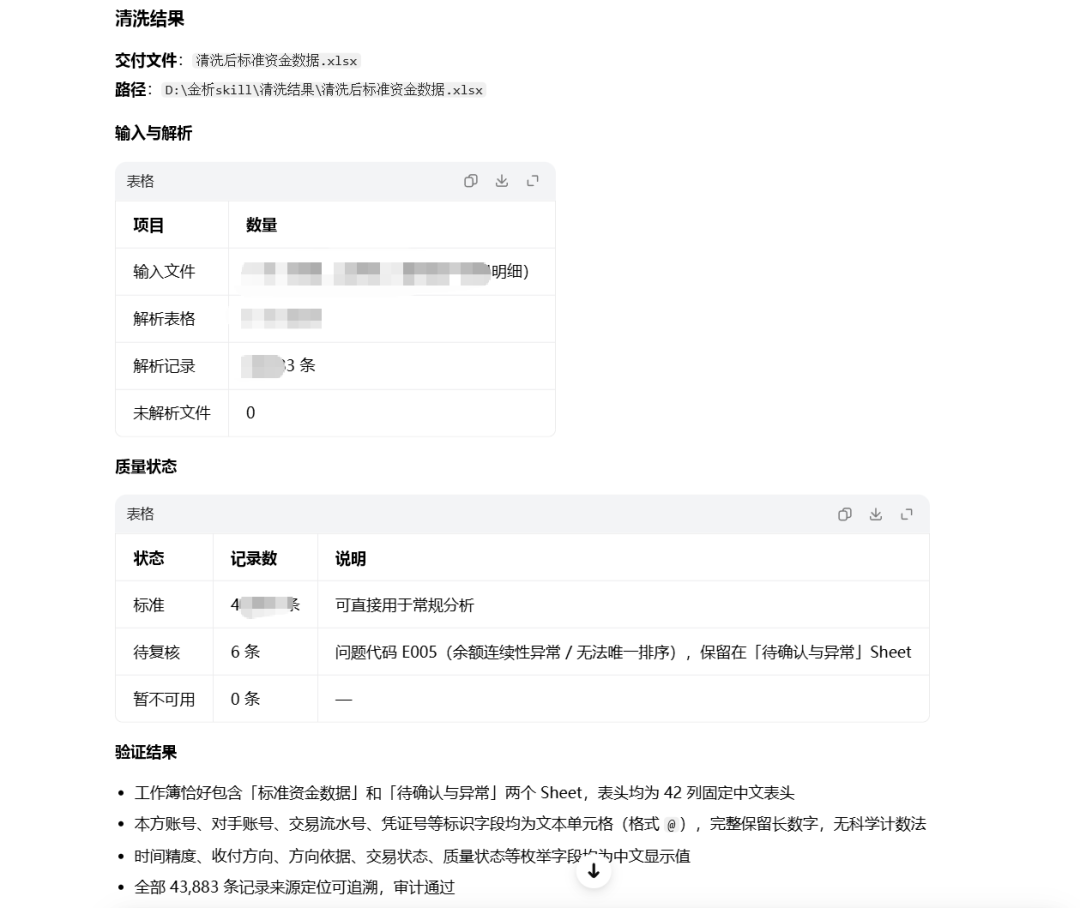
(运行完成后的汇总报告截图)
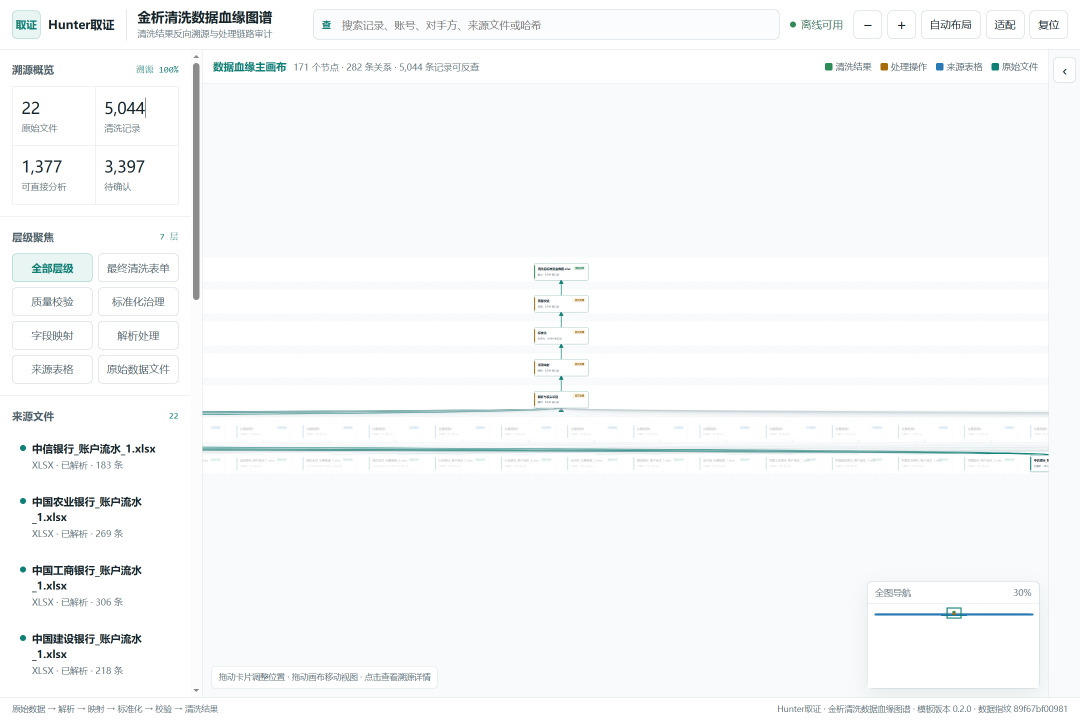
(数据血缘图谱HTML界面截图)
(只能放截图,不能放视频,涉及隐私),呈现倒金字塔结构的溯源记录
备注:数据血缘图谱,需要在生成清洗表单后,发送提示词指令:“生成该份清洗结果的数据血缘图谱”,等待智能体生活即可
12大家最关心的问题!十万条、百万条数据,显存和硬件会不会卡住
做资金清洗,战友们最关心、也最容易被"劝退"的一个问题是:数据量大了怎么办?清洗十万条、甚至百万条记录,显卡显存扛得住吗?会不会把智能体的上下文撑爆、直接卡死?
取证猎人这套顶层架构设计,不占上下文是它最大的优势。
清洗十万条、百万条,显存和硬件不会限制输出。原因要从第一性原理讲起。
先讲上下文和显存的关系。大模型处理文本靠注意力机制:每生成一个词元(token),都要把此前所有词元(token)的键值缓存(KV Cache)读取一遍,计算注意力相关性。KV Cache 的内存占用与序列长度线性相关,复杂度 O(n)。以 7B 参数级模型、FP16 精度为例,每个 token 的 KV Cache 约 0.5MB:4K 上下文约 2GB 显存,8K 约 4GB。显存里装得下多大的 KV Cache,模型就有多大的上下文窗口。
再看数据量会怎么冲击这个体系。假设十万条清洗记录全部进入上下文,按每条 200 token 估算,就是 2000 万个 token,对应 KV Cache 高达 TB 级——任何单机部署都装不下。这说明"把海量数据塞进上下文"这条路在物理上就不存在,任何宣称"让模型直接读十万条"的方案,到这里都是死路。
这套skill的选择,是把数据主体挡在上下文之外。从文件读取、字段映射、标准化、质量校验到XLSX导出,全部由本地 Python 脚本管线完成(read_only 流式读取、WriteOnlyCell 流式写入),中间数据以文件形式在脚本之间流转,模型上下文里只有三类东西:规则文档(固定开销)、输入清单与统计摘要、字段映射决策与审计结果。数据量是十万条还是一百万条,对上下文的影响为零。
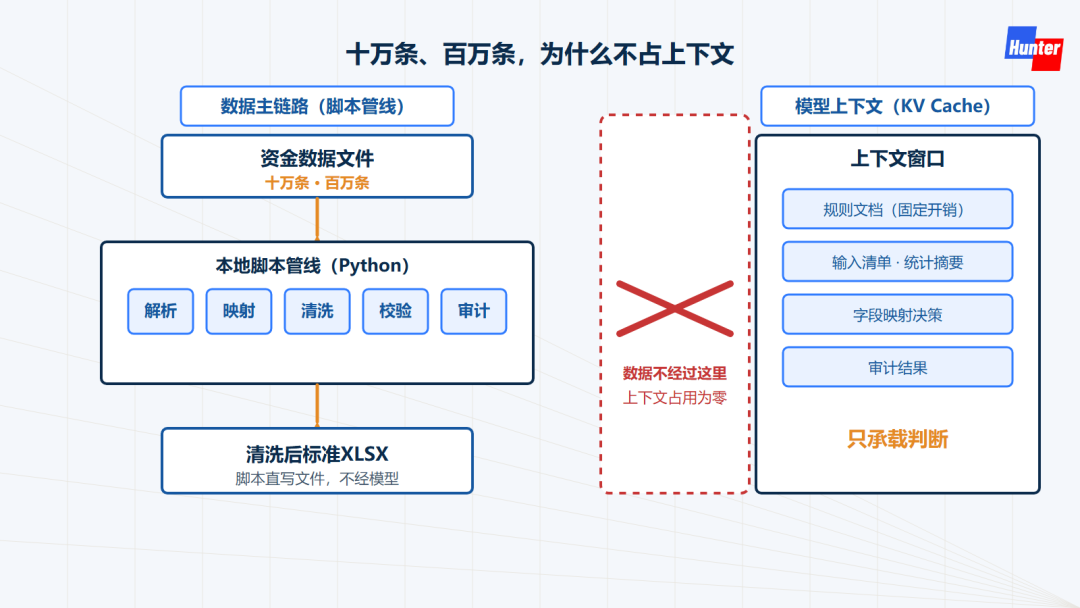
这就是这套skill在架构上最大的优势:别的方案在绞尽脑汁把数据塞进上下文,这套skill直接把数据挡在上下文之外。
那么,真正决定"能洗多大量"的是什么?是脚本处理速度、机器内存、磁盘读写这些线性成本。十万条、一百万条、甚至一千万条,区别只是多等几分钟,不是"能不能"。显存只决定模型窗口的大小,而窗口只用于承载判断——确参、映射决策、审计总结。显存宽裕可以开大窗口做更复杂的映射决策;显存紧张,小窗口模型一样洗百万条。
最后三条使用纪律,务必记住:
数据走文件路径或本地目录,不要整表粘贴进对话; 逐笔审计交给脚本完成,不要让智能体全量复读数十万条资金记录; 确参阶段只给关键信息(输入范围、输出目录、时区、格式),不要整表灌入。
数据清洗的量级,由脚本和硬件决定;上下文的上限,只约束智能体的判断深度。把这两件事分清楚,十万条、百万条,都不是问题——这正是这套skill敢说"百万条也洗得动"的底气。
13边界与申明
【申明】
本文仅作技术交流。
不得非法获取信息、不得超范围调查、不得冒充公职人员。
本skill只处理用户提供或明确授权访问的数据,全程本地运行,不上传原始资金数据到任何远程服务;不修改原始文件,不物理删除任何非空原始记录。
清洗结果是核查底稿,不是鉴定意见。资金分析鉴定须按《公安机关资金分析鉴定工作程序规定(试行)》由具备资质的鉴定机构依程序出具,所有研判结论须经法制审核后方可作为办案参考。
写在最后
长期关注我的朋友知道,从微信人物关系爆炸图skill,到团伙skill,再到今天这套金析-清洗skill
官方把"金析为证"的制度铺好了,把《法庭科学资金数据清洗规程》立起来了,这是国家层面给的方向。我们能做的,是把这条路上最苦最累的第一道工序,做成一套即装即用的工具,递到每一位战友手里。
还是那句话,我们是这个时代的播种者,很开心看到大家也是。
数据清洗是1,资金分析是0。
1立不住,后面多少个0都是空。
我们先把第一步走好。
金析为证,从把数据洗干净开始。
最后说一个期待点:"金析"战法套件,是一组专门为资金案件、经济案件分析打造的战法skill,能在资金分析、经济案件研判中帮上大忙。
今天这套清洗skill,是套件的第一件;
下一个是穿透skill——金析战法套件的第二个重大skill,把清洗好的数据真正"穿透"到底,即将发布。后面还会有更多金析战法套件陆续出来,战友们可以持续关注。
另外说明一点:包括这套金析-清洗skill在内,我发布的所有skill,都原生支持国信智擎的问迹智能线索研判系统(首个侦查研判智能体),可联系试用, 并备注hunter取证推荐。
获取方式
两种永久拥有获取方式,随便挑一个:
第一种:49.9 元直购永久拥有,享有后续升级权限,赞赏后将付款截图私信我并备注已付款,或添加微信付款并截图给我,我直接发你。
第二种:免费获取:关注、点赞、推荐、转发+朋友圈集齐至少 88 个点赞,享有后续升级权限,截图私信我并备注,添加微信并截图给我,我直接发你。
添加联系方式请备注来意~
拿到之后如果觉得好用,记得评论你的体验,让更多战友看到。
你们的支持,就是我继续做这件事最大的动力!
关注我,你就是那个一个人能顶一个组的人!