一口气拆穿底层逻辑
内容整理自视频号 / B站 UP 主「飞天闪客」:《名词诈骗!一口气拆穿 Skill / MCP / RAG / Agent / OpenClaw 底层逻辑》。以下为视频核心观点梳理。
智能体、RAG、Skill、MCP、Function Calling、OpenClaw……过去两年,AI 圈冒出的新名词比互联网营销话术还多。它们到底是革命性突破,还是换了个马甲的老概念?
今天用最直白的话,把这五个词一次性讲透。
▲ 视频截图:AI 圈的“名词轰炸”——Claude Code、Clawbot、OpenClaw、Cursor、Manus……
先把地基打好。语言模型干的事特别简单:给定前文,预测下一个词。
比如输入“我爱吃”,它算的其实是下一个词的概率分布——“火锅”30%、“苹果”25%、“屎”0.001%。就这么个“文字接龙”游戏。
那它为什么突然变“聪明”了?因为当参数规模突破某个临界点,模型“涌现”出近似智能的能力。于是人们给它加了个“大”字——大语言模型(LLM),说白了就是为了跟早期那些“智障模型”划清界限。
至于“对话”?模型本身只有一问一答。所谓多轮对话,是人把历史问答串起来、伪装成多人聊天,再一起塞进下一轮的上下文里。
从“大语言模型”开始,概念发明狂欢正式开场。
这是被误解最深的一个词。
很多人以为 Agent = 一个能自主行动的智能生命体。但真实的技术实现是这样:你问“帮我搜下今天的新闻”→ 大模型自己上不了网 → 需要一个中间程序去调搜索引擎 → 结果再回喂给大模型 → 大模型整理后回复你。
这个中间程序,就是 Agent。
它干的活儿大部分其实“不智能”——拼 URL、解析 JSON、调 API。真正需要动脑子的部分(理解意图、决定调哪个工具、整理结果),才交给大模型。
一句话总结:把不需要智能的部分程序化,只把模糊逻辑交给大模型处理。
大模型有个致命毛病:幻觉。没依据也能一本正经地编。
RAG(Retrieval-Augmented Generation,检索增强生成)就是治它的药:
① 把你的文档切片 → 向量化 → 存进向量数据库;
② 用户提问时,先做语义匹配,捞出最相关的几段;
③ 把捞到的内容塞进大模型的上下文;
④ 大模型基于这些真实材料生成回答。
说穿了,RAG 就是让大模型“开卷考试”——不许凭空编,先翻书,再回答。
这也是为什么客服机器人、企业知识库都爱用 RAG:幻觉率降下来了,答案有据可查。
一句话总结:先检索、再生成,让模型“有据可依”地作答。
用一句类比就能分清它们:
关键结论:Skill 和 MCP 不是竞争关系,是不同层次的东西。MCP 管“怎么调”,Skill 管“调什么、怎么组合着用”。
一句话总结:Function Calling 解决“模型怎么开口要”,MCP 解决“Agent 怎么统一调”,Skill 解决“能力怎么打包复用”。
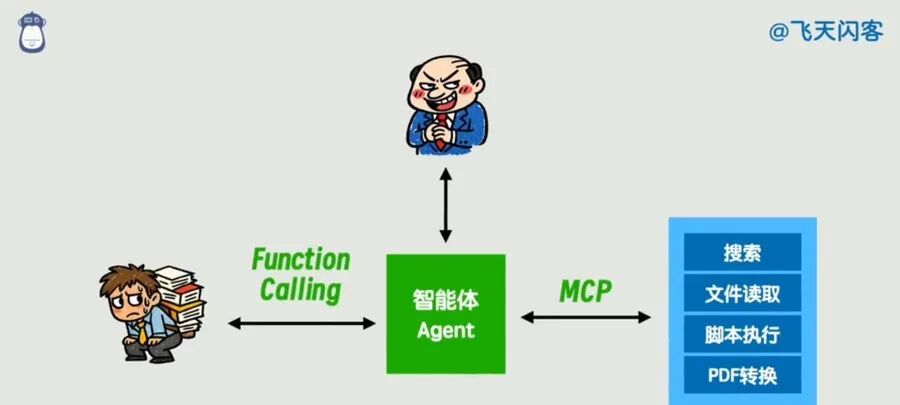
▲ 视频截图:Function Calling ↔ 智能体 Agent ↔ MCP,以及 MCP 挂载的工具(搜索 / 文件读取 / 脚本执行 / PDF 转换)
视频里给了一个很有价值的框架:所有 AI 技术,本质上都落在这条从“刚性”到“柔性”的光谱上。
稳定、便宜 ◀━━━━━━━━━━▶ 灵活、贵
硬编码:用代码写死每一步流程,确定性最高,但完全不灵活。
工作流(Workflow):低代码可视化把步骤连线,比硬编码灵活一点,但流程仍是预设的。
Skill:可插拔的脚本目录 + 说明文档,Agent 按上下文挑着用,更灵活,但仍依赖预置。
纯 Agent:完全由大模型自主决策每一步,最灵活,但 token 烧得最狠、稳定性最低。
核心洞察:稳定性和灵活性是一对跷跷板。眼下大多数产品,都在这条光谱上找自己的平衡点。
把所有花哨的名词剥掉,会发现它们干的是同一件事:更高效地利用大模型和提示词。
终极结论:当下所有 AI 新概念,本质上都是“自动化提示词工程”的不同包装。
而当前最大的拦路虎,是 token 成本。随着价格一路走低,这道坎会慢慢消失。
判断一:技术概念终将被产品体验取代。
普通用户不关心 SpringBoot 的底层原理,未来也不会有用户去区分 RAG 和 MCP——他们只问一句:好不好用,能不能解决问题。
判断二:胜出的形态是“零配置的超级 Agent”。
常用能力全部打包好,用户不用配 Skill、不用懂 MCP 协议、不用写 prompt,打开就能用。谁能把门槛压到最低,谁就能跑出来。
名词会一直翻新,但底层逻辑是相通的:让 AI 从“能说”进化到“能做”。
看懂这条主线,就不容易被下一个新词唬住——也不会被下一个“名词诈骗”割了韭菜。
观点来源:飞天闪客|内容整理与二次撰写
如果觉得有用,欢迎点赞、在看、转发给还在被名词绕晕的朋友