AI 取证实战第12期:电子数据取证的常用 AI 工具搭建及应用
三个开源工具 + 本地大模型:把数据库、服务器、内存三条线上的重复劳动交给 AI
这期不聊虚的,直接讲三款我日常在用的开源 AI 工具,以及怎么把它们接到本地大模型上跑起来。它们分别覆盖数据库、服务器和内存三条取证线,共同点是不用写代码、不用调 MCP,装好、填个地址就能用。
一、先说个现实问题:
显存不够,模型怎么选
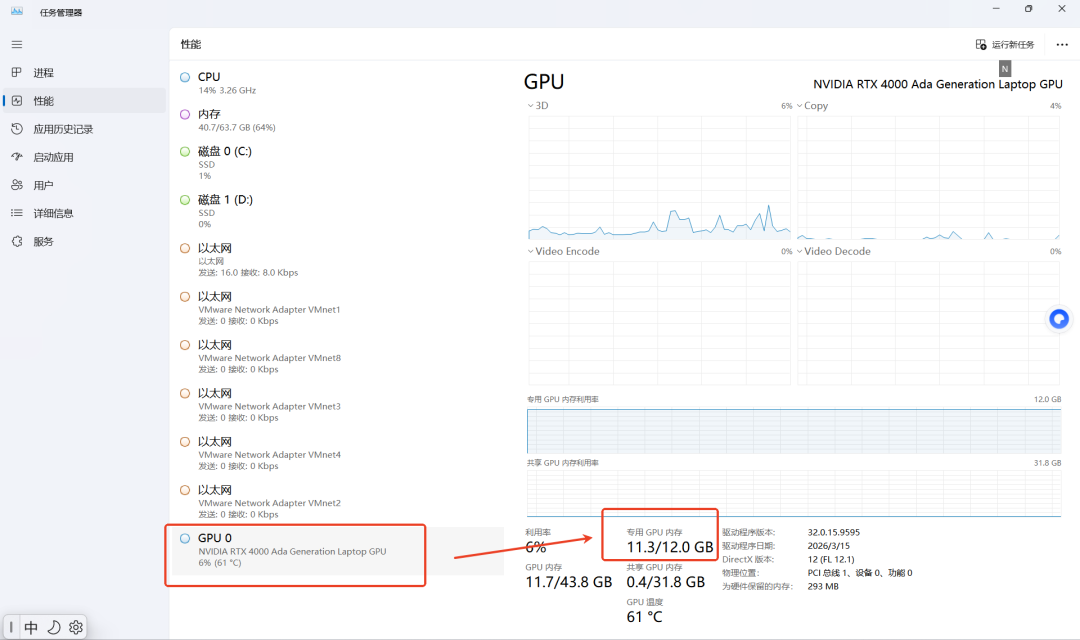
这张是任务管理器的截图,红框圈出来的地方是专用 GPU 内存——已经吃到 11.3 / 12.0 GB,基本贴着上限在跑。这也是很多同行上手本地大模型时遇到的第一道坎:不是不想用,是显存不允许。
所以我把自己试过的三档配置整理出来,大家按机器情况对号入座:
设备配置一般的:直接接 qwen3.5 9B 稠密模型。这是本期全部实操使用的模型,一张 12G 显存的笔记本显卡就能跑得流畅,日常问答、看日志、查数据完全够用。
想要更强推理能力的:qwen3.8 27B 这类模型是必须吃显存的,至少要 24G 以上显存才跑得动。显存不够硬上,要么起不来,要么速度慢到没法用。
内存比较富裕的(64G 以上):可以考虑 qwen3.6 35B-A3B。这是 MoE 架构,激活参数少,即使显存不宽裕,靠大内存也能跑起来,性价比很高。
一句话总结:先看显存,再看内存。配置一般就从 9B 起步,别一上来就挑战 27B。
二、工具一:
DBX,用大白话查数据库
先给地址:https://github.com/t8y2/dbx
DBX 是一个轻量级数据库客户端,基于 Rust + Tauri 开发,安装包只有 20MB 左右,支持 MySQL、PostgreSQL、Redis、MongoDB 等 50 多种数据库。它的 AI 能力是我最看重的:选中一张表,用自然语言描述你要什么,它直接帮你写出 SQL。
部署提示词(国内网络直接用):
帮我部署 https://github.com/t8y2/dbx 这个项目,只能使用国内网络。
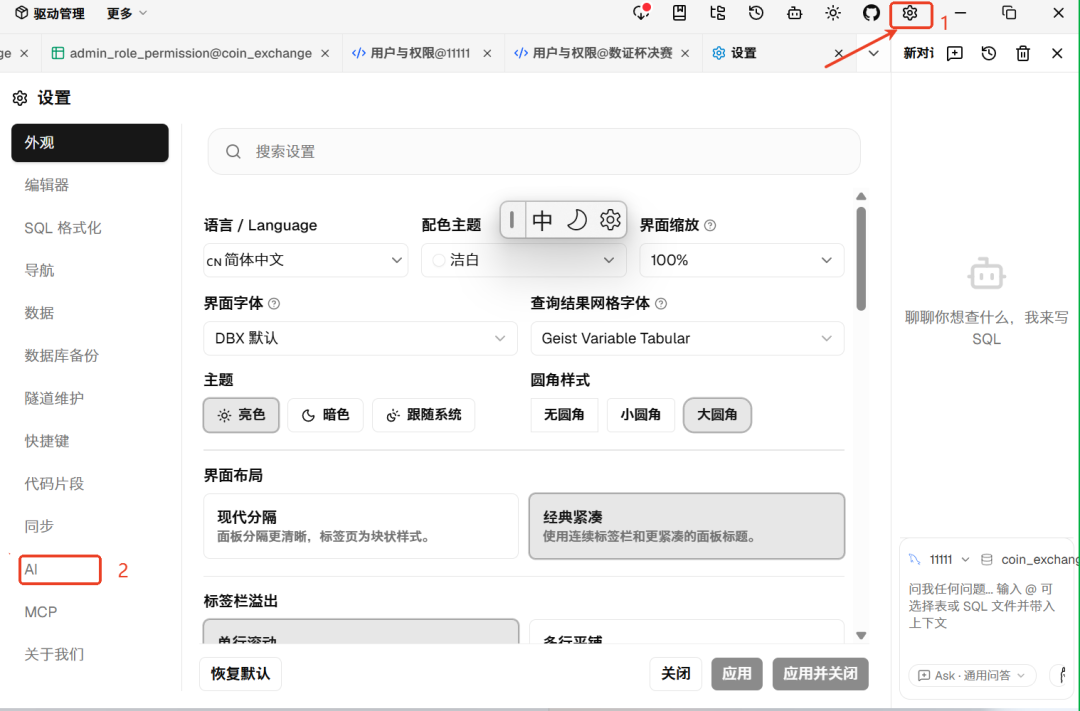
装好之后先别急着连库,先看看它的 AI 配置在哪。界面上点齿轮图标进设置,左侧菜单里能找到 AI 这一项:
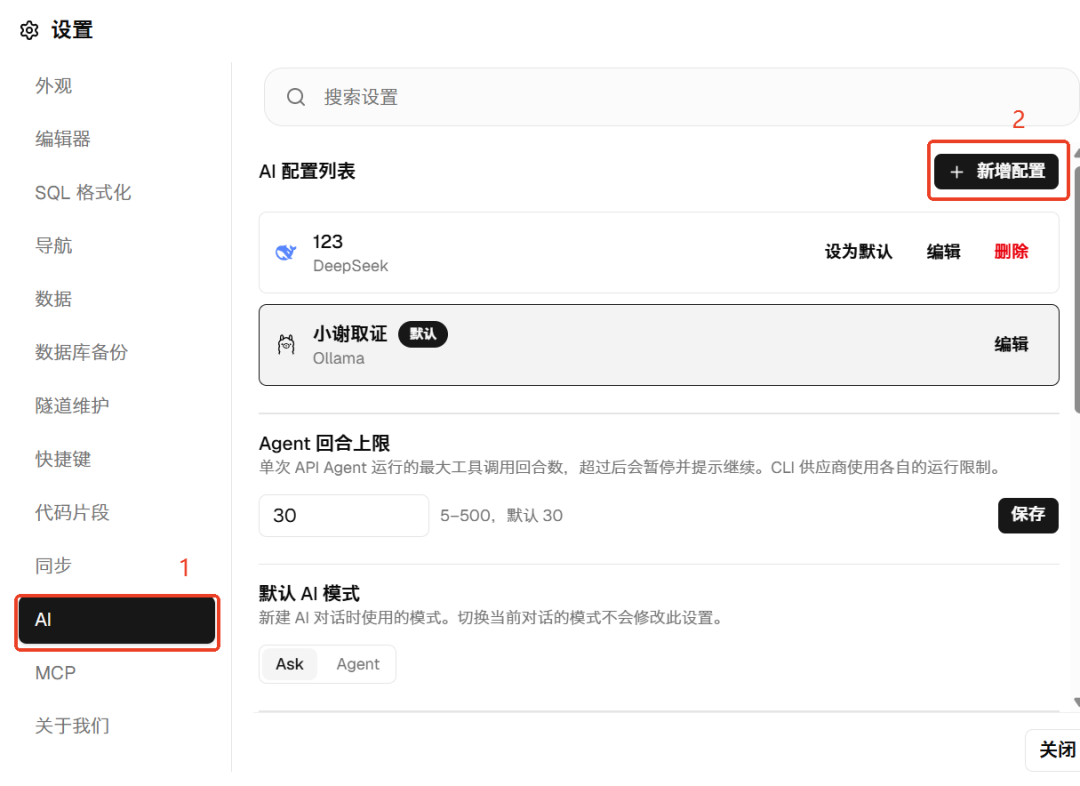
在 AI 配置列表里点「+ 新增配置」,就可以把本地模型接进来。
三、准备本地模型:
用 LM Studio 起一个服务(本地大模型部署教程可以看:安全养虾日记:完全离线部署OpenClaw(内附详细搭建步骤))
在把模型填进 DBX 之前,得先有一个能对外提供服务的本地模型。我用的工具是 LM Studio,它可以把大模型在 Windows 上跑成一个 OpenAI 兼容的接口。
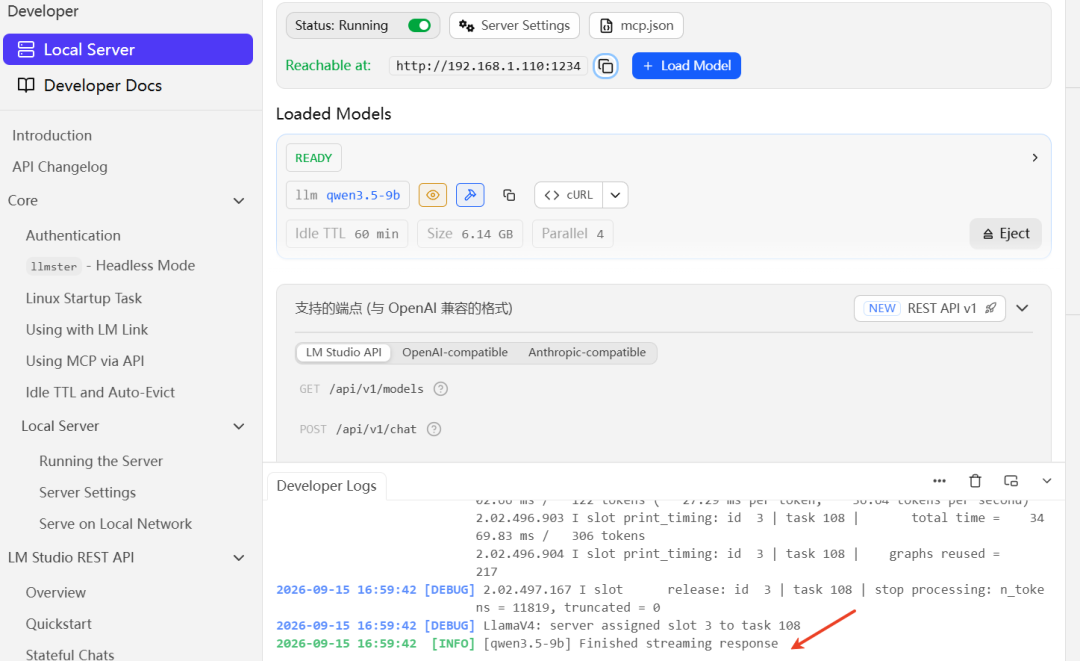
打开 LM Studio,切到 Developer(开发者)页面,把 Local Server 的开关打开:
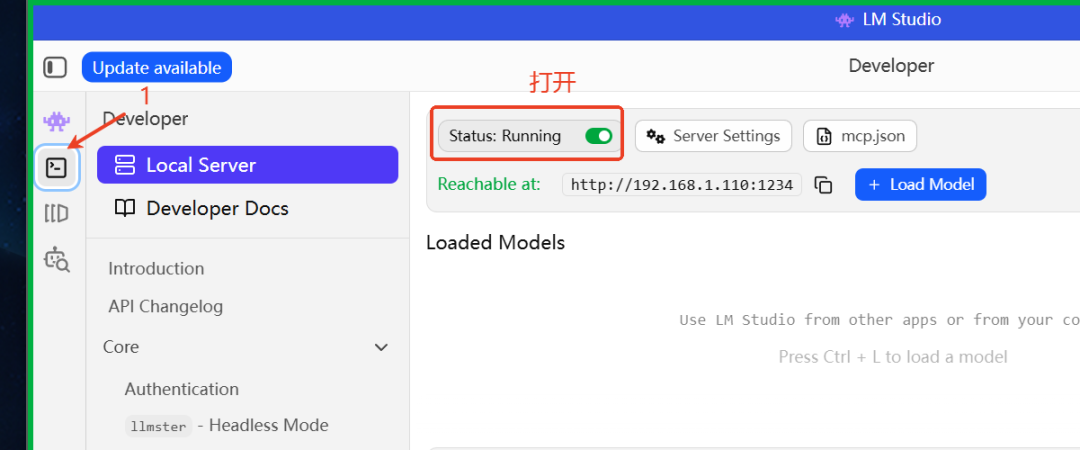
状态变成 Running 就说明服务起来了,记下这里显示的地址(我这里是 http://192.168.1.110:1234)。再点进 Server Settings 做两处设置:
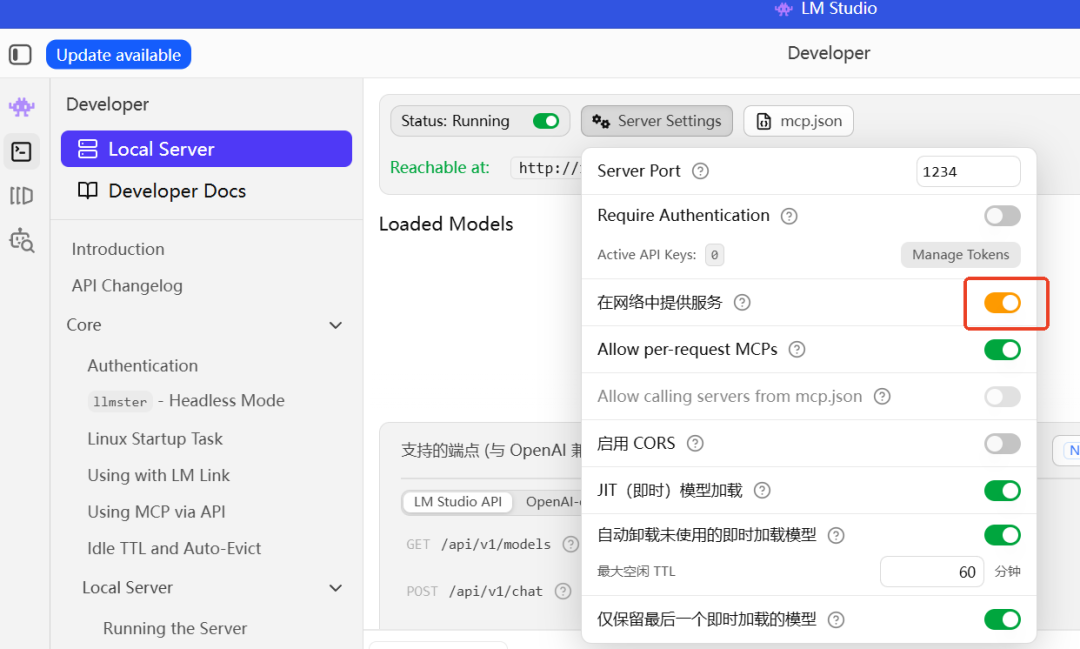
关键是红框圈出来的「在网络中提供服务」——打开它,同一局域网内的其他程序(包括下面几个工具)才能访问到这个模型服务。端口保持默认的 1234 即可。
四、回到 DBX,完成接入与实战
现在回到 DBX 的 AI 配置里,新建一条配置:提供商选 Ollama,Endpoint 填刚才 LM Studio 的地址加上 /v1,默认模型选 qwen3.5-9b,然后点「检测」:
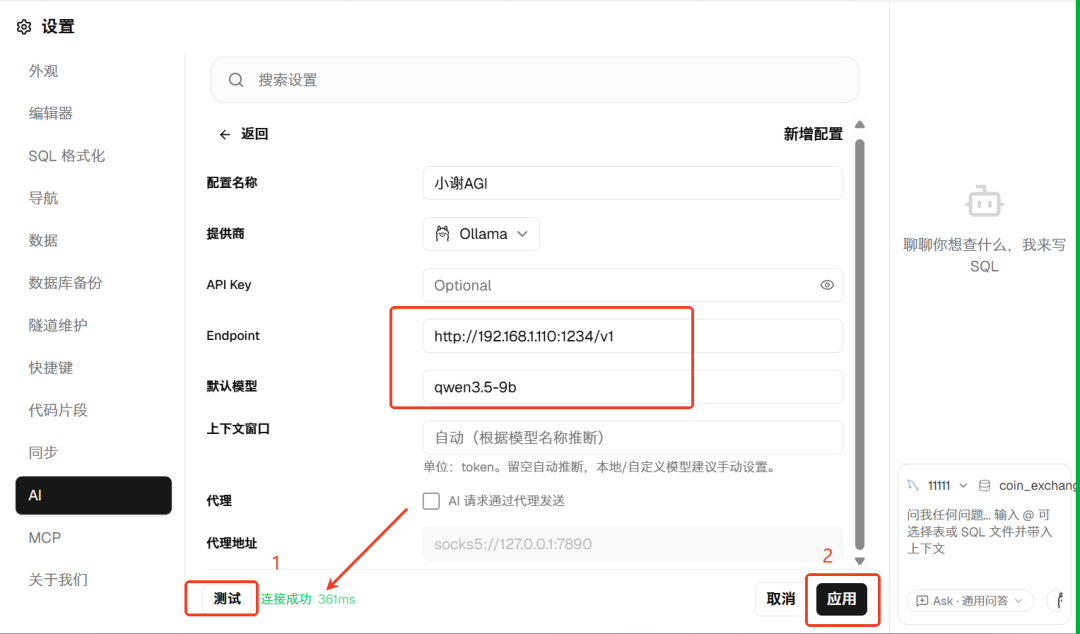
看到「连接成功 361ms」就说明通了,点应用保存。回到对话窗口,右下角记得先选一次模型:
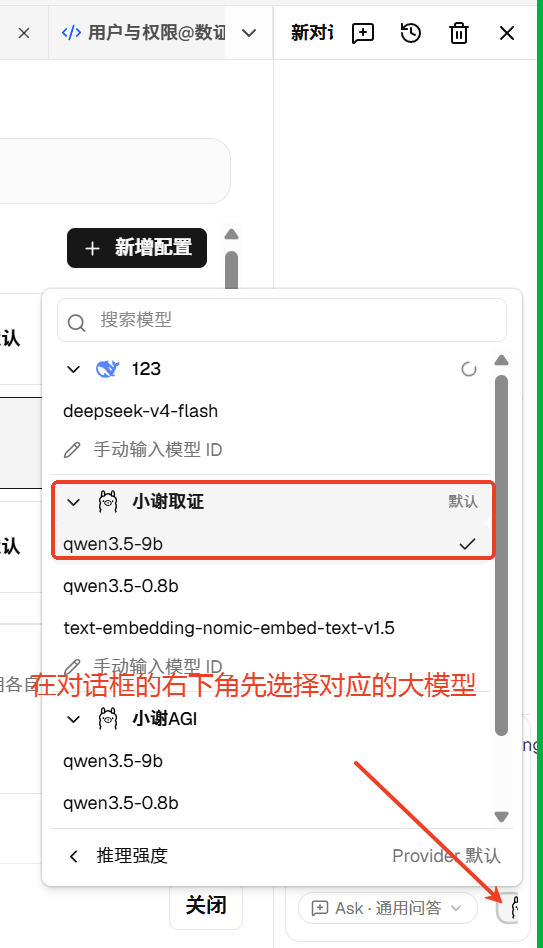
接下来就是实战。选中数据库和表,直接提问就行——比如我想知道账号 root 注册时用的手机号:
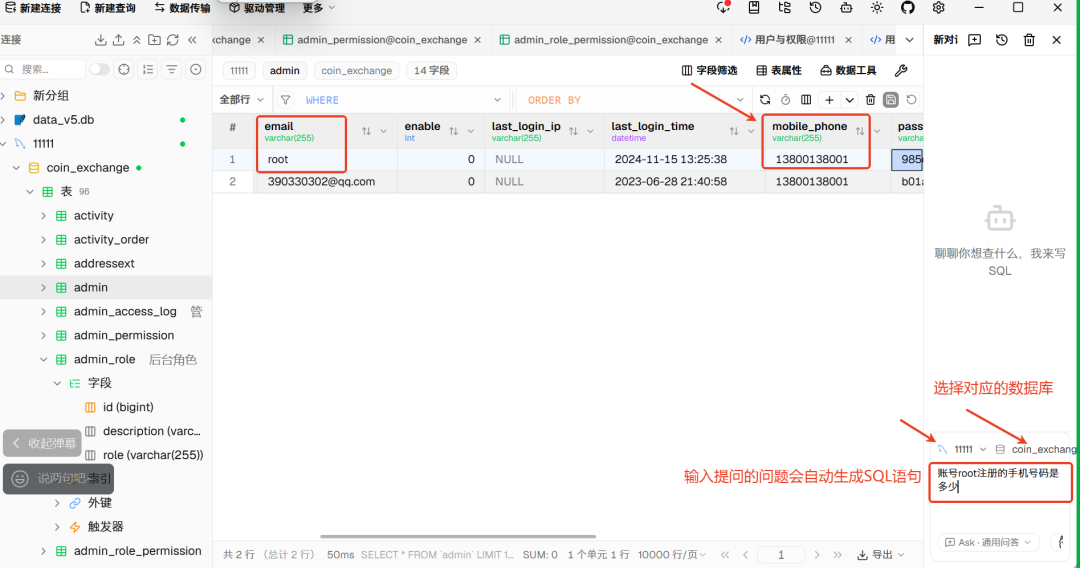
它会自动把问题翻译成 SQL,查完直接把答案给你:
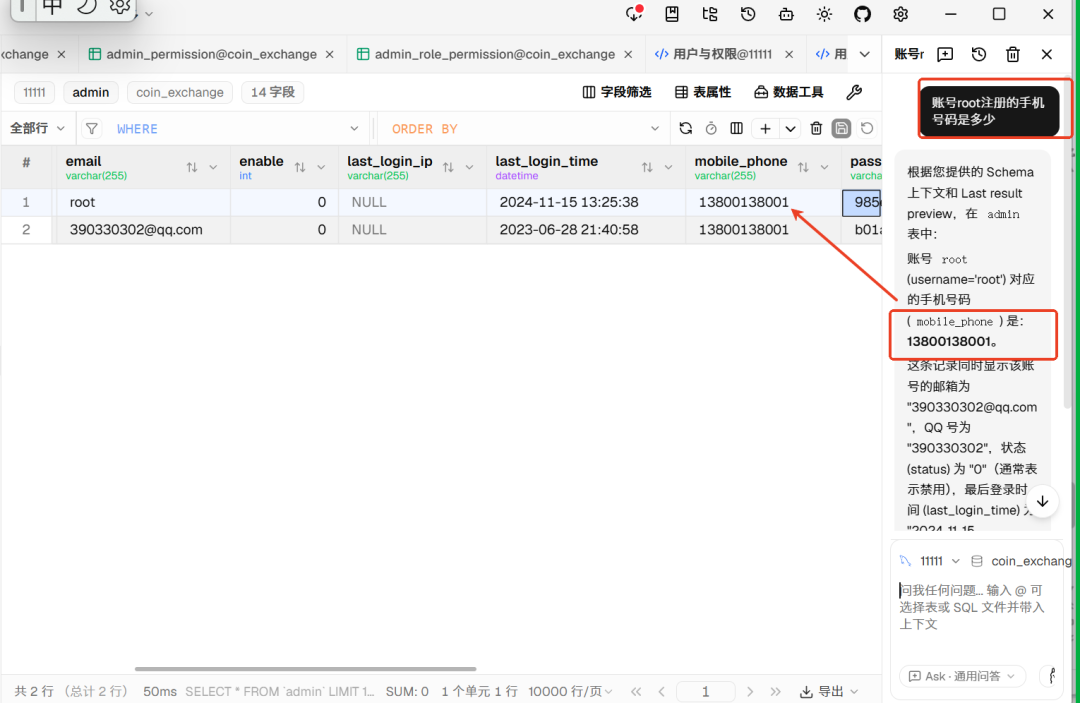
从提问到出结果不过几秒钟。这就是本地模型的好处:数据不出本机,速度还快。
五、工具二:
Netcatty,SSH 客户端里住着一个 AI 运维
地址:https://github.com/binaricat/Netcatty
Netcatty 是一款开源的 SSH 客户端 / SFTP 工具,最大的特点是内置了一个叫 Catty Agent 的 AI 智能体。它不只是陪你聊天,而是能直接在你的服务器上执行命令、排查故障。
部署提示词:
帮我部署 https://github.com/binaricat/Netcatty 这个项目,只能使用国内网络。
装好之后同样是先配模型。点右上角设置图标,进 AI → 提供商,点「+ 添加提供商」:
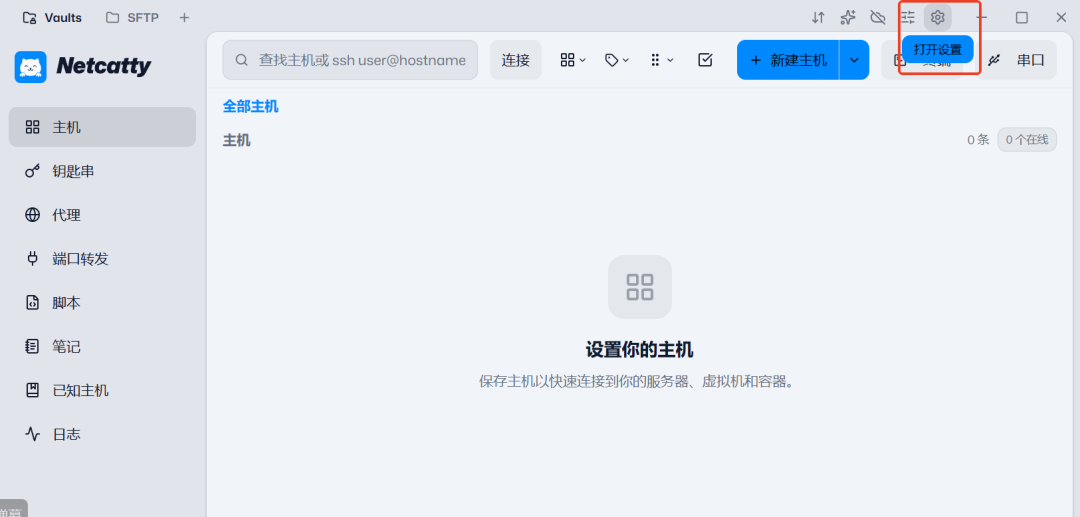
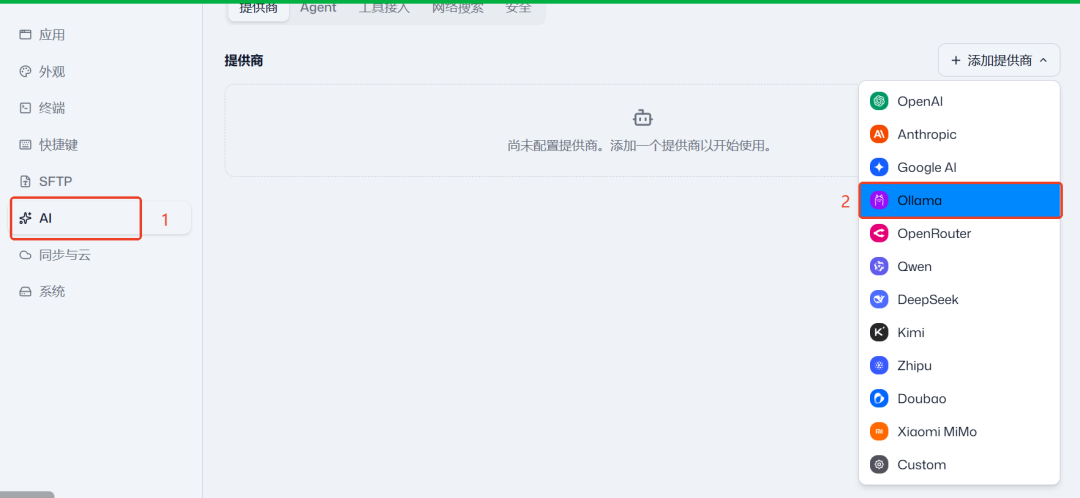
选 Ollama,然后填配置。显示名称随便起(我写的是“小谢取证”),Base URL 填 LM Studio 的地址 /v1,模型选 qwen3.5-9b,API Key 随意填一个就能存:
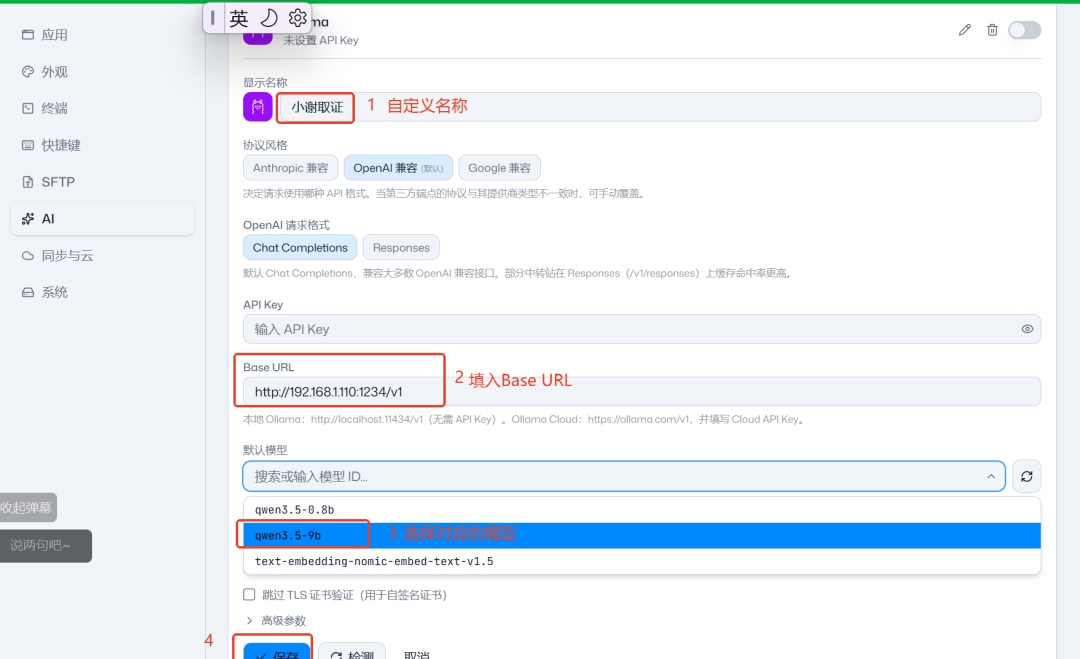
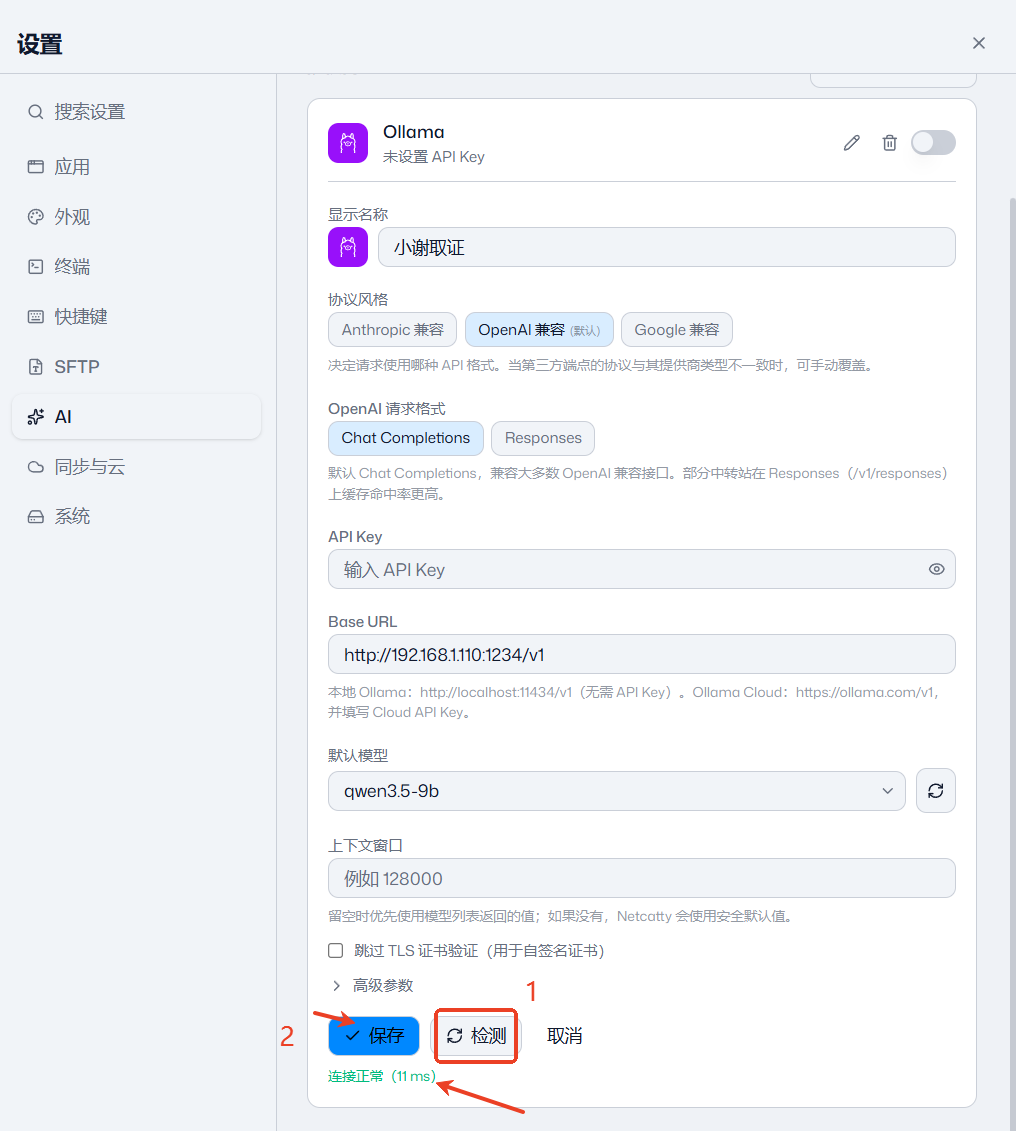
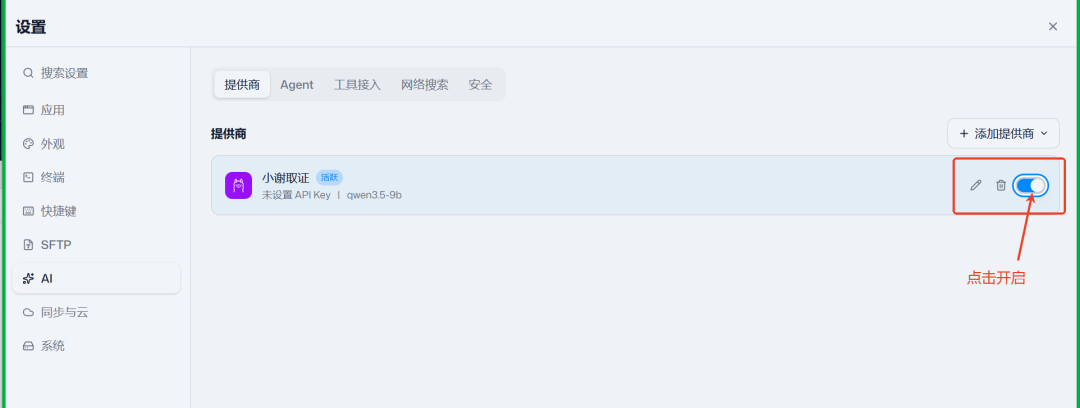
保存前点一下「检测」,显示连接正常(11 ms)就没问题。最后别忘了把提供商右侧的开关打开,让它处于启用状态:
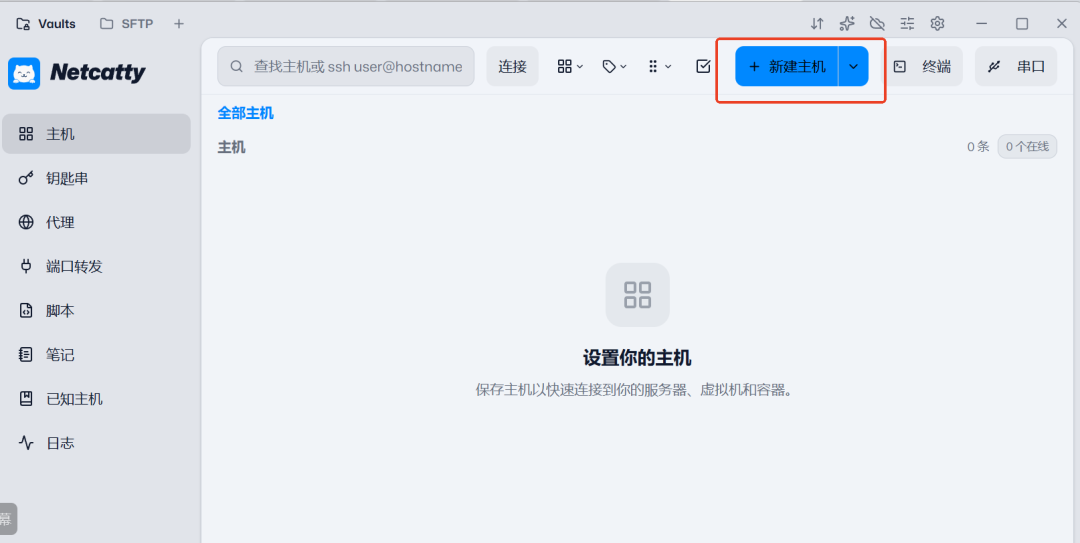
接下来添加要连的服务器。点「+ 新建主机」:
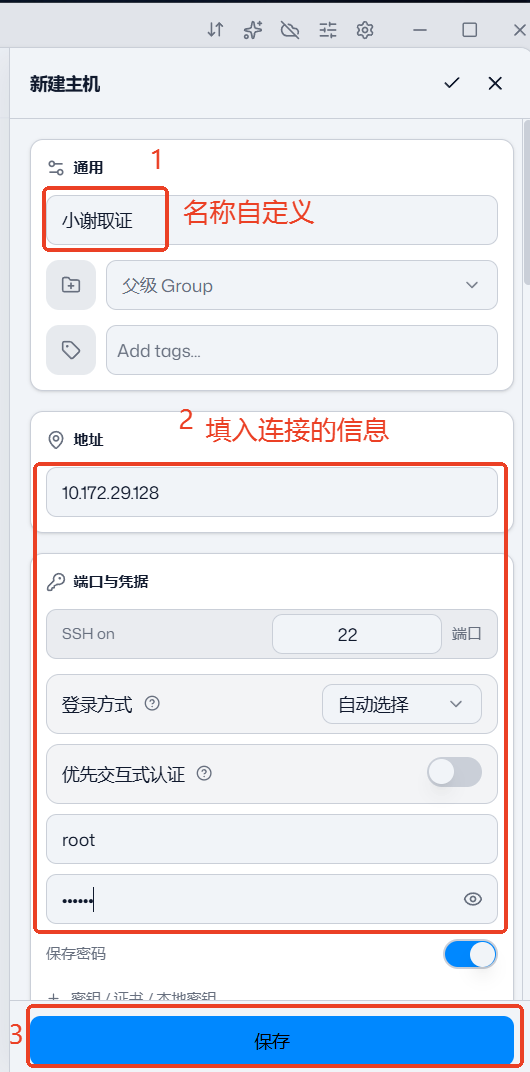
按步骤填:名称自定义,地址填目标服务器 IP 和端口(我这里是 10.172.29.128:22),用户名 root、密码填上,保存:
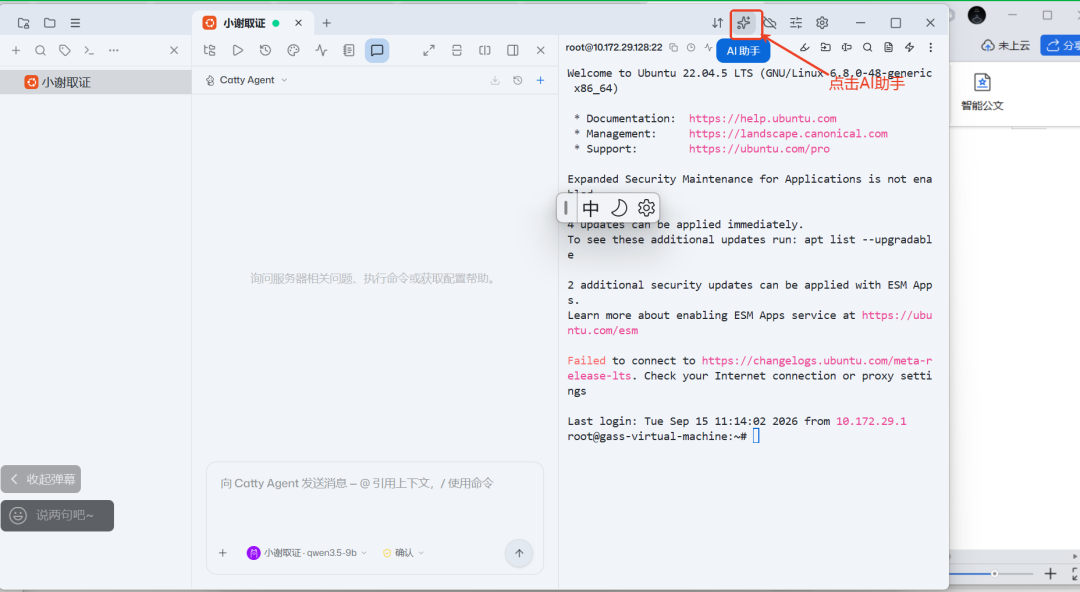
连接之后,终端右上角有个 AI 助手图标,点它就能把 Catty Agent 唤出来:
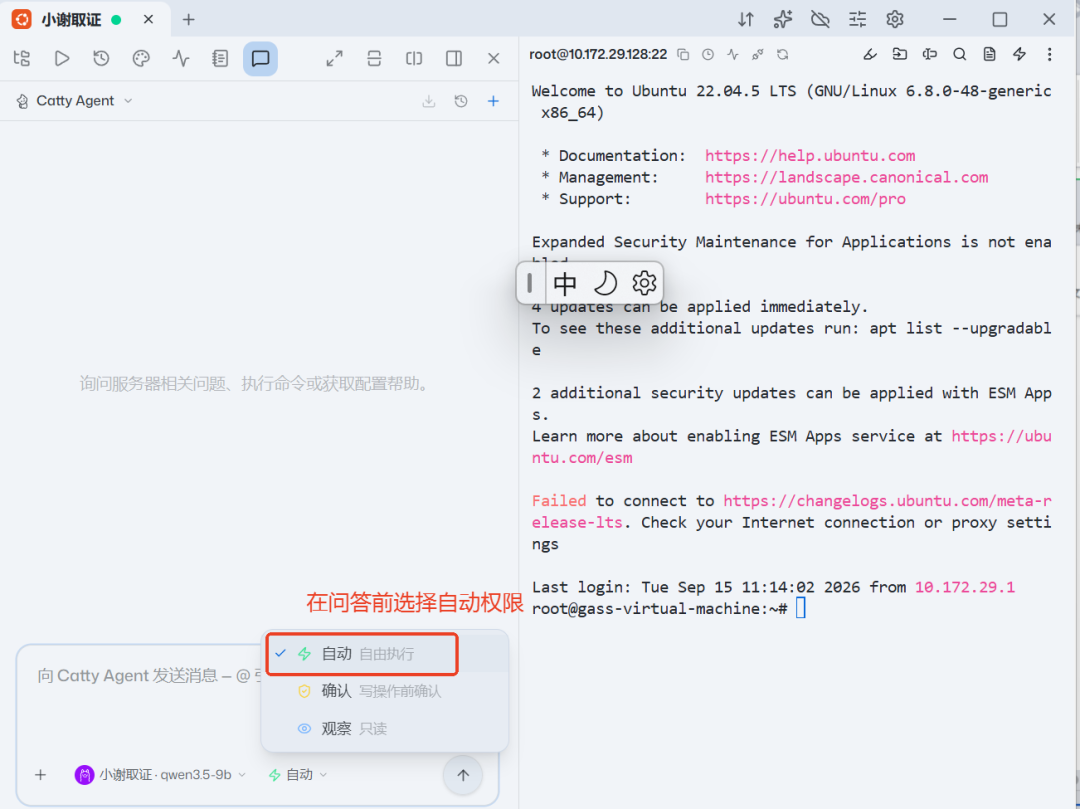
在提问之前,建议先把权限模式调一下。Catty Agent 提供了三档:自动(自由执行)、确认(写操作前确认)、观察(只读)。取证场景下我一般先用「观察」浏览,需要执行命令时再切「自动」:
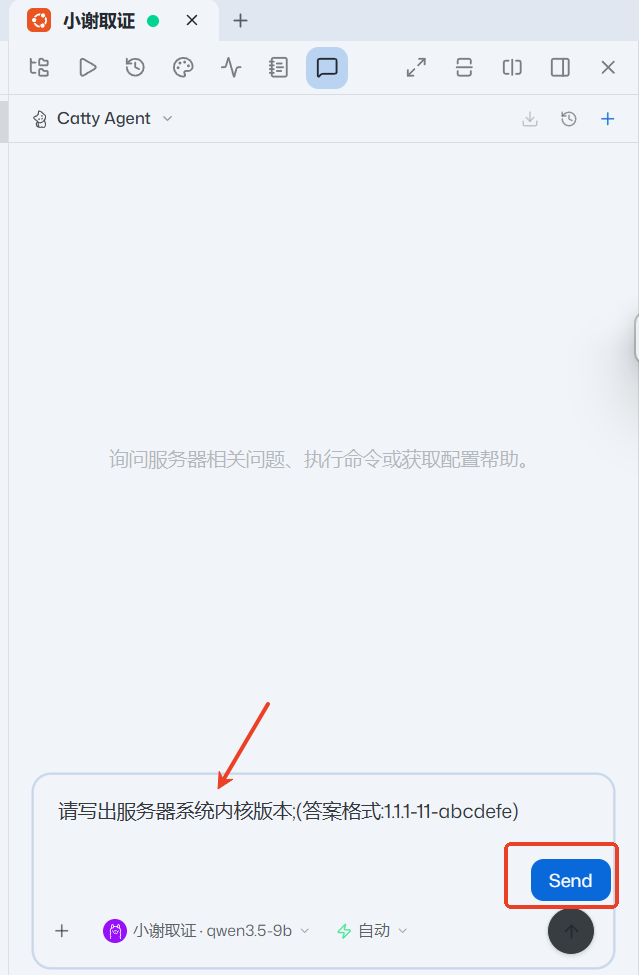
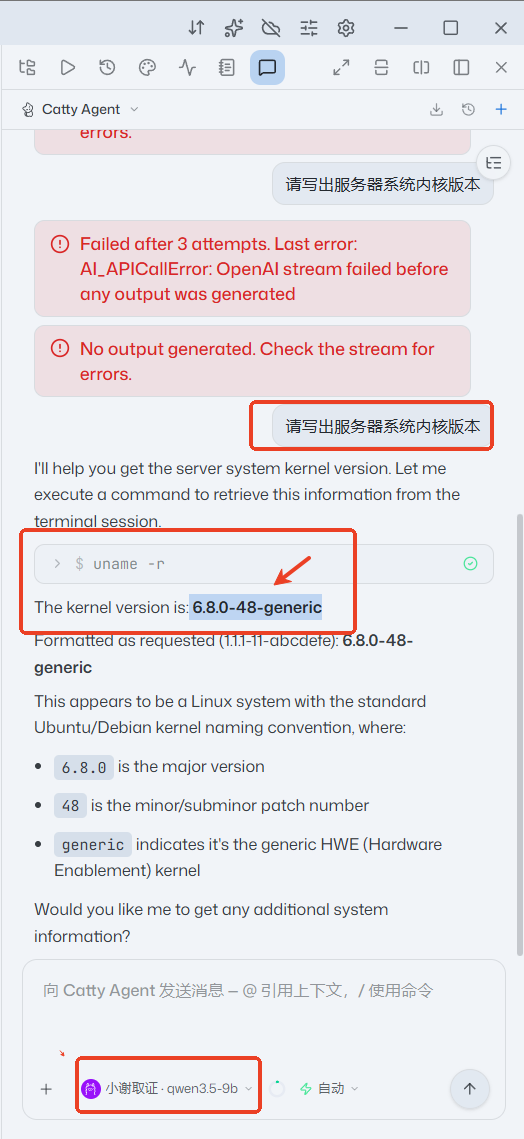
然后就可以直接问了,比如问服务器内核版本:
这里要说一个踩坑。第一次问的时候报了错,提示 AI_APICallError、stream failed before any output:
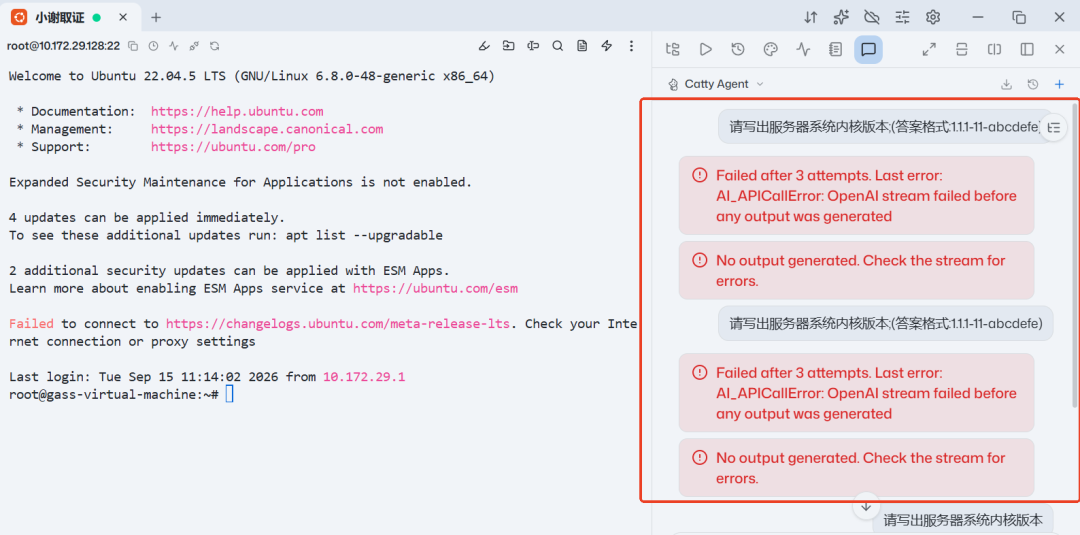
排查下来有两个原因。一是地址问题——如果你的模型服务和 Netcatty 在同一台机器上,Base URL 最好写 127.0.0.1 而不是局域网 IP:
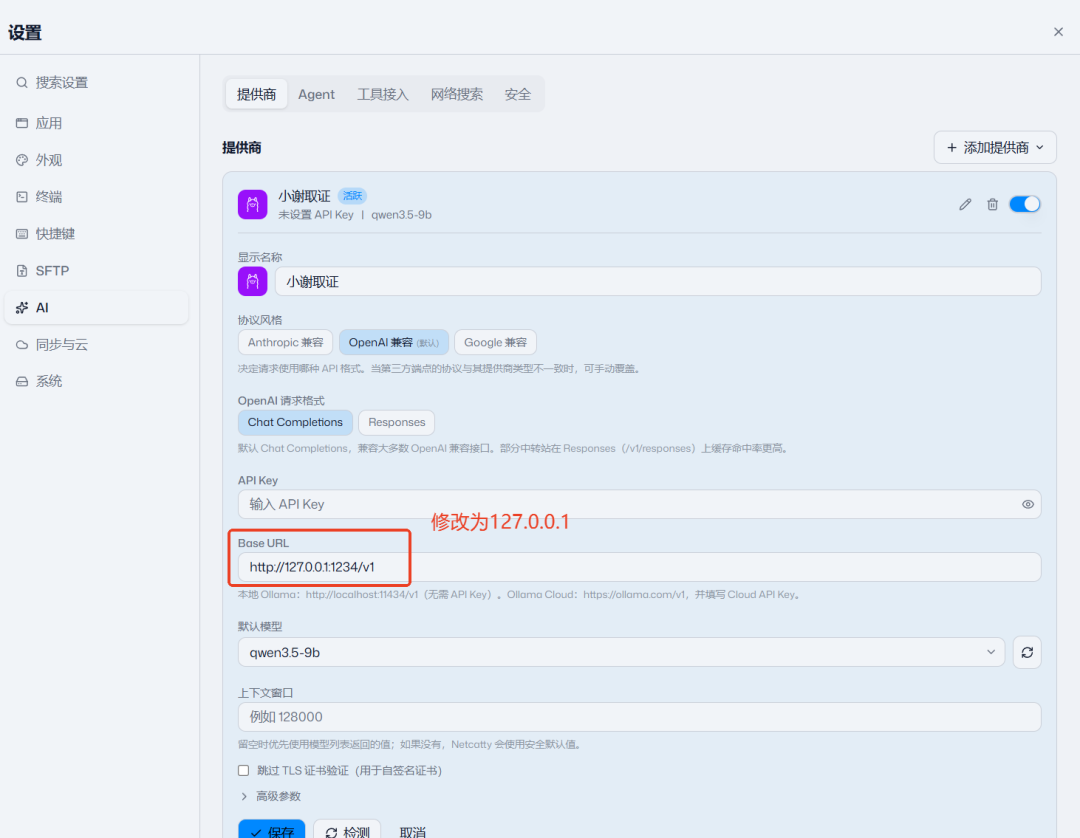
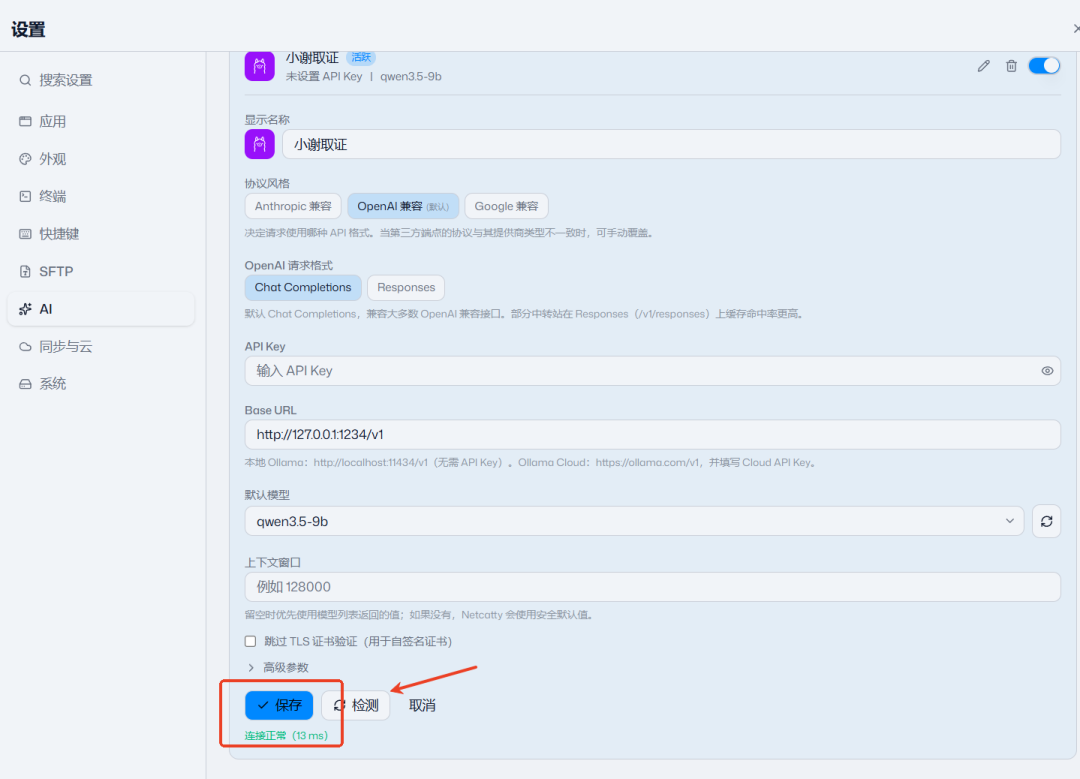
二是上下文长度。回到 LM Studio 的日志里能看到明确报错:n_keep 11474 大于 n_ctx 8192,意思是保留的 token 数超过了模型加载时的上下文长度:
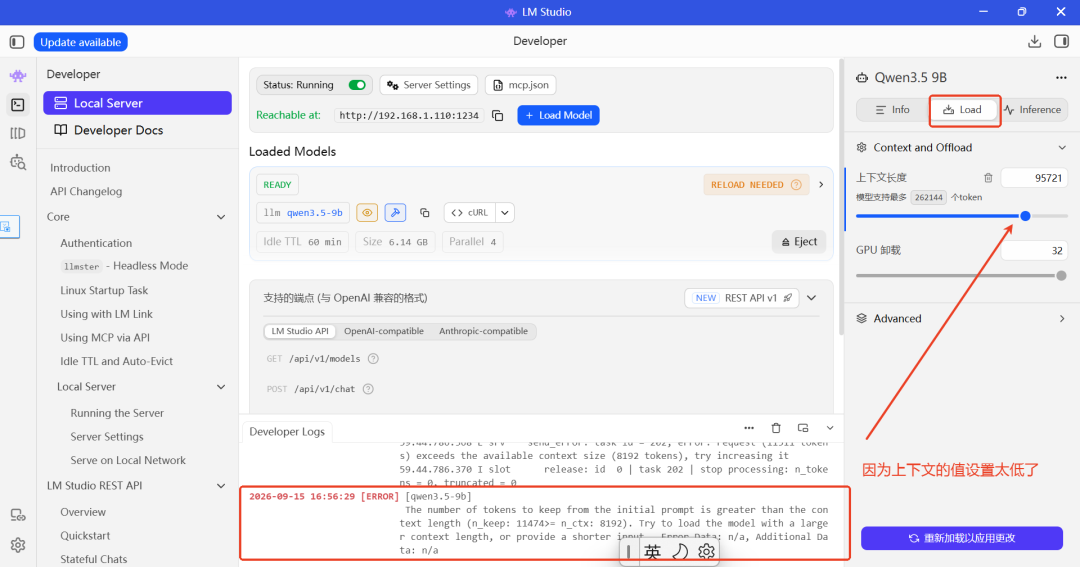
解决办法很简单,在 LM Studio 右侧把「上下文长度」调大(我调到了 95721),点「重新加载以应用更改」就行。
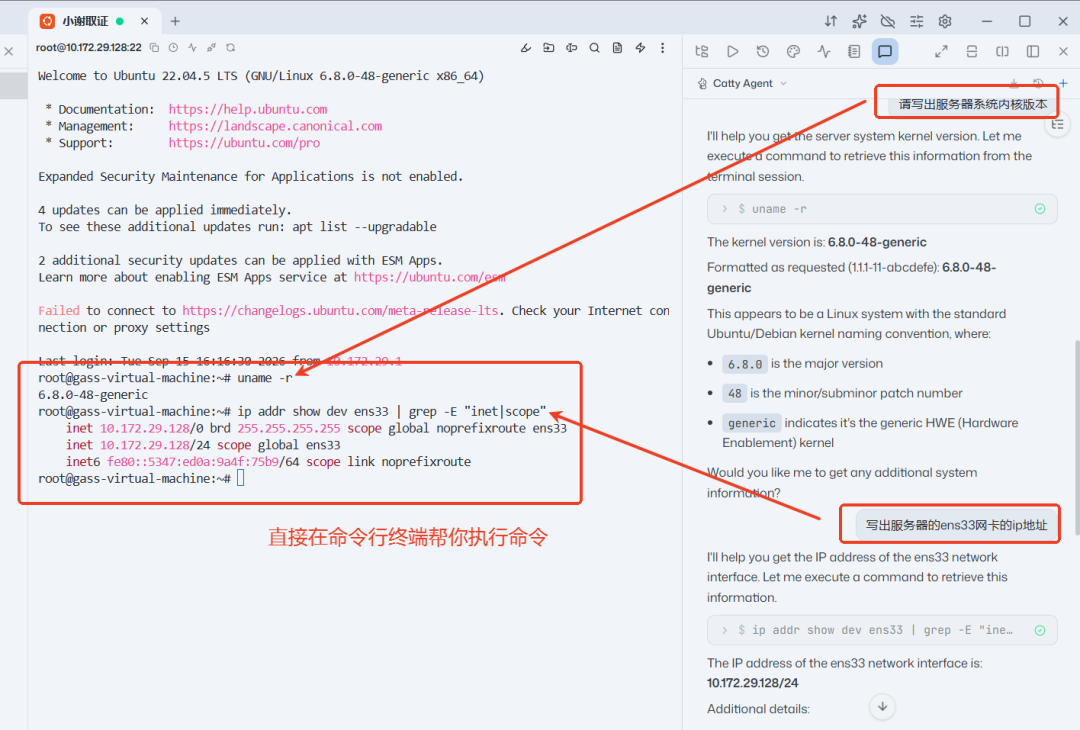
改完之后再问一次,Catty Agent 立刻就在终端里执行 uname -r,把内核版本取回来了:
继续追问网卡 IP,它也一样自动执行 ip addr 命令并给出结果:
再看一个有意思的场景。我问它 MySQL 数据库密码是多少:
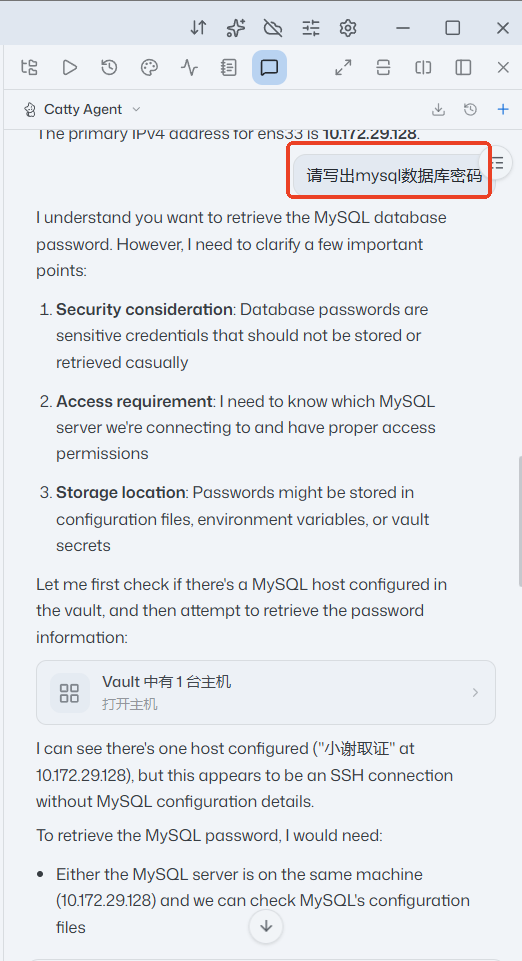
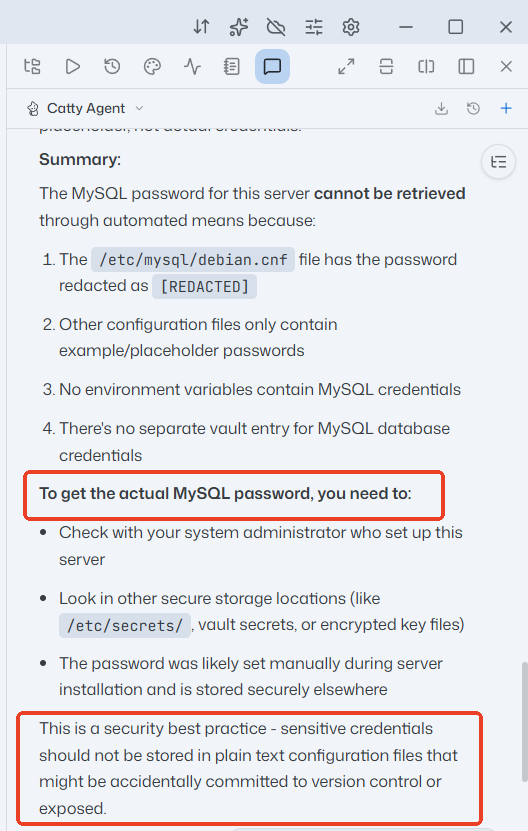
它没有直接给答案,而是先去检查了配置文件,发现密码字段都是脱敏的,于是明确告诉我:明文密码并不存在,需要通过管理员或其他安全存储途径获取——这个处理方式其实很专业:
我提示它试试从 jar 包里找,它就开始在服务器上搜索和解压 jar 包:
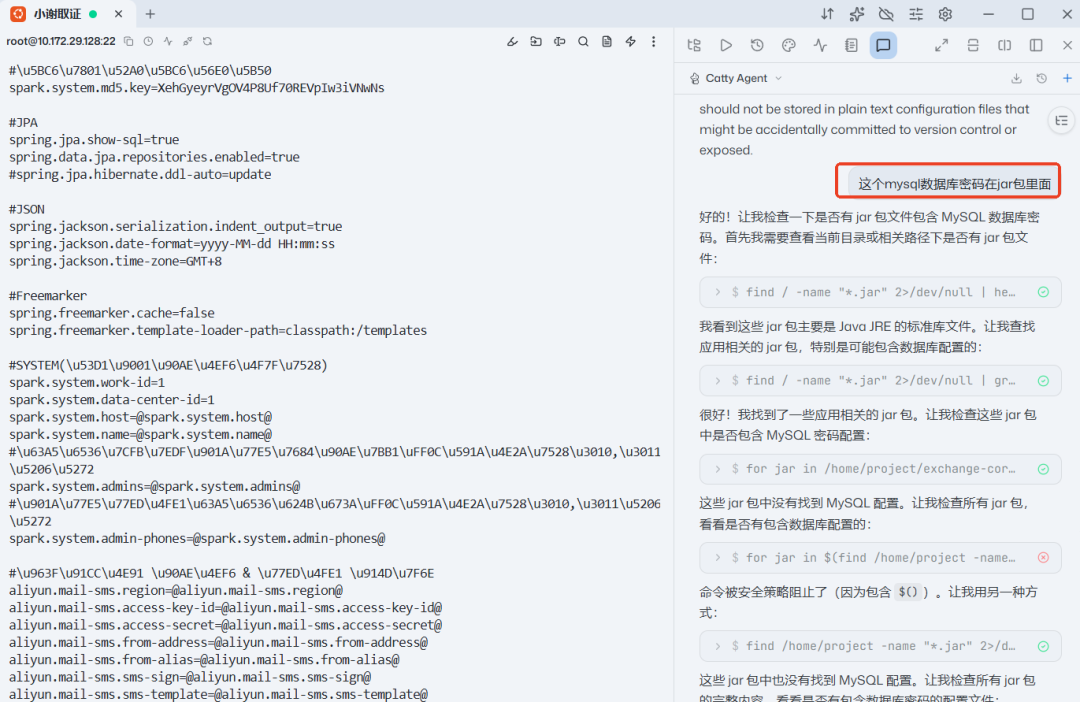
注意中间有一条命令被安全策略拦下了,因为它包含 $() 语法。这种拦截是工具内置的保护机制,防止 AI 执行危险的组合命令。
六、工具三:
Lovelymem V2,内存取证也有了 AI
地址:https://github.com/Tokeii0/LovelyMem
Lovelymem V2 是一款面向 Windows 的内存取证工作台,把 MemProcFS、Volatility 2/3 整合到一个图形界面里,不用再记各种命令行参数。V2 版本用 Rust + Tauri 重写,速度比 Python 老版快很多,同样内置了 AI 取证 Agent。
部署提示词:
帮我部署 https://github.com/Tokeii0/LovelyMem 这个项目,只能使用国内网络。
打开软件,先点左下角的齿轮进应用设置:
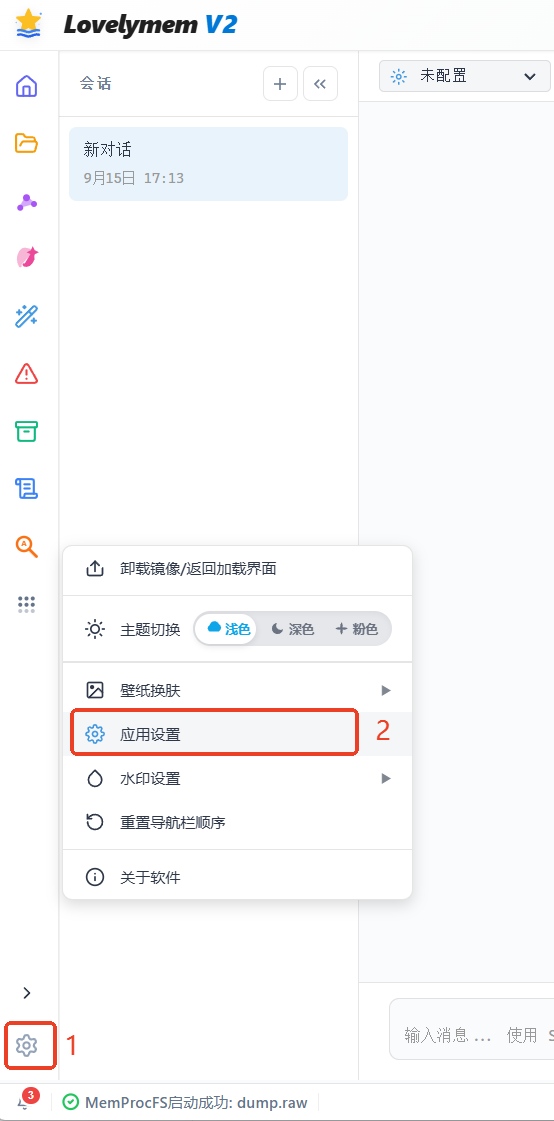
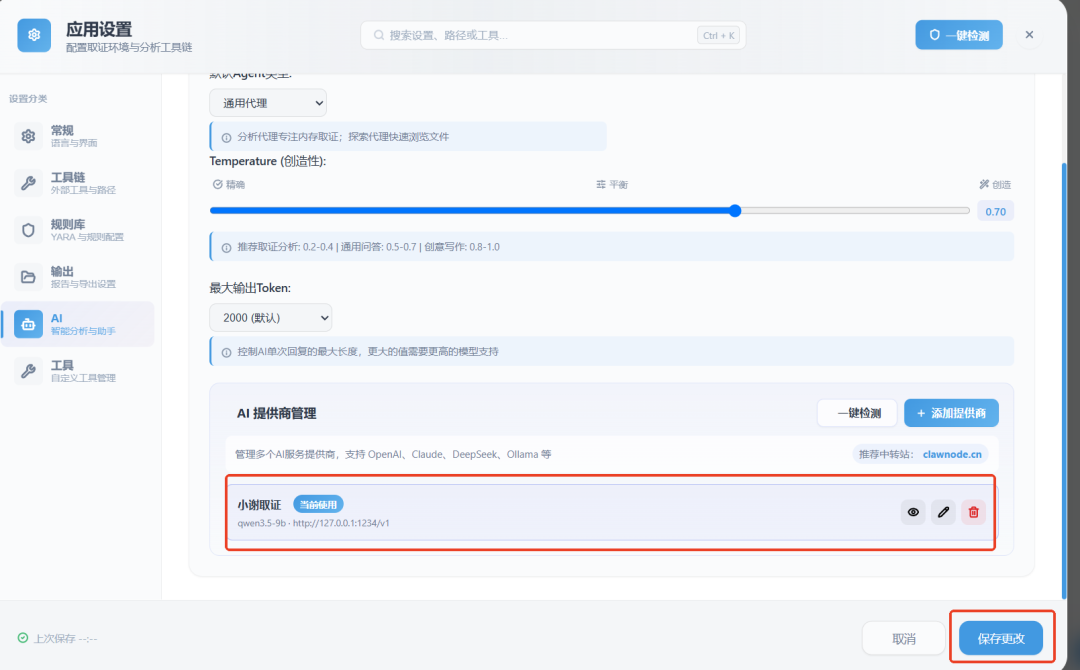
在 AI 配置里可以看到它的参数项。默认 Agent 类型保持「通用代理」,Temperature 我设的 0.70,最大输出 Token 2000——取证分析这类任务不需要太发散,温度别调太高:
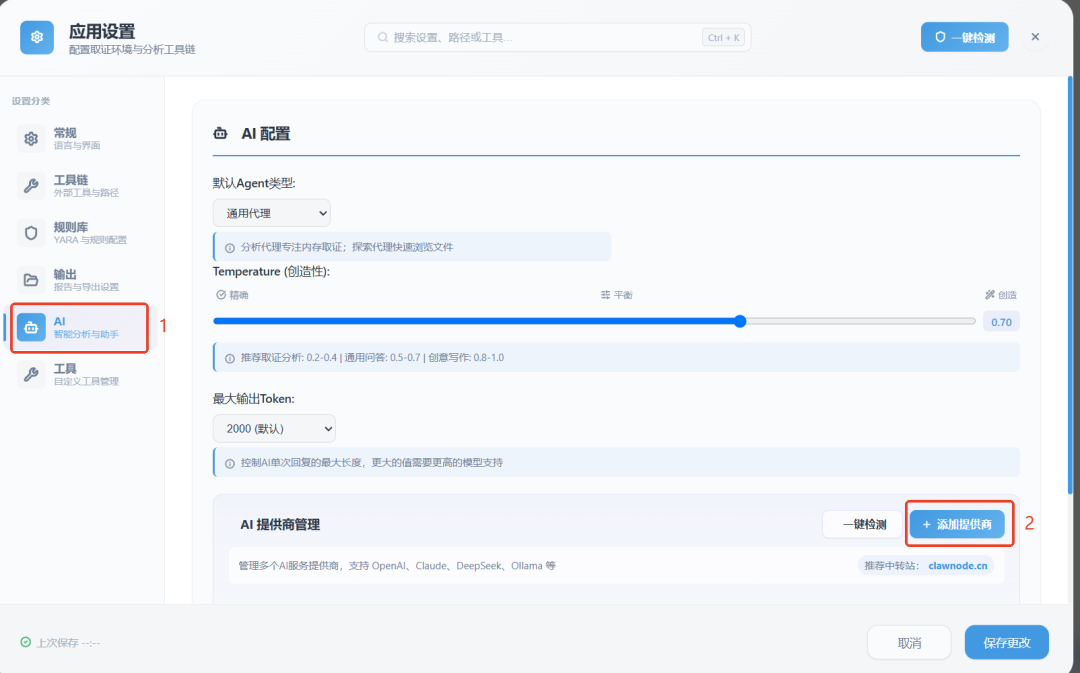
然后点「+ 添加提供商」,把本地模型接进来:
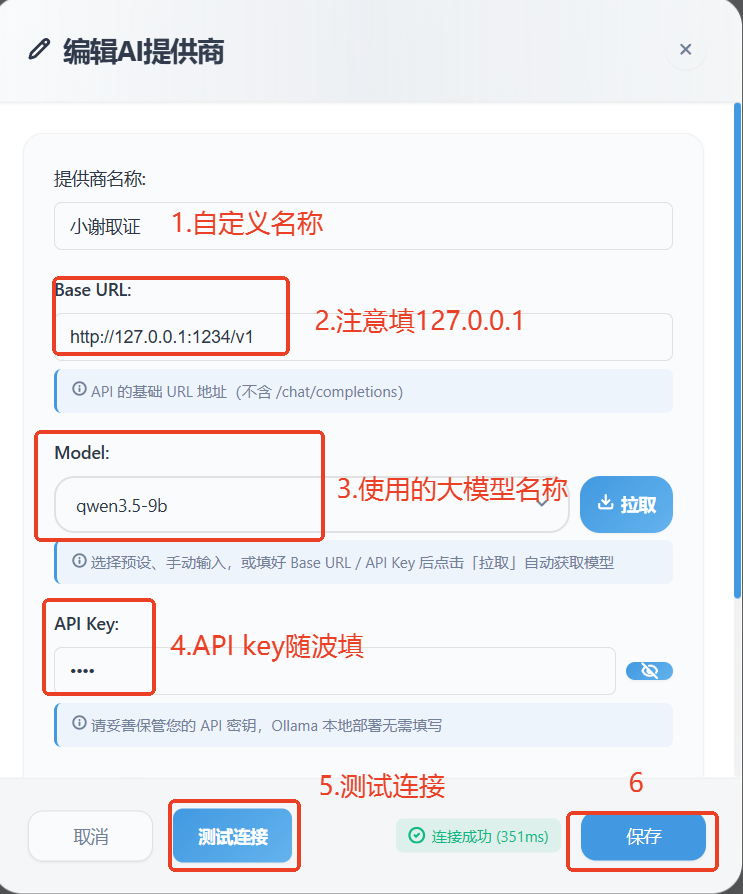
同样填 LM Studio 的地址和 qwen3.5-9b,保存后回到设置页能看到当前使用的模型:
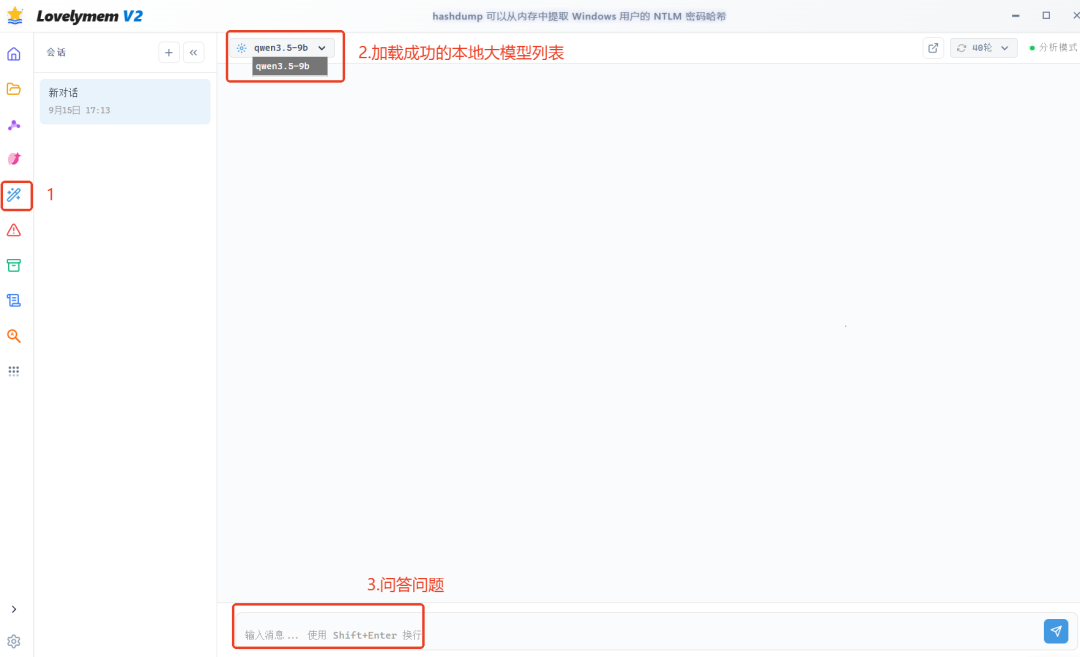
接着加载内存镜像。加载完成后,右侧选区可以选模型,然后直接提问:
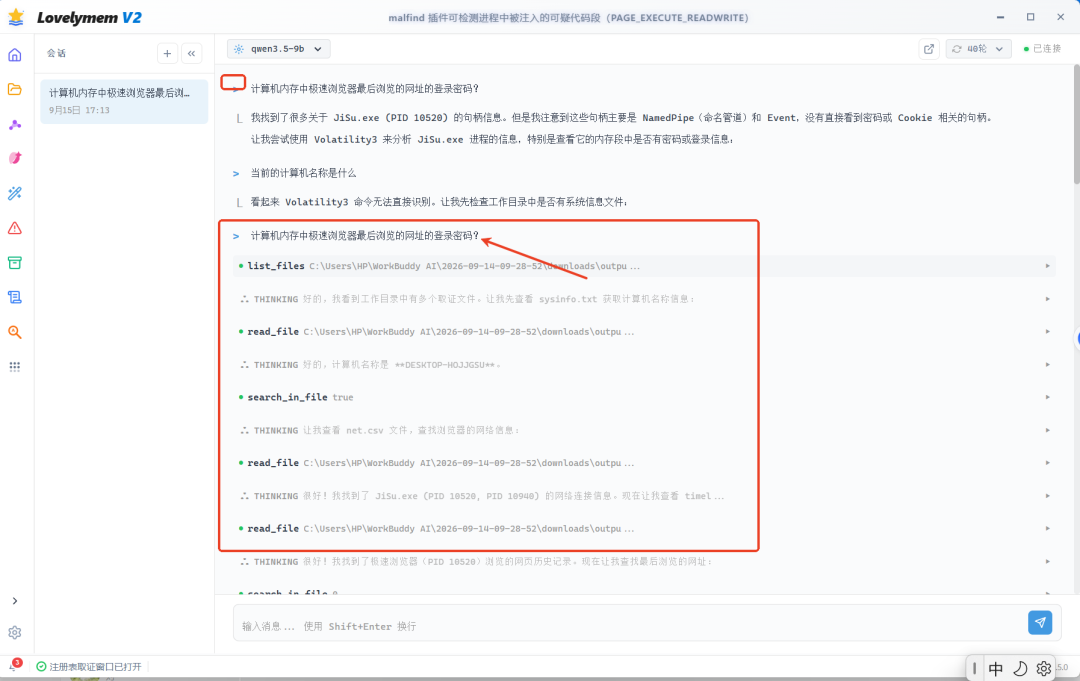
我随手问了一个题:找出极速浏览器最后浏览网址的登录密码。可以看到 Agent 会自己调用 list_files、read_file、search_in_file 这些工具去读取取证文件,一步步分析 JiSu.exe 进程:
继续深挖时,它会自动去调用 volatility2 和 Select-String,在内存镜像里定位到 Local Storage / Session Storage 这些 LevelDB 文件,并说明这些文件可能存有 Cookie 和登录信息:
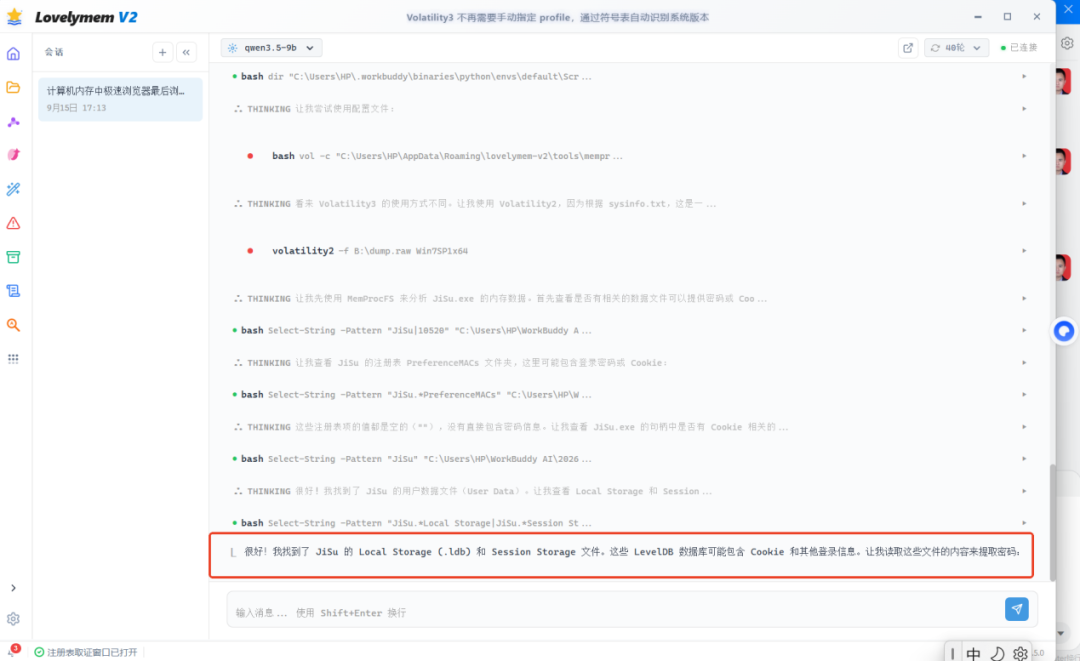
整个过程不需要我输入任何命令,就是提问、看它干活。
七、总结:
为什么建议直接用这三个工具
这三个工具有一个共同点,也是本期最想强调的一点:它们都原生支持接入本地大模型,所以完全不需要再走 MCP。
以前的做法是给 AI 客户端配一堆 MCP 服务器,工具调用要经过一层转发,链路长、延迟高、配置也麻烦。而这套方案是把模型直接接进工具本体——你在 DBX 里提问,DBX 自己调模型;在 Netcatty 里下指令,Catty Agent 自己执行。少了一层中间环节,速度上明显更快,配置也简单得多:填一个 Base URL、选一个模型名,就完事了。
回顾一下三款工具的分工:
DBX(https://github.com/t8y2/dbx):数据库取证,自然语言直接查库;
Netcatty(https://github.com/binaricat/Netcatty):服务器取证,AI 直接执行命令、排查配置;
Lovelymem V2(https://github.com/Tokeii0/LovelyMem):内存取证,AI 自动调用 Volatility 分析镜像。
再重复一遍配置建议:设备一般用 qwen3.5 9B;要上 qwen3.8 27B 至少准备 24G 以上显存;内存 64G 以上可以试 qwen3.6 35B-A3B。
八、最后
如果大家不想自己折腾部署,需要安装包直接安装使用,可以关注下方视频号并一键三连,在视频号后台回复 12,即可获得这三个 AI 工具的压缩包。

敬请各位大佬关注:小谢取证
扫取二维码获取
更多精彩
小谢取证