这个月初,OpenAI 动用近一万个 agent,花了 88 小时,交出一份 166 页的数学证明——挑战的是千禧七大难题之一的 Navier-Stokes 方程。
不过证明写完并不算完,AI 又花了 17 小时,把推导过程翻译成 Lean 代码,让机器逐行校验。
听起来,AI4S 的进展似乎比我们想象中要快很多?
数学证明有 Lean,推导对不对,机器说了算。可机器学习实验呢?
程序跑通了,日志也有了,报告写得像模像样了。但……里面的数字是真跑出来的还是幻觉而来?对照组建了吗?结果换个随机种子还能复现吗?
这些问题,目前大部分 AI 科研系统都答不上来。
今天介绍的 AutoResearch(EvoMap)要解决的,正是这件事:让多个 AI 模型组成蜂群,自动提假设、做实验、交回可查证的证据链。
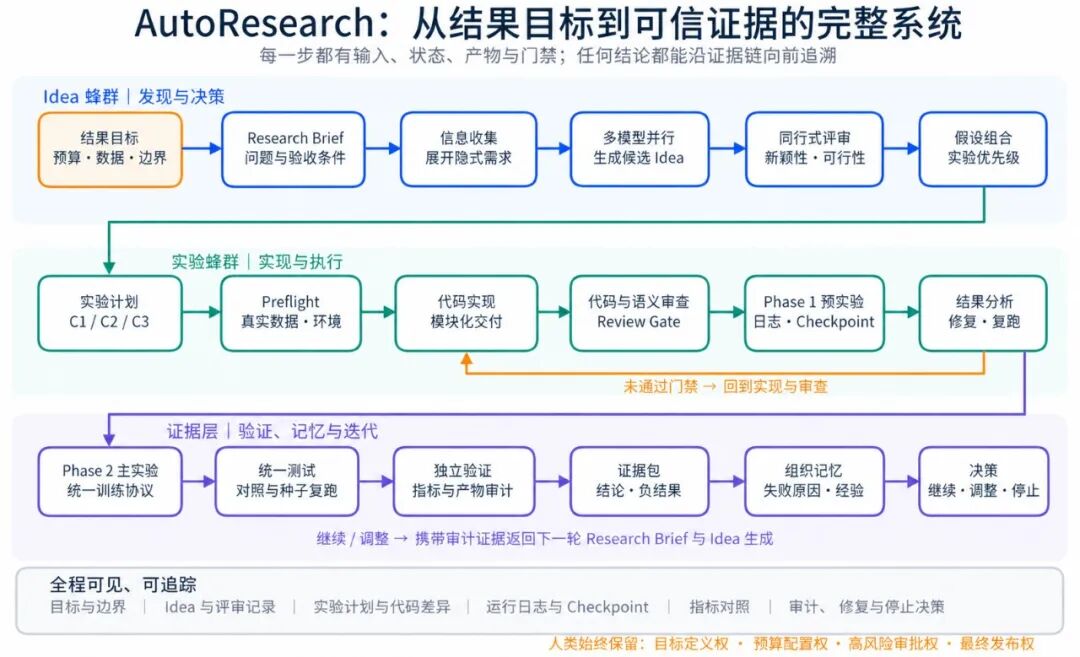
一个让多个 AI 模型组成「蜂群」,自动提假设、做实验、交回可信证据的自动研究系统。
现在大多数 AI 研究助手的工作方式,还是「人拆步骤,AI 来执行」:你得先想清楚数据从哪来、模型怎么改、跑什么实验、用什么指标判断好坏,写成一份操作手册交给它。
AutoResearch 换了个思路。
你只需要说一句目标,比如「提升卫星图文检索的准确率」,再告知预算和边界约束,然后就可以放手了。
系统拿到这句话之后,会自行展开追问:这个数据集能直接用吗?图片的局部信息要怎么处理?改进如果有,到底来自哪个环节?评测时各方法的计算口径是一致的吗?
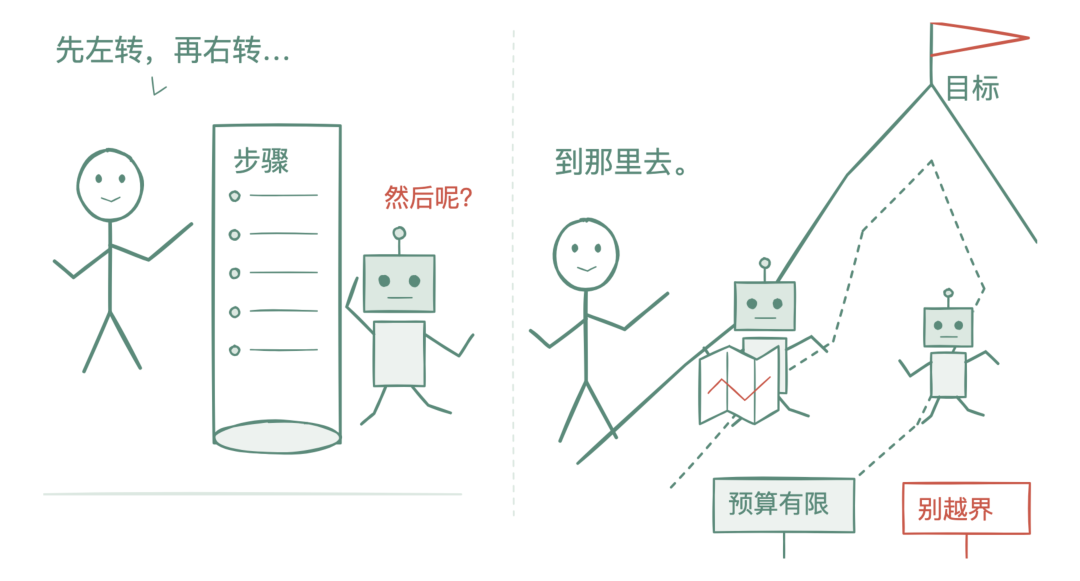
这些问题在目标里没写,但决定了实验能不能成立,即「隐式需求」。
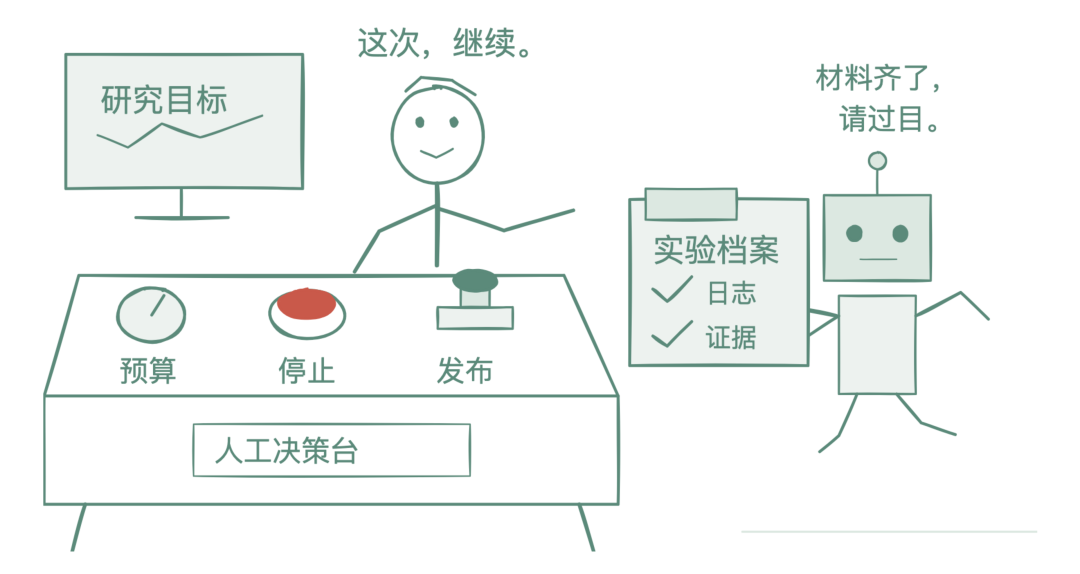
过去,这些全得靠研究者自己补齐。现在的分工变成了人负责「什么值得做、边界在哪」,蜂群负责「怎么到达」。
效果怎么样?直接来看实战。
同一道卫星图文检索题(RSICD 数据集),五套 AI 科研系统统一用 DeepSeek V4 Pro 作为执行模型,各自独立作答,最后用同一套审计口径打分。
这道题要研究的是:给一段文字描述,从一堆卫星图里找到对的那张;反过来也行,给一张图,找到对的描述。
结果如下:
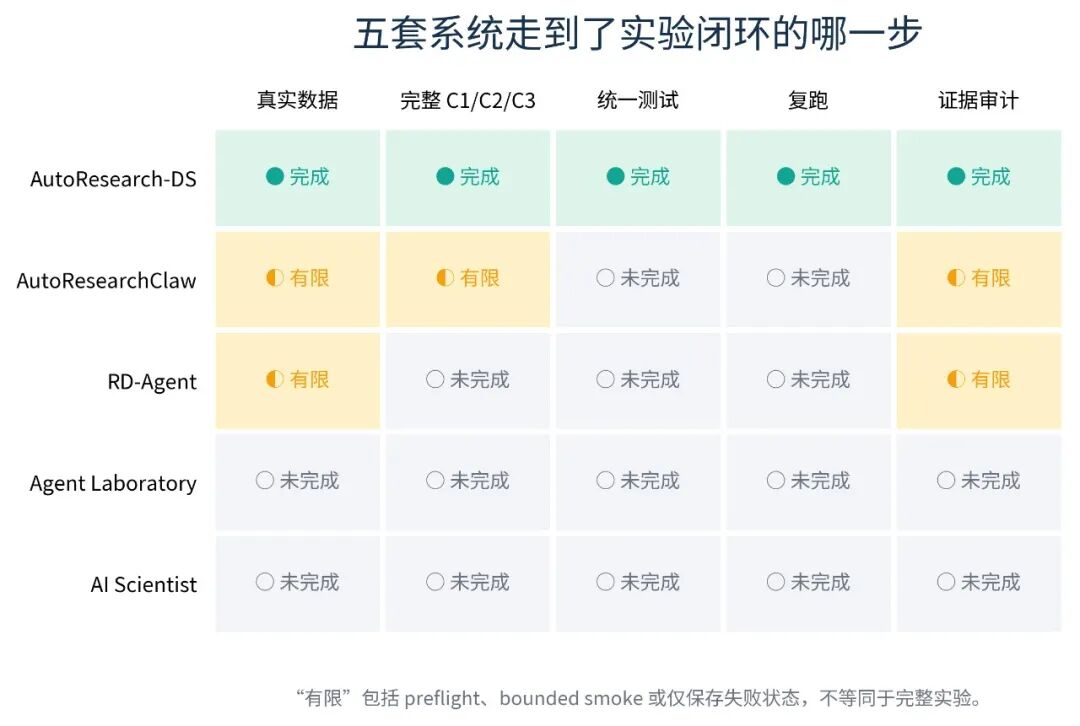
AI Scientist 跑是跑了,但交上来的「成绩」里居然还混着些占位数字,可以理解为卷子写满了答案,但答案是编的。
Agent Laboratory 安排了好几个专业角色接力合作,结果图片描述是空的、实体信息也是空的,这些半成品居然一路绿灯传到终点,最后还被盖了个「阶段完成」的章。
RD-Agent(微软开源)擅长记录每轮迭代的反馈,但这次主实验因为依赖和数据格式问题压根没跑起来。而要命的是,它过往的迭代记录里有近四成都在「自信地往错误方向走」。
AutoResearchClaw 做了小规模验证跑,但离完整训练、统一测试和复跑还差几步。
能运行,不等于做完了实验。
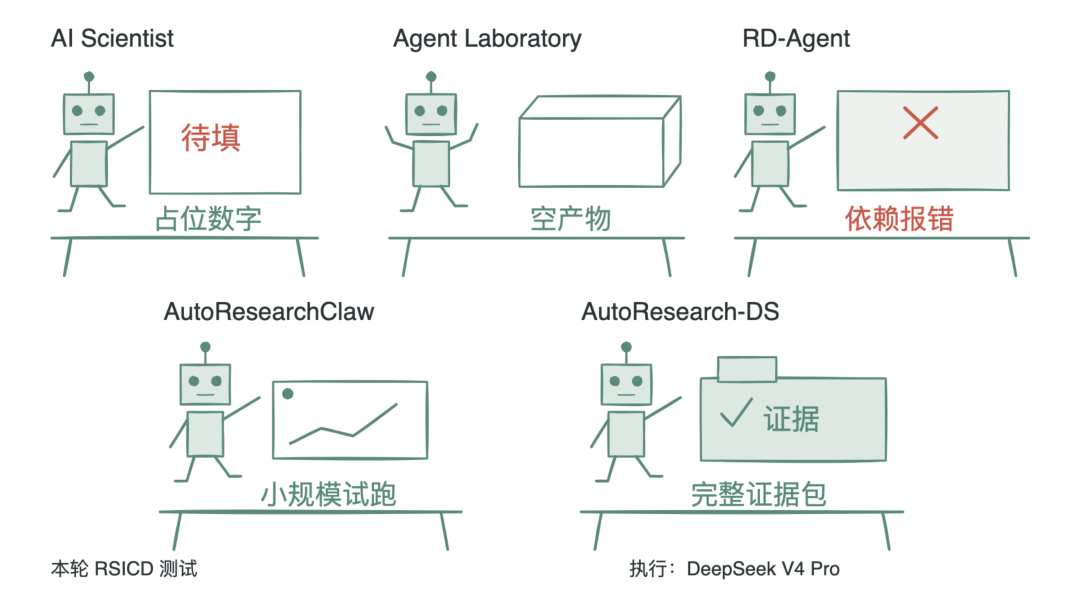
五套系统里,只有 AutoResearch-DS(DS 是本轮使用 DeepSeek 执行模型的标记)真正走完了全过程:确认数据可用 → 建立基线 → 逐步加入三个改进模块形成对照 → 同一规则下训练测试 → 两个随机种子复跑的验证。
你可能会问:为什么要用蜂群,而不是让一个模型从头想到尾呢?
因为一个模型提方案、自己评审方案、再自己执行方案,等于出题人、答题人、阅卷人是同一个人。哪怕它说「经过审慎考虑」,也不过是把最初的判断换了个说法再确认一遍。
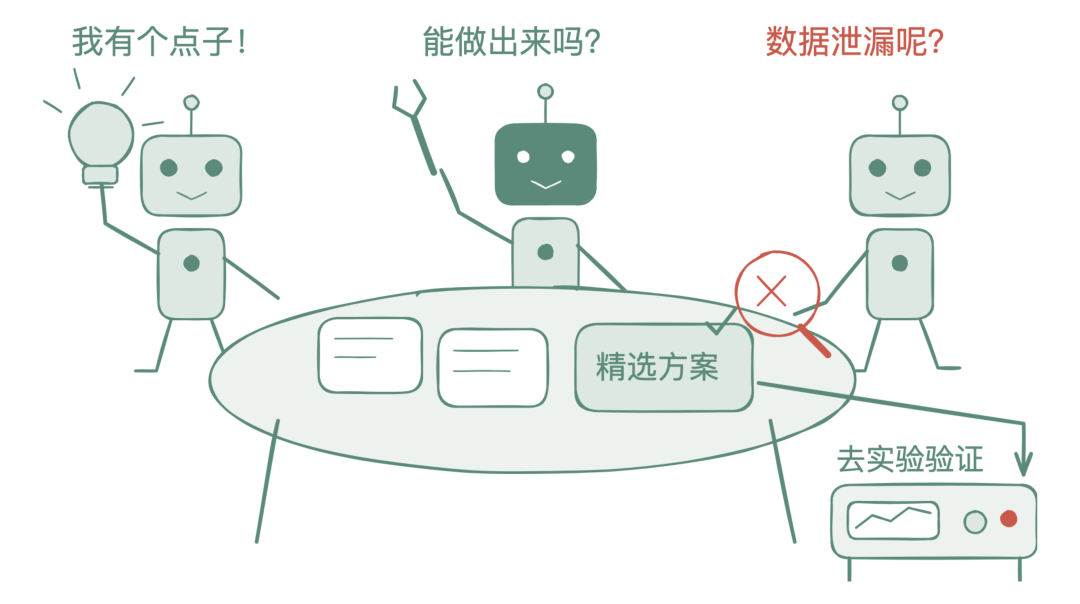
AutoResearch-DS 的规则上,在 Idea 生成阶段至少三个不同底层模型参与。它们各有分工,有的天马行空,有的盯着工程落地,有的专门挑毛病。然后像同行评审一样互撕过招:你这个方法跟目标真的对得上吗?性能提升会不会只是因为数据泄漏了?万一实验没成功,能判断问题出在哪个环节吗?
在卫星图文检索这个例子里,蜂群最终敲定了一条三步走路线:先把图文整体对齐做好,再让文字去挑选更相关的图像局部,最后把文字里的概念和图像里的具体目标关联起来。
每一步都可以单独插入实验,所以能清楚看到各自贡献了多少。
Idea 好不好,标准也很简单:值得测试、能够测试,测完之后真的增加了有用信息,即可过关。事实上,往往一个听起来很惊艳、但没法落到数据和结果上的想法,也算不上什么高质量的研究 Idea。(是不是想到了谁?🐶)
完成度之外,还有个更加直观的角度是:谁犯的错最少,又处理得最好。
错误逃不掉。
五套系统在同一审计框架下清点错误(去重后):AutoResearch-DS 5 起,RD-Agent 11 起,AutoResearchClaw 15 起,Agent Laboratory 18 起,AI Scientist 27 起。
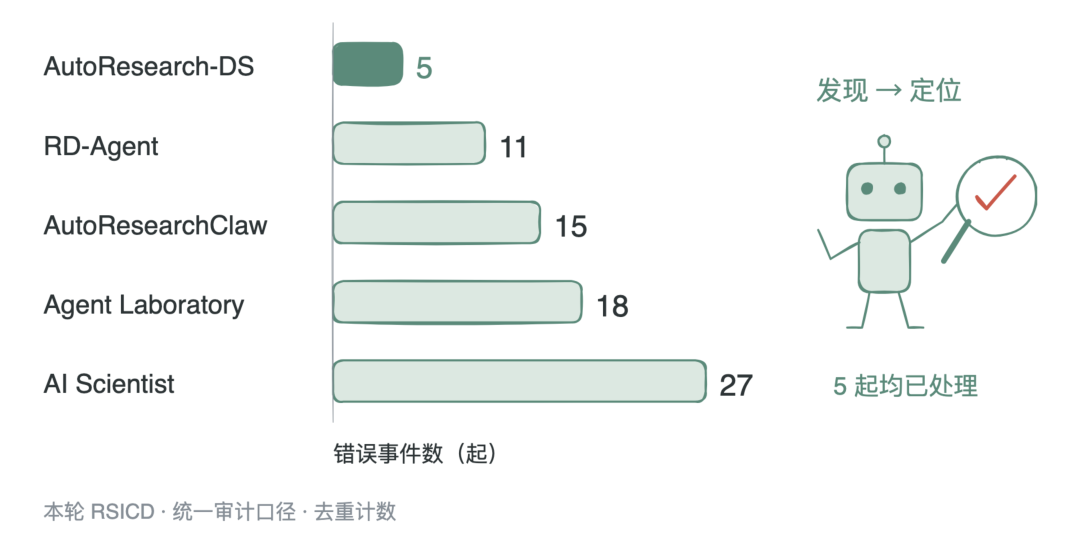
AutoResearch-DS 错误最少,且更重要的是,这 5 起错误全都被暴露、定位、并处理掉了。而且这是在完成了真实训练和统一测试的前提下,不是因为跑得少才出错少。
裁判不能是运动员。
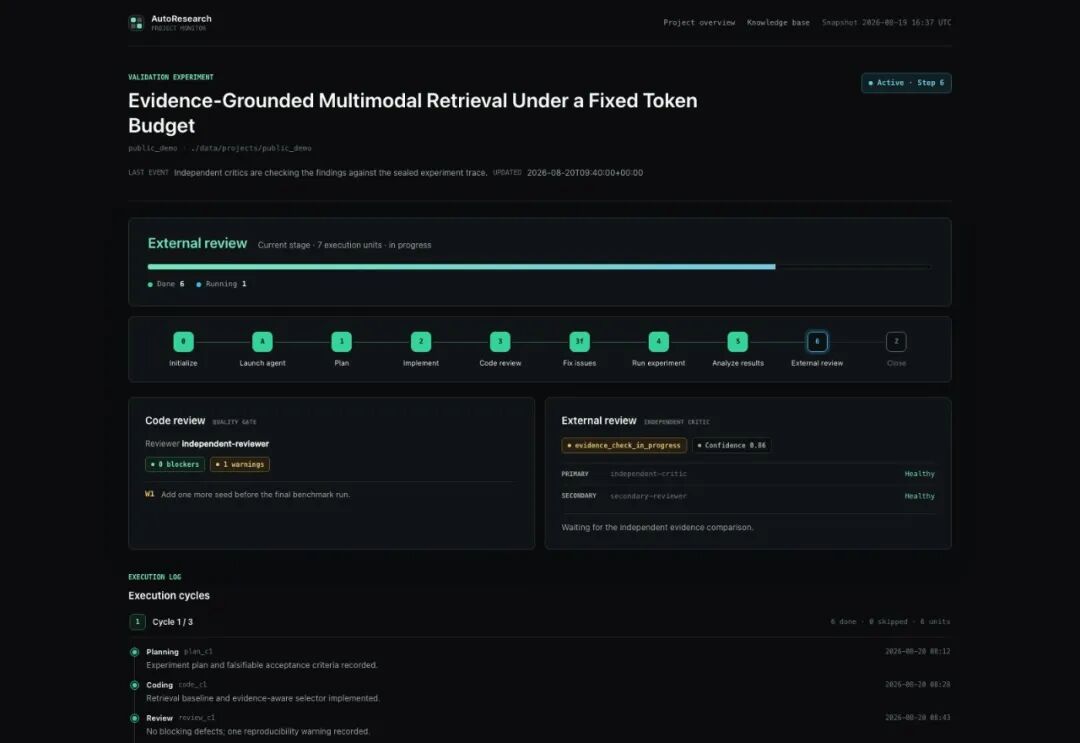
蜂群的分工上,规划的、写代码的、审查的、执行的、分析的、修 bug 的、最终验收的,都是不同角色。
提方案的人不能同时当裁判,审查结论时必须回到真实的运行产物去核对,不能光看生成的总结文字就放行。
过程中有一个实际的例子,在一次矩阵乘法实验里,速度和精度都达标了,看起来可以宣布成功。但没能通过稳定性的门禁(反复跑几次,数字不一致)。排查下来发现是计时方式搞错了,把多线程的 CPU 累计时间和实际的墙钟时间混在了一起。对测量方式进行修正后重新运行,然后才被接受通过。
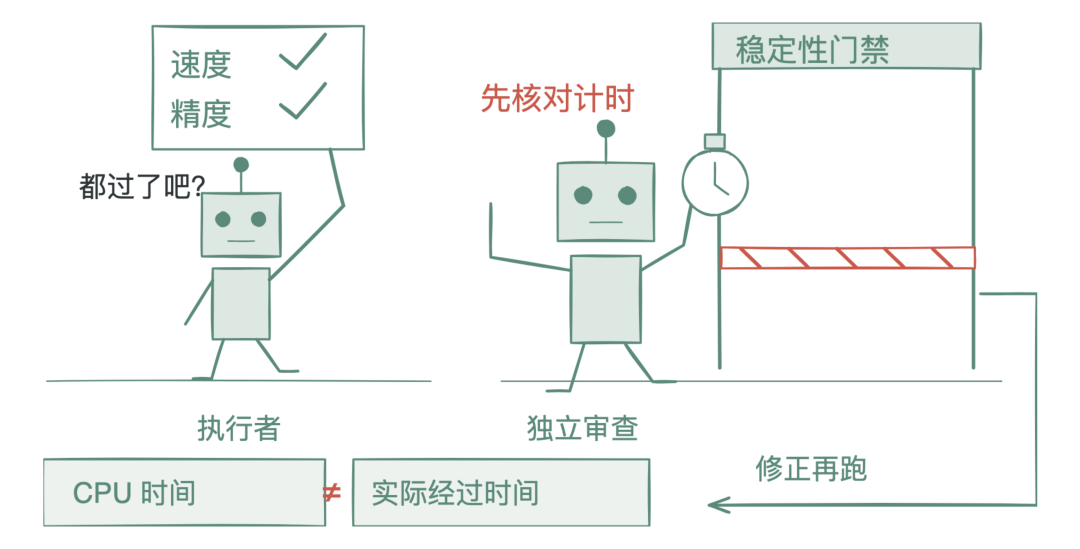
要是只看第一次输出的数字,这个实验早就「成功」了。
步步可归因。
这里的 mR,可以简单理解为综合图找文、文找图效果的平均召回指标,分数越高越好。
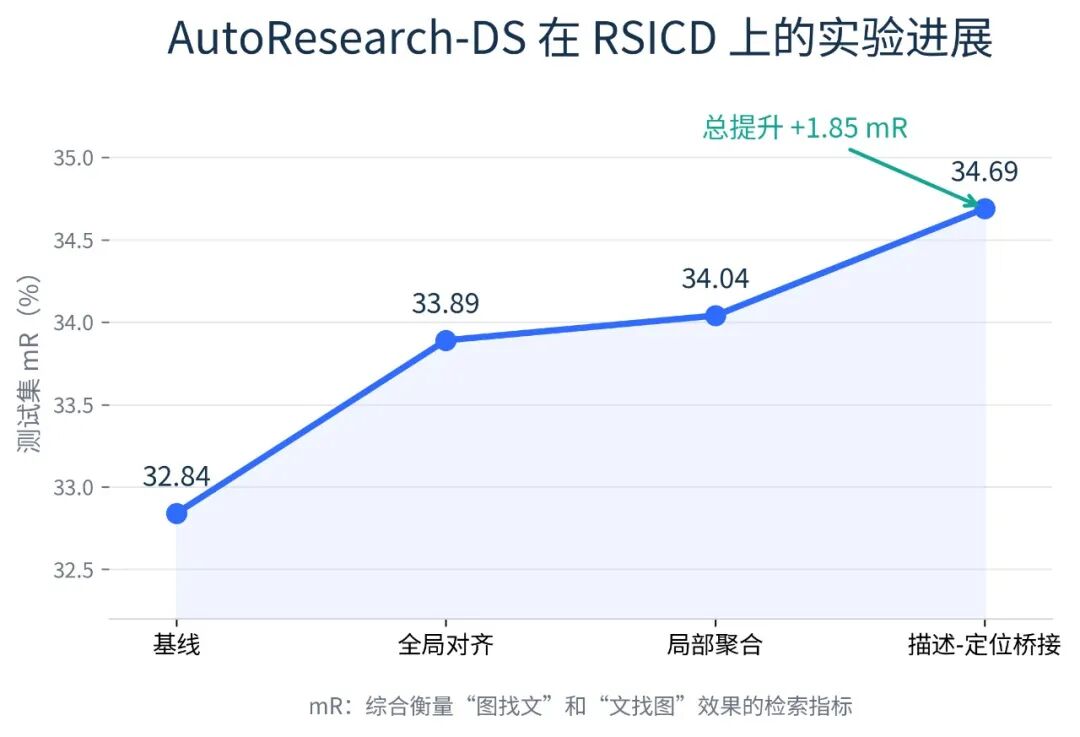
RSICD 统一测试的进展轨迹为:基线 32.84 → 加入整体对齐 33.89 → 加入局部聚合 34.04 → 加入概念-目标关联 34.69。
总共提升 1.85,并经过两个随机种子的复跑确认。
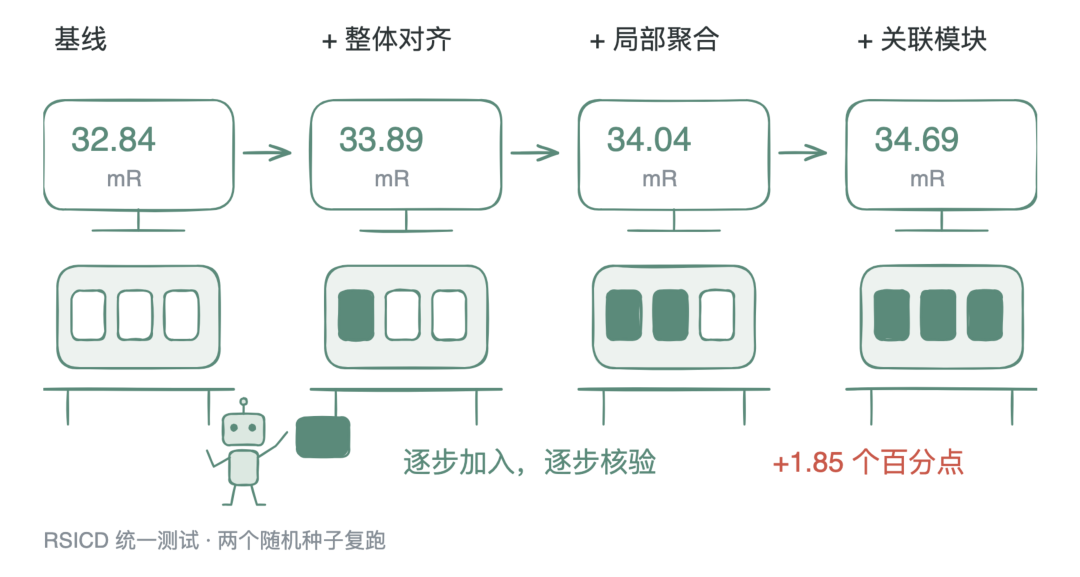
单看 1.85 的数字可能不算是惊人,但重点在于新加的每一步都是在同一规则下受控加入的,每一步的贡献可以单独拆开看,结果也经得起重跑(这是一次特定任务和配置下的测试)。
这才是「可信」的意思。
失败也是资产。
很多系统的做法是跑失败了就丢掉,换个方向重来。问题是不留记录的话,下次很可能在同一个坑上再栽一次,而且系统都不知道自己「又」栽了。
AutoResearch 会把失败过程留档,跑完了但没提升的,记为负结果;因为依赖出错或数据没准备好而中断的,记为执行失败,不轻易下「假设不成立」的结论。
数据、配置、日志、判断,全都会保存。
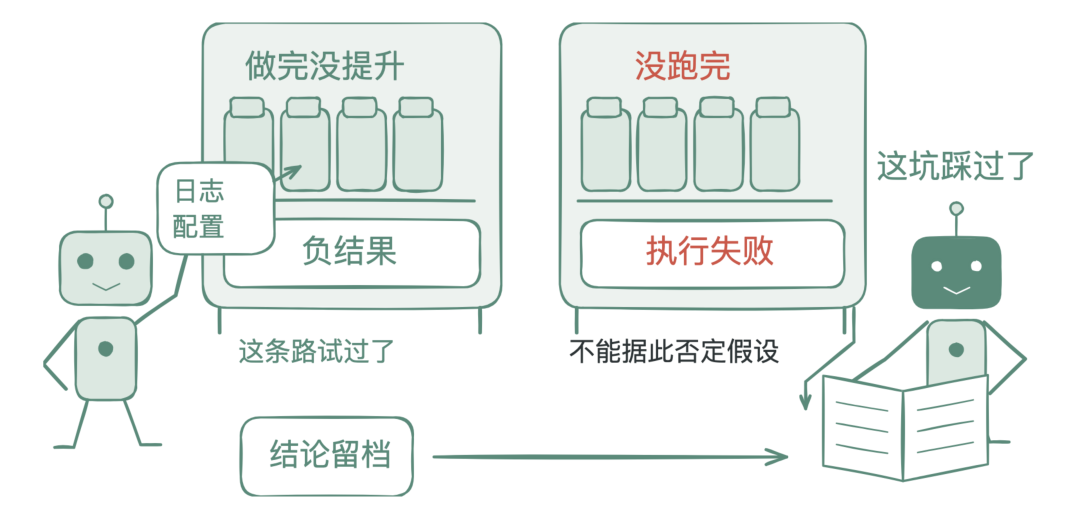
下一轮迭代启动时,系统能查到前面试过什么、踩过哪些坑、哪些假设需要调整。
这里最大的变化,并不是一个检索指标提升了 1.85,最大的变化是研究的入口从过程变成了结果。
过去做研究,得先把路线想好再交给人或 AI 去执行。现在反过来了,你只管说终点在哪,路怎么走让蜂群自己去摸索、争论、试错、验证。
至于人呢,不必再盯着每一步的过程,而是转向了更为关键的决策:这个方向值不值得继续?预算和风险可控吗?哪些结论可以发布、哪些还要再看看?
其实不只是科研。产品探索、新材料筛选、药物发现、甚至商业模式验证,都面临同样的处境,目标都很清楚,但没法提前把路线写成操作手册。
从目标出发、逐步积累证据的工作方式,也将会渗透到这些领域的研究中来。
而当 AI 开始参与改进 AI 自身的时候,这样一套「做了什么、结果对不对、过程能不能查」的审计能力,将会变得极其重要。AutoResearch 算是在 RSI 路上迈出的早期一步。
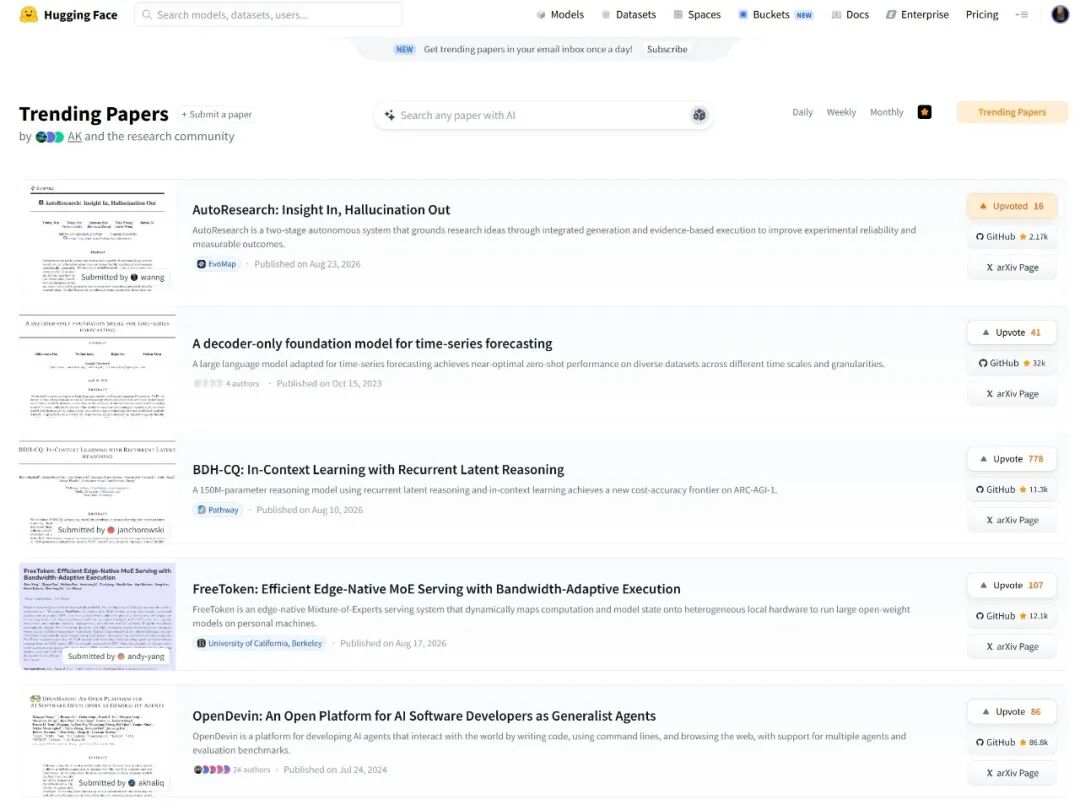
AutoResearch 上周连续两天拿下 Hugging Face Daily Trending Papers 第一。
9 月 5 日又登上了 Trendshift Python Repository of the Day 第一。
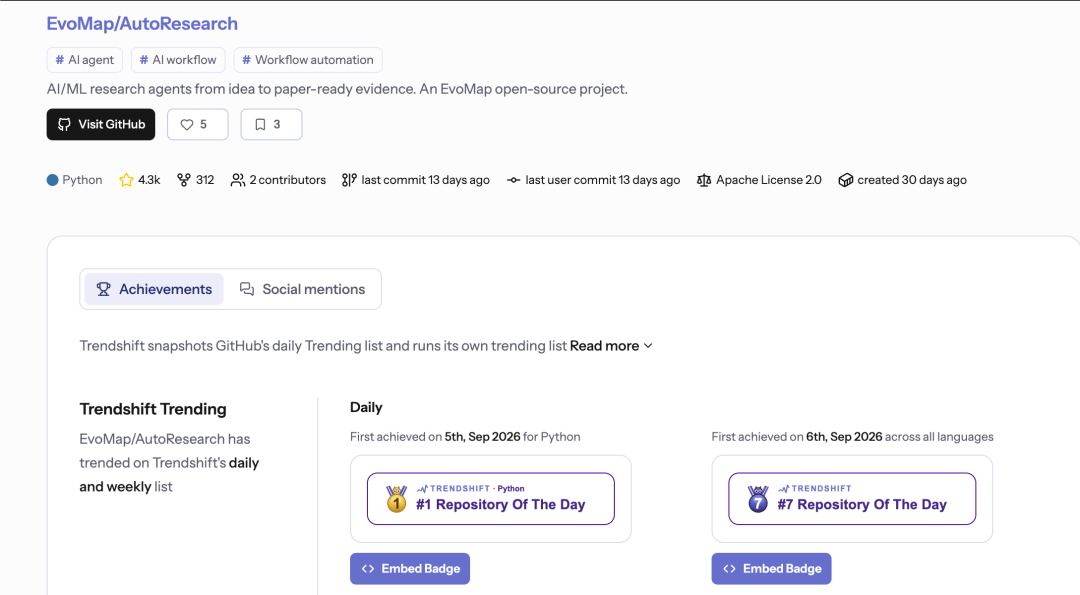
项目已开源,Apache-2.0 协议,目前约 4.3k star,论文见 arXiv 2608.17906。
虽然 AutoResearch 还不能算是真正的自动科学家,但自动科学家的到来,也并不会是某天突然宣布一个「万能 AI」或 ASI 那样的戏剧性时刻,而是让越来越多的研究目标不需要人手把手指定好路线,就能一步步走到可信结果的过程。
而一旦模型能自主提出假设、验证并不断迭代自身能力,科研的复利效应很可能将从此点燃。研究速度不再受限于人力的线性投入,而是随算力与方法的自我进化呈指数扩张,这也是 RSI 最终的形态和真正的价值所在。
如果你也想感受只需下发目标、便可坐等结果的快感,可以 GitHub 搜索 EvoMap / AutoResearch,star 和试用。
◇ ◆ ◇
