大部分争议集中在 Photos.sqlite 数据库的预写日志(Photos.sqlite-wal)上。我们的思路是按照 wal 中各帧的记录顺序,以事务提交为界,将相应的数据页回放至主数据库,逐步恢复数据库在不同时间节点的状态,并通过逐次查询寻找答案。若上述分析思路或解题过程存在疏漏,还望各位师傅批评指正
从厦门回来就一直在忙,实在没什么时间复现,本周末还有数证杯等着我们,只能先写到这里了。剩下的有空一定补上,下次一定 !
ᕙ(⇀‸↼‶)ᕗ
案情简介
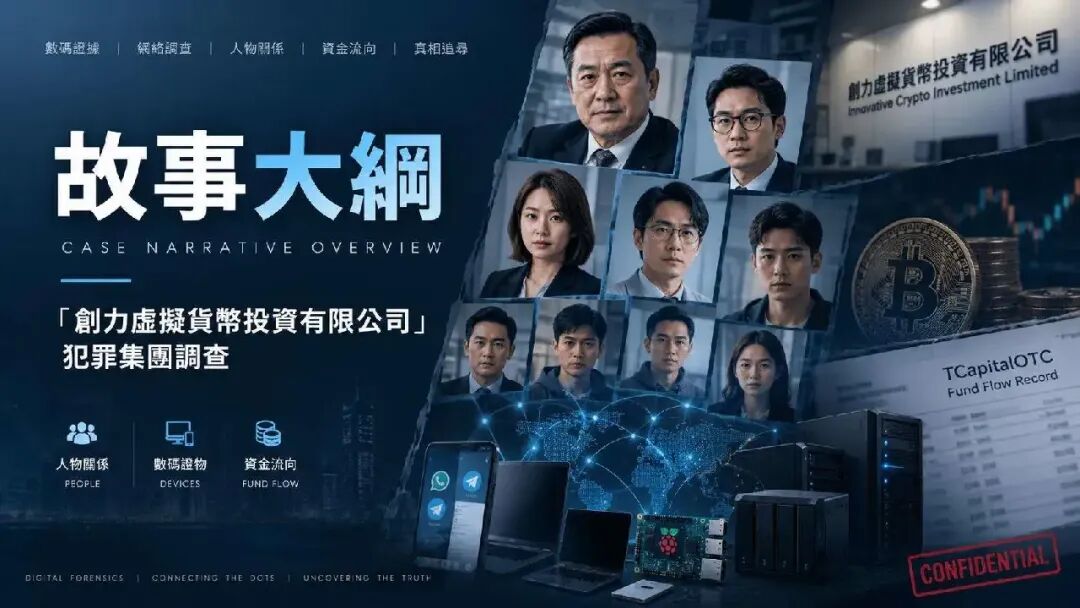
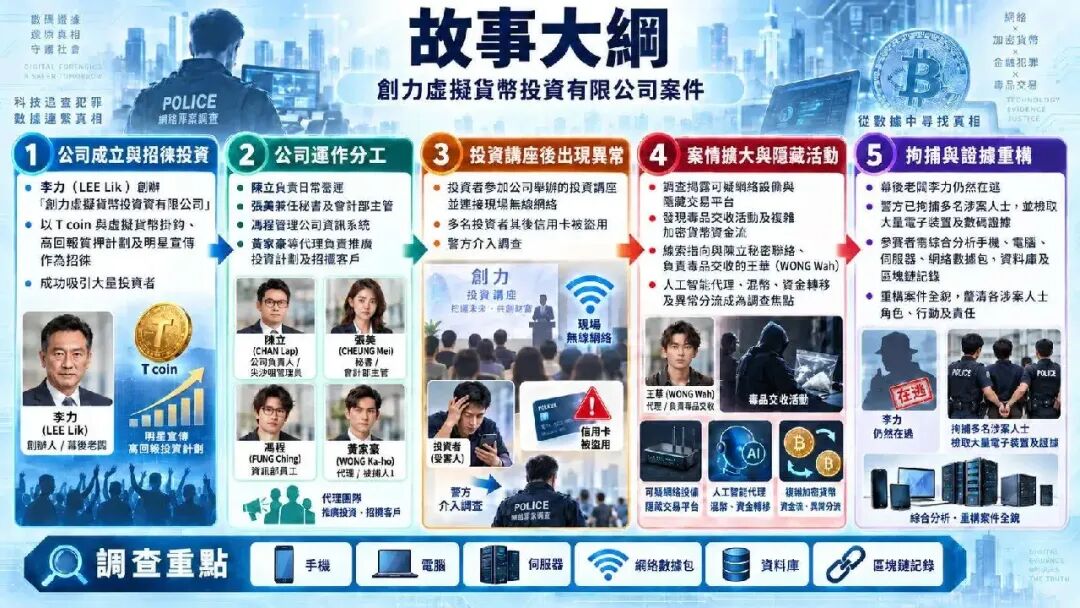
个人赛故事大纲
李力(LEE Lik)创办「创力虚拟货币投资有限公司」,以 T coin 与虚拟货币挂钩、高回报质押计划及明星宣传作为招徕,成功吸引大量投资者。
公司日常运营主要由陈立(CHAN Lap)负责、张美(CHEUNG Mei)兼任秘书及会计部主管,冯程(FUNG Ching)负责管理公司信息系统,黄家豪(WONG Ka-ho)等代理则负责推广投资计划及招揽客户。
其后,多名投资者在参加公司举办的投资讲座并连接现场无线网络后,其信用卡于数日内相继被盗用,警方遂介入调查。
(个人赛题目总数为: 128 条)
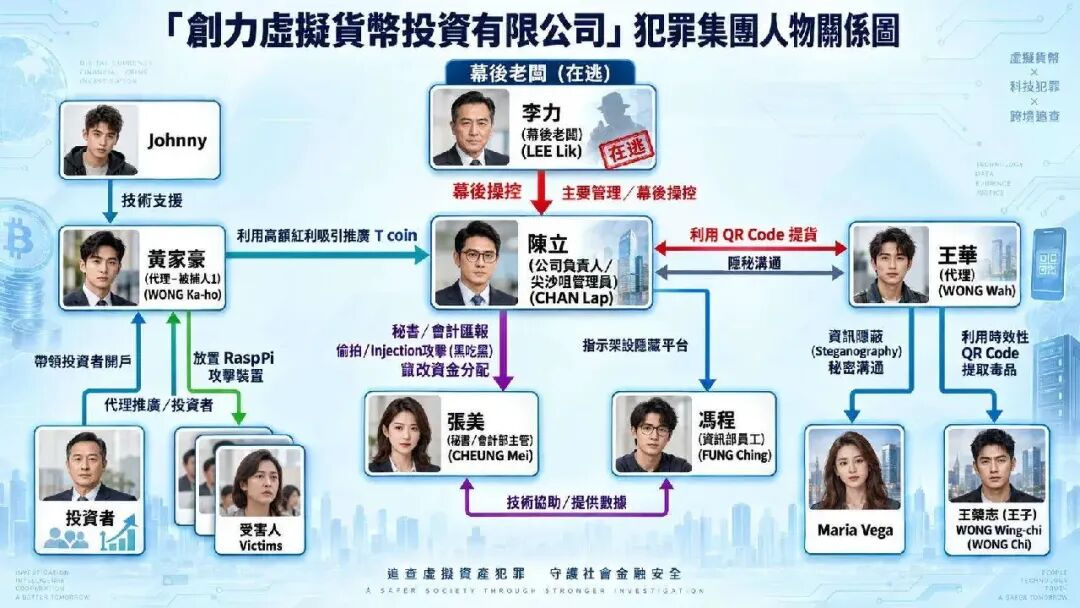
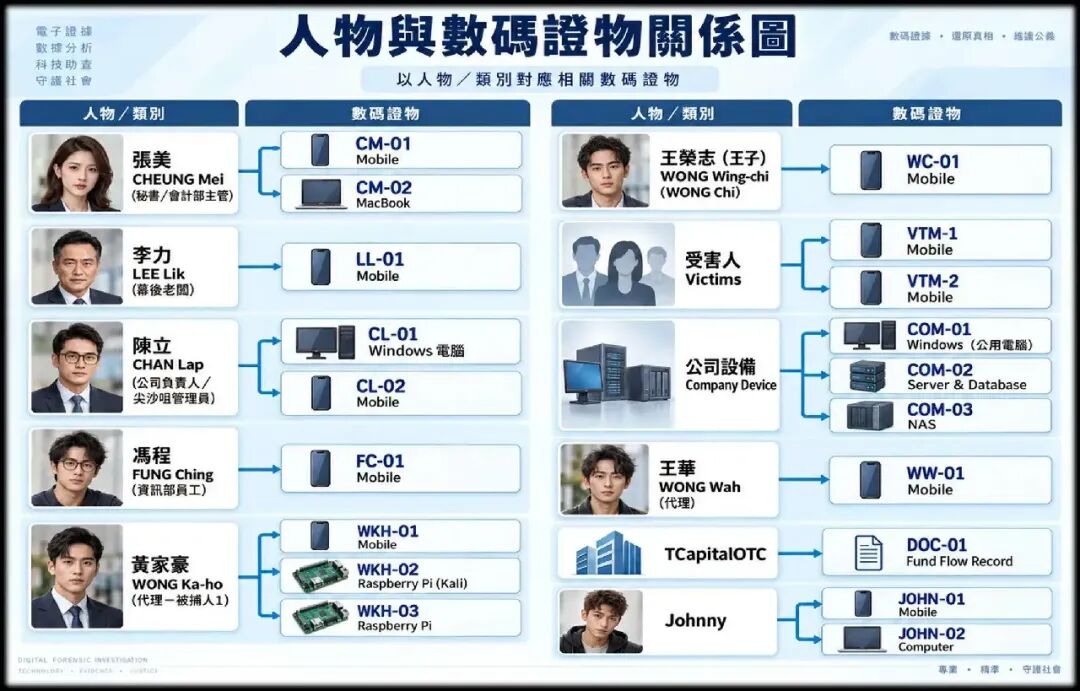
团体赛故事大纲
一宗看似单纯的网络盗卡案件,逐步揭露可疑网络设备、隐蔽交易平台、毒品交收活动,以及涉及加密货币的复杂资金流
随着调查深入,线索进一步指向与陈立秘密联络并负责毒品交收的王华(WONG Wah)及其他相关人员。公司所使用的人工智能代理,以及涉及混币、资金转移和异常分流的交易安排,亦成为案件的重点调查方向。
虽然幕后老板李力仍然在逃,警方已先后拘捕多名涉案人士,并检取多项电子装置及数字证据。参赛者须综合分析手机、计算器、服务器、网络数据包、数据库及区块链记录,重构案件全貌,查明各涉案人士的角色、行动及责任。
(团体赛题目总数为: 291 条)
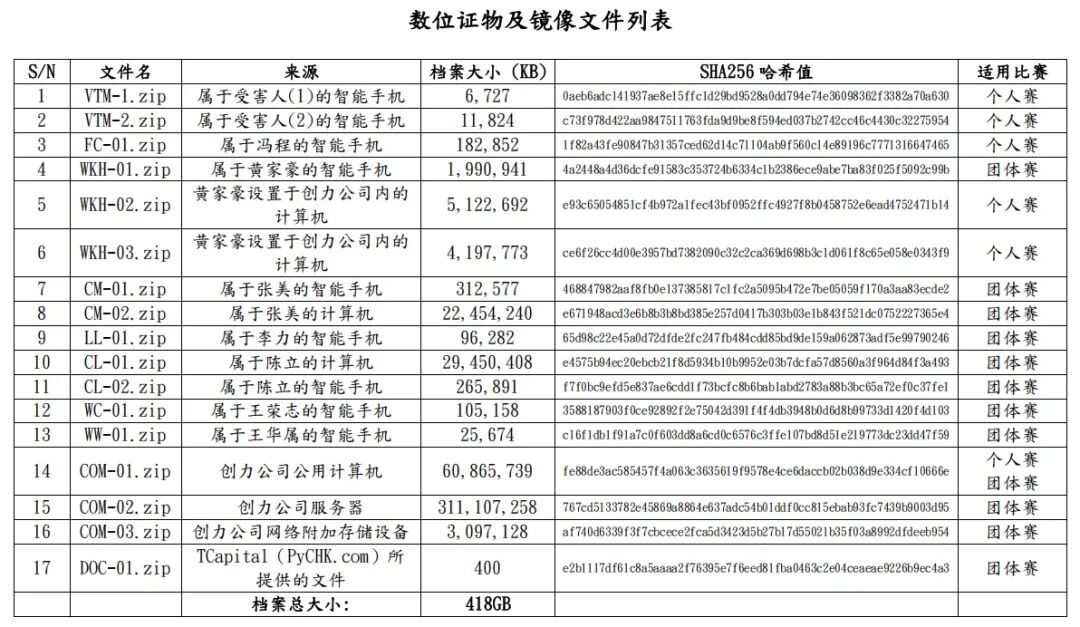
个人赛
容器大小:68GB
容器 SHA256 哈希:BD41B98BDB868D416FF136B75F1386BB6700B69F9C025E4EE76C430929272F65
容器密码:=zxky_rvQyv*4VnD2sqW?J!F&TmAcT8$9JgtPZsW?uV*_Smyp*PB+7S?sV-9%FTkTaACHcd9A*aTHKh*rE78m=@?*4aaJdD!6QM$Xa7c56uERjM7C=7L?Zb2YQCernMA
VTM-1
VTM-1 的检材是一个很小的压缩包,解压出来只有几张照片和视频
第1题【填空题】
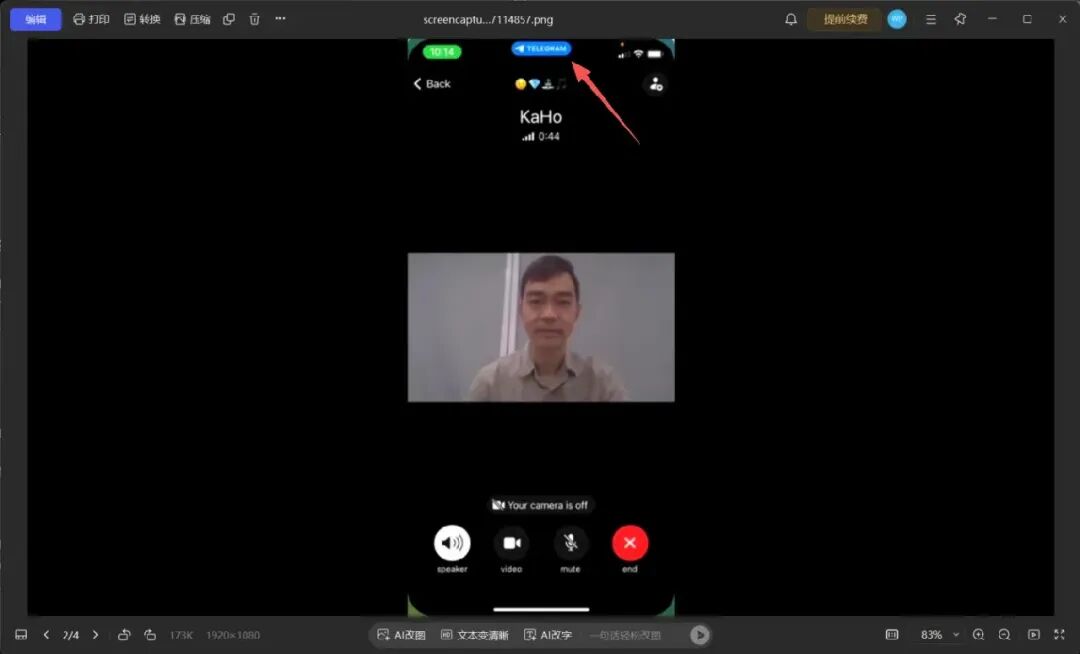
比赛材料可能包含刻意设置的错误、不一致或干扰信息,参赛者须自行辨别并交叉验证,依据核实后的证据作答。 请根据参赛材料 VTM-1 回答以下问题: 根据 POON Chi-ming(VTM-1)提供的资料,他通过哪个社交媒体APP与诈骗分子进行视频通话? (答案格式:使用全大写英文作答APP全称)
TELEGRAM
第2题【填空题】
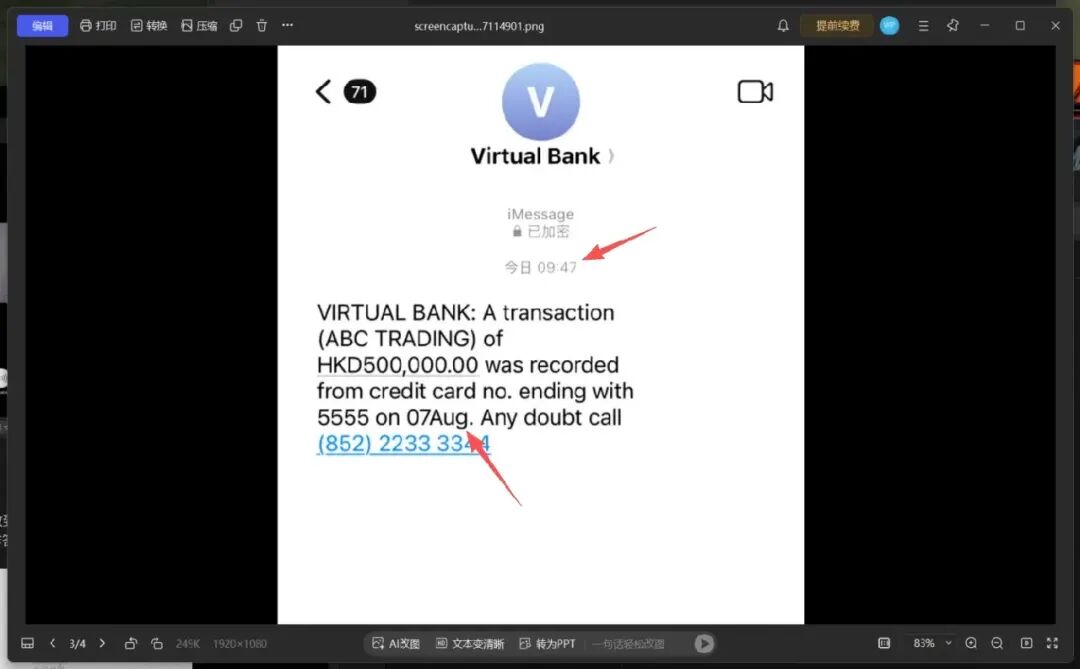
请根据参赛材料 VTM-1 回答以下问题: POON Chi-ming(VTM-1)在什么时间收到信用卡消费消息? (答案格式:请以 MMM-DD_hhmm 格式作答,例如:JAN-01_1523)
AUG-07_0947
第3题【填空题】
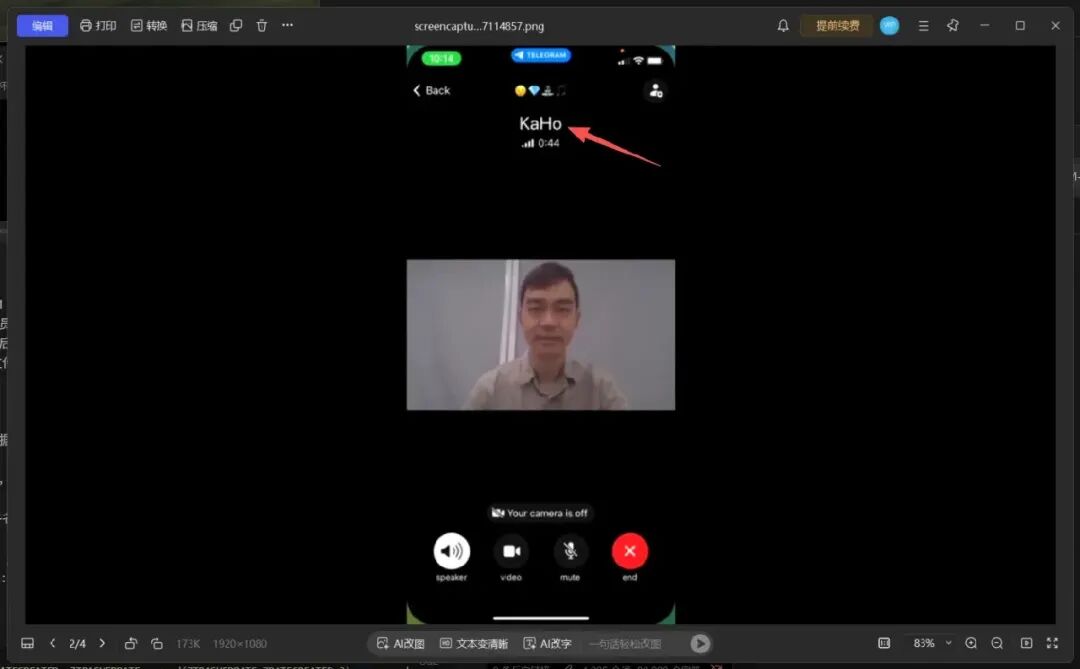
请根据参赛材料 VTM-1 回答以下问题: 在 POON Chi-ming(VTM-1)的通话记录中,诈骗分子来电时显示的名称是什么? (答案格式:请按照原始数据作答,并区分英文大小写)
KaHo
VTM-2
VTM-2 解压出来更简单,只有一段视频
第4题【填空题】
请根据参赛材料 VTM-2 回答以下问题: 诈骗分子安排 SIU Wai-shing(VTM-2)在什么时间参加投资讲座? (答案格式:请以 hh:mm 格式填写 阿拉伯数字,例如:16:35)
14:00
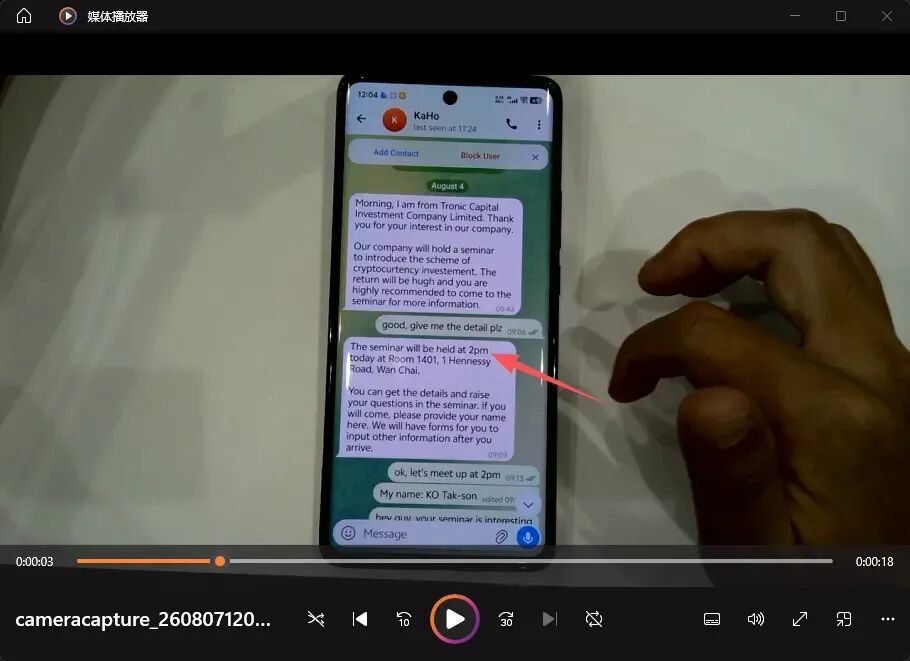
前两个检材就这么做完了,就是在翻照片和视频
FC-01
第5题【单选题】
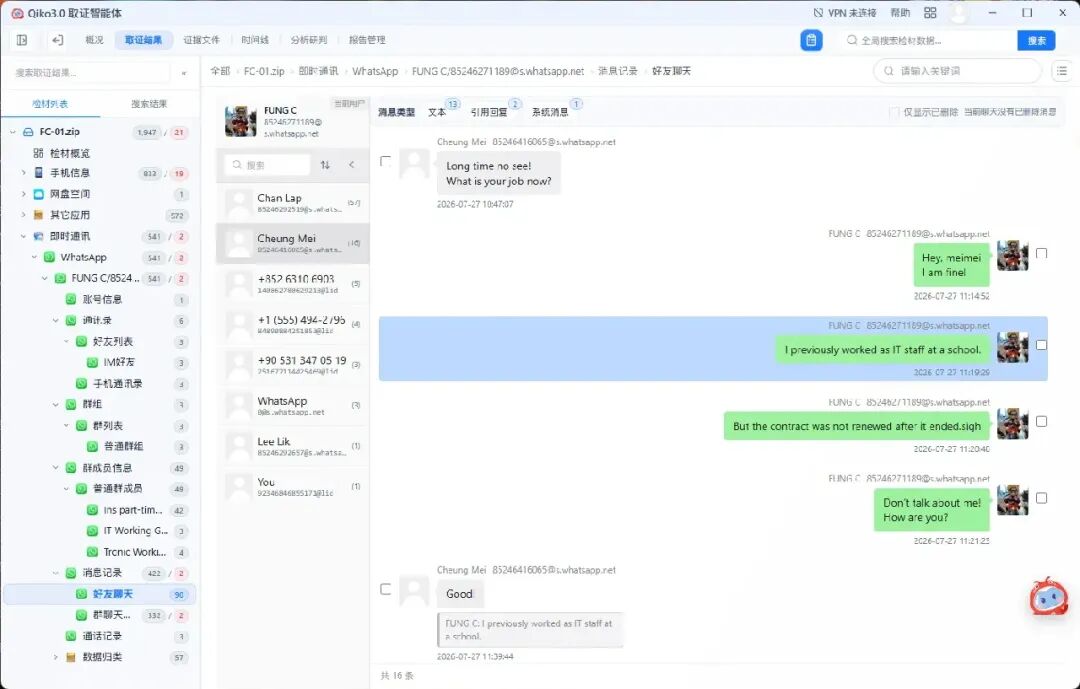
请根据参赛材料 FC-01 回答以下问题: 冯程向张美透露,他此前曾在哪里工作?
A. 银行 B. 学校 C. 科网公司 D. 酒店
B
看冯程和张美的 WhatsApp 聊天记录
第6题【填空题】
请根据参赛材料 FC-01 回答以下问题: 请问群组「IT Working Group」的建立者,其在数据库底层所记录之帐户标识符(JID / Creator JID)为何? (答案格式:请按照原始数据库记录完整填写,包含后缀,例如:123456789012345@lid)
192252030808131@lid
看群组 IT Working Group 的群成员,只有 Cheung Mei(张美)是管理员,因此认定她是群建立者
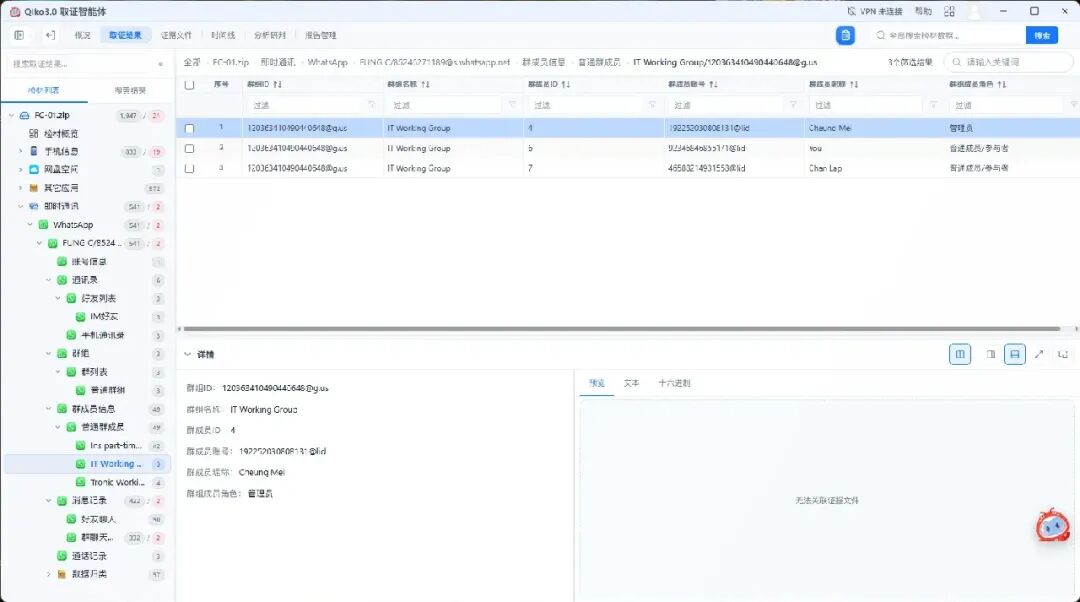
在弘连的取证工具查看 WhatsApp 群聊记录
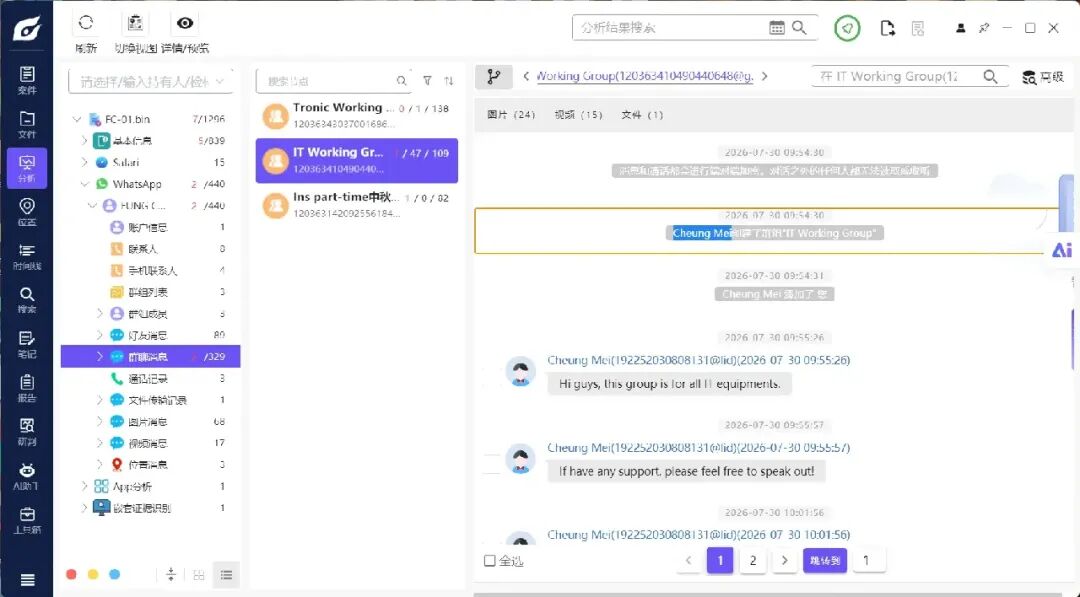
可以看到 Cheung Mei 是群聊创建者,而在美亚的 Qiko3.0 显示的却是 您
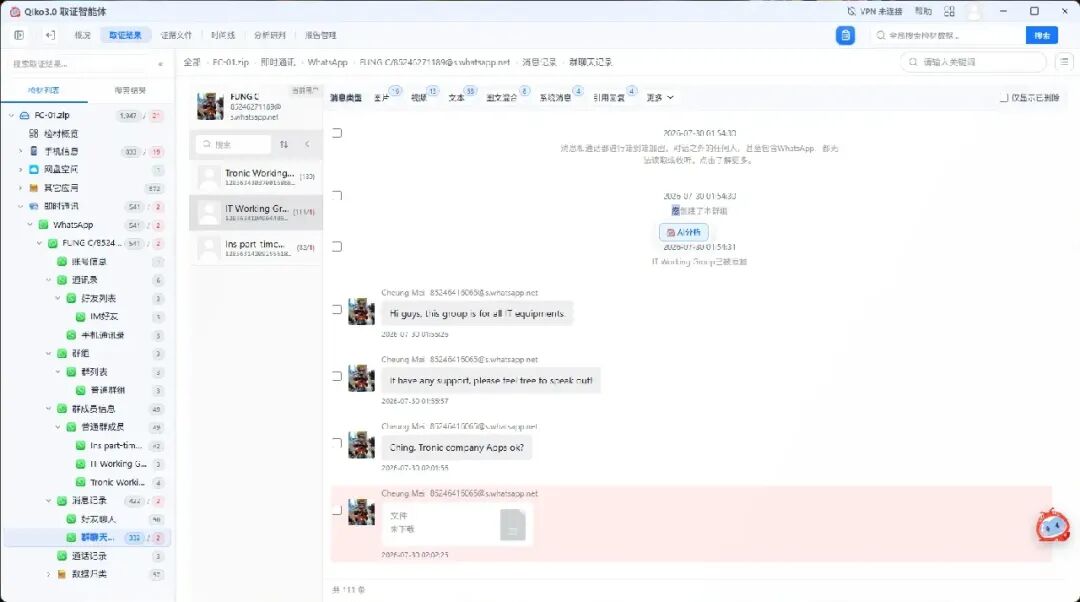
很诡异,不过 Qiko3.0 的每个群好像显示的都是 您创建了本群组,估计是个 bug
第7题【填空题】
请根据参赛材料 FC-01 回答以下问题: 在涉案群组「IT Working Group」对话记录中,冯程的手机所记录之发送与接收讯息总数(合计)共有多少条? (答案格式:仅填写阿拉伯数字,例如:88)
111
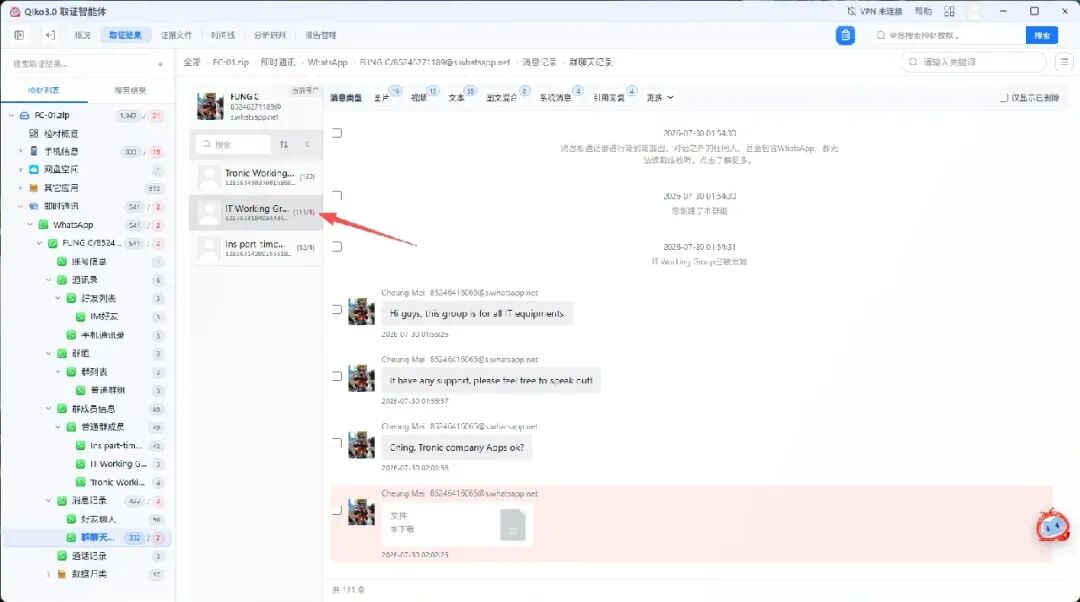
Qiko3.0 显示是 111,而弘连的软件显示为 109,正确答案应该是 111,疑似是 2 条空消息导致的差异
第8题【填空题】
请根据参赛材料 FC-01 回答以下问题: 涉案人员冯程(Fung Ching)其 WhatsApp 账号所设定之个人头像原始图片档案,在该备份架构的列表索引(Manifest)中,该头像档案所对应的备份文件标识符(fileID)为何? (答案格式:请按照原始记录完整作答,英文字母统一为全小写和数字)
df40ecf80230f659346084bc556ce96b0646eb2f
查看 WhatsApp 账号信息
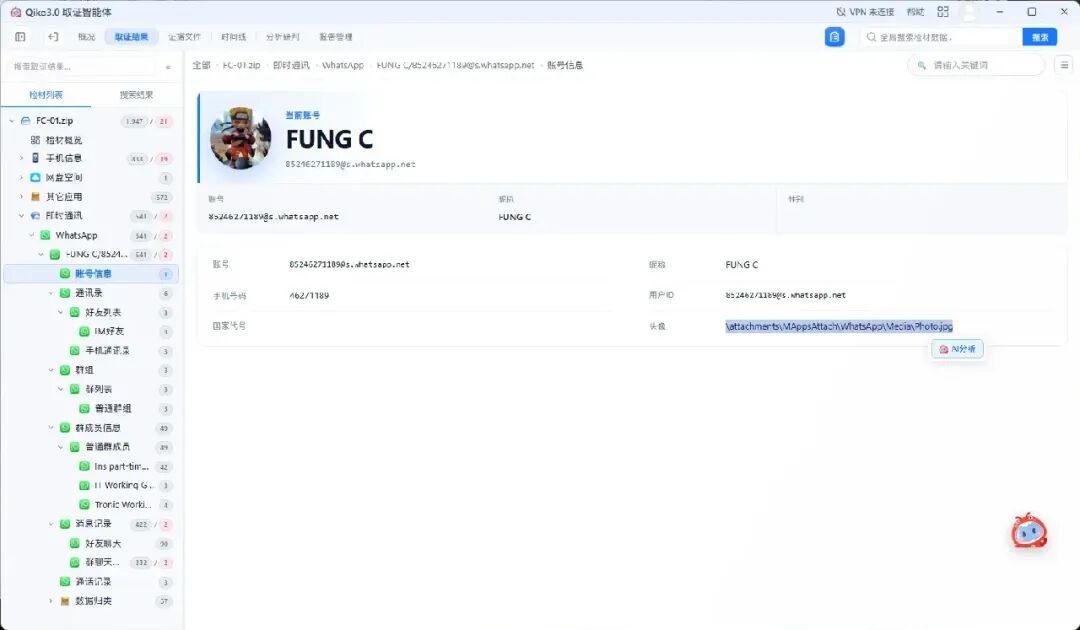
头像文件名为 Photo.jpg
在 /var/Manifest.db 中检索该文件名
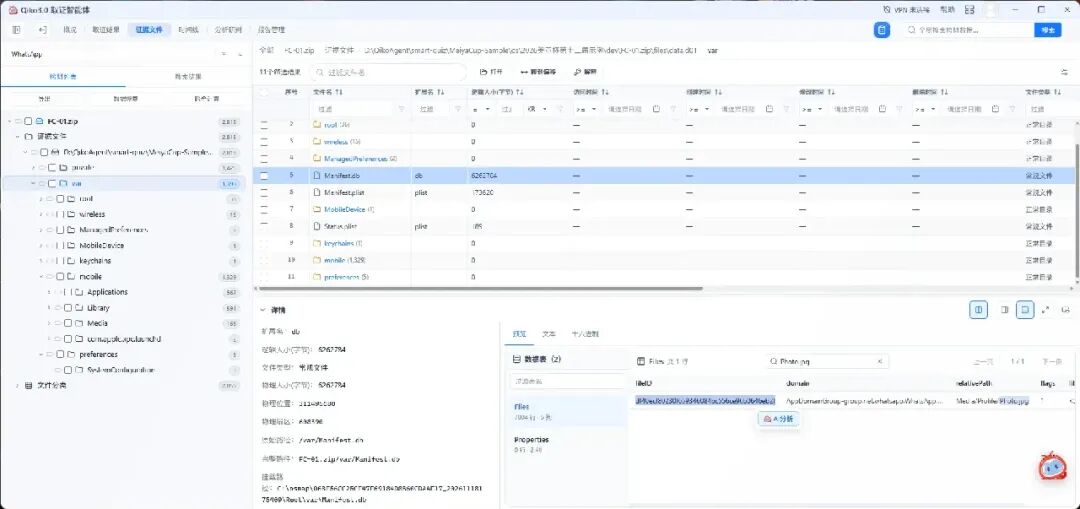
fileID 字段就是答案
第9题【填空题】
请根据参赛材料 FC-01 回答以下问题: 调查人员在分析涉案人员冯程(Fung Ching)的手机时,发现涉案人员曾试图销毁关键照片。请问哪一张照片在拍摄或生成后不足 20 秒内即被迅速移至垃圾桶? (答案格式:请按照源文件名称完整作答,并保留英文大小写与扩展名,例如:IMG_0123.JPG)
IMG_0001.PNG
本题存疑,官方赛后的赛题讲解中答案是 IMG_0015.JPG,而且是直接从
Photos.sqlite中分析得出的但是数据库里根本没有这张图片
因此可能还是要翻预写日志
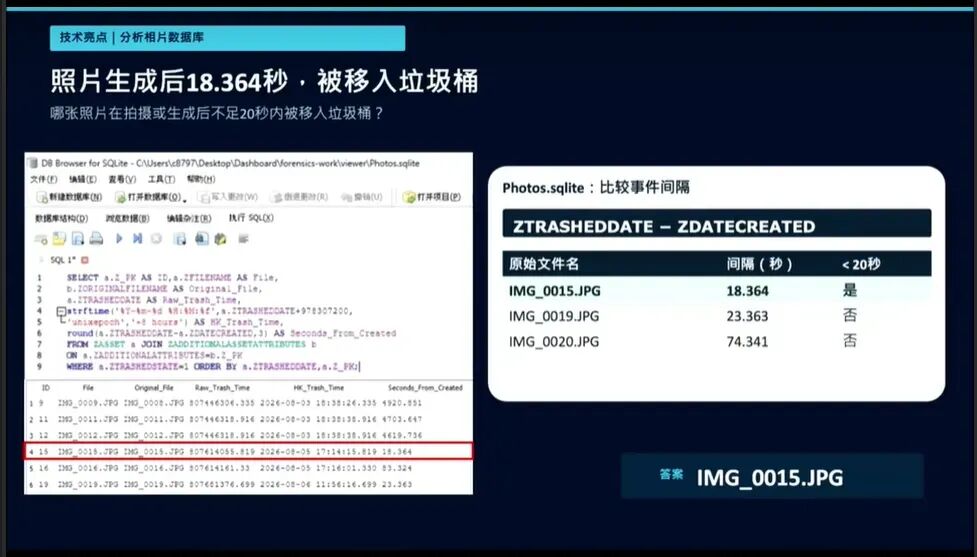
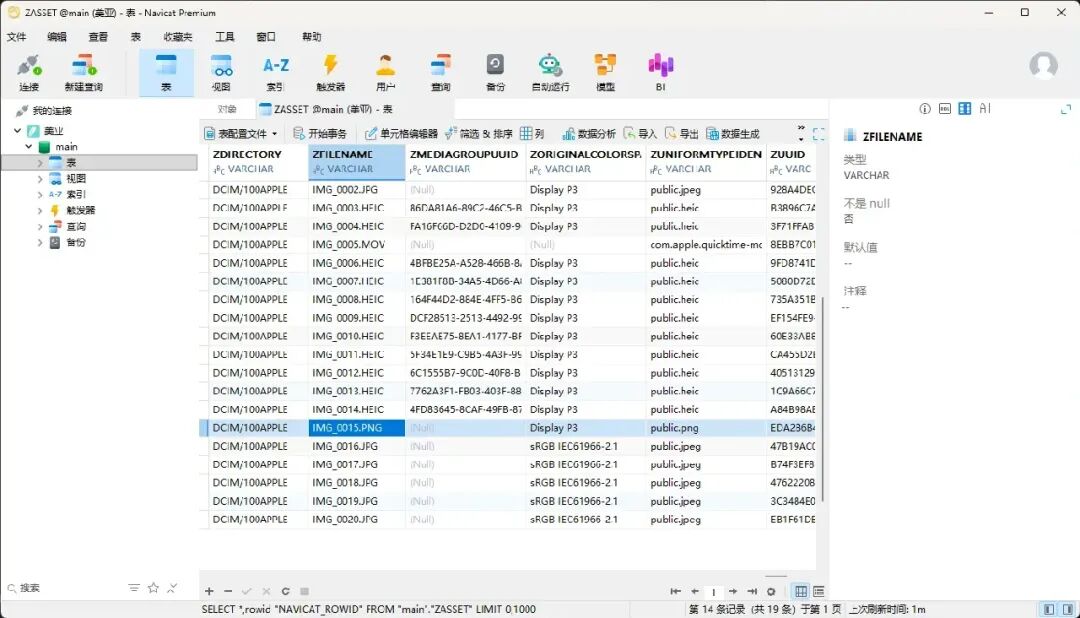
关于照片要查找照片数据库,路径 /var/mobile/Media/PhotoData/Photos.sqlite
导出后用 navicat 连接,查看 ZASSET 表,重点关注下面 3 个字段
ZFILENAME:文件名 ZDATECREATED:照片创建时间 ZTRASHEDDATE:删除时间 ZTRASHEDSTATE:照片状态,1 表示已删除,0 表示未删除
由此可以写出查询语句
select ZFILENAME, ZDATECREATED, ZTRASHEDDATE, round(ZTRASHEDDATE-ZDATECREATED,3) as seconds
from ZASSET
where ZTRASHEDSTATE=1 and seconds < 20;
但是什么都没有查询到
查看一下数据表
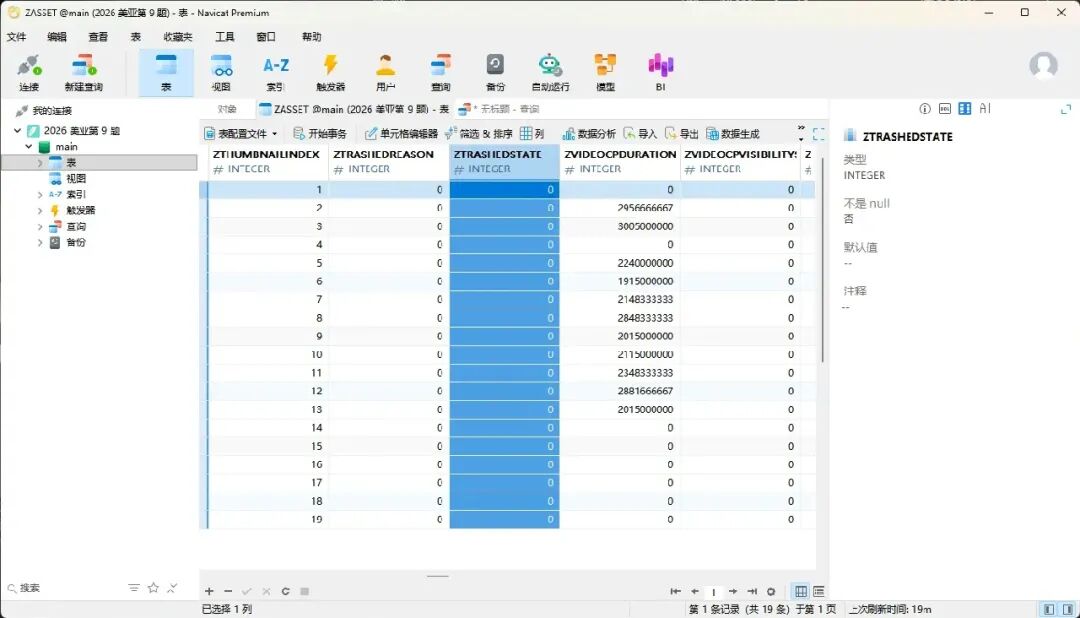
发现原表中所有记录的 ZTRASHEDSTATE 字段均为 0,还没有照片被删除
由此考虑被删除照片的记录可能在数据库的预写日志中
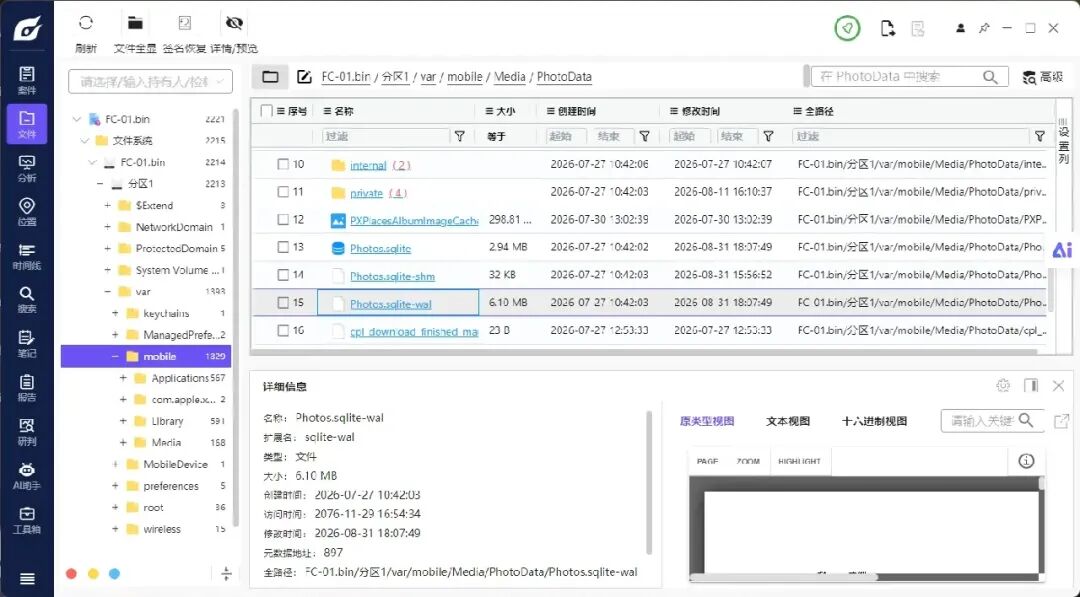
如上图中的 Photos.sqlite-wal 就是主数据库 Photos.sqlite 的预写日志
WAL 是 SQLite 的预写日志(Write-Ahead Log)。在 WAL 模式下,SQLite 先把修改后的数据库页追加到
Photos.sqlite-wal,之后再把已提交的页写回Photos.sqlite。所以,事务已经提交和修改已经写回主库是两个不同的时刻。
因此 wal 可以理解为一张张数据库页的快照,每页的修改优先记录到 wal 中,等到某个检查点再将 wal 中的快照合并到主数据库对应页上
比如,某次事务先修改了第 7 页,再修改了第 12 页,并在第二帧提交。要读出这次提交后的整个数据库快照,sqlite 从 wal 取第 7 和第 12 页,其余页从主库读取。一个页有多个版本时,取该提交点以内最新的那个
当到达某个检查点时,wal 中会把已提交的页的快照合并到主库中,因此 wal 记录各个页的每次变更,合并后的主库只有多次变更后的结果
因此我们查询不到被删除的照片,要么是这张被删除照片的记录还在 wal 中,没有合并,要么是在多次合并后被覆盖了
将 wal 文件和主数据库一并导出,放在同一目录下,sqlite 解析时会自动从 wal 中取最新帧合并到主数据库中,但是还没有查询到,那么原因显然是在多次合并后被覆盖了
这道题的思路是将 wal 中多个帧从早到晚依次合并到主库中,对每次合并执行上面的查询语句,看看能不能查到些什么
依次合并并查询的脚本:
"""Inspect SQLite WAL files, reconstruct snapshots, and run SQL on copies."""

import argparse
from contextlib import closing, nullcontext
import csv
from dataclasses import dataclass
from itertools import chain
from pathlib import Path
import shutil
import sqlite3
import struct
import sys
from tempfile import SpooledTemporaryFile, TemporaryDirectory


WAL_HEADER_SIZE = 32
FRAME_HEADER_SIZE = 24
DATABASE_MAGIC = b"SQLite format 3\x00"
MAX_PAGE = 0xFFFFFFFE


@dataclass(frozen=True)
class Frame:
    offset: int
    page: int
    commit_pages: int


@dataclass
class Wal:
    size: int
    page_size: int = 0
    checkpoint_sequence: int = 0
    slots: int = 0
    tail_bytes: int = 0
    frames: tuple = ()
    commits: tuple = ()
    stop_reason: str = ""


def valid_page_size(size):
    return512 <= size <= 65536and (size & (size - 1)) == 0


def checksum(words, data, state):
    first, second = state
    for left, right in words.iter_unpack(data):
        first = (first + left + second) & 0xFFFFFFFF
        second = (second + right + first) & 0xFFFFFFFF
    return first, second


def read_wal(file):
    size = file.seek(0, 2)
    file.seek(0)
    ifnot size:
        return Wal(size)
    header = file.read(WAL_HEADER_SIZE)
    if len(header) != WAL_HEADER_SIZE:
        raise ValueError("incomplete WAL header")
    magic, version, page_size, sequence, salt_a, salt_b, check_a, check_b = (
        struct.unpack(">8I", header)
    )
    if magic notin (0x377F0682, 0x377F0683) or version != 3007000:
        raise ValueError("unsupported SQLite WAL magic or format version")
    ifnot valid_page_size(page_size):
        raise ValueError(f"invalid WAL page size {page_size}")
    words = struct.Struct("<II"if magic == 0x377F0682else">II")
    state = checksum(words, header[:24], (0, 0))
    if state != (check_a, check_b):
        raise ValueError("WAL header checksum mismatch")

    frame_size = FRAME_HEADER_SIZE + page_size
    slots, tail_bytes = divmod(size - WAL_HEADER_SIZE, frame_size)
    frames = []
    commits = []
    stop_reason = ""
    for number in range(1, slots + 1):
        offset = file.tell()
        raw = file.read(frame_size)
        if len(raw) != frame_size:
            raise ValueError("WAL size changed while reading; use an offline copy")
        page, commit_pages, a, b, check_a, check_b = struct.unpack_from(">6I", raw)
        if (a, b) != (salt_a, salt_b):
            stop_reason = "salt mismatch (possible frame from an older WAL generation)"
            break
        ifnot1 <= page <= MAX_PAGE or commit_pages > MAX_PAGE:
            stop_reason = "invalid page number or database size"
            break
        state = checksum(words, memoryview(raw)[:8], state)
        state = checksum(words, memoryview(raw)[FRAME_HEADER_SIZE:], state)
        if state != (check_a, check_b):
            stop_reason = "frame checksum mismatch"
            break
        frames.append(Frame(offset, page, commit_pages))
        if commit_pages:
            commits.append(number)
    return Wal(
        size, page_size, sequence, slots, tail_bytes,
        tuple(frames), tuple(commits), stop_reason,
    )


def report_wal(wal, stream):
    last_commit = wal.commits[-1] if wal.commits else0
    print(f"WAL bytes: {wal.size}", file=stream)
    print(f"Page bytes: {wal.page_size or 'unknown (empty WAL)'}", file=stream)
    print(f"Frame header bytes: {FRAME_HEADER_SIZE}", file=stream)
    if wal.page_size:
        print(f"Frame bytes: {wal.page_size + FRAME_HEADER_SIZE}", file=stream)
        print(f"Checkpoint sequence: {wal.checkpoint_sequence}", file=stream)
    print(f"Complete frame slots: {wal.slots}", file=stream)
    print(f"Valid consecutive frames: {len(wal.frames)}", file=stream)
    print(f"Commit frames: {len(wal.commits)}", file=stream)
    print(f"Last commit frame: {last_commit}", file=stream)
    print(f"Valid frames after last commit: {len(wal.frames) - last_commit}", file=stream)
    print(f"Incomplete final slot bytes: {wal.tail_bytes}", file=stream)
    if wal.stop_reason:
        print(f"Validation stopped at frame {len(wal.frames) + 1}: {wal.stop_reason}", file=stream)


def warn_wal_tail(wal):
    if wal.stop_reason:
        print(f"Warning: frame {len(wal.frames) + 1}: {wal.stop_reason}", file=sys.stderr)
    if wal.tail_bytes:
        print(f"Warning: ignoring {wal.tail_bytes} bytes in a partial slot", file=sys.stderr)


def frame_limit(wal, start, end):
    limit = len(wal.frames) if end isNoneelse end
    if limit > len(wal.frames) or start > max(limit, 1):
        raise ValueError(f"frame range must be within the {len(wal.frames)} valid frames")
    return limit


def list_frames(wal, start, end, stream):
    warn_wal_tail(wal)
    limit = frame_limit(wal, start, end)
    writer = csv.writer(stream, lineterminator="\n")
    writer.writerow(("frame", "offset", "page", "commit_database_pages", "frame_bytes"))
    for index in range(start - 1, limit):
        frame = wal.frames[index]
        writer.writerow((index + 1, frame.offset, frame.page, frame.commit_pages,
                         FRAME_HEADER_SIZE + wal.page_size))


def select_frame(wal, requested, committed):
    warn_wal_tail(wal)
    if requested == "latest":
        return wal.commits[-1] if wal.commits else0
    try:
        number = int(requested)
    except ValueError:
        raise ValueError("--frame requires a frame number or latest") fromNone
    ifnot0 <= number <= len(wal.frames):
        raise ValueError(f"frame {number} is outside valid range 0..{len(wal.frames)}")
    if committed:
        return max((item for item in wal.commits if item <= number), default=0)
    return number


def database_page_size(db, wal):
    size = db.seek(0, 2)
    db.seek(0)
    header = db.read(100)
    if len(header) != 100or header[:16] != DATABASE_MAGIC:
        raise ValueError("main file does not have a standard SQLite database header")
    page_size = struct.unpack_from(">H", header, 16)[0]
    if page_size == 1:
        page_size = 65536
    ifnot valid_page_size(page_size) or size < page_size or size % page_size:
        raise ValueError("main database has an invalid page size or incomplete pages")
    if wal.page_size and wal.page_size != page_size:
        raise ValueError(f"database page size {page_size} differs from WAL page size {wal.page_size}")
    return page_size


def apply_frame(db, wal_file, frame, page_size):
    wal_file.seek(frame.offset + FRAME_HEADER_SIZE)
    contents = wal_file.read(page_size)
    if len(contents) != page_size:
        raise ValueError("WAL changed while building the snapshot; use an offline copy")
    db.seek((frame.page - 1) * page_size)
    db.write(contents)
    if frame.commit_pages:
        db.truncate(frame.commit_pages * page_size)


def finalize_snapshot(path, page_size, replayed):
    with path.open("r+b") as db:
        db.seek(0)
        header = bytearray(db.read(100))
        if len(header) != 100or header[:16] != DATABASE_MAGIC:
            raise ValueError("replayed page 1 does not have a standard SQLite database header")
        result_size = db.seek(0, 2)
        header[18:20] = b"\x01\x01"# Standalone database, with no WAL sidecar required.
        if replayed:
            struct.pack_into(">I", header, 28, result_size // page_size)
            header[92:96] = header[24:28]  # Mark the database size field as valid.
        db.seek(0)
        db.write(header)


def build_snapshot(source, output, wal_file, wal, number):
    shutil.copyfile(source, output)
    with output.open("r+b") as db:
        page_size = database_page_size(db, wal)
        for index in range(number):
            apply_frame(db, wal_file, wal.frames[index], page_size)
    finalize_snapshot(output, page_size, number)


def check_snapshot(db):
    errors = db.execute("PRAGMA quick_check").fetchall()
    if errors != [("ok",)]:
        raise ValueError("SQLite quick_check failed: " + "; ".join(row[0] for row in errors[:5]))


def publish_snapshot(source, destination):
    # Refuse an existing destination, including a concurrently created one.
    for suffix in ("-wal", "-shm", "-journal"):
        if Path(str(destination) + suffix).exists():
            raise ValueError(f"output already has a SQLite sidecar: {destination}{suffix}")
    with destination.open("xb") as output:
        try:
            with source.open("rb") as data:
                shutil.copyfileobj(data, output)
            output.flush()
        except BaseException:
            output.close()
            destination.unlink(missing_ok=True)
            raise


def statements(sql):
    start = 0
    for end, char in enumerate(sql, 1):
        if char == ";"and sqlite3.complete_statement(sql[start:end]):
            yield sql[start:end]
            start = end
    if sql[start:].strip():
        yield sql[start:]


def authorize_scratch(action, arg1, _arg2, _database, _trigger):
    # Prevent a query from attaching or exporting to an external database file.
    # VACUUM uses an internal attachment whose filename is empty.
    if action == sqlite3.SQLITE_ATTACH and arg1 != "":
        return sqlite3.SQLITE_DENY
    return sqlite3.SQLITE_OK


def query_snapshot(db, sql, stream, include_empty=True):
    db.set_authorizer(authorize_scratch)
    writer = csv.writer(stream, lineterminator="\n")
    written_set = False
    has_rows = False
    for statement in statements(sql):
        cursor = db.execute(statement)
        if cursor.description isNone:
            continue
        first = cursor.fetchone()
        if first isNoneandnot include_empty:
            continue
        if written_set:
            writer.writerow([])
        written_set = True
        writer.writerow(column[0] for column in cursor.description)
        if first isNone:
            continue
        has_rows = True
        for row in chain((first,), cursor):
            writer.writerow(value.hex() if isinstance(value, bytes) else value for value in row)
    return written_set, has_rows


def read_sql(args):
    if args.sql_file == Path("-"):
        return sys.stdin.read()
    if args.sql_file isnotNone:
        return args.sql_file.read_text(encoding="utf-8-sig")
    return args.sql


def list_columns(db, table, stream):
    relations = db.execute(
        """SELECT name, type FROM sqlite_schema
           WHERE type IN ('table', 'view') AND (? IS NULL OR name = ? COLLATE NOCASE)
           ORDER BY type, name""",
        (table, table),
    ).fetchall()
    if table isnotNoneandnot relations:
        raise ValueError(f"no table or view named {table!r} at this frame")
    writer = csv.writer(stream, lineterminator="\n")
    writer.writerow(("table", "kind", "cid", "column", "type", "not_null",
                     "default", "primary_key_position", "hidden"))
    for name, kind in relations:
        for row in db.execute(
            'SELECT cid, name, type, "notnull", dflt_value, pk, hidden '
            'FROM pragma_table_xinfo(?, \'main\') ORDER BY cid', (name,)
        ):
            writer.writerow((name, kind, *row))


def scan_frames(args, wal_file, wal, folder, stream):
    warn_wal_tail(wal)
    limit = frame_limit(wal, args.start, args.end)
    sql = read_sql(args)
    ifnot sql.strip():
        raise ValueError("SQL is empty")
    ifnot args.commits_only and limit > 0:
        print("Scanning all requested frames, including incomplete transactions.", file=sys.stderr)
    replay = folder / "replay.sqlite"
    snapshot = folder / "query.sqlite"
    shutil.copyfile(args.database, replay)
    tested = matched = failed = 0
    failure_examples = []
    with replay.open("r+b") as db_file:
        page_size = database_page_size(db_file, wal)
        for number in range(1, limit + 1):
            frame = wal.frames[number - 1]
            apply_frame(db_file, wal_file, frame, page_size)
            if number < args.start or (args.commits_only andnot frame.commit_pages):
                continue
            tested += 1
            db_file.flush()
            # SQL can modify its private copy without affecting the next frame.
            for suffix in ("-wal", "-shm", "-journal"):
                snapshot.with_name(snapshot.name + suffix).unlink(missing_ok=True)
            shutil.copyfile(replay, snapshot)
            with SpooledTemporaryFile(mode="w+t", encoding="utf-8", newline="",
                                      max_size=1024 * 1024) as rows:
                try:
                    finalize_snapshot(snapshot, page_size, number)
                    with closing(sqlite3.connect(snapshot, isolation_level=None)) as db:
                        if args.check:
                            check_snapshot(db)
                        _, has_rows = query_snapshot(db, sql, rows, args.include_empty)
                except (ValueError, sqlite3.Error) as exc:
                    failed += 1
                    if len(failure_examples) < 5:
                        failure_examples.append((number, str(exc)))
                    continue
                matched += has_rows
                if has_rows or args.include_empty:
                    label = "commit"if frame.commit_pages else"uncommitted"
                    print(f"Frame {number} ({label})", file=stream)
                    if has_rows:
                        rows.seek(0)
                        shutil.copyfileobj(rows, stream)
                    else:
                        print("(no rows)", file=stream)
                    print(file=stream)
                    stream.flush()
    print(f"Scan complete: tested {tested}, matched {matched}, "
          f"empty {tested - matched - failed}, failed {failed}.", file=sys.stderr)
    for number, message in failure_examples:
        print(f"Frame {number}: {message}", file=sys.stderr)
    if failed > len(failure_examples):
        print(f"{failed - len(failure_examples)} additional failures.", file=sys.stderr)
    return int(tested > 0and failed == tested)


def positive(value):
    number = int(value)
    if number < 1:
        raise argparse.ArgumentTypeError("must be at least 1")
    return number


def parser():
    cli = argparse.ArgumentParser(description=__doc__)
    command = cli.add_subparsers(dest="command")
    info = command.add_parser("info", help="show WAL sizes, frame counts and validation")
    info.add_argument("wal", type=Path)
    frames = command.add_parser("frames", help="list valid WAL frames as CSV")
    frames.add_argument("wal", type=Path)
    snapshot = command.add_parser("snapshot", help="export a standalone SQLite database")
    schema = command.add_parser("schema", help="list tables, views and fields at a frame")
    schema.add_argument("--table", help="list fields for just this table or view")
    query = command.add_parser("query", help="execute SQL on a temporary snapshot")
    scan = command.add_parser("scan", help="run the same SQL at each selected frame")
    scan.add_argument("--commits-only", action="store_true", help="query only commit frames")
    scan.add_argument("--include-empty", action="store_true", help="also show frames with no rows")
    for item in (frames, scan):
        item.add_argument("--start", type=positive, default=1, help="first frame, inclusive")
        item.add_argument("--end", type=positive, help="last frame, inclusive")
    for item in (query, scan):
        sql = item.add_mutually_exclusive_group(required=True)
        sql.add_argument("--sql", help="inline SQL")
        sql.add_argument("--sql-file", type=Path, help="UTF-8 SQL file, or - for stdin")
    for item in (snapshot, schema, query, scan):
        item.add_argument("database", type=Path, help="original main database")
        item.add_argument("--wal", type=Path, help="default: DATABASE-wal")
        item.add_argument("--check", action="store_true", help="require SQLite PRAGMA quick_check to pass")
    for item in (snapshot, schema, query):
        item.add_argument("--frame", default="latest", help="1-based frame, 0 for main file, or latest")
        item.add_argument("--committed", action="store_true", help="use last commit at or before the frame")
    for item in (info, frames, schema, query, scan):
        item.add_argument("-o", "--output", type=Path, help="write results to a new UTF-8 file")
    snapshot.add_argument("output", type=Path, help="new database file")
    return cli


def run(args, stream):
    if args.command in ("info", "frames"):
        with args.wal.open("rb") as file:
            wal = read_wal(file)
        if args.command == "info":
            report_wal(wal, stream)
        else:
            list_frames(wal, args.start, args.end, stream)
        return0

    source = args.database
    wal_path = args.wal or source.with_name(source.name + "-wal")
    try:
        wal_context = wal_path.open("rb")
    except FileNotFoundError:
        if args.wal isnotNone:
            raise
        print(f"No WAL file at {wal_path}; using the main database.", file=sys.stderr)
        wal_context = nullcontext(None)
    with TemporaryDirectory() as folder, wal_context as file:
        wal = read_wal(file) if file isnotNoneelse Wal(0)
        if args.command == "scan":
            return scan_frames(args, file, wal, Path(folder), stream)
        frame = select_frame(wal, args.frame, args.committed)
        print(f"Snapshot at frame {frame}", file=sys.stderr)
        if frame andnot wal.frames[frame - 1].commit_pages:
            print("Warning: stopping inside a transaction; the database may be inconsistent.",
                  file=sys.stderr)
        temp = Path(folder) / "snapshot.sqlite"
        build_snapshot(source, temp, file, wal, frame)
        if args.command in ("query", "schema") or args.check:
            with closing(sqlite3.connect(temp, isolation_level=None)) as db:
                if args.check:
                    check_snapshot(db)
                if args.command == "query":
                    written_set, _ = query_snapshot(db, read_sql(args), stream)
                    ifnot written_set:
                        print("SQL completed (no result set)", file=sys.stderr)
                elif args.command == "schema":
                    list_columns(db, args.table, stream)
        if args.command == "snapshot":
            publish_snapshot(temp, args.output)
            print(f"Saved: {args.output}", file=stream)
    return0


def main():
    cli = parser()
    args = cli.parse_args()
    if args.command isNone:
        cli.print_help()
        return0
    try:
        if args.command == "snapshot"or args.output isNone:
            return run(args, sys.stdout)
        with args.output.open("x", encoding="utf-8", newline="") as stream:
            status = run(args, stream)
        print(f"Results written to {args.output}", file=sys.stderr)
        return status
    except (OSError, ValueError, sqlite3.Error, OverflowError) as exc:
        print(f"Error: {exc}", file=sys.stderr)
        return1


if __name__ == "__main__":
    sys.exit(main())
用法:
python scan_wal.py scan Photos.sqlite --sql-file query.sql
query.sql 的内容为:
select ZFILENAME, ZDATECREATED, ZTRASHEDDATE, round(ZTRASHEDDATE-ZDATECREATED,3) as seconds
from ZASSET not INDEXED
where ZTRASHEDSTATE=1 and seconds < 20;
使用 not INDEXED 是因为在部分帧中 sqlite 为 ZTRASHEDSTATE = 1 选用了索引 Z_Asset_compoundIndex8。完整性检查显示,这一帧里该索引的条目数与表数据对不上,原查询走这个索引时就报了 database disk image is malformed,因此使用 not INDEXED 让 sqlite 不走索引直接扫描数据表避免报错
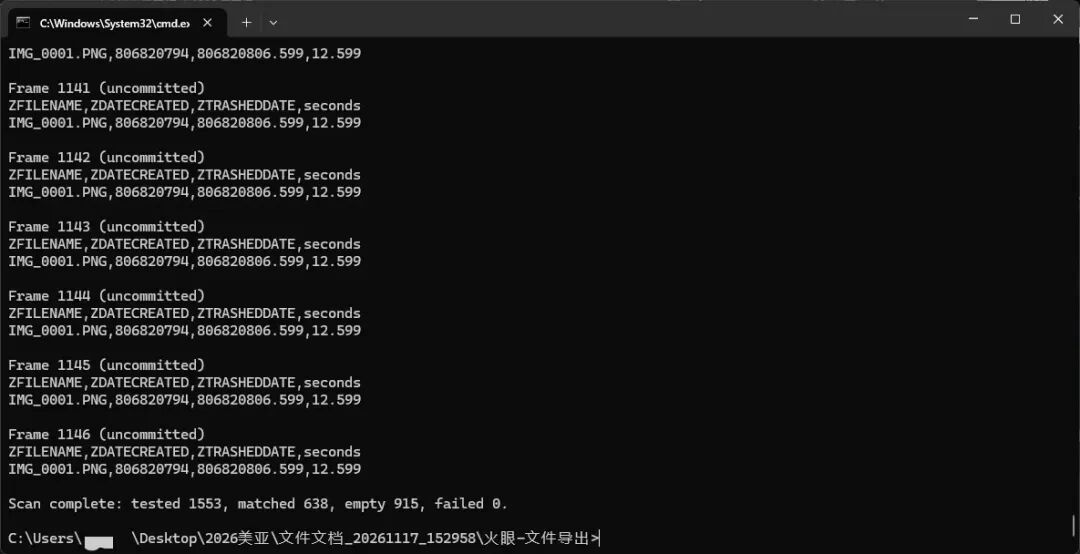
扫描显示共查询 1553 帧,其中有 638 帧存在被删除图片的信息
文件名为 IMG_0001.PNG,从创建到被删除的时间为 12.599 秒,满足题意
第10题【单选题】
请根据参赛材料 FC-01 回答以下问题: 承接上题,在涉案群组的视讯通话记录中,唯一被涉案装置成功接通的视讯通话,其所属组名、通话开始时间(以UTC+8计算)及通话持续时间分别为何?
A. Tronic Working Group, 2026-08-04 09:48:25, 135秒 B. Tronic Working Group, 2026-08-04 17:48:25, 135秒 C. Tronic Working Group, 2026-08-06 14:10:48, 54秒 D. IT Working Group, 2026-08-04 09:48:25, 135秒 E. IT Working Group, 2026-08-04 17:48:25, 135秒
A
看 Qiko 的 WhatsApp 通话记录
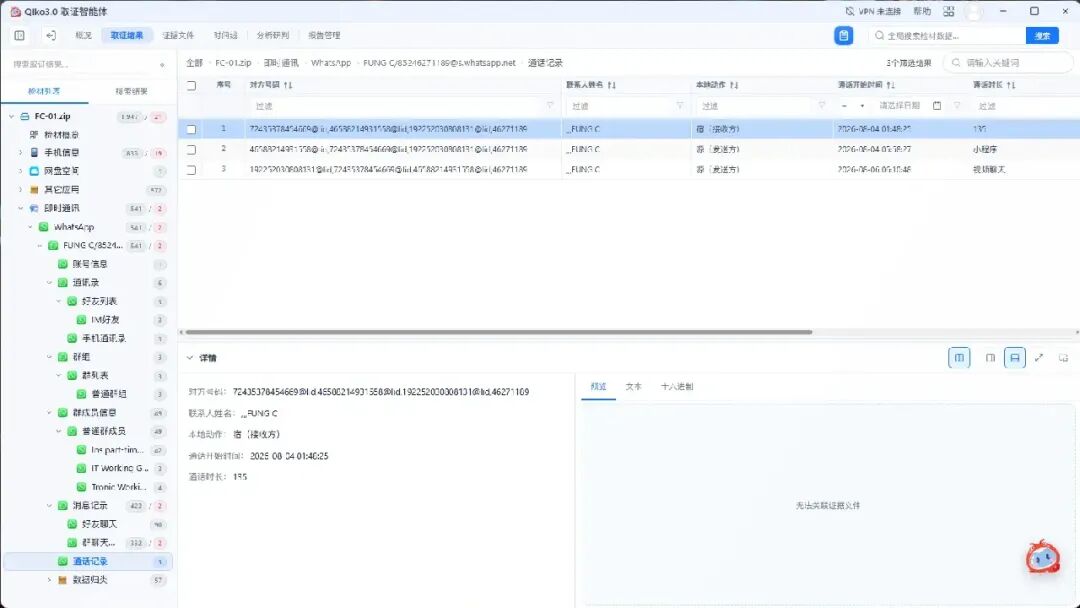
看不出哪个是唯一被成功接通的,再看看弘连
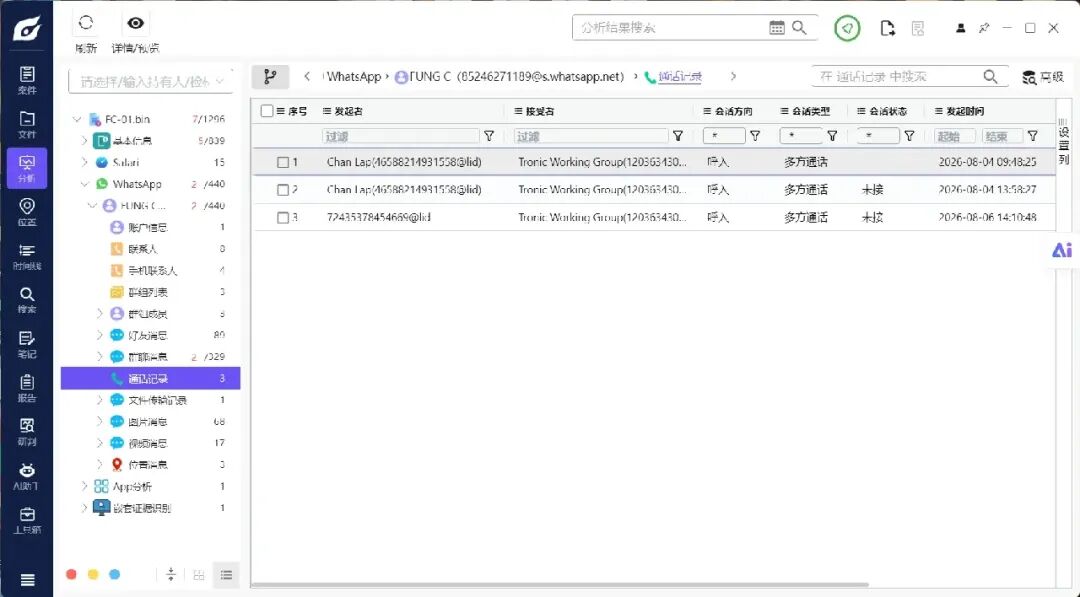
结合两个工具的结果可以确定是第一条,所属组名为 Tronic Working Group,通话开始时间为 2026-08-04 09:48:25(Qiko 中需要 UTC+8),通话持续时间为 135s
第11题【填空题】
请根据参赛材料 FC-01 回答以下问题: 根据底层系统进程导入记录(Imported By Bundle Identifier),该手机上主动进行屏幕截图(Screenshots)的图像共有多少张? (答案格式:仅填写阿拉伯数字)
2
(本题存疑,参考答案为 11)
还是图片相关,和第 9 题一样,找图片数据库 /var/mobile/Media/PhotoData/Photos.sqlite 和同目录下的预写日志 Photos.sqlite-wal
需要把预写日志中各帧合并进主数据库
iOS 原生按键主动截图,是由 SpringBoard(系统桌面进程) 完成,它的 Bundle Identifier:com.apple.springboard。 在
Photos.sqlite中,ZADDITIONALASSETATTRIBUTES.ZIMPORTEDBYBUNDLEIDENTIFIER(题目所说 Imported By Bundle Identifier)字段会记录这张图片是由哪个进程导入相册;原生按键截图这条字段值就是com.apple.springboard。
通过前面的脚本将各帧合并进主数据库后依次执行如下查询语句
select ZORIGINALFILENAME from ZADDITIONALASSETATTRIBUTES not INDEXED where ZIMPORTEDBYBUNDLEIDENTIFIER = 'com.apple.springboard';
查询结果显示有的帧有两张符合条件的图片(IMG_0001.PNG 和 IMG_0015.PNG),有的帧只有一张(IMG_0015.PNG)
暂定答案为 2
第12题【单选题】
请根据参赛材料 FC-01 回答以下问题: 调查人员在分析涉案人员冯程(Fung Ching)装置内的 WhatsApp 群组记录时,发现有一条讯息提及两名客户分别投资 HK500,000。最早阅读该讯息的群组成员是谁?
A. Lap Chan B. Lik Lee C. Ching Fung D. Tronic_Office
参考答案为 A,实际存疑,下面是官方解题思路
在 Tronic Working Group 群组中定位到相应消息
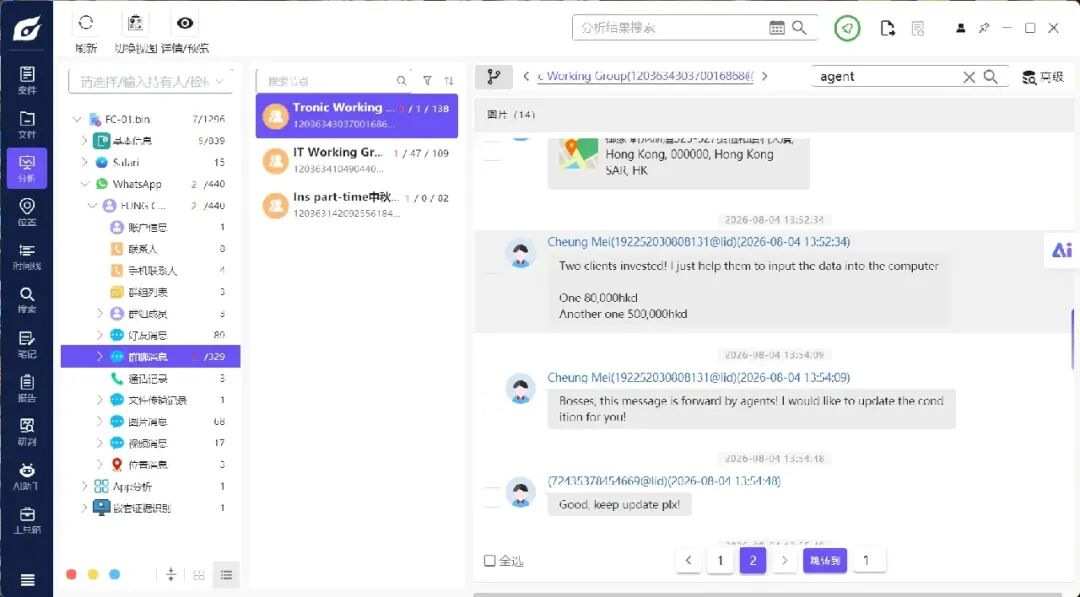
定位到源数据库 /var/mobile/Applications/group.net.whatsapp.WhatsApp.shared/ChatStorage.sqlite
由于需要查找最早阅读该讯息的群组成员,因此需要查找已读回执,在 /var/mobile/Applications/group.net.whatsapp.WhatsApp.shared/MessagingInfraDB_v2/MessagingInfraDatabase.sqlite 数据库中
首先需要在 ChatStorage.sqlite 数据库中找到这条消息
SELECT Z_PK, ZSTANZAID, ZTEXT, ZMESSAGEDATE, ZISFROMME, ZCHATSESSION
FROM ZWAMESSAGE
WHERE ZTEXT LIKE '%80,000hkd%500,000hkd';
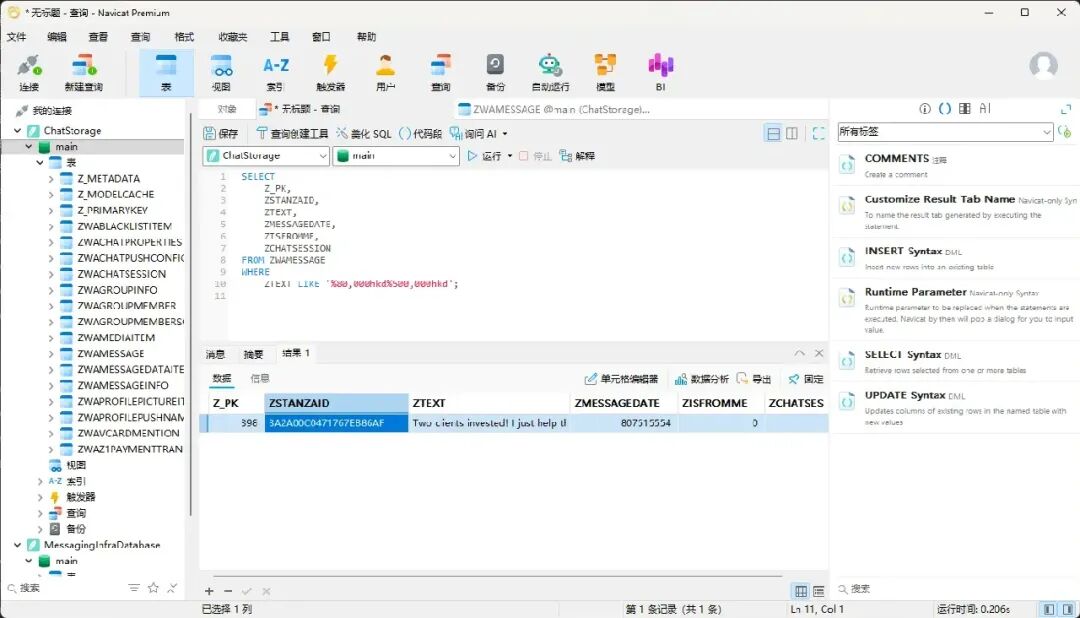
重点是拿到这条消息 ZSTANZAID 字段的内容(如上图,为 3A2A00C0471767EB86AF)
接着拿着这个值到 MessagingInfraDatabase.sqlite 数据库中去查找消息,按y已读时间升序排列,拿到最早的已读回执,并根据 user_jid 确定最早阅读的是哪个人
SELECT chat_jid, user_jid
FROM receipt_device
WHERE stanza_id = '3A2A00C0471767EB86AF'
ORDER BY read_timestamp ASC;
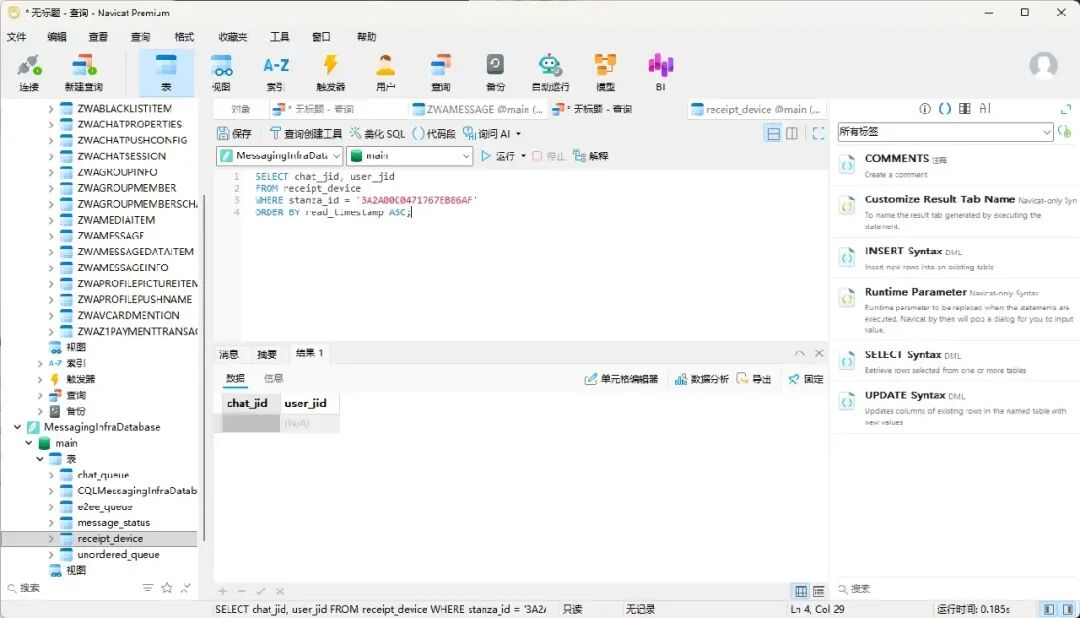
但是并没有找到这条记录,因此本题存疑
第13题【多选题】
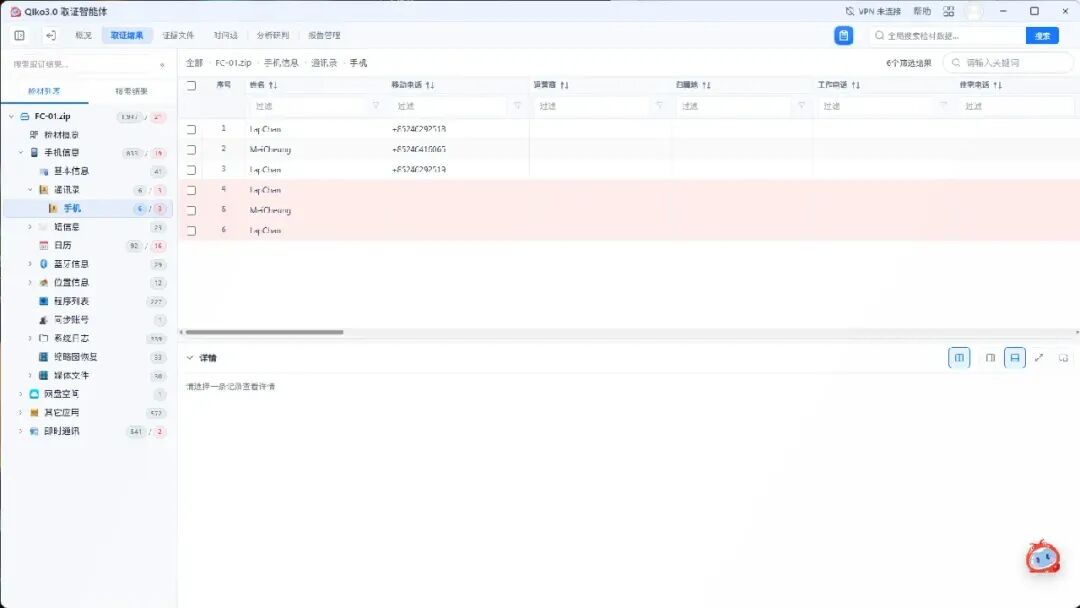
请根据参赛材料 FC-01 回答以下问题: 根据冯程(Fung Ching)的手机设备,以下哪些电话号码由 CHAN Lap 使用?
A. +85246292518 B. +85256115454 C. +85252846820 D. +85246292519
AD
直接看通讯录
第14题【填空题】
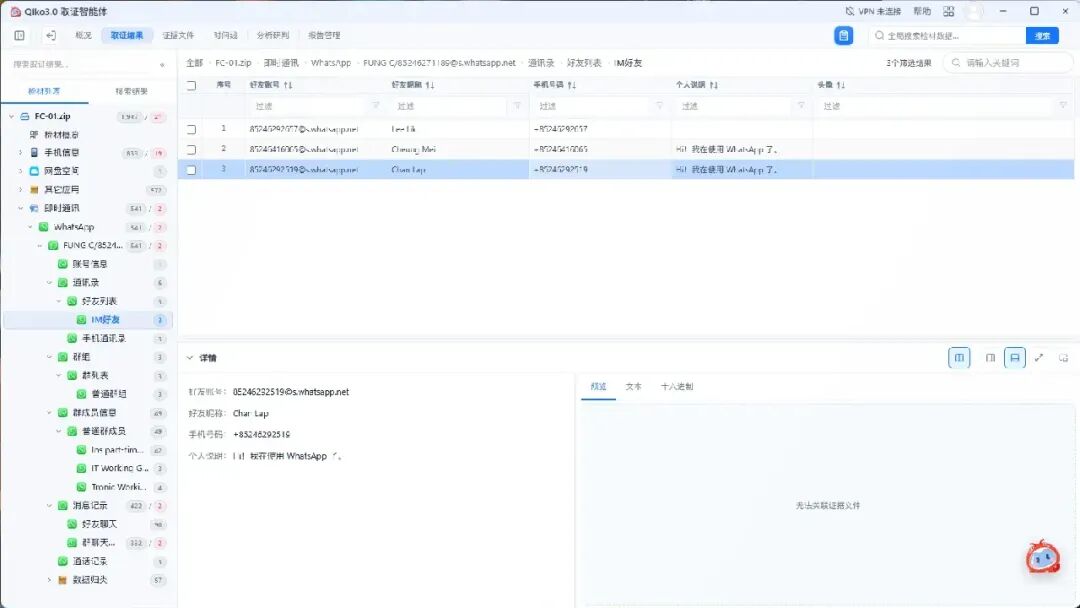
请根据参赛材料 FC-01 回答以下问题: 在「CHAN Lap(陈立)」名下登记的电话号码中,哪一个电话号码在 WhatsApp 通讯应用程序中的实际使用? (答案格式:请按照数据库原始记录完整作答,保留「+」号及全部数字,不加空格,例如:+85212345678)
+85246292519
直接看 WhatsApp 的 IM 好友
第15题【单选题】
请根据镜像文件 FC-01 回答以下问题: 该设备在相簿目录中所生成的第一张照片之完整文件名是什么?
A. IMG_0001.JPG B. IMG_0001.PNG C. IMG_0001.HEIC D. IMG_0000.HEIC
B
本题和第九题一样,需要将预写日志中的各个帧合并并依次查询
要查询第一张生成的照片文件名,需要按创建时间升序排列,查询语句如下
SELECT ZFILENAME FROM ZASSET NOT INDEXED ORDER BY ZDATECREATED ASC LIMIT 3;
选择 LIMIT 3 是因为开始用 LIMIT 1 时查询到了两个结果:IMG_0001.PNG 和 IMG_0002.JPG
修改为 LIMIT 3 发现 IMG_0001.PNG 总在 IMG_0002.JPG 上面(其实采用 LIMIT 2 也可以),因此创建时间更早的是 IMG_0001.PNG
第16题【填空题】
请根据镜像文件 FC-01 回答以下问题: 承接上题,经排查该相片已被删除。该相片被删除的准确时间是什么(以 UTC+8 表示)? (答案格式:请按 YYYY-MM-DD HH:mm:ss 格式作答,例如:2026-01-01 12:00:00)
2026-07-27 12:53:26
同上题,逐帧查询 ZTRASHEDDATE 字段
SELECT ZTRASHEDDATE FROM ZASSET NOT INDEXED WHERE ZFILENAME = 'IMG_0001.PNG';
查询到的删除时间戳为 806820806.599,转换一下即可拿到答案
第17题【填空题】
请根据镜像文件 FC-01 回答以下问题: 承接上题,请指出该相片的全局唯一标识符(ZUUID)是什么? (答案格式:请按标准 UUID 格式填写,英文字母大写并包含连字符,例如:12345678-ABCD-EF01-2345-6789ABCDEF01)
5C28BFF1-9751-4709-B0B1-B20C9ECF5D8F
同上题,逐帧查询 ZUUID 字段
SELECT ZUUID FROM ZASSET NOT INDEXED WHERE ZFILENAME = 'IMG_0001.PNG';
第18题【填空题】
请根据镜像文件 FC-01 回答以下问题: 承接上题,请指出该相片的原始文件大小是多少字节(Byte)? (答案格式:仅填写半角阿拉伯数字,例如:102400)
318970
同上题,逐帧查询 ZADDITIONALASSETATTRIBUTES 表的 ZORIGINALFILESIZE 字段
SELECT ZORIGINALFILESIZE FROM ZADDITIONALASSETATTRIBUTES NOT INDEXED WHERE ZORIGINALFILENAME = 'IMG_0001.PNG';
第19题【填空题】
请根据镜像文件 FC-01 回答以下问题: 承接上题,该已删除相片曾同步至 iCloud 的主资源记录,请指出其在数据表中所记录的云端主唯一标识符(ZCLOUDMASTERGUID)是什么? (答案格式:请严格区分英文字母大小写并完整填写字符串,包含加号“+”等特殊符号,不含空格,例如:Bq1adfkjadDSDFjkahdf+ljaljsfEdfa)
Aa1sazGmizbawcNL+g4HklK5aEqo
同上题,逐帧查询 ZCLOUDMASTER 表的 ZCLOUDMASTERGUID 字段
SELECT ZCLOUDMASTERGUID FROM ZCLOUDMASTER NOT INDEXED WHERE ZORIGINALFILENAME = 'IMG_0001.PNG';