贾浩楠 发自 凹非寺
量子位 | 公众号 QbitAI
货运自动驾驶,正在由“细分赛道”变成“兵家必争”。
变化来自一批新玩家。
原本深耕乘用车智驾的团队开始切入商用车赛道,发布会一场接一场,方法论也高度相似:通用模型、场景复用、摊薄成本。
逻辑听起来很顺——乘用车数据量更大、模型底层通用,把能力迁移到卡车上,边际成本自然下降。
由此,行业出现了一个值得被认真讨论的话题:通用模型装到卡车上,到底够不够用?如果不够,货运是不是需要一套原生于自己的物理AI?
支持“通用复用”的一方有规模效应做论据;支持“货运原生”的一方有场景约束做论据。
在这场讨论升温之前,这个赛道上已经有一批玩家默默跑了许久。
他们的运营数据、场景库和模型迭代,构成了一个无法被跳过的参照系——当行业开始讨论“通用模型能不能复用”的时候,的确有人已经用12亿公里真实货运里程,把这道题的答案写在了路上。
货运自动驾驶的三年,发生了什么
这个参照系最直观的刻度,是里程。
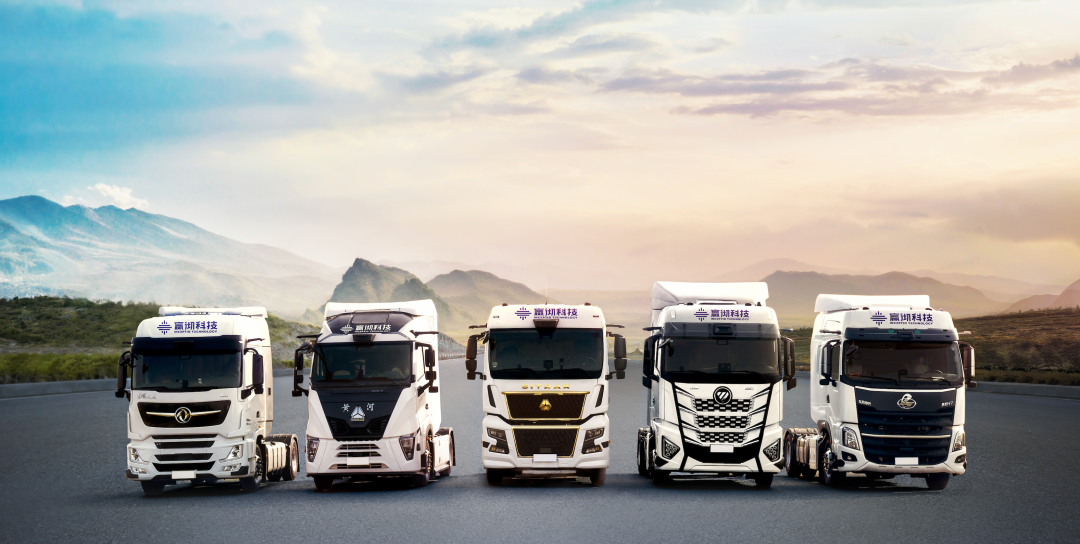
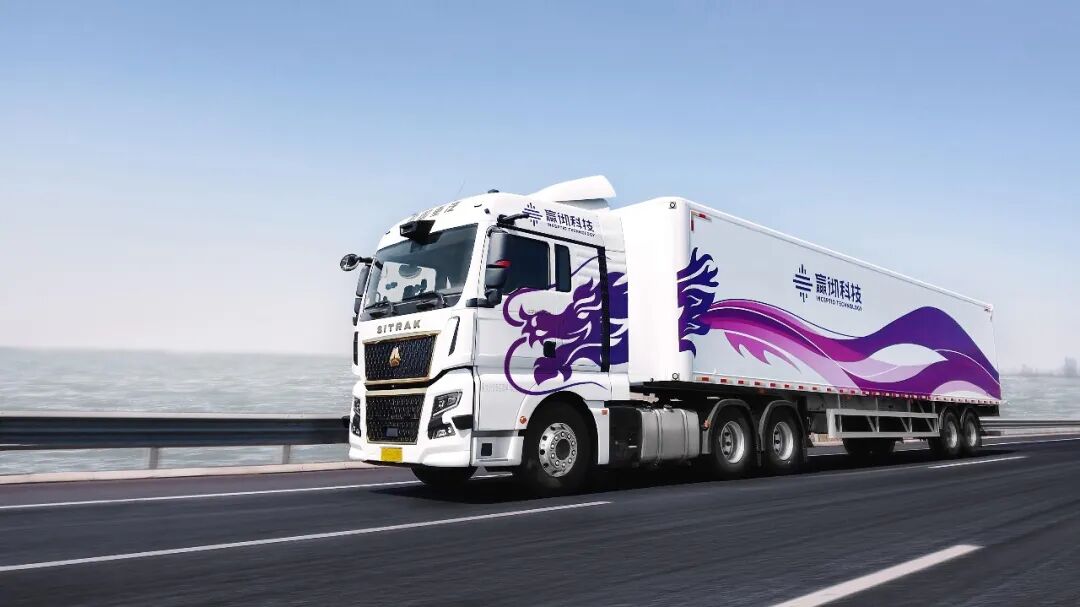
以赛道头部玩家嬴彻科技为例:其前装量产智能重卡的系统商业运营里程在8月底累计突破10亿公里;而到10月底,这个数字已经更新为12亿公里:两个月新增约2亿公里,折算下来日均新增300多万公里。
而大约三年之前,这组数据还是5000万公里——三年暴增20多倍。
这个增速与交付规模直接相关——目前嬴彻有数千台前装量产智能重卡在路上跑,预计2026年底突破1万台订单,同时行业首发L4全无人轻卡公开道路商业试运营,运营里程的累计曲线也随之快速上量。
其中高速网络覆盖率97%,头部快递快运场景市占率连续两年超90%。客户既覆盖中通、圆通、申通、韵达、顺丰、京东物流、德邦、百威中国、雀巢等头部货主与大型承运方,也已延伸至零担专线、合同物流等细分领域,涵盖冷链、汽配、酒类、快消等场景。
这些数据,客观上是自动驾驶卡车赛道落地运营领先的体现。
行业里长期流行一种判断:
L4最先商业化的很可能是智能货运,理由是货运场景的场景约束强、边界条件清晰。
顺着这个逻辑,很容易产生一种感觉——高速NOA加上重卡平台,商业化路径似乎并不复杂。
这种判断也确实影响了不少做乘用车智驾的团队进入货运赛道,发布会之后冠以“通用自动驾驶”的title。
但长期扎根智能货运自动驾驶卡车的玩家,其商业化实践呈现出的特征和复杂程度与这种流行的认知,恰恰相反。
嬴彻科技在技术层面,支撑规模化运营的,是一套覆盖车端、数据、仿真、运营的体系。嬴彻将其定义为“Freight Physical AI”,货运物理AI,有三大核心能力:货运原生智能(Freight-Native Intelligence)、场景智能(Scenario Intelligence)、运营智能 (Operational Intelligence),共同形成一条数据回流链路:
车端算法产生运营数据,真实场景数据库ROSL(Real-world Operation Scenario Library)把数据转化为场景资产,World Model把场景扩展为可训练可验证的虚拟环境,E2E端到端模型在闭环中迭代策略,Operational Brain把运营结果回流为新的数据和问题。
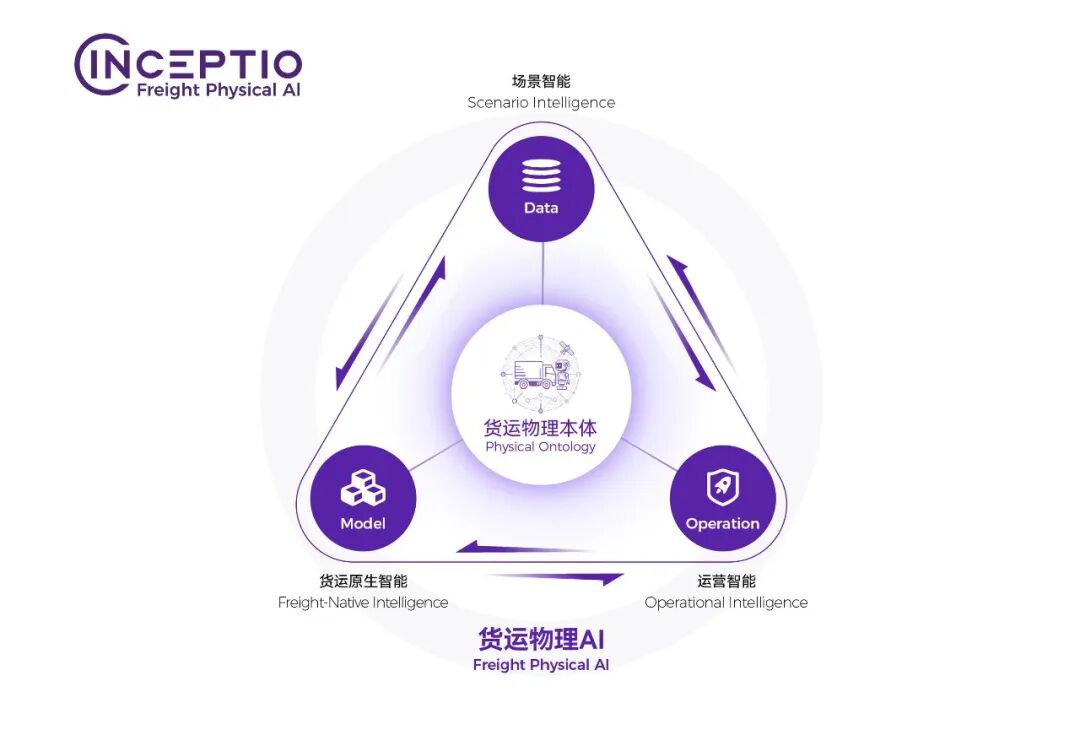
实际上是“数据飞轮”从车端软件算法,扩展到云端的运营调度策略。
这样做的原因在于,货运智驾与Robotaxi的复杂度类型不同,复杂度分布在不同位置。
Robotaxi的复杂度集中在城市长尾博弈——行人、非机动车、路口、临停、复杂交互;货运的复杂度集中在车辆物理、载荷、挂车动力学、场景长尾和运营协同。
另外,运营底层关注的目标函数,也不相同。
乘用车可以在舒适性与通行效率之间做更多权衡,但货运关注的核心是运输效率——从A到B的综合效率,其中成本、安全、人机共驾感受、可靠耐久,都是综合效率的组成部分。
更贴近车辆物理细节,更依赖运营协同,场景治理的颗粒度也更细。
最终包括嬴彻在内,长期扎根智能货运、自动驾驶卡车玩家们的商业化实践,与乘用车玩家口中的“轻松简单”大相径庭,呈现出一种深入“毛细血管”的复杂、精细程度。
A2驾照,比C1难得多
乘用车玩家们强调的“通用基座摊薄成本”论点,本身是有合理性的:
通用基座在感知、预测、基础驾驶能力上有规模效应,传感器、算力、通信模块复用确实能摊薄成本。
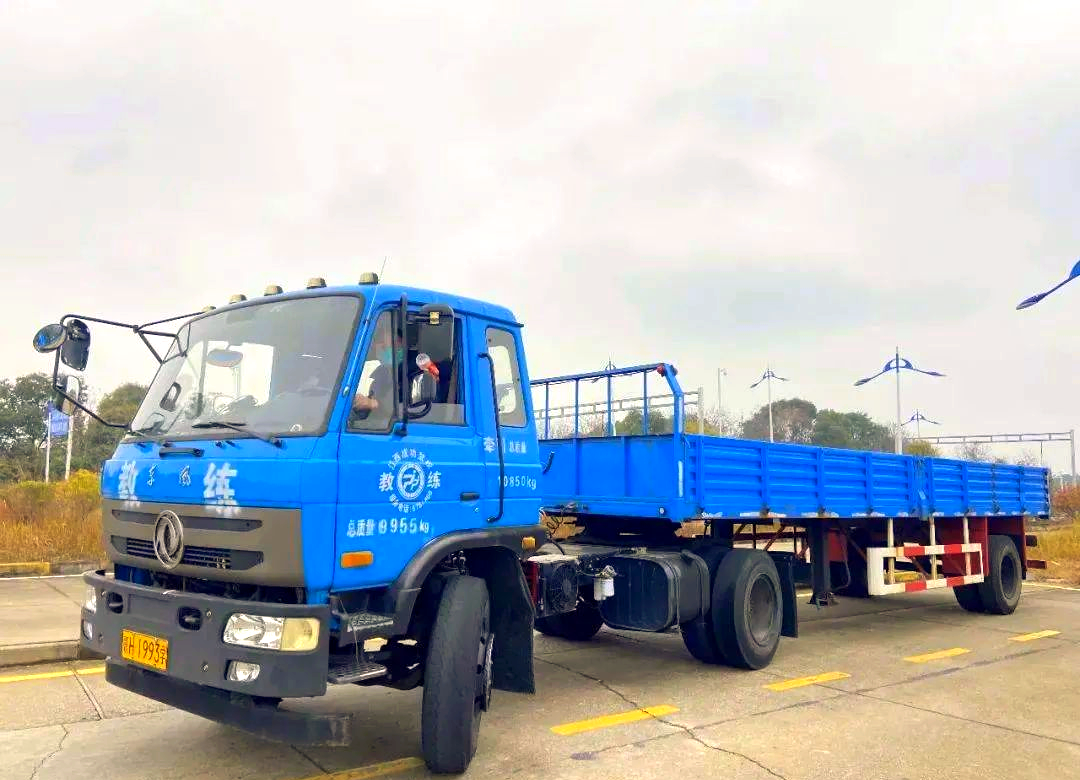
不过理论一回事,现实却是另一回事,这里有一个形象的类比:B2、A2驾照难度,比C1高得多。
C1考倒车入库、侧方停车、坡道定点、直角转弯、曲线行驶等等,这些科目需要司机的观察、计算、预判等基础能力,而且这些能力在驾驶货车也必然要用到。
但开过大车的人都知道,B2和C1的考试项目不是一个量级,卡车驾考还要面对大车盲区、更长制动距离、更大转弯半径、挂车摆动,以及满载和空载完全不同的操控手感。
总结下来就一句话,数据相似不等于物理相似,智能货运,尤其是嬴彻聚焦的自动驾驶卡车,天生自带5重壁垒,包括车辆物理、场景长尾、传感器与仿真一致性、安全验证、物流运营。
嬴彻技术体系中的几个模块,其实就是针对这5个壁垒而生。
第一关,车辆物理。
通用范式的做法,是把车辆参数隐式地藏在数据分布里。模型见过大量乘用车行驶数据,学到一个统计意义上的“通用驾驶员”。这套方法在乘用车场景里够用,因为乘用车的质量、尺寸、制动响应区间相对集中。
但直接套用在货运场景,会出现“失效”:比如49吨满载重卡和1.5吨乘用车,同样跑80km/h,制动距离、横向响应、转弯半径、侧倾阈值完全不在一个区间。通用模型没有显式编码载荷、挂车姿态、制动衰减,遇到满载下坡、窄路会车、超越大车,它输出的轨迹在统计上“像老司机”,但在物理上可能根本不可执行。
嬴彻在Freight-Native End-to-End(E2E)里做Vehicle-aware,把车辆类型、整车质量、载荷状态、尺寸、制动能力、动力系统状态、挂车姿态编码成统一的Vehicle Representation,进入Transformer与Environment、Mission做交互。
编码是这些物理条件进入模型的前提;要让它们影响决策,还需要训练中的约束构造和对应场景的数据。到了决策层面,窄路会车时模型知道自己的车宽和挂车摆动幅度;满载下坡时知道制动衰减的余量;超越大车时知道横向加速度和侧倾风险的边界。
这是车辆物理这一关的分野:物理参数进入模型的方式,决定了策略能不能落地。
接下来要问的是:车所处的世界,究竟有多复杂,也就是ROSL(真实运营场景库,Real-world Operation Scenario Library) + Data OS / Data Factory,核心机制分三层。
通用范式的逻辑,是让模型在道路驾驶数据的自然分布里慢慢磨。乘用车数据量大、城市道路覆盖广,路口、行人、非机动车见得多,稀疏场景靠规模逐步覆盖。
货运的场景分布和乘用车差异太大。干线有夜间、团雾、积水、山区、暗冰(山区冬季)、逆光、施工、大车、异形车(大件运输、超宽超长等)频繁交互;园区有低速近距离会车、路权博弈、行人叉车、窄空间掉头。极限Cut-in、道路坠落物、动物闯入这些高风险场景,在通用数据里分布稀疏,靠自然覆盖效率很低。
嬴彻的做法是ROSL加Data OS,用随机采样把“无偏”两个字做实。运营中按一定概率随机触发20秒片段录制回传,数据等比例反映真实场景分布,避免按工程师偏好定向挑选。
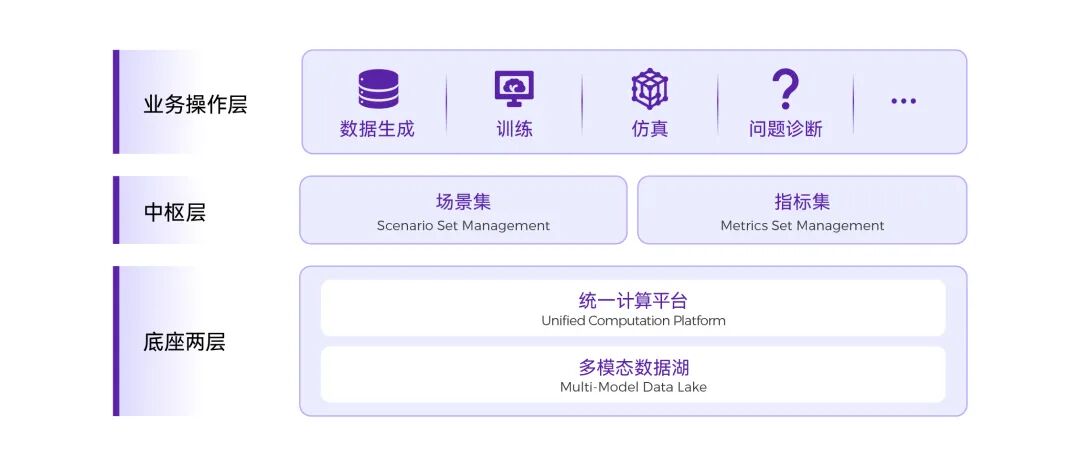
Data OS每天处理万级新增片段,用视觉语言模型给每个片段打上障碍物、车道线、天气、施工等标签,相当于发一张“场景身份证”。ROSL沉淀下来之后,可以做场景概率估计、盲区识别、高保真评测集构建,也能反向优化标签树。
目前ROSL已积累数十万级以上独特高价值场景。
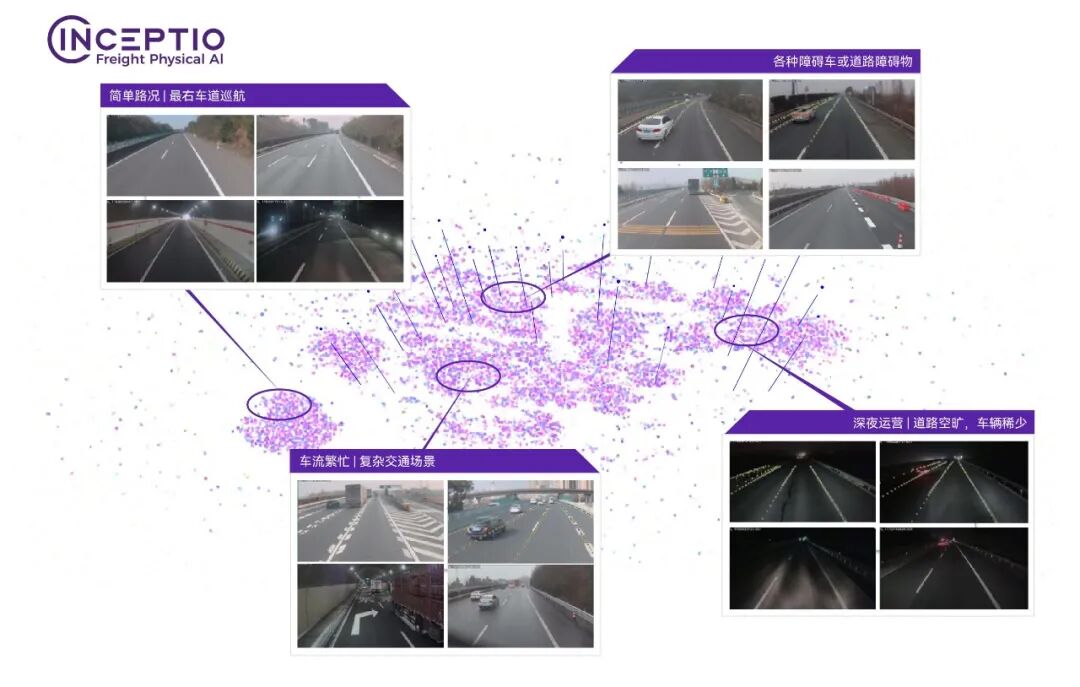
△ 基于随机场景集数据的场景分布可视化:
图中每一个点代表一个场景Moment,可看到场景分布存在明显的热点区域
接下来是第三层壁垒——传感器与仿真一致性。
先讲一个不需要技术背景也能理解的对比:假设要测两个算法版本在同一个Cut-in场景里的表现差异。通用视频生成世界模型的做法,是重新生成一段Cut-in视频,背景纹理、车辆外观、阴影可能都变了。
两次仿真跑完算法表现不一样,你很难判断差异来自算法本身,还是来自生成环境的随机扰动。可控仿真解决的问题,正是让工程师能够隔离变量、复现特定边界场景。
智能货运对激光雷达的刚需让这件事更复杂。
摄像头看的是纹理和光照,激光雷达看的是激光打到物体上的回波,两者的物理形成机制不同,一个统一生成模型很难保证几何对齐。
嬴彻的做法,是用Freight World Model把仿真拆成Asset、Agent、Rendering三个部分,在统一3D世界表示上分别处理。
Asset:用4DGS从真实数据里提取可编辑的3D资产和长尾目标,一个只出现过一次的山体碎石可以拆出来,放到雨天山路、夜间高速反复使用。
Agent:建模其他驾驶员对大车的“交互逻辑”——用非对称注意力把这个空间风险结构学进去。
Rendering:摄像头用3DGS保证几何稳定,再用生成模型微调光照和材质;激光雷达先建扫描模型,再预测哪些位置会因为材质、距离、入射角产生回波缺失,让生成的点云既几何正确,又符合真实传感器的统计特征。
货运物理AI和乘用车智驾在仿真层的分野,本质是可控性优先于生成多样性,传感器一致性优先于视觉真实感。
再往下,就要问:在这个世界里AI司机开出来的行为,究竟如何定性定量验证安全性。
货运对安全的定义复杂得多,包括验证载荷稳定性,满载和空载的侧倾阈值不同;制动衰减,长下坡连续制动后制动力下降;挂车折叠与侧翻,铰接式车辆特有的动力学风险;货物属性,液罐的液体晃动、冷链的温控约束。
这些维度,在乘用车的验证体系里没有直接对应物。
自动驾驶所有细分赛道都重视安全,但货运物理AI需要对安全验证体系进行重写,并且贯穿训练、设计、验证三个环节,成为模型全生命周期的内生能力。
而嬴彻把这套验证拆进三个环节。
Training Safety在训练目标里纳入碰撞风险、TTC、安全边界、车辆稳定性、制动强度和商用车动力学约束,从专家模仿扩展到难样本、扰动和自恢复学习。
Design Safety保留独立安全模块,端到端模型给出轨迹后,仍从碰撞、道路边界、车辆动力学角度做独立检查,必要时可以限制或覆盖输出。
Validation Safety让模型连续面对自身决策产生的新状态,通过传感器级闭环仿真和真实车队回流做回归验证。
最后还要回答一个更实际的问题:这趟货,能不能跑得更有效率。
不同运单对时效、能耗、平顺性的要求不同,快递、冷链、液体对应不同策略;
车端毫秒级控制之外,云端还要做车队级风险监控、路线速度优化、远程干预和调度协同。
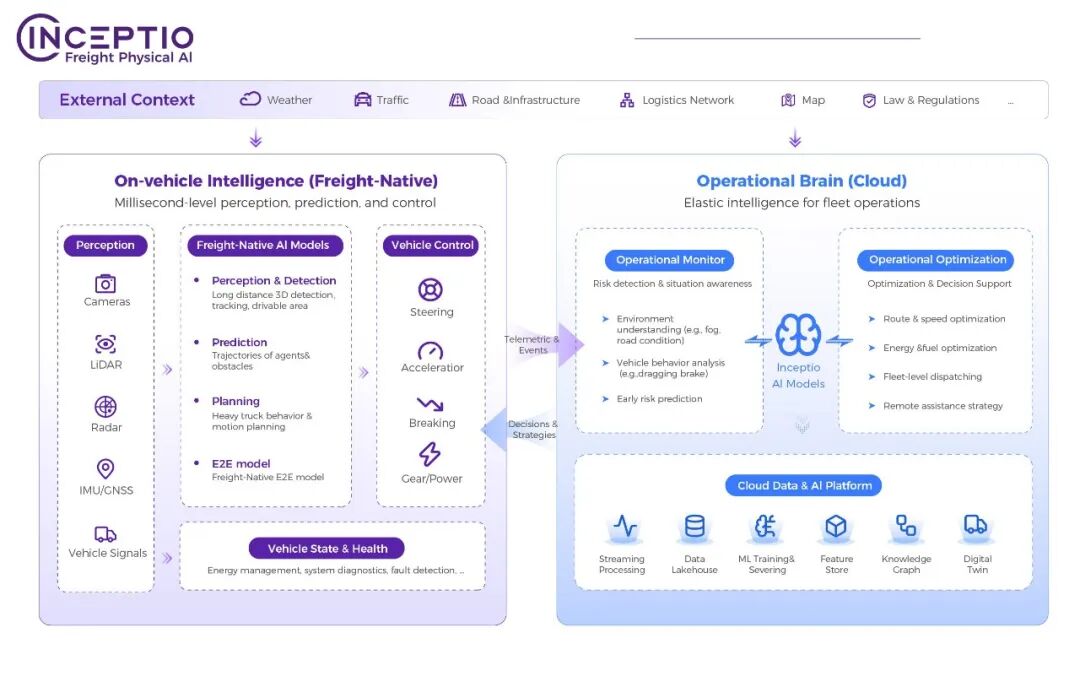
△ 嬴彻端云技术架构:车端负责实时控制、云端运营监控与优化
嬴彻在技术侧用Mission-aware加Operational Brain接住这件事。
Mission Encoder把运输任务编码进E2E,时效充裕的车辆倾向经济性驾驶,减少超车和车道切换;时效紧张的车辆面对慢车会更主动地变道。
Operational Monitor在云端识别浓雾、制动拖滞等单车不容易察觉的运营风险,Operational Optimizer做路线速度规划、能量优化和远程干预。
但运营这一关的厚度不止在技术。
CEO马喆人把公司策略概括为“技术+运营”双轮驱动,举个用户的真实数据案例:申通快递干线,目前由嬴彻智驾系统承运的里程累计超过1.5亿公里,系统里程占比超90%。
过程中,嬴彻深度嵌入客户的运营流程,理解运单结构,跟调度系统对话,运营结果再回流成新的数据和问题,不断优化迭代。
而运营优化最朴素、也最务实的一个落点,是能耗。
节能是货运原生智能与生俱来的本质,也是货运智能驾驶最朴素的诉求。在真实货运场景中,货(货重、载荷分布)、车(风阻、滚阻、车速)、路(交通流)、环境因素(风、雨、雪)、人(干预)等耦合因素共同决定了能耗水平。
嬴彻在数亿公里的货运里程中,系统性梳理每个因素的影响并作量化显示,让客户每一趟货运都能把节能这笔账清晰的算出来,算得明白。
这笔帐的结果是可见的:百公里能耗节省3%到7%。而比数字更重要的是合作模式的变化,从“双驾变单驾”延伸到“智驾接龙”长途单驾再到全里程段智驾标配——
智能货运的“交付”非但不是终点,反而是商业模型的最底层的支柱、起点,玩家本身成为技术加运营的复合生态位角色。
这其中包括大量的“苦活累活”,但话说回来,苦和累本来就是货运行业的底色。
也只有在复杂细致的模型迭代、运营管理优化过程中,智能货运玩家才有可能把数据闭环从狭义的算法层面拓展到全流程,更极致的实现货运用户的降本诉求。
而这样“后交付”一侧的利润窗口和持续性营收,价值可能比单独卖一套系统高得多。
五关走完,再回头看“通用基座摊薄成本”这个论点,逻辑就更清楚了。
通用基座能摊薄的是通用层成本,货运特有层的成本不会因底层复用而消失。即便是端到端、数据驱动大模型的玩家,算法层面仍有千万甚至亿公里级的原始积累要补。
所以,乘用车“跨界”值得讨论的首先不是效率问题,而是“效率”能释放的前提——
货运特有层的能力,有没有补齐?
L2+原始积累,跨越L4“复利”
蜂拥而至的玩家,紧盯的都是货运赛道规模化的“复利”:
仅中国,每年的货运市场规模就有8.5万亿元人民币(长途货运约4.7万亿元),而其中人工成本至少占25%(交通运输部公路科学研究院2025年数据)。
哪怕只实现1%的L4无人化,都是巨额利润窗口,况且这条赛道本身也面临用工不足的趋势。
但复利的起点,是拥有足够的L2+原始积累。
嬴彻通过自身的实践,给出了一组可供参考的原始积累模式,以及定量数据。
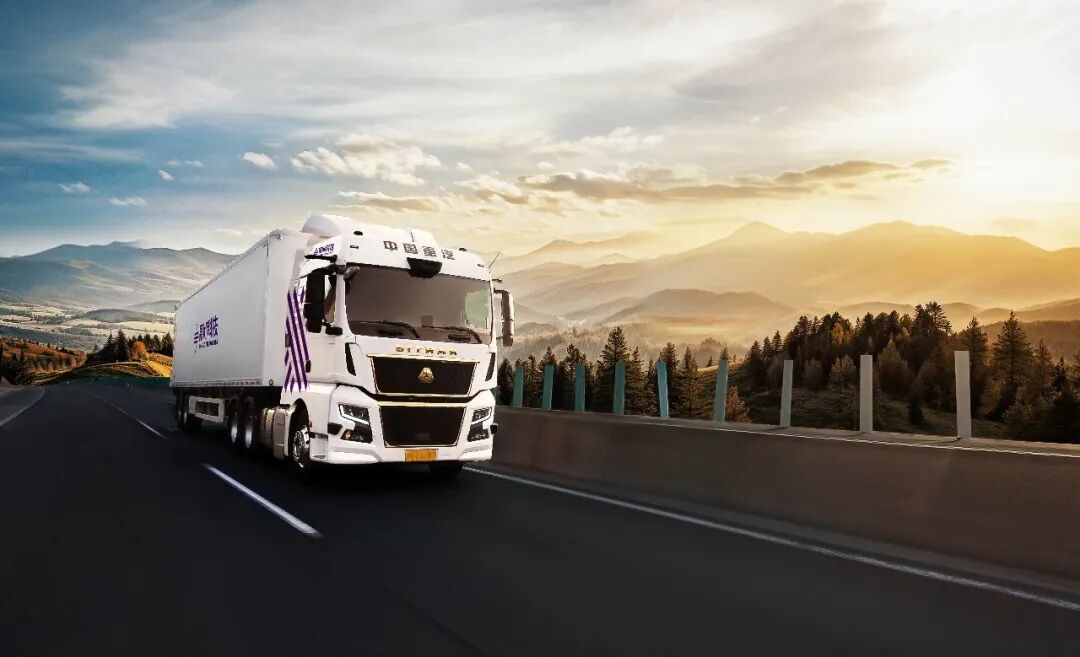
数千台前装量产智能重卡在路上跑,每天产生真实运营数据,这是数据入口。
ROSL则把入口进来的数据做随机采样、语义解析、场景标签、场景身份证,沉淀成可搜索、可量化、可评测的场景资产。
E2E和World Model拿着这些场景资产做训练和闭环验证,模型在虚拟世界里反复迭代。
Operational Brain再把运营结果回流成新的数据和问题。
能力串起来,形成一条从车端到云端、从数据到场景再到模型和运营的回流链路。
这条链路,就是L4复利的起点。
至于复利怎么产生?拆开看,是四个机制在起作用。
首先是场景复用,比如夜间高速上一次极限Cut-in,可以扩展成不同侵入角度、不同TTC、不同车型、不同路面湿滑程度、不同光照条件的场景族。
真实世界提供一次锚点,World Model把它扩展成几十上百个可训练、可验证的变体。
其次是评测复用。ROSL里的高保真评测集,可以反复用于模型回归,每次版本迭代都跑同一套基准,省掉重复采集和重复标注的成本。
然后是仿真复用,也就是把World Model里的Asset和场景重组,一次构建、多次使用,新增场景的生成成本随之下降。
最后则是运营复用:Operational Brain在车队层面积累的风险模式、能耗模式、调度经验,可以反哺场景库和模型。比如制动器拖滞的早期迹象,从运营数据里识别出来,变成场景标签,再进入训练和评测。
场景越用越厚,评测越用越准,仿真越用越便宜,运营越用越有数据。边际成本递减,边际效率提升。
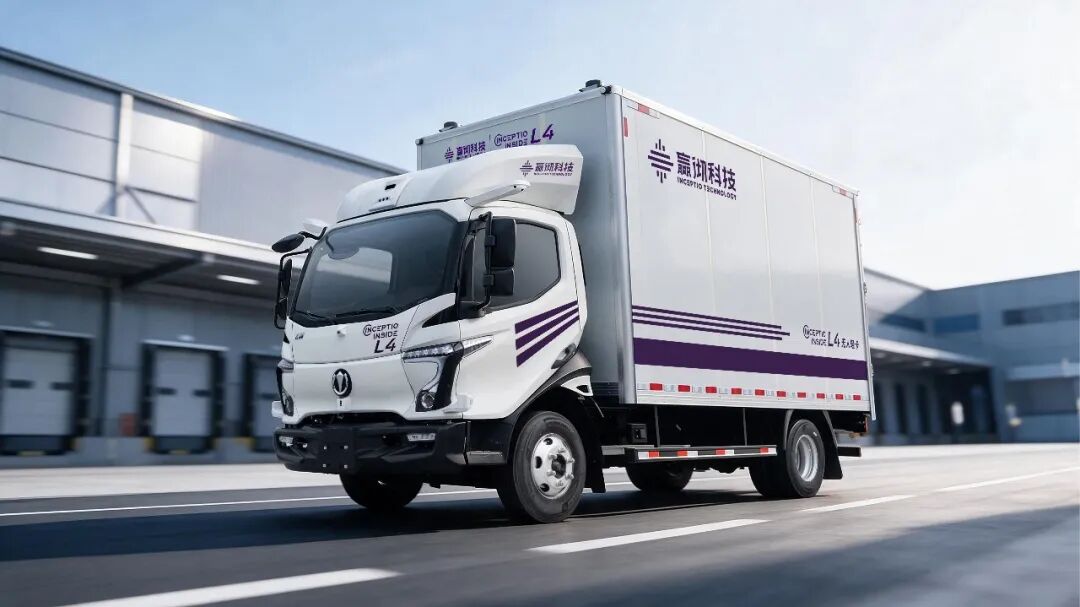
由此,在即将落地的L4,嬴彻也能够提前聚焦至少3个层面的业务:前装量产、L4示范运营、技术出海。
其中前装量产线对应规模,L4示范对应验证,技术出海提供地理与运营场景的复制空间。
嬴彻的德国代表处、比利时安特卫普-布鲁日港试点项目、卢森堡合作备忘录,都是把国内跑通的场景资产、技术体系和运营经验,复制到海外地理和运营环境里。
复利四机制回答“怎么启动”,三条L4业务线回答“在哪变现”,两者咬合,复利才转得起来。
嬴彻科技,实际上正在进入数据资产约束下的商业落地增速期,边际成本递减,边际效率提升,且这种复利具有约束条件,包括安全验证、法规准入、主机厂合作、传感器成本、L4无人化节奏等等。
但约束条件越清晰,复利释放就越有序、可预期。
数据闭环是入场券,技术体系闭环是护城河。
而商业闭环——真实货物、真实线路、真实运营规模——才是复利真正开始计息的地方。这三层,行业里能同时跑通的玩家并不多。
货运物理AI的“定义权”,最终不由谁先说出这个词决定,而由谁的技术体系被行业检验、被规模化运营验证、被全球市场复制来决定。
12亿公里,是这场定义之战的第一个里程碑,不是终点
Source:嬴彻科技技术blog:https://www.inceptio.ai/blog
一键三连「点赞」「转发」「小心心」
欢迎在评论区留下你的想法!
— 完 —
🌟 点亮星标 🌟