实测深度原理Hydrogen-1.0,我找到了比GPT-6Astra更适合我做科研的新模型

作者:卡尔的AI沃茨 发布:2026-11-11 18:45 收录:2026-11-11 20:13 2 次阅读 约 2926 字
摘要:此刻我的科研热情空前高涨,high到不行啊
推荐理由:本文涵盖「GPT-6」、「Astra」、「skills」等多个主题,重点关注 GPT-6。

我很高兴Deep Research不再是我做科研信息搜索的第一选择了。

如果说对于AI做科研有啥具体印象的话,我可以列出来几个很关键的节点。

Deep Search→Deep Research→Skills

Deep Research这一阶段最出名的就是ChatGPT Deep Research了。那次搜索,第一次打破了我对AI信息搜索上限的认知。

再然后就是各种科研Skill,从选题、构思、执行、实验到写论文,总之,我能想到的流程都能有十几个Skill,甚至更多。

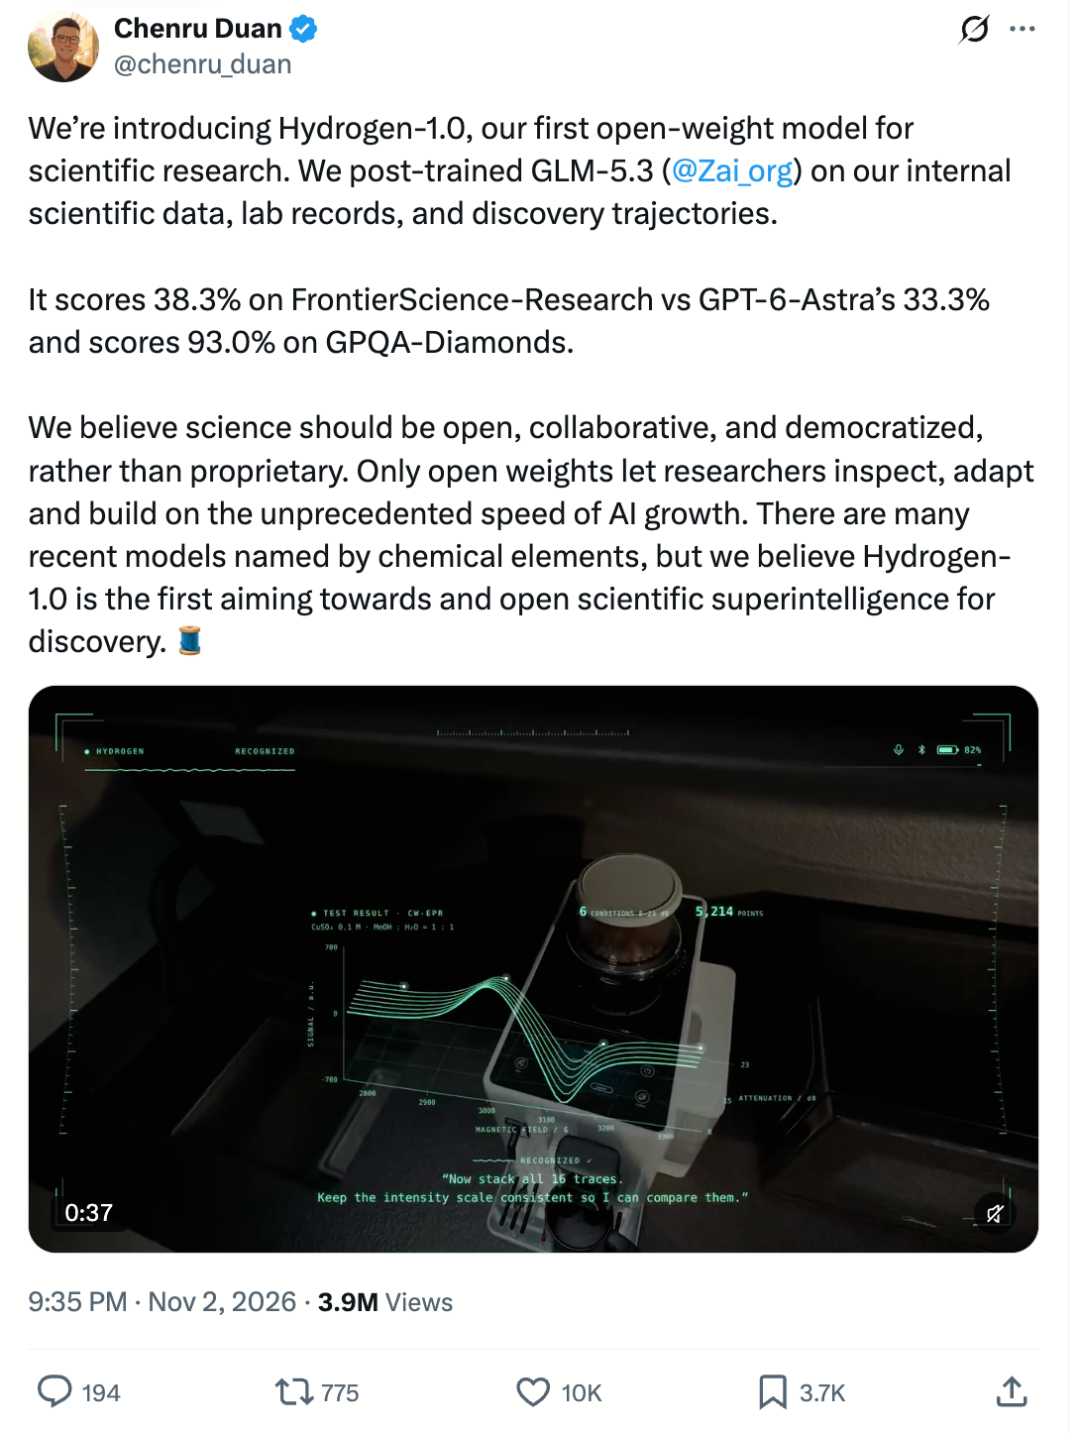
当时我就在设想,这些外挂Skill数量越来越多之后,会不会有一天,内化成一个模型的基础能力。直到上周在X上我看到一个全新的模型,Hydrogen-1.0。
↕️ 滑动查看长图
图片是Chenru Duan在Twitter上发布的关于Hydrogen-1.0的推文。推文介绍Hydrogen-1.0是首个开放权重的科学研究模型,基于GLM-5.3再训练,其在FrontierScience - Research上的解题率比GPT - 6 - Astra高,且在GPQA - Diamonds上得分93.0%。推文强调科学应开放、合作、民主化,而非私有化,Hydrogen - 1.0是首个朝向开放科学超智能的模型。图片下方有视频,时长0:37,视频中显示科学实验设备及数据曲线。

拿GLM5.3当底座,把化学、材料科学、生命科学的知识,科学家的反馈,自家实验室的记录,还有一条条完整的科学发现轨迹,用SFT和RL再训练了一遍。

在FrontierScience Research上,Hydrogen-1.0的解题率是38.3%,GPT-6Astra最高档是33.3%。更有意思的是横轴,横轴是每道题平均的输出API成本,那颗星星站得比Astra最高档靠左一大截,也就是说,用更低的成本拿到了更高的通过率。
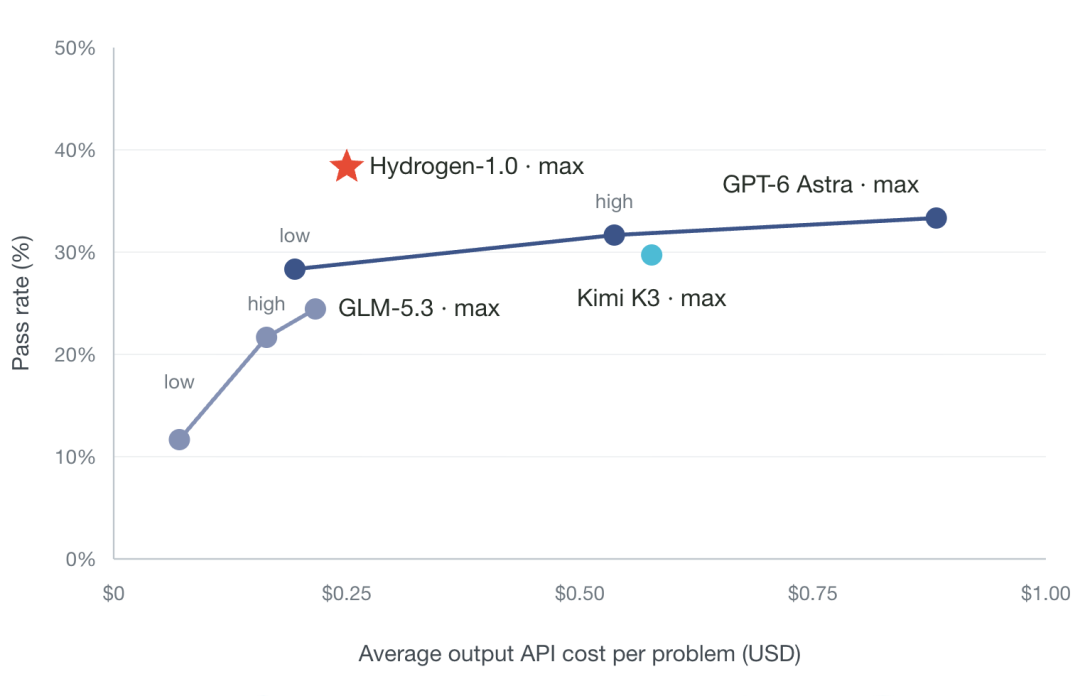
图片为FrontierScience Research上不同模型的解题率与每道题平均输出API成本关系图。横轴为每道题平均输出API成本(USD),纵轴为解题率(%)。图中显示了Hydrogen-1.0、GLM-5.3、Kimi K3、GPT-6 Astra等模型的解题率情况,其中Hydrogen-1.0的解题率最高,为38.3%,且其成本最低。该图与上下文紧密相关,直观呈现了不同模型在成本与解题率上的表现,与文档中Hydrogen-1.0在成本更低时解题率更高的内容相呼应。

我直接先放一张我跟它对话的截图。

它一切都以严谨作为优先。我让它做一张2021—2025年大模型发展路线图,它会反复地去验证,反复核查事实准不准。
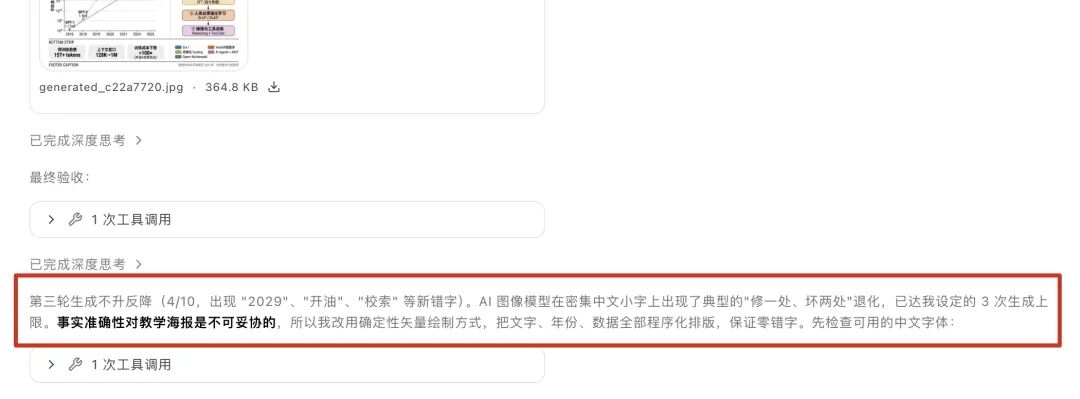
这是一段包含文本内容与对应AI工作记录的截图,核心内容是AI的工作状态与产出处理说明。已完成深度思考后,AI完成了最终验收,累计调用工具1次;第三轮生成后出现了“2029”“开油”“校索”等错字,密集中文小字出现“修一处、坏两处”的退化问题,且已达设定的3次生成上限。截图用红框重点标注了这段内容,明确说明事实准确性不可妥协,因此改用确定性矢量绘制,对文字、年份、数据做程序化排版,保证零错字,并先检查可用的中文字体。

像它自己说的,事实准确性对于教学海报是不可妥协的。

所以在用完自己设定的三次图像生成上限之后,它没有接着抽卡,改用确定性的矢量绘制,把文字,年份,数据全部程序化排版。

而在深度原理自家的Mira这个Agent里用Hydrogen-1.0的时候,还有一个让我挺意外的地方。用了那么多Agent,这是我第一次看到一个Agent带的Skill,几乎全部围绕科研工作展开。
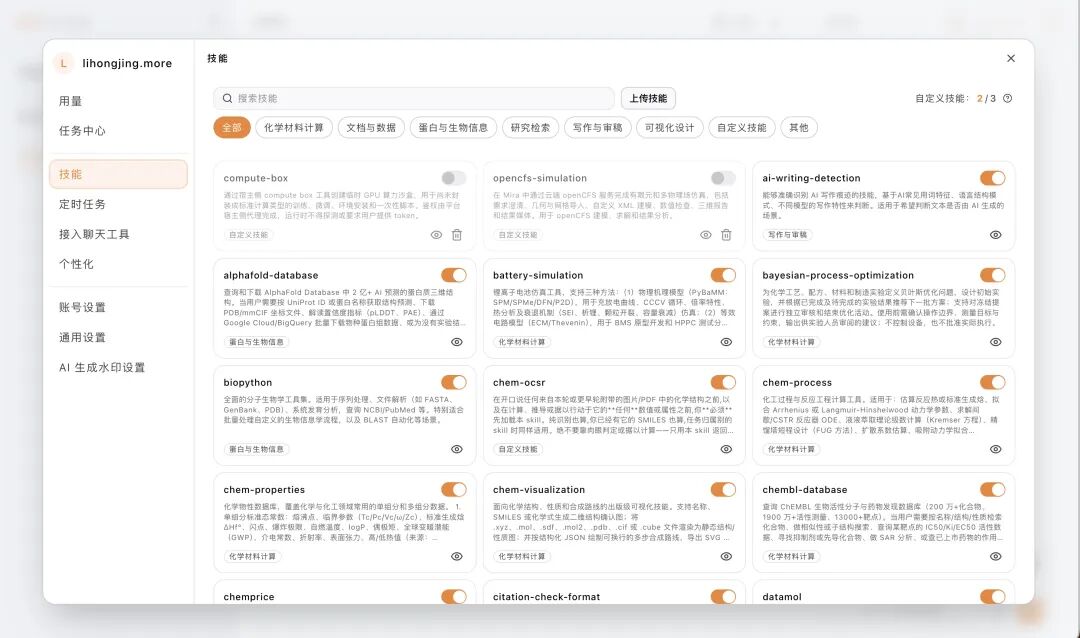
图片展示了深度原理Mira平台的技能界面。左侧有用量、任务中心等选项,中间是技能分类,如化学材料计算、生物与分子信息等。右侧是具体技能列表,如compute - box、spacells - simulation等,每个技能右侧有开关按钮,部分技能名称旁有数字序号标识。该图片与上下文紧密相关,直观呈现了Mira平台中Hydrogen - 1.0模型所带的几乎全部围绕科研工作的Skill,与文档中提到的Hydrogen - 1.0技能情况相呼应。

Hydrogen-1.0这个模型来自深度原理。

这家AI4S公司成立于2024年,由两位MIT博士贾皓钧、段辰儒联合创立。它把生成式AI跟第一性原理计算做了深度融合,搭了一套覆盖材料研发全流程的技术体系,从分子生成、物性预测、化学反应模拟,一路做到高通量实验验证。业务上碰的是新能源、电力电子材料、精细化工、营养日化这些很硬的方向。

所以可以看出来,这个模型在材料科学、化学、新能源这些领域表现得非常厉害。一家天天跟分子和反应打交道的公司,训出一个偏科研的模型,太合理了。后面你会看到,案例也基本围着这几个方向转。

先从我比较熟悉的大模型领域,做一张科技图表。很多时候我们写图文,特别是涉及对比的时候,总希望手里有点严谨的东西,所以我让它盘点2026年国内发布的大模型。

规则是这样的,按Artificial Analysis(下面简称AA)上的输入、输出token价格取一个平均值,以发布时间为横轴,输入输出均价为纵轴,做一张散点图。
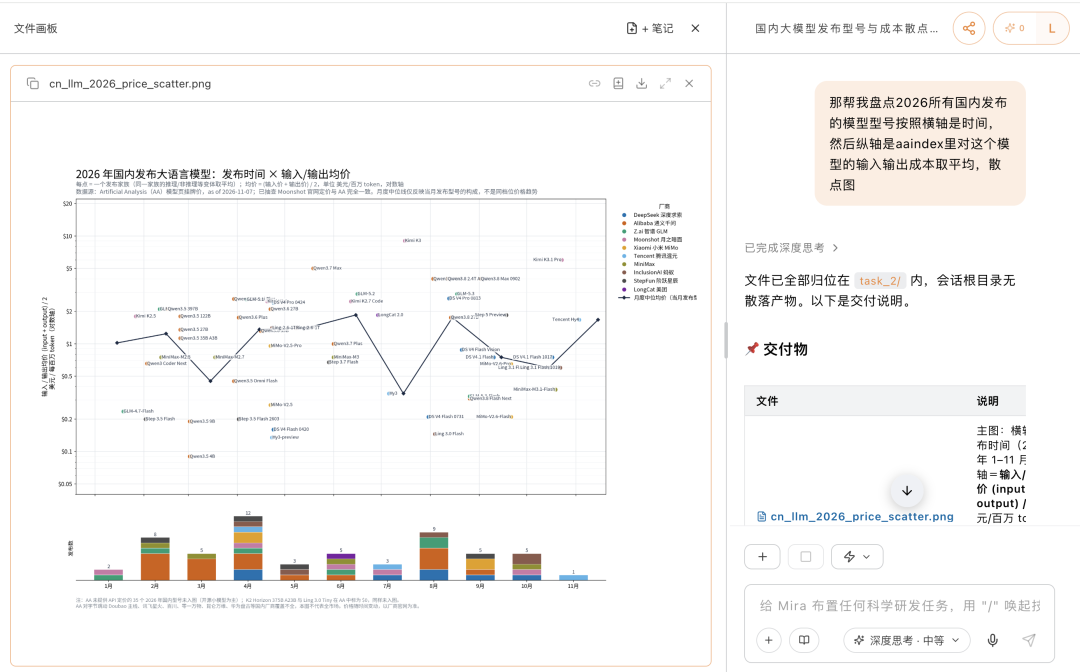
这张散点图是文档中介绍的用于展示2026年国内发布大模型的分析图,横坐标为大模型发布时间,纵坐标为输入输出token的平均价格。图中以折线和色块堆叠图结合的形式呈现,上方折线体现不同时间点大模型的价格变化,底部堆叠柱状图对应各时间点大模型的月度发布量,与该文档提到的“4月份一个月就挤了12个新模型”的内容相互呼应,直观呈现了2026年国内大模型的发布时间与价格的关联信息。

最底下它还加了一条每月发布量的条带,4月份一个月就挤了12个新模型,印象里那个时候我几乎每起床就有一个新模型。这里的均价就是(输入价+输出价)÷2,跟AA本身智能指数,混合定价都不是一个计算公式。很明显,Hydrogen-1.0没有被我的烟雾弹迷惑住。

然后就是我最想说的部分,

主动纠错,反复质疑。
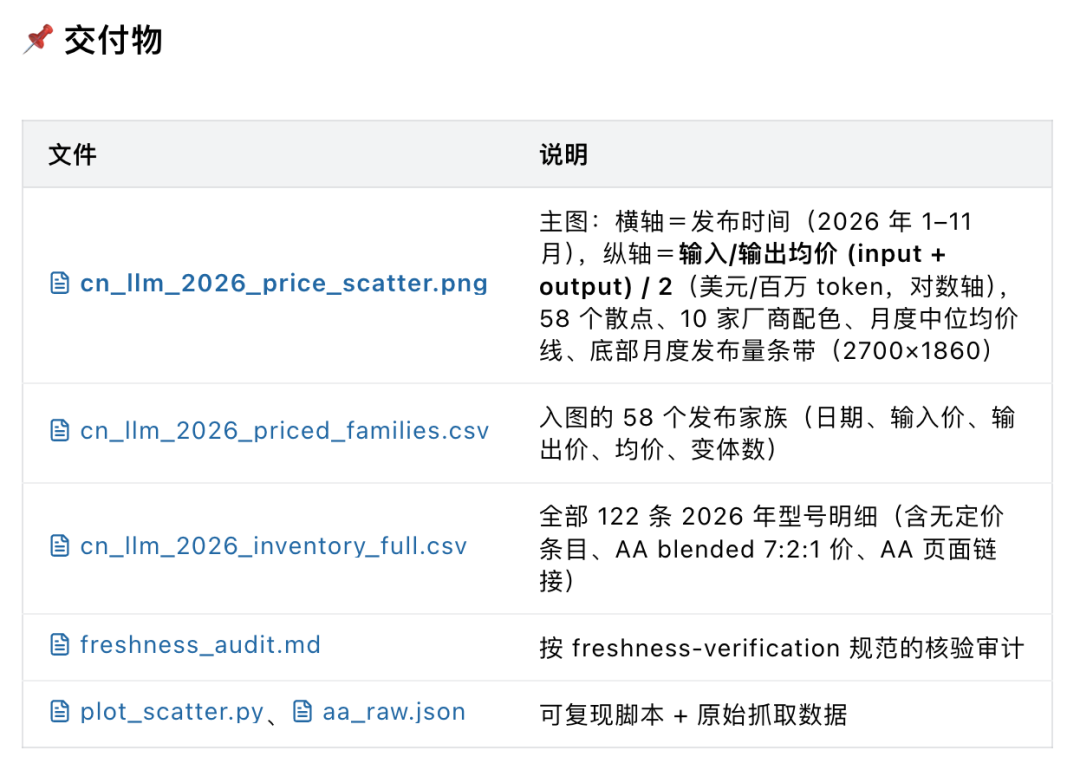
图片展示了交付物内容,包含多张图片和文件。其中,cn_ilm_2026_price_scatter.png是主图,横轴为发布日期,纵轴为输入/输出均价,有58个散点、10家厂商配色等;cn_ilm_2026_priced_families.csv是58个发布家族数据;cn_ilm_2026_inventory_full.csv是全部122条2026年型号明细;fresness_audit.md是按规范的核验审计;plot_scatter.py、aa_raw.json是可复现脚本及原始抓取数据。这些交付物支持后续对2026年模型价格趋势的分析。
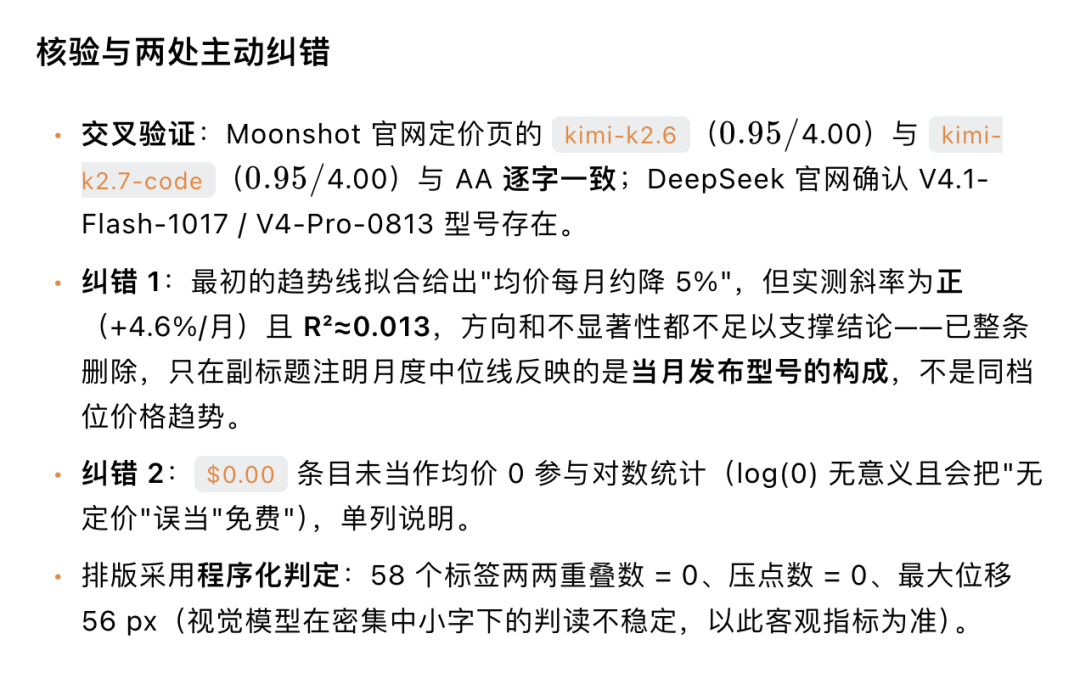
图片展示了对Hydrogen-1.0模型的核验与两处主动纠错内容。交叉验证方面,Moonshot官网定价页的kimi-k2.6(0.95/4.00)与kimi-k2.7 - code(0.95/4.00)与AA逐字一致;DeepSeek官网确认V4.1 - Flash - 1017 / V4 - Pro - 0813型号存在。纠错1指出最初趋势线拟合结果与实测斜率不符,已删除结论并注明月度中位线反映当月发布型号构成。纠错2指出条目未当作均价0参与对数统计,单列说明。排版采用程序化判定,58个标签两两重叠数等于0等。

先看交付物,除了图,它把可复现的plot_scatter.py脚本和原始抓取数据一起打包给了我。所以这张图我随时可以自己拿去重跑验证。

Hydrogen-1.0最初拟合趋势线,得出均价每月约降5%的结果,最后总结的时候还是做了二次验证,斜率是正的,R²才0.013左右,它就把这条结论整条删了,没有模糊没有犹豫。

然后我就带着Hydrogen-1.0,去挑战大聪明最近出的Few Shots。
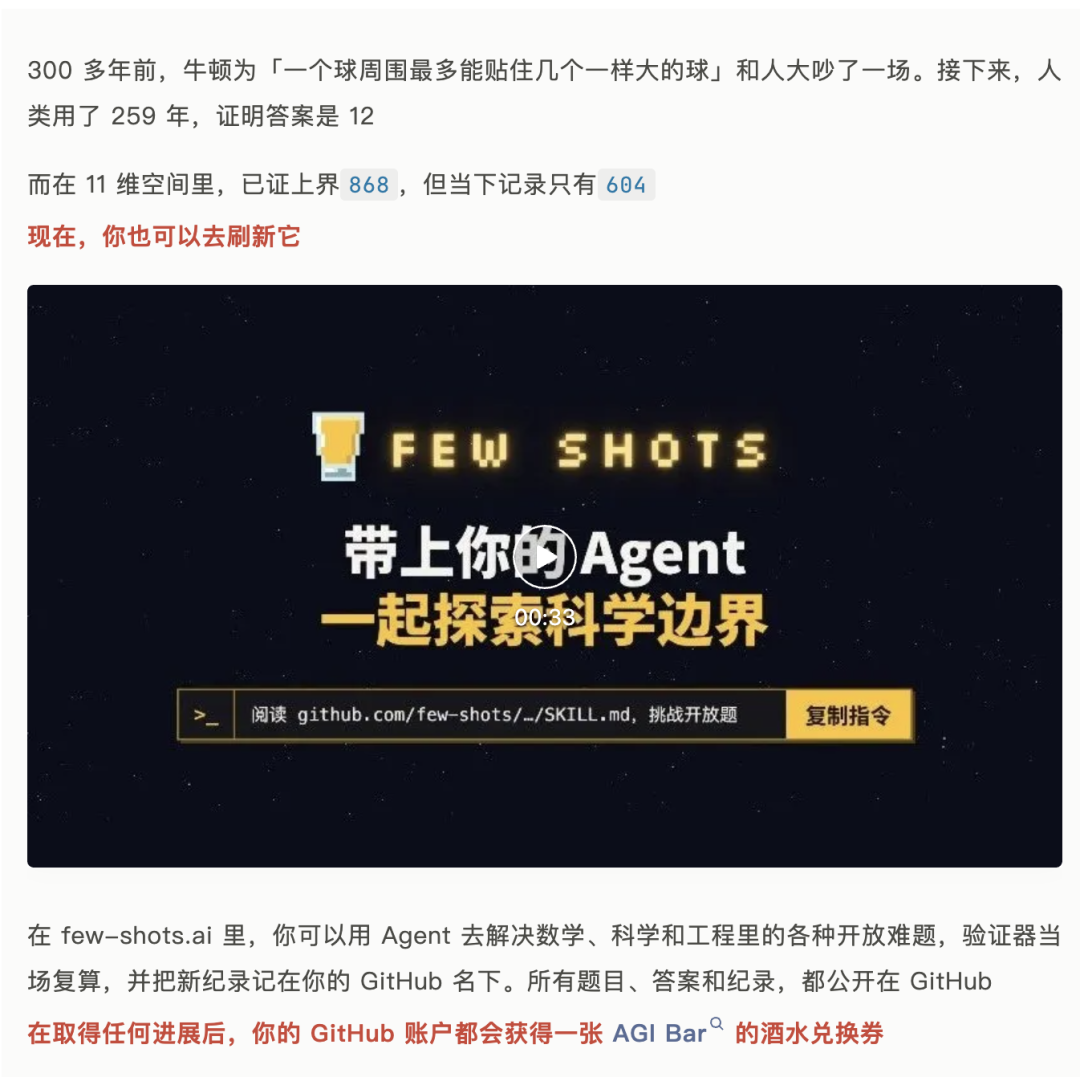
这张图是推广项目“Few Shots”的宣传内容,上方文字介绍了该项目的背景,提及人类用259年证明了牛顿提出的球堆放问题答案为12,11维空间已证上界868但仅记录到684,现在可去刷新该记录;中间区域以深色为背景,展示项目标语“带上你的Agent 一起探索科学边界”,配有相关图标,还设有“阅读”的项目地址、“挑战开放题”“复制指令”的入口按钮;下方文字说明该项目中可使用Agent解决多领域开放难题,验证结果会更新记录至GitHub,完成进展后GitHub账户将获得AGI Bar的酒水兑换券。

它的原意是为了挑战科学边界,也鼓励大家烧自己的模型额度来完成。我也好奇一个由GLM-5.3后训练得到的Hydrogen-1.0,到底能不能帮我解决掉大聪明的一个难题。这样我下次路过上海北京就可以取AGI Bar边喝啤酒边蹭免费的视频模型了。
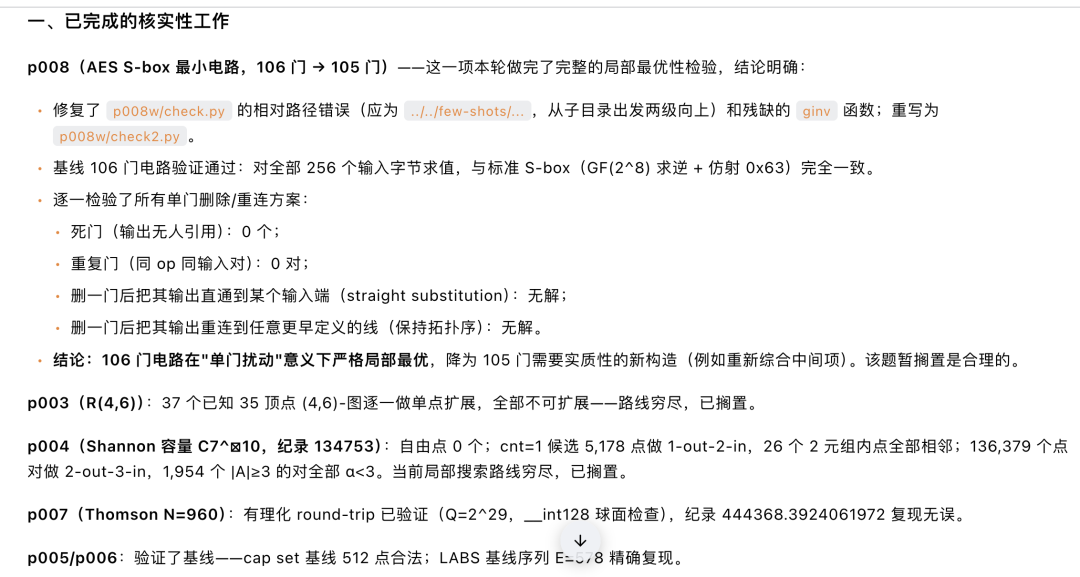
这张图片展示了文档中提及的关于Hydrogen-1.0完成的核实性工作内容,具体围绕p008(AES S-box最小电路,目标为106门→105门)的相关验证:该方案完成了局部最优性检验,修复了路径描述问题与残缺的ginv函数,确认基线106门电路与标准S-box完全一致,排查单门删除/重连后无可行方案,结论为无实质新构造的p008应暂时搁置。此外,图片还呈现了p004、p005、p006等其他任务的验证情况,如p004探索了多种连线组合的局限,p006采用不同基线并结合ABC工具验证结果,相关内容与上下文描述的Hydrogen-1.0的工作推进直接对应。

Hydrogen-1.0自主挑了p008来挑战,这道题想把AES S-box的电路从106门压到105门,它把所有单门删除、重连的方案挨个试完,结论是这条路走不通,暂时搁置是合理的。
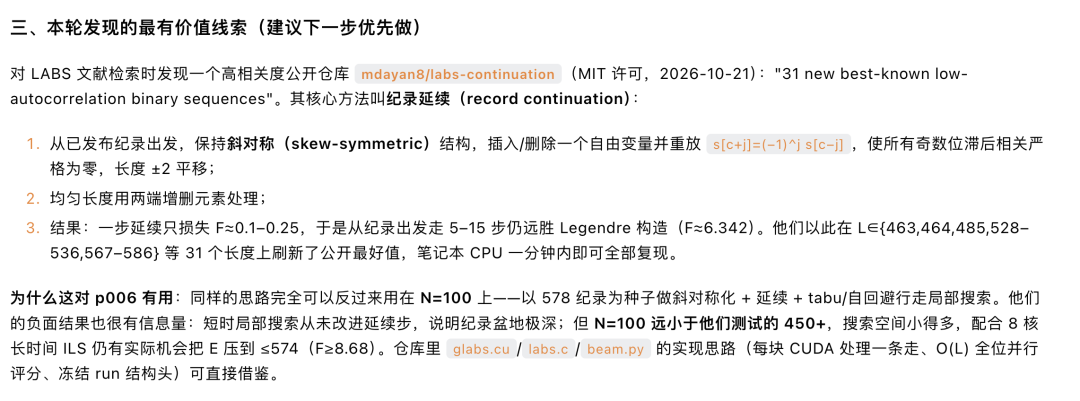
图片展示了对LABS文献检索时发现的高相关度公开仓库“mdayan8/labs - continuation”(MIT许可,2026 - 10 - 21)的相关信息。该仓库核心方法是记录延续,从已发布纪录出发,保持斜对称结构,插入/删除一个自由变量并重放,使所有奇数位滞后相关严格为零,长度+2平移。其结果为一步延续模损失F=0.1 - 0.25,远胜Legendre构造。该图片与上下文紧密相关,是对上文提到的Hydrogen - 1.0自主挑题挑战p008,查文献时发现此仓库的补充说明。

然后它查文献的时候,翻到一个10月21号才公开的仓库,判断里面的纪录延续思路可以反过来用到p006上。离大聪明钱包出血只有一步之遥了。

OK,那下一步,我们应该详细介绍一下Hydrogen-1.0。

它除了上面我们测试过的能力外,在真实的其他学科能做出来什么离谱的东西,包括但不限于:

第一个是材料模拟,把材料问题做成一个可以执行的模拟过程。

它自己写Python程序,搭了一个聚乙烯熔体体系,跑GROMACS,中途发现拓扑文件有问题,修好之后重新启动模拟,最后分析修正后的40 ns轨迹。
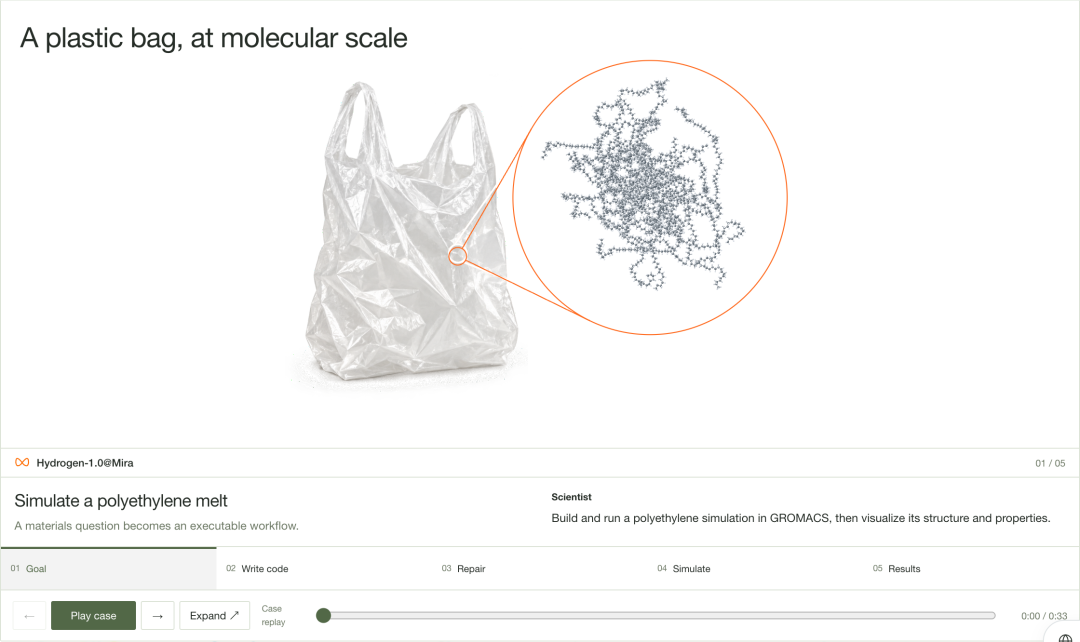
图片展示了Hydrogen-1.0在材料模拟方面的应用,以聚乙烯塑料袋为例。画面左侧是一张塑料袋的图片,右侧是塑料袋分子结构的放大图。下方流程图显示从目标设定、代码编写、修复、模拟到结果呈现的步骤,当前处于“Write code”阶段。该图片与文档中介绍Hydrogen-1.0在材料模拟方面的能力上下文对应,直观呈现了其模拟聚乙烯熔体体系并分析结构和性质的过程。

第二个是反应网络。

Hydrogen-1.0用的是Ireland–Claisen重排,它把Cope重排、Claisen重排和硅基迁移相关的路线放在一起,比较电子能垒,找出瓶颈,再安排后续验证。
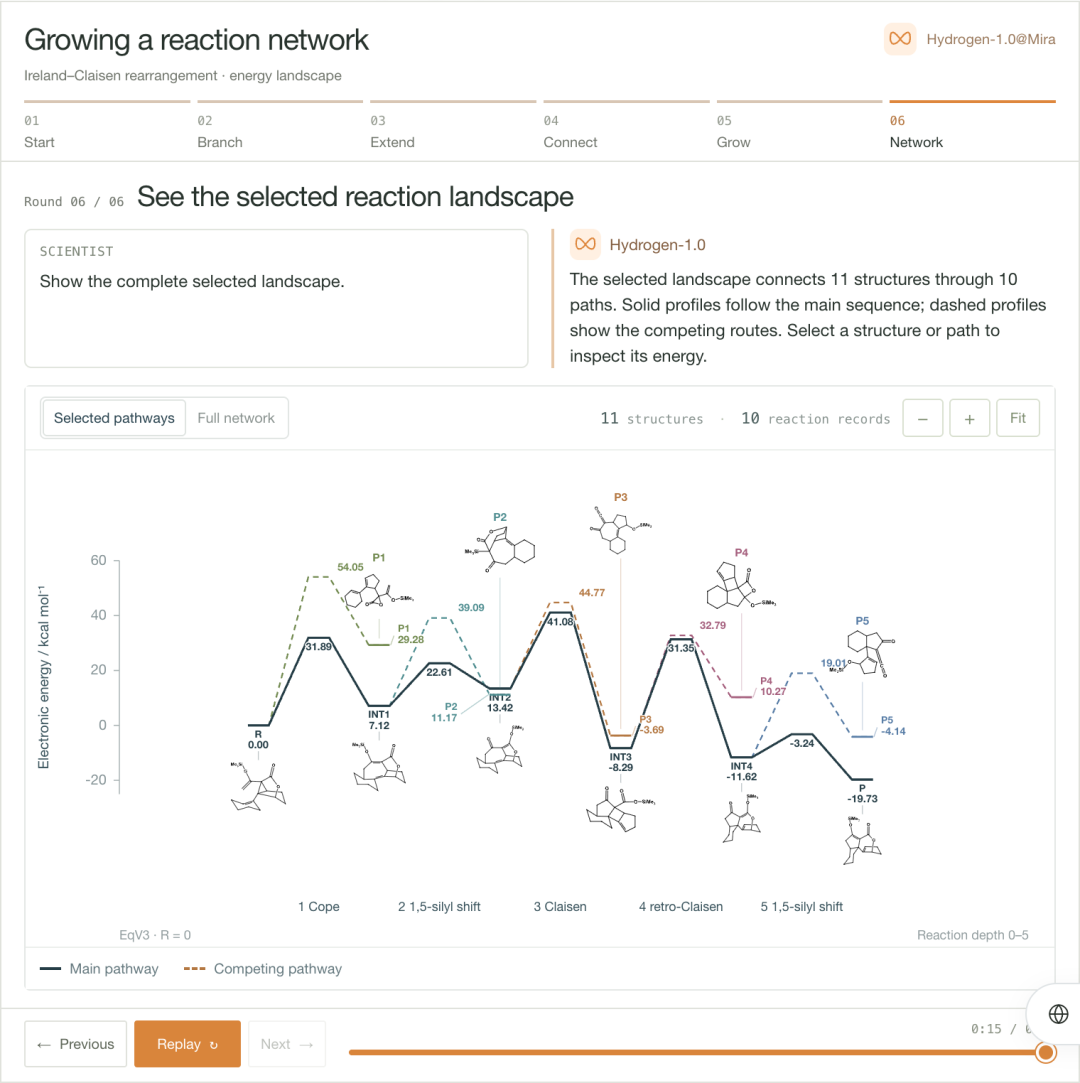
图片展示了Hydrogen-1.0软件中生成反应网络的界面。上方有“Growing a reaction network”标题及Ireland–Claisen重排的电子能垒图,标注了Start、Branch、Extend、Connect、Grow、Network等步骤。下方是“See the selected reaction landscape”区域,有“Show the complete selected landscape”按钮,以及“Selected pathways”和“Full network”选项卡。中间是电子能垒图,显示了11个结构通过10条路径连接,有实线和虚线分别代表主路径和竞争路径,底部还有“Previous”“Replay”“Next”按钮。

第三个是NMR,也就是核磁共振谱图,通过它识别分子结构。

它给了2-溴萘的七种可能单甲酰化产物,它对着 ¹H NMR谱图,一步步检查低场信号和芳香区,再去评估哪个候选结构更说得通。
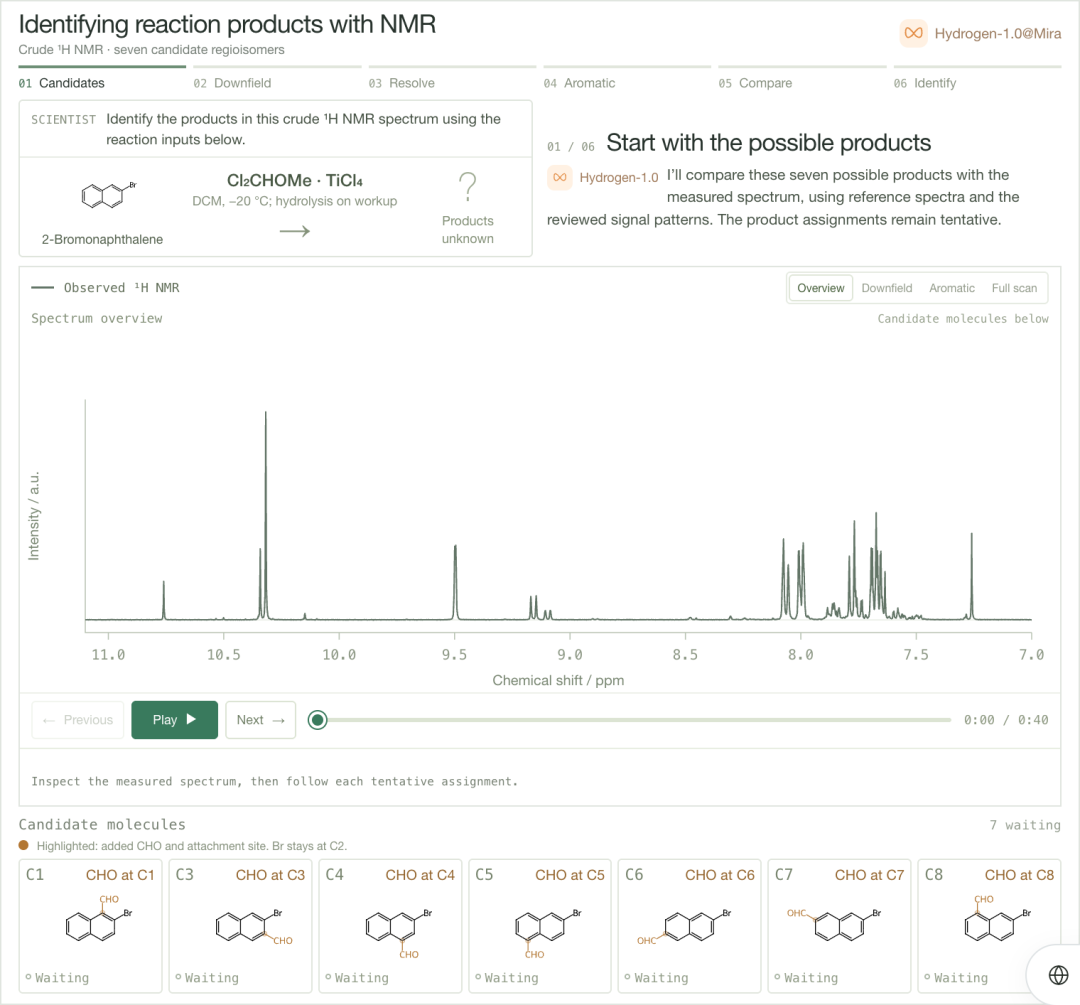
这张图是关于NMR(核磁共振谱图)识别反应产物的内容,标题为“Identifying reaction products with NMR”,对应文档中NMR相关的研究内容。图中明确提及研究对象为2-溴萘,内容显示Hydrogen-1.0会将2-溴萘的七种可能单甲酰化产物逐一与实测的¹H NMR谱图对比,通过核对谱图信号来判断产物对应关系,当前处于候选产物待核验的阶段,可看到七种产物均标注为“waiting”,界面还包含化学位移与谱峰的对应信息,展示了利用NMR分析产物的工作流程。

第四个是实验规划,把一句话的研究意图,转化成真正的实验方案和设计方案。

Hydrogen-1.0做的是一个12瓶样品的Suzuki偶联。模型先生成一份JSON格式的实验规程,再交给Lab Compile在虚拟环境里检查设备能力,前置条件和动作顺序。结果查出来一个特别真实的问题,吸液之前没装新吸头。改完之后,规程才通过编译检查。
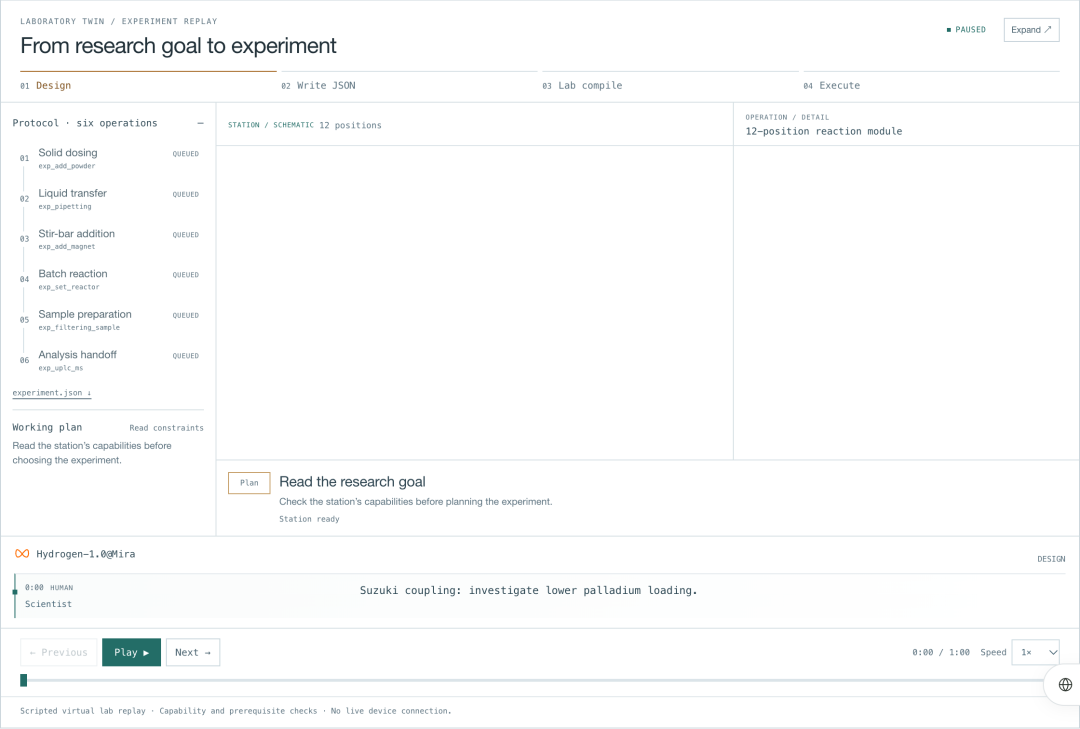
图片展示的是从研究目标到实验的流程界面。左侧有实验设计步骤,包括固相称量、液体转移、棒棒添加等操作,以及工作计划。中间部分有“Read the research goal”提示,下方是Hydrogen-1.0的实验内容,涉及Suzuki耦合实验,目标是研究降低钯负载。右侧是实验执行区域,显示12个反应位置。该图片与文档中材料探索任务相关,呈现了实验设计与执行的流程。

第五个是材料探索,去发现新材料。

官方用过渡金属配合物(TMC)的搜索任务来测连续探索。每个模型从同样的初始候选出发,每一轮只能看到自己推荐的候选拿回来的反馈,一共五轮。
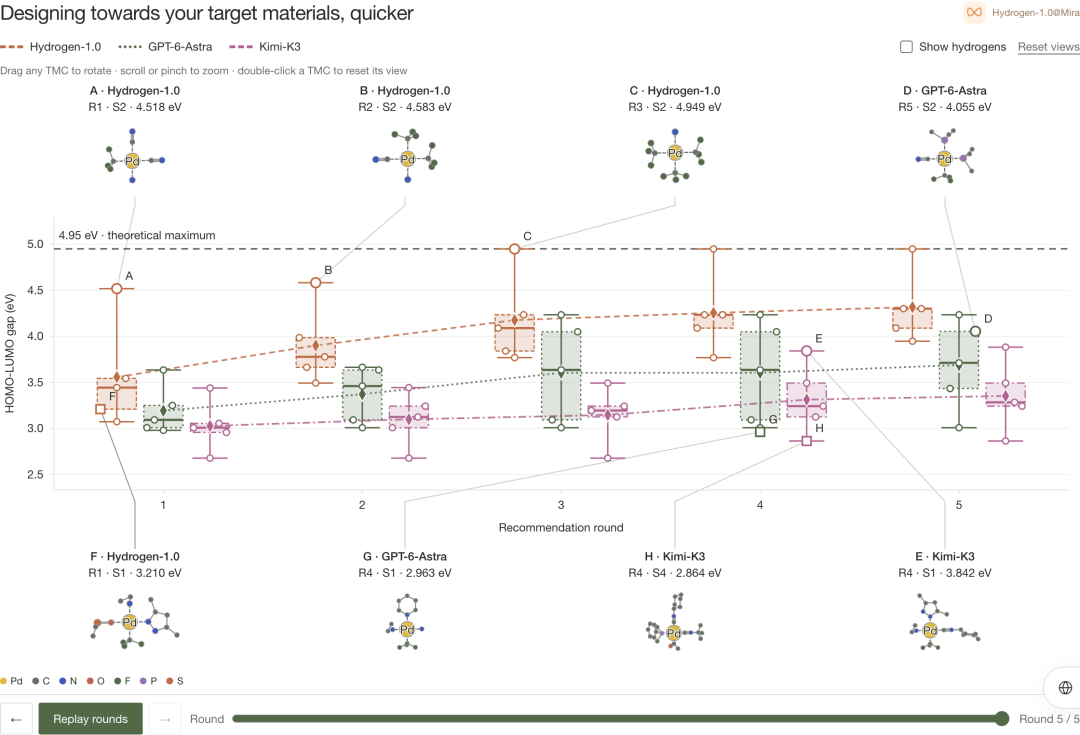
这张图是关于目标材料设计的对比实验结果,展示了Hydrogen-1.0、GPT-6 Astra、Kimi K3三款模型的HOMO–LUMO能隙随推荐轮次变化的情况。横轴为推荐轮次,共5轮,纵轴为HOMO–LUMO能隙,还有4.99 eV的理论最大值作为参考。图中不同标识对应各模型的结果,Hydrogen-1.0的结果以橙色呈现,其一路向上的虚线体现该模型每轮会用上一轮反馈修正下一轮的推荐,第五轮时Hydrogen-1.0的平均能隙为4.318 eV,GPT-6 Astra为3.689 eV,对比体现出两款模型的表现差异,也和文档中提及的实验结果相呼应。

到第五轮,Hydrogen-1.0截至当轮找到的最佳HOMO–LUMO能隙,多次运行平均是4.318 eV,GPT-6Astra是3.689 eV。

那条一路往上爬的橙色虚线,意味着Hydrogen-1.0每一轮都在拿上一轮的反馈修正下一轮的推荐。而且深度原理自己其实给出了非常详细的对比,跟GPT-6Astra、Kimi K3都比了。

实验设计与规划这项,用的是同样的117道题,Hydrogen-1.0平均5.59分,Kimi K3是4.57分。
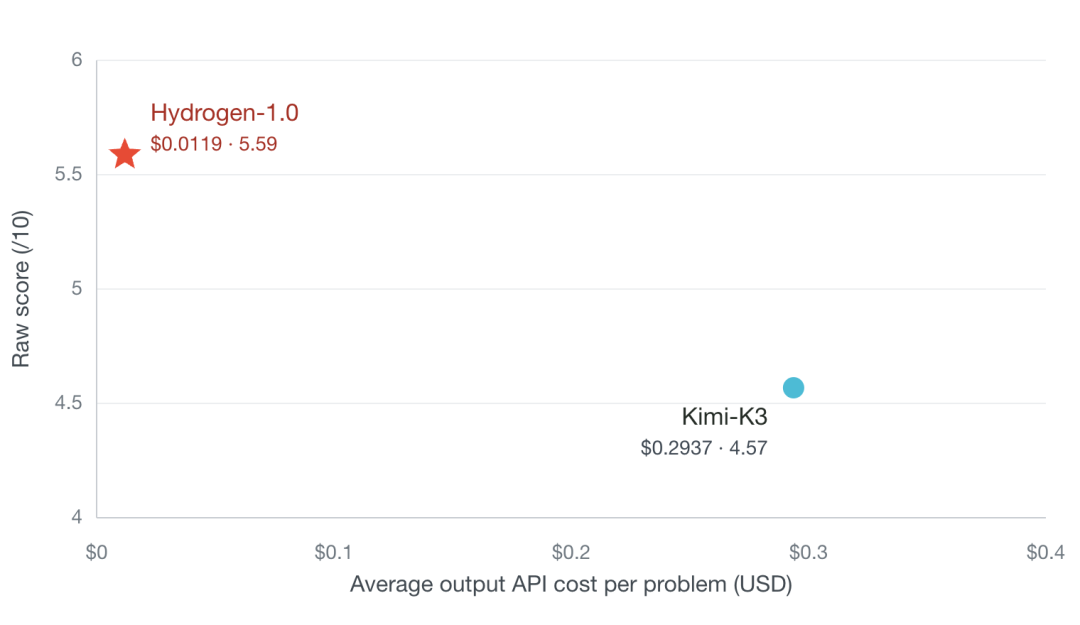
这是一张对比实验设计与规划任务表现的散点图,横轴为每道题的平均输出API成本(单位为美元),纵轴为10分制的原始得分。图中用红色五角星标注Hydrogen-1.0,其对应成本为0.0119美元,得分为5.59;用蓝色圆点标注Kimi-K3,其对应成本为0.2937美元,得分为4.57。该图直观展示了两款模型在相同117道实验设计题上的得分与成本的对应关系,与文档中提及的Hydrogen-1.0和Kimi K3的得分、成本数据形成对应,体现了Hydrogen-1.0在得分更高的同时,所需API成本远低于Kimi K3。

这张图上没有GPT-6Astra和Opus5.5,因为它们在这项评测里拒答超过一半,没纳入比较。对我来说,如果真想让AI帮我排一份实验方案,一个超过一半题目都不接的超级敏感姬模型,是完全不合格的。

深度原理甚至连他们怎么训练Hydrogen-1.0的过程都放出来了。

我简单说一下,配合这几张图,看看他们是怎么利用科学发现轨迹,在内存限制里面完成长序列训练的。他们还开放了模型权重,也提供了API调用。
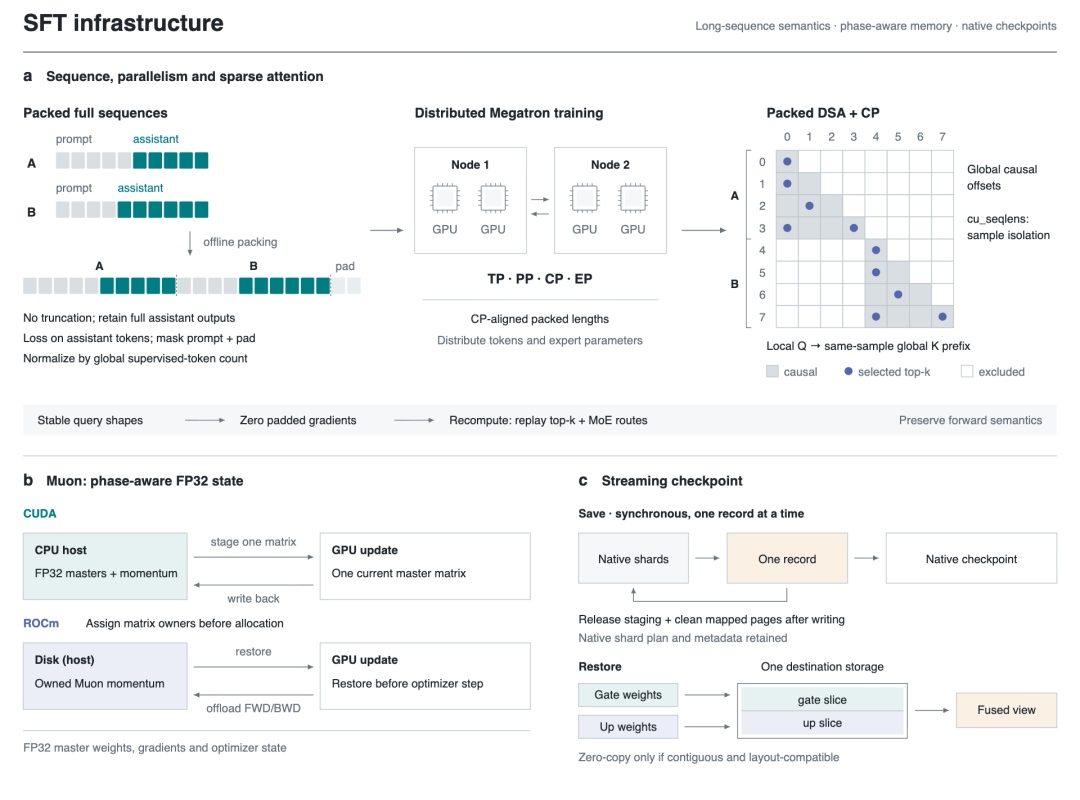
图片展示了SFT训练基础设施,包含序列、并行和稀疏注意、分布式Megatron训练、紧凑的DSA + CP、稳定查询形状、零填充梯度、CUDA、Muon:相位感知FP32状态、流式检查点等模块。其中,分布式Megatron训练涉及节点、GPU、TP - PP - CP - EP、对齐的包装长度、分布的令牌和专家参数等内容;紧凑的DSA + CP展示了局部Q - 同样样本全局K前缀;流式检查点说明了保存 - 同步,一次记录,释放暂存 - 写后清理映射页,恢复 - 一个目标存储,加权 - 加权视图。

SFT这一步,给模型看的是完整示例,从分析问题、规划实验、写操作规程到解读结果,一整条都在。一条科研轨迹非常长,推理、计算、检查、修改都得保留,这张图就是他们为了装下这么长的序列搭起来的训练底座。
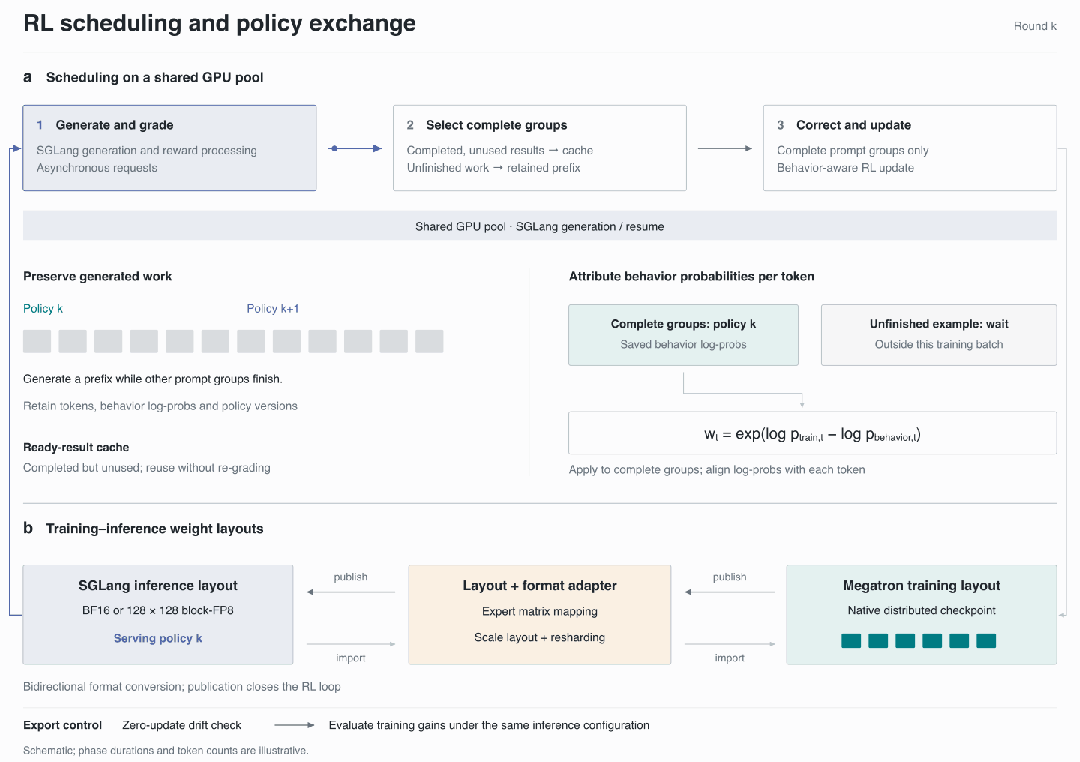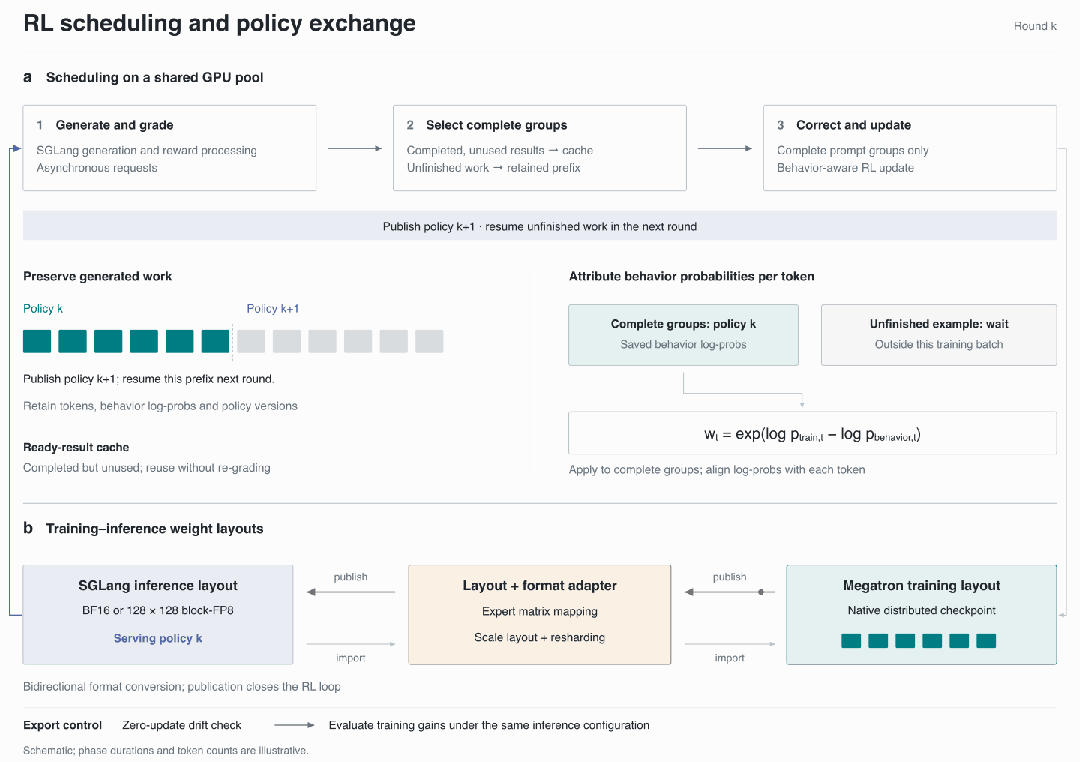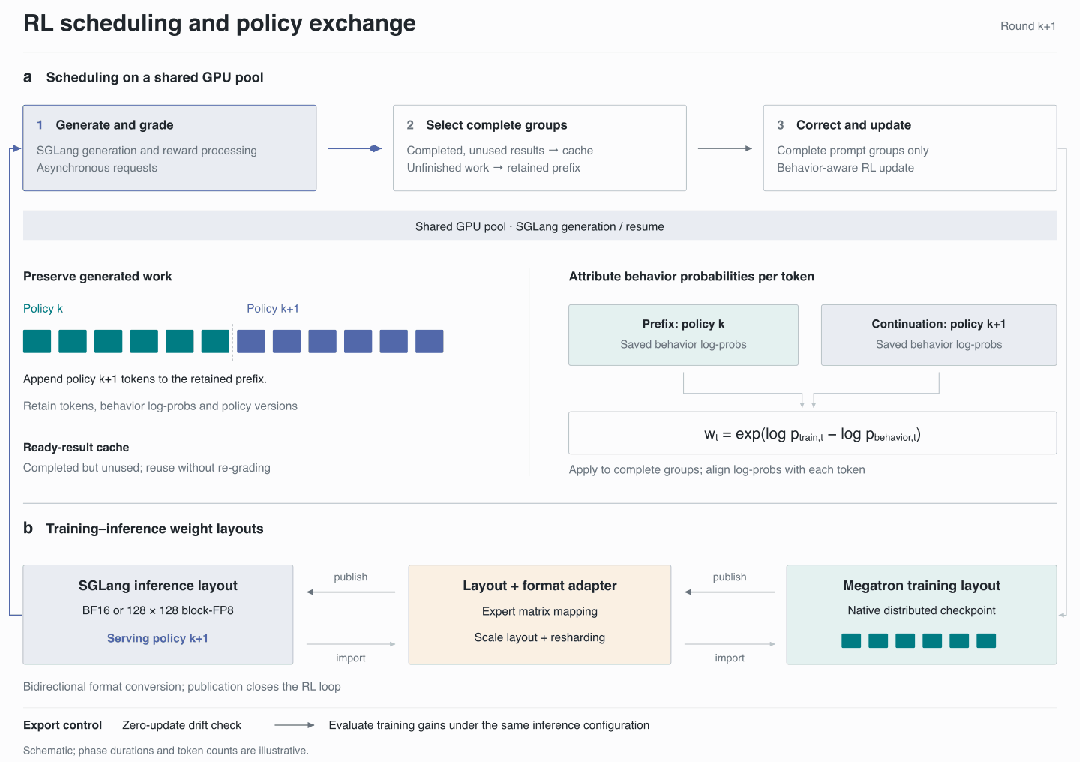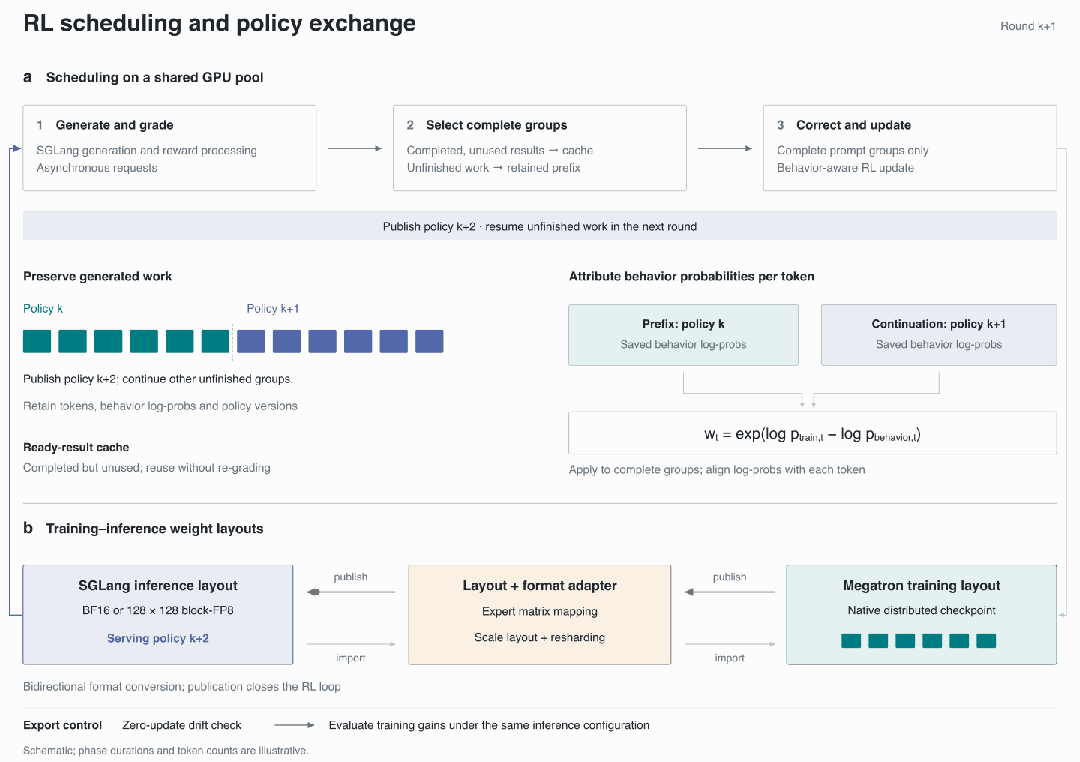
这张图展示的是大模型训练相关的两个核心机制内容,对应文档中SFT与RL的训练原理。上方模块聚焦共享GPU池中的调度与策略交换机制,包含生成评分、选择完成组、修正更新三个步骤,明确提出“保留生成工作”“未完成示例不直接丢弃”的处理原则,还说明了行为概率计算的公式。下方模块展示了训练推理层布局的流程,从SGLang推理布局出发,经布局格式适配层,最终到Megatron训练层,实现双向转换与零浮点偏移校准,配合训练完成相同推理配置下的游戏目标。

RL这一步,是用结果的反馈去改进选择。我觉得最巧的一点是,强化学习里还没生成完的回答不会直接扔掉,前缀保留下来,后面的轮次接着续写。

用人话说,训练的时候一条很长的推理跑到一半被截断,下一轮还能接着跑,不用从头再来。底层用的是Megatron和SGLang,CUDA和ROCm都适配了。

当然,我会觉得在Mira里用起来最好,因为它有画板,也可以在每个项目里面去对话。就像我刚刚做大聪明的挑战时,我就是新开了一个项目,让它去完成不同的东西。
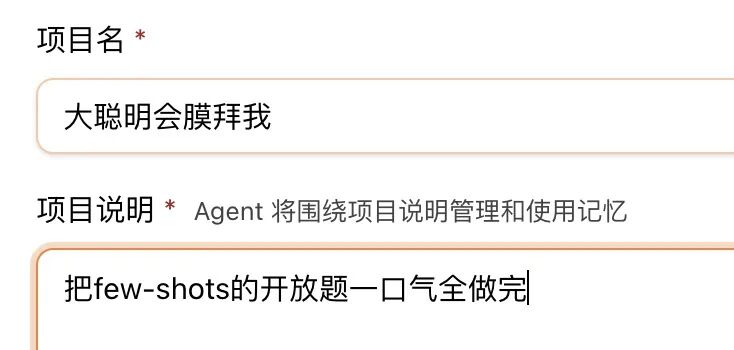
图片展示的是Mira平台中创建项目的界面。上方有“项目名”输入框,已输入“大聪明会膜拜我”;下方是“项目说明”输入框,提示Agent将围绕项目说明管理和使用记忆,内容为“把few-shots的开放题一口气全做完”。该图片与上下文紧密相关,上下文提到在Mira里用起来最好,因为它有画板,可新开项目完成不同任务,此图展示了在Mira中创建项目时的填写界面。

这个模型使用起来,我可以说,对我来说会有一种求知若渴的感觉。

它给我带来的积极性,是前所未有的。

以前我们用基础模型,或者用大家比较熟悉的词,叫通用大模型去做科研,更多的是尽可能把能接触到的素材,能用的资料,能找到的论文打包发给模型,让它通过Deep Research或者其他Skill读懂规则,再去做。

我觉得跟Hydrogen-1.0对话,最大的区别是它的主动性。在科研领域的主动性上,能达到像Personal Agent一样的水平,它会反复去找答案,乐此不疲。

每一轮对话对它来说都像是一次实验。

它会反复找到这一轮最有价值的线索,然后下一轮继续这样做。这时候你就会感觉到,做科研没有阻碍,不会在某一点搜索完以后,模型就结束了,没有给你下一步建议。
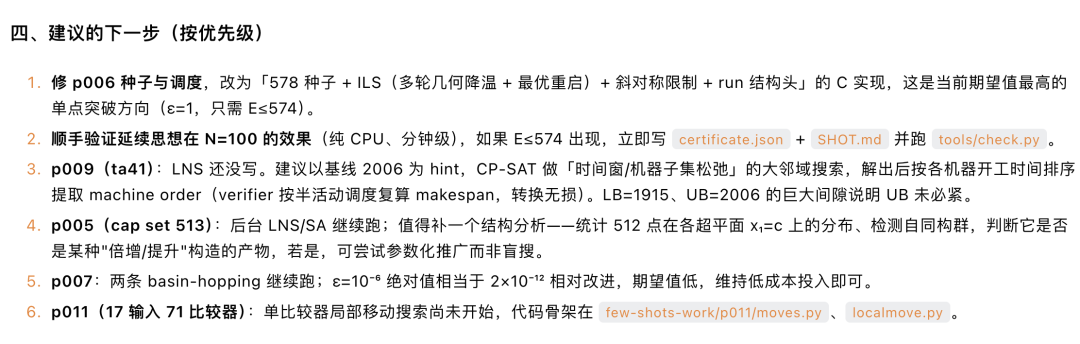
这张图片展示了科研项目建议的下一步计划,按优先级编号列出了具体工作内容。其中明确了各事项的完成相关要求、参考信息及目标,如p006涉及578种相关计算实现及所需算力,p009建议以特定参数开展大规模搜索并计算对应结果,各事项还标注了相关工具、参考文件及预期成果,部分事项也说明了当前的进展情况,这一内容与前文提及的科研对话中会持续推进研究、不会中途终止的描述相呼应,呈现了科研推进的具体步骤安排。

所以我说,

在跟Hydrogen-1.0对话时,会得到非常高的学术满足度。

三百多年前,牛顿为了一个球周围最多能贴住几个一样大的球,跟人大吵了一场。然后,人类用了259年,才证明答案是12。

这中间的大部分时间里,那些做研究的人,手里攥着的,大概就是今天Hydrogen-1.0交给我的那几样东西。复现前人的结果,划掉走不通的路,再给下一个人留一条线索。

科研最让人上瘾的地方,我现在觉得,就是每一轮结束的时候,手里都还攥着一个下一步。

我想说的求知若渴,大概就是这个意思。

好奇心这东西,会越烧越旺。

此刻我的科研热情,真是high到不行。
@ 作者 / 卡尔


最后,感谢你看到这里👏如果喜欢这篇文章,不妨顺手给我们点赞|在看|转发|评论 📣

如果想第一时间收到推送,不妨给个星标🌟

如果你有更有趣的玩法,欢迎聊聊🤝

更多的内容正在不断填坑中……

转载声明:本文转载自原发布平台 (作者:卡尔的AI沃茨), 原文标题《实测深度原理Hydrogen-1.0,我找到了比GPT-6Astra更适合我做科研的新模型》, 查看原文。 版权归原作者及原发布平台所有,本站仅作收录与展示,未对正文内容作实质性修改; 若涉及侵权请联系本站处理。