因为要打美亚杯,听说其他学校师傅们都打算带上很多的Spark打比赛,所以撺掇着也弄了台 今天也是对师傅们推荐的Strata和TensorFold架构都进行了测试 模型感觉也只推荐qwen3.8 flash next了,其他在单机上表现都不太好 dgx给我最惊艳的是这么小的一个东西,也不太发热,能跑这么强劲的模型,果然时代发展的好快呀
速度对比
| 113 | ||
| 16 流 160–215 tok/s | ||
比较
Strata
优点
完整的“产品”体验: strata launch引导式装模型、自动选量化、strata connect一键生成 Claude Code / Codex / OpenCode 配置、预设、开机级 API key 管理。有 Web 聊天页、TUI 监控( strata monitor)、桌面快捷方式、模型目录与显存适配计算。OpenAI + Anthropic 双协议、局域网/tailscale/cloudflare 访问模式。 签名更新源、断点续传、模型校验;文档极其完整(含 DGX Spark 专页)。 模型选择多(Qwen 各量化、DeepSeek V4.1、Qwen3.6 等),NVFP4/GGUF 等格式支持成熟。
缺点
慢:解码 42–55 tok/s,差不多是 TensorFold 的 60–70%。 128K 就顶到实测上限,再大没验证;并发只有 4–8 槽,聚合吞吐低。 ARM/Spark 上只能用 Terminal,没有桌面 App;模型准备阶段还依赖 GitHub(被墙时要手动预置 llama.cpp)。 内存更吃紧(128K 只剩 21 G)。 模型是 IQ3_S(约 3-bit)或 NVFP4,格式由它决定。
TensorFold
优点
快:单流最高 113 tok/s,16 并发 215 tok/s,是这台机器上目前最快的方案。 内存效率高:128K + 5 流还能剩 28 G;32K 能开 16 流。 内置实时监控面板( --dashboard,解码/预填充/内存/草稿接受率,5 分钟曲线)。单二进制 48 MB,无 Python 依赖; pull断点续传 + SHA 校验,复用 HF 缓存;Prometheus/metrics。模型家族覆盖广(qwen4、GLM、Nemotron、Gemma、LFM 等),支持多卡 TP、结构化输出、工具调用。 原生支持 256K,文档给出 1M 的 YaRN 路径。
缺点
开发者工具:没有 connect、没有模型目录/适配建议、没有预设和服务管理,装模型要自己选仓库和参数。没有聊天网页, /dashboard只是监控页,还要过 API key(为此写了 8090 反代)。CUDA 上的 Flash Next 路径较新:只认 MLX 4-bit g32 检查点、不支持 fp8 KV、对模型结构校验很严(不匹配直接拒绝加载)。 模型 113 GB,比 Strata 的 84 GB 大;依赖 HuggingFace(国内要镜像,且镜像不稳定)。 文档偏“研发/复现”风格,普通用户上手成本高。
简单来说做美亚杯的话TensorFold更好,速度快一些,5并发基本没什么压力
上下文有个参考,目前来看128K是最好的
安装
许愿式即可 
应用
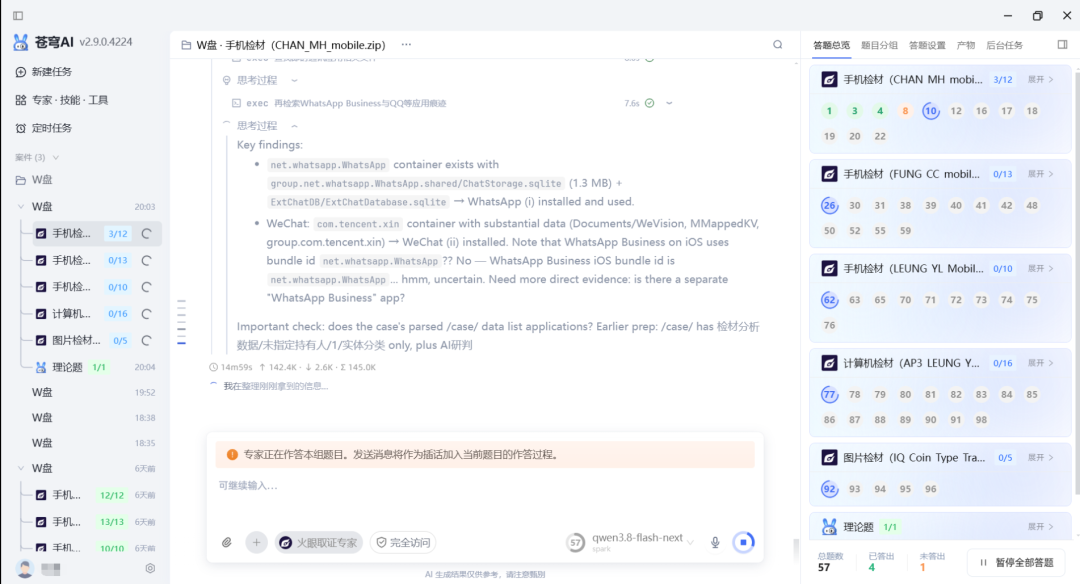
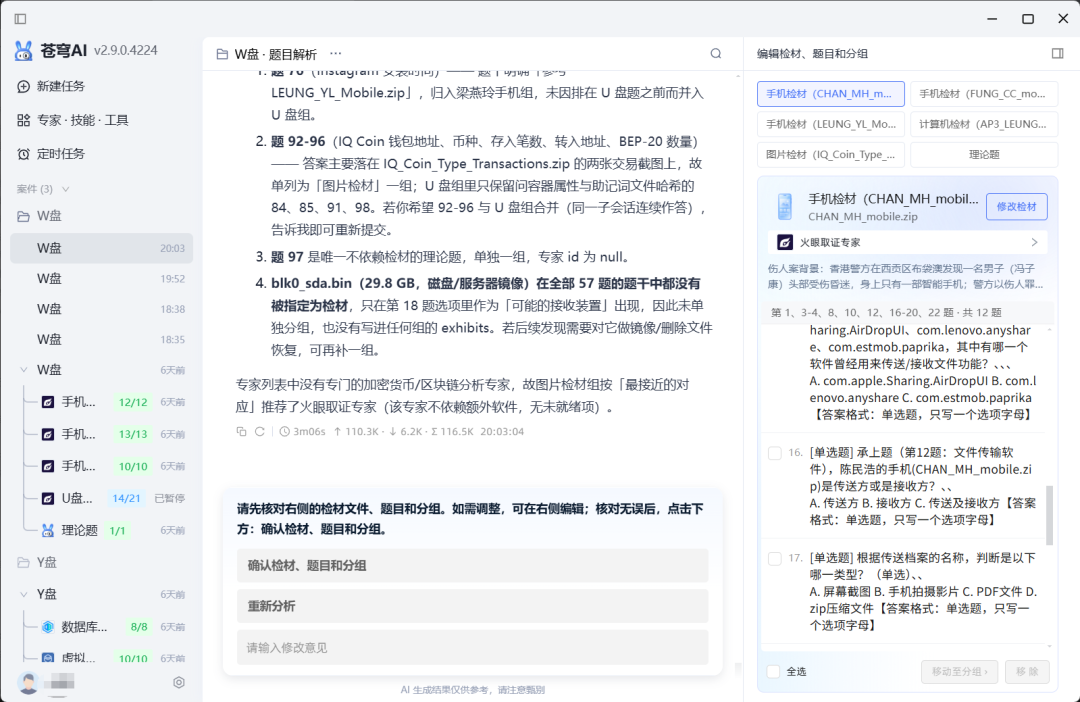
dsh上就不说了,非常丝滑  接下来打算用苍穹测试一下(2025美亚杯个人赛),刚刚3分钟完成了题目分组
 开了5并发(其实还是有点大了,导致大多数时间一直在prefill)
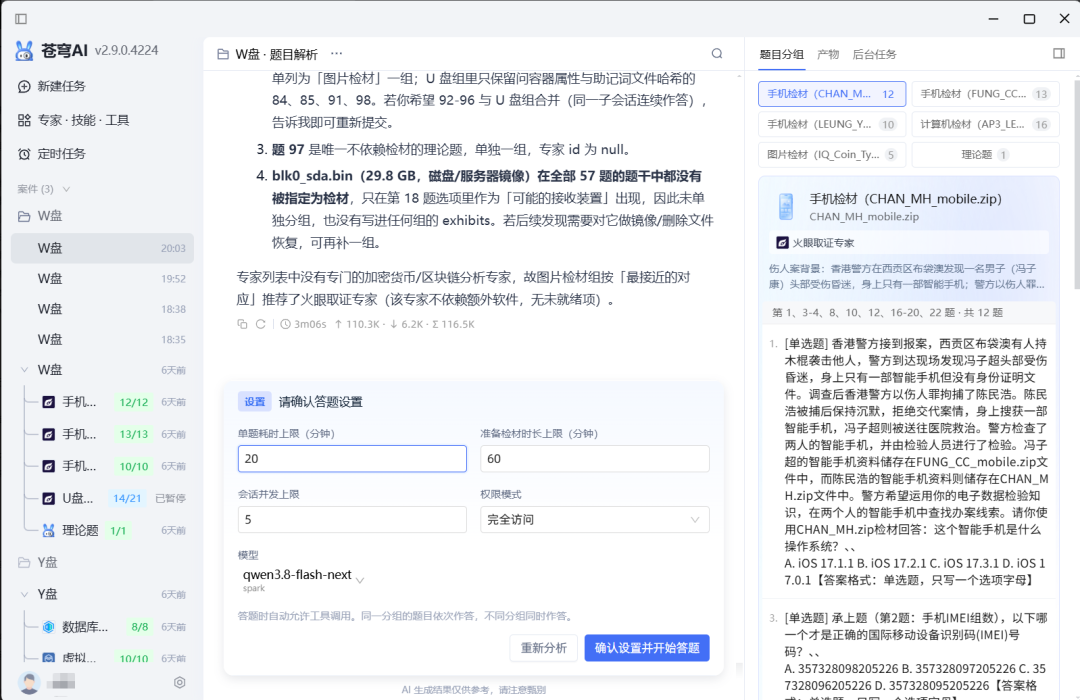
所以全分析就比较吃力了,先让他跑一晚上,明天看看效果 (这是做了一个半小时的)