当 Excel、Word、PDF、扫描件、SQL 导出同处一案,多格式清洗到底解决了什么?
一、办案数据整理的“第一关难题”
在纪检监察线索研判工作中,电子检材的标准化处理是所有分析工作的前置基础,而多源数据格式异构、质量参差不齐,始终是一线办案的共性痛点,直接拖慢整个案件研判节奏,核心集中在四点:
1格式异构不一,数据预处理耗损大量办案精力
来自不同渠道的检材格式标准完全不统一:不同银行的流水表头、字段定义各有差异;微信、支付宝等支付账单带有冗余说明行、非标准列;通话记录、出行轨迹、工商信息、企业财务数据等各自遵循不同的导出规范,有的检材甚至可能还包括图片、音频和视频内容。办案人员拿到检材后,往往需要先花数小时甚至数天统一格式、对齐字段、删除冗余内容,大量核心办案精力消耗在基础数据整理上。
2目录层级混乱,检材管理与交接成本高
案件电子检材通常按原始取证的文件夹结构存储,包含多层子目录、零散文件。传统人工入库需要重新分类整理、统一命名,不仅工作量大,还容易破坏原始材料的目录逻辑;案件交接时,经常出现文件缺失、路径混乱、版本不清的问题,查找一份特定检材需要翻查多个文件夹,效率极低。
3人工清洗易出错,数据质量影响研判结果
人工处理海量数据时,普遍存在字段错配、重复数据遗漏、异常值识别不全等问题:比如交易时间与记账时间混淆、同名交易主体去重不彻底、小额零散异常数据被忽略。数据底层的误差会直接传导至后续研判环节,导致分析结果偏差,甚至产生无效线索,增加核查成本。
4清洗与研判脱节,数据流转链路不顺畅
传统模式下,数据清洗和线索研判分属不同环节、不同工具,清洗完成后需要手动导入分析系统、重新关联案件,不仅流转效率低,还容易出现数据版本不一致、检材与案件对应错误等问题,数据从入库到研判的链路断裂。
二、全格式覆盖:办案材料无需“先转格式”
问迹清洗层原生覆盖办案场景全部常见格式:文本、图片、音频、视频等。与通用文件管理工具不同,系统对结构化数据在解析入库时会主动识别字段语义:流水表中的交易时间、金额、对手账户被归并到对应分析维度,通话详单中的主叫、被叫、时长被结构化提取。这种“边清洗边理解”的能力,让材料入库的同时就具备了被 AI 直接分析的基础。对于图片、音频、视频等非结构化文件,系统不进行结构化入库处理,而是通过多模态模型的图像理解能力直接读取原始文件内容,辅助办案人员快速了解材料信息。
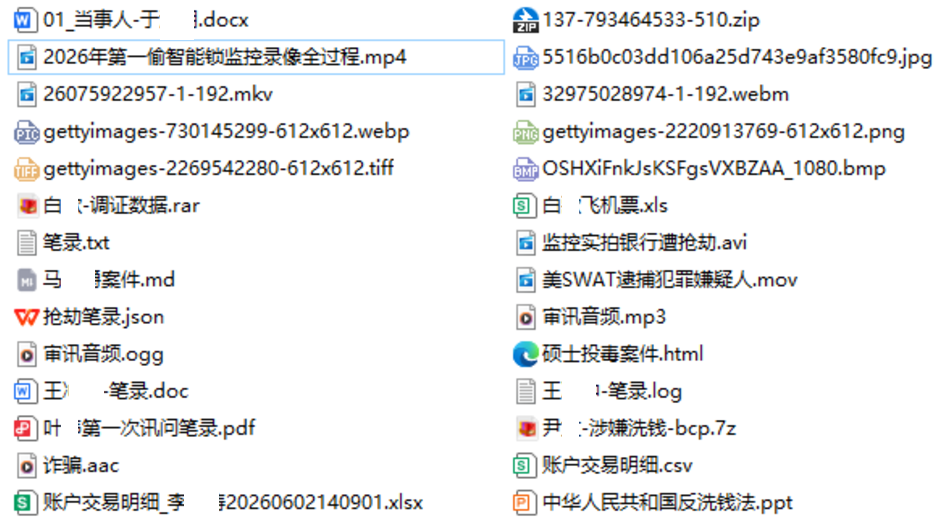
将多格式繁杂检材直接导入到系统中,28 个检材、涵盖 DOCX、PDF、XLSX、CSV、JSON、TXT、HTML、MD、ZIP、7Z、RAR、PPT、LOG 等 13 种格式以及视频、音频、图片等媒体文件共计 890M 的全部清洗与初步分析——没有人工标字段、没有跨系统导表,材料传完,分析就能开始。
三、整文件夹一键拖拽:本地怎么归档,进系统就怎么归档
一个案子卷起来,材料往往是几百上千份:不用再一份一份选、选完再一份一份标对象,光把材料“搬进门”就要耗掉大半天。问迹把这一步直接压成一次拖拽。
拖进来之后,本地怎么归档,进系统就怎么归档:子目录、相对路径完整保留,办案人员一眼就知道哪份材料来自哪个批次。同名根文件夹会主动询问是否合并,避免不同批次的材料被误并;空目录自动不入队,不留下一堆空占位;上传前可展开子目录逐份勾选,不属于本案的文件直接剔除。队列里还能逐份或批量填写“所属对象”和“检材备注”,一次框选、一键填充,不用每份重复敲。
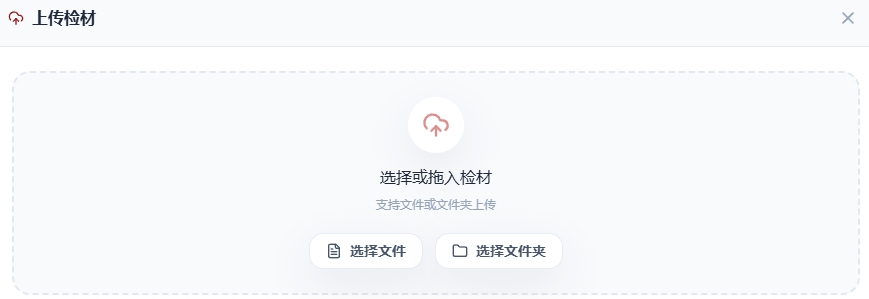
四、扫描件秒级识读:纸质卷宗直接变可检索文本
早年归档的纸质卷宗、现场手写笔录、当事人签字的证据照片,扫描成图片后就堆在硬盘里,要用时只能一页一页翻。问迹把这部分最耗时间的“人肉翻卷宗”环节也并进了清洗层:系统通过多模态模型直接读取图片内容,秒级输出文字识别结果和内容摘要,不用先跑一遍 OCR 软件,也不用再人工逐字校对。
两个细节贴合办案实际:一是快——扫描件一上传,文字内容立刻可读、可搜、可引用,办案人员不用再抱着一堆 PDF 逐页翻找;二是稳——对清晰的手写体、印刷体,识别结果与原图高度一致;原始扫描件完整保留在检材库中,识别结果作为辅助参考,随时可以翻回原图复核,不会因为系统误识造成二次错误。
五、边上传边入库:结构化数据自动“读懂字段”
传统数据清洗最费劲的,其实不是传文件,而是传完之后的“建模”——哪一列是时间、哪一列是金额、哪一列是对手账户,都要人工对着表头一列表一列表地标。问迹把这一步也省了:Excel、CSV、数据库 SQL 导出的结构化数据,上传后在后台自动完成格式解析与标准化入库,流水表中的交易时间、金额、对手账户被自动归并到资金分析维度,通话详单中的主叫、被叫、时长被自动提取到通联维度。后台做了什么、做到哪一步,办案人员在“传输列表”里一眼可见,不需要猜。
这种“上传即完成”的体验,把传统模式下需要数天的数据规整工作压缩到了分钟级。
六、清洗完直接研判:从材料到线索不换系统
清洗不是终点,而是研判的起点。在传统流程里,材料清洗完还要导出、整理格式、再导入到另一个分析工具,跨系统的搬运往往又会耗掉大半天。问迹把清洗层和研判层直接打通:检材入库后,在检材列表勾选目标文件就能一键“发起分析”;在研判对话里用 @ 引用具体检材,AI 立刻就能基于刚清洗好的数据回答问题,一句话下去,线索就出来了。
清洗层越扎实,AI 给出的每一条结论就越能落回到原始材料上,也越经得起“这句话来自哪份文件哪一页”的追问。从产品价值看,清洗层直接决定三件事:AI 研判的准确率、线索溯源的可还原性,以及办案人员从材料整理中被释放出来的时间。
公众号私信“问迹”了解更多产品功能~
END
精/选/文/章
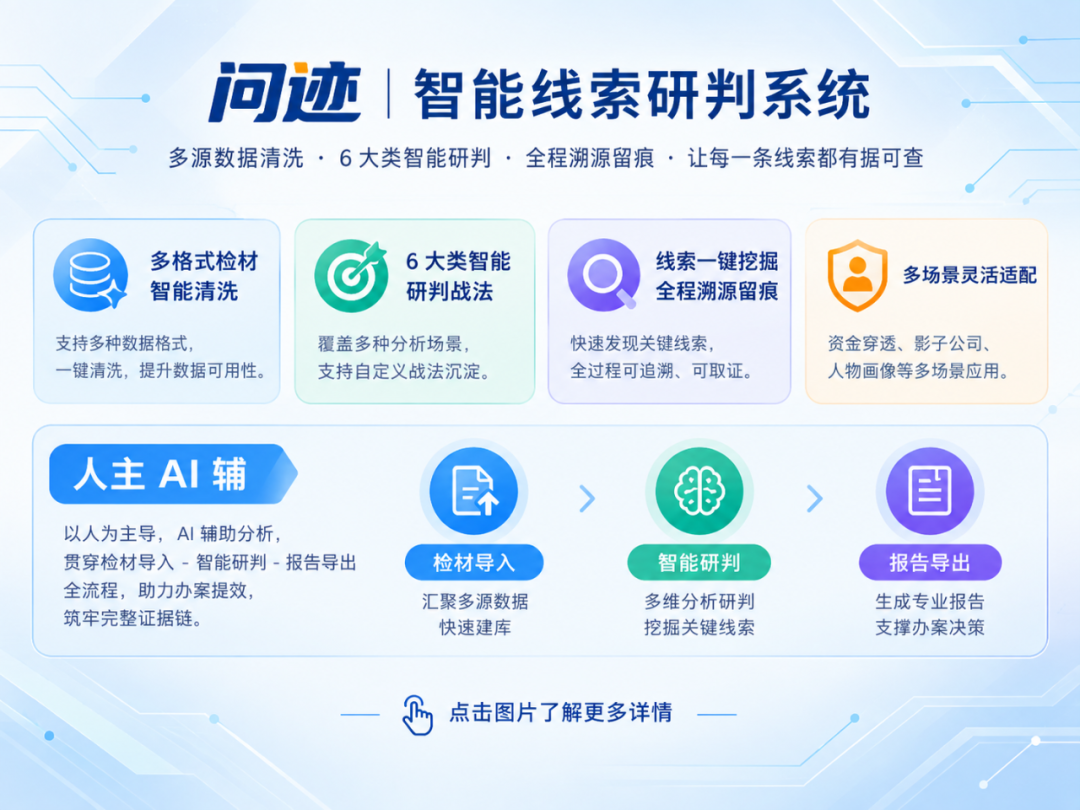
关于国信智擎
国信智擎(四川)科技有限责任公司(简称国信智擎)是一家专注于数据线索分析智能体的科技公司。
我们在电子数据取证与分析领域长期深耕,从无数真实场景中反复打磨,沉淀出一套完整的智能体能力体系——涵盖多源数据接入恢复、深层结构识别解析,直至智能化的线索挖掘、关联追踪与结论输出。
我们的愿景是用智能体重新定义数据洞见,成为数据决策领域的信任基石。我们做这件事的目的很简单:聚同道,交挚友。