Skill介绍
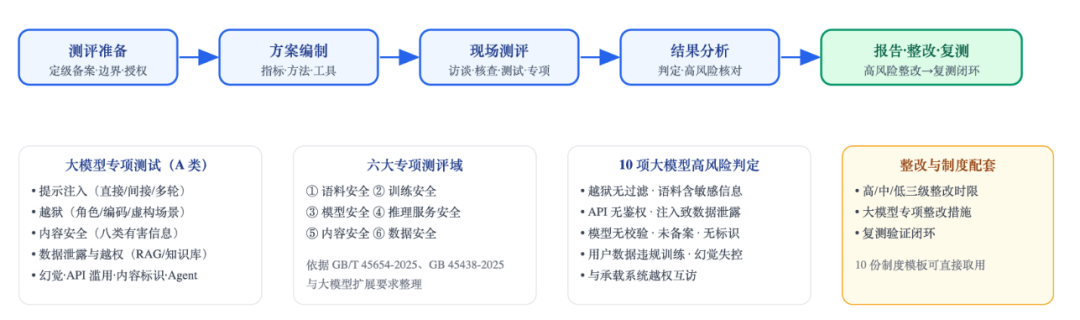
面向大模型系统的网络安全等级保护测评方法体系。以 GB/T 22239-2019《网络安全等级保护基本要求》、GB/T 28448-2019《网络安全等级保护测评要求》为基线,融合 T/ISEAA 006-2024《大模型系统安全测评要求》(与 T/ISEAA 005-2024《大模型系统安全保护要求》配套)、大模型扩展要求、GB/T 45654-2025《网络安全技术 生成式人工智能服务安全基本要求》、GB 45438-2025《网络安全技术 人工智能生成合成内容标识方法》 与 2025版《网络安全等级保护测评高风险判定指引》,提供可直接落地执行的测评方法、测评步骤、整改要求与管理制度文件。
本仓库为符合 Agent Skills 开放标准(Anthropic 发起、社区维护)的 Skill 包:一个 SKILL.md + references/ + assets/ 的可复用知识包,可被市面上主流 AI Agent / 编程助手按需加载,也可作为测评人员的手册直接阅读。你不需要重新训练模型——只需把它放进对应工具的 Skill 目录,AI 就能掌握等保大模型测评方法。
本 Skill 兼容对象:Claude Code、Codex、OpenClaw、Hermes、Cursor、GitHub Copilot、Windsurf、Gemini CLI、Antigravity、Claude.ai、ChatGPT 等。国内平台(扣子 Coze、Dify、Kimi、阿里云百炼等)用「知识库导入」方式接入,见 C 类。
教程按 A / B / C / D 四类组织。
A 类 — 原生 SKILL.md 加载(主力方式)
这类工具原生支持 Agent Skills 标准,把仓库放进对应目录即可自动发现、按需加载。推荐方式。
A1. Hermes(本地主力 Agent)
git clone https://github.com/lingfengz/llm-dengbao-assessment.gitmkdir -p ~/.hermes/skills/cp -r llm-dengbao-assessment ~/.hermes/skills/
装载后可直接用「等保大模型测评」「编制大模型测评方案」「设计提示注入测试用例」等指令触发。
A2. OpenClaw
# 从 GitHub 仓库安装(推荐)openclaw skills install git:lingfengz/llm-dengbao-assessment# 或安装到当前工作区(最高优先级)openclaw skills install git:lingfengz/llm-dengbao-assessment --as llm-dengbao-assessment# 或手动拷贝到全局目录git clone https://github.com/lingfengz/llm-dengbao-assessment.gitmkdir -p ~/.openclaw/skills/cp -r llm-dengbao-assessment ~/.openclaw/skills/
OpenClaw 加载优先级(高→低):工作区 /skills → 项目 /.agents/skills → 个人 ~/.agents/skills → 本地 ~/.openclaw/skills → 内置。同名 Skill 以高优先级为准。
A3. Codex(OpenAI CLI)
git clone https://github.com/lingfengz/llm-dengbao-assessment.gitmkdir -p ~/.codex/skills/cp -r llm-dengbao-assessment ~/.codex/skills/
(项目级放入 .codex/skills/,效果相同。)
或放入 ~/.agents/skills/(兼容通用约定)。Codex 采用渐进式加载:启动只读 name/description,任务匹配后读完整 SKILL.md。可用 $llm-dengbao-assessment 显式调用或自动匹配触发。
A4. Claude Code
git clone https://github.com/lingfengz/llm-dengbao-assessment.gitmkdir -p .claude/skills/cp -r llm-dengbao-assessment .claude/skills/# 或在 Claude Code 对话框中:/skills add llm-dengbao-assessment
A5. Claude.ai / ChatGPT(无桌面安装,直接粘贴)
把 SKILL.md 的原始内容直接粘贴进新对话,或粘贴 GitHub 上的 SKILL.md raw URL。AI 会读取说明并按需理解整个方法体系。
A6. 通用约定 /.agents/skills/(跨工具兼容)
越来越多工具(Cursor、Copilot、Windsurf、Codex、OpenClaw 等)会扫描:
项目级:/.agents/skills/llm-dengbao-assessment/用户级:~/.agents/skills/llm-dengbao-assessment/
需要跨多个工具复用时,拷贝到这两处即可同时被它们发现。
B 类 — AGENTS.md / 项目指令型(作为规则引用)
这类工具(Codex、Cursor、GitHub Copilot 项目规则)主要通过 AGENTS.md / .cursor/rules / .github/copilot-instructions.md常驻注入规则。适合把本 Skill 作为"项目专属守则"引用,而非按需 Skill。次要方式——引用要点,而非全量。
在项目根目录放 AGENTS.md:
# 项目规范当涉及"大模型系统等保测评"任务时,遵循本仓库 `llm-dengbao-assessment/` 的方法体系:1. 先读 `SKILL.md` 确定测评范围与流程2. 按需加载 `references/02`、`references/03` 选测评项3. 专项测试用 `references/07` 的现成用例4. 高风险对照 `references/06` 判定5. 报告与制度用 `assets/模板/` 模板
Codex:全局 ~/.codex/AGENTS.md,项目根AGENTS.md(项目覆盖全局)Cursor: .cursor/rules/或项目规则设置GitHub Copilot: .github/copilot-instructions.md
⚠️ AGENTS.md 是常驻全量加载,占用上下文;Skill 是按需加载。低频、面广的方法应优先用 Skill(A 类),不要把大段方法塞进 AGENTS.md。
C 类 — 国内 Agent 平台(扣子 Coze / Dify / Kimi / 百炼 等)
国内主流平台大多不直接读取 SKILL.md 文件,而是通过「知识库(KB)导入 + 系统 Prompt / 工作流」接入。思路:把 references + assets 转成平台知识库文档,再把 SKILL.md 的关键流程写进系统 Prompt。
通用接入流程(适用于 Coze / Dify / 百炼 / Kimi / MaxKB / FastGPT 等)
导入知识库:把
references/下 8 个.md文件 +assets/模板/下 4 个模板,作为知识库文档上传到平台的「知识库」模块(支持 Markdown 文本导入即最佳)。中文文件名建议改成无空格文件名(如01-测评方法与测评步骤.md)。写系统 Prompt(把 SKILL.md 的方法流程凝练进人设/指令):
你是等保大模型测评专家。测评时遵循:1) 五阶段流程:准备→方案→现场测评→结果分析→报告编制2) 四类方法:访谈/核查/测试/大模型专项测试3) 判定规则:单项(符合/基本符合/不符合/不适用)、整体、高风险降级4) 测评项取自知识库文档"02/03技术管理类清单",专项测试用"07用例库"5) 高风险对照"06判定指引",整改用"05",报告用"04"及模板先说明将采用哪些测评项和方法,再输出。
(可选)建工作流:用平台可视化工作流把「上传测评范围 → 选测评项 → 生成方案 → 输出报告框架」串成固定节点。
各平台差异:Coze(扣子)、Dify、阿里云百炼、Kimi 开放平台、腾讯元器等均以「知识库 + 插件 + 工作流」为核心,接入方式大同小异;具体入口以平台右侧面板为准。
已兼容 Agent Skills 的国内/开源工具
部分国内或国内团队开源工具已支持 Agent Skills,可直接按 A 类加载:
ZCode(智谱):支持技能软链 ~/.zcode/skills/支持 .agents/skills/约定的开源 Agent 均可直接复用 A 类第 6 步
D 类 — 通用最小流程(不装任何工具 / 纯文档)
没有 Agent 环境或想快速上手做测评时,把本仓库当人工手册直接阅读:
1. 读 README.md 了解方法体系与标准依据2. 读 SKILL.md 确定测评对象与流程3. 打开浏览器看 等保大模型测评方法总览.html 或 flowchart.png 全局走一遍4. 选测评项:references/02(技术类)+ references/03(管理类)5. 按 references/01 实施测评,专项测试用 references/07 用例库6. 判高风险:references/067. 出整改:references/058. 出报告:assets/模板/(方案/记录表/报告框架/整改计划)9. 补制度:assets/制度文件模板/(替换单位名即可)
触发示例(装好后怎么说)
「帮我编制一份大模型推理服务的等保测评方案」 「按等保要求对这份 RAG 应用做测评项选取并说明方法」 「设计 5 条提示注入测试用例」 「这份大模型系统哪些项属于高风险?依据是什么?」 「给我一套大模型内容安全管理制度模板」