最让人后背发凉的,并不是屏幕上跳出一个陌生进程,而是从它的密文里读到了自己熟悉的窗口标题。
然而,真正把这次分析拖进深水区的,是另一个看似令人安心的结果:密文解开了,中文也出来了,验证程序还在不断打印成功。
这次排查恰好走到了这一步。调查目录里已经积累了一组载荷文件、几份内存提取件、几十个通信文件,还有一份写着“协议权威实现”的 Python 脚本。它对自己的结论相当有把握:字段含义已经确认,八份样本逐字节匹配,结果是 EXACT。
如果故事停在这里,很容易写成一篇漂亮的战报:木马现形,密钥到手,协议攻破。
可是,把一个只有 84 字节的文件重新拿出来计算,另一件事发生了。
old EXACT: True
old header interpretation consistent: False
同一份数据,在同一次运行里,一边“精确通过”,一边连自己声称的长度关系都对不上。
这才是本文真正的起点。
木马的密文里确实有本机窗口标题。看到这些原本属于桌面的字串,出现在另一个程序组织的消息中,已经足够让人警觉。但要弄清楚它究竟做了什么,还得穿过另一层东西:那些看起来专业、彼此还能互相印证的错误解释。
这篇文章会尽量保留这段过程里的摩擦:为什么先怀疑 HTTP,为什么 AES 解开以后 UTF-8 仍然报错,为什么四个字节会像幽灵一样插在中文中间,以及为什么一份“全部通过”的回归测试,仍然没有证明协议正确。
这篇复盘沿着三条线展开:主机上留下了什么,内存中的程序怎样组织消息,以及远端探测究竟回答了多少问题。AI 参与了材料梳理、代码编写和核验,但每一个结论仍要回到文件与字节。
文中代码与响应分别标明历史记录、离线重跑和人工测试。 主要实验均实际运行,完整脚本与输出随文附上;读者可以沿着同一份短帧,把关键步骤重新走一遍。
一、先把现场摊开:资料包、任务和进程之间,究竟连得上什么
最初能抓住的线索并不复杂:本地微信文件目录中留着一个压缩包,本文以脱敏名称“某某地区招聘数据.zip”指代。后来核查发现,一共有三份内容相同的 ZIP,每份里面都只有一个 MSI,展开后的安装文件长度为 4,411,392 字节。
这不是根据文件名猜的。先前复核读取了 ZIP 的条目,对 ZIP 本身和其中的 MSI 分别计算了 SHA256。三份包的指纹相同,包内 MSI 的指纹也相同。
ZIP SHA256
2D0EC969F275FDE94AD5D1F07FC5F86EC75378E13953371ADB3FA42B6B21A043

MSI SHA256
2171E7CB8A9594FB305CA2D7FDE1A2C327C614AFCA801C0D4553D24A081148D2与此同时,保存的载荷副本中有两个名字:SeGyvmDwXftw.exe 和 SingMusice.exe。它们看上去不像同一个东西,算出来却是同一个 SHA256:
AE5325C22304C8EF2E53B1C199B8DDAC6FB4E3A315E61DF2BD00B74F5C833AAD先前取证报告还记录了 FindOversee、ChangeHunt 两项任务,任务动作指向载荷,配置身份为 SYSTEM,重复间隔分别为 61 分钟和 90 分钟。历史进程日志中则出现了相关进程的多个实例。
这些材料值得重视,因为文件、任务和进程能够在同一条线索上互相对应。随机名称本身没有证明力;名字像正版软件也没有免责作用。面对一组未知文件,最好先回答“它是什么内容、谁启动它、它做了什么”,再考虑给它贴标签。
这里还埋着两个容易写过头的地方。
第一,ZIP 位于微信目录,并不能单独证明谁是发送者,更不能证明发送者就是木马操作者。聊天原件、转发过程和实际执行经过仍然需要单独核实。
第二,早期报告记录了 3 月 11 日的安装和落地线索,9 月 20 日又有相关进程记录。这是相隔约半年的两组证据,不是一份覆盖六个月的键盘日志。把“最早发现于三月”写成“连续监控半年”,中间缺少的恰恰是需要证明的部分。
两项任务在清理中已经删除,留下的是当时的检查记录和备份材料。后续复核只能从这些材料继续向前。原件、历史输出和分析结论看起来都可以是一份文件,证据分量却不同。
二、感染链不是一根箭头,而是一组需要对齐的时间
协议解开以后,很容易产生一种错觉:只要消息足够清楚,感染经过也就跟着清楚了。实际上,从“窗口标题被组织进消息”回到“这个程序何时、由谁、通过什么方式开始运行”,中间仍然隔着安装包、文件系统、任务配置和进程记录。
把安装包、落地文件和任务排在一起,时间线似乎已经成形。可当我回到 PE 分析文本,第一处裂缝就出现在最不起眼的日期里。
以下是 raw/SeGyvmDwXftw.exe-pe.txt 的历史输出节选,保留原文:
Created: 2026/5/26 1:18:01  Modified: 2026/3/9 15:54:39  Attr:Archive
TimeDateStamp:0x69AE71BA = 2026-03-09 07:07:38 (UTC) / 2026-03-09 15:07:38 (Local)
早期分析曾把 2026-03-09 15:54:39 当作 PE 编译时间。对照字段后才发现,它对应的是文件修改时间;PE 头的 TimeDateStamp 对应本地时间 15:07:38。此外,同一份文件记录的创建时间是 5 月 26 日。这三种时间不能揉成一个“感染时间”。
报告之间出现矛盾,最直接的办法是回到文件本身。我重新读取了隔离区保存的 PE 字节。脚本没有加载或执行它,只是从 DOS 头找到 PE 头,再读取 COFF 时间戳:
peoff = struct.unpack_from('<I', pe, 0x3c)[0]
assert pe[:2] == b'MZ' and pe[peoff:peoff+4] == b'PE\0\0'
stamp = struct.unpack_from('<I', pe, peoff+8)[0]
实际读取结果:
{
"machine":"0x8664",
"coff_timestamp_utc":"2026-03-09T07:07:38+00:00",
"sha256":"ae5325c22304c8ef2e53b1c199b8ddac6fb4e3a315e61df2bd00b74f5c833aad"
}
这个结果修正了字段混用,但仍不等于找到了真正的编译时刻。PE 时间戳可以被修改;文件时间也会受到复制、恢复、安装和人为设置的影响。这里能确认的是“保存的文件头里写着什么”,而不是攻击者电脑在那个时刻发生了什么。
同样,微信目录里存在 ZIP、安装信息中出现 MSI 产品名、任务配置带有三月的起始日期,可以放在同一条调查时间线上;但要证明“某人在某时发送,用户在某时点击执行”,还需要聊天原件、安装记录和执行痕迹相互对应。截图时间、文件属性时间、任务触发器时间,各自回答的是不同问题。
取证最容易显得“不够爽”的地方就在这里:每当故事快要连成一条漂亮直线,就要停下来检查箭头。可真正能交给读者复查的,恰恰是这些停顿。
三、有签名的程序、随机名驱动,以及一个不是驱动的 .sys
这一组落地文件很有迷惑性。有人负责看起来正常,有人负责名字混乱,还有人借了一个系统扩展名,却连对应文件格式都不是。
SodaMusicLauncher.exe 的历史检查结果为:
Authenticode Status:Valid
FileVersion    :2.2.0
CompanyName    :Beijing Douyin Technology Co., Ltd.
ProductName    :汽水音乐
随机长文件名 TDIEZTJwHlbXkDcWpTqcYxbixDLYfM 的历史检查结果则是:
Authenticode Status:Valid
SignerCertificate :CN=Wincor Nixdorf International GmbH, O=Wincor Nixdorf International GmbH, L=Paderborn, S=Germany, C=DE
FileDescription:WnBios Driver
OriginalName   :wnbios.sys
这两段输出来自保存的原始分析文本,不是这次离线复核重新联网验证证书。签名状态有其采集时点;产品信息和签名主体也不是同一个字段。例如宿主的版本信息写着 Beijing Douyin Technology Co., Ltd.,证书主体另有自己的名称,不应随手替换成一个笼统的公司名。
更重要的是,签名只能帮助核查文件来源与完整性,不能替启动上下文背书。合法程序出现在异常落地目录、邻近可疑 DLL、被异常链条启动,仍值得调查。反过来,只凭它和恶意载荷摆在一起,也不能证明某次 DLL 侧加载确实完成了。要把“白加黑”从候选解释写成具体过程,还需要加载模块、路径解析、导入调用或者动态记录。
同样,wnbios.sys 的原始名称、签名和文件特征支持把它列入驱动滥用线索,但不能单独证明内核杀软已经发生。驱动存在、服务注册、成功加载、设备句柄打开、危险操作执行,是逐步加深的证据。在缺少加载和调用证据时,分析只能停在驱动滥用线索,尚不能写成“已经在内核层终止安全软件”。
另一边,asnmkMCG.sys 在历史 PE 检查里得到的是:
Size: 1214679 bytes
NOT A VALID PE (bad e_lfanew)
这里 .sys 只是文件名的一部分。非 MZ 开头、PE 偏移越界,使它不符合那次检查所期待的常规 PE 驱动结构。高熵可以提示继续考虑压缩、加密或其他编码,但不能直接指定算法,更不能得出“静态绝对无法分析”。如果能恢复读取它的加载器及密钥路径,静态分析仍可能推进;内存提取只是本案已有材料中更直接的一条路。
把这些东西统称为“木马组件”很省字,代价却是抹掉技术差别。真正值得逆向的是它们之间的调用关系:谁启动谁,谁读取谁,谁把磁盘上的字节变成内存中的程序。
四、两个计划任务,证明的是启动条件
历史任务检查记录给出了两条不同的启动入口:
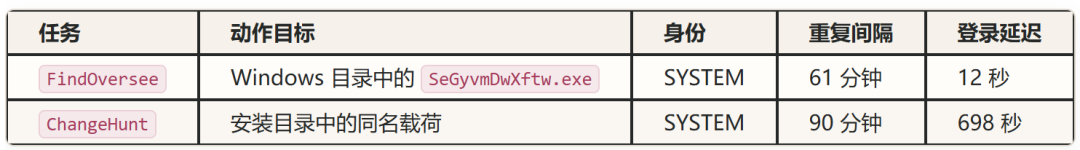
来源是 t2-report.md 中的历史任务复核;这里是归纳表,不是终端原文。两项配置还记录了隐藏属性。Microsoft 风格的任务目录和 SYSTEM 身份,会使普通用户更难凭名称判断异常,但它们不等于系统组件的真实性证明。
这些材料足以说明存在两套周期启动条件。至于它们是否会“删除一份,另一份就重新释放”,还需要另一类证据:删除后的文件重建事件、负责写入的进程、被调用的释放代码,或者连续观测日志。双份文件与双条任务本身,没有证明相互修复。
取证时可以将任务 XML 中的动作、主体、触发器、设置,与任务调度服务拉起的进程对应起来。清理后再做检查,回答的是另一道题:这些已知启动点是否还存在。它不能补回清理前没有采集的执行历史。
早期记录提到部分审计通道未启用、事件日志已经滚动覆盖。因此“查询没有命中”不等于“行为没有发生”。类似地,某一时刻进程没有网络端点,或者某项 I/O 计数为零,都不应扩写为“半年从未发送任何数据”。窗口快照、单个进程实例与整个感染周期,不能互相替代。
五、第一处真正的坑:目录里既有木马消息,也有调查者自己发的消息
逆向之前还有一道看似琐碎的工序:把输入整理明白。
原调查目录包含不同版本的监听器、协议探针、早期猜测、清理脚本和多份报告。先前目录快照统计到 456 个文件,其中有 74 个脚本。文件不断增加,“最新一份报告”也未必是最可靠的一份。
历史沉洞报告明确列出了自测流量:GET /selftest HTTP/1.1、GET /selftest2 HTTP/1.1,以及其他用于检查监听器的请求。它还记录了重复写盘问题。
这件事对协议识别的影响很直接。如果在整个目录中搜 HTTP/1.1,当然能够搜到。但这只能说明目录里存在 HTTP 文本,不能证明这些字节由木马发送。调查者发出的健康检查,也可能成为后来分析中的“协议证据”。
所以本篇把范围收紧到现存的 23 个 frame-*.bin。不把早期 HTTP 自测和主动伪造的信标混进来,再按文件内容哈希去重。
以下函数来自附件 code/lab_walkthrough.py,ctx["frames"] 是已经读入的 (文件名, 字节内容) 列表。读取的是数据,不启动这些文件:
def inventory(ctx):
    groups = collections.defaultdict(list)
    for name, blob in ctx['frames']:
        groups[hashlib.sha256(blob).hexdigest()].append(name)
print('input files:', len(ctx['frames']))
print('unique SHA256:', len(groups))
    for digest, names in groups.items():
        if len(names) > 1:
print('duplicate:', digest)
            for name in names:
print('  ' + name)
对本机授权原始目录重新运行,得到:
input files: 23
unique SHA256: 21
duplicate: 1677c86f1cd9f8324d395f80f9e5b3fe8e7f51ed85fb3747af9e5882dbd3bb1b
  frame-20260920-192020-661-c4-f0-46545.bin
  frame-20260920-192028-675-c4-46545.bin
duplicate: 5e92269a01fe5fbb540ca8c958574e0e03f0ca1094c2da1462519562eeae4327
  frame-20260920-192253-158-c13-f0-46916.bin
  frame-20260920-192301-160-c13-46916.bin
两个重复组把 23 个文件压缩成了 21 份不同内容。日志对重复落盘也有对应说明。
这一步解决的不是密码学问题,却决定了后面统计的对象。两个同内容文件,可能来自重复写盘,也可能来自协议重传;单凭哈希相同,还不能替它们选择原因。这里的重复写盘解释来自相关历史日志,而不是由哈希直接推导。
同样,文件名中的 19:17:56 是文件命名时间。监听日志里可能先收到内容、隔了几秒才落盘。用这个时间给攻击者画毫秒级行为轨迹,看上去精密,实际上已经离开了证据。
我希望 AI 在这一阶段产出的首先是一份可检查的清单:文件多少、来源是什么、哪里重复、哪些是自测、哪些只有二次报告。这样它后面提出的每个解释,才有明确的输入范围。
六、留下一份读者真的能跑的样本
如果全文只有几段代码和作者提供的截图,读者仍然只能相信作者。
附件因此单独选出了一份原始帧,编号 F01。它解密后的内容是:
0分 / QQ / 0ms/超时 / 未登录TG这条记录没有个人浏览标题,适合展示完整解析。公开附件中的 data/F01-original.hex 是它的原始字节十六进制文本,内容未经重加密或重新构造,SHA256 可与原文件核对。它是选取的真实证据,不是人工测试帧。
其余真实帧没有整包公开,因为它们能恢复私人窗口标题。人工构造的数据则放在另一个目录 synthetic_examples/,文件名明确包含 SYNTHETIC。
这两类东西用途不同:F01 可以让读者验证这条真实记录是否被正确解释;人工样本让读者检查解析器遇到长字符串、非 BMP 字符和错误输入时怎么表现。人工数据无论多么“像”,都不能用来证明电脑曾经被窃取了什么。
这次离线复核实际运行环境如下,完整输出见 runs/full-original-run.json:
Python:3.14.0
PyCryptodome:3.23.0
mode:authorized local original directory
network calls:none
公开附件可以直接运行下面的命令:
# 已经安装 Crypto.Cipher.AES 的环境无需重复安装依赖。
python -m pip install pycryptodome

# 只使用附件内选取的真实 F01;不需要本机原取证目录。
python -B -X utf8 code/lab_walkthrough.py --out my-f01-run.json

# 单独检查人工测试数据。
python -B -X utf8 code/test_verify_frames.py脚本使用排他创建写结果,my-f01-run.json 必须尚不存在。重复运行请换一个输出名称。解析过程没有网络请求;安装依赖是另一项操作,应使用可信包源。
正文中 23/23 的输出来自持有全部原件时的运行。公开包默认只读 F01,因而对应输出会是 1/1,去重结果也是 1。这不是复现失败,而是输入范围不同。两套真实运行结果都随附件保存,避免读者被这个差异绊住。
七、84 字节摆在面前,先让长度回答问题
选定 F01 以后,先不猜加密算法,也不猜消息含义。第一步只看文件长度和前四字节。
def outer(ctx):
    frame = ctx['f01']
    le, be = struct.unpack('<I', frame[:4])[0], struct.unpack('>I', frame[:4])[0]
print('F01 SHA256:', hashlib.sha256(frame).hexdigest())
print('file bytes:', len(frame))
print('prefix:', frame[:4].hex(' '))
print('little-endian:', le, 'actual body:', len(frame)-4)
print('big-endian:', be)
print('HTTP method prefix:', frame.startswith((b'GET ', b'POST ', b'HEAD ')))
print('IV:', frame[4:20].hex())
print('ciphertext bytes:', len(frame[20:]))
真实输出:
F01 SHA256:fc210b9c83c8915dda47f4c3cc949768f88ad010dac2336003fab35e10fdddf0
file bytes:84
prefix:50 00 00 00
little-endian: 80 actual body:80
big-endian:1342177280
HTTP method prefix:False
IV:7b251c71b41572d56022f75ab0b8e136
ciphertext bytes:64
前四字节为 50 00 00 00。按小端解释是 80,文件剩下的字节数恰好也是 80。按大端解释则是 1,342,177,280,显然不能直接作为这份文件中实际存在的后续字节数。
这还不是对所有消息形式的证明,但足以把这个样本的工作假设定为:
[4 字节小端负载长度][指定长度的负载]
逐份核对其他文件,外层长度关系也能够成立。这个假设的好处在于它容易失败:只要出现一个原始文件,声明长度与实际内容对不上,就要追查截断、多帧拼接、额外尾部,或者协议假设本身。
相比之下,“这是 HTTP 的某种特殊变体”就容易滑向不可证伪。F01 并不以 GET 、POST 或 HEAD 开头,早期调查记录又明确记录了一批 HTTP 自测请求。把自测从输入中移除以后,HTTP 假设已经没有理由继续占据中心位置。
不过,也不能因为这一个样本不是 HTTP,就断言整个恶意程序没有任何 HTTP 路径。它可能包含更新、下载或备用通信逻辑。当前正在解析的消息格式,与整个程序所有网络能力,是两个范围。
这也是写技术文章时很容易漏掉的限定:代码检查了什么,结论就先落在什么范围上。
八、关于“高熵”的一段弯路:64 个字节,凭什么要求它接近 8
未知二进制出现时,计算信息熵是一种常见的观察手段。旧材料里也有类似分析。但我在复盘时特意加了一项小实验,因为这里太容易出现“数值很科学,结论却跳得很远”的情况。
def entropy_caution(ctx):
    data = ctx['f01'][20:]
    counts = collections.Counter(data)
    h = -sum((n/len(data))*math.log2(n/len(data)) for n in counts.values())
print('ciphertext bytes:', len(data))
print('empirical entropy:', f'{h:.6f}', 'bits/byte')
print('sample-size ceiling:', f'{math.log2(min(256,len(data))):.6f}', 'bits/byte')
print('This statistic does not identify AES or distinguish encryption from compression.')
运行结果:
ciphertext bytes: 64
empirical entropy: 5.656250 bits/byte
sample-size ceiling: 6.000000 bits/byte
This statistic does not identify AES or distinguish encryption from compression.
这里只有 64 字节密文。用频数直接估计熵,最多只能观察到 64 种不同符号;即使每个字节都不重复,这种估计的上限也只是 log2(64) = 6,不会达到 8。
所以,拿这份短样本的 5.656250 去套“接近 8 才是加密”的规则,本身就不合适。
更根本的问题是,熵值不能替我们认出 AES。压缩数据也可能看起来杂乱,随机 IV 加上短密文更不适合仅凭统计量推断全部结构。不同算法、不同采样长度和不同消息内容,都可能给出相似的数字。
这一步保留下来的价值是描述输入分布,而不是宣布算法身份。后面真正支撑 AES-CBC 假设的,是明确的候选密钥线索、块长度、严格填充检查,以及解密后能够继续被完整结构解释的数据。
我把这个小实验写出来,是因为它很能说明 AI 辅助分析中的一种风险:模型能够迅速生成“熵很高,所以是某种加密”的顺滑解释,但公式背后的采样前提仍然需要逐项检查。让它打印样本长度和理论上限,比让它再写一段更自信的判断更有用。
九、内存里留下了方向,但方法名没有替我们执行过命令
在流量之外,先前调查保存了一份从内存中提取的映射文件。为了确认本文提到的技术线索不是只存在于报告措辞中,我又对这份文件做了简单的字节搜索。
这里没有加载程序集,没有运行其中的方法,也没有重新附加受感染进程。只是读取文件内容,计算指纹并寻找特定字符串:
"""Read an authorized mapped-memory artifact as bytes; never load or execute it."""
import argparse
import hashlib
from pathlib import Path

def main():
    parser=argparse.ArgumentParser(description=__doc__)
    parser.add_argument('artifact',type=Path)
    args=parser.parse_args()
    data=args.artifact.read_bytes()
print('artifact:',args.artifact.name)
print('bytes:',len(data))
print('sha256:',hashlib.sha256(data).hexdigest())
    offset=data.find(b'BSJB')
print('BSJB offset:',hex(offset) if offset>=0 else 'not found')
for name in ('xClient.Core.Compression','SafeQuickLZ','NetSerializer',
'GetCurrentActiveWindowInfo','GetAccountType',
'HandleGetKeyloggerLogs','HandleGetPasswords'):
print(f'{name}: {name.encode() in data}')

if __name__=='__main__':main()
运行命令与实际输出:
python -B -X utf8 code/memory_markers.py "原件目录/dumped-36678550-mapped.bin"artifact:dumped-36678550-mapped.bin
bytes:1204224
sha256:ef6f0a80cafa10149ec8e26c5b015f1915b80b8fb372fac54050fa445706d267
BSJB offset:0x1d428
xClient.Core.Compression:True
SafeQuickLZ:True
NetSerializer:True
GetCurrentActiveWindowInfo:True
GetAccountType:True
HandleGetKeyloggerLogs:True
HandleGetPasswords:TrueBSJB 标记、命名空间以及 SafeQuickLZ、NetSerializer 等字符串,为下一步查找格式提供了方向。它们与后面原始字节的解释相互吻合,比单纯根据文件扩展名猜测更有价值。
但这段代码只证明相应字节序列出现在这个提取件里。它不是完整的 .NET 元数据解析器,更没有证明每个同名方法都可达、都执行过。
例如 HandleGetPasswords 和 HandleGetKeyloggerLogs 的存在值得警惕,提示程序含有相关功能线索。要进一步写成“密码已经上传”“键盘记录运行了半年”,仍然需要调用、取数、文件或通信证据。即使在技术帖中,这一步也不能用惊悚措辞替代。
另外,GetCurrentActiveWindowInfo 与 GetAccountType 是不同的线索。前者引导我们关注窗口标题,后者指向账户类型相关逻辑。看到一条消息里出现“管理员:”标题,并不能把整个消息首字节也解释成账户权限。这个混淆,在后面的旧解析器里恰好发生了。
十、从 BSJB 到元数据流,把字符串线索再往前推进一步
前文的字节搜索只是方向。要进一步讨论 .NET 程序结构,需要弄清这些名称处在哪一层:它们是普通文本、元数据中的标识符,还是用户字符串堆中的字面量?
内存提取件名为 dumped-36678550-mapped.bin。这个名字提醒我们,它已经是派生文件。磁盘 PE 的原始偏移、映射映像中的 RVA、完整进程转储里的地址,不一定相同。把某个报告给出的 RVA 直接用作另一份文件的偏移,可能会读出零,也可能读到无关数据。
这次离线复核先做一个范围较小、可以重复的检查:定位 BSJB,读取版本串长度和元数据流目录,并确认每个流的边界没有越出当前文件。核心代码如下,完整版本在 code/supplement_audit.py:
off = blob.find(b'BSJB')
assert off >=0
version_len = struct.unpack_from('<I', blob, off+12)[0]
assert 0 < version_len <1024
cursor = off +16 + version_len
_, count = struct.unpack_from('<HH', blob, cursor)
cursor +=4
for _ in range(count):
    relative, size = struct.unpack_from('<II', blob, cursor)
cursor +=8
end = blob.index(0, cursor, cursor+32)
    name =blob[cursor:end].decode('ascii')
cursor = (end+4) &~3
    assert off + relative + size <= len(blob)
真实输出如下。这里的 relative_offset 相对元数据根,不能拿来冒充原始进程虚拟地址:
{
"root_offset":"0x1d428",
"runtime":"v4.0.30319",
"streams":[
{
"name":"#~",
"relative_offset":"0x6c",
"size":82228
},
{
"name":"#Strings",
"relative_offset":"0x141a0",
"size":52376
},
{
"name":"#US",
"relative_offset":"0x20e38",
"size":905140
},
{
"name":"#GUID",
"relative_offset":"0xfddec",
"size":16
},
{
"name":"#Blob",
"relative_offset":"0xfddfc",
"size":19596
}
]
}
这比孤立地发现四个魔数字节多了一层结构支持:版本串可读,流名组成合理,目录能被逐项遍历,所声明的范围位于文件内。但它还不是完整的 CLR 校验器,更没有验证每个方法体都完好。
历史 dnmeta-analysis.md 在这份提取件上记载了程序集 Client、模块 Client.exe,以及 333 个 TypeDef、1,252 个字段、1,978 个方法和 846 条用户字符串。这些数量是历史解析报告的结果;这次离线脚本只复核元数据流目录,没有重新计算所有表行数。
这里有一个很实用的区分:#Strings 常能帮助恢复名称,#US 是查找用户字符串字面量的重要位置;找到 ENCRYPTIONKEY 这个字段名,与找到赋给它的具体值,是两件事。再加上方法体不完整,文本上相邻的两个字符串,也不能自动认定在执行时发生过赋值。
所以,命名空间与方法名适合作为后续定位入口,而不是一张“已经发生全部窃密行为”的清单。HandleGetPasswords 可以让分析转向该处理器,但要证明密码被实际读取并传走,还需调用、数据来源和传输记录。
十一、PreHashKey 给出方向,缺失的初始化方法留下问号
逆向线索在 AES.PreHashKey 这里收拢。散落在字符串里的密码学名称,开始连成一条具体的数据路径。下面是 t7-findings.md 保存的历史反汇编节选:
; xClient.Core.Encryption.AES.PreHashKey, reported RVA 0x11E0C
+001 newobj     System.Security.Cryptography.MD5CryptoServiceProvider::.ctor
+006 stloc.0
+008 ldloc.0
+009 call       System.Text.Encoding::get_UTF8
+00E ldarg.0
+00F callvirt   System.Text.Encoding::GetBytes
+014 callvirt   System.Security.Cryptography.HashAlgorithm::ComputeHash
+019 stsfld     field _key
把这段调用序列翻译成数据关系,就是:参数字符串先变成 UTF-8 字节,再经过 MD5,结果存入 _key。它解释了为什么“数字字符串直接补零”与“先 SHA256 再截断”是不同假设,不能因为都能凑够 16 字节就混为一谈。
但是,追到“输入字符串从哪里来”时,历史材料出现了缺口。settings-cctor.txt 的原始节选为:
=== xClient.Config.Settings..cctor (rva=0x3c5c) ===

--- rva=0x3c5c size=0 ---
这条输出本身只说明该解析路径没有取得有效方法体。历史报告将它解释为对应区域被清零,并注明:配置字段的初始化关系部分依据 #US 堆中的字面量顺序推定。因而不能把 Settings.ENCRYPTIONKEY = "6153" 写得像从完好静态构造函数直接反编译出来的一行源码。
但这个缺口没有让工作停下。另一条验证路线可以独立成立:取候选字节 b"6153",按 MD5 派生,把结果用于保存的原始通信帧;随后检查 PKCS7、压缩层长度、序列化长度与完整消费。接下来的 23 份输入核验,正是沿着这条路线继续收紧条件。
因此结论可以分成两层:MD5(b"6153") 是这批记录已验证可用的解密密钥;而“某个初始化方法如何把它写入某个字段”,仍应保留历史映像缺失和推断成分。这种分层告诉下一位分析者,哪块已经能站住,哪块还值得补。
至于 xClient、NetSerializer、SafeQuickLZ 等名称,可以用来寻找代码血缘。它们不能单独证明某个家族“独有”,更不能跨越工具来源、二次修改与部署者之间的差别,直接认定操作者。“银狐”曾出现在早期分析的归因判断里,但现有材料还不足以把这个名称写成已经确认的操作者身份。技术结构可以逐字节核查,归因还需要更多独立证据。
十二、密钥为什么是四位数字:先保留来源,再对派生方式做对照
6153 这个字符串看起来很普通。它不像一段复杂口令,也不像某种编码后的长密钥;如果只按外观筛选,很容易把它当成端口、计数或者配置编号略过。
内存分析留下了这个字面量和 MD5 派生线索。配置赋值与 IL 调用链存在前述缺口,因此接下来换一个验证方向:把候选带回原始帧,检查它能否同时满足解密、压缩与序列化的约束。
四个字符为什么不能直接当作 key?这个问题值得做一次对照实验。下面比较三种派生方式,其中两个错误候选专门为实验构造,并非历史穷举字典的完整重放:
def candidates(ctx):
    choices = {'MD5(6153)': hashlib.md5(b'6153').digest(),
'SHA256(6153)[:16]': hashlib.sha256(b'6153').digest()[:16],
'UTF8(6153).ljust(16,0)': b'6153'.ljust(16,b'\0')}
for label,key in choices.items():
        passed=0
for _,blob in ctx['frames']:
try:
                plaintext(blob,key)
                passed+=1
except ValueError:
pass
print(f'{label}: PKCS7 {passed}/{len(ctx["frames"])}')
print('selected key hex:', KEY.hex())
辅助函数 plaintext() 会检查 PKCS7 的每一个填充字节,而不只是看最后一个字节是否落在 1 到 16 之间。
它的关键实现为:
def plaintext(frame, key=KEY):
    padded = AES.new(key, AES.MODE_CBC, frame[4:20]).decrypt(frame[20:])
    n = padded[-1]
if not (1 <= n <= 16 and padded[-n:] == bytes([n])*n):
raise ValueError('invalid PKCS7')
return padded[:-n], n
实际输出:
MD5(6153): PKCS7 23/23
SHA256(6153)[:16]: PKCS7 0/23
UTF8(6153).ljust(16,0): PKCS7 0/23
selected key hex: a4d5fad84ee90c1308cc37b52135d5db
直接把四字节 UTF-8 字符串交给 AES 会遇到密钥长度问题;表中的第三种方法为了形成可测试的 16 字节错误候选,特意用零补齐。这样失败的含义是“这个候选解不开当前样本”,而不是“根本没有建立合法长度的 AES 实例”。
这里也不能把 23/23 当成 23 次彼此独立的密码学证明。文件中有重复,消息之间也可能存在结构关联。PKCS7 通过只是筛选条件,后面还必须检查 QuickLZ 和字符串结构。一个偶然符合填充规则的错误明文,未必能继续通过这些检查。
在这批文件上,MD5 派生得到的 16 字节 key 可以让全部输入继续走完后续核验。这才使它从“报告里的一条线索”,变成“有原始数据支撑的解释”。
十三、AES 解开了,为什么 UTF-8 还在偏移 12 处报错
终于到了一个很容易让人兴奋的节点:密钥能够工作,填充也通过了。
对 F01 进一步打印,我们得到:
ciphertext bytes:64
padding value:11
padding hex:0b 0b 0b 0b 0b 0b 0b 0b 0b 0b 0b
un-padded bytes:53
plaintext hex:4f 35000000240000000000008028050230e58886030251510b06306d732fe8b685e697b60c05e69caae799bb00000080e5bd9554 47
direct UTF-8: rejected at offset 12:invalid start byte
先把长度账算一遍:
53 字节解密内容 + 11 字节 PKCS7 = 64 字节填充后数据(4 个 AES 分组)
16 字节 IV + 64 字节密文       = 80 字节负载
4 字节外层长度 + 80 字节负载   = 84 字节原始文件
但是,把去填充后的 53 字节直接按 UTF-8 解码,仍然失败,位置在零基偏移 12,也就是从头数的第 13 个字节。
一个自然的怀疑是:密钥不对,前面只是碰巧通过填充。这个怀疑应该保留,但不应成为唯一方向。密码学里的“明文”只是加密前的字节序列,它完全可以是一段压缩数据、二进制对象或者另一层协议,并不承诺它直接是人类可读文本。
观察这 53 字节,已经可以在中间看到一些可读片段:QQ、0ms/,以及中文的 UTF-8 字节。它们之间又夹着少量无法解释的控制字节。
这就是最容易开始打补丁的时候。把 .decode("utf-8") 改成 .decode("utf-8", "replace"),输出会变得友好;遇到几个不认识的字节就跳过去,后面的中文甚至可能重新连上。
可读性会提高,证据质量却未必提高。原本的异常告诉我们“这里还有一层没有处理”,宽容解码则可能把异常揉成替换字符,让人误以为只剩一点显示问题。
所以这里保留严格解码,让错误原样出现。偏移 12 处的报错不是一个要被消音的麻烦,它是下一层结构留给我们的路标。
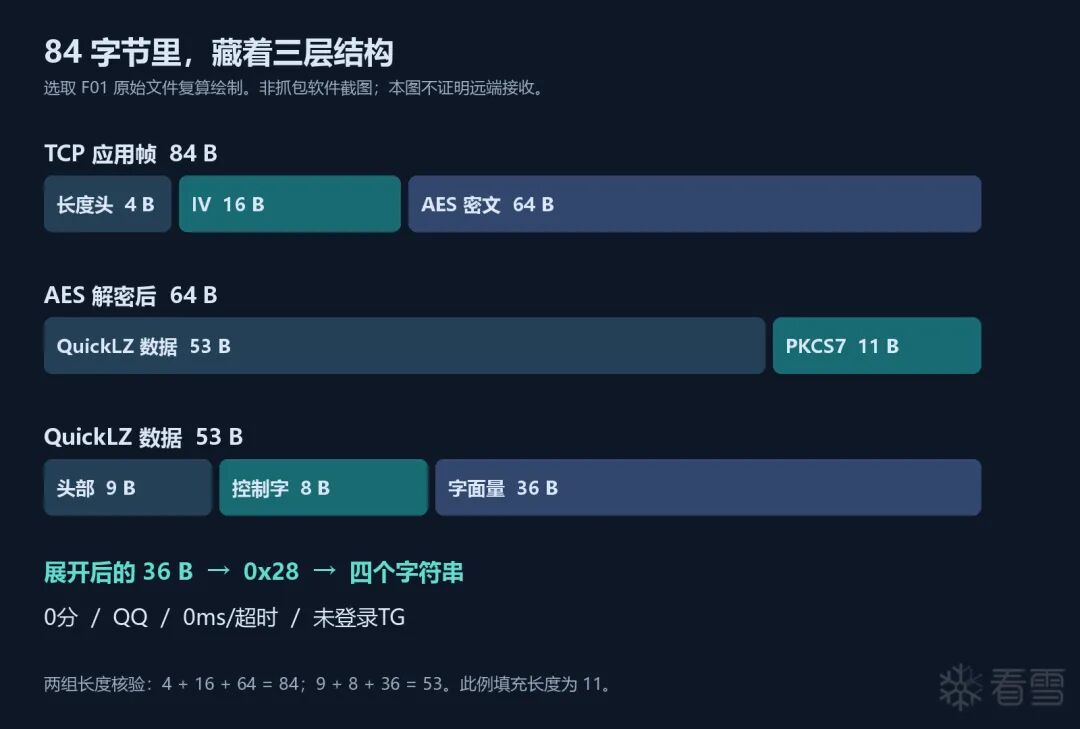
依据 F01 字节复算绘制,不是抓包软件截图。
十四、真正的转折:旧测试打印了 EXACT,却没有检查它声称的含义
旧版协议脚本把 AES 明文的头部解释成这样:
[1 字节消息类型][4 字节明文总长][4 字节字段流长][字段流]
同时,它允许字段流里出现 00 00 00 80,把它当成空值占位。其回归通过条件的核心是:
clean = all(f["type"] in ("null", "field") for f in fields)
consumed = sum(field_sizes)
exact = consumed == body_len
这里引用的是旧代码的判断思想,变量名在节选中做了简化;原版完整逻辑在既有 dcrat.py 的 verify() 内。我们没有把那个带构造和运行入口的脚本重新启动,而是单独编写了这一通过条件的最小复现,只给它 F01。
复现代码见附件 old_gate_demo()。它保留了旧解析的关键动作:遇到四字节标记就跳过,否则按 UTF-8 首字节估计步长,用 UTF-16 单元数累加到声明值,并在结尾比较总消费字节数。
运行结果就是开头那段矛盾的来源:
minimal reproduction of OLD acceptance logic
row kinds: ['null', 'field', 'field', 'null', 'field']
clean: True consumed: 44 body_len: 44
old EXACT: True
declared payload: 36 actual bytes after 9-byte header: 44
old header interpretation consistent: False
它把数据归成了五段:空值、字段、字段、空值、字段。段的字节数加起来,确实消费了 44 字节,所以 EXACT 为真。
然而头部里那个被它称为“字段流长”的数字是 36,而头部之后实际还有 44 字节。旧通过条件没有把这个矛盾纳入失败条件,更没有独立检查四个业务字符串是否被正确恢复。
于是,“走到了缓冲区末尾”被包装成了“协议逐字段确证”。
这是本案最值得记住的一次踩坑。一个解析循环,只要每次都往前移动,最终就有机会走到末尾。即使分段错了、类型错了、字段语义错了,也可能得到一个非常整齐的消费总数。
这个问题不能通过再加几句 print("PASS") 解决。应该先明确什么叫正确,再把正确性的条件写进去:所有声明长度怎么对应,字符串编码是否严格有效,字段数量是否符合观察,数据结束时是否恰好读完,以及原始消息是否支持这套解释。
AI 可以很快补出一个测试函数,也可以很快给它起一个“权威验证”的名字。测试的名字没有权威性;决定它价值的,是失败条件。
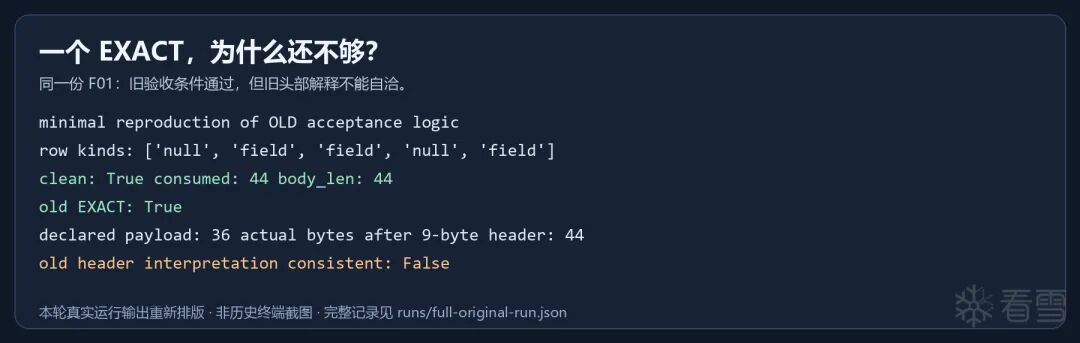
上图由离线复核的实际输出重新排版,原始文本保存在附件日志中,并非历史终端截图。
十五、0x4F 的“管理员身份”,被同一个样本集推翻了
旧解释还给两个首字节分配了鲜明的语义:
0x4E = 普通会话
0x4F = 管理员会话
它之所以显得可信,是因为某些 0x4F 帧中恰好出现了“管理员:”字样。如果只挑这几份输入观察,标志和标题很容易形成一种假相关。
这次离线复核把全部输入逐份解析,再打印白名单中的通用窗口标题。个人浏览标题不进入输出。
下面是程序实际找到的反例:
frame-20260920-191756-179-c1-46165.bin: 0x4f title='QQ'
frame-20260920-192020-661-c4-f0-46545.bin: 0x4f title='管理员: C:\\Windows\\system32\\cmd.exe'
frame-20260920-192828-667-c14-f0-65042.bin: 0x4e title='管理员: C:\\Windows\\system32\\cmd.exe'
frame-20260920-193101-167-c23-f0-9206.bin: 0x4f title='ChatGPT'
flags by file: {'0x4e': 15, '0x4f': 8}
这组输出应该怎样理解?
0x4F 可以对应 QQ,也可以对应 ChatGPT;0x4E 则能对应带“管理员:”的命令提示符标题。因此,原解释中“某标志专属某类标题”的对应关系不能成立。
这里还要再收紧一步:窗口标题本身也不是安全令牌证明。某个程序叫自己“管理员”,不等于进程真的提升了权限。任务配置、令牌信息和进程身份应该由相应证据回答,不应让一段标题文本代劳。
对照字节结构,0x4E 和 0x4F 只差最低位;内存提取件中又能找到 SafeQuickLZ。把它们放回 QuickLZ 长头解释,多个现象同时有了位置:
0x4E = 0100 1110
0x4F = 0100 1111
^ 最低位表示是否压缩

4F             标志
35 00 00 00    存储长度 53
24 00 00 00    展开长度 36
这与 QuickLZ 格式说明相符。对这份样本,标志、两个长度字段、控制字和后续文字都可以在同一个结构下解释,不需要为“管理员消息”额外发明一套分隔规则。
这时假设的质量就发生了变化:它不仅能解释几个好看的字符串,还预测了下一步应该消费多少字节、产生多少字节。
十六、四个字节怎样把中文截成两半:控制字的实际偏移
00 00 00 80 是整个过程里最像“特殊业务标记”的东西。
它数值醒目,出现位置又很别扭。按小端整数读出来是 0x80000000。如果已经认定自己拿到的是 .NET 字符串列表,很容易联想到特殊值、空值、分隔符,甚至 int.MinValue。
但在本批压缩数据里,它是 QuickLZ 的控制字。
下面这个函数特意把每次读取控制字时的输入偏移和已经生成的输出长度打印出来。它不是完整解压器,只处理本批实际观察到的 literal-only 情况:
def control_trace(ctx):
    pt,_=plaintext(ctx['f01'])
    stored,expanded=struct.unpack_from('<II',pt,1)
    print(f'flags={pt[0]:#04x} stored={stored} expanded={expanded}')
    pos=9;control=1;out=bytearray();control_offsets=[]
while len(out)<expanded:
if control==1:
            control=struct.unpack_from('<I',pt,pos)[0]
            print(f'control @input+0x{pos:02x}: 0x{control:08x}; output={len(out)}')
            control_offsets.append(pos);pos+=4
if control&1:raise ValueError('match token unsupported')
out.append(pt[pos]);pos+=1;control>>=1
    print('control words:',len(control_offsets),'control bytes:',4*len(control_offsets))
    print('expanded bytes:',len(out),'consumed input:',pos)
    print('expanded hex:',out.hex(' '))
assert bytes(out)==quicklz_observed(pt)
实际响应:
flags=0x4f stored=53 expanded=36
control @input+0x09: 0x80000000; output=0
control @input+0x2c: 0x80000000; output=31
control words: 2 control bytes: 8
expanded bytes: 36 consumed input: 53
expanded hex: 28 05 02 30 e5 88 86 03 02 51 51 0b 06 30 6d 73 2f e8 b6 85 e6 97 b6 0c 05 e6 9c aa e7 99 bb e5 bd 95 54 47
第一次在输入偏移 0x09 读取控制字,此时输出为 0。接着复制 31 个字面量。第二次在输入偏移 0x2C 读取控制字,此时已经输出 31 字节,再复制剩下 5 字节。
所以,53 字节的内容可以逐项写成:
9 字节头部
+ 4 字节控制字 + 31 字节字面量
+ 4 字节控制字 +  5 字节字面量
= 53 字节
展开以后留下 36 字节,两个控制字正好贡献了多出来的 8 字节。前面那组 36 对 44 的矛盾,就在这里得到解释:旧解析器把压缩体长度和展开后的长度混在了一起。
注意,压缩层按字节组织数据,它没有义务照顾上层 UTF-8 的字符边界。控制字可以出现在一个中文字符串中间,甚至出现在某个多字节字符的字节序列之间。只有把这一层还原掉,才轮到字符串解码器工作。
这比“看到标记就删四字节”多做了一件关键的事:它解释了标记为什么出现在那里、应当消耗多少控制位、接下来生成多少数据。
附带核验器遇到需要回拷匹配串的 QuickLZ token 会明确报不支持。23 个文件能够通过,说明它覆盖了当前观察到的输入,不意味着已经实现 QuickLZ 的全部编码形式。这一范围会被后面的负向测试专门验证。
十七、压缩层拆掉之后,字符串仍然能把你再绊一次
拿到展开数据以后,最前面的字节已经干净得多:
28
05 02 30 E5 88 86
03 02 51 51
0B 06 30 6D 73 2F E8 B6 85 E6 97 B6
0C 05 E6 9C AA E7 99 BB E5 BD 95 54 47
如果继续沿用“tag + 字节长度 + 内容”,第一项就会出问题。
这次离线复核写了一个故意按照这个错误假设读取的函数。它不是用来分析所有协议的通用失败示例,就是拿 F01 的前几个字节做一件具体的事:把 05 当 tag,把 02 当后续内容的字节长度。
def naive_string(ctx):
    pt,_=plaintext(ctx['f01']);raw=quicklz_observed(pt)
    tag,declared=raw[1:3]
    wrong_slice=raw[3:3+declared]
print(f'naive [tag][byte length]: tag=0x{tag:02x}, length={declared}')
print('naive content bytes:',wrong_slice.hex(' '))
try:
print(wrong_slice.decode('utf-8',errors='strict'))
except UnicodeDecodeError as error:
print('UTF-8 error:',error.reason)
print('first real string UTF-8:', '0分'.encode().hex(' '))
print('byte count:',len('0分'.encode()),'UTF-16 units:',len('0分'.encode('utf-16-le'))//2)
输出如下:
naive [tag][byte length]: tag=0x05, length=2
naive content bytes: 30 e5
UTF-8 error: unexpected end of data
first real string UTF-8: 30 e5 88 86
byte count: 4 UTF-16 units: 2
它拿到的是 30 E5。30 是 ASCII 的 0,E5 则只是后面一个三字节 UTF-8 字符的开头。字符串被截断,严格解码器毫不含糊地报了 unexpected end of data。
真实的“0分”是 30 E5 88 86,占 4 个 UTF-8 字节、2 个 UTF-16 码元。这里的两个前缀字段表达的不是类型和内容长度,而是两种编码尺度下的长度信息:
varuint(UTF-8 字节数 + 1)
varuint(UTF-16 码元数)
UTF-8 编码内容
因此 05 02 的含义是 4+1 和 2。继续读下去,03 02 对应 QQ,0B 06 对应 0ms/超时,0C 05 对应 未登录TG。
旧解析为什么在 ASCII 路径上看起来顺畅?因为 ASCII 的字节数与 UTF-16 码元数相同。某些错误假设在英语路径上能够得到正确的表面结果,直到遇到中文才开始露出缝隙。只用同一类数据测试解析器,恰好会把这种缝隙藏起来。
另一个容易被忽略的细节是 Python 的 len(str) 和 .NET 的字符串长度不总相同。对于非 BMP 字符,UTF-16 使用代理对;一个可见字符可能占两个 UTF-16 码元。附带测试因此加入了一个非 BMP 字符,避免“处理中文没问题”被误当成“处理所有 Unicode 都没问题”。
这一编码结构与 NetSerializer 的字符串实现相符。+1 也有用途:0 可以表达 null,1 可以表达空串,非空字符串再携带字节数加 1 和字符长度。真实 F01 是四个非空串;null 与空串分支是在人工测试中检查的,不能说本案数据出现过它们。
十八、把四个字符串的起止位置打印出来,解析才算有了落脚点
到这里,已经可以读出文字。但我仍然希望看见边界。
给每个字段打印起止偏移、两个长度和解码后的文本,能够把“我觉得它像四个字符串”变成一份很容易人工检查的记录。下面的显示函数专门用于 F01,它的四个长度前缀都是单字节;真正的核验器另有完整的变长整数读取逻辑。
def string_trace(ctx):
    pt,_=plaintext(ctx['f01']);raw=quicklz_observed(pt);pos=1
print(f'message=0x{raw[0]:02x}, expanded bytes={len(raw)}')
# These four selected original strings have single-byte length varints.
# The full verifier handles multi-byte varints; this is an offset display.
for index in range(4):
        start=pos;encoded_count,units=raw[pos:pos+2];pos+=2
        count=encoded_count-1;value=raw[pos:pos+count].decode('utf-8');pos+=count
print(f'field{index}: [{start:02d},{pos:02d}) prefix={encoded_count:02x}{units:02x} utf8={count} utf16={units} value={value!r}')
print('consumed:',pos,'remaining:',len(raw)-pos)
assert strings_observed(raw)[1]==['0分','QQ','0ms/超时','未登录TG']
真实输出:
message=0x28, expanded bytes=36
field0: [01,07) prefix=05 02 utf8=4 utf16=2 value='0分'
field1: [07,11) prefix=03 02 utf8=2 utf16=2 value='QQ'
field2: [11,23) prefix=0b 06 utf8=10 utf16=6 value='0ms/超时'
field3: [23,36) prefix=0c 05 utf8=11 utf16=5 value='未登录TG'
consumed:36 remaining: 0
这次的 36 字节是可以从头走到尾的:消息编号占第 0 字节,四个字符串依次覆盖 [1,7)、[7,11)、[11,23)、[23,36)。尾部没有剩余字节,也没有依赖猜测跳过某段内容。
这里的消息编号 0x28 是观察到的结构值。它对应服务端类型注册表里的哪个完整类名、其他编号如何分配,不应该只凭这一条消息硬填出来。四个字符串的字面值已经确定,但第一项“0分”究竟表示会话在线时长、空闲时间还是别的计时,仍需进一步追踪产生这个字段的代码。
这种停下来的能力很重要。逆向做到一个能闭合的结构,常常会激起把所有字段一次命名完的冲动;AI 尤其擅长把半张表补成一张整齐的表。可是不知道一个字段的精确业务语义,并不会抹掉已经验证的偏移和编码。
相反,把未知保留在正确的位置,下一位分析者才能继续往前走。
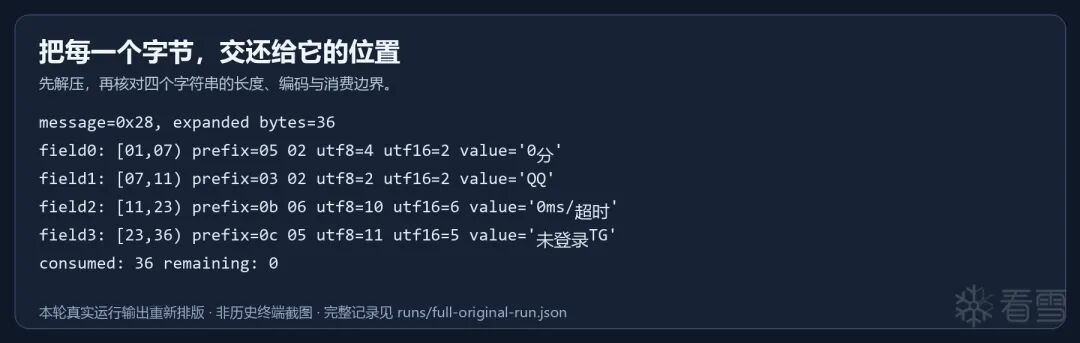
上图由这次离线复核输出重新排版。字段起止位置可以与 F01 的解密、展开结果逐一对照。
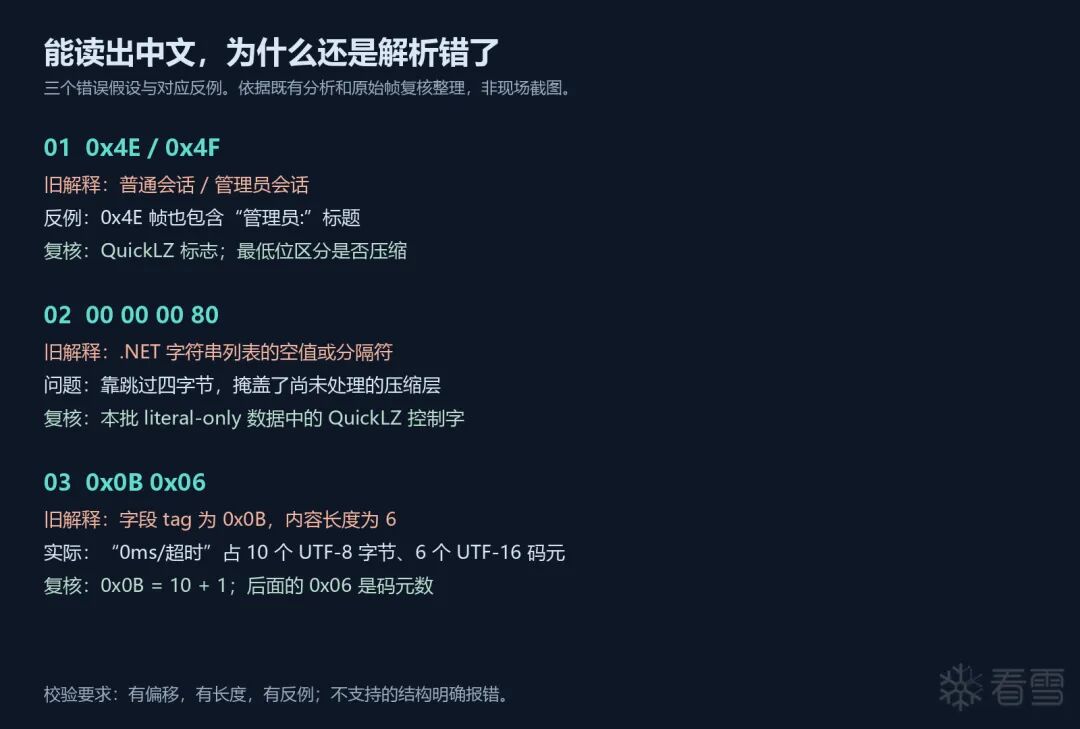
依据原始字节与离线复算结果整理,展示分析中被推翻的解释;不是历史终端截图。
十九、另一个陷阱:自己加密,再自己解密,通过了能说明多少
旧版脚本还提供了一种很常见的自测:先构造消息,再加密,再解密,最后检查恢复的数据是否等于构造的数据。
这个测试能验证一些实现细节,比如 AES 调用、IV 拼接和填充是否自洽。它的问题在于,很容易被赋予自己没有验证的含义。
我为文章专门做了一个人工反例:给一段根本不是合法协议的文本加密,再解密。
def roundtrip_trap(ctx):
# Deliberately malformed synthetic plaintext can still pass crypto roundtrip.
    malformed=b'THIS IS NOT A VALID PROTOCOL RECORD'
    frame=encrypt_fixture(malformed,bytes(16))
    restored,_=plaintext(frame)
print('AES encrypt/decrypt roundtrip:',restored==malformed)
try:decode_frame(frame)
except ValueError as error:print('protocol verifier:',str(error))
else:raise AssertionError('malformed protocol accepted')
实际运行:
AES encrypt/decrypt roundtrip:True
protocol verifier:unsupported QuickLZ header
第一行是 True,第二行拒绝了它。
这并不矛盾。加密和解密函数忠实地往返了输入字节,协议验证器则发现输入压根不符合 QuickLZ 头部。
也就是说,即使构造器完全想错了业务协议,AES 往返仍然可以稳定通过。甚至解析器和构造器共享同一个错误时,两者之间的回归也可能显得十分和谐。
要检查和真实协议的兼容性,就需要真实原始数据、独立约束以及最好来自不同方向的依据。这里使用的是原始帧的长度关系、公开压缩格式、序列化结构和针对错误输入的测试,而不是只让两个自己写的函数互相证明。
AI 帮忙写测试时,同样需要把这两件事说清楚:“这个函数是否能把自己的输入往返恢复”,与“这个函数是否正确实现外部协议”,测试目标不同。让它多生成十组往返样本,不能弥补目标定义的偏差。
二十、接下来故意把数据弄坏,看它是否还在满屏报成功
一个解析器面对正确输入输出正确结果,当然是好事。但安全分析里的输入并不友善:可能截断、缺字段、长度谎报,也可能只是我们当前还没实现的另一种编码形式。
这次的负向检查没有修改任何原始帧。所有破坏性输入都由人工数据构造,包含以下几类:
给 QuickLZ 记录追加一个字节,让存储长度与实际长度不一致; 在控制字里设置匹配位,确认 literal-only 实现会拒绝; 截断字符串; 把消息编号从 0x28改为尚未支持的0x29;在合法字符串序列后追加多余字节; 截断外层帧; 制造严格 PKCS7 不接受的填充。
此外还检查两类标志、超过 127 字节的变长长度、非 BMP 字符,以及 null 和空串。
真正执行这些检查的函数如下。这里保留完整测试列表,读者可以看到每个错误到底是怎样制造的:
def negative_tests(ctx):
    fields=['0分','SYNTHETIC  '+('A'*140),'0ms/超时','未登录TG']
    raw=serialized(fields)
for flag in (0x4e,0x4f):
        frame=encrypt_fixture(compressed_record(raw,flag),bytes([flag])*16)
if decode_frame(frame)['fields']!=fields:raise AssertionError('roundtrip')
print(f'PASS synthetic flag=0x{flag:02x}: multi-byte lengths + non-BMP Unicode')
if strings_observed(serialized([None,'','A','B']))[1]!=[None,'','A','B']:
raise AssertionError('null/empty')
print('PASS synthetic null + empty string')
    record=compressed_record(raw,0x4e);compressed=compressed_record(raw,0x4f)
    bad_padding=struct.pack('<I',32)+bytes(16)+AES.new(KEY,AES.MODE_CBC,bytes(16)).encrypt(bytes(16))
    checks=[('stored-length mismatch',quicklz_observed,record+b'X'),
            ('unsupported match token',quicklz_observed,compressed[:9]+struct.pack('<I',0x80000001)+compressed[13:]),
            ('truncated string',strings_observed,raw[:-1]),
            ('unknown message',strings_observed,b'\x29'+raw[1:]),
            ('trailing byte',strings_observed,raw+b'\x00'),
            ('outer truncation',decode_frame,frame[:-1]),
            ('invalid PKCS7',decode_frame,bad_padding)]
for name,fn,data in checks:
try:fn(data)
except (ValueError,UnicodeError) as error:print(f'REJECT {name}: {error}')
else:raise AssertionError('bad data accepted: '+name)
运行响应:
PASS synthetic flag=0x4e: multi-byte lengths + non-BMP Unicode
PASS synthetic flag=0x4f: multi-byte lengths + non-BMP Unicode
PASS synthetic null +empty string
REJECT stored-length mismatch: QuickLZ stored size mismatch
REJECT unsupported match token: unsupported QuickLZ match token
REJECT truncated string: truncated string
REJECT unknown message: unsupported message number
REJECT trailing byte: trailing fields or bytes
REJECT outer truncation: outer length mismatch
REJECT invalid PKCS7: invalid PKCS7我很在意第二条拒绝:unsupported QuickLZ match token。它说明核验器没有为了漂亮的通过率,悄悄把尚未实现的输入当成某种近似结构继续处理。
这里的 REJECT 也不都代表数据恶意。例如未知消息编号可能是合法协议的其他类型,匹配 token 可能只是普通 QuickLZ 压缩结果。核验器表达的是自己的能力范围:我不能按当前模型验证它,所以不把它算进成功。
正向和负向测试解决的仍然只是这些明确列出的条件,并非通用安全审计。它们不能证明代码绝无 bug,也不能证明不存在另一种恰好符合结构的解释。但相较于“最终指针到了末尾”,它们已经把失败边界写得具体得多。
如果让 AI 协助补测试,我会要求它优先寻找能让当前模型难堪的输入。能把错误拒绝得清楚,往往比多打印几行成功更值得写进文章。
二十一、最后才把整个目录交给它
单条记录解释通了,人工失败样本也按预期被拒绝,才回到全部原始帧。
批量函数没有把私人字段值写进响应,只保留文件名、长度、QuickLZ 标志、存储和展开大小以及字段数量:
def batch(ctx):
    passed=0
for name,frame in ctx['frames']:
        result=decode_frame(frame);passed+=1
print(f'OK {name} bytes={len(frame)} qlz={result["quicklz_flag"]} stored={result["stored_size"]} expanded={result["expanded_size"]} fields={result["field_count"]}')
print(f'PASS {passed}/{len(ctx["frames"])} files; no private field values printed')
以下为这次离线复核 23 个文件的完整结构输出:
OK frame-20260920-191756-179-c1-46165.bin bytes=84 qlz=0x4f stored=53 expanded=36 fields=4
OK frame-20260920-192020-661-c4-f0-46545.bin bytes=116 qlz=0x4f stored=93 expanded=72 fields=4
OK frame-20260920-192028-675-c4-46545.bin bytes=116 qlz=0x4f stored=93 expanded=72 fields=4
OK frame-20260920-192253-158-c13-f0-46916.bin bytes=116 qlz=0x4f stored=93 expanded=72 fields=4
OK frame-20260920-192301-160-c13-46916.bin bytes=116 qlz=0x4f stored=93 expanded=72 fields=4
OK frame-20260920-192455-163-c1-f0-53343.bin bytes=100 qlz=0x4e stored=70 expanded=61 fields=4
OK frame-20260920-192525-674-c3-f0-55164.bin bytes=100 qlz=0x4e stored=70 expanded=61 fields=4
OK frame-20260920-192828-667-c14-f0-65042.bin bytes=116 qlz=0x4e stored=82 expanded=73 fields=4
OK frame-20260920-193101-167-c23-f0-9206.bin bytes=84 qlz=0x4f stored=58 expanded=41 fields=4
OK frame-20260920-193404-165-c34-f0-19419.bin bytes=84 qlz=0x4f stored=53 expanded=36 fields=4
OK frame-20260920-193636-669-c43-f0-27876.bin bytes=148 qlz=0x4e stored=122 expanded=113 fields=4
OK frame-20260920-193939-663-c54-f0-38080.bin bytes=148 qlz=0x4e stored=122 expanded=113 fields=4
OK frame-20260920-194541-682-c71-f0-58282.bin bytes=148 qlz=0x4e stored=122 expanded=113 fields=4
OK frame-20260920-194814-162-c80-f0-2150.bin bytes=148 qlz=0x4e stored=122 expanded=113 fields=4
OK frame-20260920-195117-172-c91-f0-4089.bin bytes=132 qlz=0x4e stored=104 expanded=95 fields=4
OK frame-20260920-195349-668-c100-f0-4419.bin bytes=148 qlz=0x4e stored=122 expanded=113 fields=4
OK frame-20260920-195622-169-c109-f0-4823.bin bytes=148 qlz=0x4e stored=126 expanded=117 fields=4
OK frame-20260920-195925-164-c120-f0-5524.bin bytes=148 qlz=0x4e stored=122 expanded=113 fields=4
OK frame-20260920-200228-166-c131-f0-5922.bin bytes=180 qlz=0x4e stored=151 expanded=142 fields=4
OK frame-20260920-200500-668-c140-f0-6284.bin bytes=132 qlz=0x4e stored=102 expanded=93 fields=4
OK frame-20260920-200803-673-c151-f0-6710.bin bytes=148 qlz=0x4e stored=126 expanded=117 fields=4
OK frame-20260920-201036-164-c160-f0-7104.bin bytes=84 qlz=0x4f stored=53 expanded=36 fields=4
OK frame-20260920-201339-164-c171-f0-7524.bin bytes=148 qlz=0x4e stored=126 expanded=117 fields=4
PASS 23/23 files; no private field values printed
按文件统计,其中 15 份标志是 0x4E,8 份是 0x4F;重复的两组位于 0x4F 文件中。再次强调,统计口径是文件,不是独立会话,也不是外泄次数。
这次核验可以支持的结论是:这 23 个文件符合当前支持的外层、AES-CBC/PKCS7、QuickLZ 和四字符串结构。它们经哈希去重后是 21 份内容。
它不能替我们证明所有远控指令都已还原,更不能证明攻击者服务端已经收到这些内容。真实数据是在本地沉洞环境中接收的,日志明确记录了本地监听;这是受感染程序产生消息、调查端保存消息的证据,不是境外收件箱的镜像。
这批标题记录也不等于完整键盘输入。有些网页或会话会把部分文本放进标题,因而窗口标题里出现熟悉的字句并不奇怪。它足以说明窗口信息被采集,却不足以推导所有密码、文档正文和 Telegram 会话文件都被获取。
“窗口标题泄露风险”已经是一件严肃的事,不需要夸张成“全盘内容全部沦陷”才显得重要。技术文章的冲击力,完全可以来自每一步都算得上的细节。
二十二、端口看起来全开,先怀疑测量工具
本机的字节逐渐有了含义,远端却仍像隔着一层雾。调查记录中还有一条向外延伸的支线:服务识别、页面探测和认证尝试。
这条支线没有取得远端 shell、管理权限或受害者数据库。它留下的是一系列响应,以及几次被对照实验推翻的判断。下面沿着保存的日志复盘这些过程;离线复核期间没有重新连接目标。
第一个转折甚至不是目标服务器给出的,而是代理。早期扫描看见大量“连接成功”,很容易顺着这个信号画出一张服务丰富的网络地图。
但 recon/05-proxy-rootcause.txt 保留了如下对照:
192.0.2.1        BND.ADDR=b'\x7f\x00\x00\x01\x1e\xfc' rep=b'\x05\x00\x00\x01' atyp=1 dt=0.016
203.0.113.9      BND.ADDR=b'\x7f\x00\x00\x01\x1e\xfc' rep=b'\x05\x00\x00\x01' atyp=1 dt=0.000
198.51.100.7     BND.ADDR=b'\x7f\x00\x00\x01\x1e\xfc' rep=b'\x05\x00\x00\x01' atyp=1 dt=0.000
240.0.0.1        BND.ADDR=b'\x7f\x00\x00\x01\x1e\xfc' rep=b'\x05\x00\x00\x01' atyp=1 dt=0.000
255.255.255.255  BND.ADDR=b'\x7f\x00\x00\x01\x1e\xfc' rep=b'\x05\x00\x00\x01' atyp=1 dt=0.000
这组结果让“成功”本身变得可疑:不同对照地址得到了几乎一样的代理答复和极短耗时。此时,如果扫描器把 SOCKS 代理答复成功直接记成目标端口开放,最终统计的可能是代理接受了多少请求,而不是远端真的接收了多少连接。
需要区分的至少有四层:本机连上代理、代理接受连接请求、代理到目标的链路建立、目标应用返回可辨认的数据。上一层的成功不能代替下一层。尤其是先答复再拨号,或者中间设备合成响应时,只有一个“connected”字符串远远不够。
这个坑与前文的 EXACT 很像:工具证明了一个比读者想象中更窄的条件。错误出现在我们擅自扩大了它的含义。因此,早期调查记录中的开放端口列表不能脱离路径和响应判据单独引用。失败实验值得写进帖子,因为它让读者知道,第一张漂亮的扫描结果是如何被放弃的。
二十三、548 字节的神秘页面,最后只多了六段填充
另一个看起来很有故事感的异常发生在 /kk3/。不同 User-Agent 对应的响应体长度不一样:有时 146 字节,有时 548 字节。站在已知有恶意样本的背景下,很容易把它解释为面板分流、反爬策略或隐藏入口。
但 recon/panel/L1-run-548.txt 留下了更细的历史对照:
  ① 不发 UA                                  404  body=146   msie_padding块=0  UA长度=0
  ③ 仅含 MSIE                                404  body=548   msie_padding块=6  UA长度=34
  ⑧ 现代 Firefox119                          404  body=146   msie_padding块=0  UA长度=70
  ⑩ curl                                   404  body=146   msie_padding块=0  UA长度=10
  不发 UA                                    200  body=138   msie_padding块=0  UA长度=0
注意最后一行属于 / 的对照,不应混入 /kk3/ 分组。保存日志同时记录了填充块数量;长度关系也吻合早期调查记录对错误页填充的解释:
548 - 146 = 402
402 / 6 = 67
这里是对历史数值的复算,不是新的网络响应。差异可以由六段固定长度的填充解释,已经不需要先假设“进入了隐藏后台”。填充不是后台功能,错误页变大也不是认证绕过。
相邻的 corroboration.txt 又记录了任意 Host 值的结果:
Host=this-host-does-not-exist-zzzzz   HTTP 200 138B sha=301bd9f16f94feed
Host=a                                HTTP 200 138B sha=301bd9f16f94feed
原记录中的 sha 是摘要前缀,不是完整 SHA256。另有站点对照取得了不同页面,说明那次测量并非只能读到一张固定本地页面。但这些材料仍只支持“已测试的请求收到相同默认响应”,不支持穷尽式结论“这台机器根本不存在目标虚拟主机”。
从 404 的页面里找出线索很容易,证明它超出了通用错误处理却困难得多。这里最有用的收获不是隐藏路径,而是把状态行、响应头、正文长度、正文内容及路径分组放在一起看。即便遇到 HTTP 200 搭配正文标题 404 Not Found,也要各自记录,不能只选其中一个解释整个响应。
二十四、WinRM 给了响应,但没有给权限
recon/l2/04-winrm-fingerprint.txt 中,2026-09-21 的历史记录包含以下请求与响应节选。这里只摘取协议字段,未重新发送请求:
OPTIONS /wsman
HTTP/1.1 405
Allow: POST
Server: Microsoft-HTTPAPI/2.0

POST /wsman (no auth)
HTTP/1.1 401
Server: Microsoft-HTTPAPI/2.0
WWW-Authenticate: Negotiate
405 配合 Allow: POST,可以帮助理解该请求被怎样处理;401 配合认证头,说明这次访问遇到了认证要求。它们不是登录成功,更不是命令执行证明。响应头提供了服务识别线索,也不能单独保证头部背后一定是某个未修改的实现。
调查随后进入了认证尝试阶段。这已经属于主动操作,必须与前面的文件分析、历史日志复核区分开来。这里对保存的日志做离线计数,认证工具及候选口令列表没有随文公开。
统计代码的核心只有三项:
attempt_lines = len(re.findall(r'\battempt\s+\d+', auth))
rejected_credentials_lines = auth.count('InvalidCredentialsError:')
result = next(l.strip() for l in auth.splitlines()
if 'attempts=30 hit=None' in l)
这次离线复核实际统计结果:
{
"attempt_lines":30,
"rejected_credentials_lines":30,
"result":"结论: attempts=30 hit=None"
}
这段日志记录了 30 次尝试行和 30 条凭据被拒错误,最终没有命中。日志里的 [lock/deny] 是脚本标签;InvalidCredentialsError 本身不能进一步证明账户已经锁定。认证方式、策略限制、凭据不被接受等原因,也不能仅靠这个异常名称细分。
还有一个必须拆开的概念:样本通信的 AES 密钥,不是服务器管理账户的登录口令。掌握 MD5(b"6153") 能让我们核验保存的应用消息,却没有建立它与 Windows 账户密码之间的关系。协议逆向成果不能自动兑换成服务器访问权限。
原行动总报告另外承认了尝试次数与先前约束不一致,以及部分路径曾发生直连。日志自称“授权操作”也只是作者表述,不能代替第三方资产所有者的授权证明。写复盘时,应保留操作性质与结果,不把它包装成全程被动观察。
这段经历的结尾就是没有取得访问权限。把失败写清楚,读者才可以看见每个响应在哪个层级结束,以及为什么后续结论必须停在那里。
二十五、没响应不等于撤服,没记录不等于没发生
几轮探测没有得到预期响应后,一个很容易浮现的判断是:主 C2 已经撤离。它为整场调查提供了一个干脆的结局,却未必是证据能够抵达的地方。
来自不同路径的超时、复位或无应用数据,可以记录为某一时间窗口内的观测。它们不直接显示服务器上的进程列表,也没有告诉我们服务为什么不响应。访问策略、协议前置条件、网络设备行为、路径差异、服务状态,都可能影响结果。不同出口表现不同,也不足以独自锁定某一种服务端策略。
类似的推理错误在主机侧出现过:没有历史连接日志,被写成没有外发;没有发现某文件,被写成彻底清除;发现三月线索,被写成连续窃密半年。在网络侧,它又变成“没响应,所以没有监听进程”。这些句子的共同问题是,把观测能力的边界藏了起来。
把观测与推断分开,结论才有可以复查的落点:
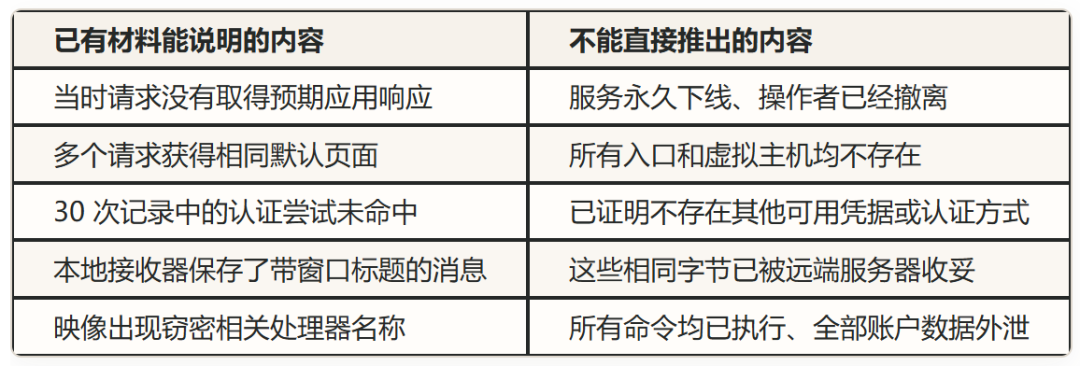
尤其需要解释本地接收器:历史工作通过本地地址与监听调整接收程序通信,从而取得可分析字节。它支持“程序生成了这样的消息”,但接收位置已经改变,不能用这次本地接收结果替代远端服务器的接收日志。
窗口标题确实出现在了该程序组织的消息里,已足以构成需要处置的实际发现。只是技术写作不能借一个真实发现,替其他尚未证明的事情签字。
二十六、相似的报错,未必来自同一个原因
当二进制消息已经能够解析,一个更朴素的问题又把核验拦了下来。读取历史日志、隔离文件和内存提取件的脚本,在第一次运行时将文本统一按 UTF-8 解码,结果报错:
UnicodeDecodeError:'utf-8' codec can't decode byte 0xff in position 0: invalid start byte
decoding with 'utf-8-sig' codec failed
这与前文解密后的 UTF-8 异常表面相似,原因却不相同。这里读的是历史文本报告,其中一些文件带有 UTF-16 的字节序标记。修复是在文本入口识别 BOM,保持严格解码,而不是丢弃不认识的字节。
raw = read(source, rel)
txt = raw.decode(
'utf-16' if raw.startswith((b'\xff\xfe', b'\xfe\xff'))
else 'utf-8-sig'
)
修改后,脚本完成了 PE 时间戳复算、元数据流边界检查、认证失败计数以及历史响应摘录。输出保存在 runs/supplement-audit-run.json,其中每份读取材料都记录文件长度和 SHA256,摘录还保留原始行号。文件路径用相对来源名表示,避免把私人目录带进帖子。
“遇到乱码”从来不是足够具体的诊断。它可能来自错误密钥、没有处理压缩层、错误的字符编码,也可能只是读日志时没有尊重文件格式。每次都应该回到当前正在处理的那一层,而不是被相似的报错带回同一个解释。
这份离线核验脚本的调用方式如下。需要持有对应原件;公开包保留脚本和运行结果,未包含恶意可执行样本及完整内存转储:
python -B -X utf8 code/supplement_audit.py `
--source "历史调查目录" `
--memory "内存取证目录" `
--quarantine "隔离样本目录" `
--out my-supplement-audit.json
一个哈希不能把事后形成的记录变成完整保管链,一次成功重跑也不能补回缺失的历史。它们的作用是让后续核查更具体:核查的是哪份文件、哪几行、哪段字节,以及本文从它们推出了多远。
二十七、走过这些弯路,问题终于露出各自的形状
走到这里,再回头看,问题并不是某个地方少写了一句 if。几种不同层面的错误叠在一起,才让早期解释显得格外完整。
第一层是来源混淆。自测 HTTP 请求与被分析程序的数据保存在附近,重复文件又抬高了计数。没有先分类输入,后面的模型很容易得到一套包含调查者自己行为的“攻击画像”。
第二层是把可读性当结构正确。解密后能够找到中文,就急于解释每段文字;无法解码的控制字被当成噪声或特殊分隔符。这样做的结果,是在压缩层尚未解除时提前进入了字符串层。
第三层是把相关当定义。部分 0x4F 帧出现“管理员:”标题,两个现象就被绑定成了一条协议规则。等所有样本摆在一起,反例才把这条规则拆开。
第四层是测试目标偏移。旧代码检查“所有字节被消费”,结论却写成“逐字段语义已确证”;自构造数据的 AES 往返通过,又被误认为外部协议兼容。
第五层是结论越过观察范围。程序中有某种方法,被写成该方法长期执行;本地采集到窗口标题,被写成远端已收到全部输入;三月与九月各有记录,被写成中间每天都在监控。
这几层错误都不是增加一点情绪就能修正的。真正有效的修正,是让文件来源、数据层次、假设、测试目标与最终措辞保持一致。
如果有人只拿走本文的一条经验,我希望是这个:每看到一个 PASS,就继续问一句——它到底检查了什么,又没有检查什么?
二十八、AI 在这次逆向里,究竟强在哪里
把这篇文章写成“AI 自动秒杀木马”,当然会更轻松。它也会省掉大量最值得分享的东西。
这次 AI 真正发挥作用的地方,首先是把分散材料组织成可以继续工作的状态:读取报告、对照目录、定位旧代码的判断条件、记录清理前后证据的差别。对于一个持续生成文件的调查目录,这些整理工作本身就决定了分析能否向前推进。
其次,它能够把一句怀疑很快变成一段检查。怀疑计数重复,就生成哈希分组;怀疑权限分类,就遍历全部记录找反例;怀疑控制字,就输出输入偏移和累计长度;怀疑自测过于宽松,就构造一个错误协议仍能完成加密往返的例子。
这种从文字问题到可执行实验的转换,是本案中最有实感的能力。讨论不必停在“也许是这样”。可以要求它把条件写下来,运行,让结果给出下一步方向。
再往后,它还能把运行响应、完整代码、公开样本、私密证据和文章分开整理。原始标题不该不加筛选地出现在帖子里,人工测试也不能混入真实证据计数。这些边界需要有人明确提出,而 AI 可以协助将它落实到输出格式、白名单和打包检查中。
但同一段经历也说明,AI 的语言能力会给错误披上一层很合身的外衣。一个错误协议,只要故事足够连贯、字段表足够整齐、验证结果足够热闹,就可能在多份报告里被反复引用,越写越像事实。
所以这里不能用“另一个 AI 也同意”作为终点。另一个模型、另一个脚本,都可能沿用相同前提。更有用的是改变验证方向:从语义退回长度,从几份好看的样本扩展到全部输入,从正向运行走向刻意失败,从自动输出回到人工可读的偏移表。
下面这段提示词可以直接复用。它是根据此次经验整理的工作指令,不伪装成当时会话的逐字记录:
任务:验证一个未知二进制消息的结构,不要先判断恶意家族。

1. 先列出原始输入、哈希和来源,标记自测、重复和可能的截断。
2. 对每一个字段假设给出偏移、长度、支持样本和反例。
3. 把外层帧、加密、压缩和序列化分开验证,不跨层解释字节。
4. 不使用宽容 UTF-8 解码掩盖异常,不默默跳过未知字节。
5. 检查每一个长度声明,核对输入与输出是否完全消费。
6. 不复用旧解析器的通过条件,写出明确的失败条件。
7. 用人工数据测试截断、超长、多字节长度、非 BMP 字符和未知类型。
8. 对所有原始文件批量运行,输出结构,不默认打印私人明文。
9. 最终分别列出:验证通过的结构、尚不支持的输入、未确定的语义。
10. 保存代码与真实输出;没有运行过的步骤,只能标为建议或推测。
本案没有做模型与人工的速度对照,也没有测量“节约了多少小时”,所以这里不给它安一个虚构的倍数。可以检查的成果已经放在附件里:14 个实验阶段、两套实际运行记录、选取的原始帧、负向测试和逐文件结果。
AI 的强大,在这里体现为把一个人能够提出的问题,迅速推进到一组可以运行、可以检查、也可以被推翻的实验。 最后保留下来的不是模型的自信,而是经得起这些实验的部分。
二十九、给准备复现的读者:附件应该怎样打开
读到这里,分析已经走过主机痕迹、内存结构、协议拆解和远端响应。附件按这几条线索组织:能公开复现的留出入口,需要原件的注明条件,只有历史记录的保留来源。材料索引与文件指纹列在文末。
附件的主要文件如下(完整清单见 上传说明.md):
看雪完整实录-逆向渗透取证版.md    这篇文章
code/
  verify_frames.py              分层离线核验器
  lab_walkthrough.py            本文 14 个实验阶段
  test_verify_frames.py         人工正向与负向检查
  memory_markers.py             对授权内存提取件做字节搜索
  supplement_audit.py           主机、元数据与历史日志离线核验
data/
  F01-original.hex              选取的真实 84 字节原始帧
synthetic_examples/             人工测试帧,明确标记 SYNTHETIC
runs/
  full-original-run.json        对本机 23 原始文件的本轮真实运行记录
public-f01-run.json           对公开 F01 的本轮真实运行记录
  memory-markers.txt            本轮字节搜索输出
  supplement-audit-run.json     主机与历史日志的离线核验结果
verification_summary.json      先前完整核验器的去明文结果
source-index.json              来源编号与内容指纹
figures/                       派生分析图与运行输出排版图
SHA256SUMS.txt                  发布包内文件指纹
先运行 F01 版本,就能复现外层长度、候选密钥对照、AES 解密、旧 EXACT 最小复现、控制字跟踪、错误字符串模型、正确偏移表和人工负向测试。由于输入只有一份原始记录,权限反例展示与全部文件统计不会和 23 文件版本完全相同;具体差别已经写进两份日志的 mode 字段。
持有原件、且有权处理其中隐私内容的调查人员,可以追加 --frames:
python -B -X utf8 code/lab_walkthrough.py `
--frames "原始帧目录" `
--out my-authorized-full-run.json
memory_markers.py 需要另行提供原始映射提取件。该内存文件没有公开打包,所以读者不能在公开附件中复现它的全部字节搜索;随文保留的是这次离线复核输出、文件长度和 SHA256,方便以后获授权的人比对。
历史载荷相关目标为 154[.]91[.]82[.]63:5245。本文没有重新连接目标,不提供主动探测或认证尝试步骤。IP 可能被租用、转用或属于受侵入设施,仅凭地址不能认定当前持有人就是操作者。
如果有读者持有同哈希样本的独立分析,尤其是序列化类型注册顺序、0x28 对应的完整消息定义、其他消息分支或实际压缩匹配路径,欢迎给出可以核查的证据。命名空间相同或者代码风格相似,都可以作为进一步研究的起点,但不足以独自完成家族和团伙归因。
三十、回到那四个字符串
文章写到最后,可以再看一次最初解出的内容:
0分 / QQ / 0ms/超时 / 未登录TG只有这么短。没有一长串密码,没有所谓受害者总表,也没有戏剧性的服务器终端。
它的意义在于,这几个字确实来自受感染程序组织的消息;而我们能够指出它们在原始文件中经历了哪几层变换、每层消耗多少字节、每段字符串从哪里开始、在哪里结束。
从一个熟悉的窗口标题,到一段看不懂的密文,再回到同一个标题,技术分析在这里完成了一次可以复查的往返。这比“我觉得它很像某某木马”更具体,也比“AI 说已经全部破解”更值得留下。
截至 2026-09-21 03:22 的系统快照,没有发现已知恶意名称进程、两个任务及所查原落地路径继续存在,诱饵压缩包仍有残留,清理后尚无重启验收。这个状态不等于全盘安全。真实外泄范围、最早触发经过、操作者身份,也没有因为消息格式解释清楚就自动得到答案。
关于历史操作,还需要保留一项说明:原调查目录包含主动外部探测和 WinRM 认证尝试记录,因此不能把整个既往过程描述成“全程被动、全程隔离”。本篇重跑的是本地离线核验,没有重复那些操作。原始记录形成于感染后的在线系统,经历过工具和清理,缺少完整可信时间戳与连续保管证明;本篇是技术复盘,不是司法鉴定。
这场复核最重要的收获,也许就是重新理解“解开”两个字。
AES 解开的时候,答案还没有到。看到中文的时候,答案仍然没有到。甚至控制台打印 EXACT 的时候,答案也可能只是被一个过于宽松的测试提前宣布了。
后来我们回到字节,回到长度,回到那个不肯消失的报错,才终于知道哪一部分真的站得住。
密文可以用密钥打开。一个看似完美的错误解释,只能靠证据拆开。
公开附件与脱敏范围
本文对应附件为 看雪上传定稿.zip。附件包含本文 MD、正文引用的 4 张图、5 份离线 Python 脚本、4 份运行记录、1 条经筛选的原始短帧 HEX、2 份人工测试帧,以及来源索引、去明文核验摘要和完整性校验表。目录细项见 上传说明.md。
F01 解密结果是 0分 / QQ / 0ms/超时 / 未登录TG。其他真实窗口标题仅保留 QQ、ChatGPT 和通用 Windows 命令提示符标题作为反例;人工测试标题明确标为 SYNTHETIC。样本通信密钥用于复现解密,不是个人账户口令。
公开材料保留调查日期、采集文件名中的时间及连接编号、样本和证据哈希、恶意文件名称及系统落地路径、历史网络指标。这些有利于复核,也可能被知情者用于关联事件;这些材料并不构成完全匿名的叙述。材料中的服务响应及认证失败记录是历史摘录,没有声称渗透成功。
本包未包含私人窗口标题全集、聊天记录、个人公网 IP、微信账号标识、账户密码、Cookie、令牌、完整内存转储或恶意可执行文件。文件审查未发现这些内容,但不等于对未知隐私线索作零风险保证。未公开原件仍由持有者保管;附件索引中的哈希不表示相应原件已经公开。
附录:材料来源与核验范围
调查材料既包含原始文件和工具输出,也包含形成于不同阶段的分析报告。报告中的判断需要回到对应证据核查,不能仅因被反复引用就成为事实。以下文件指纹在离线复核时计算;原件未全部公开,持有者可据此核对。runs/supplement-audit-run.json 保存结构化索引及部分摘录行号。
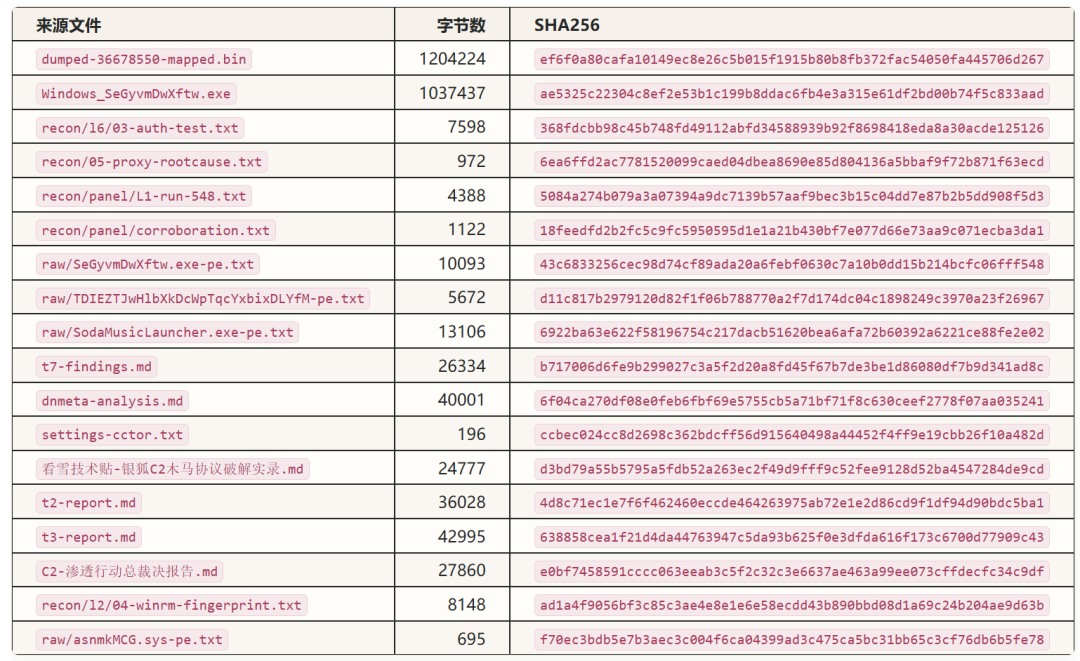
这些是本地历史来源,并非这次离线复核对外重新探测结果。原件包含私密内容,附件只保留经过筛选的引用及指纹;附件脚本不联网、不执行样本、不重放认证。
看雪ID:学习的小秦
https://bbs.kanxue.com/user-home-996278.htm
# 往期推荐
当高频观测不再经过异常路径:Shadow Cave 与常驻式插桩架构
D3CTF 2026 d3llvm.apk 反调试定位与加密 SO的Dump
球分享
球点赞
球在看
点击阅读原文查看更多