一、疯狂擦屁股的Codex...OpenAI 的基建撑不起他们的野心
昨天轰轰烈烈的 Dev Day 之后,OpenAI 连忙开始“擦屁股”了,24 小时内连续发布了几个 Alpha 版本,想刷版本号的朋友,从 160 Alpha 1 可以直接一路升到 Alpha 5 了。
目前来看,OpenAI 正在集中精力修补一些基础能力。因为现在新增了 Dots,还有云端 Codex 和本地 Codex,所以会面临任务持续性和连续性的问题,核心要解决是任务不要丢。
现在 Codex 面临的任务,已经不再只是修改一个文件、跑一个命令,而是可能要跑几十分钟,甚至几个小时。中间还涉及不同线程、多个 Agent、云端和本地执行环境,以及大量状态同步。所以任务越长,就越容易出现一个问题:“任务本身没失败,但 AI 已经忘记自己要做什么了。”
这次连续发布几个版本,很大一部分就是为了改善任务连续性。当用户恢复旧任务时,Codex 不再完全依赖本地缓存,而是优先采用服务端保存的真实历史。整个判断的权利从本地改为在服务端做判断,很多任务不仅在本地跑 云端也有跑,当用户手动修改目标,也就是我们说的 Goal,这些修改也会写入模型历史,这样可以避免用户已经改变任务,但Agent还在继续执行旧任务。
同时,这次还增加了数据库损坏检测和定期备份。这其实说明,过去的运行过程中应该出现过数据库损坏的问题,各种线程、任务、执行结果,以及 Agent 的各种状态,最终都要落入数据库。一旦数据库损坏,面临的就不只是对话丢失,而是整个任务失败。
总之,Codex 这几个迭代确实有点像是在“擦屁股”。现在又是 Dots 调 Codex,又是云端 Codex、本地 Codex,状态实在太复杂了,现阶段肯定还会有一大堆 Bug,大家遇到问题记得及时更新软件。
二、GPT-6.1 Sol到底行不行,我说神鬼二象性
GPT-6.0 Sol 应该算是目前生命周期最短的模型之一,大概活了不到一个月,就被 6.1 Sol替换了,这个模型到底好不好?
目前Codex 雷达那边还没有特别完善的数据,但从大家反馈的体感来看:
1、这个模型可能属于“又快又慢”。小任务比较快,大任务和困难任务就比较慢。2、任务的成本节约很明显,但是大任务未必能像官方宣传得那么省,可能最后还是趋向Sol 5.6 的水平。
所以,这 ChatGPT 他妈又吹牛逼了啊,官方说这个东西成本可以比原来下降一半,小任务可能确实如此,但经过不少网友测试,超长任务的整体成本,差不多还是 5.6 那个级别。
而且我们的额度又下降了。
如果不开 Fast 模式,复杂任务确实比较慢。我甚至怀疑它是不是通过“水时长”,让你觉得 Token 比较耐用?
开启 Fast 之后会快一点。目前经过雷达站站长测试,Fast 模式大概可以达到 2 倍左右的速度,以前大概是 1.5 倍,也算是一个好消息吧。
目前 GPT-6.1 Sol 已经成为 Codex 的默认模型,而且也放到了亚马逊 Bedrock 上,所以这个模型确实比较重要。
当然,它目前还没有进入普通 Chat,主要用于代码执行、模型调度和 Agent 协作。
总之,我目前的体感还是有点差。
大家有钱的话,还是多用一点 Astra 吧。
另外:6.1 Sol 少开 Max,真的慢。
三、Dots到底收费不,真的报用
目前测试下来,只要使用它云电脑本身的能力,不管是通过浏览器访问,还是读取电脑里面的信息,这些操作本身目前都不额外消耗 Codex 额度。
但是如果让它调用 Codex 去执行任务,那就要开始算额度了。
所以大家使用的时候,能不让它调用 Codex,就尽量不要调用,我觉得最好是自己已经有一套比较成熟的流程和方法论,甚至提前准备好脚本或者 Skills,再让它定期运行。一个不限量Astra 模型,真的是可以深度研究下的,也是我下一阶段的研究重点,。
虽然首个 Dot 不额外收费,但官方只承诺首月提供“更深度工作的扩展额度”,说不定次月就有更多的限制了。
团队型多个 Dot 要等 OpenAI 收集完第一阶段使用数据后再开放....你看上面的基建就知道还没准备特别好。
另外还没蒸馏够用户数据,先观察用户如何使用主 Dot,然后训练“长期个人代理”,再开放多代理协作,发布不代表就有嘛,Beta 也是发布嘛。
Tibo 自己也没有真正的用好他的 Dots,毕竟他说连续教 Dot 了解个人偏好和近期想法两三天后,明显感觉效果提升...他可是能很早就能用到 Dot 的人....
所以大家量力而行,等最佳实践最好了。
Gemini 4 Argon还是路边一条,但是我要打 call
然后我们再看一下 Gemini 4发布了,但是不用看路边一条,我认为它仍然是一个喜欢刷分的模型,为啥:
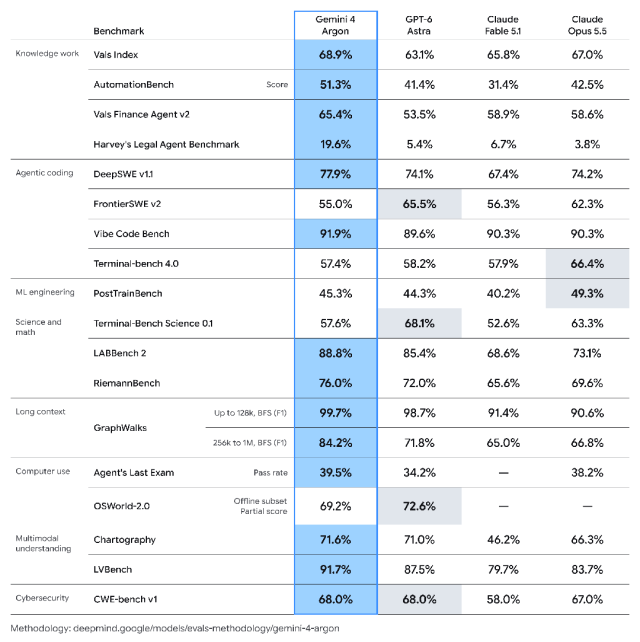
1、它虽然有新名字Argon,但它不带 Pro
2、悄咪咪地发布,所以它能有什么好东西。
3、价格输入 2 美金/百万 10 美金/百万,就这个档次 就是我们的 GPT-6.1-sol 的档次。
4、你看这个成绩 比 Astra 更好4、我们再看一下 还有一个 Grok 4.7,跟它一起数一数二,这难兄难弟是吧,这模型训练坏了,分数倒是蛮高的。
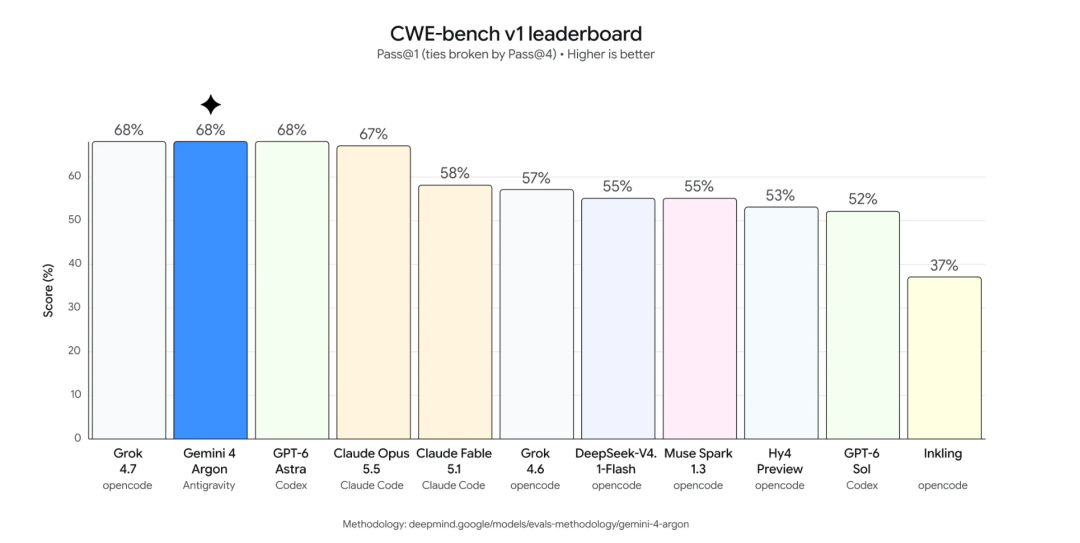
也希望谷歌能争气点 不然的话,现在我们只能在OpenAI这个渣男与Claude O/之间 真的是左右为男....
最后再插播一条信息,目前 Pro 200 和 Pro 500 都已经可以开通了,大家还是要先看看 OpenAI 最近的稳定性,再考虑要不要直接上 Pro 500。目前我觉得它的性价比还是有点低。
市面上现在也出现了一些低价 Pro 500 渠道,但这种肯定就没有官方渠道那么“正宗”了,如果你真的特别想体验 Ultrafast 这种超快模式,倒也可以研究一下。